
JMeter基础
JMeter基础
1 JMeter介绍
1.1 什么是JMeter?
Apache JMeter 是 Apache 组织基于 Java 开发的压力测试工具,用于对软件做压力测试。
JMeter 最初被设计用于 Web 应用测试,但后来扩展到了其他测试领域,可用于测试静态和动态资源,如静态文件、Java 小服务程序、CGI 脚本、Java 对象、数据库和 FTP 服务器等等。JMeter 可对服务器、网络或对象模拟巨大的负载,在不同压力类别下测试它们的强度和分析整体性能。另外,JMeter 能够对应用程序做功能/回归测试,通过创建带有断言的脚本来验证程序是否返回了期望结果。为了最大限度的灵活性,JMeter 允许使用正则表达式创建断言。
1.2 JMeter的优缺点
优点:
- 扩展性强,插件丰富,灵活性高
- 可以和很多工具兼容,方便自动化
- 与平台无关
缺点:
- JMeter的GUI模式资源消耗较大,在真正需要负载压测时需要在非GUI环境下进行,并且关闭不需要的监听器。
- JMeter采用线程并发机制,主要依靠增加线程数来提高并发量。当单机模拟数以千计的并发用户时,JMeter对系统的CPU和内存资料消耗巨大,能支持并发数量不多。
2 JMeter的安装
安装步骤:略
注意:安装包的版本选择Binaries的可执行版本(Source是源码版本)
3 JMeter的执行
JMeter在执行时GUI界面比较消耗系统资源,应该将真正的压测任务脚本放到服务器上开展执行。在Linux上通过命令行的方式使用。
①单机执行脚本命令
./bin/jmeter -n -t 【Jmx脚本位置】-l 【中间文件result.jtl位置】-e -o 【报告指定文件夹】

②分布式执行脚本命令
./bin/jmeter -n -t 【Jmx脚本位置】-R ip1:1099,ip2:1099 -l 【中间文件result.jtl位置】-e -o 【报告指定文件夹】
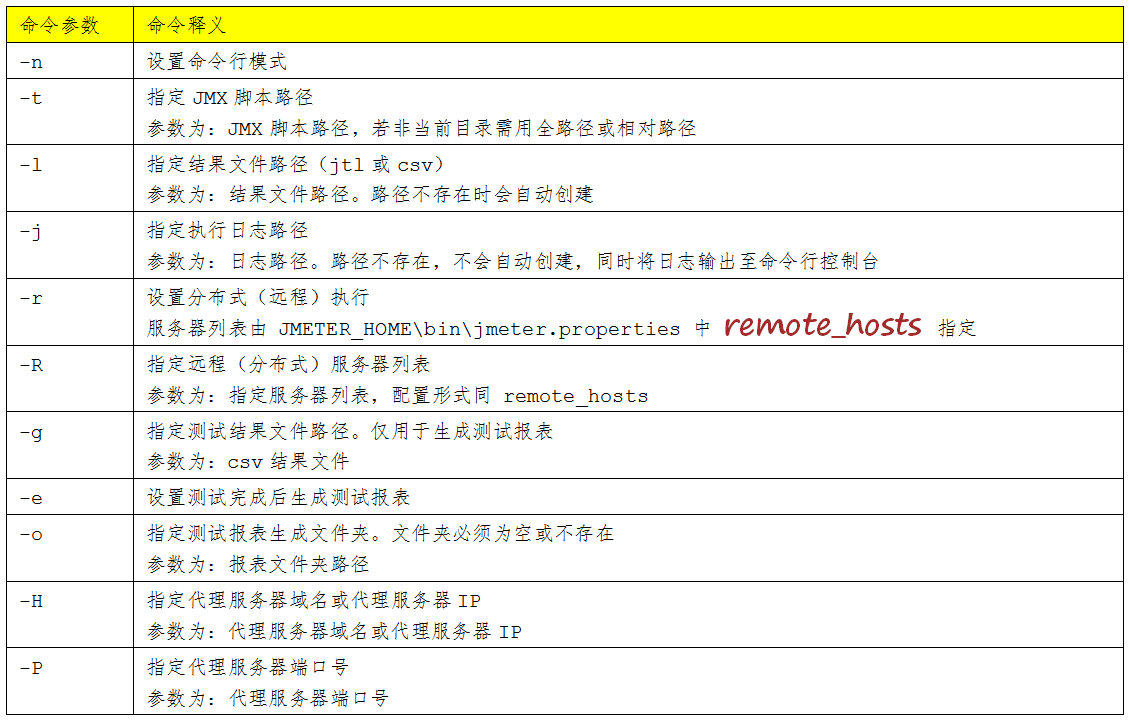
4 JMeter结果查看
①结果文件查看
结果文件类型为 jtl 或 csv,测试计划里添加的哪种监听器,就可通过JMeter的相应的监听器浏览结果文件,查看最终的结果。
-
打开JMeter图形窗口,并新建或打开一个测试计划,为该计划添加“结果查看树”和“聚合报告”
-
打开聚合报告,点击“浏览”按钮打开测试结果文件test.jtl生成聚合报告。

②HTML报告查看
将指定生成的报告指定文件夹打包,然后点击查看index文件

5 JMeter的常用核心组件

5.1 测试计划
一个测试计划中至少包含一个线程组,多个线程组之间可以并行运行,也可以串行运行,可在测试计划页面中进行选择。

5.2 线程组
5.2.1 线程组

PS:Same user on each iteration表示每个迭代都用相同的线程。这个得从老版本讲起,在以前 3.x 和 4.x 版本的 JMeter 中,是没有这个选项的。创建好 1 个线程后,每次迭代都是用这个线程,直到测试结束。它的影响就是,比如登录,加了 HTTP Cookie 管理器以后,单个线程多次迭代(注意不是多个线程哦)登录用的都是相同的 Cookie。5.x 版本加入了这个选项,可以控制每次迭代是否创建新的线程。同时在 HTTP Cookie 管理器也增加了一个选项,控制是否清除旧 Cookie。
默认这个 Same user on each iteration 的选项是勾选的。因为销毁和创建线程本身就会占用资源,可能会影响性能测试结果
5.2.2 并发线程组
在实际性能测试过程中,可能需要模拟一种阶梯式的压力情况(从某个值开始不断增加压力,直到达到某个值,然后持续运行一段时间)。这种场景下JMeter本身的组件无法完成,需要用到扩展插件Custom Thread Groups。
1 安装插件管理工具
①官网下载 JMeter Plugins 的jar包
②将下载的jar包复制到 %JMETER_HOME%\lib\ext 目录下
③启动 JMeter --> Options --> Plugins Manager 。(如果没将jar包放在ext目录下是没有该选项的)

2 安装Custom Thread Groups插件


3 选择阶梯式加压插件


5.3 配置元件
配置元件用来设置一些JMeter的脚本公用信息,会影响其作用范围内的所有元件,常用的包括:HTTP请求默认值、HTTP消息头管理器、CSV参数化配置元件等。
5.3.1 请求默认值
一般用作全局的配置,有多个请求的时候,可以把默认公共的值作为请求默认值,如:IP地址和端口号一样。
5.3.2 HTTP消息头管理器
HTTP请求需要传递后后端服务器的一些验证信息,如:token、cookie,可以放到HTTP消息头管理器中。HTTP消息头是在客户端请求或服务端响应时传递的,通常位于请求响应的第一行,HTTP消息体在其后传输。每个消息头最后回车符或者换行符结尾。
注意Content-Type的类型,一般为application/json的json数据格式传输
| Content-Type的类型 | 含义 |
|---|---|
| application/x-www-form-urlencoded | 常见的 POST 提交数据的方式,原生Form表单,如果不设置 enctype 属性,默认为application/x-www-form-urlencoded 方式提交数据。 |
| multipart/form-data | 常见的 POST 数据提交的方式, Form 表单的 enctype 设置为multipart/form-data,它会将表单的数据处理为一条消息,以标签为单元,用分隔符(这就是boundary的作用)分开,类似我们上面Content-Type中的例子 |
| application/json | 消息主体是序列化后的 JSON 字符串 |
| application/octet-stream | 二进制流数据(如常见的文件下载) |
| multipart/form-data | 需要在表单中进行文件上传时,就需要使用该格式 |
PS:
①当有多个消息头管理器,且不同消息头管理器内有名称相同的消息体时,顺序靠前的管理器中的消息体会覆盖后面的。
②web程序中用来跟踪用户的会话常用的为cookie和session技术。cookie通过客户端记录确定用户身份,session通过服务器记录确定用户身份。
5.3.3 CSV参数化配置元件

PS:引用的格式为${变量名},如果是分布式压测,需将CSV文件上传到各个压测从机上,同时注意文件路径的修改
5.4 监听器
监听器最常用的为查看结果树和聚合报告,需要注意的是,监听器会消耗系统资源,真正压测时应该尽量避免开启不必要的监听器。
5.4.1 聚合报告
性能测试中需要理解聚合报告中的各个参数的含义,并以此分析性能测试结果。

PS:性能测试过程中Average、90%Line、95%Line、Error%、Throughout这几个参数作为性能分析重要指标数据。
5.4.2 查看结果树
通常该组件用于脚本调试时,观察请求和响应是否正确,包括请求头、请求体、响应内容等。在真正压测的时应该尽量禁用或者删除该组件,否则会对客户端性能造成影响,性能测试第一原则是不能让性能瓶颈出现在发起压测的客户端。
5.5 逻辑控制器
作用:用户可通过逻辑控制器来控制脚本的执行顺序,以便更加真实地模拟按照用户期望的顺序和逻辑执行脚本。
逻辑控制器包含两类十几种:
①一类是控制测试计划执行过程中节点的逻辑执行顺序,常用的有if控制器、循环控制器和随机控制器。
②另一类是对测试计划中的脚本进行分组、方便JMeter统计执行结果以及进行脚本的运行时控制等,如事务控制器、吞吐量控制器。
最常用逻辑控制器:简单控制器、事务控制器、if控制器、仅一次控制器、吞吐量控制器
注:多个控制器时各个控制器的执行顺序为从上到下的先后顺序
5.5.1 简单控制器
这是Jmeter里最简单的一个控制器,它可以组织我们的采样器和其它的逻辑控制器(分组功能),提供一个块的结构和控制,并不具有任何的逻辑控制或运行时的功能,对内部取样器没有任何影响,只是方面分组命令。
5.5.2 事务控制器
产一个额外的采样器,可以在该控制器下添加多个请求,当做一个事务,统计该控制器子结点的所有时间。

Generate parent sample:是否生成父取样结果,勾选后有两个效果,一是Aggregate Report会看到Transaction Controller字样,它把节点下的取样器的运行结果(如消耗时间)累加在一起(注意事务控制器下如果有多个取样器,全部取样器都运行成功,整个事务控制器才算成功)
①不勾选Generate parent sample

②勾选Generate parent sample

Include duration of timer and pre-post processors in generated sample:统计结果会包括定时器和前置-后置处理器的耗时,建议不用勾选,不然会影响统计结果。
5.5.3 If控制器
①根据给定表达式的值决定是否执行该节点下的子节点,可以使用变量表达式或JavaScript(条件为True时执行,否则不执行)。
②勾选Interpret Condition as Variable Expression表示使用变量表达式,建议勾选上。这时可以借助函数助手中的_jexl3和_groovy将条件表达式计算为true/false。

③默认情况下,条件在初始输入时只判断一次,勾选Evaluate for all children表示在每个子结点执行前计算表达式。
eg:发送if判断前的请求->正则表达式后置处理器提取返回的数据->if逻辑控制器判断提取的参数信息->根据if判断结果是否执行if控制器内的请求


5.5.4 仅一次控制器
控制只执行一次的控制器,通常用于登录请求。
5.5.5 吞吐量控制器
吞吐量控制器用于控制其下的子节点的执行次数与负载比例分配,通常用于混合场景下的比例测试。有两种方式:
①Total Executions:设置运行次数
②Percent Executions:设置运行比例(1~100之间)

Per User:当选择Total Executions时,它表示线程数;当选择Percent Executions时,它表示线程数*循环次数。一般不选。
5.6 取样器
取样器用来模拟用户操作,它可以向服务器发送请求以及接收服务器的响应数据,常用的为HTTP请求,JAVA请求
注:多个取样器时,各个取样器的执行顺序为从上到下的先后顺序。
5.6.1 HTTP请求
模拟各类的HTTP请求,常见的有GET和POST。

请求信息根据实际接口填写,其中有几个参数需要特别说明
-
Content encoding:一般配置为utf-8
-
Redirect Automatically:自动重定向(默认不勾选)。勾选后,当HTTP请求后,若响应为301(永久性重定向)或302(临时重定向),jmeter会自动重定向到新页面,但不会记录重定向的请求和响应内容,只能观察到重定向后的最终结果。注意此选项只能应用于GET和HEAD请求,不能应用于POST或者PUT请求。
-
Follow Redirects:跟随重定向(默认勾选)。勾选后jmeter将会观察到整个重定向过程中的所有请求,无论重定向了多少次。
-
Use KeepAlive:当勾选时,jmeter和服务器之前将采用keeplive(持久连接)的方式进行通信。
-
Use multipart/from-data:使用
multipart/from-data或application/x-www-form-urlencoded方法发送HTTP。此选项应用于POST请求,默认不选。Keep-Alive模式:Keep-Alive模式下当一个请求发起后,客户端和服务器之间的TCP连接不会关闭重新建立连接,会一直保持连接,如果客户端再次访问相同资源,会继续使用者一条建立的连接,启用Keep-Alive模式更高效,性能更高。http 1.0中默认是关闭的,需要在http头加入
Connection: Keep-Alive,才能启用Keep-Alive;从HTTP/1.1开始,浏览器都默认开启了keep-live,保持连接特性,如果加入Connection: close,才关闭。目前大部分浏览器都是使用HTTP1.1。keep-live不会永久保持连接,它有一个保持时间,可以在不同服务器软件(如 nginx)中设定。开启Keep-Alive的优缺点如下:
- 优点:开启后更高效,避免了连接建立和关闭释放的性能开销。
- 缺点:长时间的TCP连接容易导致系统资源的无效占用,浪费系统资源。
当保持长连接时,如何判断一次请求已经完成?
①消息首部字段
Content-Length,它表示实体内容的长度。浏览器通过该字段来判断当前请求的数据是否已经全部接收。如果服务器知道返回内容的长度时(如静态页面或者图片),可以通过设置Content-Length来控制请求的结束;如果服务器不知道请求结果的长度时,如动态页面或者数据,就不能使用Content-Length,就需要使用第二种方法Transfer-Encoding字段。②消息首部字段
Transfer-Encoding,它指传输编码。如果服务器不知道请求结果的长度时,就可以使用Transfer-Encoding:chunked来告诉浏览器当前的编码是将数据分块传递,Chunked编码将使用若干个Chunk串连而成,由一个标明长度为0的chunk标示结束。最后当浏览器接收到一个长度为0的chunked时,就知道当前请求内容已全部接收。
5.7 定时器
默认情况下,JMeter线程在发送请求之间没有间隙,为了更加真实地模拟现实用户请求情况,定时器用于在用户操作之间设置等待时间。
注意:
①定时器的时间不会计入单个取样器的响应时间统计,但如果加入了事务控制器,并且勾选了事务控制器中的Include duration of timer and pre-post processors in generated sample选项,则会计入到事务控制器的响应时间统计中。
②无论定时器位置是在取样器之前还是之后,定时器都是在每个取样器之前执行,执行一个取样器之前,所有(同时含有多个情况下)当前作用范围内的定时器都会被先执行。。
③在定时器作用范围之内,每个取样器执行前都将执行一次定时器,如果需要定时器只对一个取样器生效,就需要将该定时器作为该取样器的子节点
JMeter中定义了9中定时器,常用的为固定定时器和固定吞吐量定时器
5.7.1 固定定时器
两次请求之间暂定相同的时间。它代表的含义是在上一个请求发出至完成后,开始固定定时器指定的时间,再发出第二个请求,它并不是代表两个请求之间的发送间隔时间。

5.7.2 固定吞吐量定时器
主要用来设置QPS限制,该控制器可以控制取样器发送请求的吞吐量,常用在混合场景压测,尤其是同时压测多个接口,这种场景下我们需要对每个接口的吞吐量设置一个上限。

- Name:定时器的名称
- Target throughput(in samples per minute):目标吞吐量。
注意,这里是每分钟发送的请求数。 - Calculate Throughput based on:有5个选项。
- this thread only:表示控制每个线程的吞吐量,选择这种模式时,总的吞吐量为设置的目标吞吐量乘以线程的数量。
- all active threads:表示设置的目标吞吐量将分配在每个活跃线程上。每个活跃线程在上一次运行结束后等待合理的时间后再次运行。活跃线程指某一时刻同时运行的线程。
- all active threads in current thread group:表示设置的目标吞吐量将分配在当前线程组的每一个活跃线程上,当测试计划中只有一个线程组时,该选项和all active threads选项的效果完全相同。
- all active threads(shared):与all active threads选项基本相同,区别是每个活跃线程都会在所有活跃线程上一次运行结束后等待合理的时间后再次运行。
- all active threads in current thread group (shared):与all active threads in current thread group选项基本相同,区别是每个活跃线程都会在所有活跃线程的上一次运行结束后等待合理的时间后再次运行。
5.8 前置处理器
前置处理器用于实际请求发出之前对即将发出的请求进行特殊处理,如:参数化、加密请求、替换请求字段等。

5.9 后置处理器
后置处理器用于对取样器发出请求后得到的服务器响应进行处理,最常用的就是正则表达式提取器提取响应结果中的数据。
5.9.1 正则表达式提取器
测试过程中许多接口的入参不是确定和固定的,需要从其它请求的返回结果中获取,这种前后接口存在字段依赖的,需要通过正则表达式提取器来提取关联的字段数据。

常用正则表达式字符含义

PS:
①*和*?不同,前者表示贪婪匹配模式(找到一个后不会停止,一直匹配),后者带?号的表示懒惰模式匹配(匹配到一个后就不再匹配)
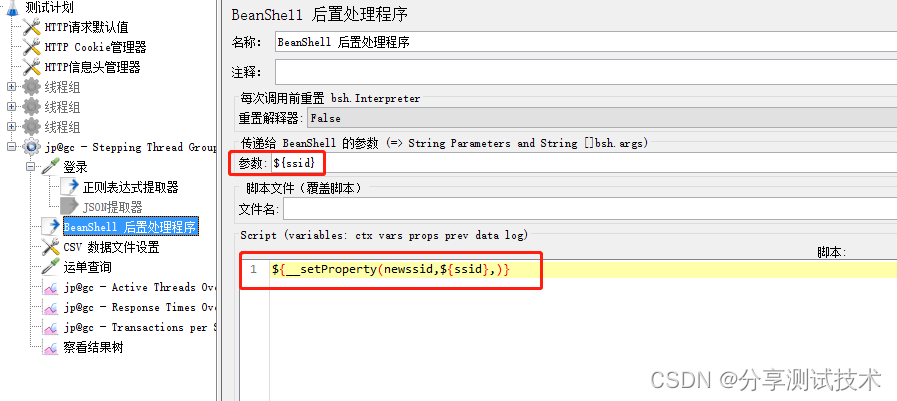
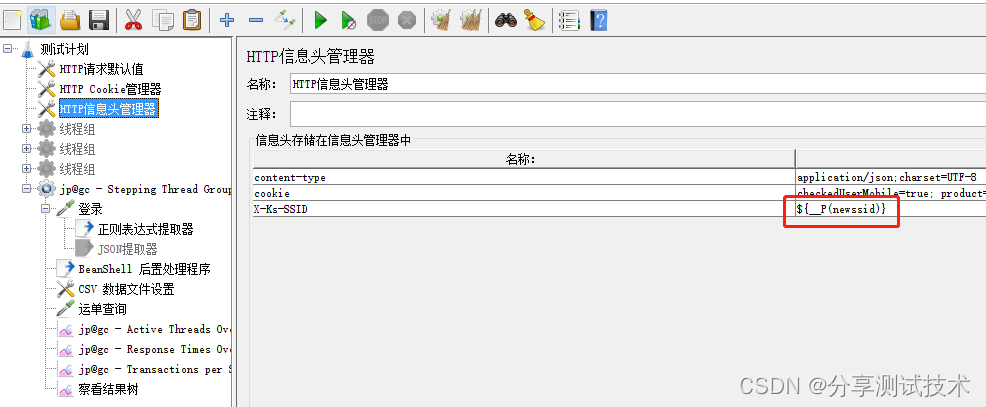
②如果需要跨线程组之间引用变量,在正则表达式提取后,还需要添加一个BeanShell后置处理器,通过${__setProperty(globalToken,${token},)}设置为全局变量,在另一个线程组中就可以通过${globalToken}参数值
5.9.2 BeanShell后置处理器
BeanShell使用轻量级的面向java的脚本语言,运行使用标准的java语法来处理json数据。可以使用BeanShell后置处理器进行一些更复杂的逻辑判断或者提取一些更复杂的值。
5.10 断言
断言用于对取样器请求或者响应数据是否返回了期望结果的判断,可以针对请求也可以针对响应,大多数情况针对响应做断言。
5.10.1 响应断言
对响应数据做断言判断

(1)Apply to:指定断言作用范围。
-
Main sample and sub-sample:作用于主main sample(主节点取样器)和子sub-sample(子节点取样器)
-
Main sample only:只作用于main sample
-
Sub-samples only:只作用于sub-sample
-
JMeter Variable:作用于JMeter变量,输入框内,可输入jmeter变量名称,从指定变量中提取需要的值
注意:
-
大多数情况下,可只勾选“main sample only”,因为一般情况下,发起一个请求,实际就只有一个请求。但是在某些情况下,发起一个请求时,会触发多个服务器请求,这时候就有main sample和sub-sample之分,类似ajax请求,另外,如果发起重定向请求,并且勾选“跟随重定向”, 则把重定向后的请求视为main-sample
-
如果sub-sample断言失败,但main sample断言成功,那么main sample也被设置为失败状态。如果作用域JMeter变量,且该变量关联main sample,那么如果断言失败,则main sample也被设置为失败(If the JMeter variable option is used, it is assumed to relate to the main sample, and any failure will be applied to the main sample only)。
-
如果执行完每个sampler的所有断言,变量JMeterThread.last_sample_ok会被设置为true或false
(2)测试字段:
-
响应文本(Text Response) - 从服务器返回的响应文本,比如body,包含HTTP头
-
Document(text) -通过Apache Tika追踪的各种各种类型文档的文本
-
URL样本
-
响应代码(Response Code) - 比如 200
-
响应消息(Response Message) - 比如 OK
-
Response Headers - 响应头,包括Set-Cookie 头,如果有的话
-
Ignore Status - 指示JMeter设置sampler status的初始状态为success。sample status是否成功,由已Response status和断言结果决定,当选中Ignore Status时,Response status被强制设置为success,不执行进一步的断言判断。仅第一次断言时使用。
(3)模式匹配规则:

(4)测试模式:
填写需要测试的模式列表(list of patterns)。 每个模式都单独测试,如果某个模式失败了,那将不会往下检查剩余的模式。添加一个断言,多个测试模式(通过重复点击面板的添加按钮来添加多个测试模式),和多个断言,每个断言一个模式是一样的。注意空格需要去掉。

注意
如果返回报文为状态码200的情况,只判断状态码,可能存在漏判的可能,因为有些情况下状态码返回200,但是返回数据为null,这种情况,事务应该是失败的。
5.10.2 Size断言
size断言用来判断返回内容字节大小,以及响应结果是否包含正确数量的字节。
6 JMeter的参数化
参数化就是将脚本中的某些参数值或者变量,特别是需要变化更新的值,通过动态参数来替换实现。从而使脚本能更加灵活真实地模拟测试场景。如:登录场景中需要用到手机号,而每次请求需要不同手机号,此时就可以将脚本中的手机号值进行参数化替换。
参数化常用的方式如下:
6.1 用户定义的变量
通过配置元件中用户定义的变量进行参数化。通常用于设定一些全局变量,比较适用于测试计划中不需要随便迭代发生改变的参数。

ps:值中既可以输入具体的值,也可以通过Jmeter的函数助手进行读取
6.2 函数助手
通过函数助手可进行参数化处理,常见的为随机函数,每次请求产生不同的数字或者字符串,${__Random(0,100,number)}、${__RandomString(10,asdfghjkl,name)}。


6.3 从文件中读取
PS:引用的格式为${变量名},如果是分布式压测,需将CSV文件上传到各个压测从机上,同时注意文件路径的修改
7 JMeter的关联方法
在真实的性能测试过程中,往往会遇到多个请求之间具有先后顺序,且具有参数关联,如:下一个请求的内容是上一个请求响应结果中的某一些内容,此时就需要用到正则表达式提取器进行提取内容并作为参数,通过这种方式进行请求之间的关联。
8 JMeter的集合点设置
我们的并发线程在启动后,其实不能做到所有线程真正绝对的同时马上启动运行,然而有时候需要涉及到绝对并发场景,如:秒杀,这时候需要用到集合点设置,顾名思义就是同一时刻达到了某一集合点数目的并发线程数后,再统一发出请求,这样的一个时刻点就是集合点。就好比很多人一起过桥,先让人们在桥头集体,然后一起走过去。
JMeter中提供了一个同步定时器,可以实现这样的绝对并发场景

PS:
-
集合点设置如果设置为默认的0,则等于线程组中的线程数
-
超时时间为0,如果线程数不足集合点中设置的数,就会一直处于等待当中超时时间大于0,如果超过设置的最大等待时间后,还没达到模拟用户组中设置的值,线程组将不再等待,释放已到达的线程
9 JMeter的混合场景方法
在真实业务中,往往都是混合场景,比如:查询和新建场景业务的比例为3:2,JMeter中常用于混合场景的方法有三种
(1)多线程组方式
可以通过多个线程组多模拟多个场景,然后通过每个线程组中的线程数量来控制场景的比例,如查询场景和新建场景各一个线程组,查询场景中线程数量设置为30并发,新建场景中的线程数量设置为20并发,以此达到3:2的场景比例。通过这种方式时,要注意测试计划中要配置各线程组可以并行执行,如下配置不勾选

PS:
这种方式只有在理想情况下才是准确的,前提是这两个业务的响应时间都一样才行。如果这两个业务的响应时间不一样,那么最终完成的业务数比例就会不一样,就会存在结果偏差,因此这种方式并不是准准确的方法。
(2)if控制器实现
①通过函数助手中的_counter函数,来获取当前的请求迭代次数
②通过if控制器来求余判断此次的请求次数是否符合对应的数学比例,符合哪个场景的比例就执行哪个场景,如:${__counter(false,)}%15<=5
数据比例的计算方式
假设A:B:C需要2:3:4的比例 最大值为4,所以我们取余4来操作: A为${__counter(false,num)}%4<2,在0,1的时候运行 B为${__counter(false,num)}%4<3,在0,1,2的时候运行 C不用设置IF控制器,每次均运行 这样每4个请求,A运行2次,B运行3次,C运行4次。
(3)吞吐量控制器
使用吞吐量控制请求量比例


 浙公网安备 33010602011771号