
2025龙信杯wp(全解)
容器密码:MjAyNS3oi4/lt57pvpnkv6E=
今年写龙信杯的时候刚好在手搓美亚团体,就先写了个龙信的服务器,结果美亚团体写完后,正好碰到好多比赛,然后就陷入了比一场比赛写这场比赛的wp的死循环,久而久之就忘记其他的题没做了,正好最近看到了,就补一下吧

手机取证
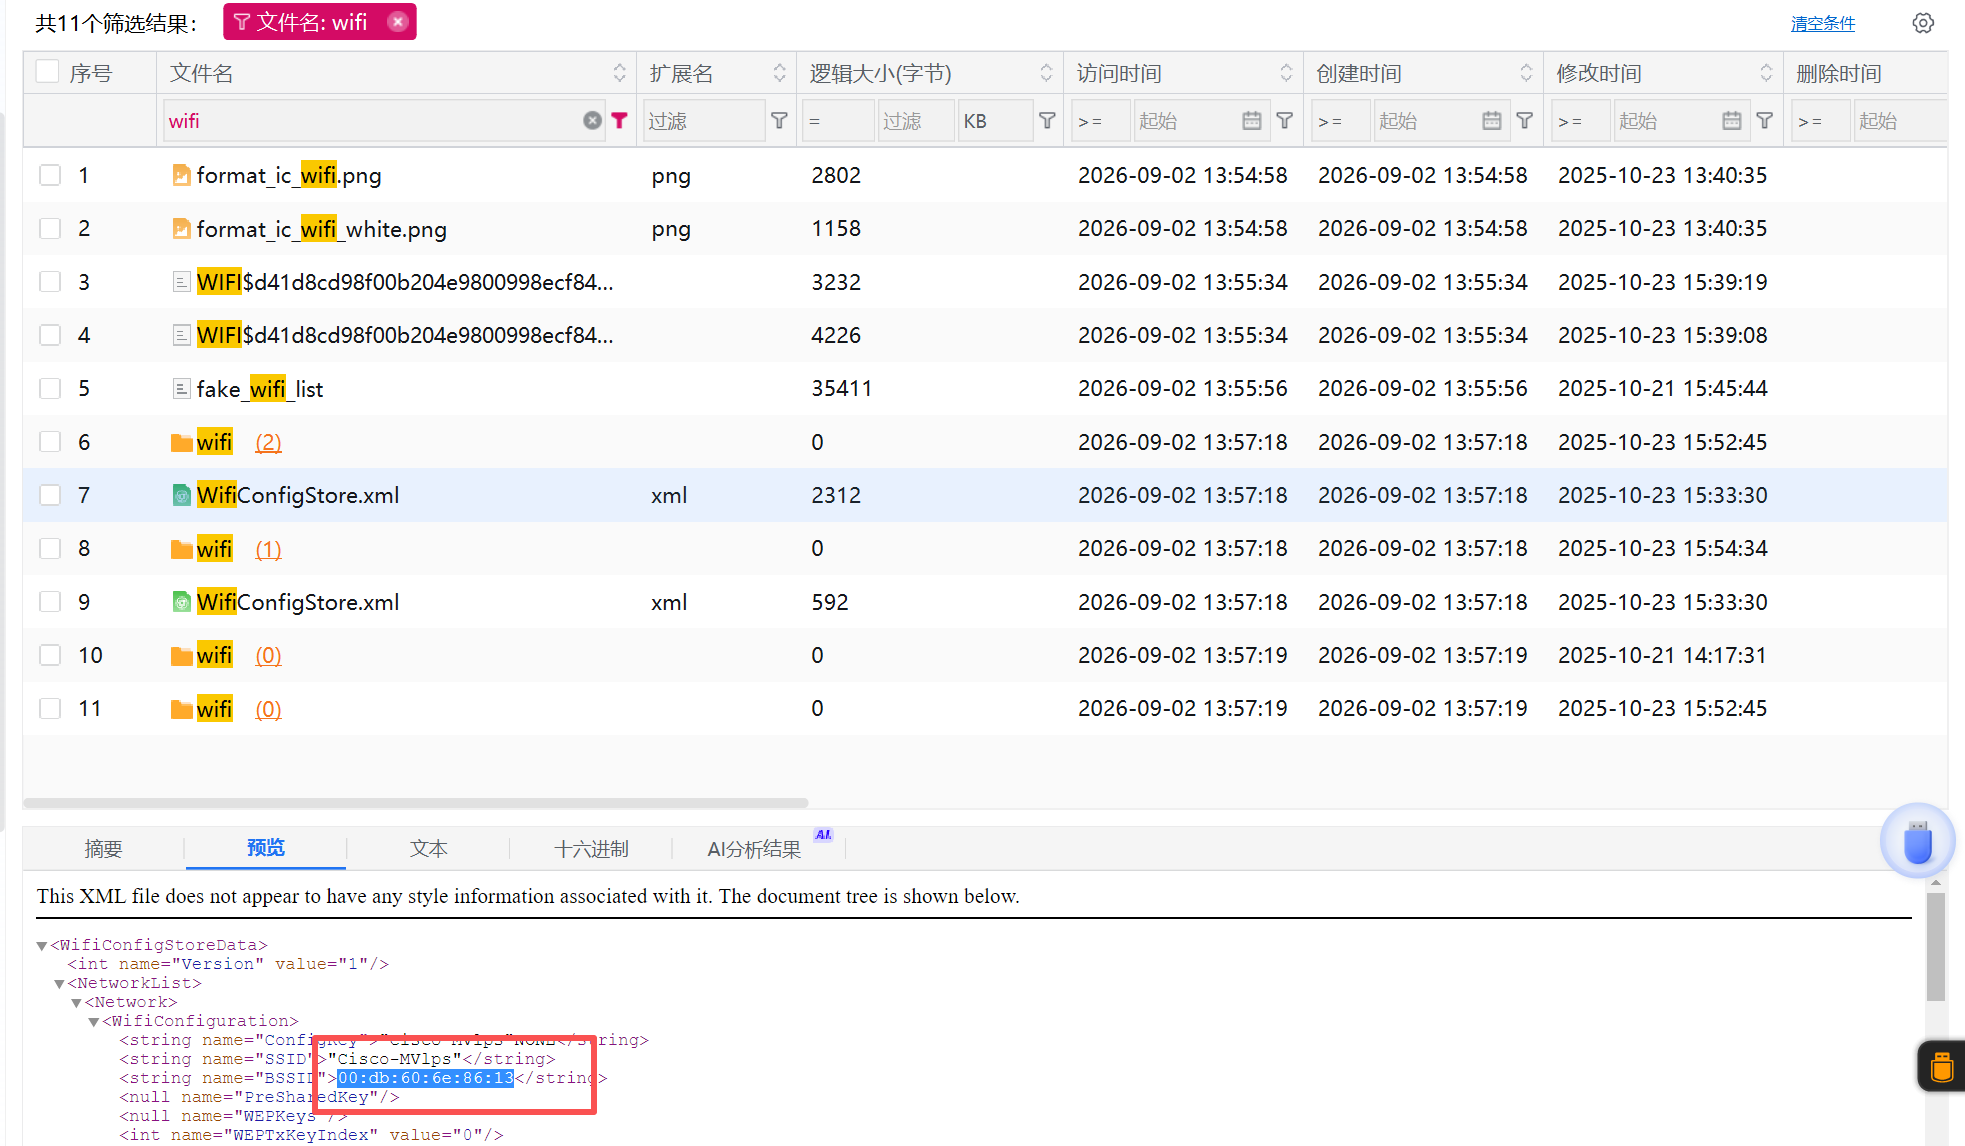
01 分析手机镜像,请问机身的 Wi-Fi 信号源的物理地址是什么?
00:db:60:6e:86:13
搜索wifi,查看config文件
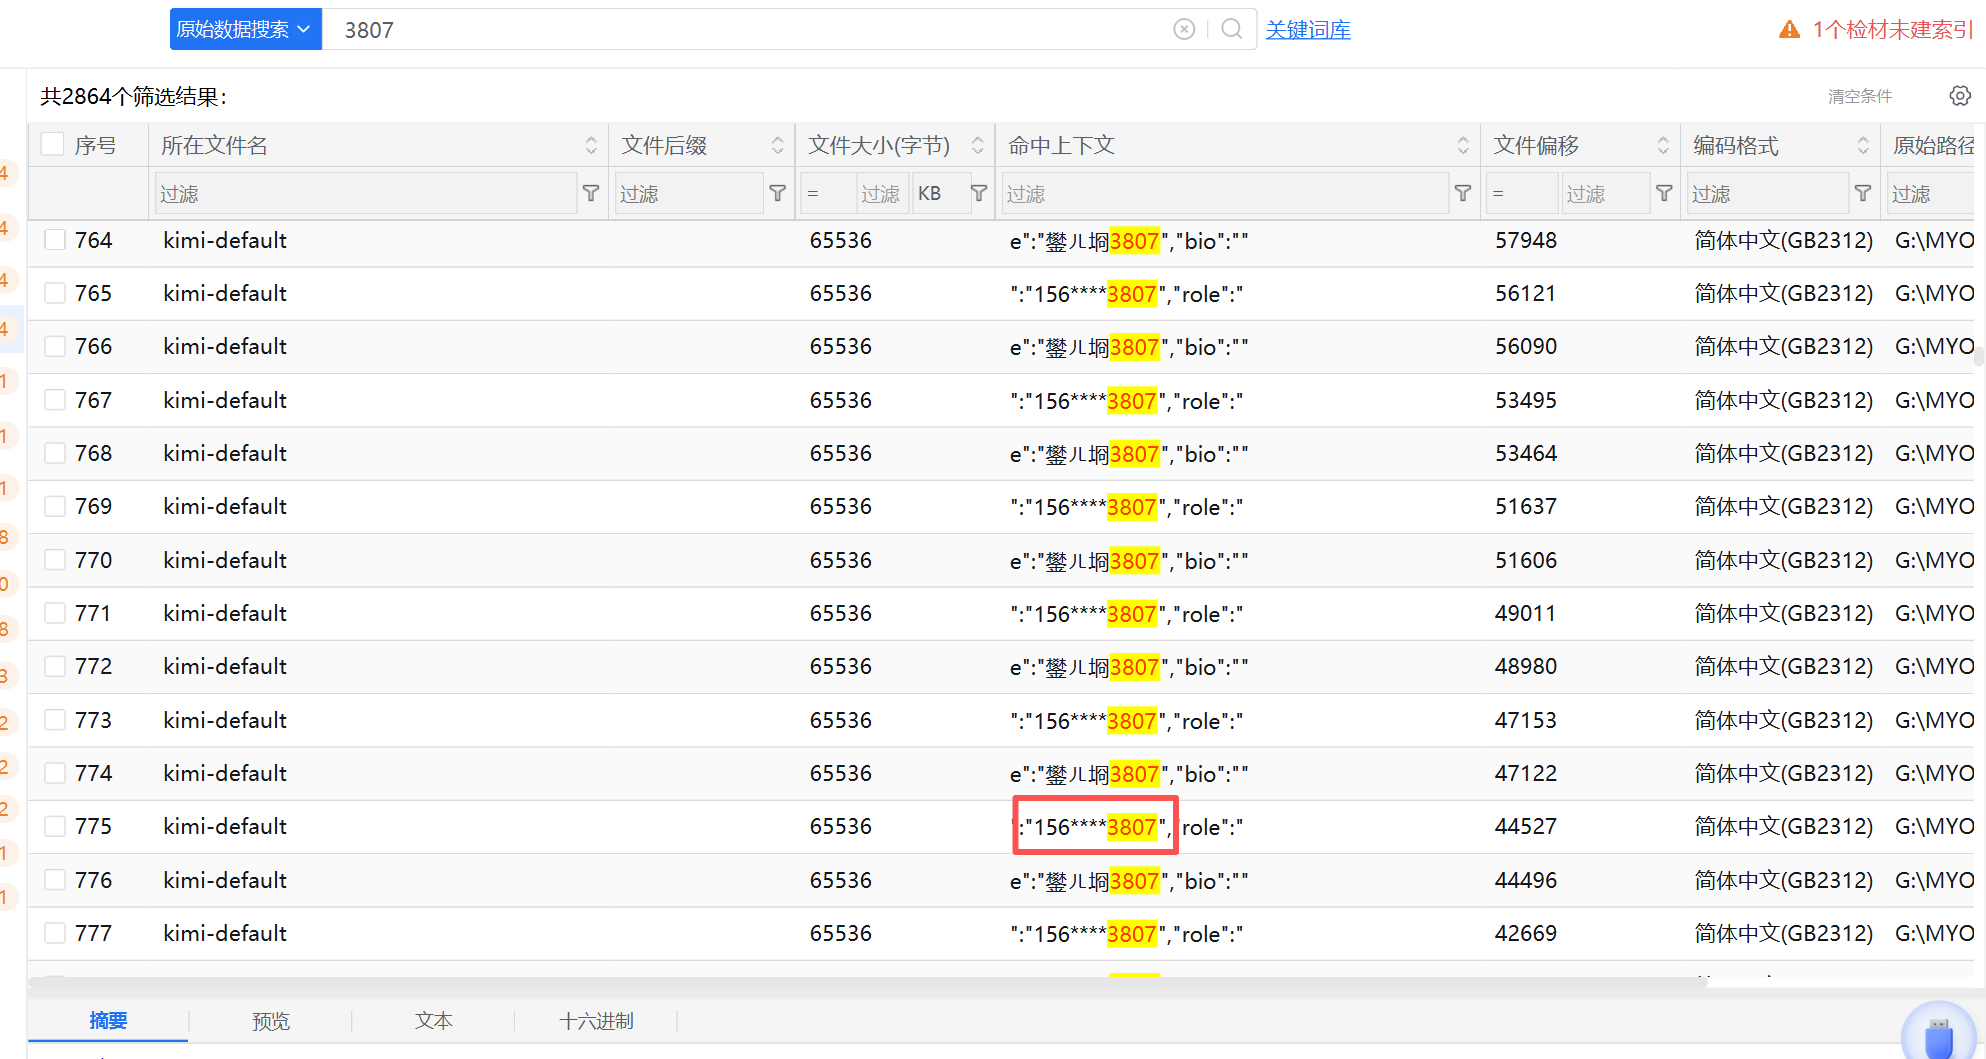
02 分析手机镜像,请问张大的手机号码尾号是 3807 的手机号码是多少?
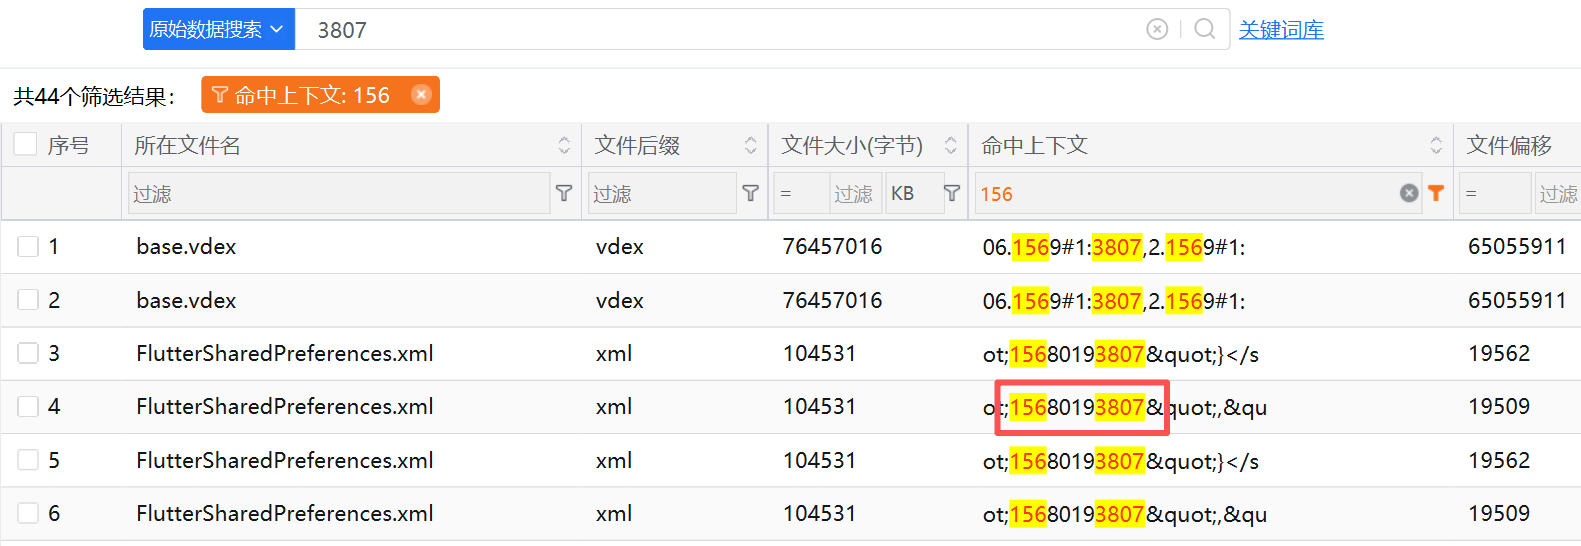
15680193807
全局搜索看到了一个156
再筛选一下156
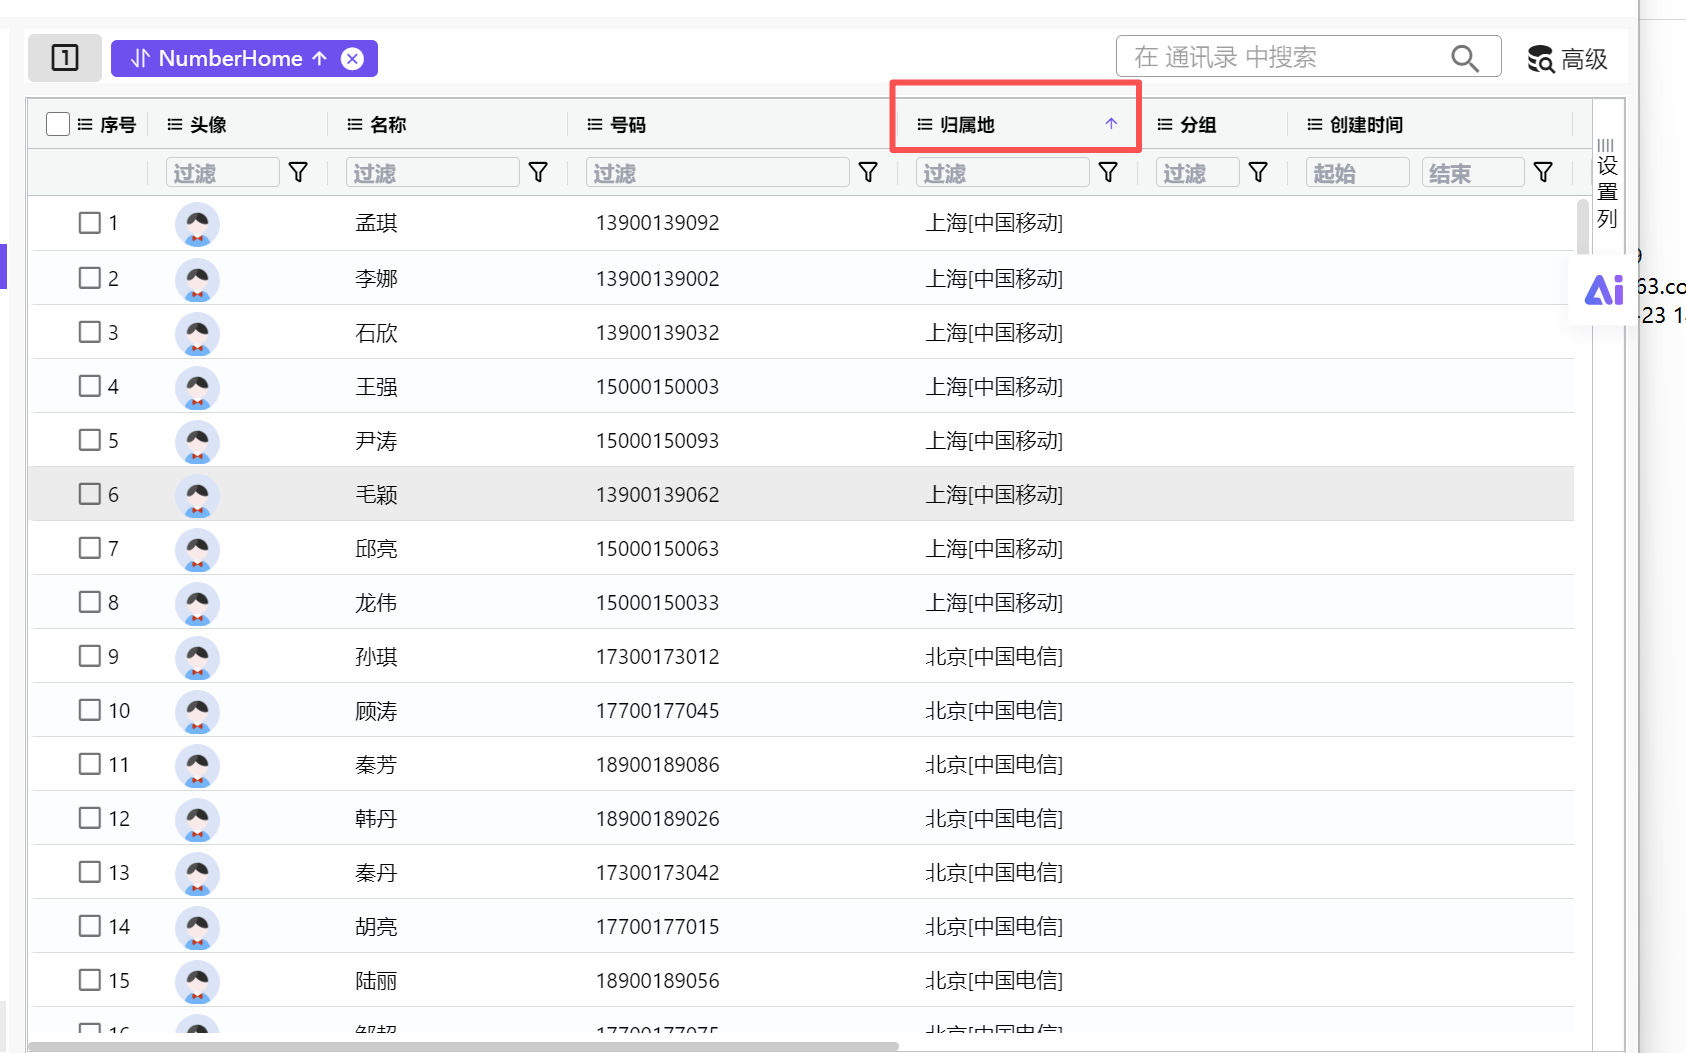
03 分析手机镜像,其通讯录中号码归属地最多的直辖市是哪里?
北京市
对归属地进行排序,数一下即可
04 分析手机镜像,嫌疑人最近卸载过的一款小说 APP 的名字是什么?
七猫免费小说
在浏览器历史中看到曾经安装过小黄鸟抓包
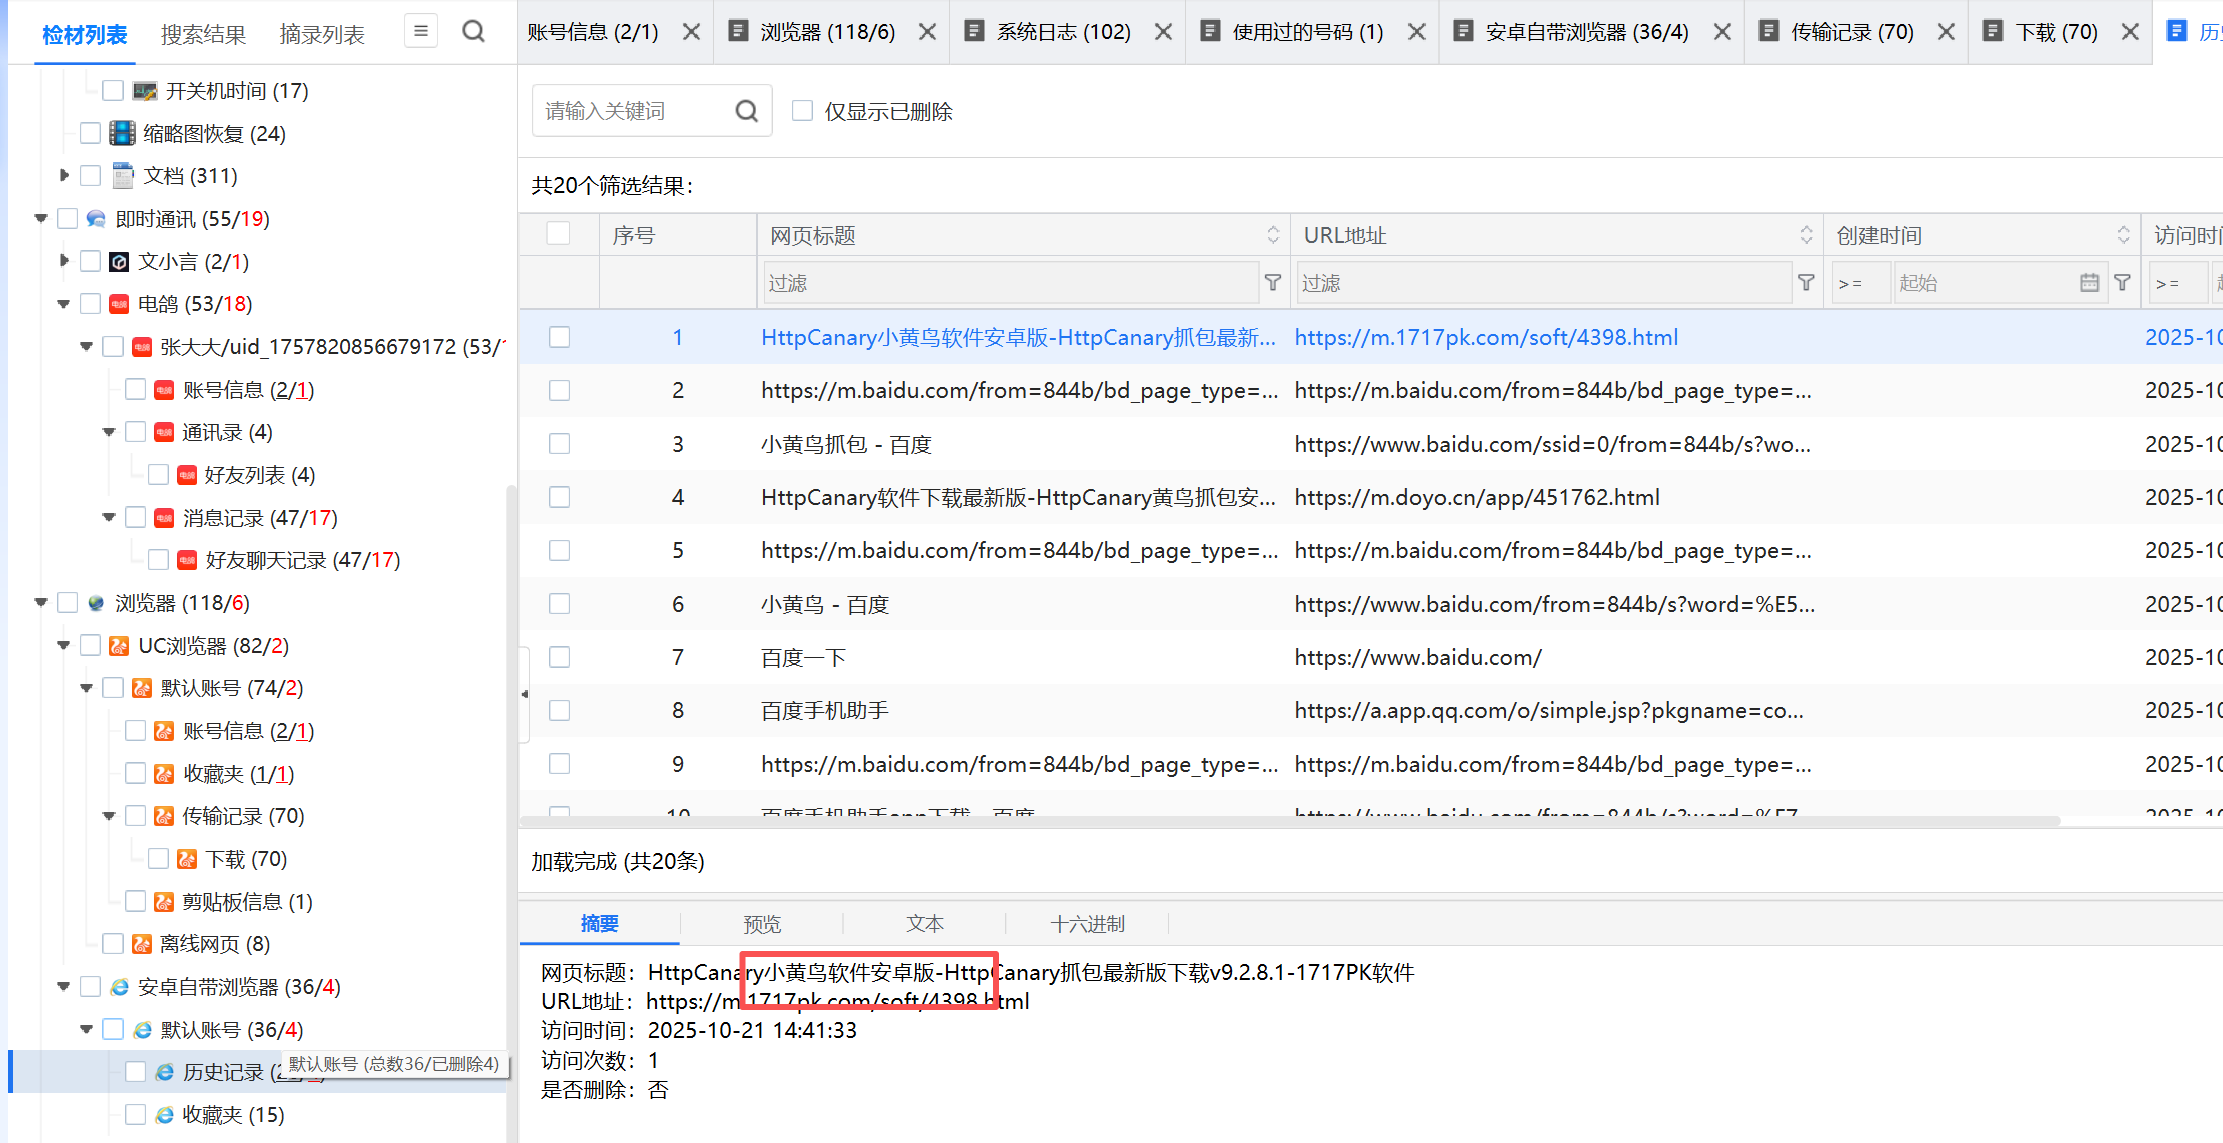
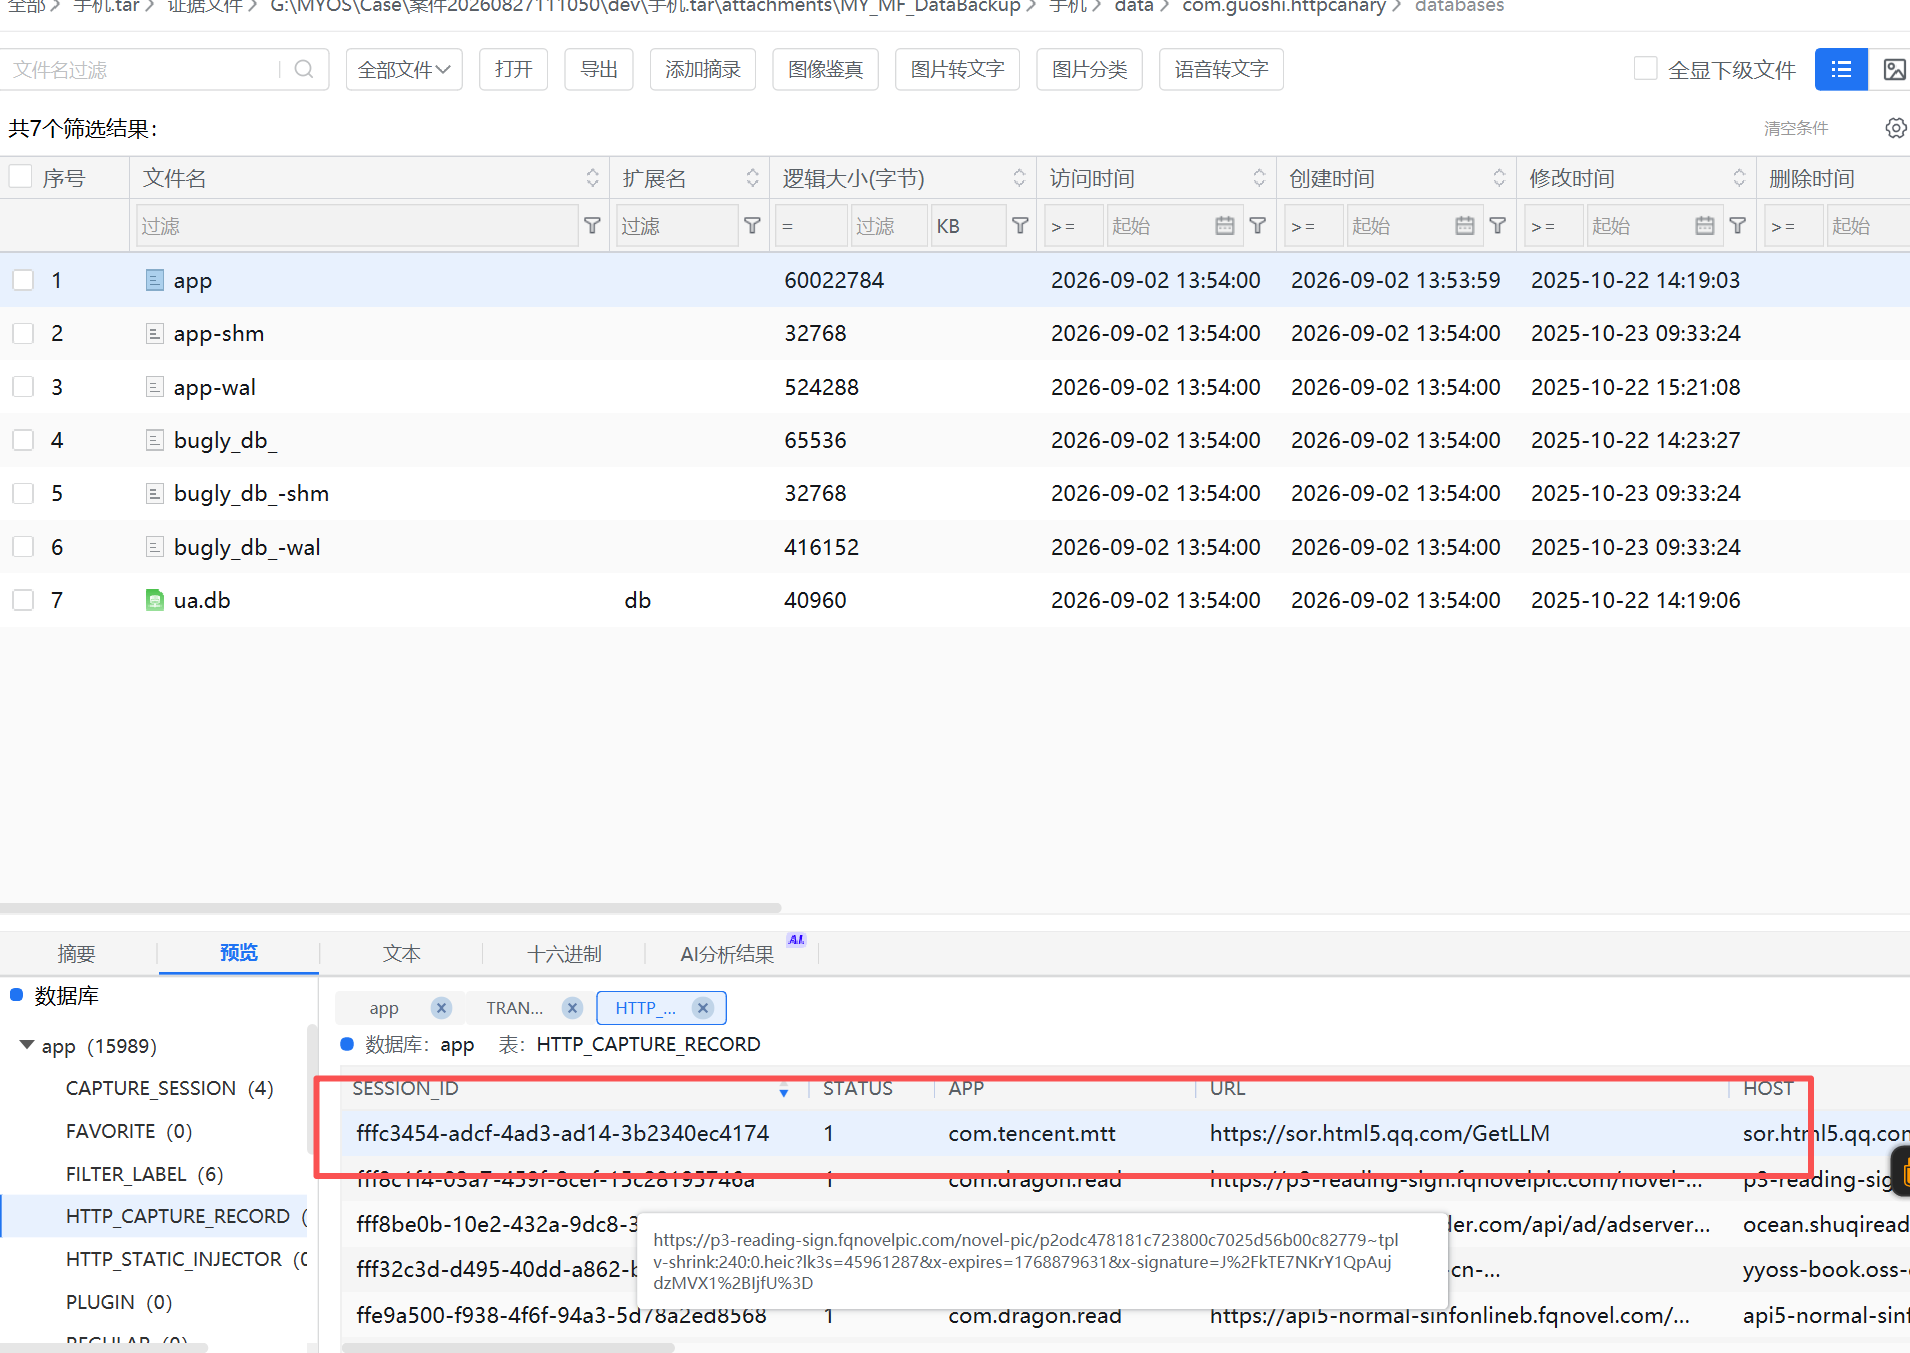
查看一下小黄鸟的目录文件,在app的这个数据库中看到好多软件抓包记录
打开数据库看一下,几千条数据,过滤一下系统打包安装程序的包名com.android.packageinstaller(这里可以还原一下软件数据,直接在模拟器打开方便一点)
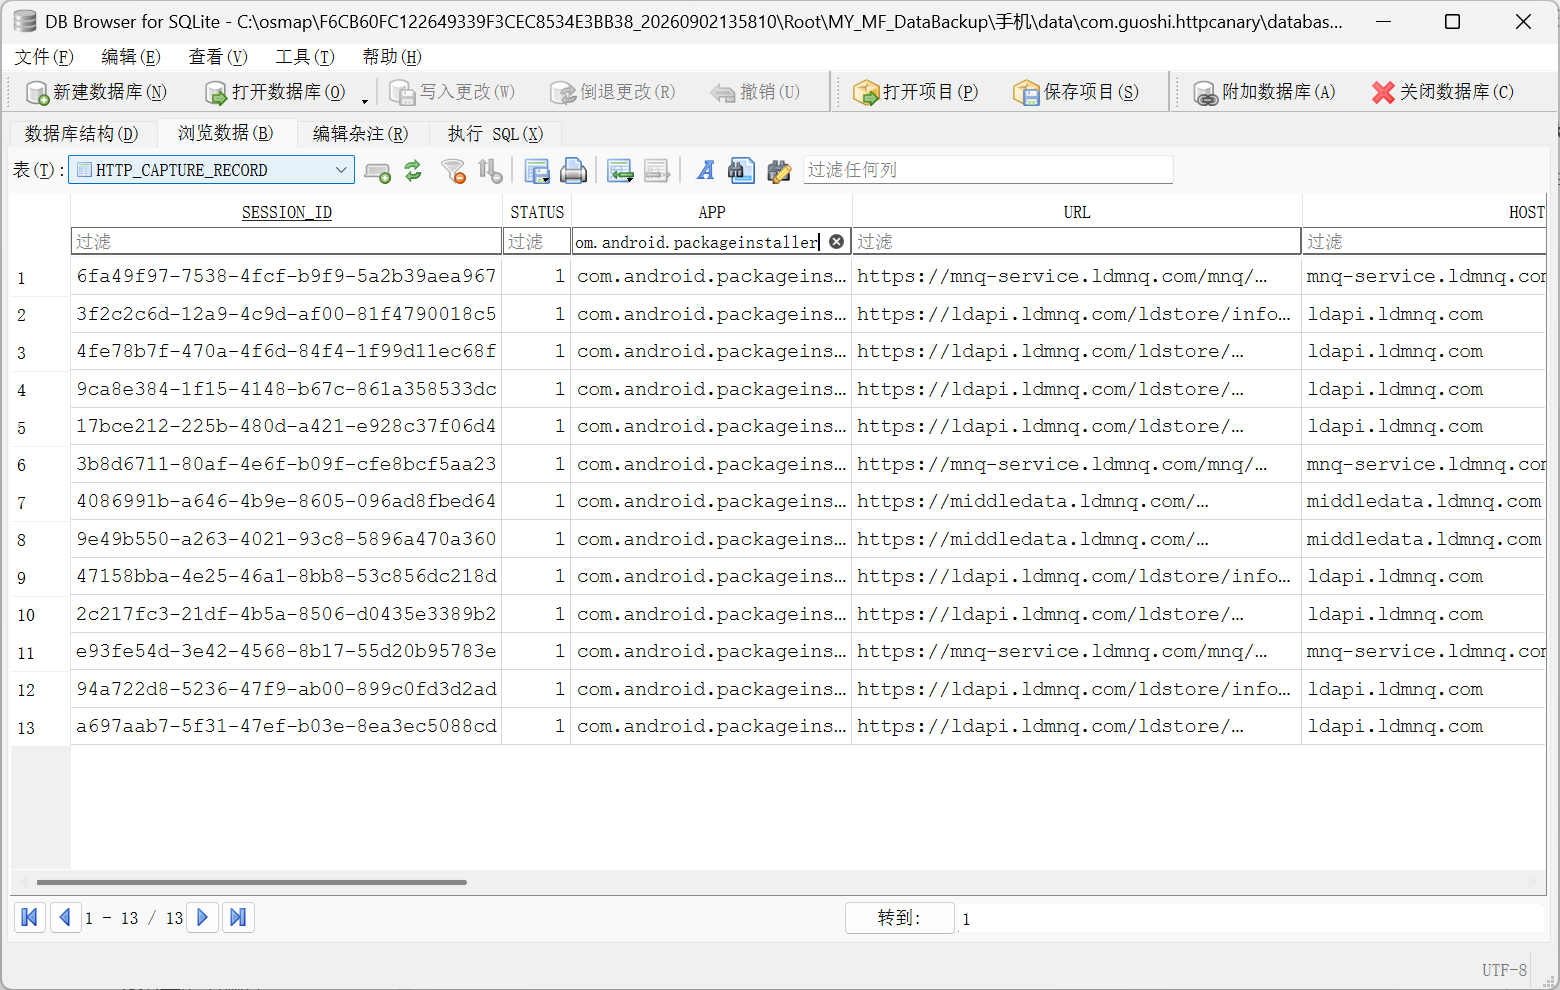
看到一个七猫免费小说,在手机上没有任何信息
05 分析手机镜像,嫌疑人使用“逐浪小说”应用最近一次搜索小说书名叫什么?
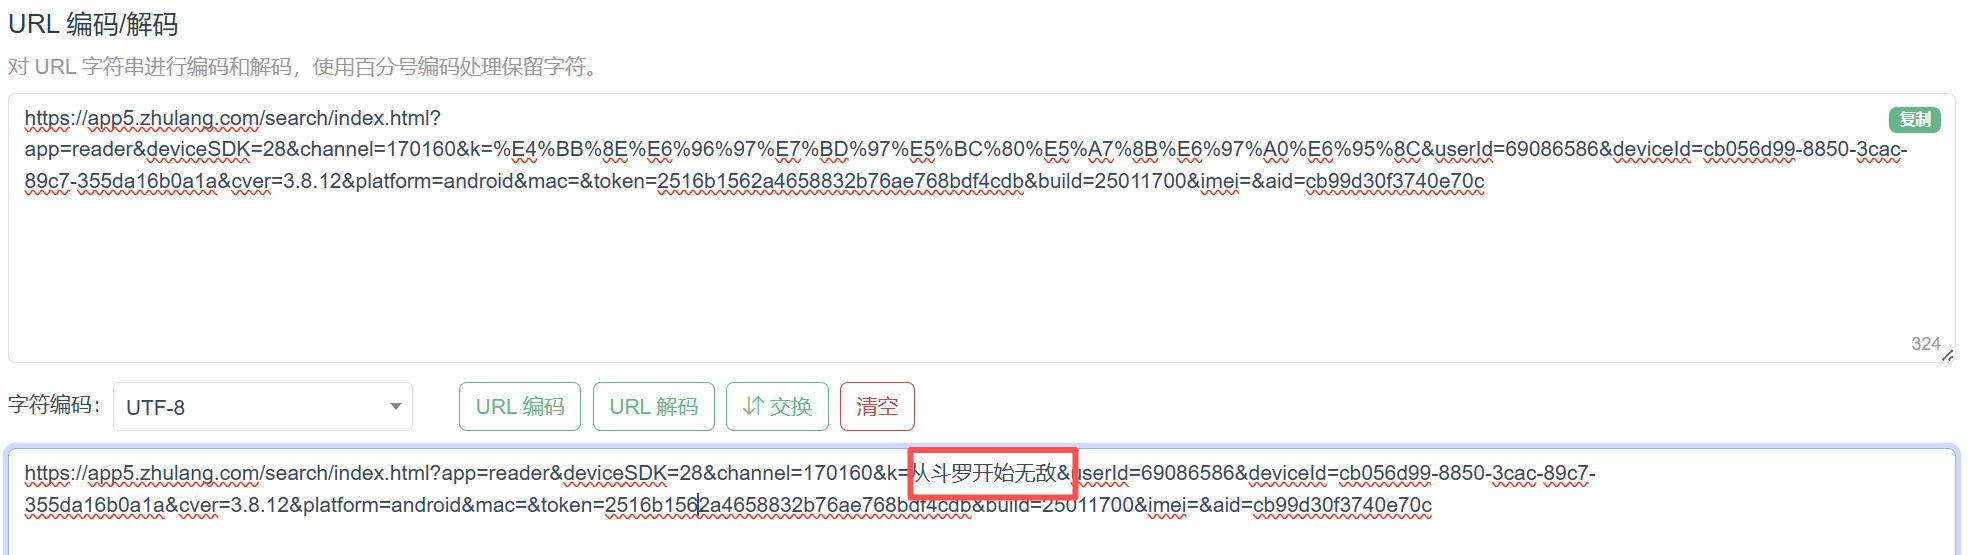
从斗罗开始无敌
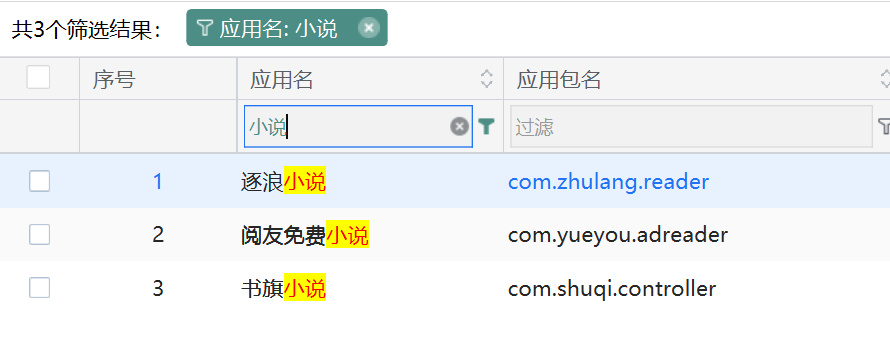
先查找逐浪小说的包名
直接去分析目录文件
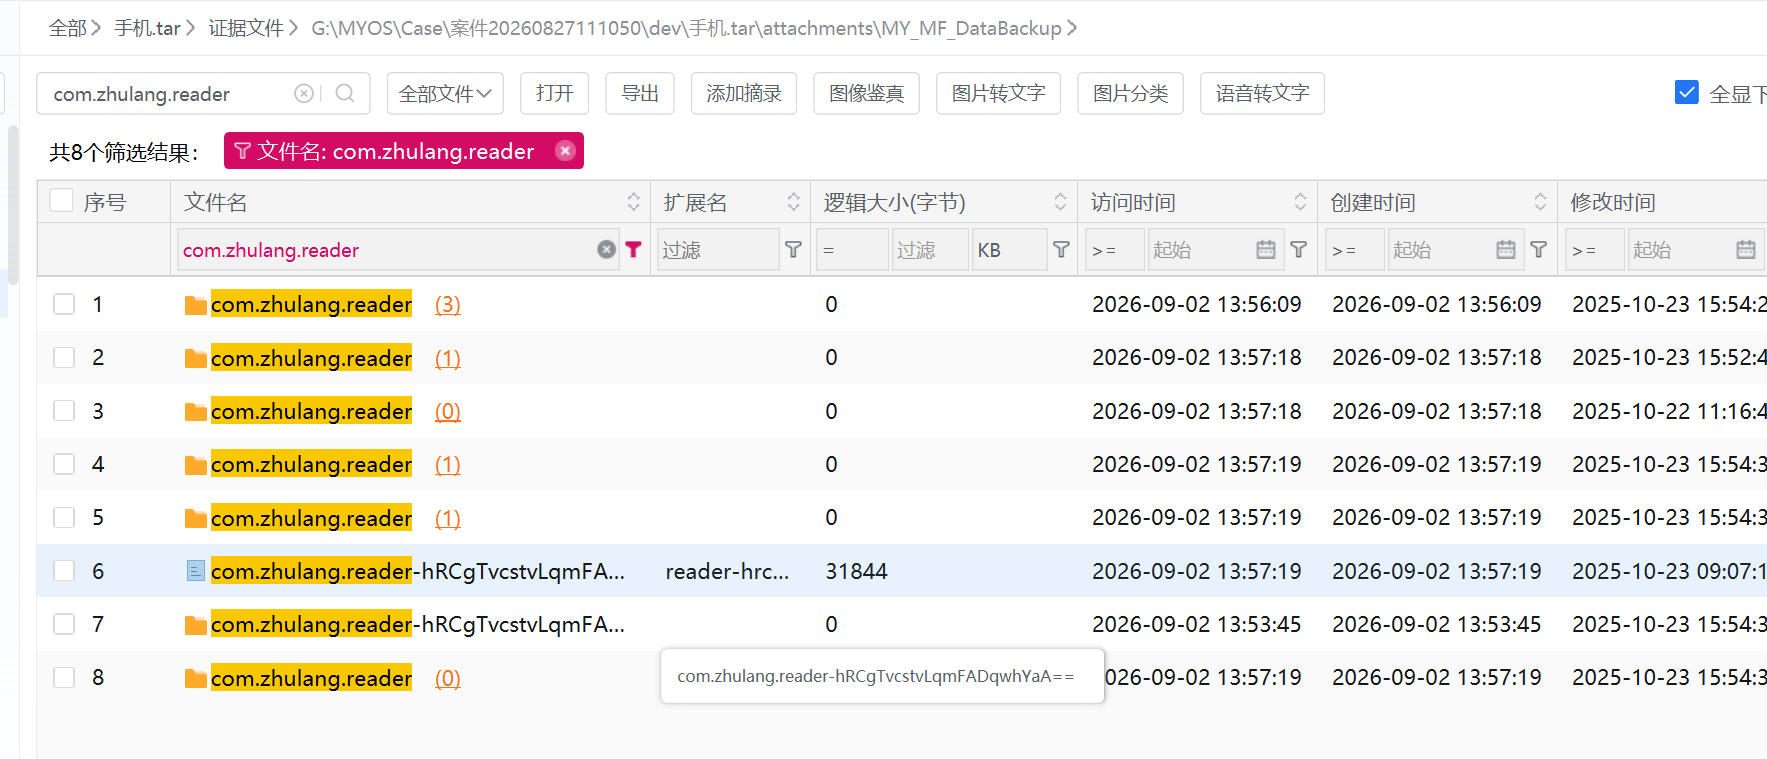
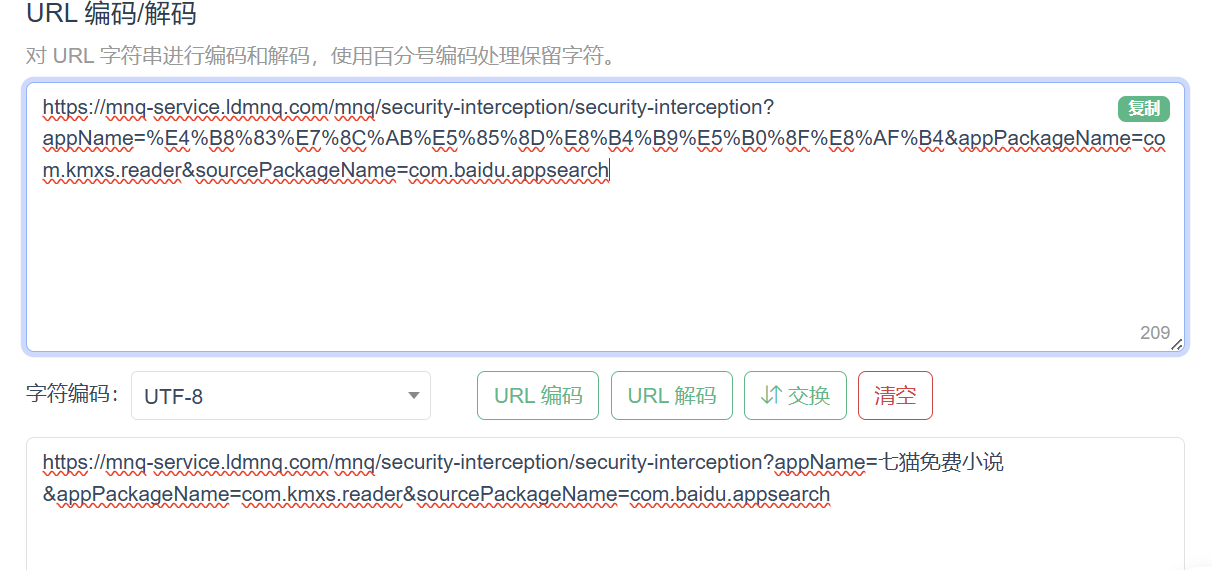
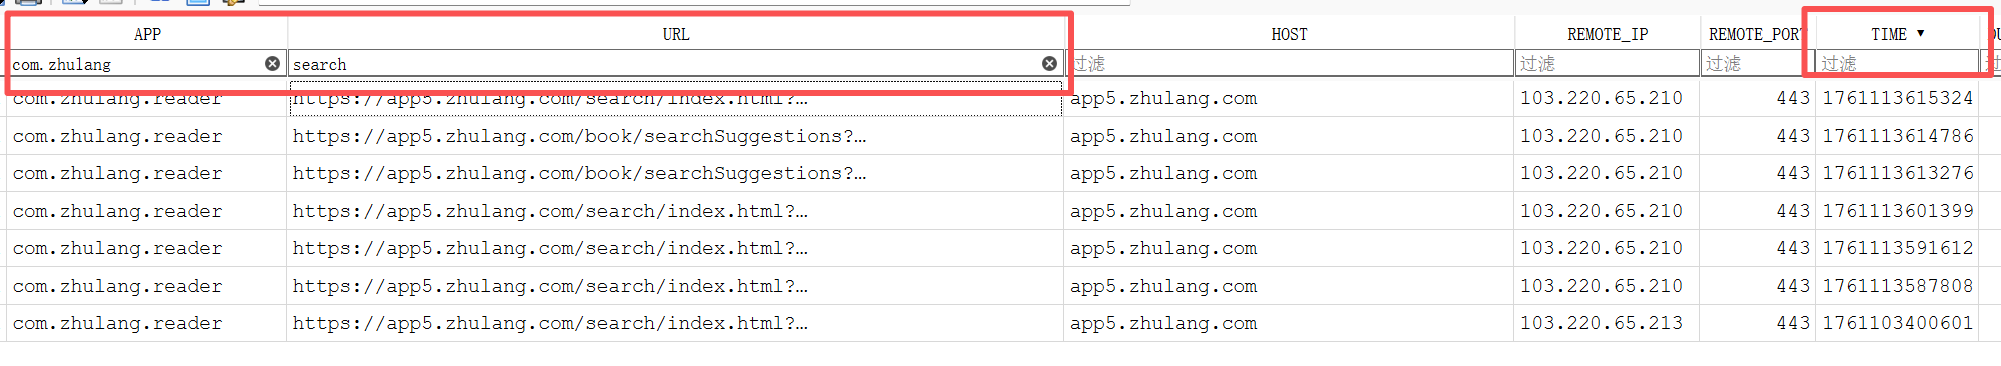
发现什么都没有,那在抓包软件数据库再看看,直接过滤app,search,筛选时间
url解码得到
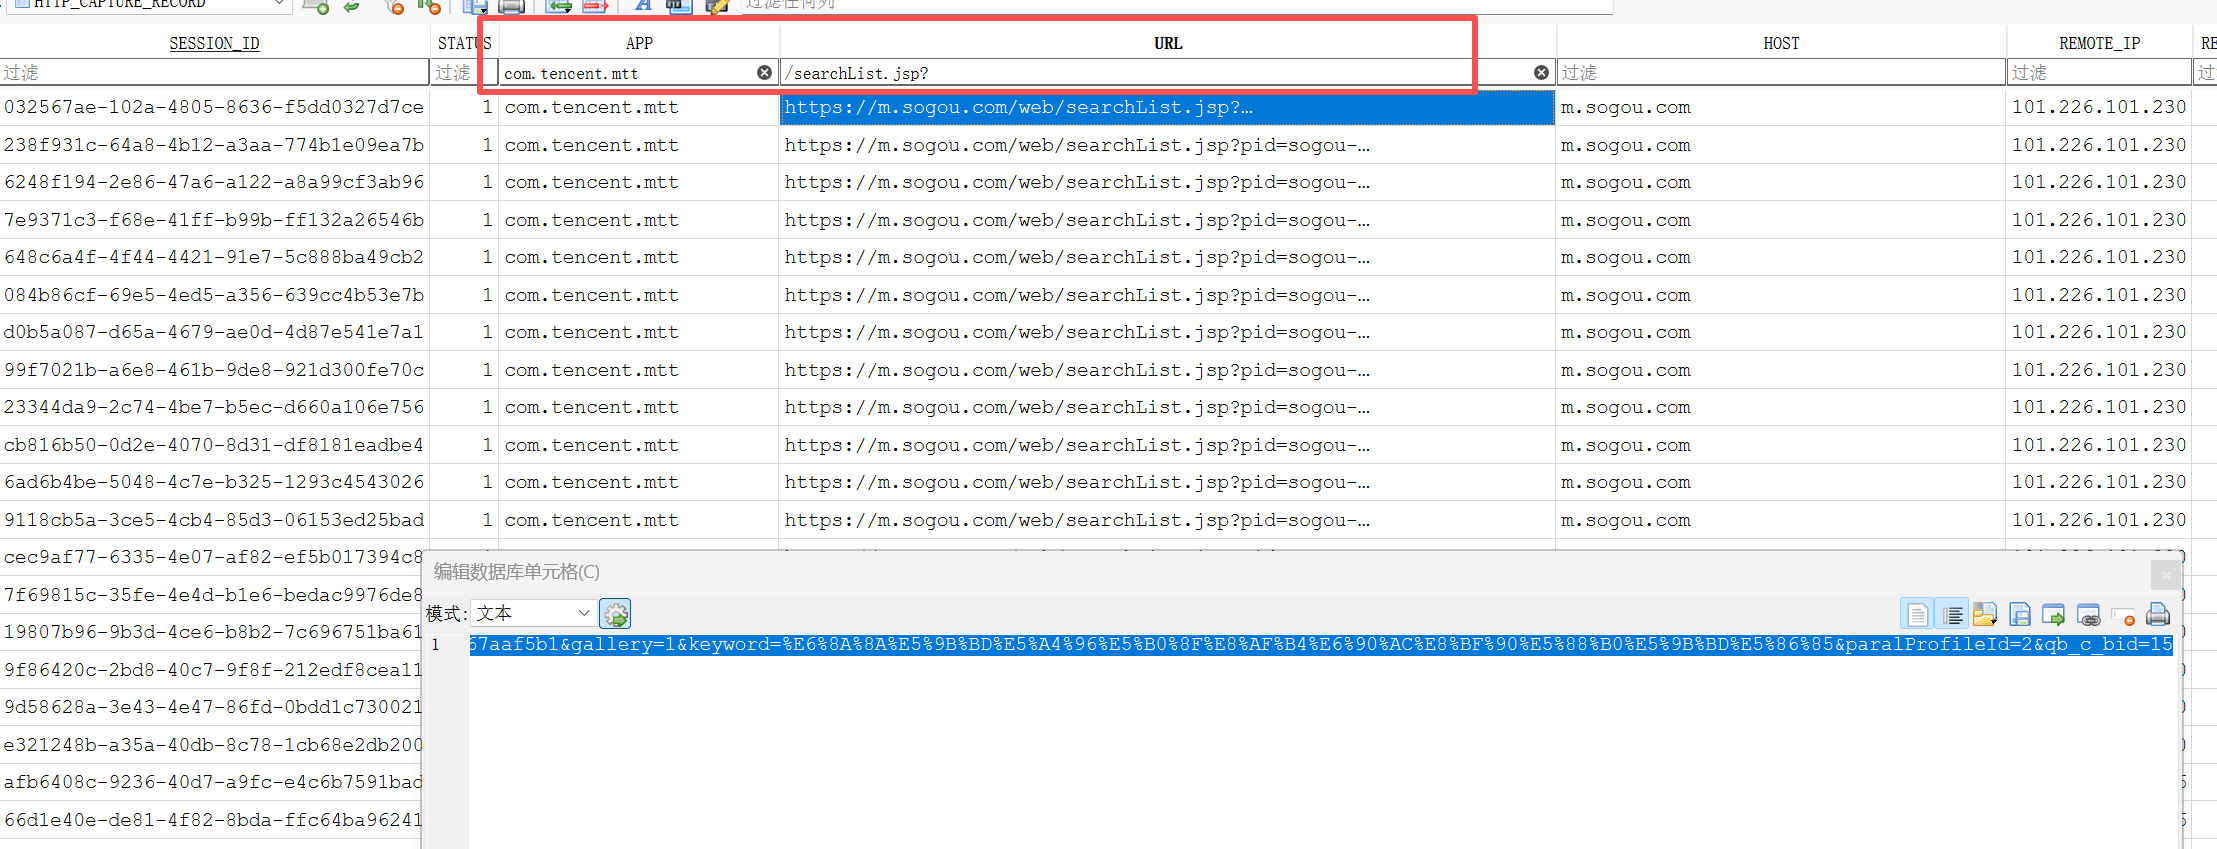
06 分析手机镜像,嫌疑人曾使用“QQ浏览器”使用过的搜索关键词有几个?
27个
继续筛选,然后统计一下关键词,不算重复的27个
07 分析手机镜像,嫌疑人曾经安装过的一款 AI 软件登录的用户名是什么?
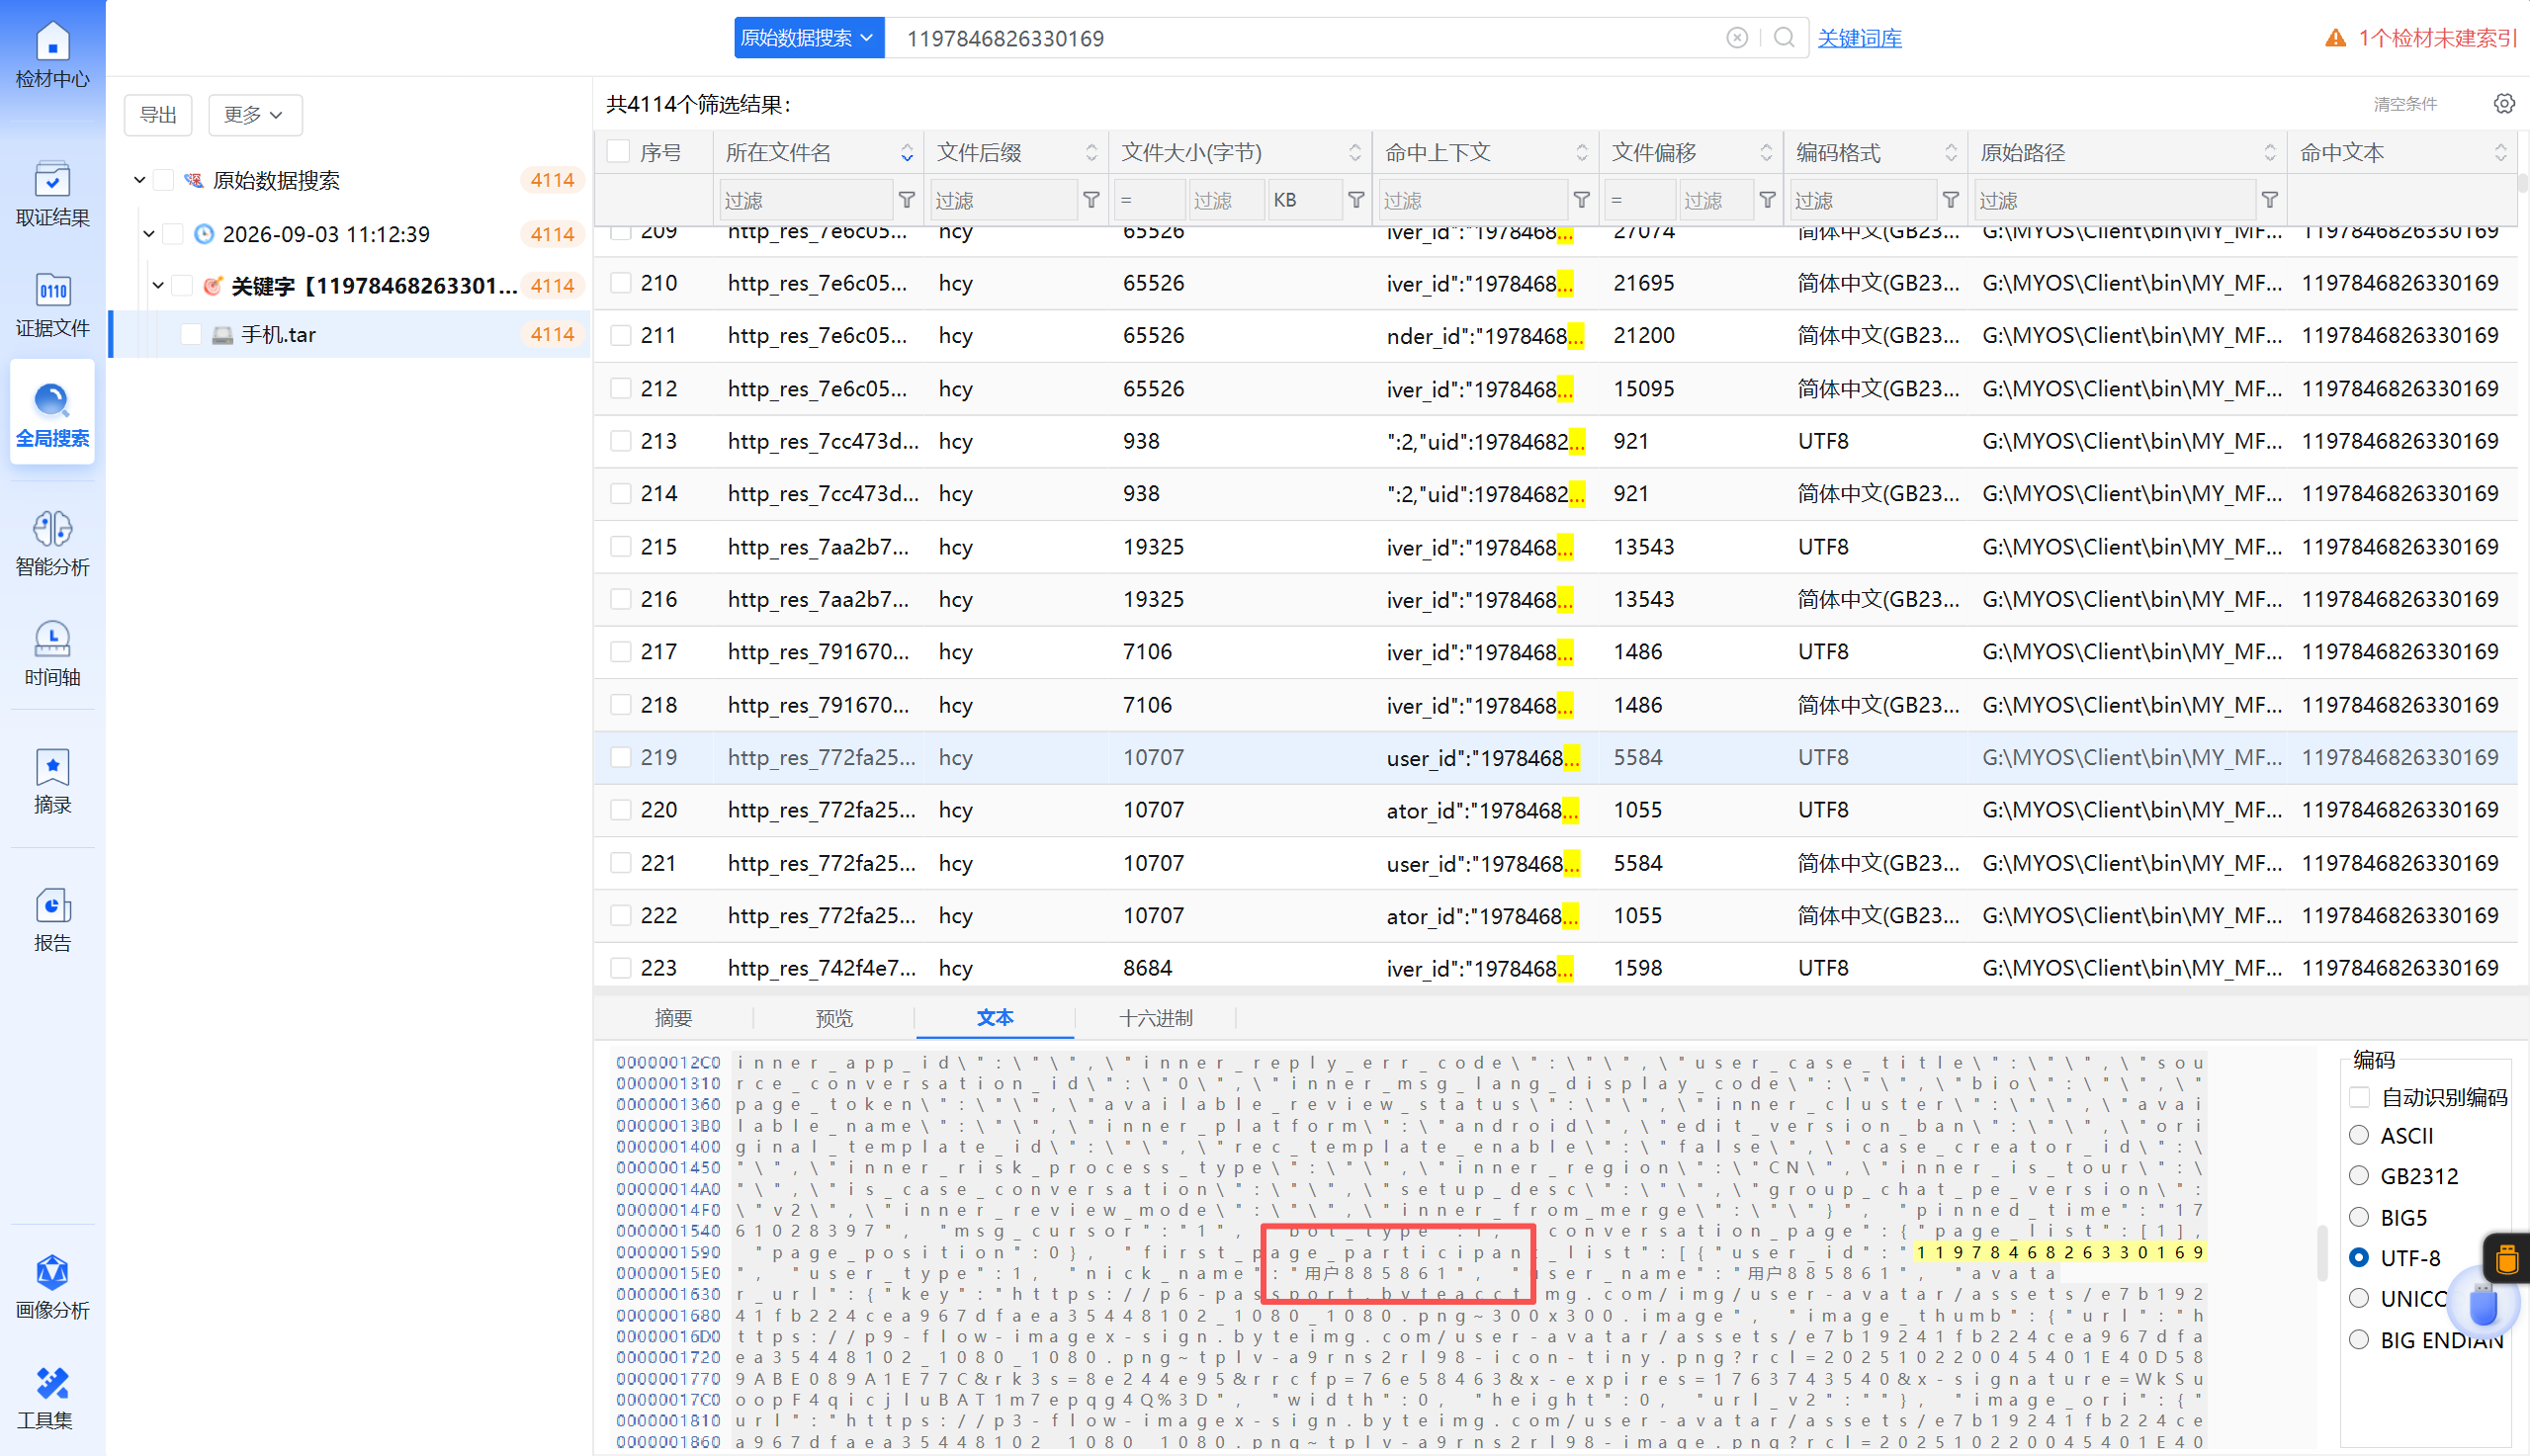
用户885861
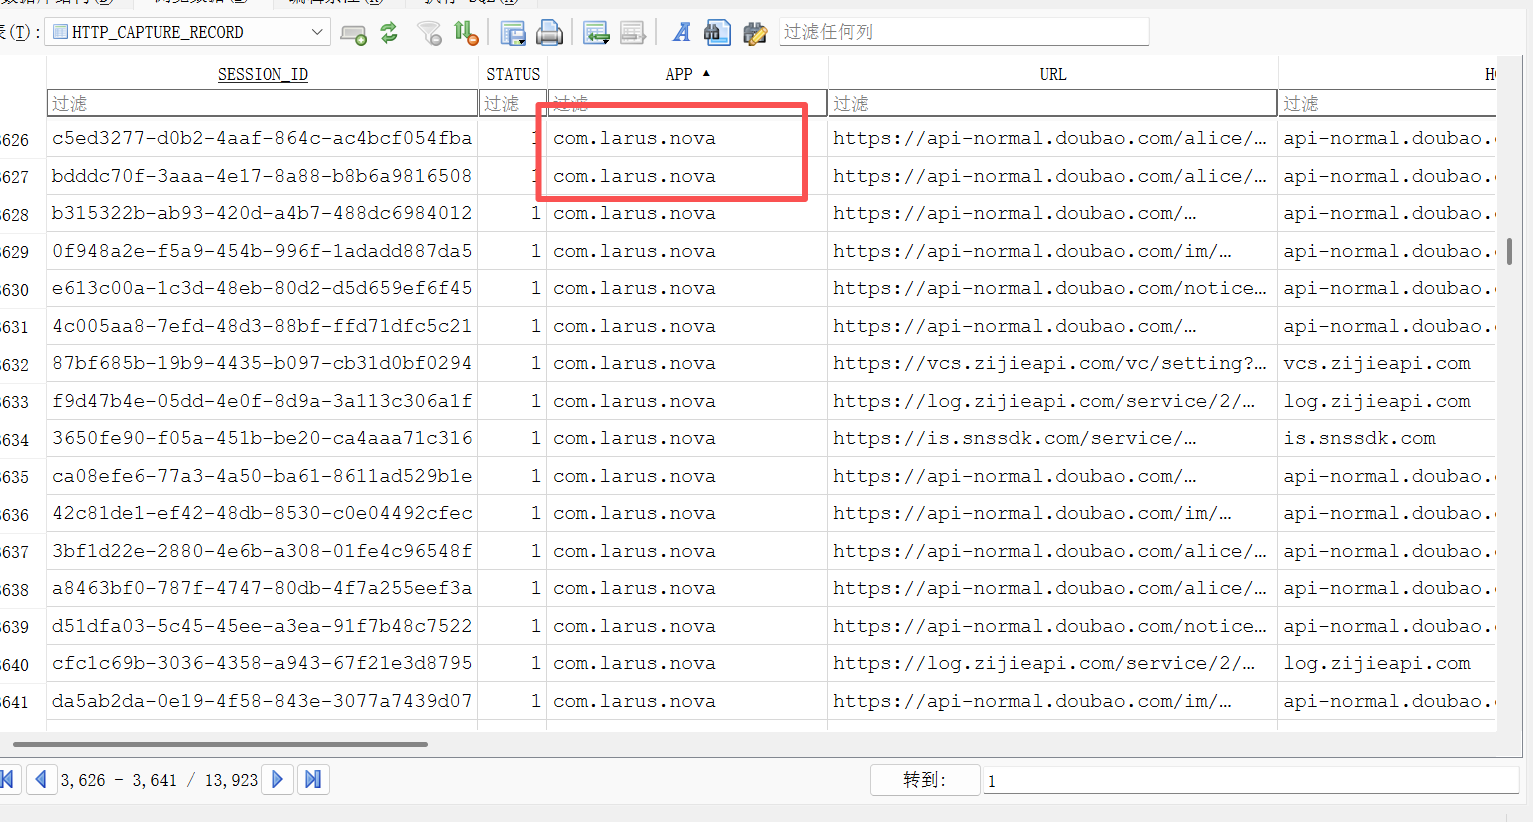
这道题说的曾经安装,说明现在已经删除了,我们继续在这个小黄鸟的数据库找,既然是ai软件,那就对app进行名称排序看一下,看到个豆包
过滤一下,找到一个uid1197846826330169,暴搜一下吧,找到用户名
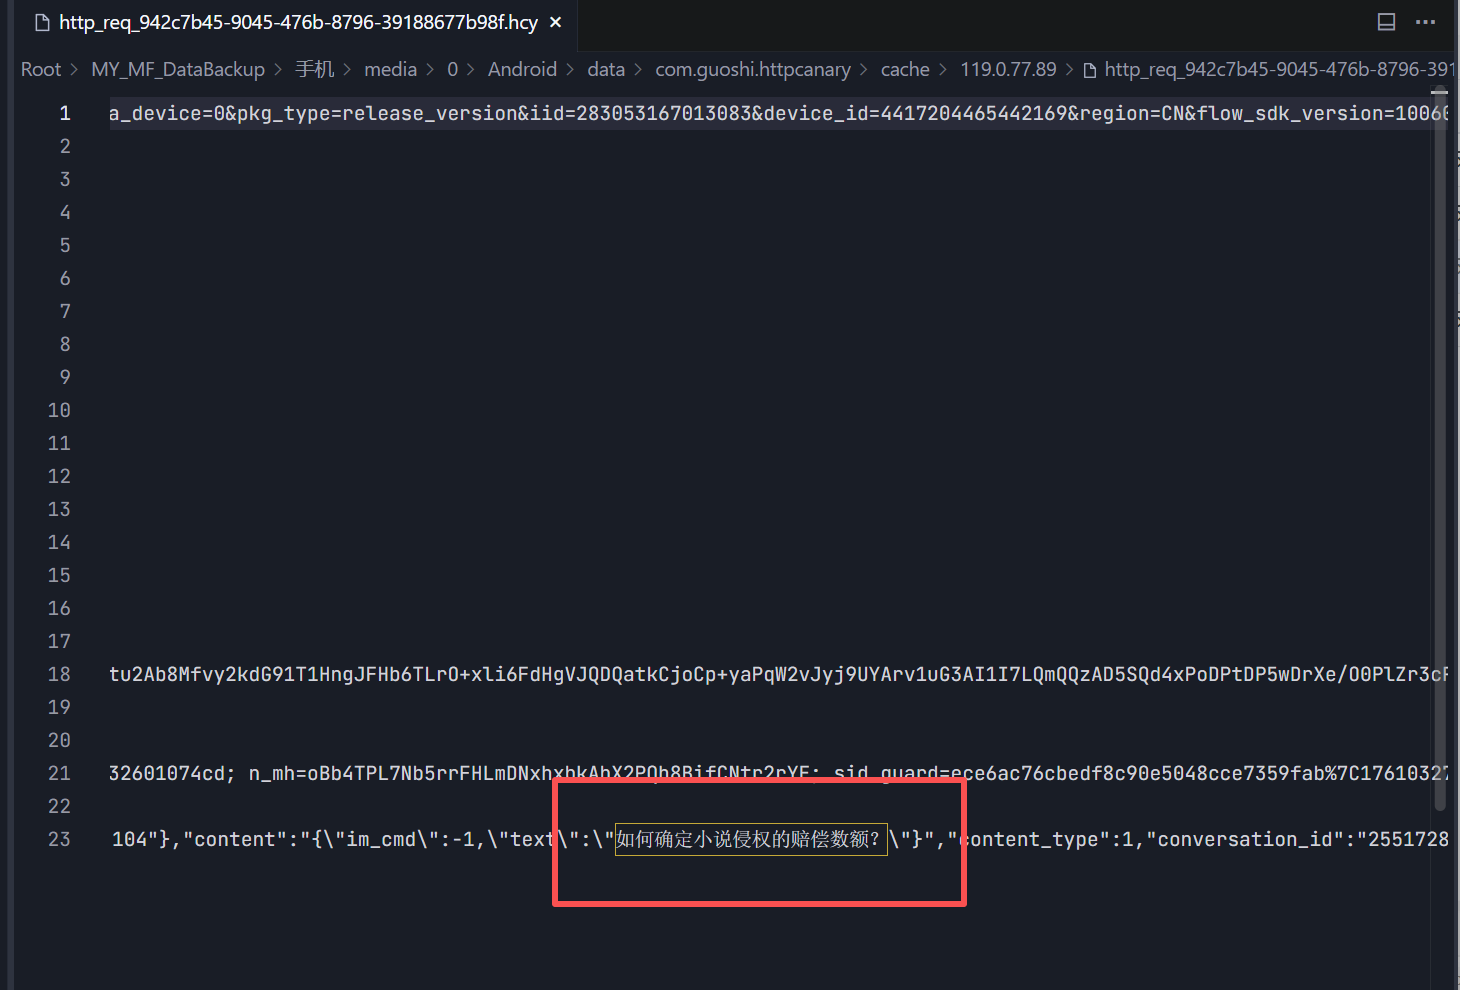
08 接上问,嫌疑人在此 AI 软件中最后一次提问的内容是什么?
如何确定小说侵权的赔偿数额?
继续筛选,豆包发送的url为im/sse/send,然后时间排序
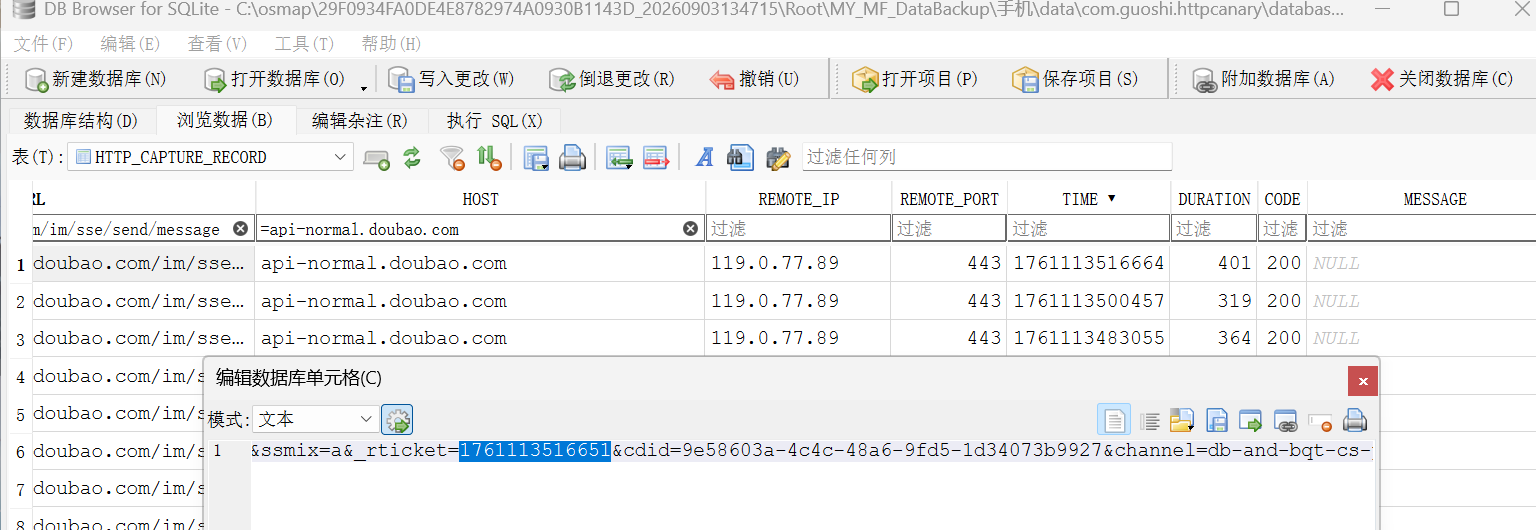
得到rticket之后直接爆搜得到返回包
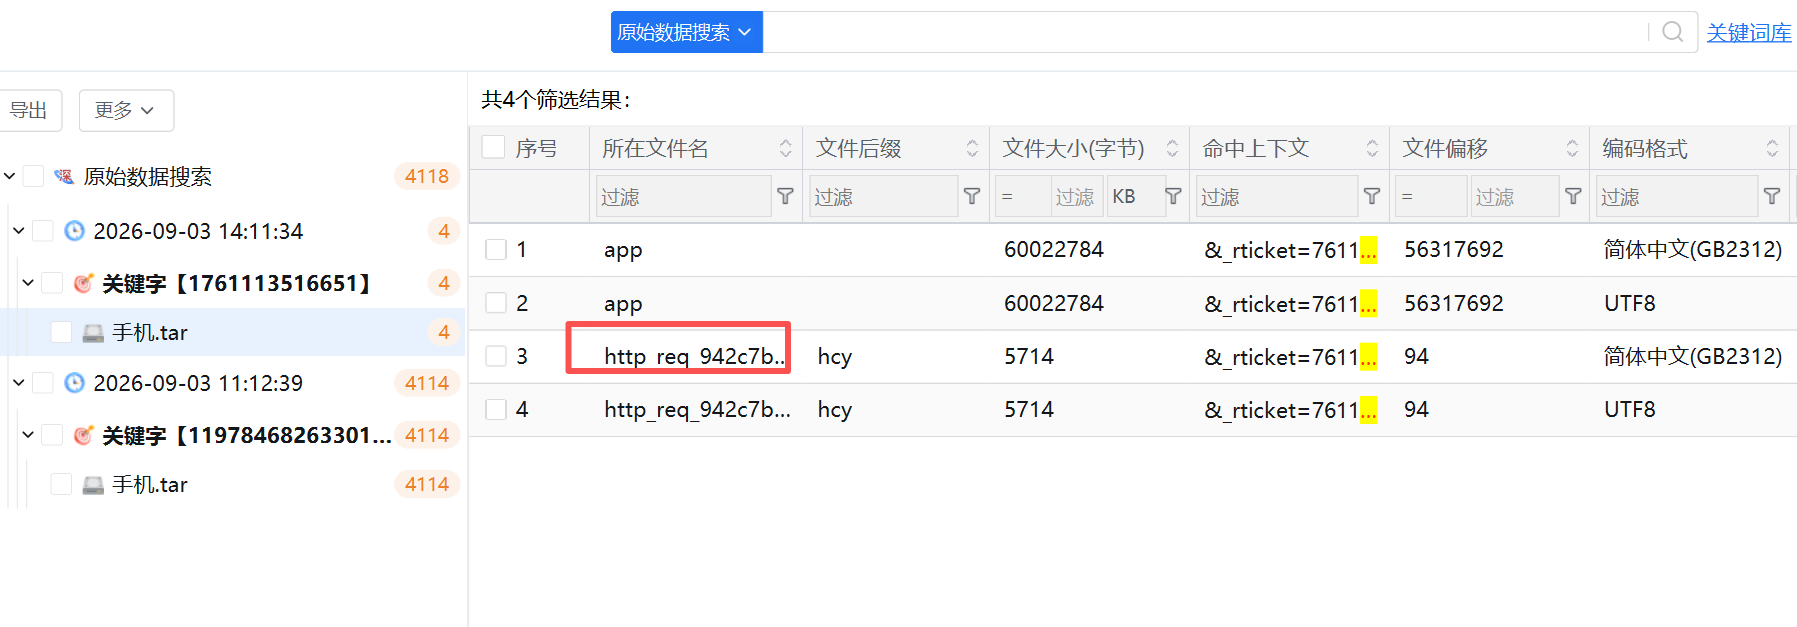
打开查看即可
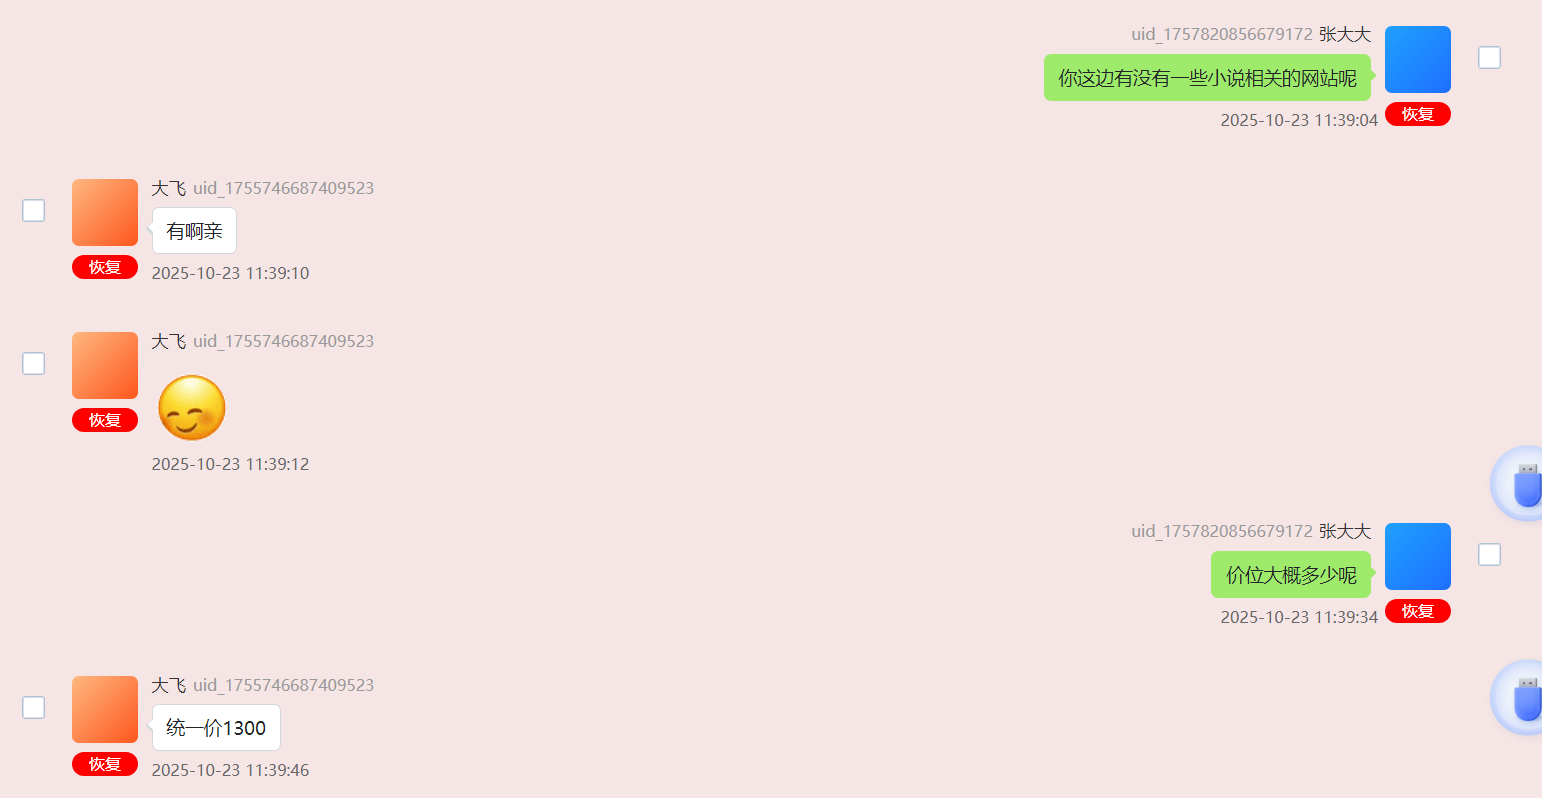
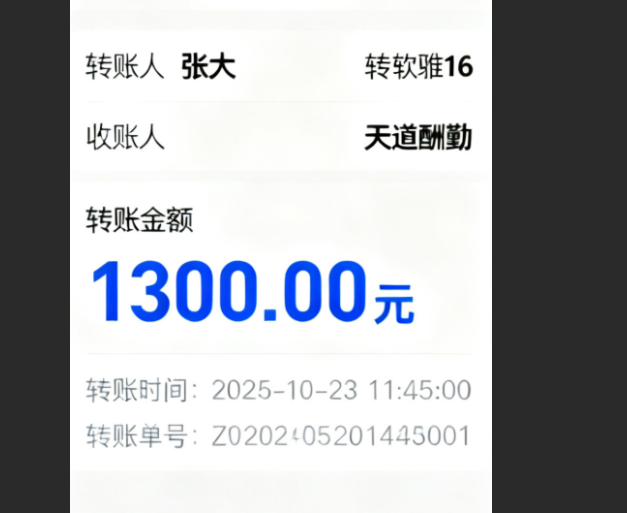
09 分析手机镜像,嫌疑人花费多少元购买小说网站源码?
1300
在电鸽上看到聊天记录
以及支付截图
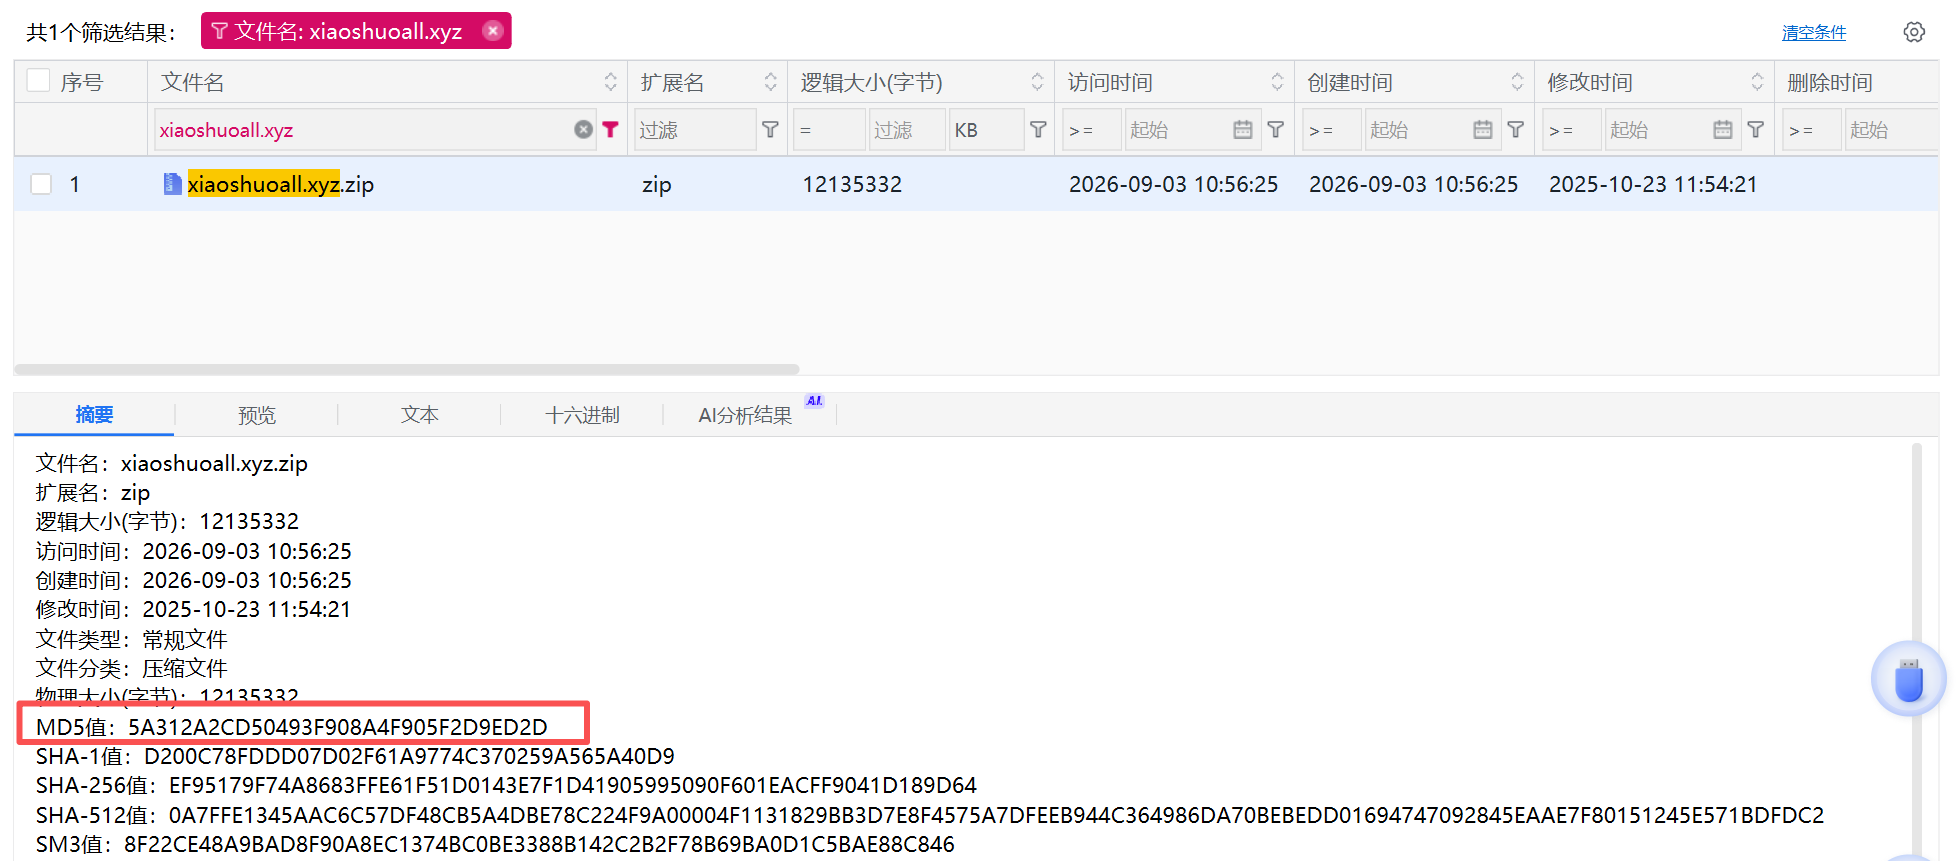
10 接上问,嫌疑人购买的小说网站源码的 MD5 值后六位是什么?
d9ed2d
在聊天记录中看到源码压缩包,直接计算哈希即可
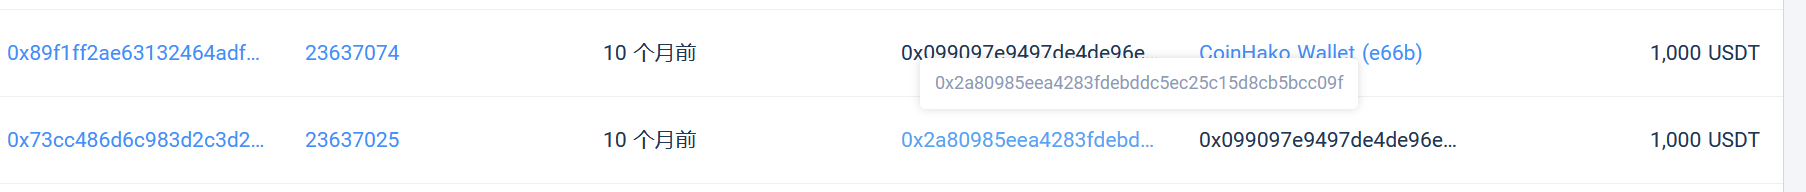
11 分析手机镜像,嫌疑人的虚拟钱包地址是什么?
0x2a80985eea4283fdebddc5ec25c15d8cb5bcc09f
在下一题我们可以知道卖家的交易地址,直接查一下交易记录
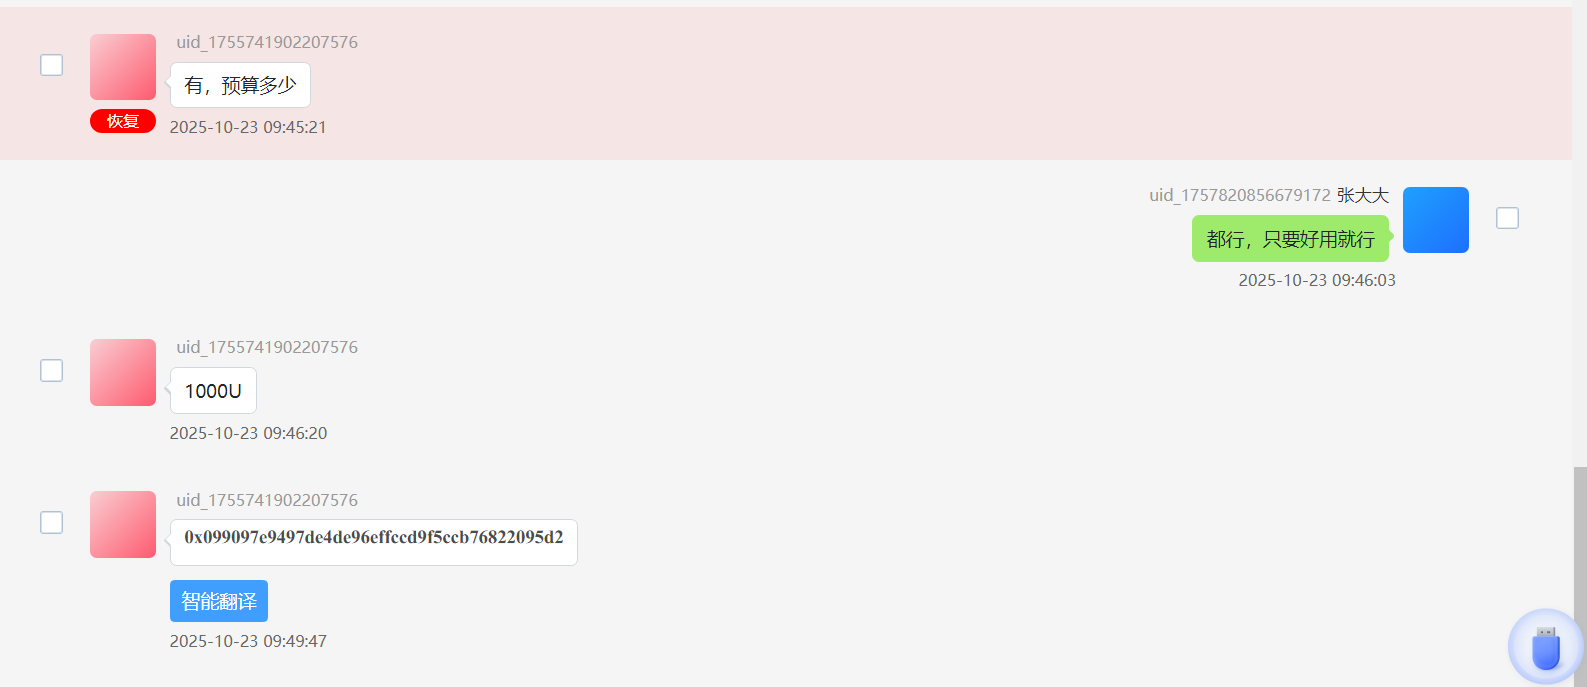
12 分析手机镜像,嫌疑人购买视频网站源码花费了多少 USDT?
1000
直接看电鸽聊天记录即可
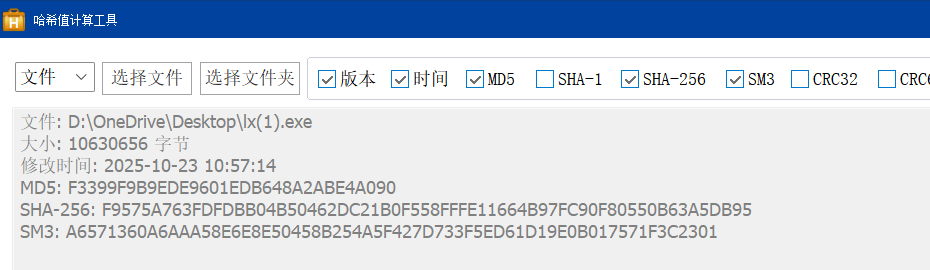
13 分析手机镜像,其接受过一个远控木马程序(exe),请问其 MD5 值后六位是多少?
e4a090
在聊天记录中可以看到这个软件,直接计算哈希即可
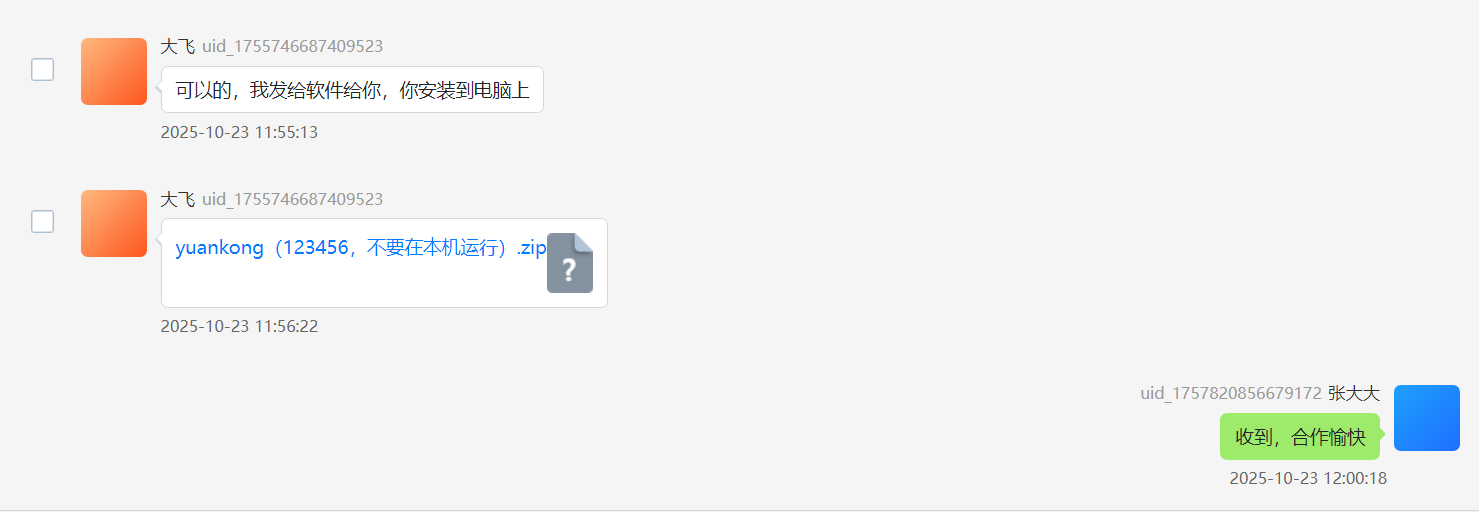
导出解压计算哈希
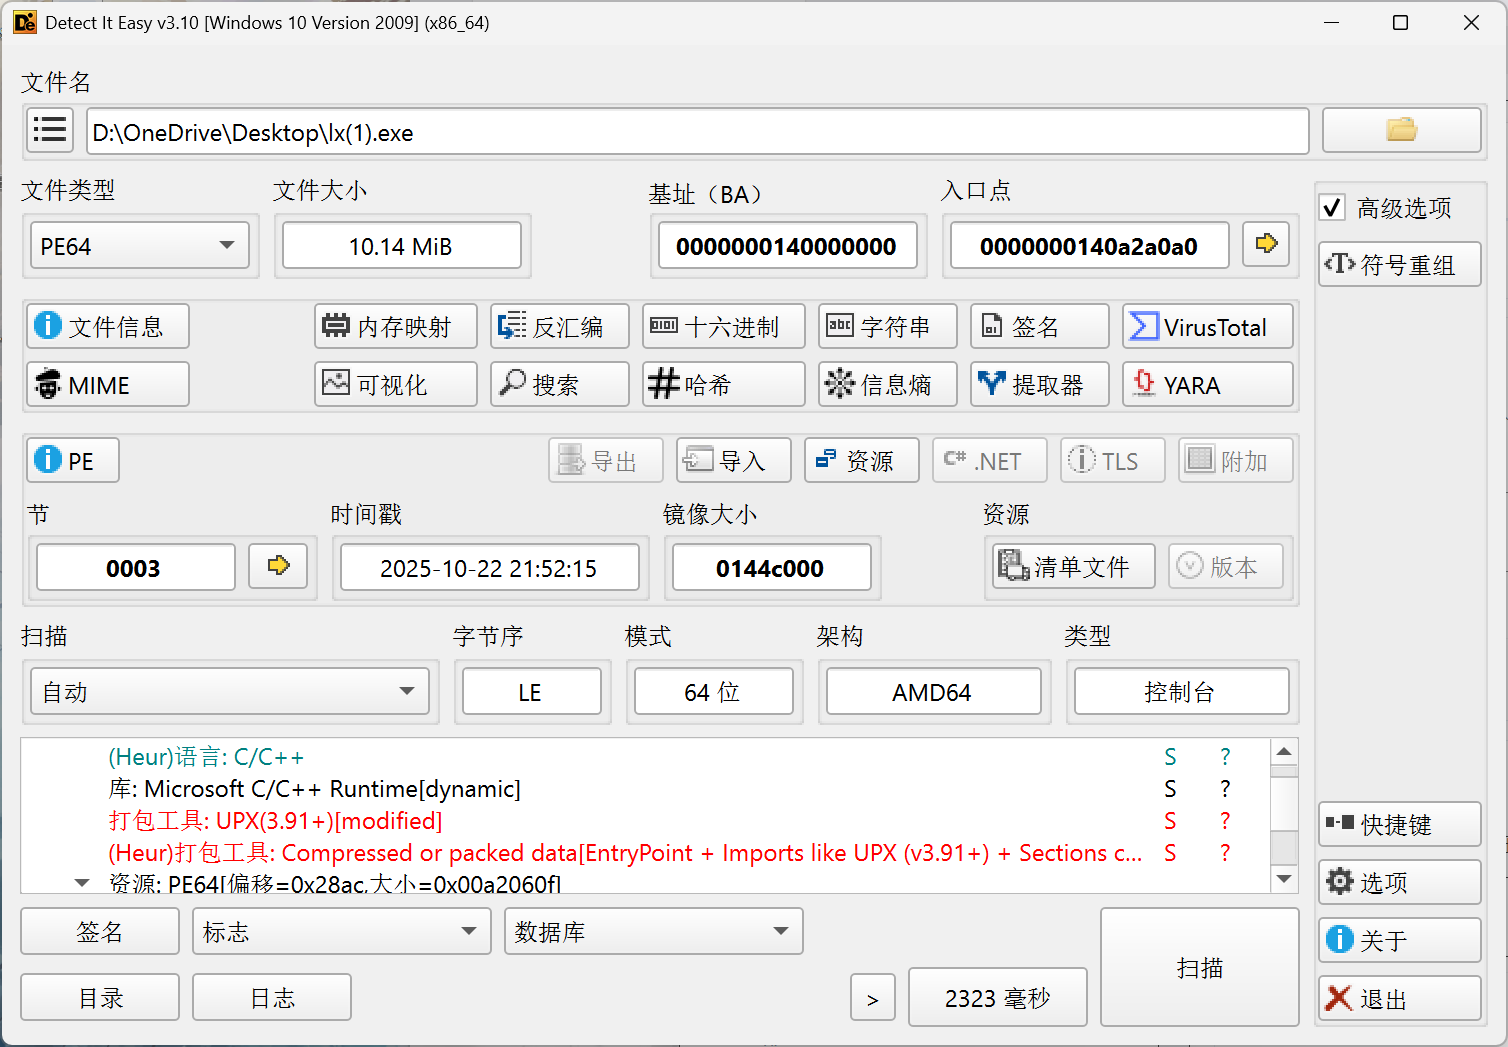
14 接上题,该 exe 使用了哪种压缩方式?
UPX
使用die打开
15 接上题,该 exe 使用的压缩方式修改了几处特征?
3
使用010打开,可以看到有三处
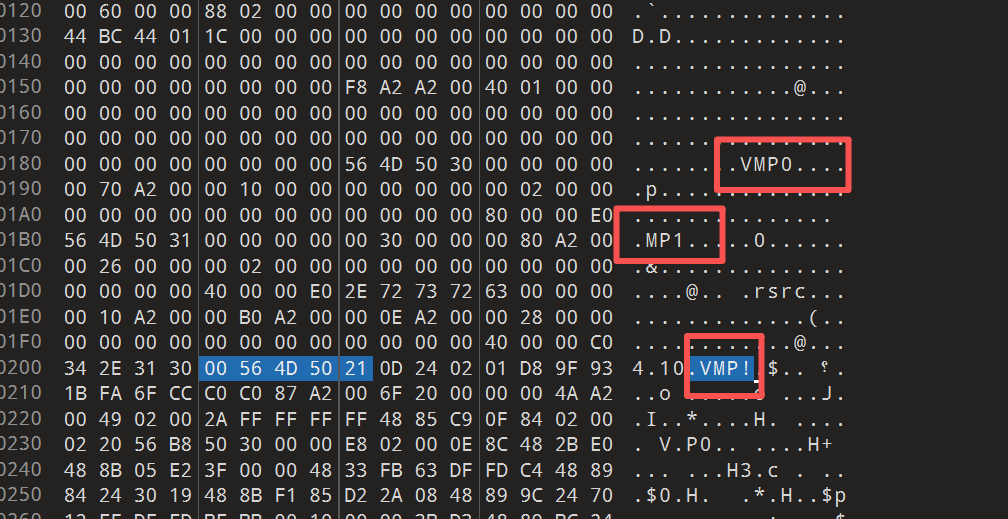
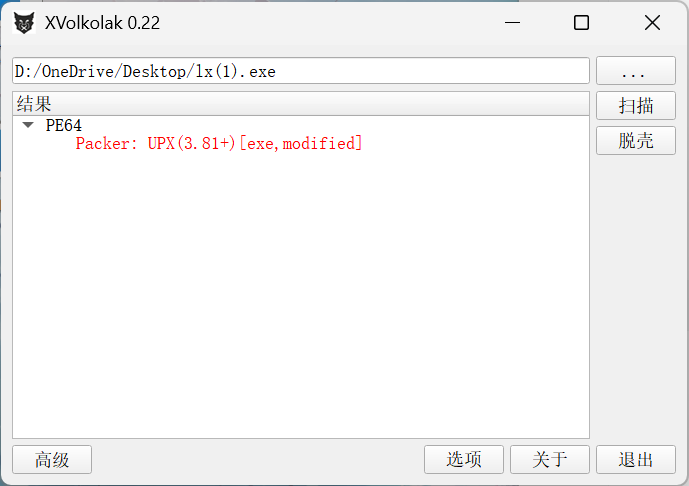
将vmp转化为upx即可脱壳,或者使用XVolkolak一键脱壳
16 接上题,该 exe 外联的端口号是多少?
4444
脱壳后的exe用ida打开,在函数sub_1400019B0中看到
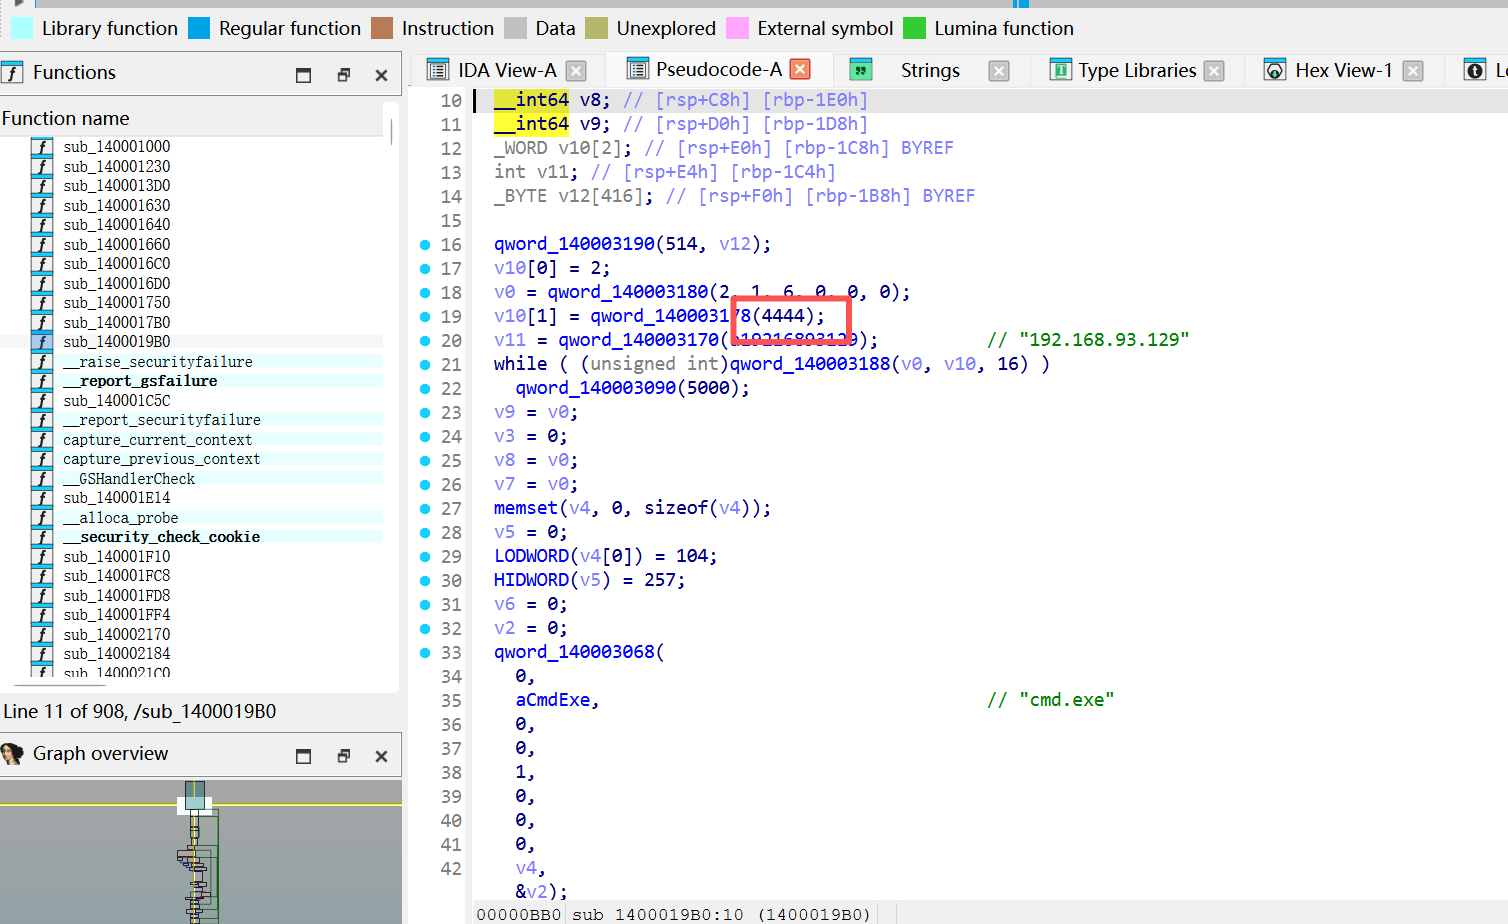
17 接上题,该 exe 会搜索并加密几种类型的文件?
3
在函数sub_1400013D0中找到
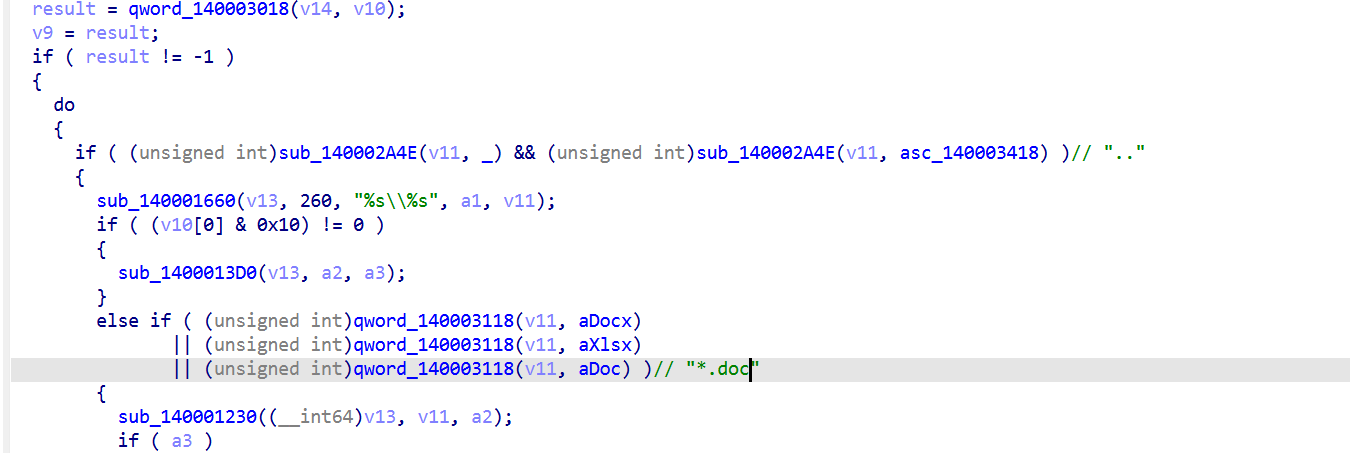
18 接上题,该 exe 会释放一个新的 exe,请问新的 exe 是用哪种编程语言编写的?
python
使用ResourceHacker查看一下
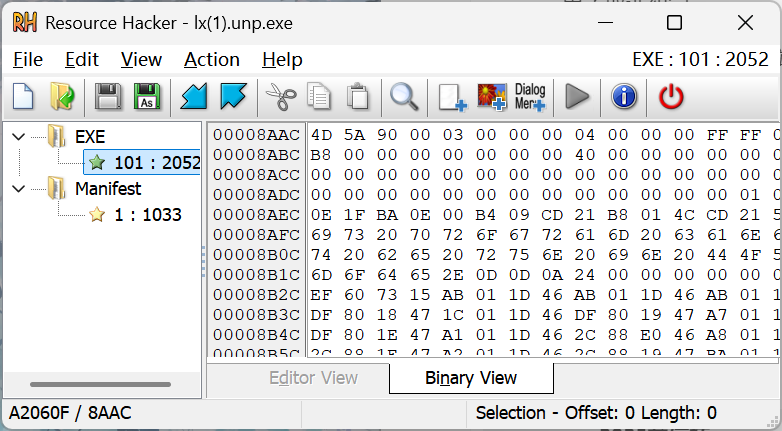
看到有个exe文件,导出
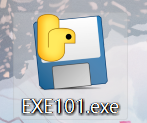
一眼python写的
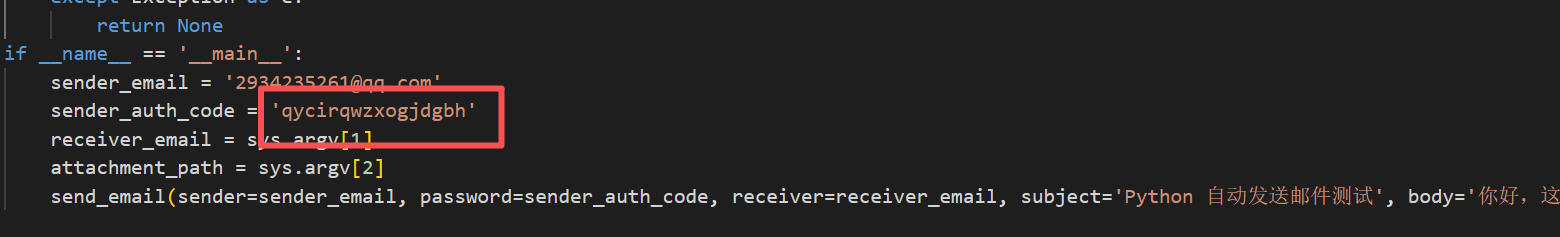
19 接上题,释放出的 exe 使用的邮件服务器的授权码是?
qycirqwzxogjdgbh
碰到好多次了,也该记住了
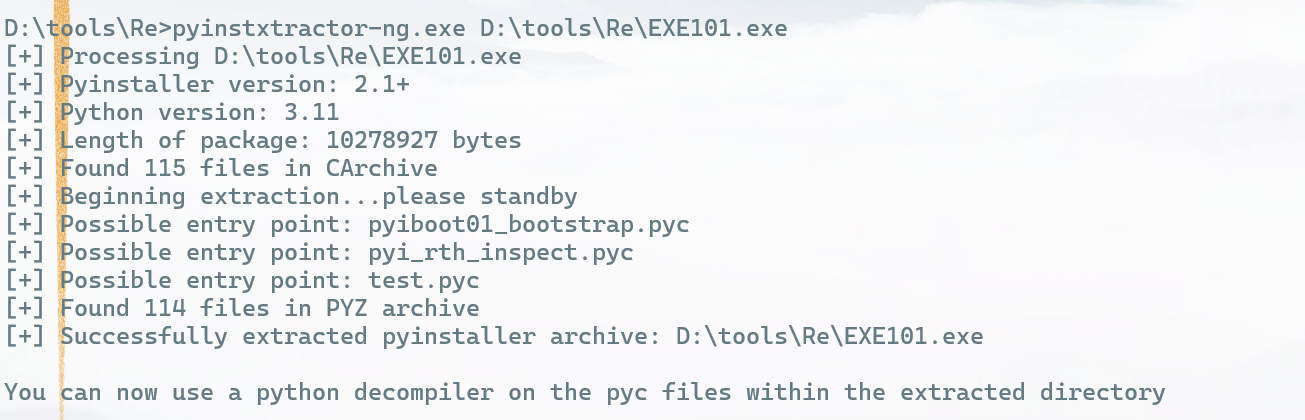
使用pyinstxtractor-ng解包
再用pylingual查看pyc文件
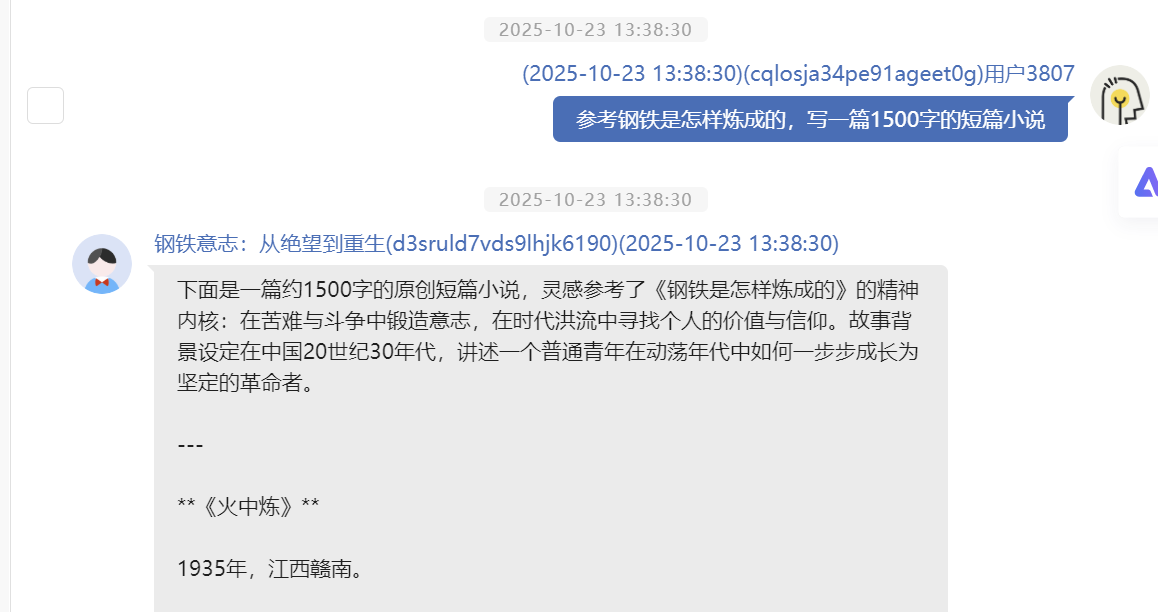
20 分析手机镜像,嫌疑人发布的抖音作品是参考哪篇文学巨著生成的?
钢铁是怎样炼成的
打开视频查看后是一个非常熟悉的名字
在刚刚翻看kimi的时候就可以看到
21 分析手机镜像,嫌疑人通过抖音发布了几个作品?
2
看到分析出来五个作品,但是答案不对
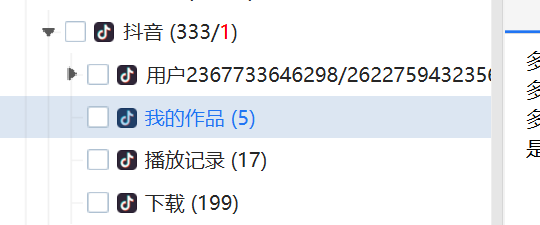
看到下一题有个作品id,直接爆搜,看到个json文件
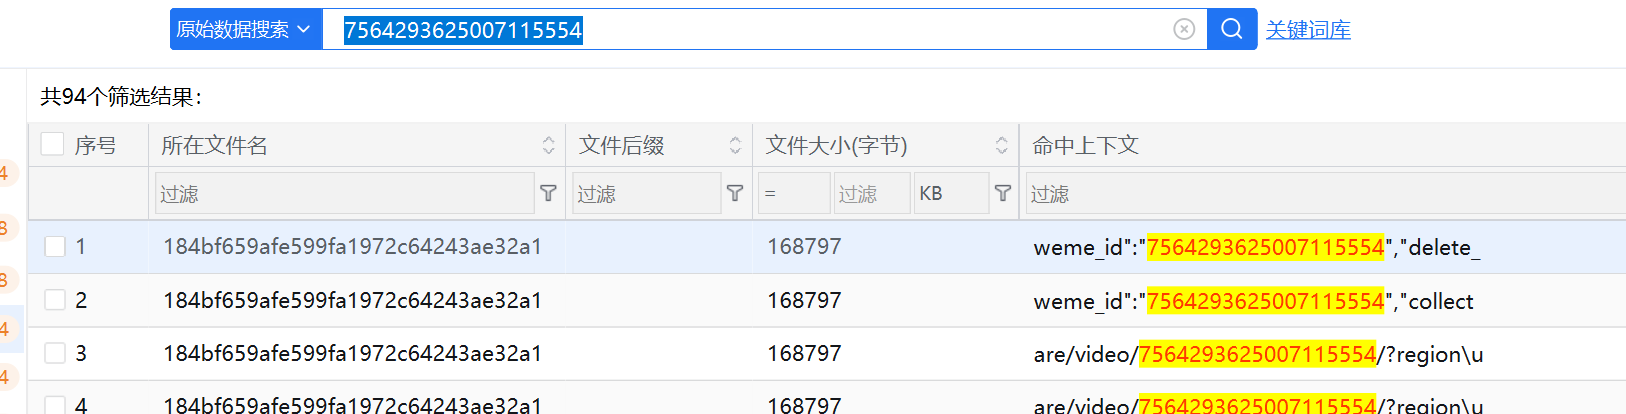
打开搜索statistics,可以看到是两个
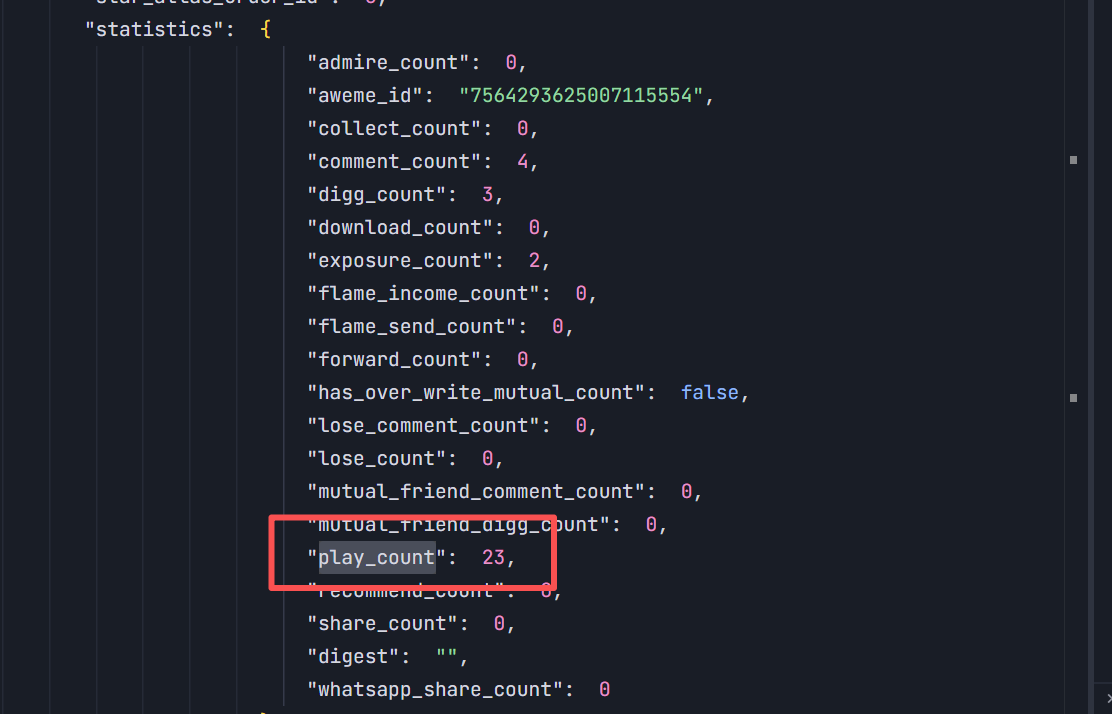
22 接上题,作品 ID 为 7564293625007115554 的观众浏览量为几次?
23
依旧在这个文件中找
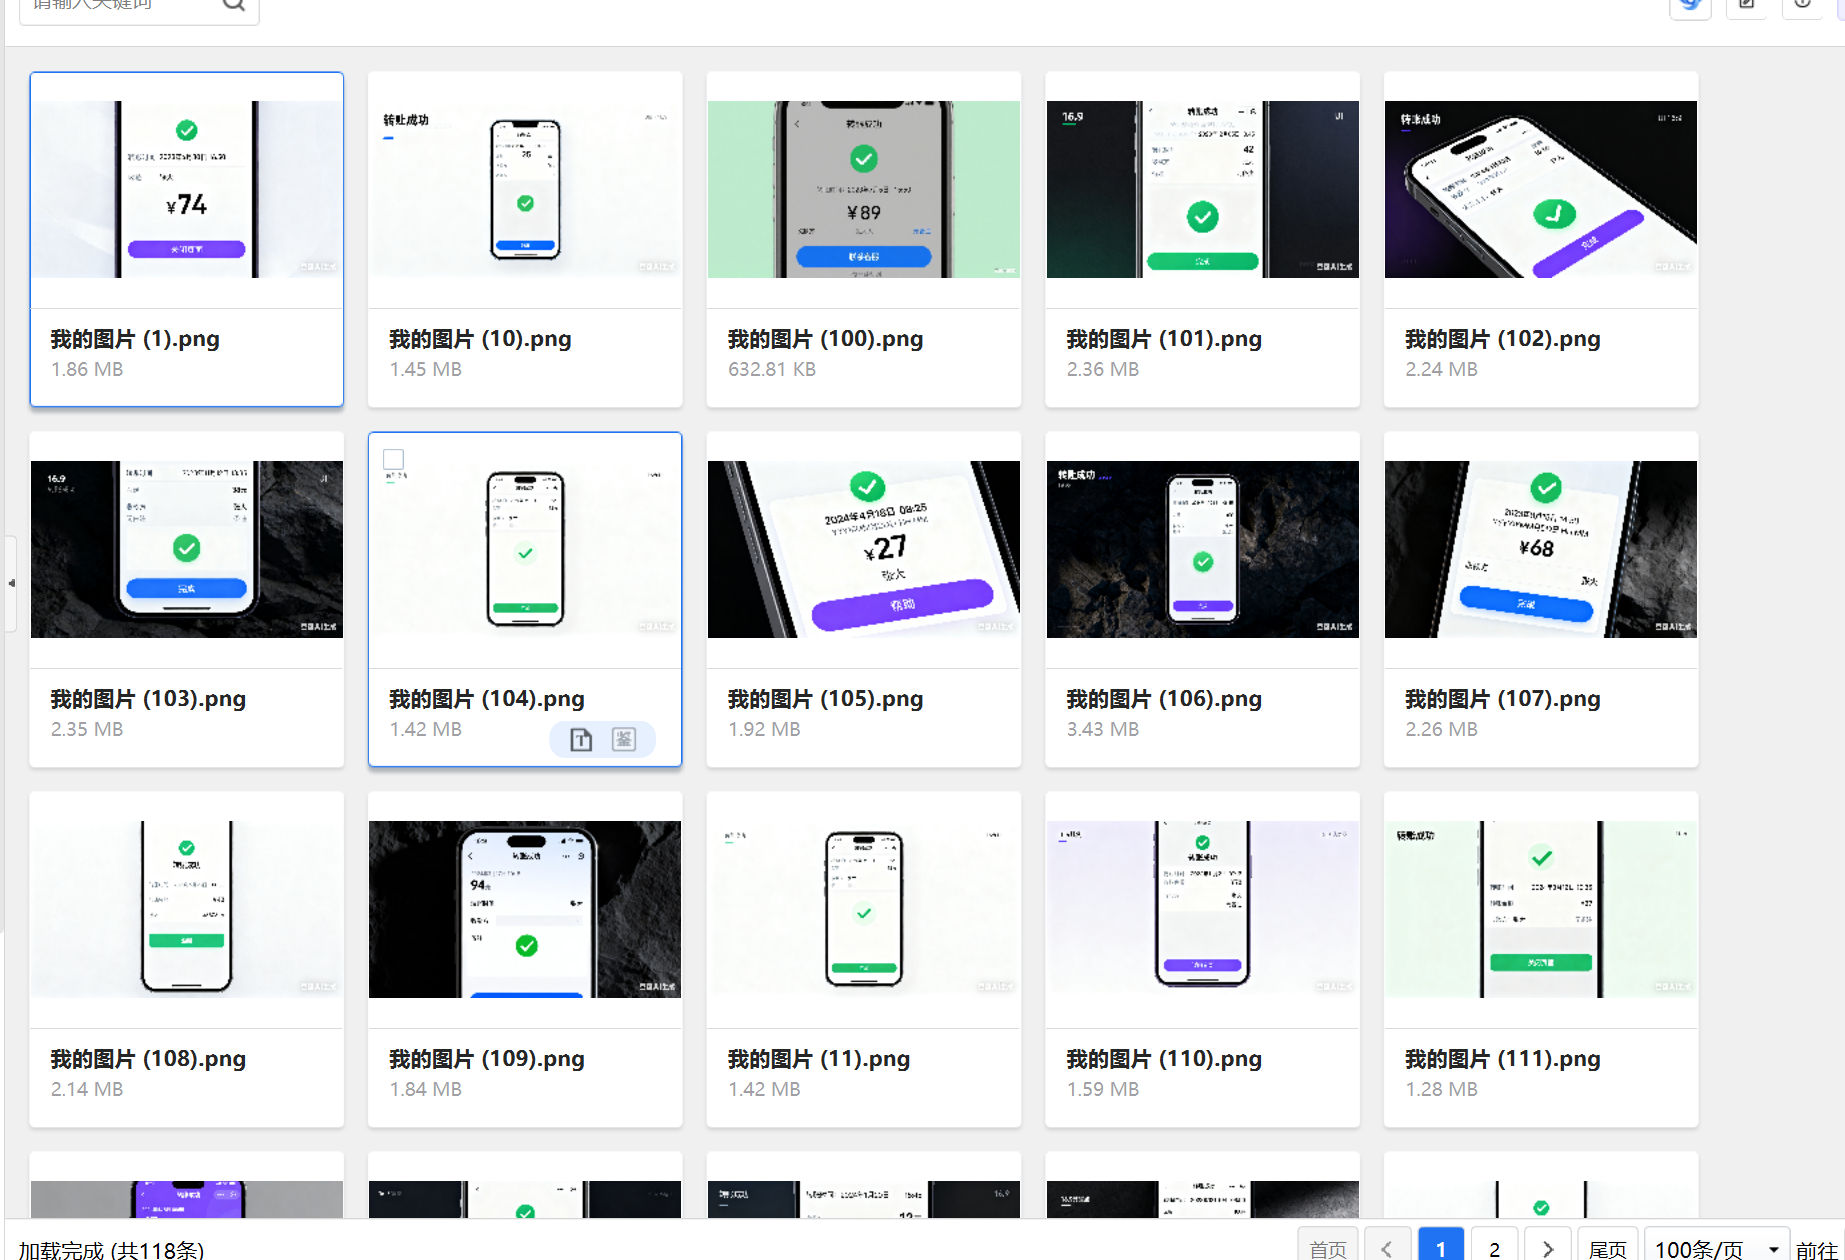
23 分析手机镜像,嫌疑人相册中的图片为其非法所得(不考虑重复),请分析其总收益为多少元?
6577
相册中有118张图片,要不就ocr扫出来加,要不就自己手动算
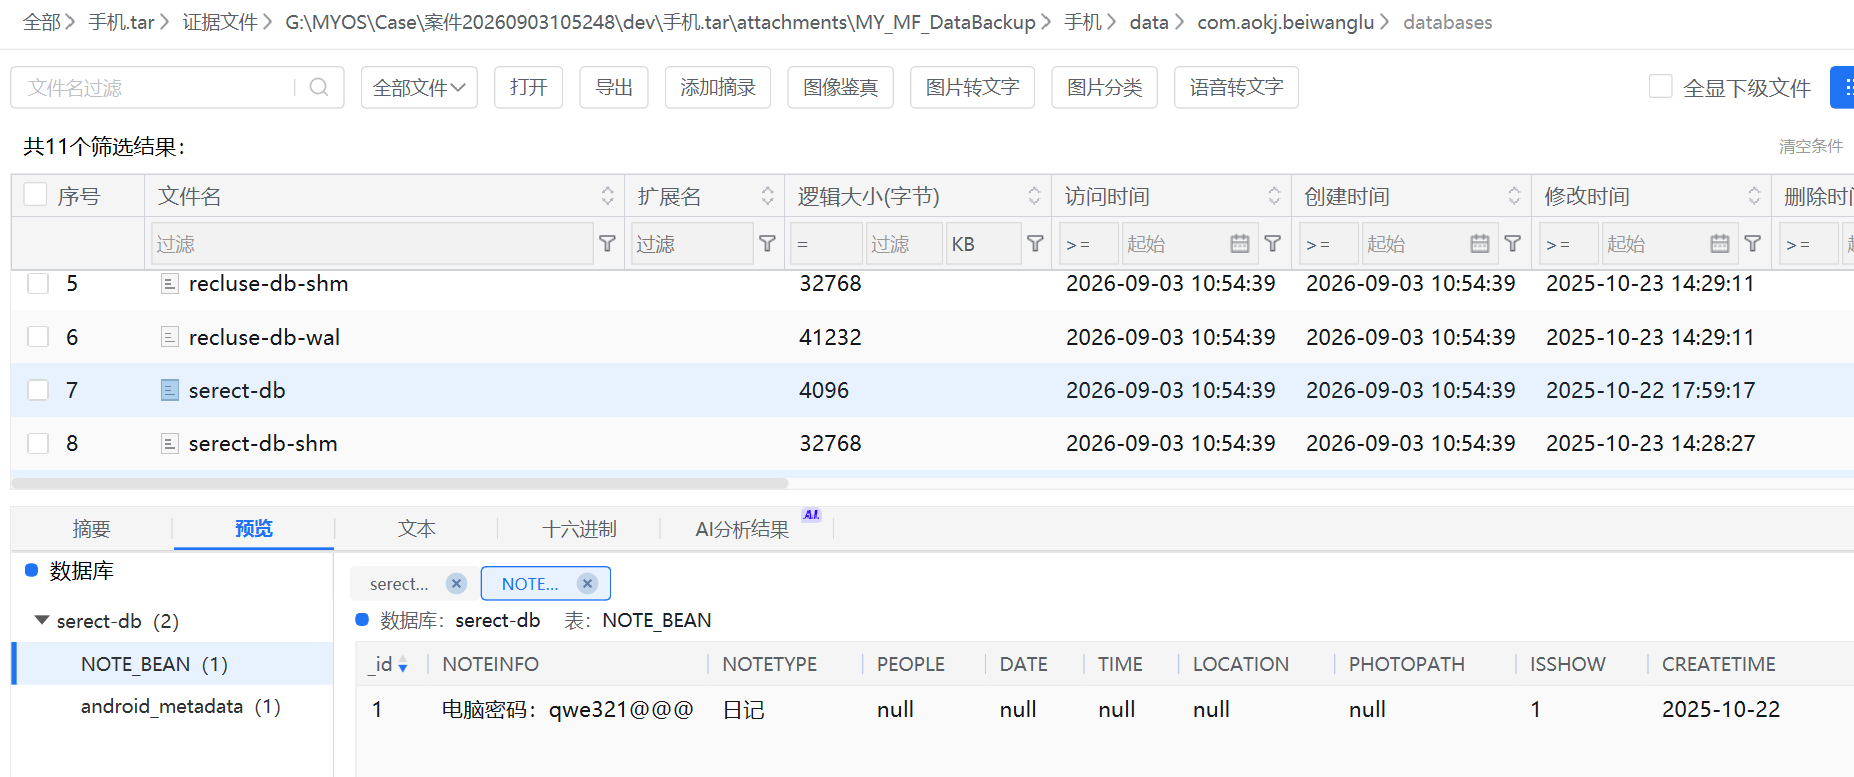
24 分析手机镜像,嫌疑人电脑的开机密码是多少?
qwe321@@@
在备忘录中找到
计算机取证
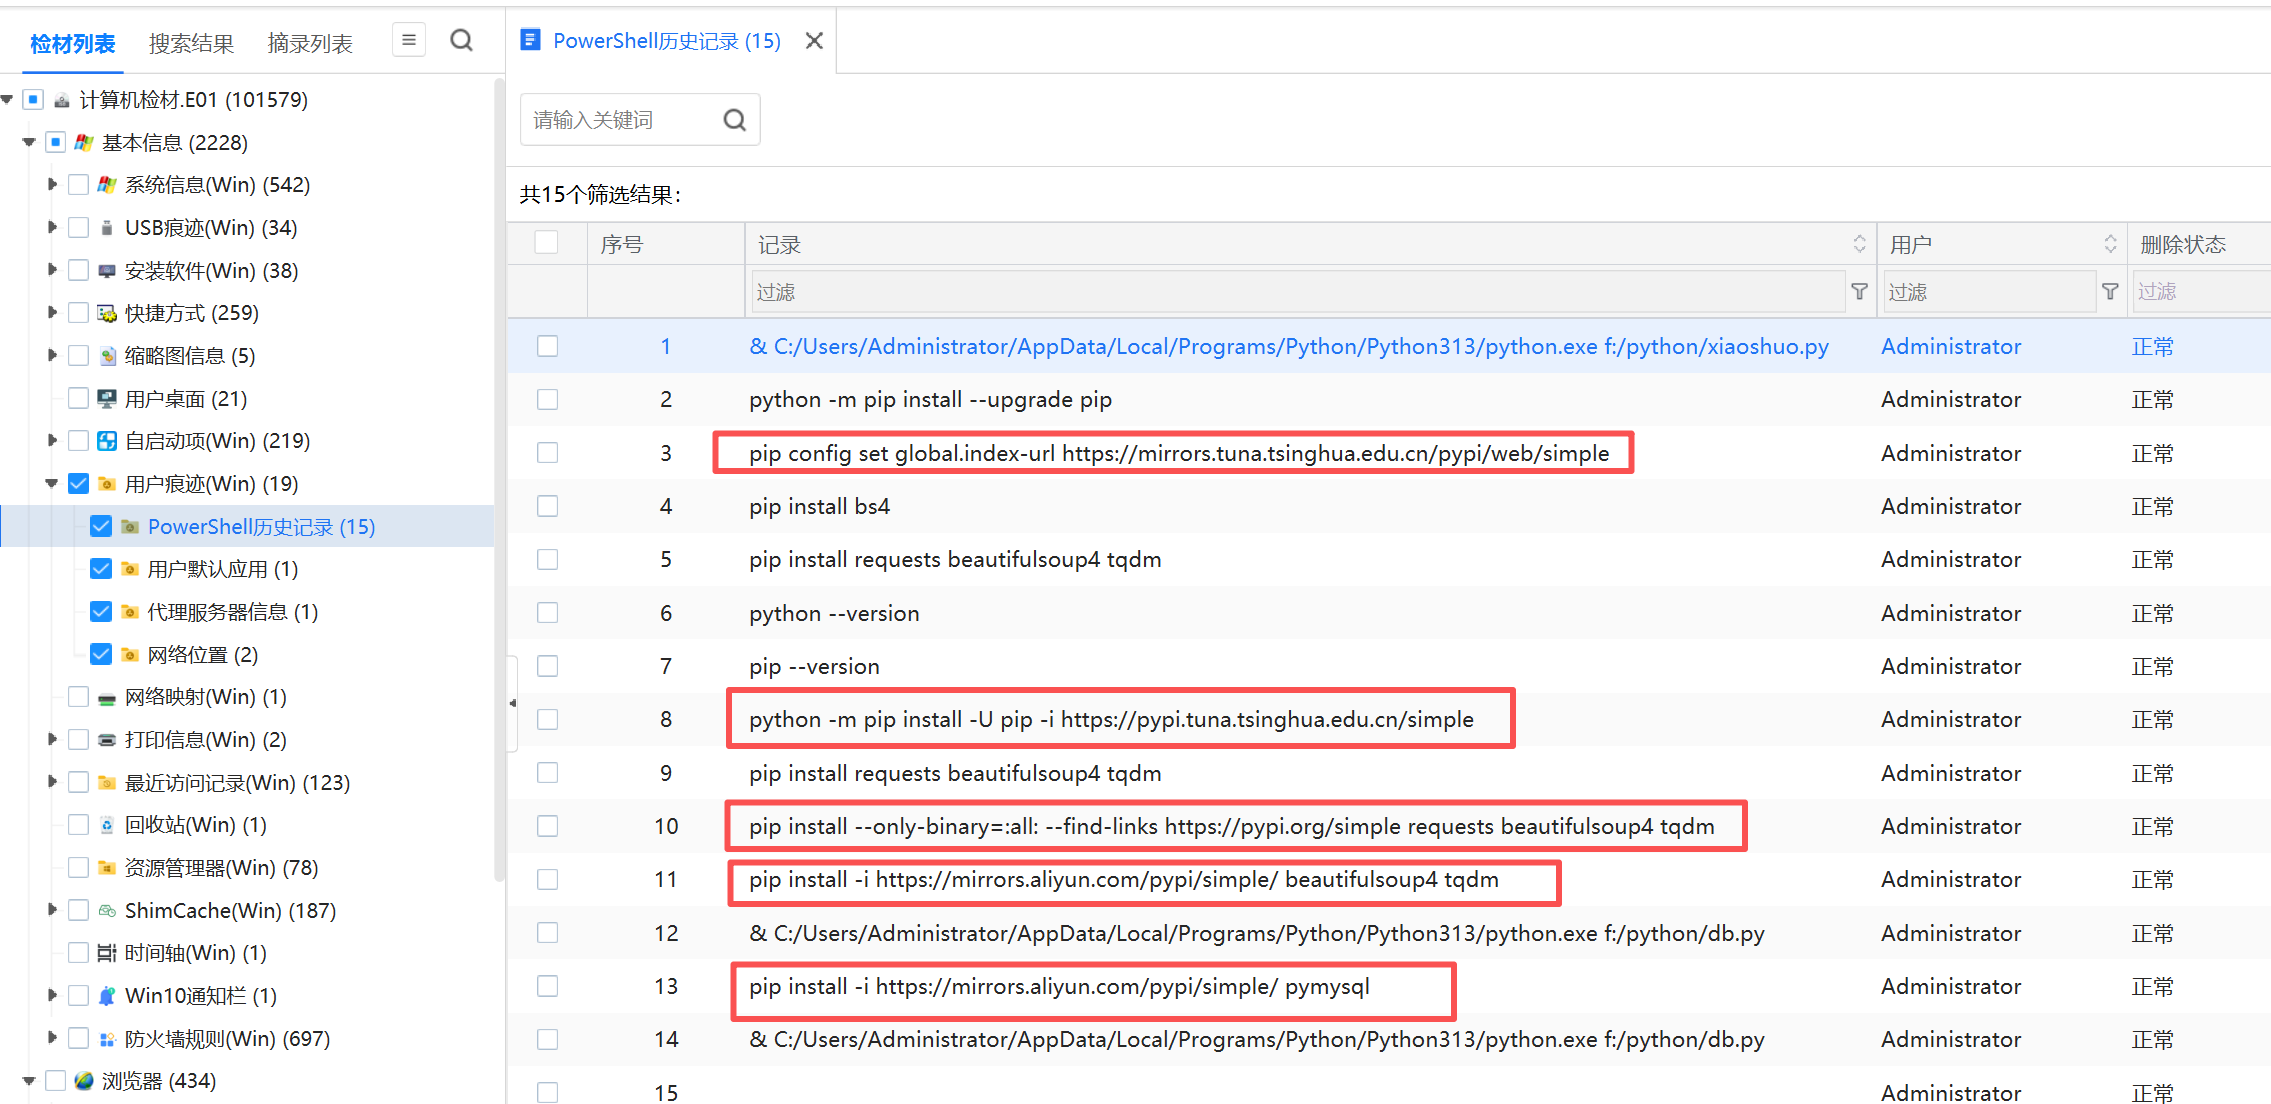
01 分析 Windows 检材,PowerShell 中多少个命令关联 URL 地址?
5
在powershell的历史命令中可以看到有5条
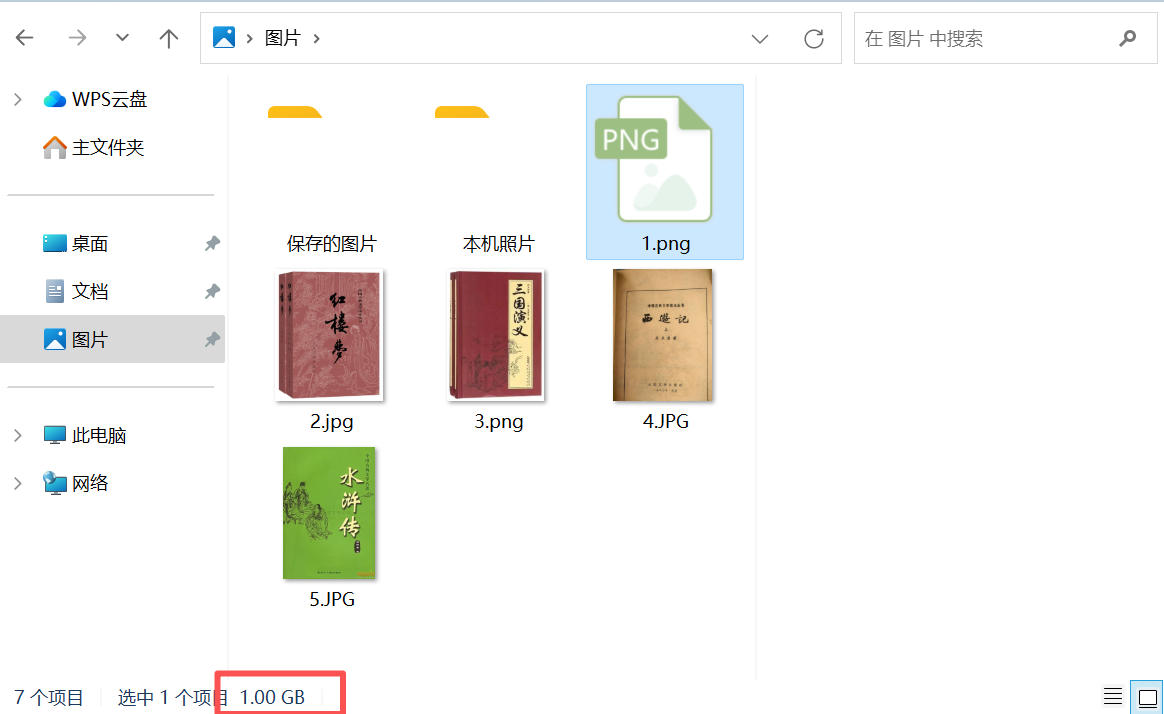
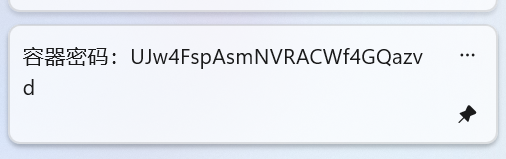
02 分析 Windows 检材,VeraCrypt 加密容器密码是什么?
UJw4FspAsmNVRACWf4GQazvd
在图片这里看到一个1GB大小的图片,肯定就是VC加密容器了
win+v查看剪切板看到加密容器密码
解密成功
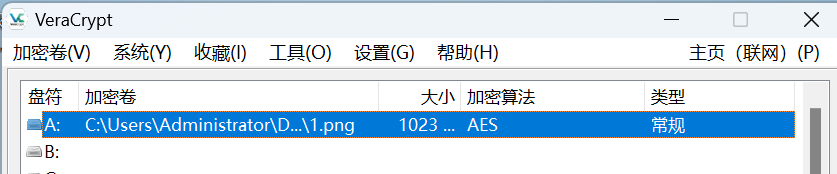
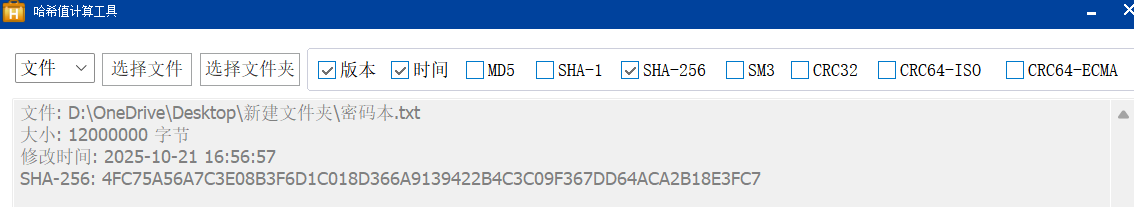
03 分析 Windows 检材,加密容器中“密码本.txt”文件 SHA-256 后六位是多少?
8E3FC7
他说加密容器中的,但是并没有看到有这个文件
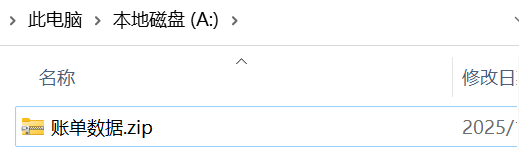
看到桌面上有个DiskGenius,想起26平航也有这样的题,打开恢复一下看看
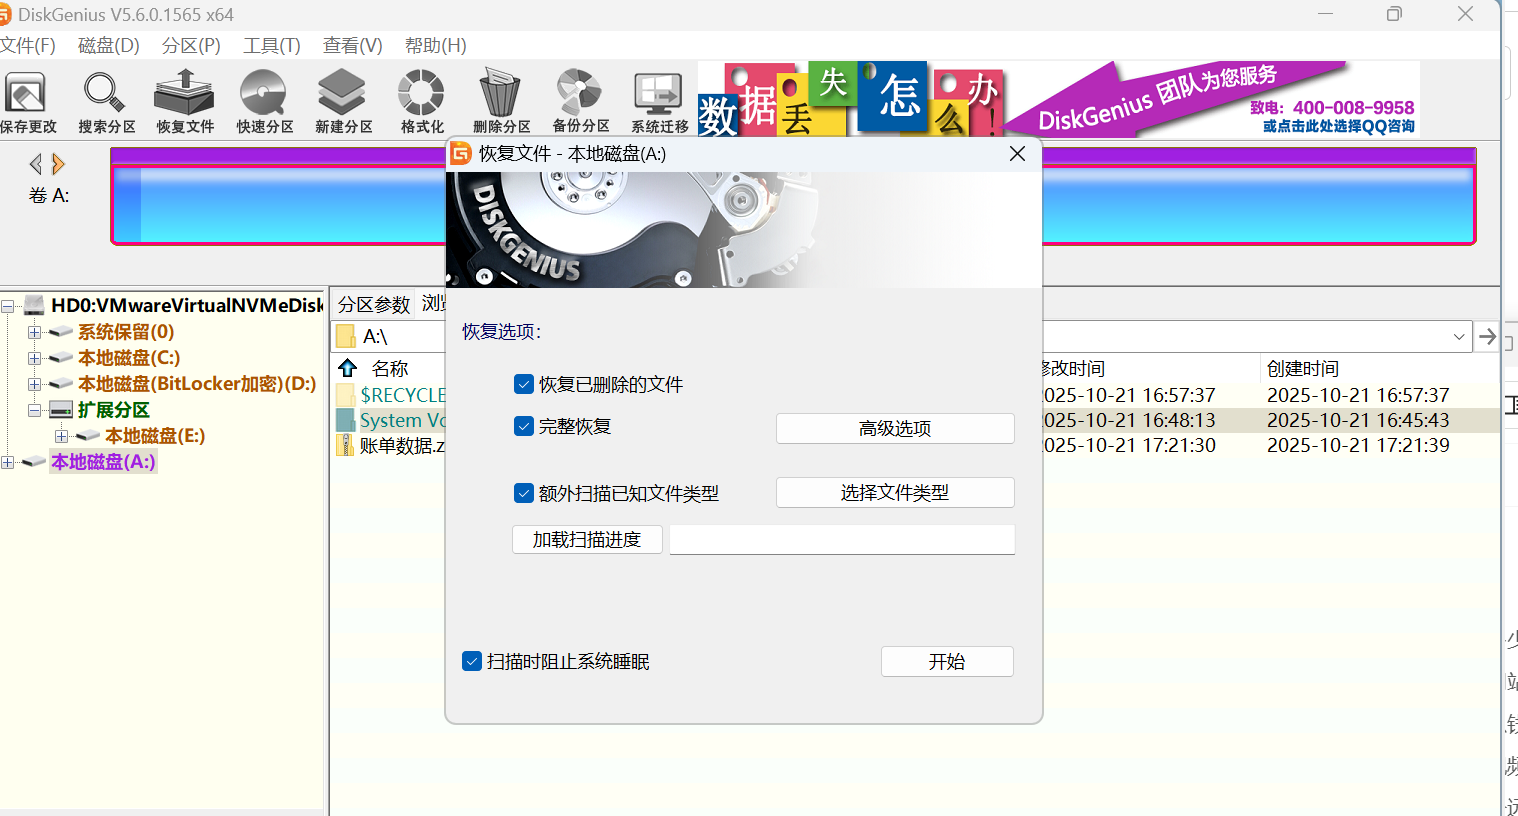
确实是需要恢复一下才能看到(虚拟机的未注册不能导出,可以使用自己的工具进行恢复导出)
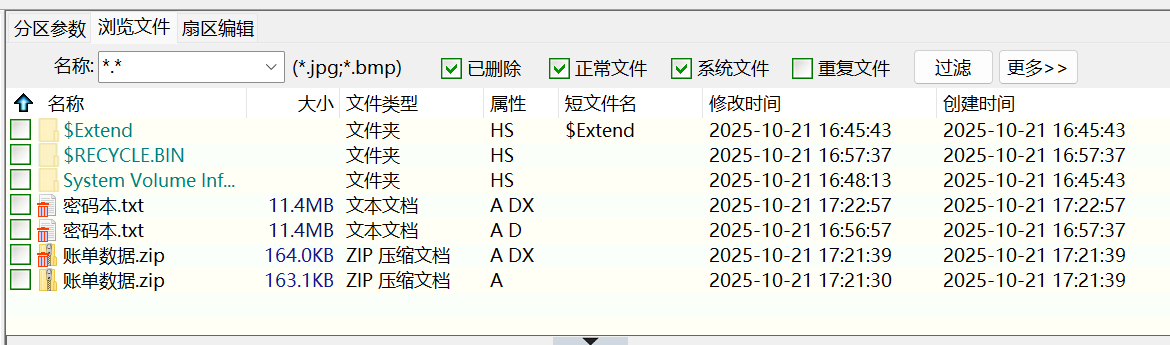
导出之后计算哈希
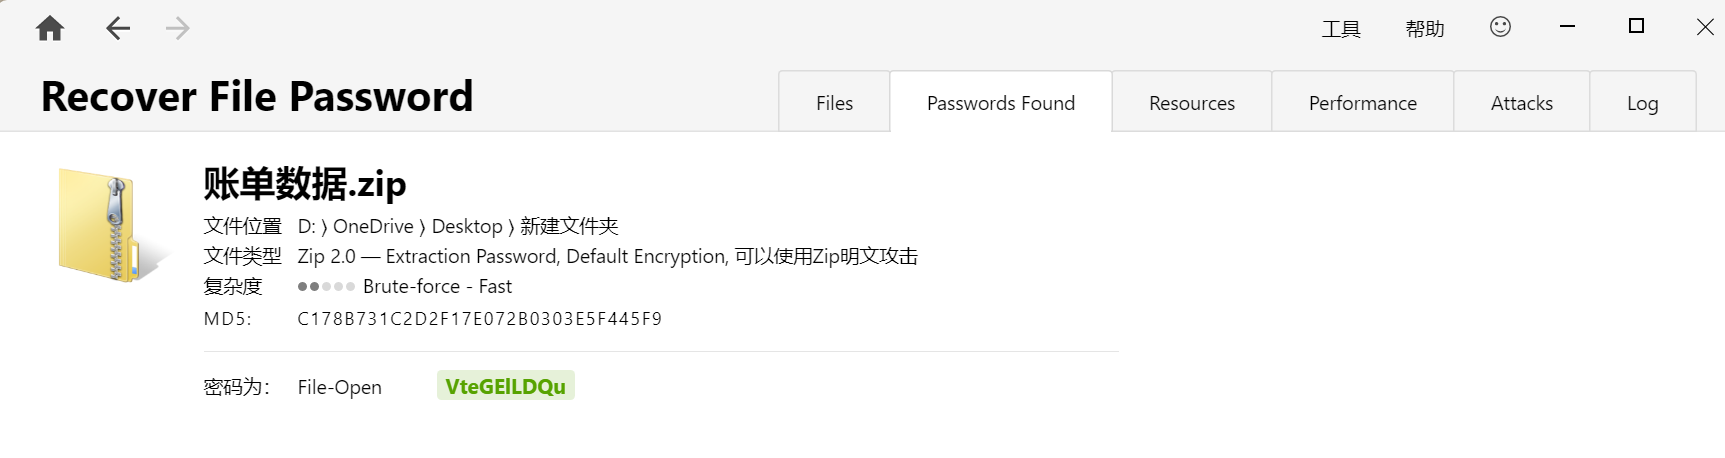
04 分析 Windows 检材,账单数据压缩包解密密码是多少?
VteGElLDQu
有了密码本和压缩包,直接passwarekit字典爆破一下
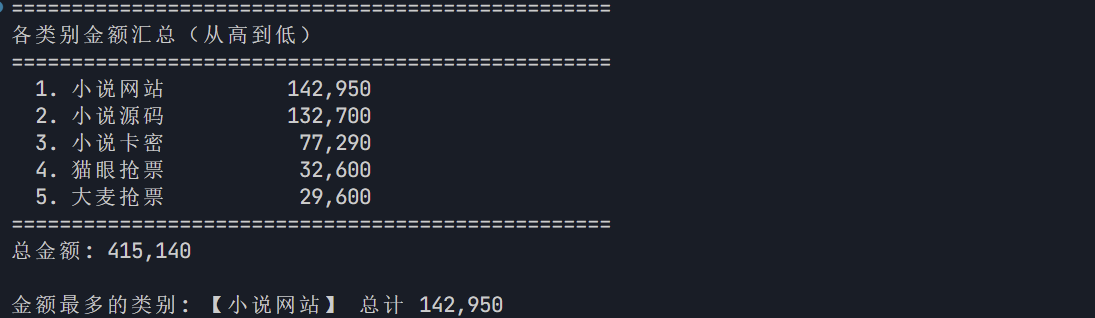
05 分析 Windows 检材,账单数据中哪个类别金额最多?
小说网站
这就得借助ai写个脚本分析一下了
import pandas as pd
import glob
import os

# 读取所有xlsx文件并合并
files = sorted(glob.glob(os.path.join(os.path.dirname(__file__), "*.xlsx")))
dfs = [pd.read_excel(f) for f in files]
df = pd.concat(dfs, ignore_index=True)

# 按项目分组汇总金额
result = df.groupby('项目')['金额'].sum().sort_values(ascending=False)

print("=" * 50)
print("各类别金额汇总(从高到低)")
print("=" * 50)
for i, (category, amount) in enumerate(result.items(), 1):
    print(f"{i:>3}. {category:<10} {amount:>10,}")

print("=" * 50)
print(f"总金额: {df['金额'].sum():,}")
print(f"\n金额最多的类别: 【{result.index[0]}】 总计 {result.iloc[0]:,}")
可以看到是小说网站
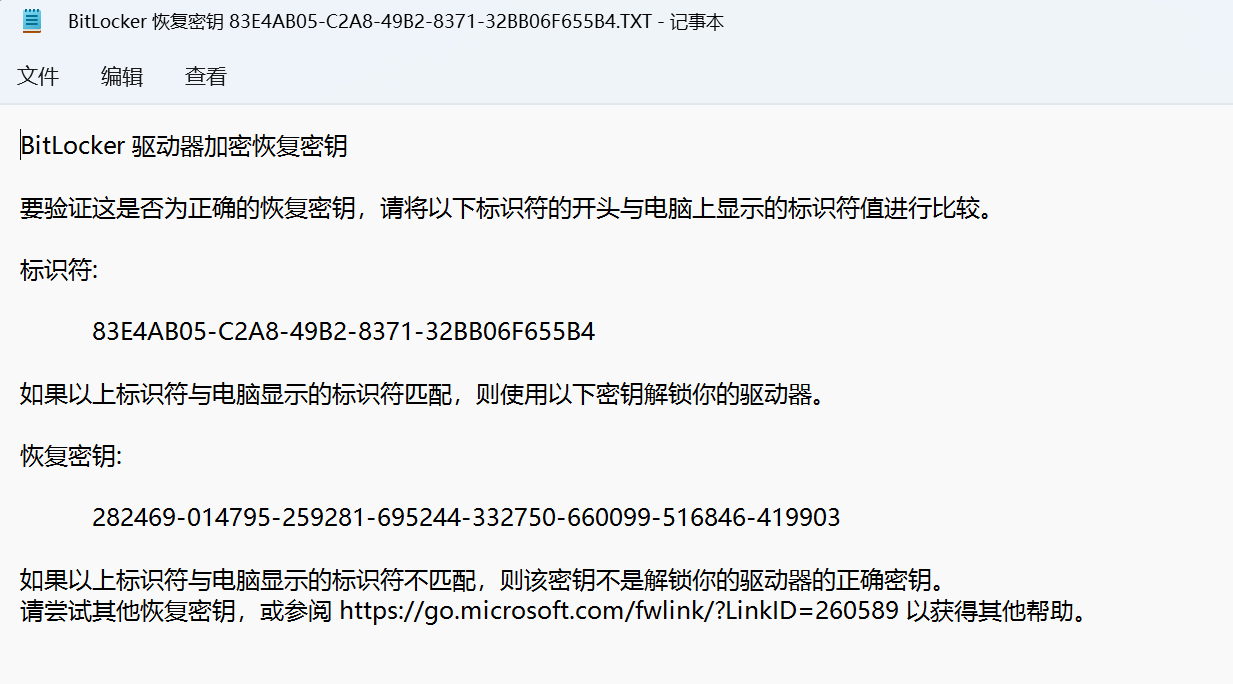
06 分析 Windows 检材,Bitlocker 的恢复密钥前六位是什么?
282469
在文档看到bitlocker密码x
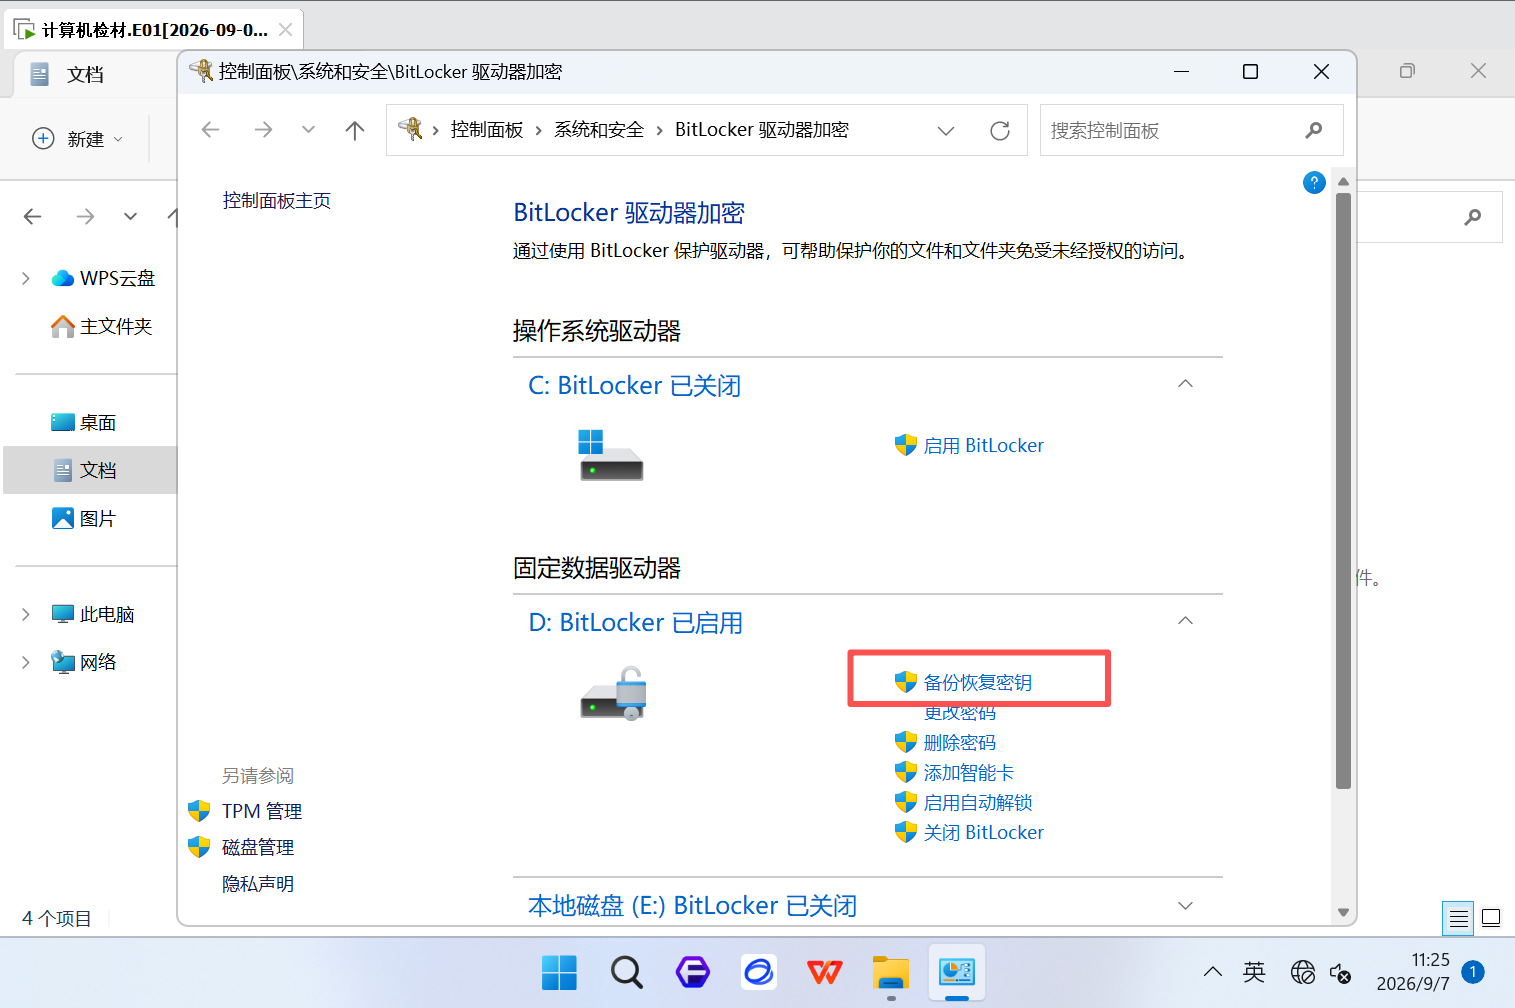
解密一下磁盘,然后打开bitlocker管理器
点击备份恢复密钥,保存到文件
查看文件即可
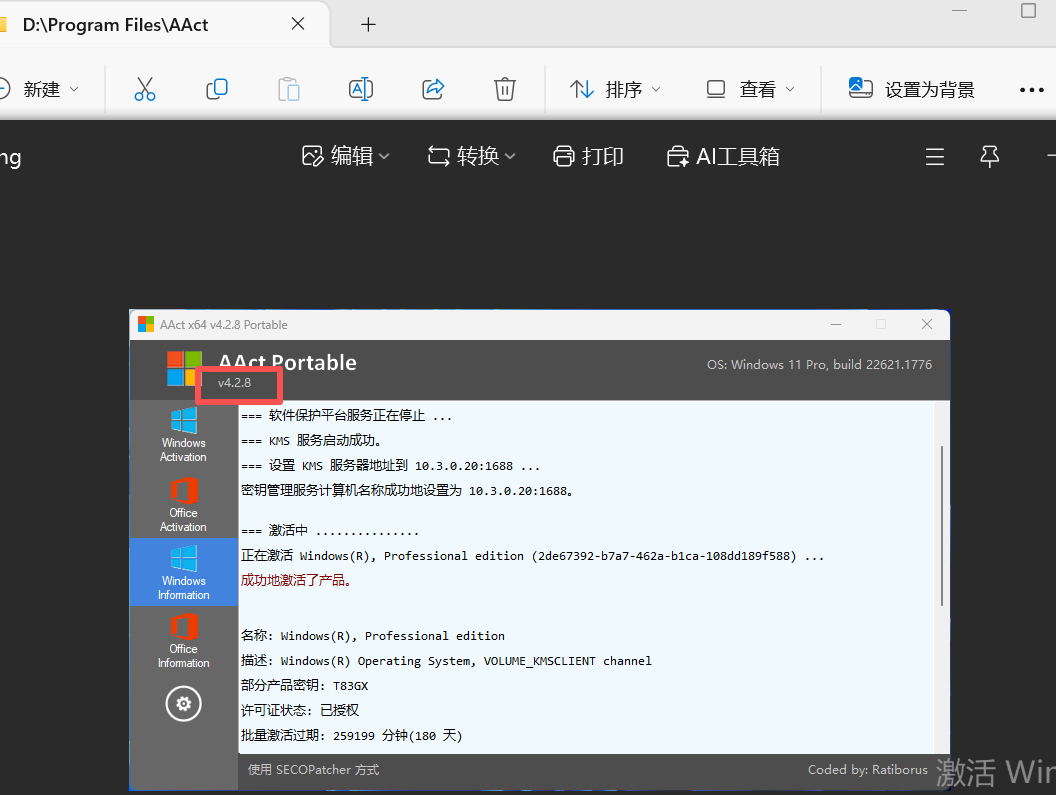
07 分析 Windows 检材,嫌疑人使用的 Windows 激活工具版本是什么?
v4.2.8
在D盘找到一张图片,里面可以看到
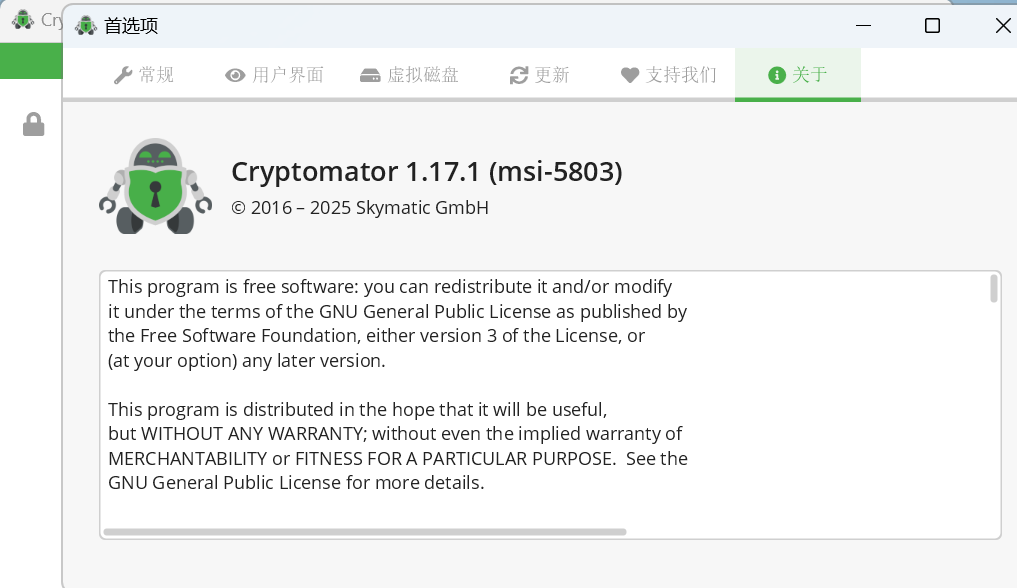
08 分析 Windows 检材,已安装的加密软件(非 VeraCrypt)版本是多少?
1.17.1
打开菜单可以看到有个加密工具
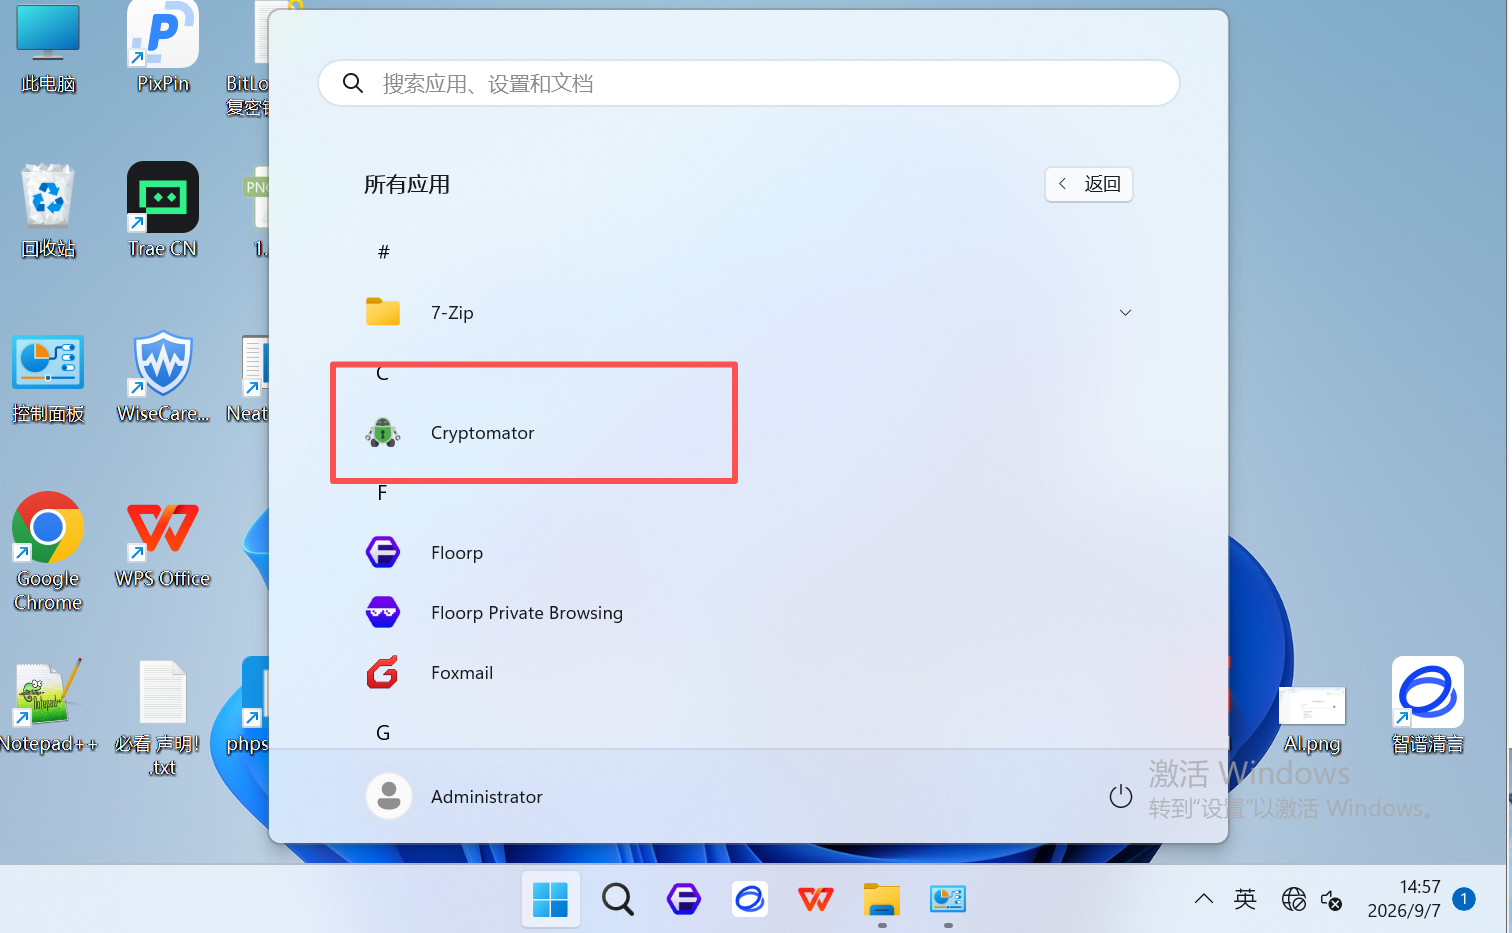
打开看看
09 分析 Windows 检材,该加密软件恢复秘钥文件最后一个单词是什么?
accent
在D盘可以看到有个恢复密钥的docx文件
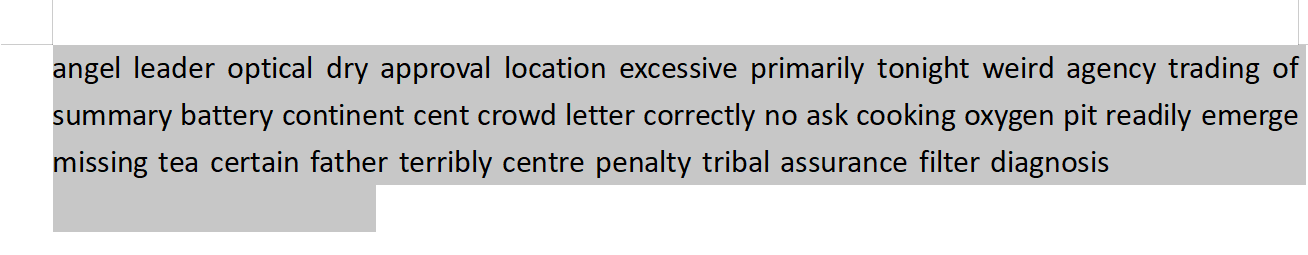
选中一下看到选到空的了,先变个颜色看看
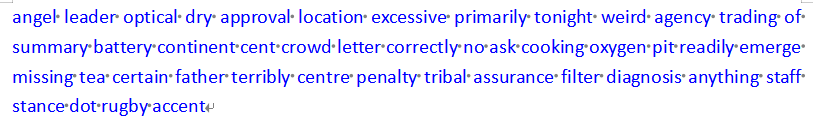
可以看到
10 分析 Windows 检材,MySQL 数据库路径是什么?
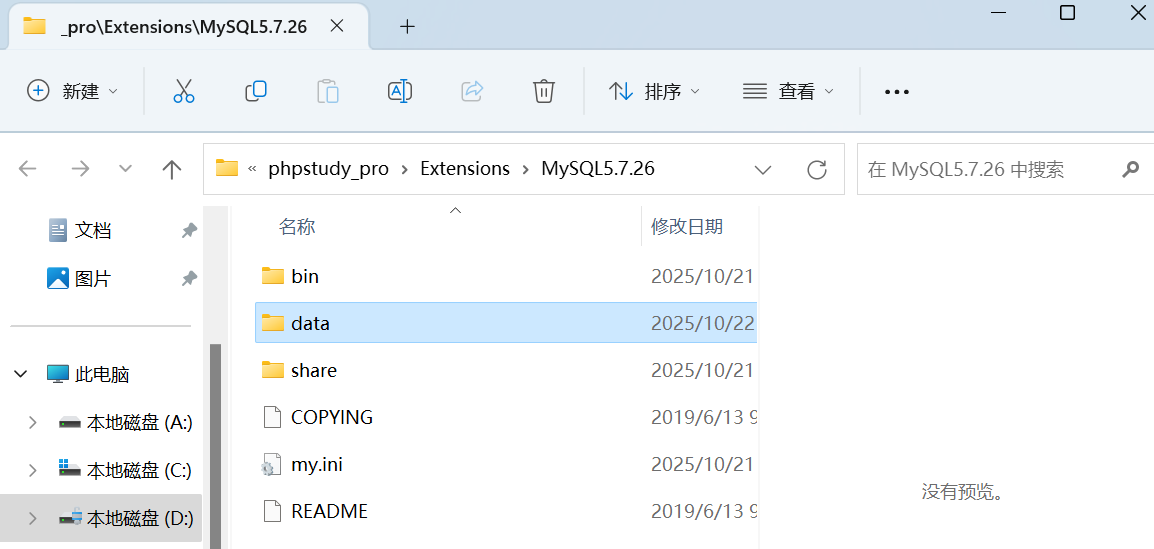
D:\phpstudy_pro\Extensions\MySQL5.7.26\data
直接打开phpstudy
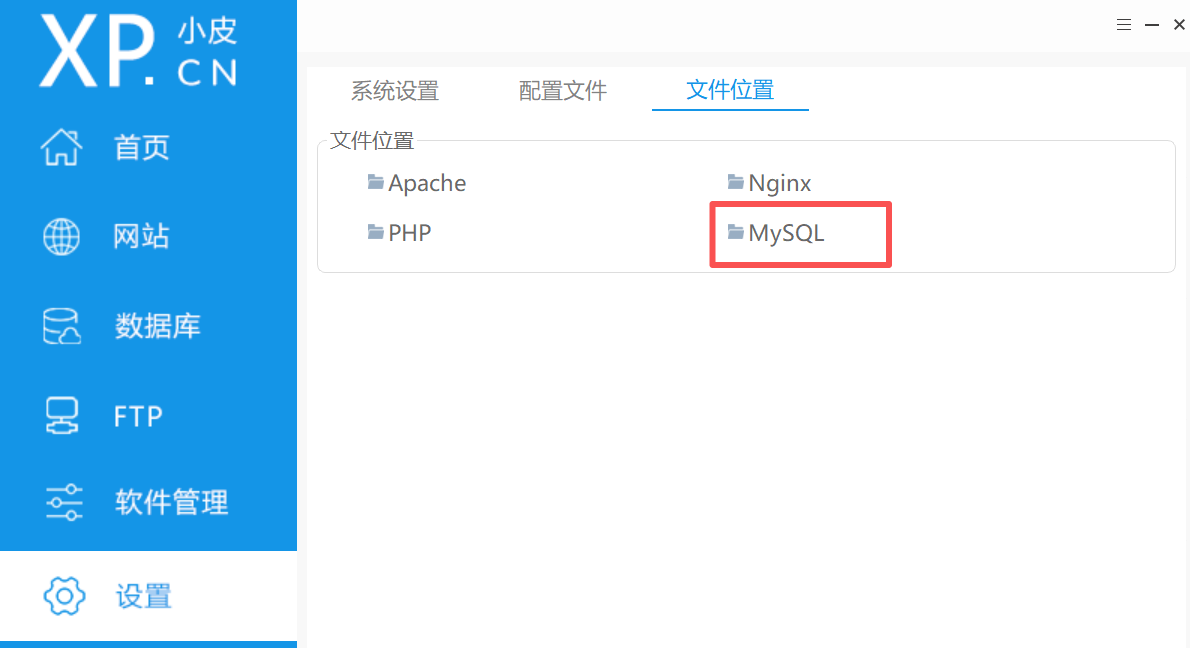
跳转到目录即可
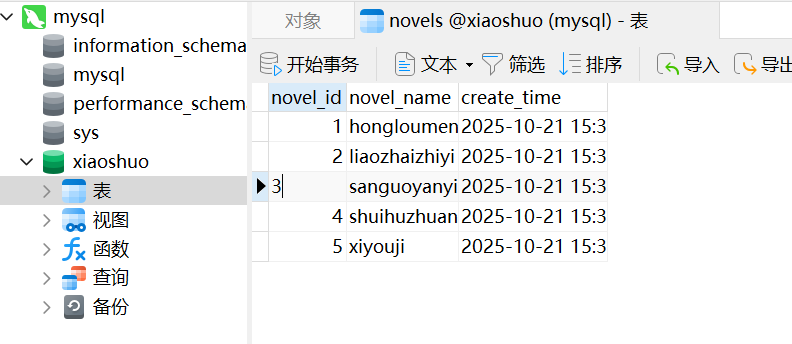
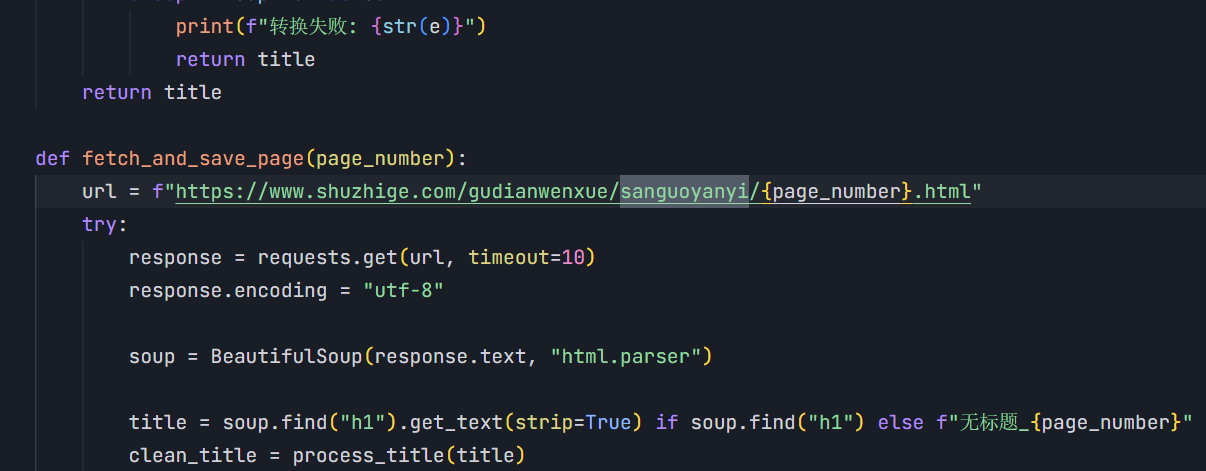
11 分析 Windows 检材,novel_id=3 的爬虫代码爬取的网站域名地址是什么?
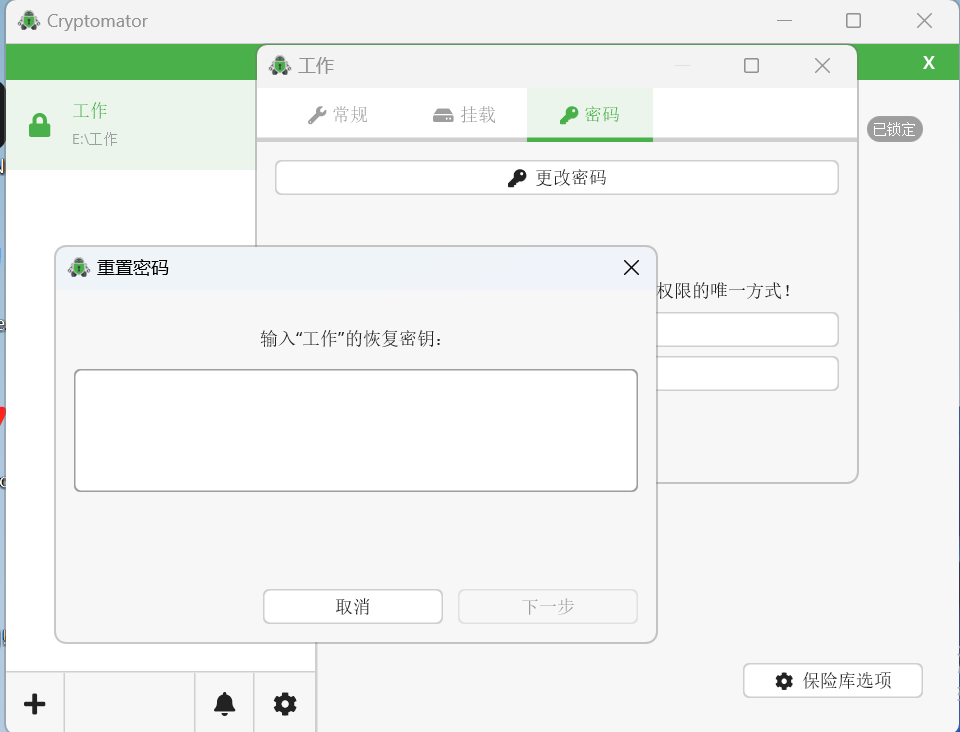
拿第九题的恢复密钥重置一下密码
修改密码打开驱动器可以看到是关于爬虫的
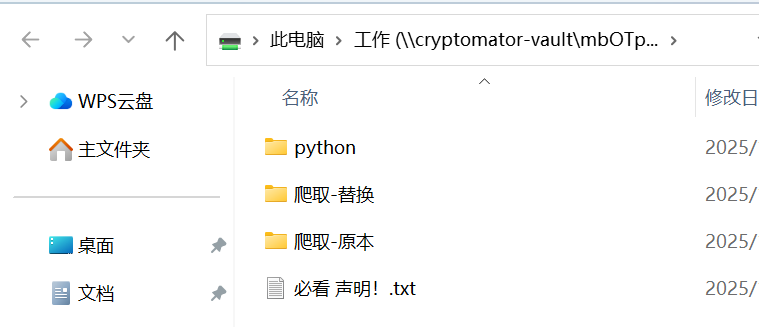
看到数据库了,直接连接
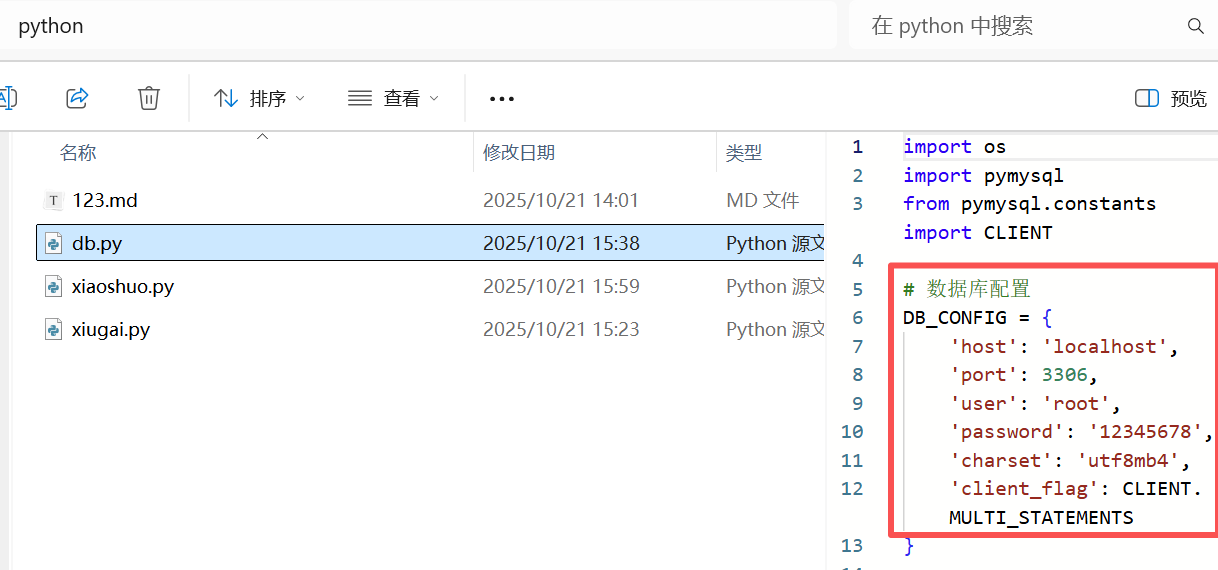
其实在phpstudy启动mysql,navicat直接连接就行
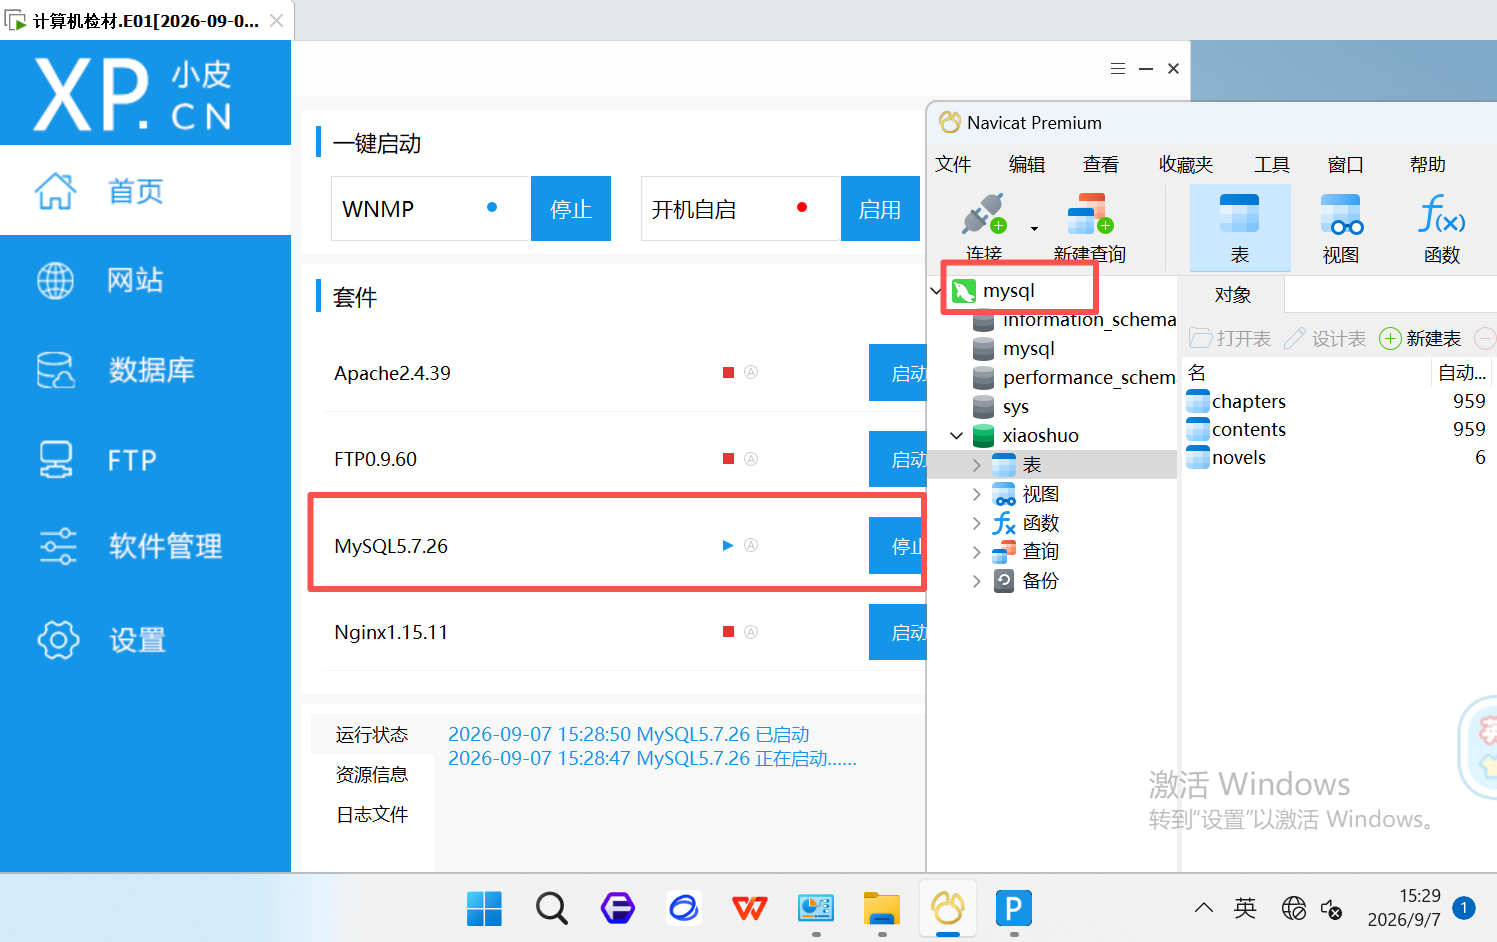
在数据库中可以看到小说名称
在脚本中搜索一下
12 分析 Windows 检材,数据库中缺失的小说共有多少章节?
3
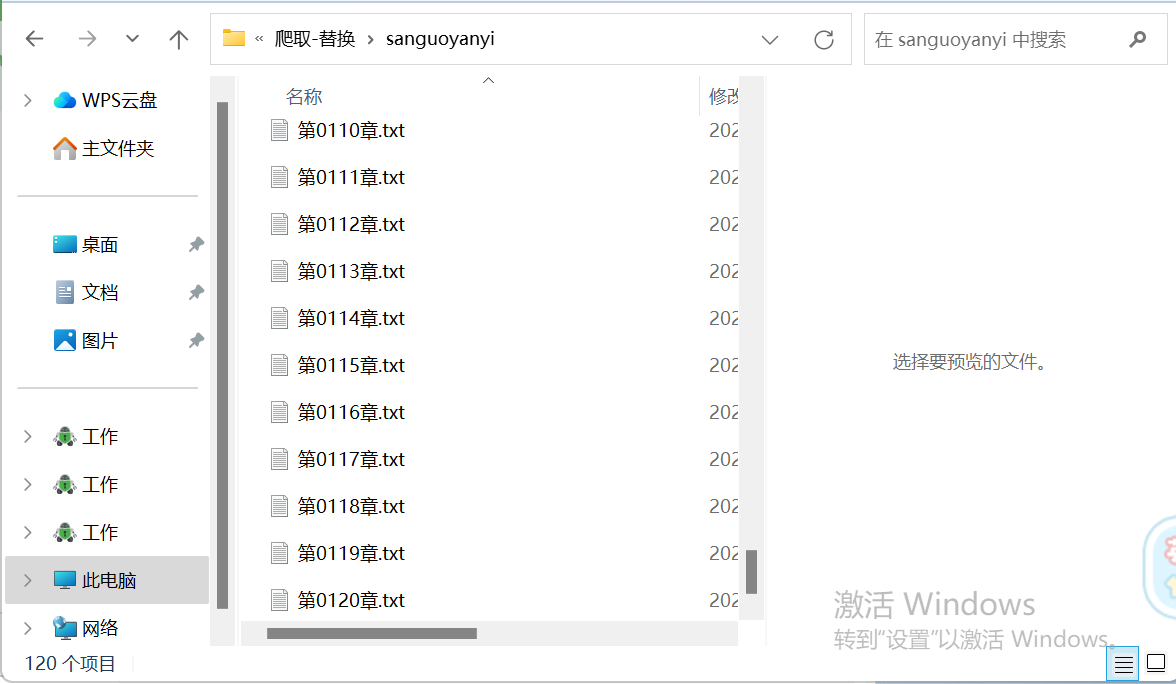
应该是有个小说缺失章节了,对比一下文件夹的章节和数据库中的章节即可
数据库查询SELECT count(*) FROM chapters where novel_id = 1
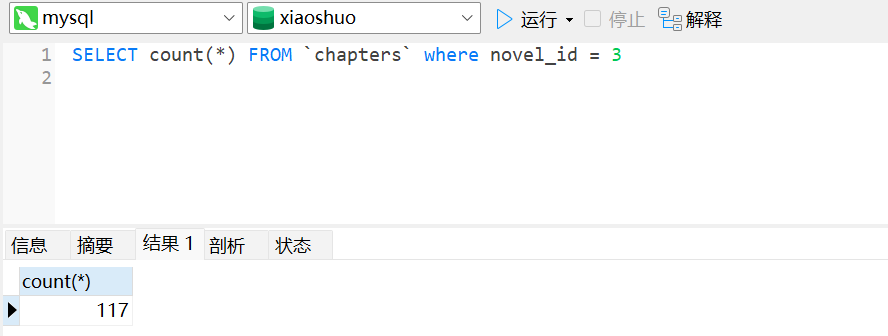
可以看到三国演义是120章,少了三章
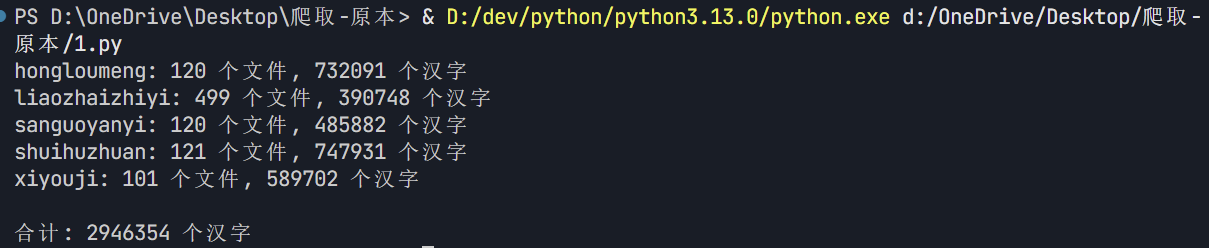
13 分析 Windows 检材,嫌疑人爬取的小说共有多少汉字?
2946354
继续让ai写脚本统计一下字数
import os
import re

# 统计汉字的正则:CJK统一汉字基本区 + 扩展A区
chinese_re = re.compile(r'[\u4e00-\u9fff\u3400-\u4dbf]')

def count_chinese_in_file(filepath):
    """统计单个文件中的汉字数量"""
    with open(filepath, 'r', encoding='utf-8') as f:
        text = f.read()
    return len(chinese_re.findall(text))

def main():
    base_dir = os.path.dirname(os.path.abspath(__file__))
    grand_total = 0

    # 遍历所有子目录
    for subdir in sorted(os.listdir(base_dir)):
        subdir_path = os.path.join(base_dir, subdir)
        if not os.path.isdir(subdir_path):
            continue

        subdir_total = 0
        file_count = 0

        for filename in sorted(os.listdir(subdir_path)):
            if filename.endswith('.txt'):
                filepath = os.path.join(subdir_path, filename)
                count = count_chinese_in_file(filepath)
                subdir_total += count
                file_count += 1

        print(f"{subdir}: {file_count} 个文件, {subdir_total} 个汉字")
        grand_total += subdir_total

    print(f"\n合计: {grand_total} 个汉字")

if __name__ == '__main__':
    main()
一共是2946354个
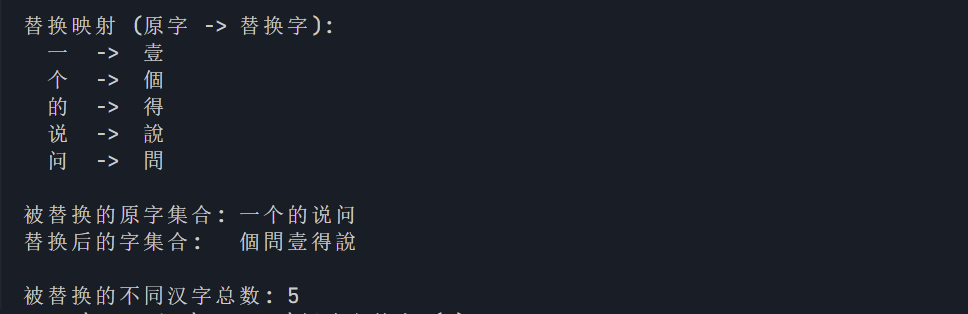
14 分析 Windows 检材,被替换的不同汉字共有多少个?
5
继续脚本分析
import os

original_dir = os.path.join(os.path.dirname(os.path.abspath(__file__)), "爬取-原本")
replaced_dir = os.path.join(os.path.dirname(os.path.abspath(__file__)), "爬取-替换")

# 存储 所有 被替换的 原字 -> 替换字 的映射
replacements = {}  # original_char -> set of replacement_chars
# 存储所有被替换的原字(去重)
replaced_originals = set()
# 存储所有替换后的字(去重)
replacement_chars = set()

def compare_file(orig_path, repl_path):
    """逐字符比较两个文件,找出被替换的汉字"""
    with open(orig_path, 'r', encoding='utf-8') as f:
        orig_text = f.read()
    with open(repl_path, 'r', encoding='utf-8') as f:
        repl_text = f.read()

    min_len = min(len(orig_text), len(repl_text))

    for i in range(min_len):
        o = orig_text[i]
        r = repl_text[i]
        if o != r:
            # 只关注汉字的替换
            if '\u4e00' <= o <= '\u9fff' or '\u3400' <= o <= '\u4dbf':
                replaced_originals.add(o)
                replacement_chars.add(r)
                if o not in replacements:
                    replacements[o] = set()
                replacements[o].add(r)

def main():
    # 遍历所有子目录
    for subdir in sorted(os.listdir(original_dir)):
        subdir_path = os.path.join(original_dir, subdir)
        if not os.path.isdir(subdir_path):
            continue

        repl_subdir_path = os.path.join(replaced_dir, subdir)
        if not os.path.isdir(repl_subdir_path):
            continue

        for filename in sorted(os.listdir(subdir_path)):
            if not filename.endswith('.txt'):
                continue
            orig_file = os.path.join(subdir_path, filename)
            repl_file = os.path.join(repl_subdir_path, filename)
            if os.path.exists(repl_file):
                compare_file(orig_file, repl_file)

    # 输出结果
    print("=" * 60)
    print(f"被替换的不同汉字共有: {len(replaced_originals)} 个")
    print("=" * 60)
    print("\n替换映射 (原字 -> 替换字):")
    for orig in sorted(replaced_originals):
        repls = replacements[orig]
        repl_str = ", ".join(sorted(repls))
        print(f"  {orig}  ->  {repl_str}")

    print(f"\n被替换的原字集合: {''.join(sorted(replaced_originals))}")
    print(f"替换后的字集合:   {''.join(sorted(replacement_chars))}")
    print(f"\n被替换的不同汉字总数: {len(replaced_originals)}")

if __name__ == '__main__':
    main()
一共5个
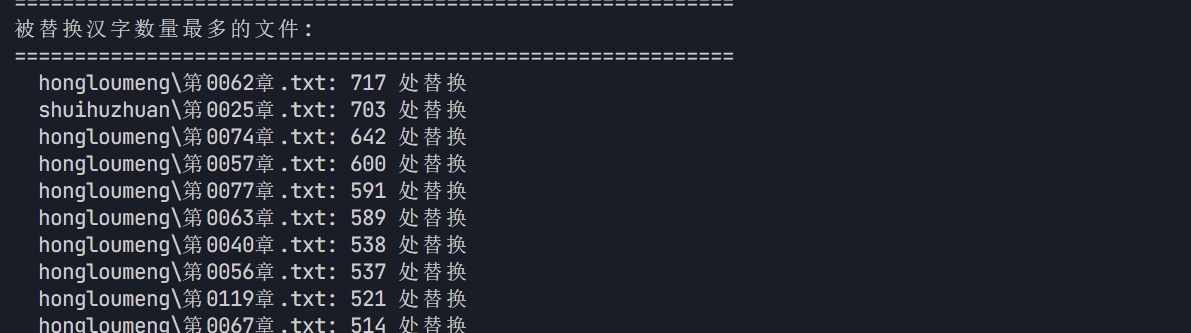
15 分析 Windows 检材,被替换汉字数量最多的文件名称是什么?
第0062章.txt
继续ai分析
import os

original_dir = os.path.join(os.path.dirname(os.path.abspath(__file__)), "爬取-原本")
replaced_dir = os.path.join(os.path.dirname(os.path.abspath(__file__)), "爬取-替换")

# 存储每个文件的替换次数
file_counts = {}  # relative_path -> count

def compare_file(orig_path, repl_path, rel_path):
    """逐字符比较两个文件,找出被替换的汉字"""
    with open(orig_path, 'r', encoding='utf-8') as f:
        orig_text = f.read()
    with open(repl_path, 'r', encoding='utf-8') as f:
        repl_text = f.read()

    min_len = min(len(orig_text), len(repl_text))
    count = 0

    for i in range(min_len):
        o = orig_text[i]
        r = repl_text[i]
        if o != r:
            # 只关注汉字的替换
            if '\u4e00' <= o <= '\u9fff' or '\u3400' <= o <= '\u4dbf':
                count += 1

    file_counts[rel_path] = count

def main():
    # 遍历所有子目录
    for subdir in sorted(os.listdir(original_dir)):
        subdir_path = os.path.join(original_dir, subdir)
        if not os.path.isdir(subdir_path):
            continue

        repl_subdir_path = os.path.join(replaced_dir, subdir)
        if not os.path.isdir(repl_subdir_path):
            continue

        for filename in sorted(os.listdir(subdir_path)):
            if not filename.endswith('.txt'):
                continue
            orig_file = os.path.join(subdir_path, filename)
            repl_file = os.path.join(repl_subdir_path, filename)
            if os.path.exists(repl_file):
                rel_path = os.path.join(subdir, filename)
                compare_file(orig_file, repl_file, rel_path)

    # 找出被替换汉字数量最多的文件
    print("\n" + "=" * 60)
    print("被替换汉字数量最多的文件:")
    print("=" * 60)
    sorted_files = sorted(file_counts.items(), key=lambda x: x[1], reverse=True)
    for rel_path, count in sorted_files[:10]:
        print(f"  {rel_path}: {count} 处替换")

    top_file, top_count = sorted_files[0]
    print(f"\n被替换汉字数量最多的文件: {top_file} ({top_count} 处替换)")

if __name__ == '__main__':
    main()
可以看到是第0062章最多
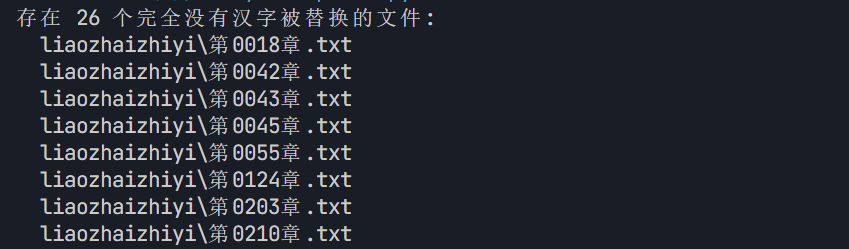
16 分析 Windows 检材,是否存在完全没有汉字被替换的文件?
26
脚本分析
import os

original_dir = os.path.join(os.path.dirname(os.path.abspath(__file__)), "爬取-原本")
replaced_dir = os.path.join(os.path.dirname(os.path.abspath(__file__)), "爬取-替换")

# 存储每个文件的替换次数
file_counts = {}  # relative_path -> count

def compare_file(orig_path, repl_path, rel_path):
    """逐字符比较两个文件,找出被替换的汉字"""
    with open(orig_path, 'r', encoding='utf-8') as f:
        orig_text = f.read()
    with open(repl_path, 'r', encoding='utf-8') as f:
        repl_text = f.read()

    min_len = min(len(orig_text), len(repl_text))
    count = 0

    for i in range(min_len):
        o = orig_text[i]
        r = repl_text[i]
        if o != r:
            # 只关注汉字的替换
            if '\u4e00' <= o <= '\u9fff' or '\u3400' <= o <= '\u4dbf':
                count += 1

    file_counts[rel_path] = count

def main():
    # 遍历所有子目录
    for subdir in sorted(os.listdir(original_dir)):
        subdir_path = os.path.join(original_dir, subdir)
        if not os.path.isdir(subdir_path):
            continue

        repl_subdir_path = os.path.join(replaced_dir, subdir)
        if not os.path.isdir(repl_subdir_path):
            continue

        for filename in sorted(os.listdir(subdir_path)):
            if not filename.endswith('.txt'):
                continue
            orig_file = os.path.join(subdir_path, filename)
            repl_file = os.path.join(repl_subdir_path, filename)
            if os.path.exists(repl_file):
                rel_path = os.path.join(subdir, filename)
                compare_file(orig_file, repl_file, rel_path)

    # 检查是否存在完全没有汉字被替换的文件
    zero_files = [k for k, v in file_counts.items() if v == 0]

    if zero_files:
        print(f"存在 {len(zero_files)} 个完全没有汉字被替换的文件:")
        for f in zero_files:
            print(f"  {f}")
    else:
        print("不存在完全没有汉字被替换的文件")

if __name__ == '__main__':
    main()
可以看到有26个
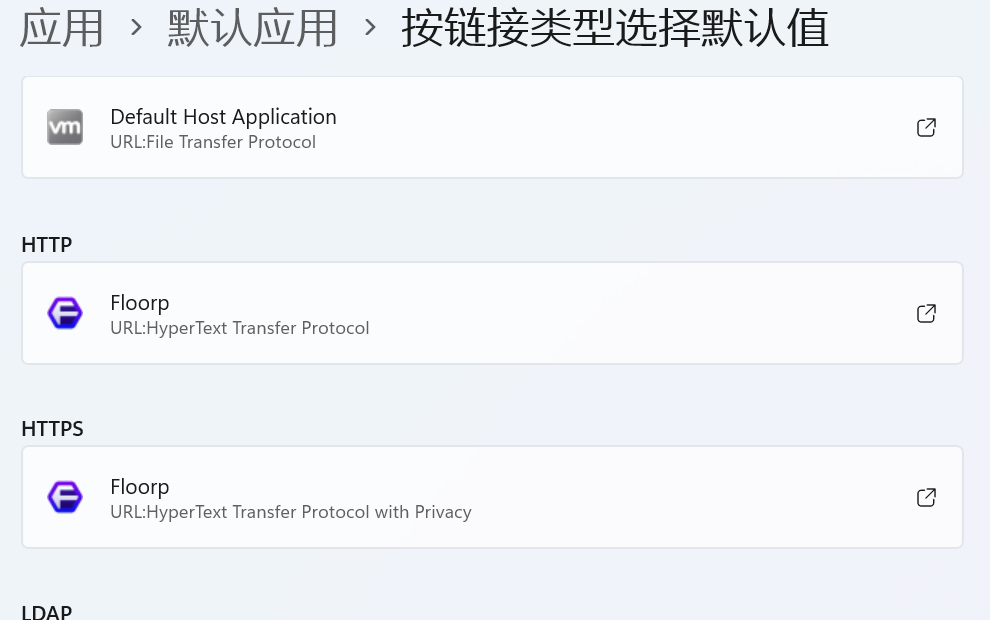
17 分析 Windows 检材,嫌疑人使用的默认浏览器名称是什么?
Floorp(Ablaze Floorp)
在设置中查看一下
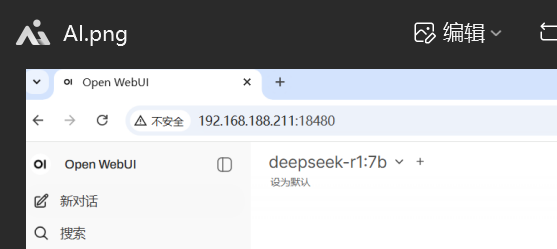
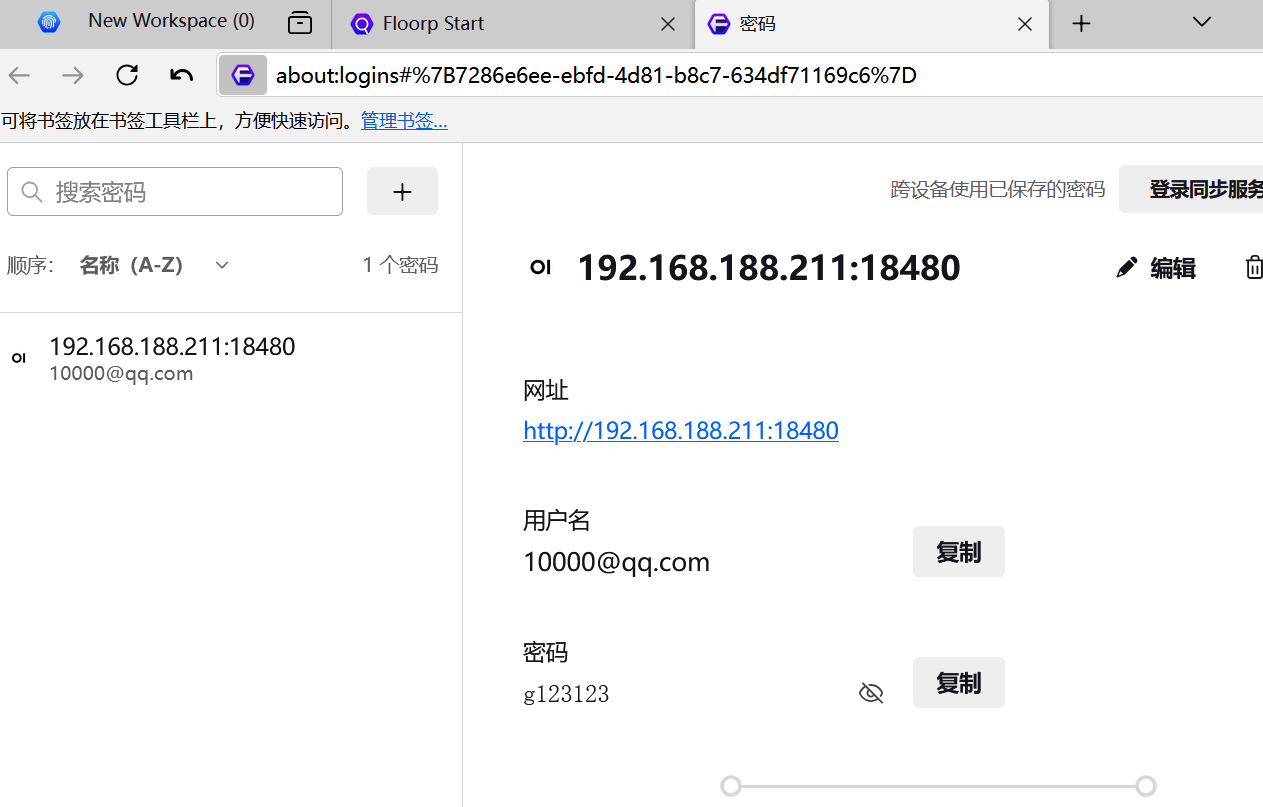
18 分析 Windows 检材,嫌疑人使用的 AI 网站端口是多少?
18480
桌面上有个AI.png,打开看一下
19 分析 Windows 检材,嫌疑人使用的 AI 网站登录密码是多少?
g123123
在floorp中可以看到
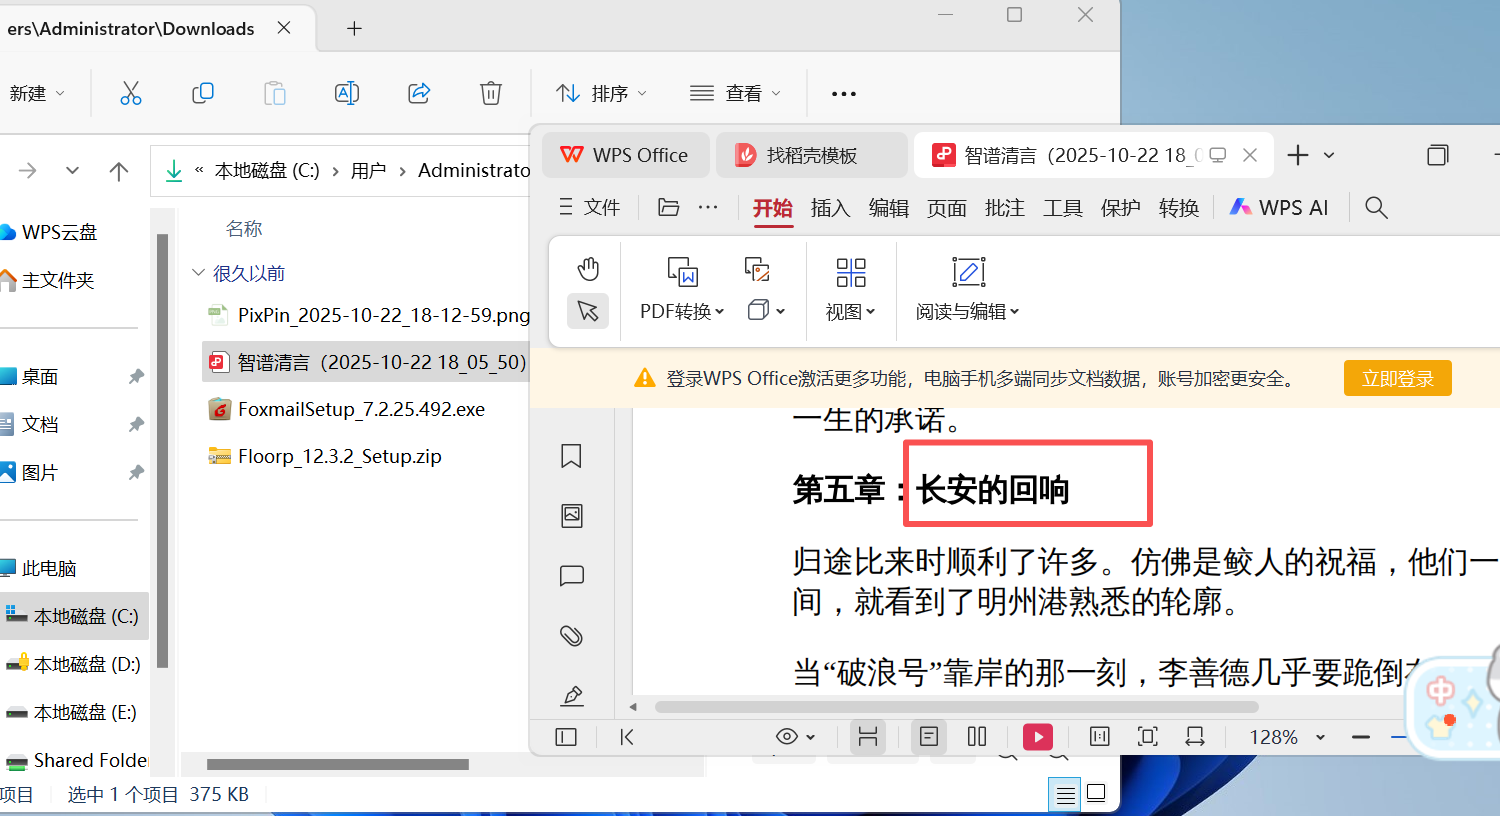
20 分析 Windows 检材,嫌疑人创作的小说第五章标题是什么?
长安的回响
这个翻文件肯定能翻到,就在下载中有个很显眼的pdf
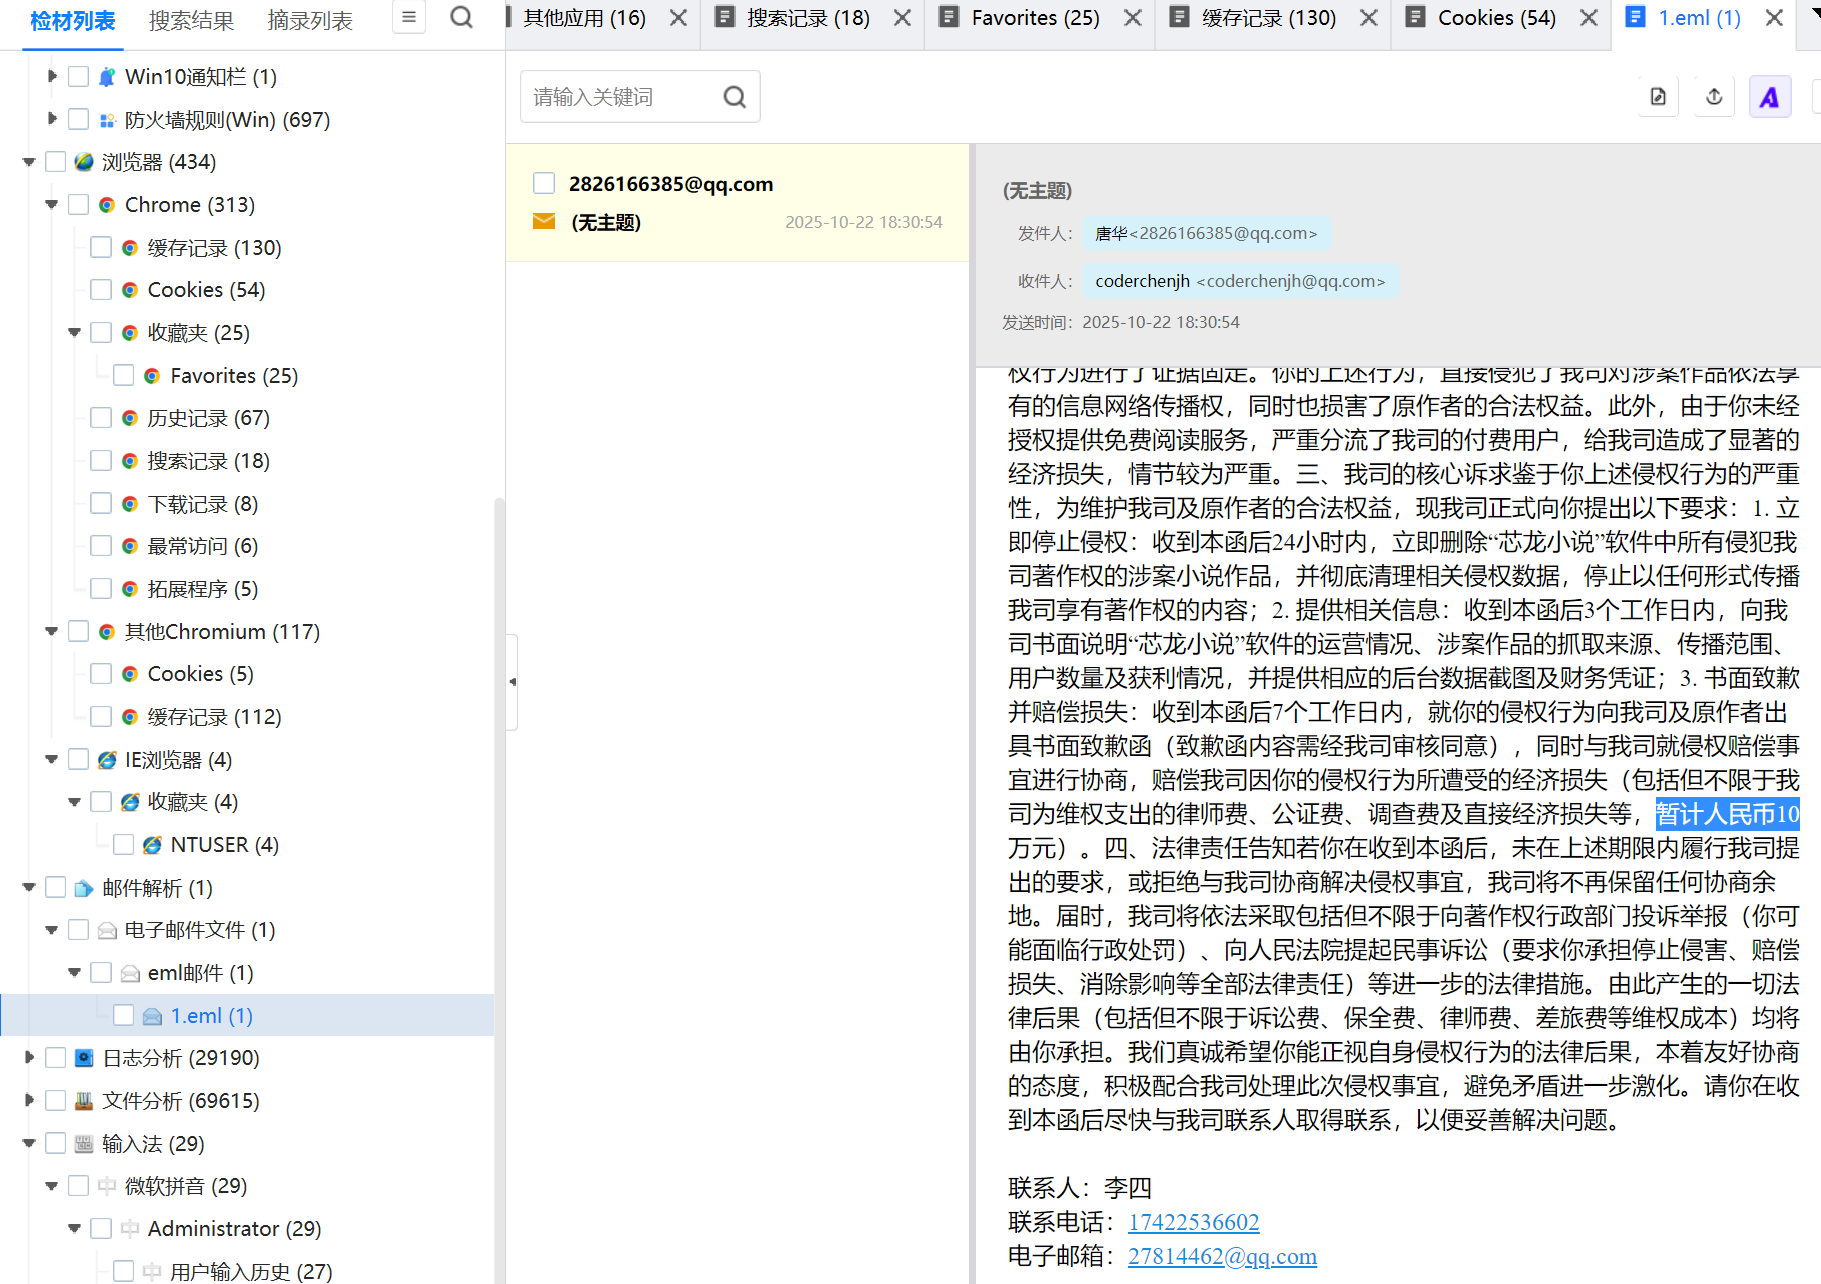
21 分析 Windows 检材,终点小说要求赔偿的金额是多少万元?
10
在邮件解析中可以看到
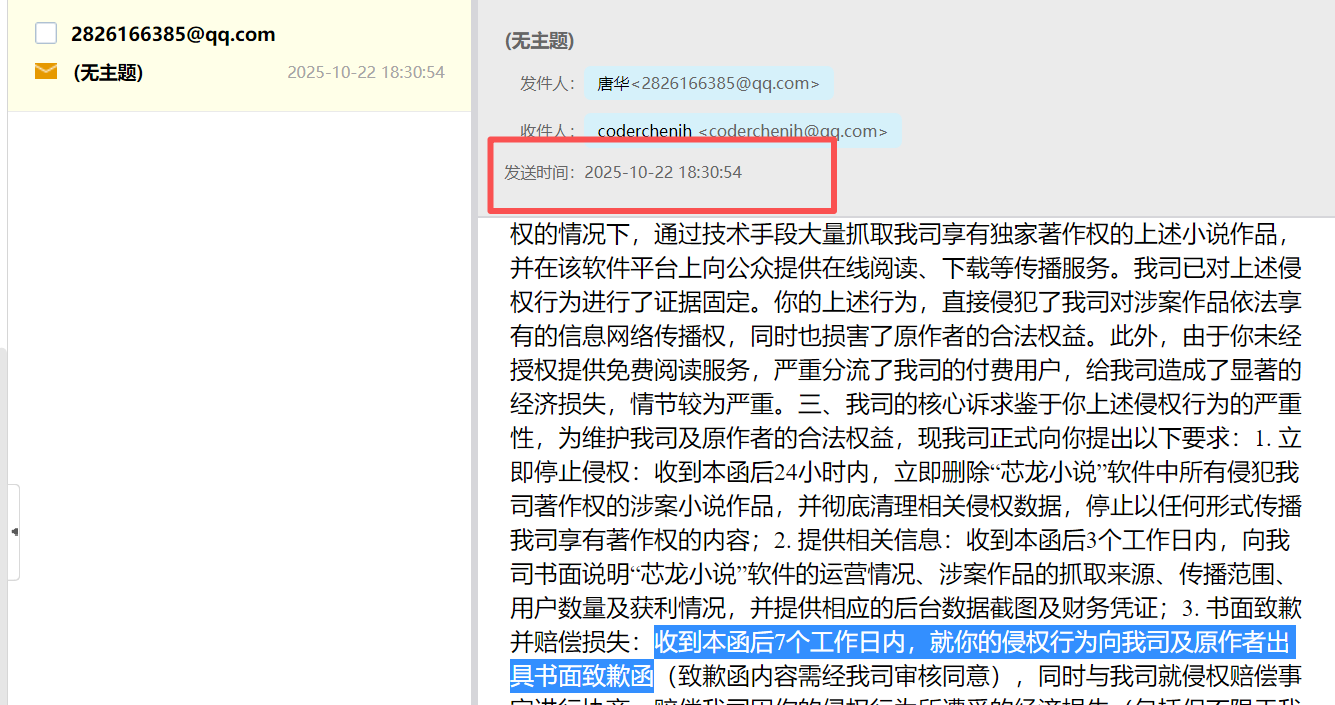
22 分析 Windows 检材,嫌疑人最晚需于几月几日前提交致歉函?
10月29日
见上题邮件
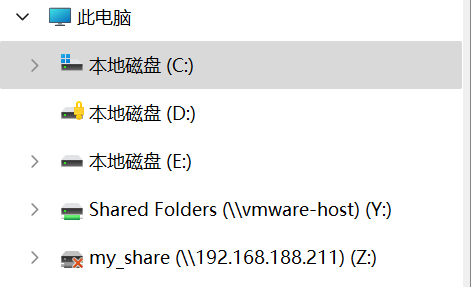
23 分析 Windows 检材,嫌疑人 NAS 映射的盘符是什么?
Z
其实这道题看一眼就知道了
24 分析 Windows 检材,嫌疑人正在阅读的小说名称是什么?
小年小月
桌面上有个阅读器
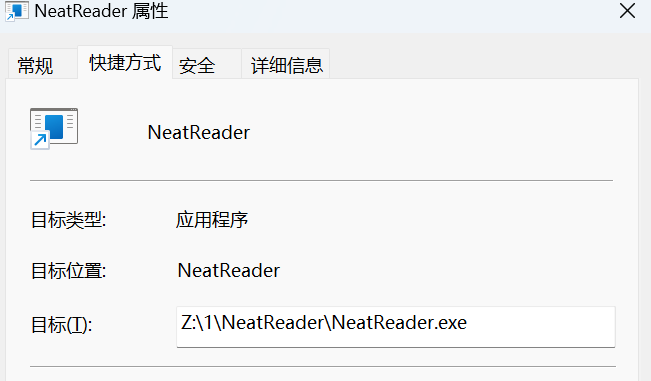
那就得结合nas容器做了,服务器取证好久之前就做完了,可看服务器专项
https://mp.weixin.qq.com/s/BYL3aGLmaoe7ZOEQxMoQog
这里就不复现了,采用另一种做法,去看看软件数据C:\Users\Administrator\AppData\Roaming\NeatReader\bookData\ec345732-6389-450a-965e-f1635a6815e1
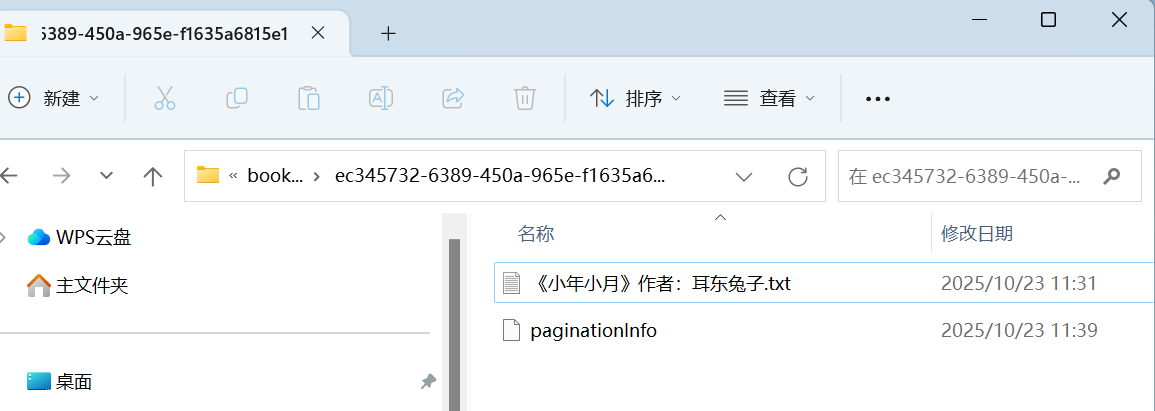
25 分析 Windows 检材,嫌疑人当前阅读到第几章?
第五十一章
这个只能在nas里看了
服务器取证
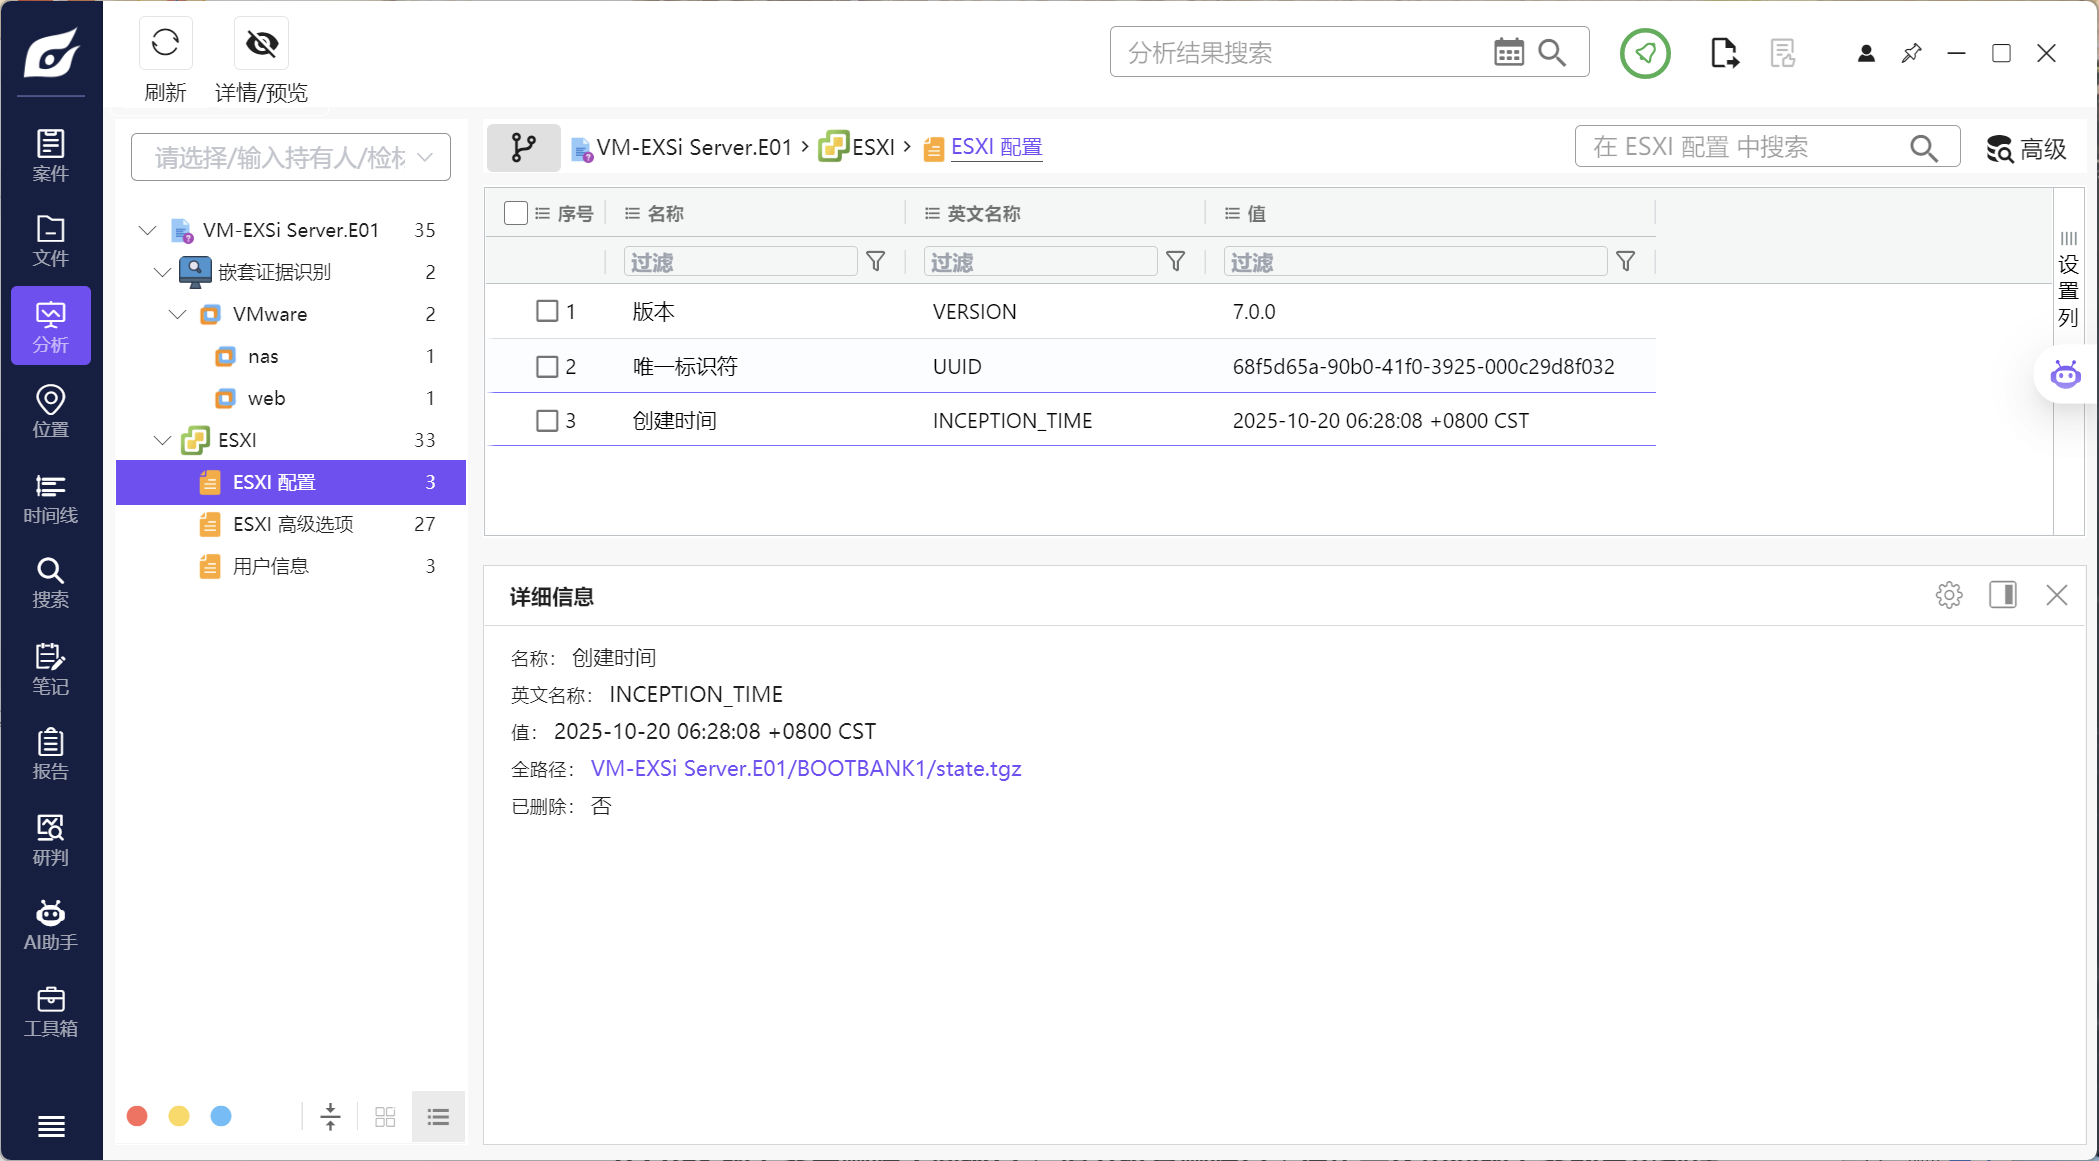
01 Exsi 虚拟化平台是什么时候安装的
20251020-062808
火眼直接分析查看
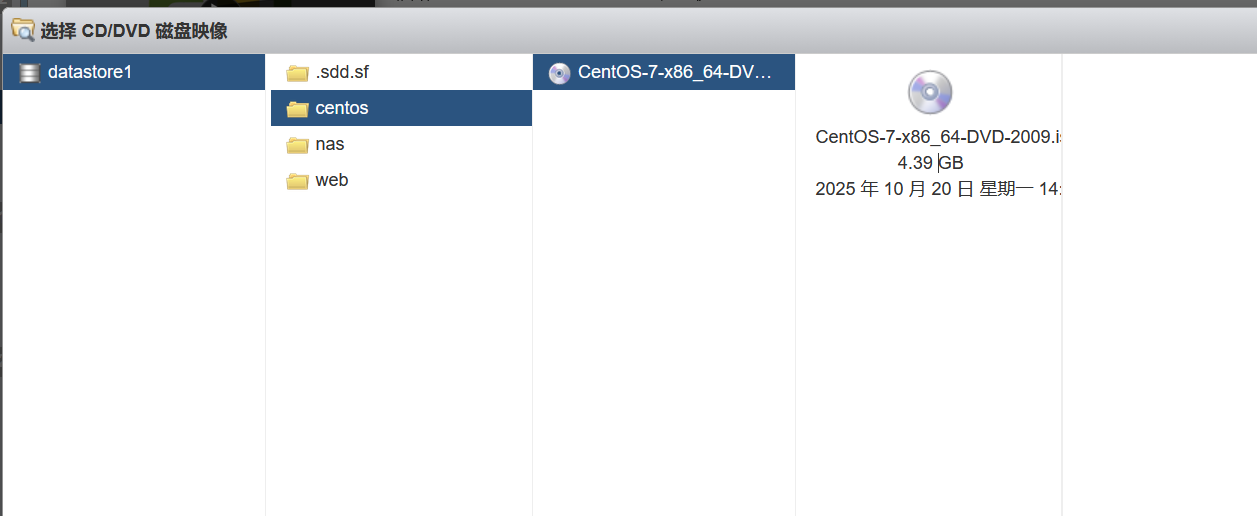
02 Exsi 虚拟化平台虚拟机使用的ISO镜像大小
4.39
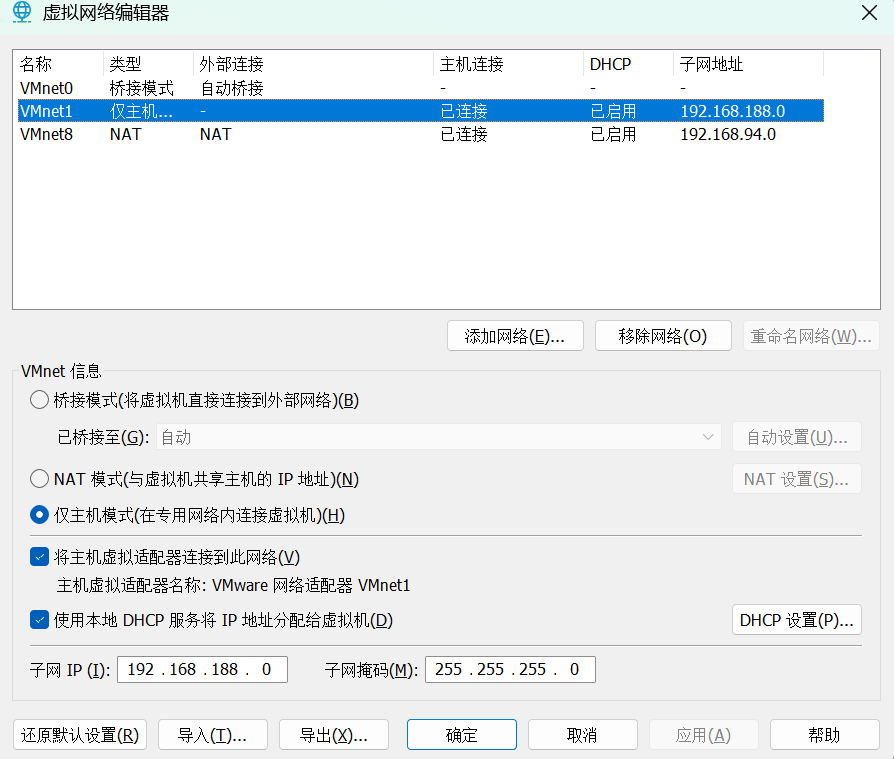
仿真之后发现ip为192.168.188.222
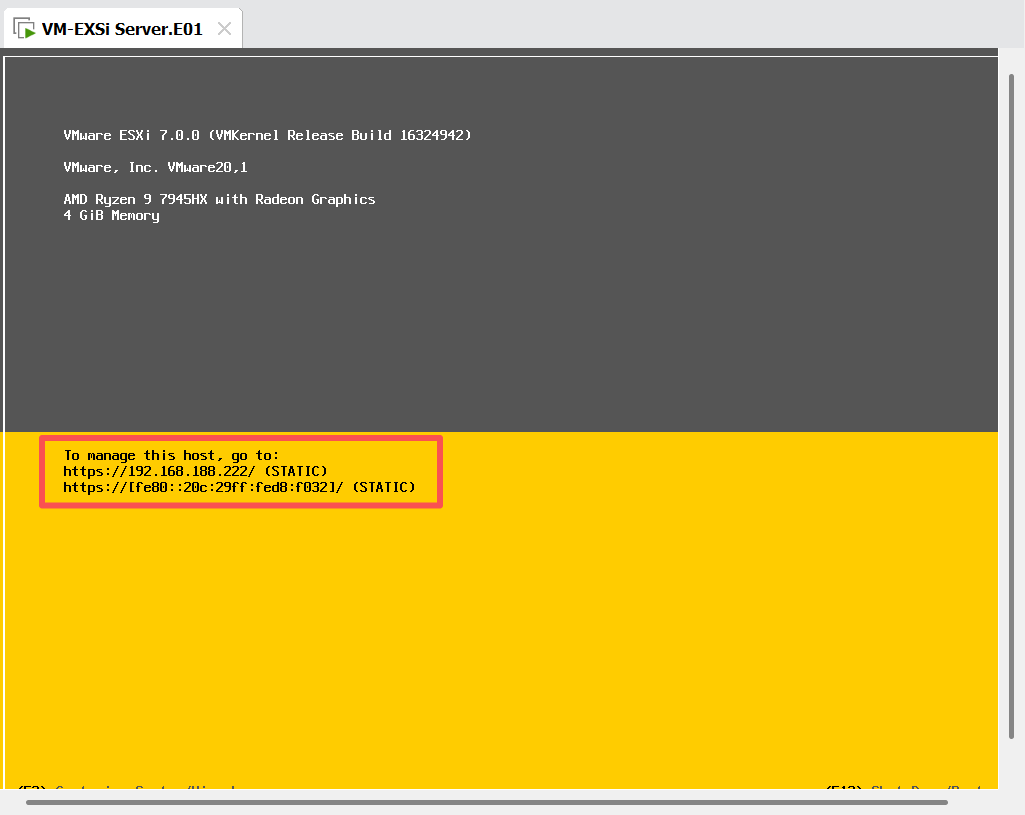
在虚拟网络编辑器这里更改一下网段,改成192.168.188.0
进入管理页面
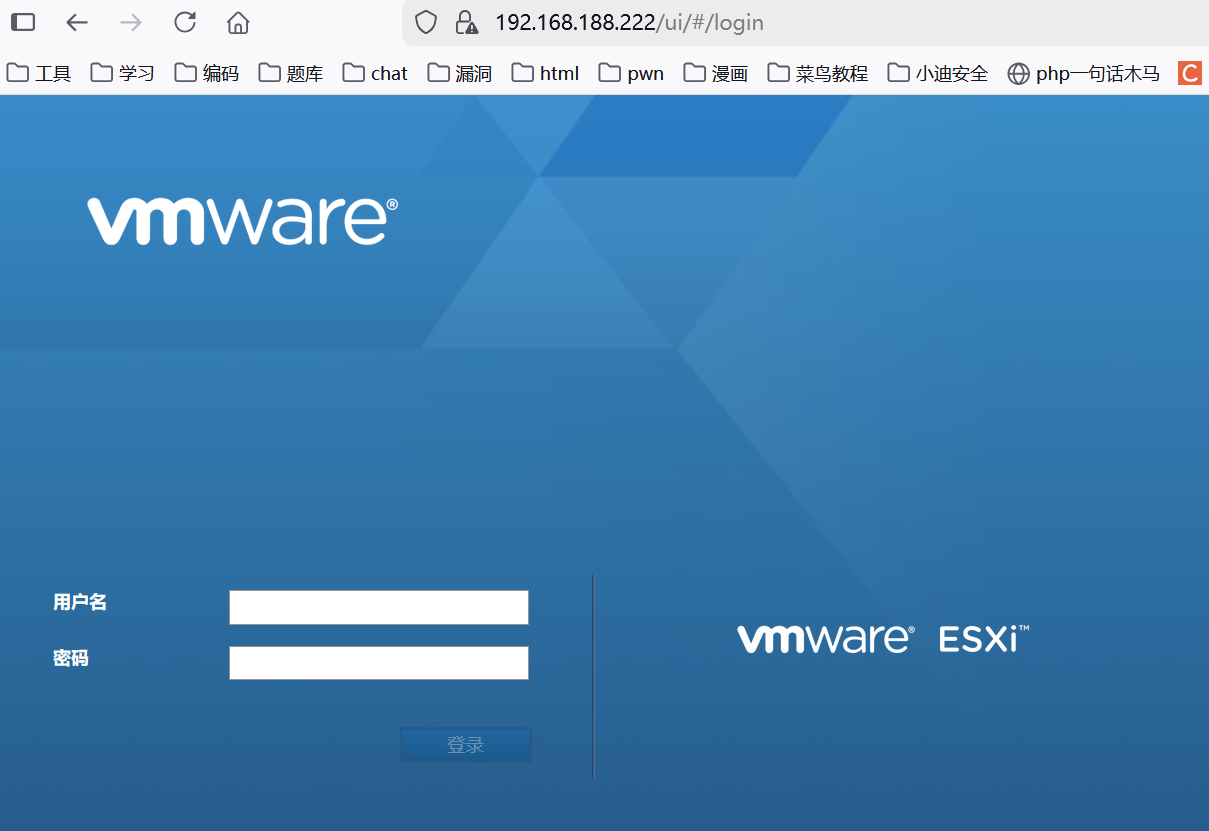
账号root,仿真的时候密码为空
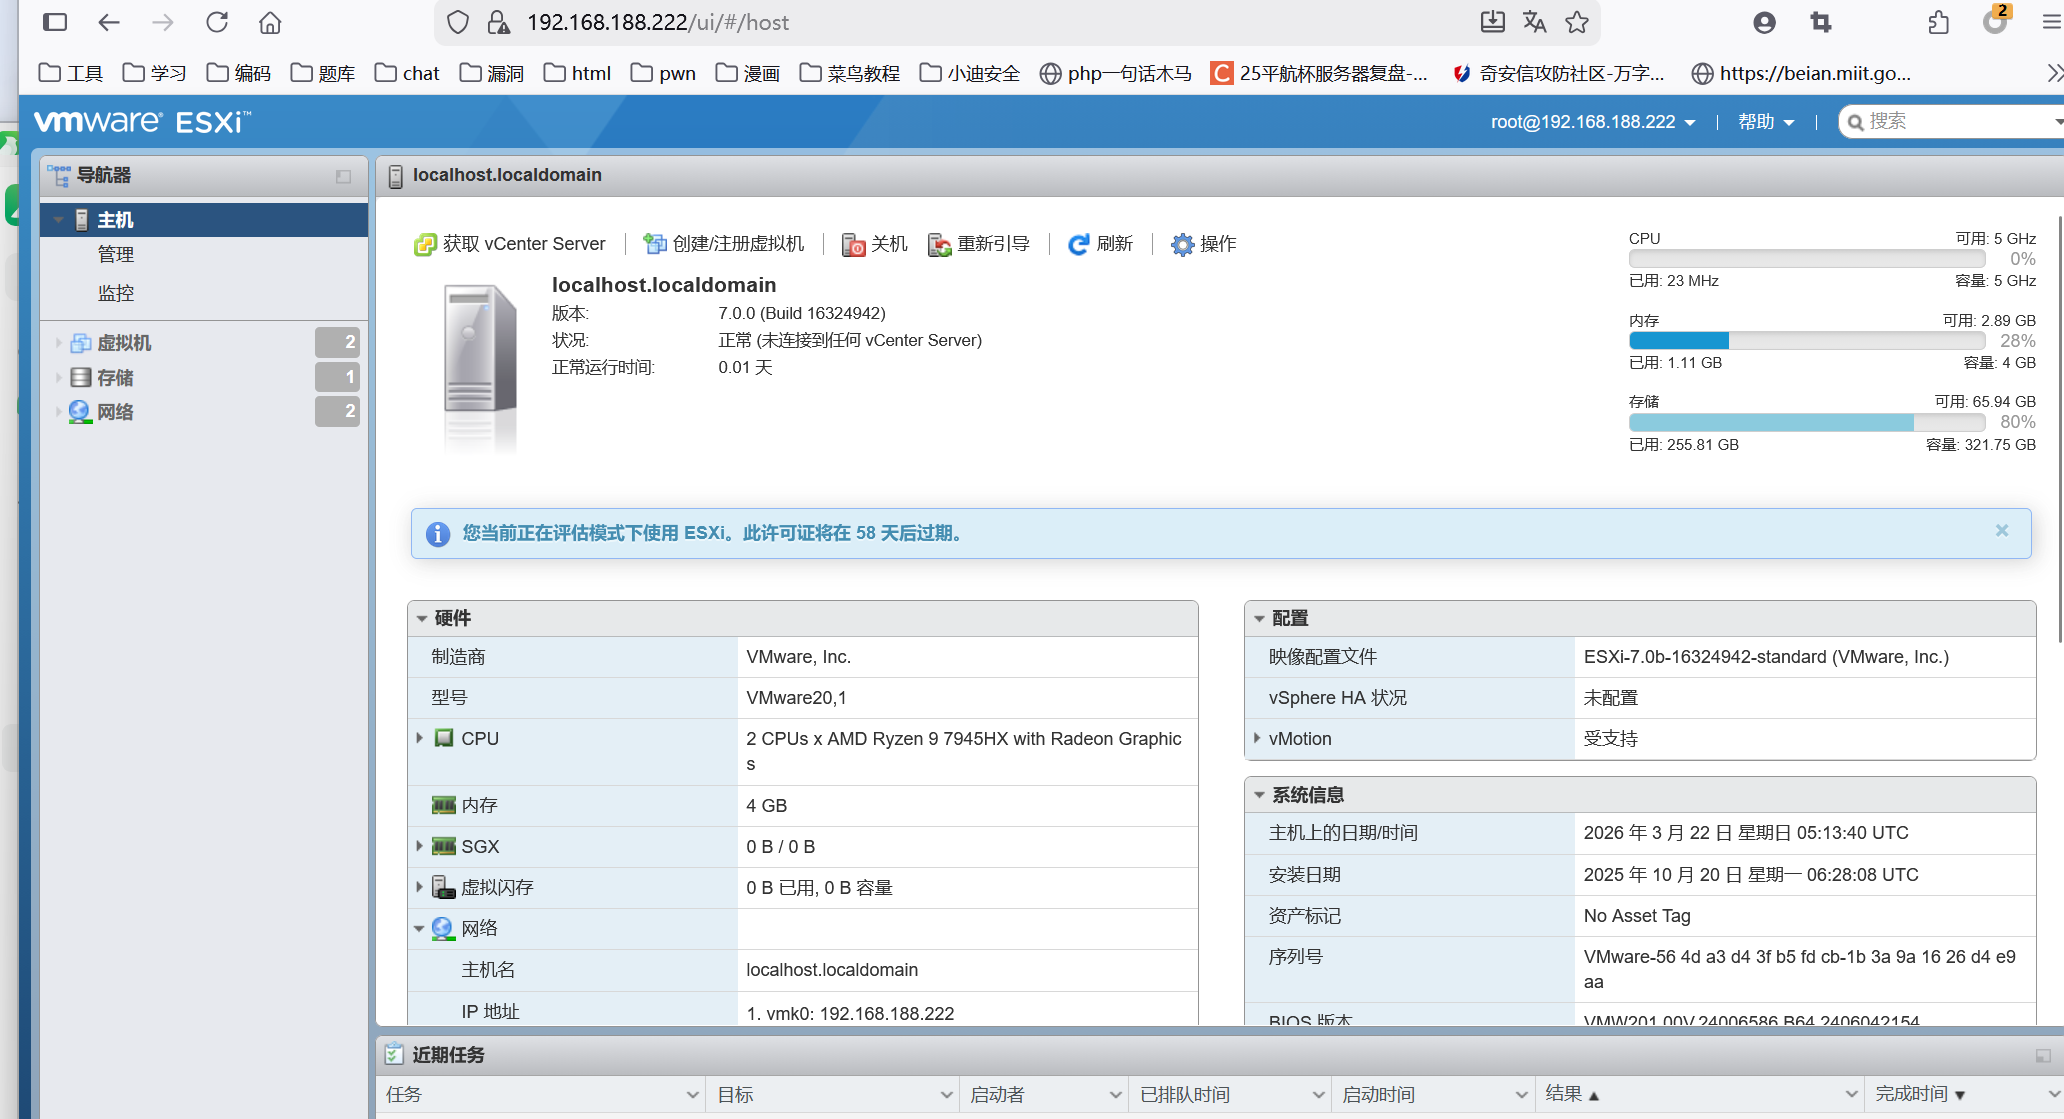
有两个虚拟机,用的同一个镜像,都是centos系统
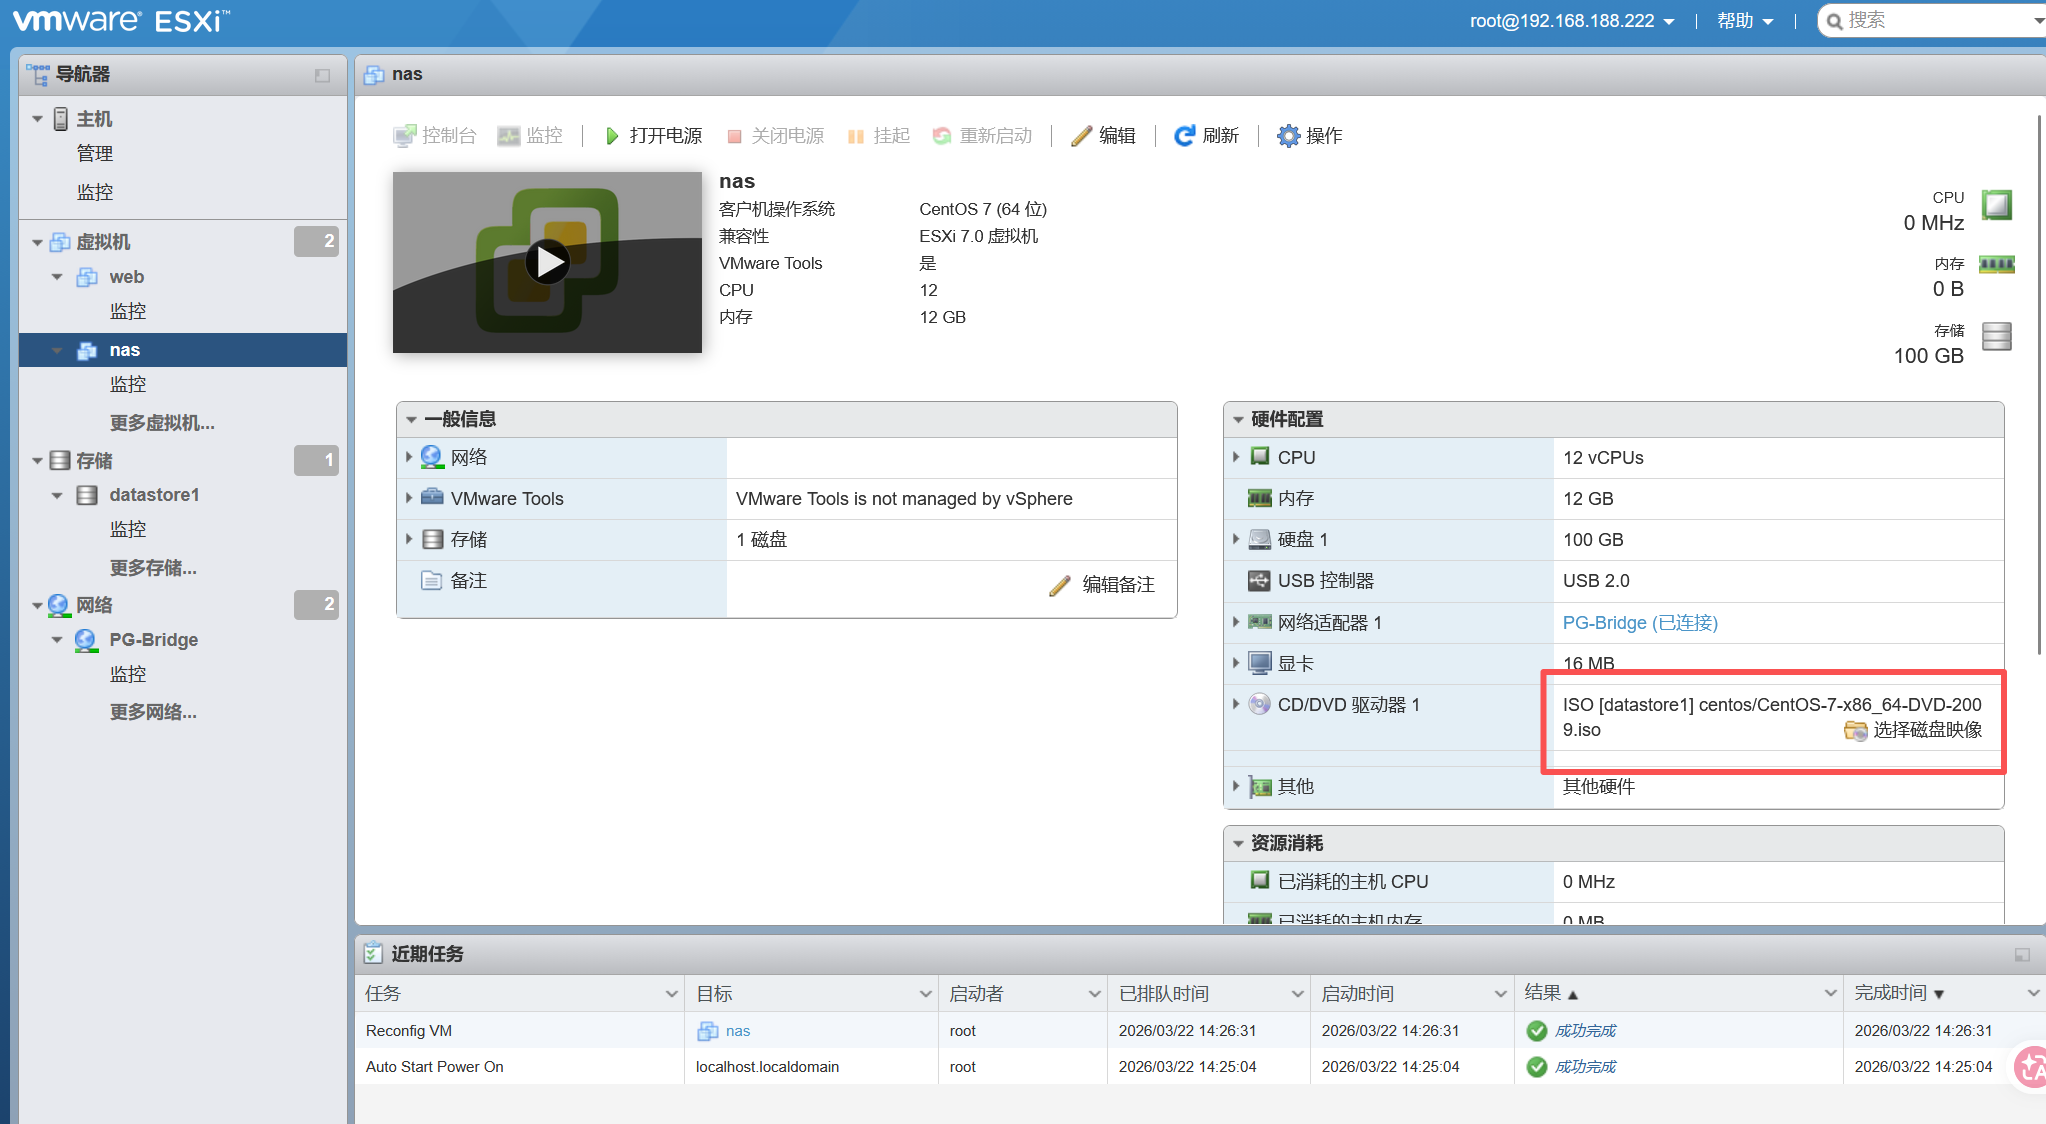
选择磁盘映像,找到iso文件
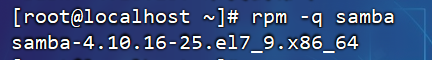
03 nas 服务器samba应用完整版本标识
4.10.16-25.el7_9
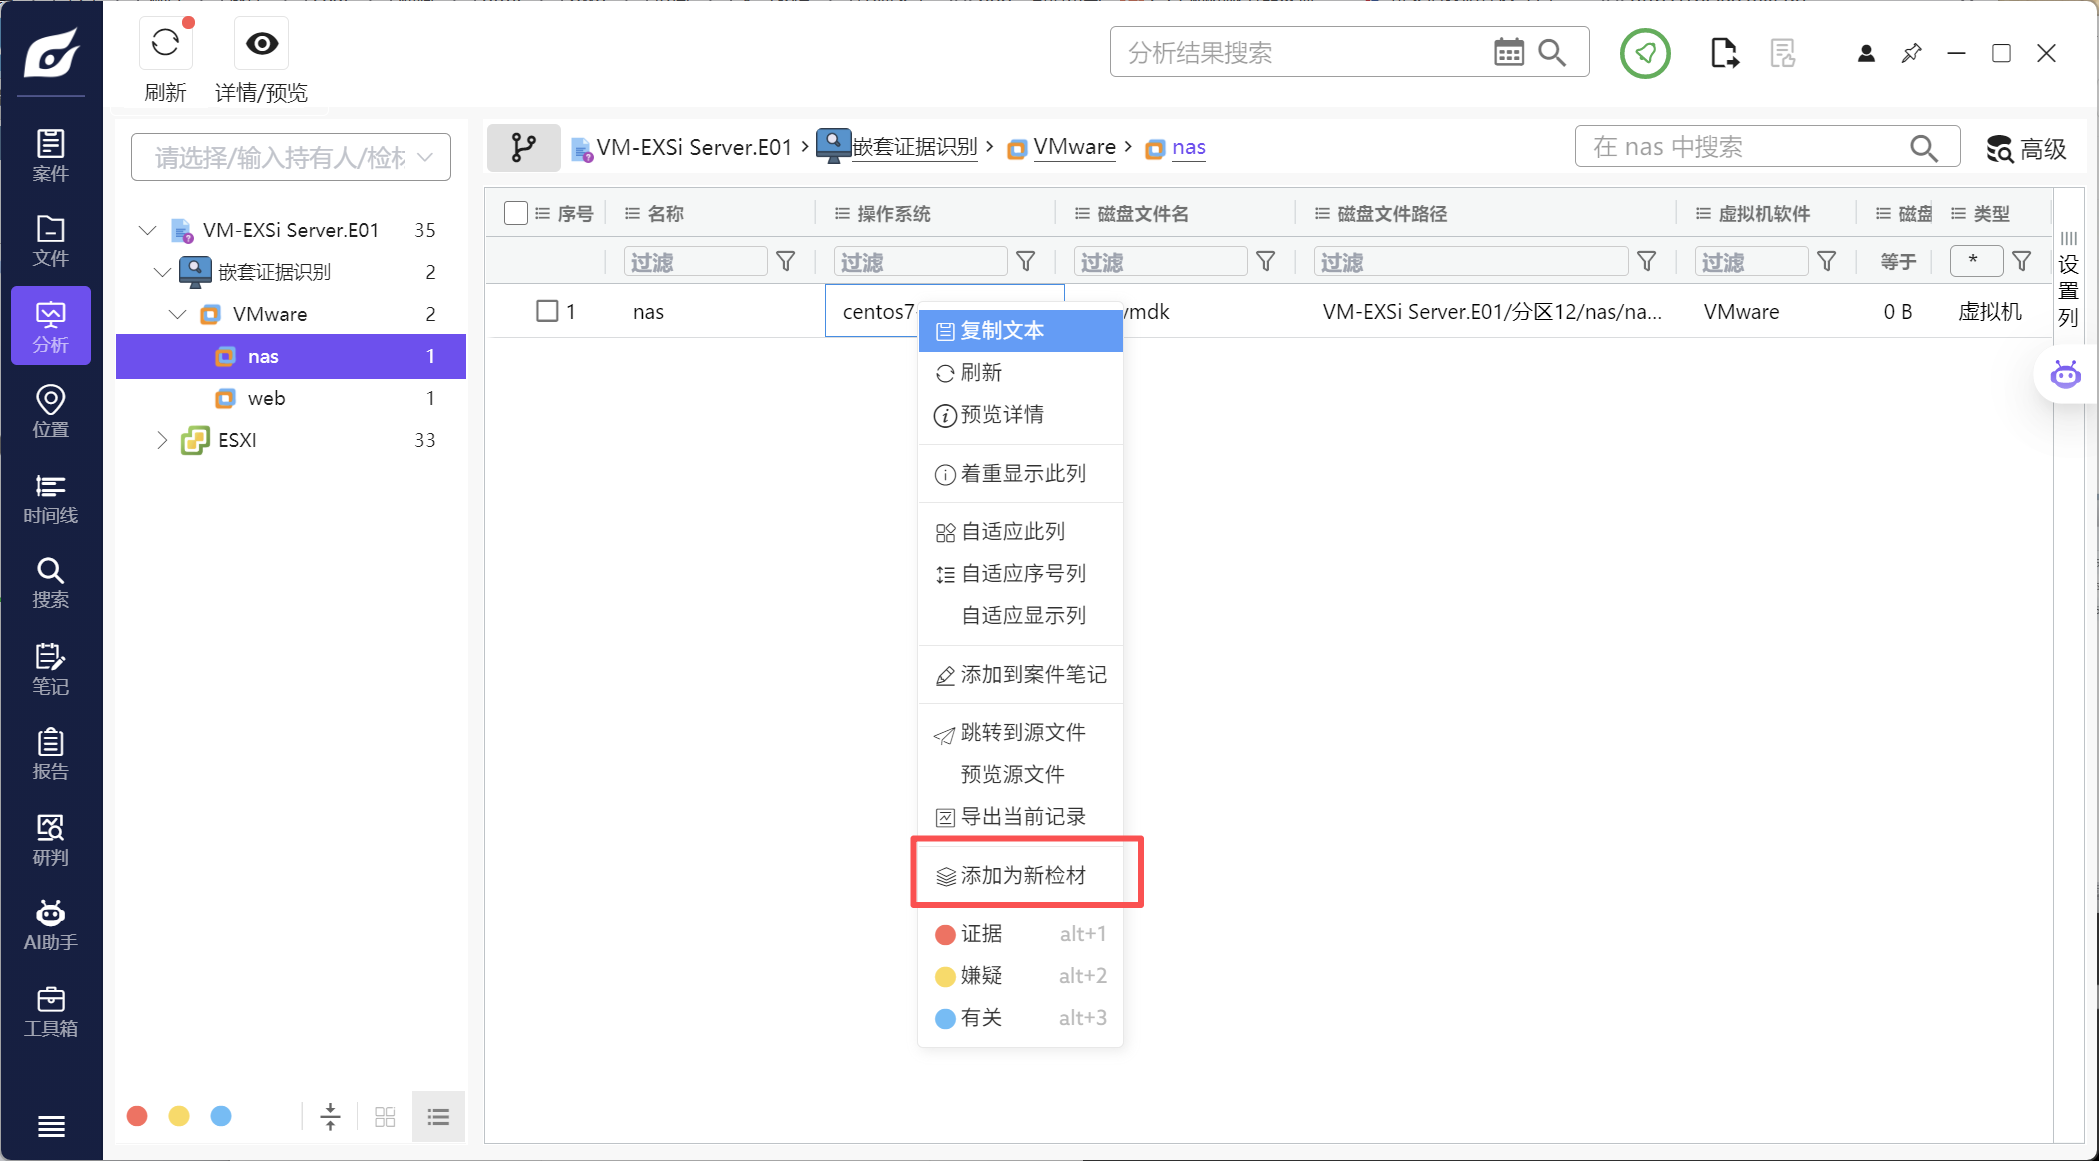
方案一(推荐):
直接在火眼添加新检材仿真,可以直接重置密码
用finalshell连接方便操作
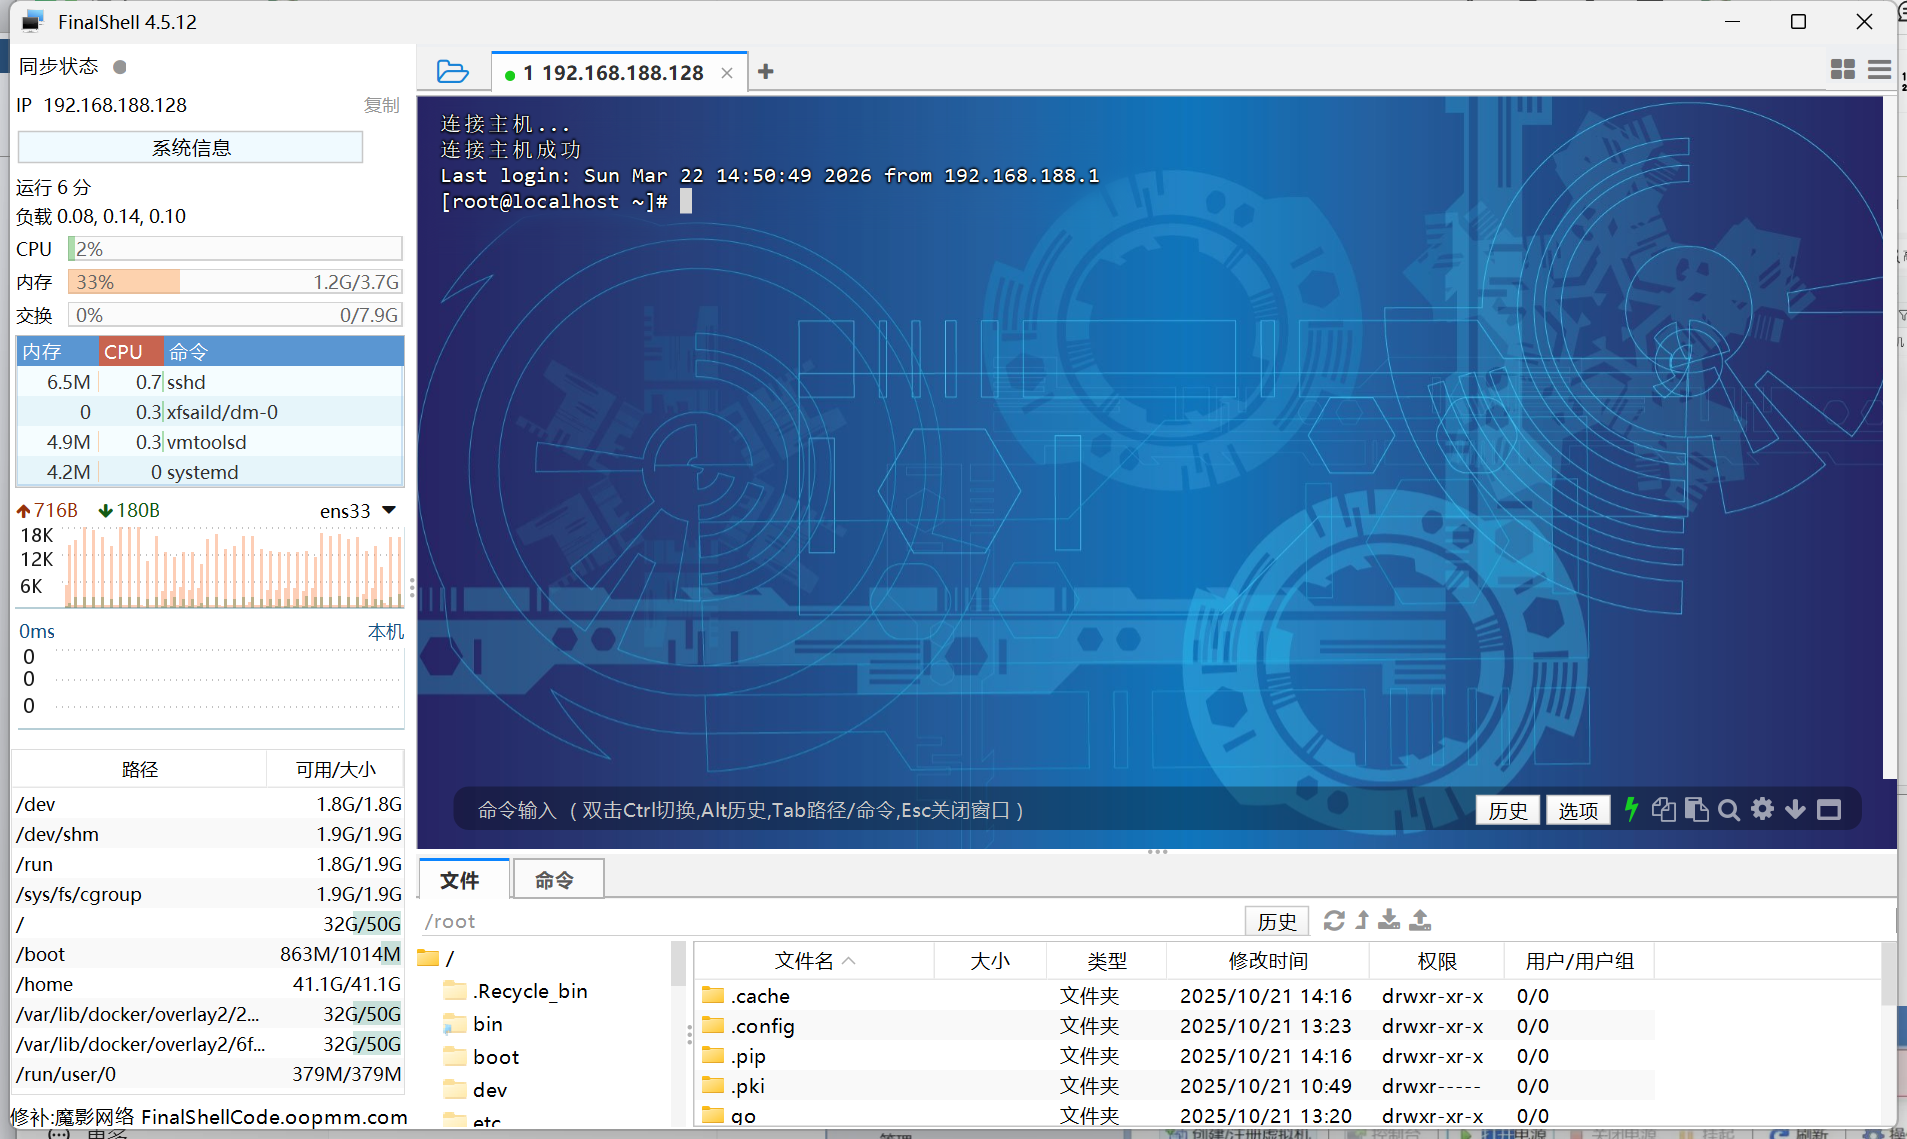
rpm -q samba
方案二(bug多,麻烦):
启动nas虚拟机
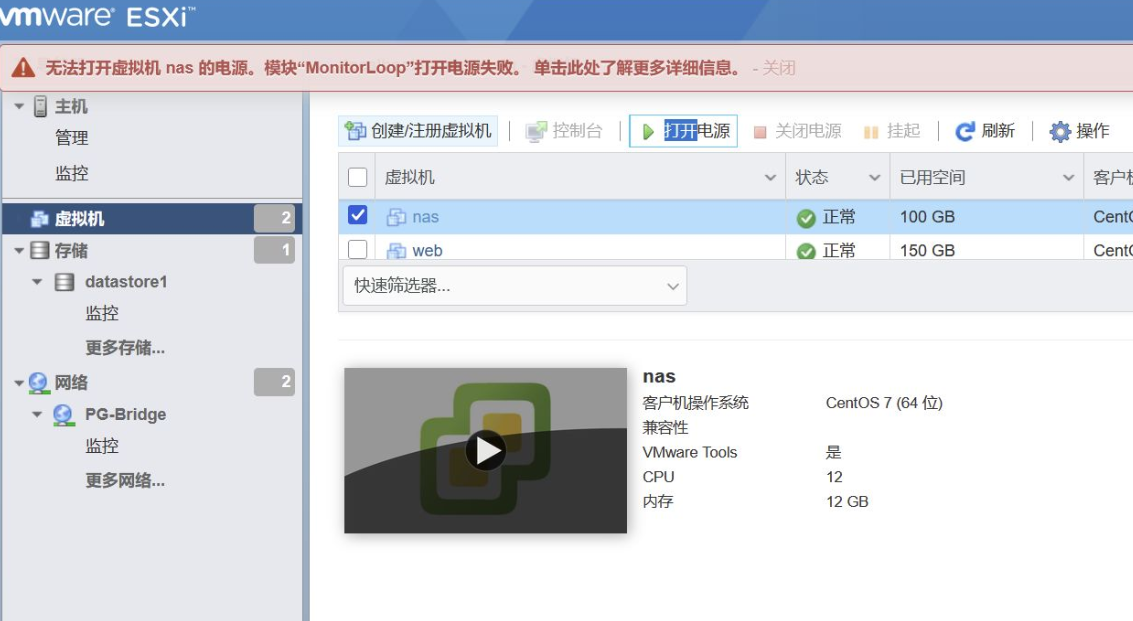
出现报错
失败 - 模块“MonitorLoop”打开电源失败。
错误
模块“MonitorLoop”打开电源失败。
虚拟 CPU 的数目 (12) 多于物理 CPU 的数目 (2)。
无法打开虚拟机电源: 已超出正在运行的 VCPU 数目限制。
无法打开虚拟机电源。
无法启动虚拟机。
编辑一下cpu的数目重新启动
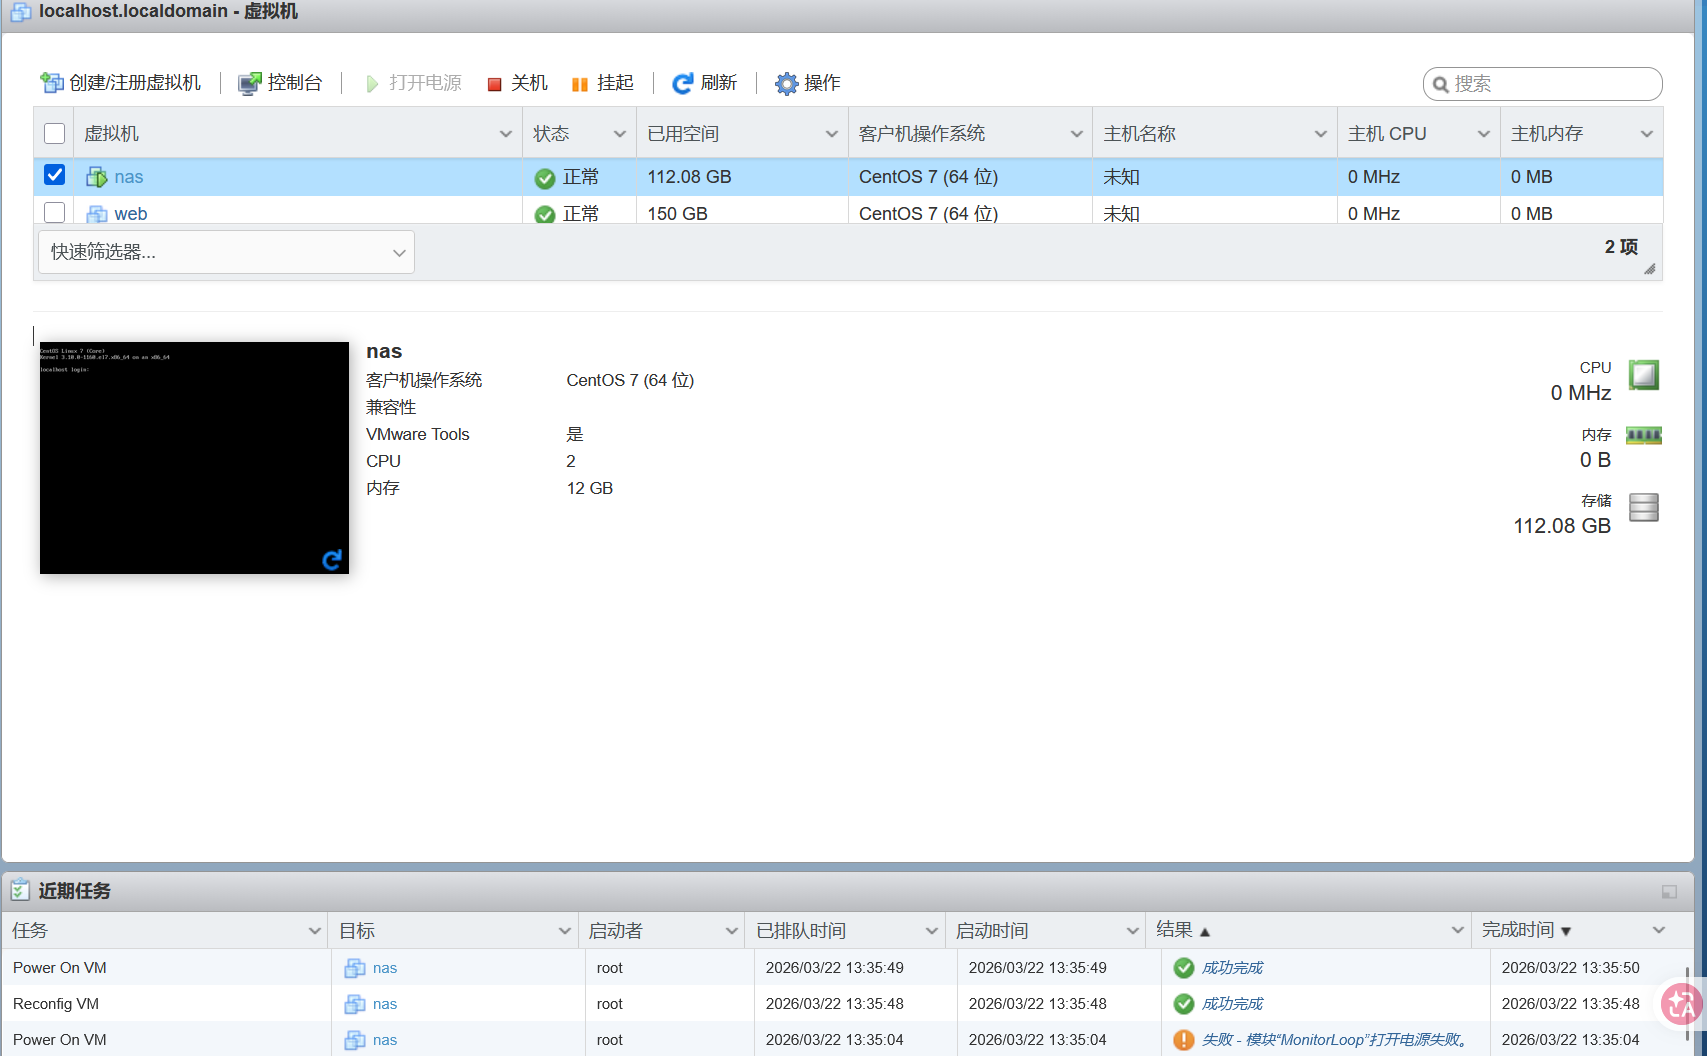
这里不知道账号密码,需要重置一下(图片太多就不做演示了)
- 在 GRUB 菜单中,用箭头键选择 第一行
- 按 e 键进入编辑模式。
- 找到以
linux16开头的行。将光标移动到此行的末尾,先按 空格键,然后添加rd.break。这会让系统在初始化早期进入一个紧急 shell。 - 修改后,按
Ctrl+X或F10启动系统。 - 系统启动后会进入一个紧急模式的 shell,提示符为
switch_root:/#。 - 执行以下命令重新挂载根文件系统为可写:
mount -o remount,rw /sysroot - 切换根目录:
chroot /sysroot - 现在可以修改 root 密码:
passwd root - 输入新密码两次(输入时不会显示,注意大小写)。
- 如果系统启用了 SELinux(默认启用),需要更新文件系统标签:
touch /.autorelabel - 退出 chroot 并重启:
exit、reboot
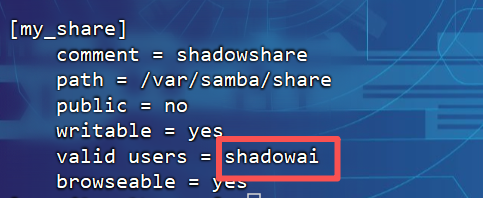
04 nas 服务器samba应用共享目录允许访问的用户名
shadowai
编辑Samba主配置文件,查看每个共享目录的权限设置。
cat /etc/samba/smb.conf
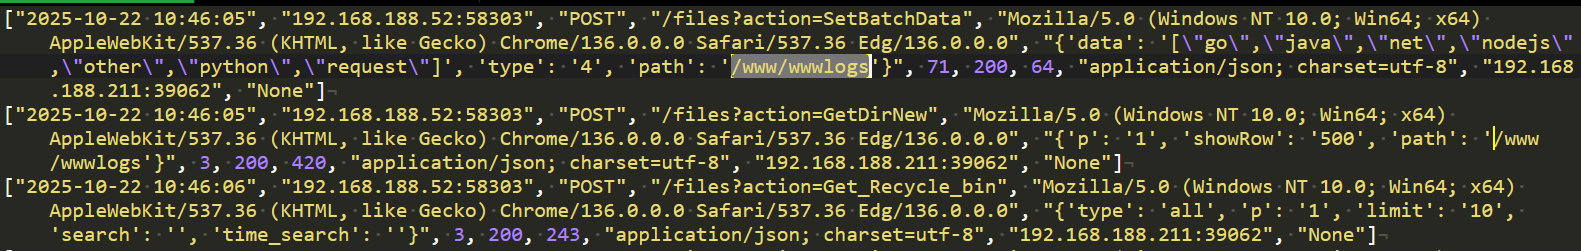
05 nas 服务器中删除了面板日志,请分析其删除日志后第一次访问服务器的目录物理路径
/www/wwwlogs
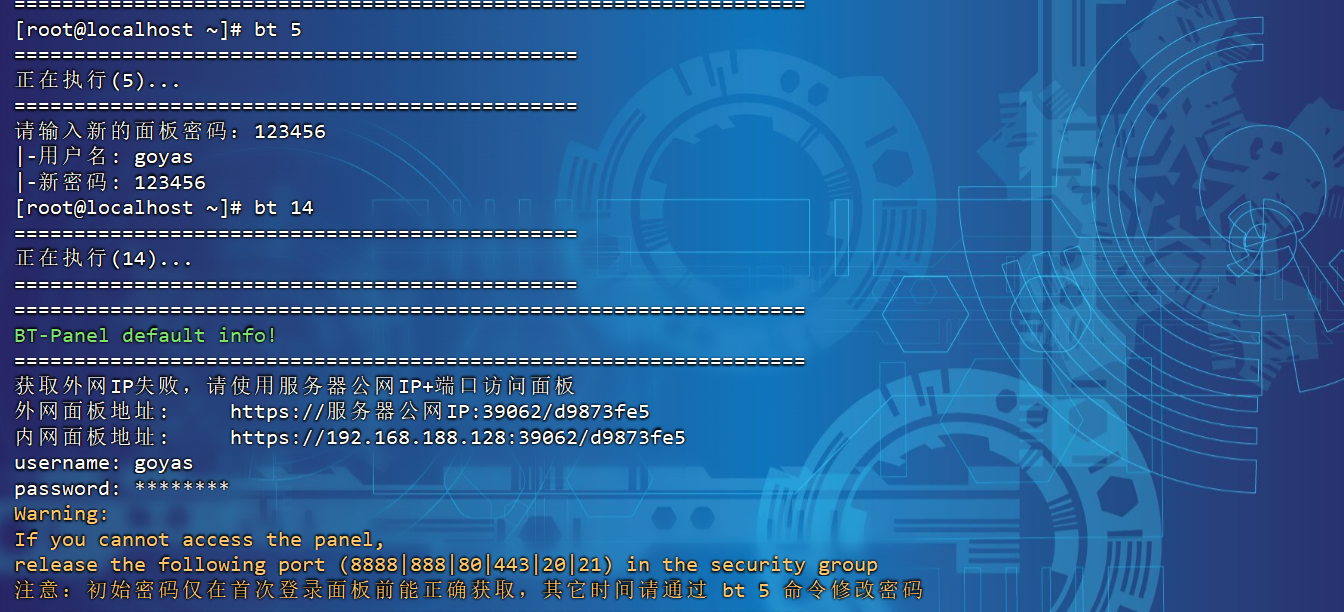
提到了面板,那就打开面板日志看看,注意修改密码
查看面板日志
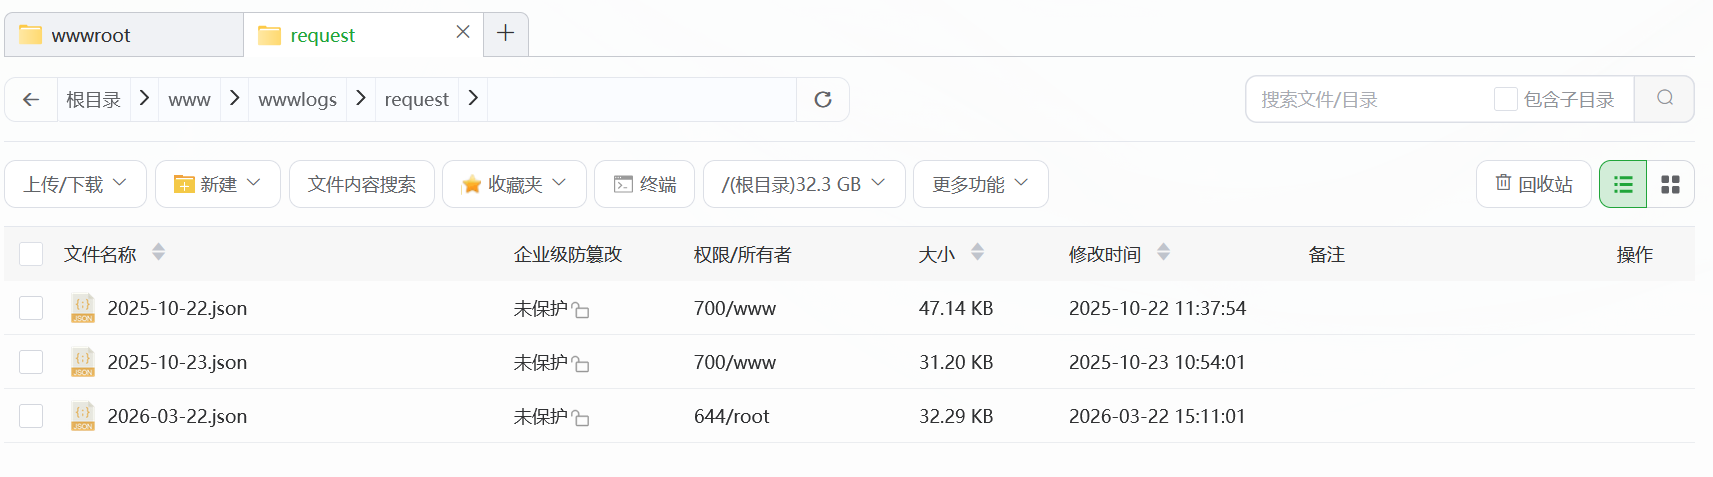
最早的是10月22号的
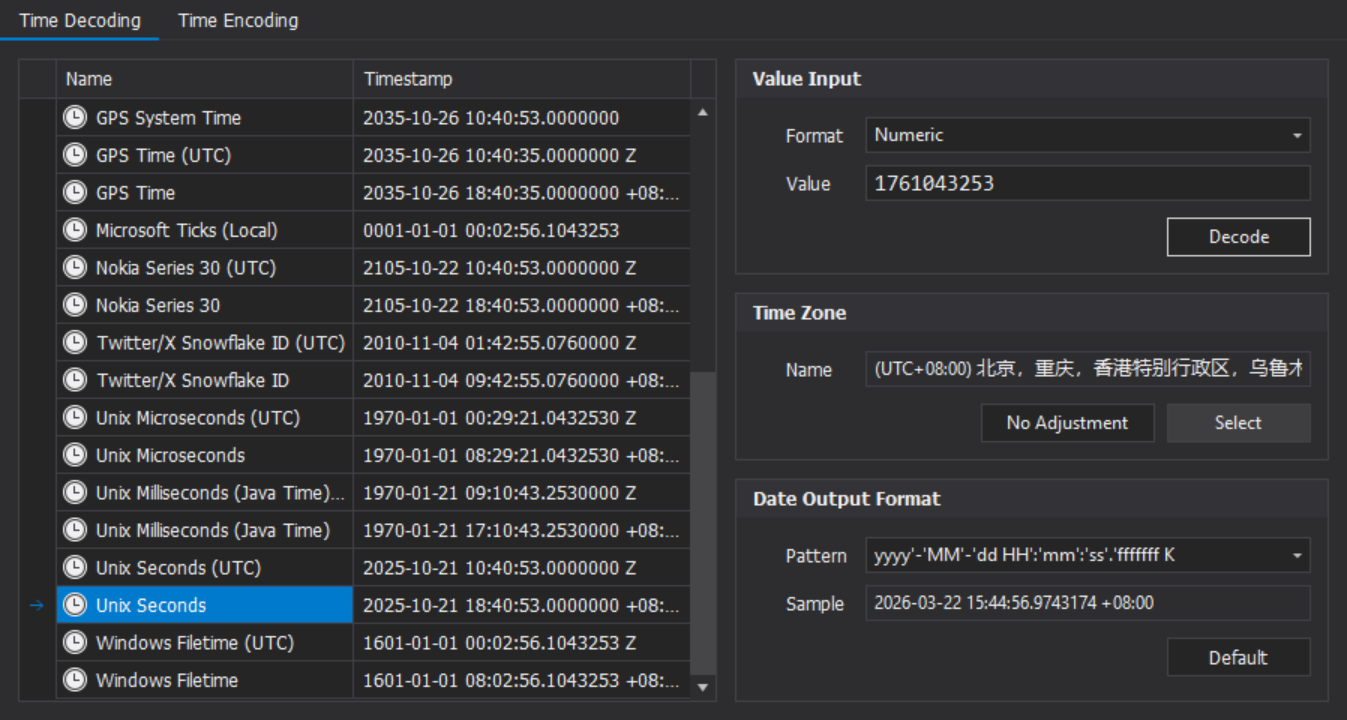
06 某用户在"2025-10-21 18:40:53(北京时间)"向本地AI模型提问,请问其一共提问了几次
2
没有发现网站,但是看到了docker容器
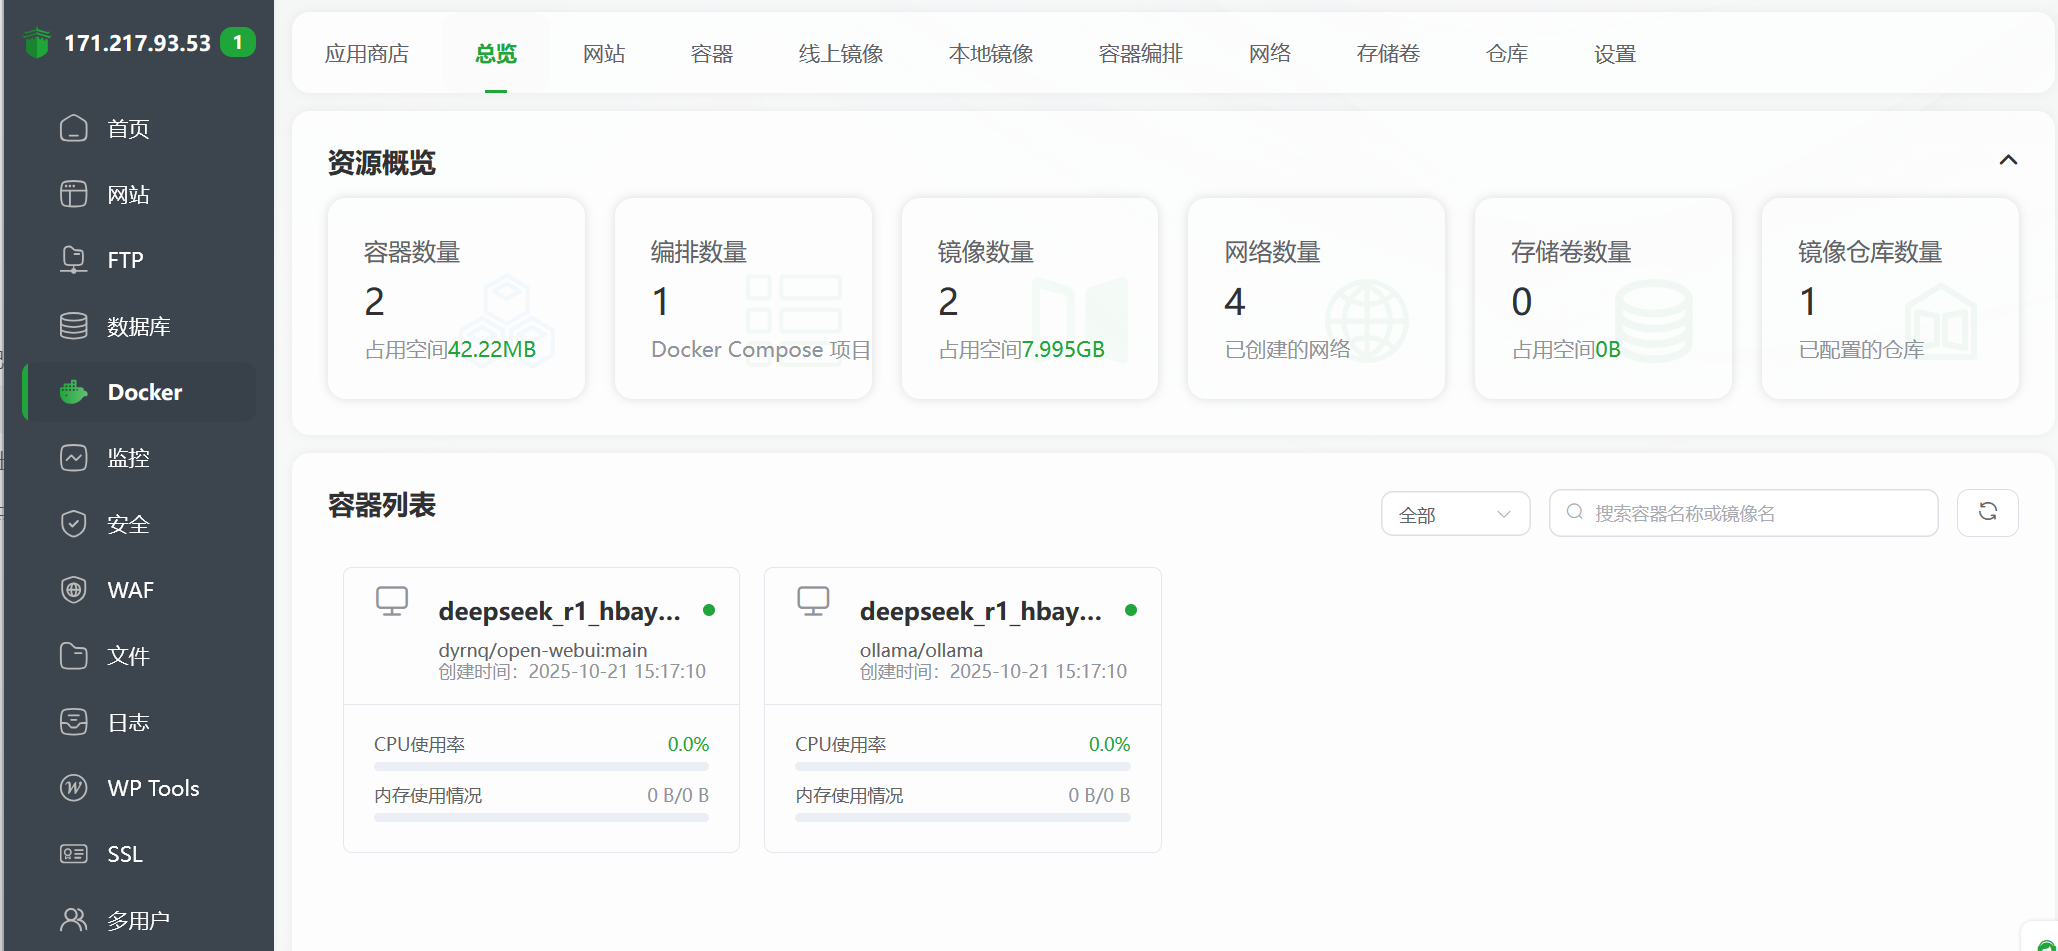
打开网站看看
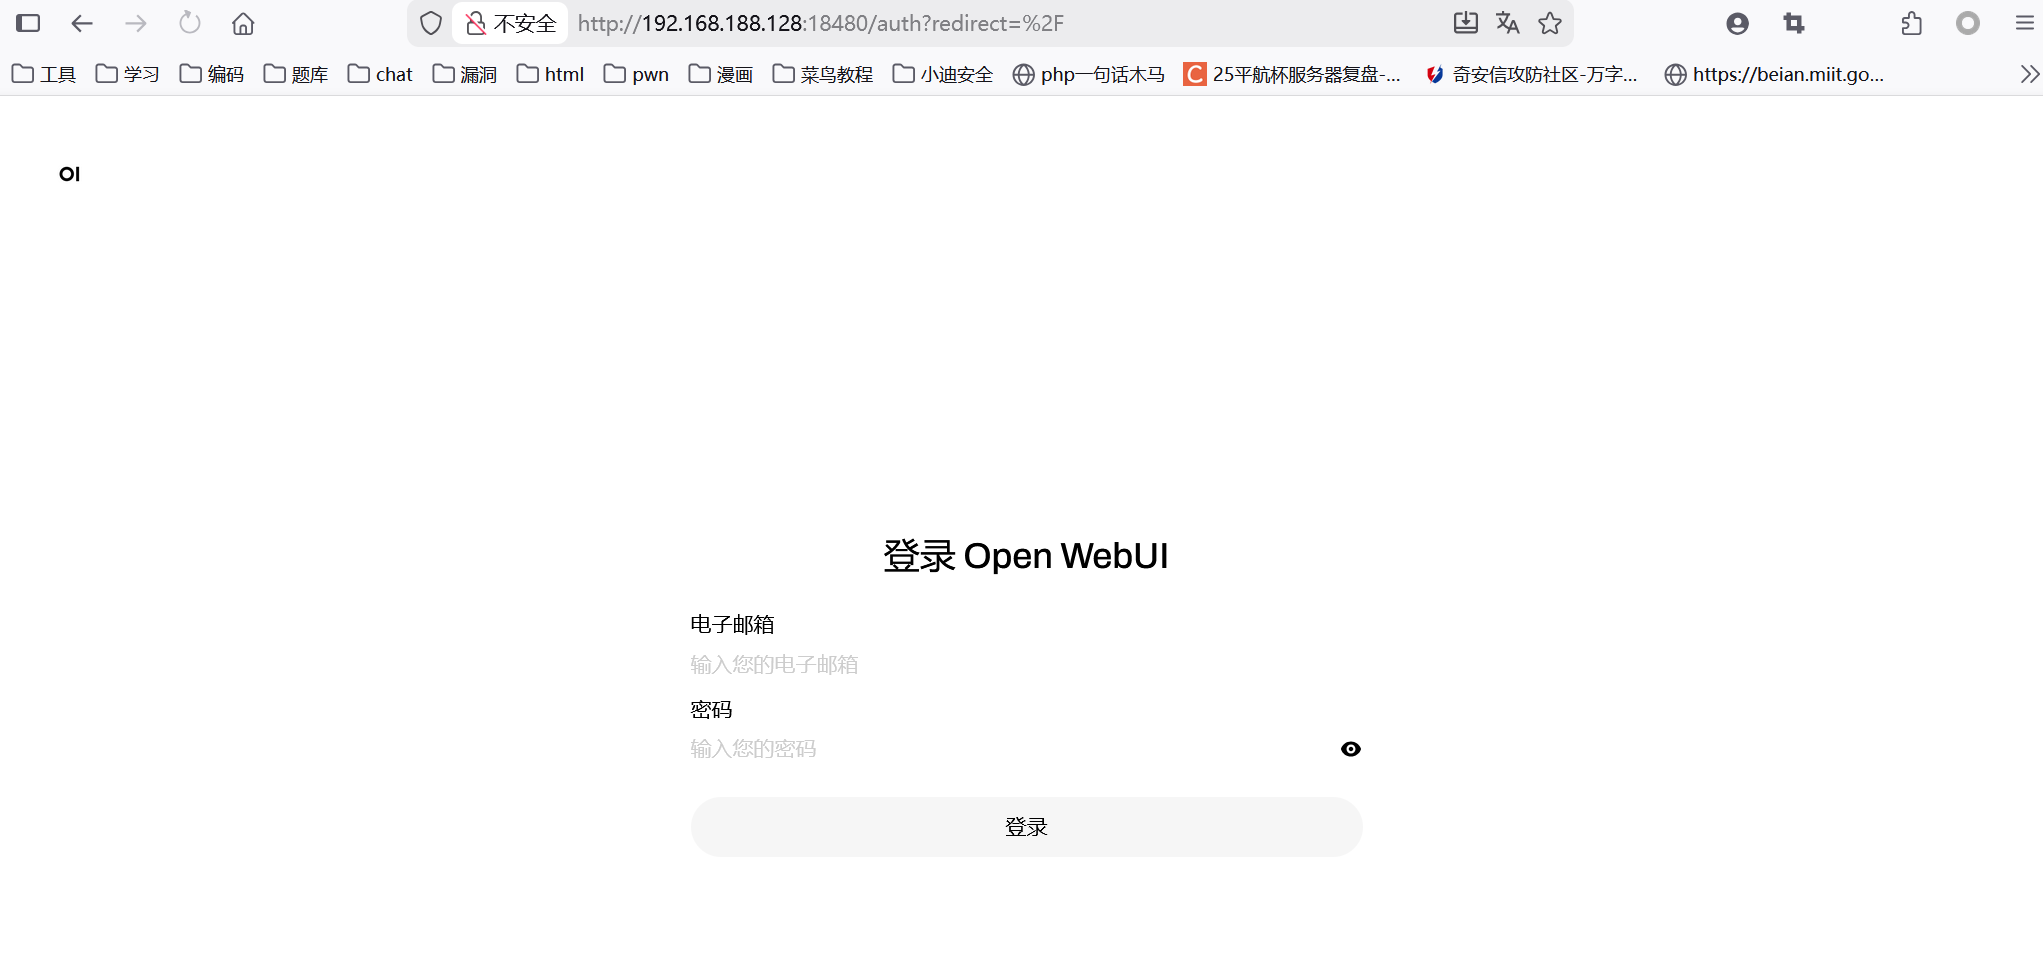
没有账号密码,那就看看本地的数据库文件
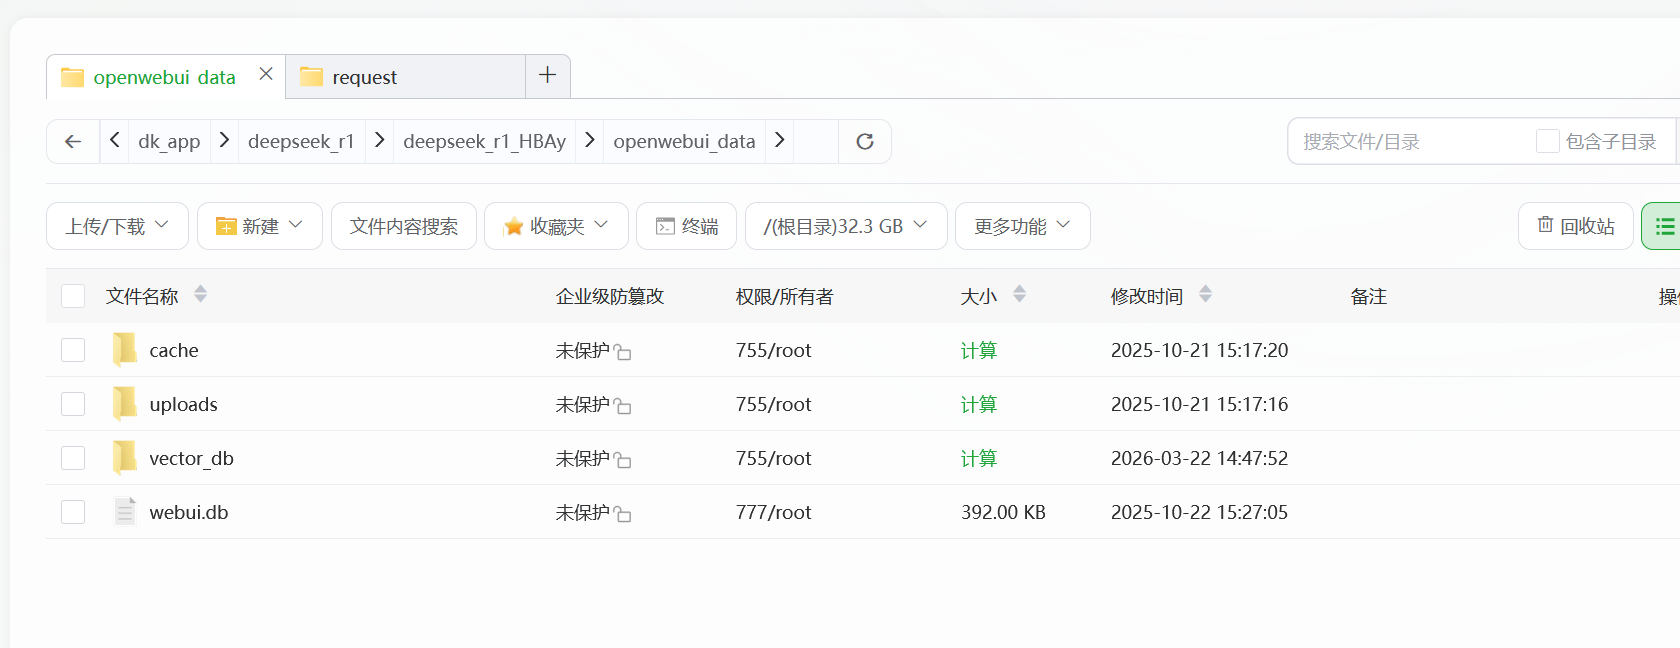
导出文件看一下
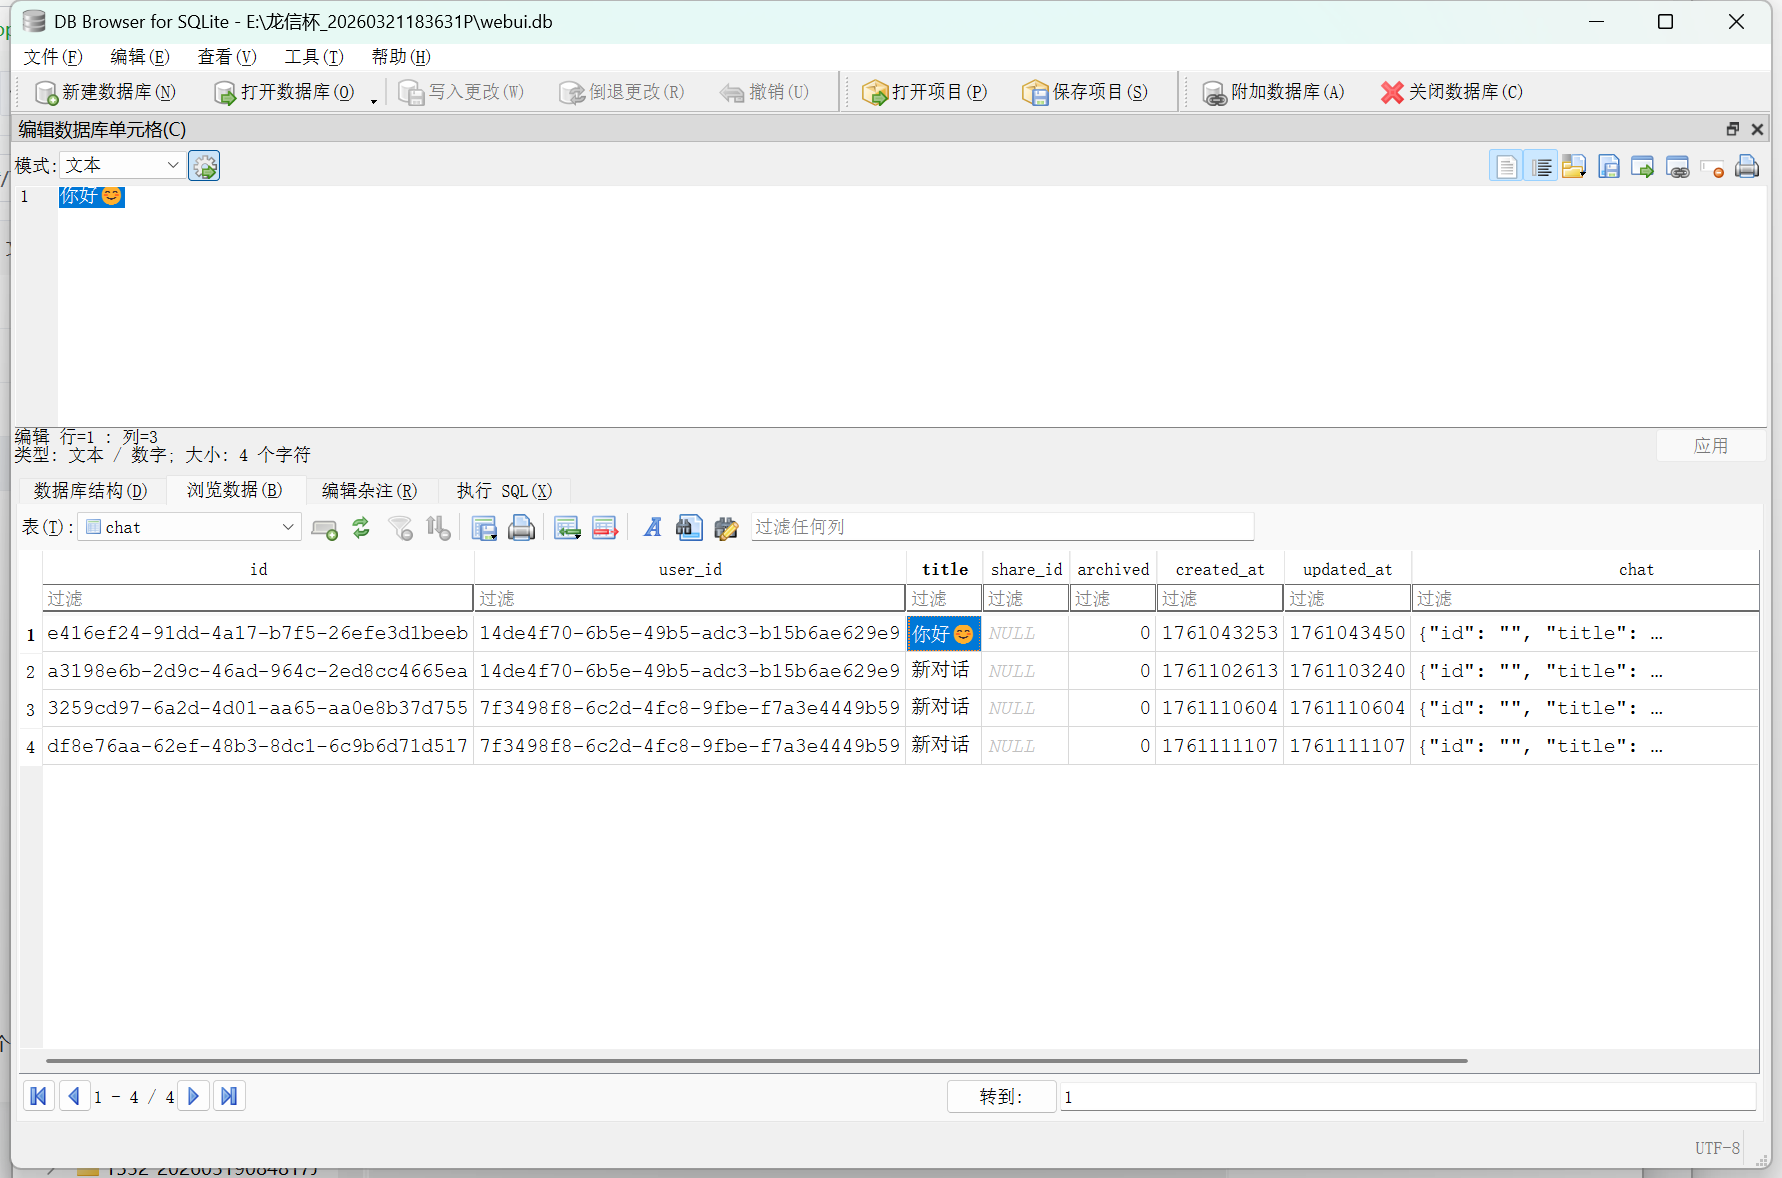
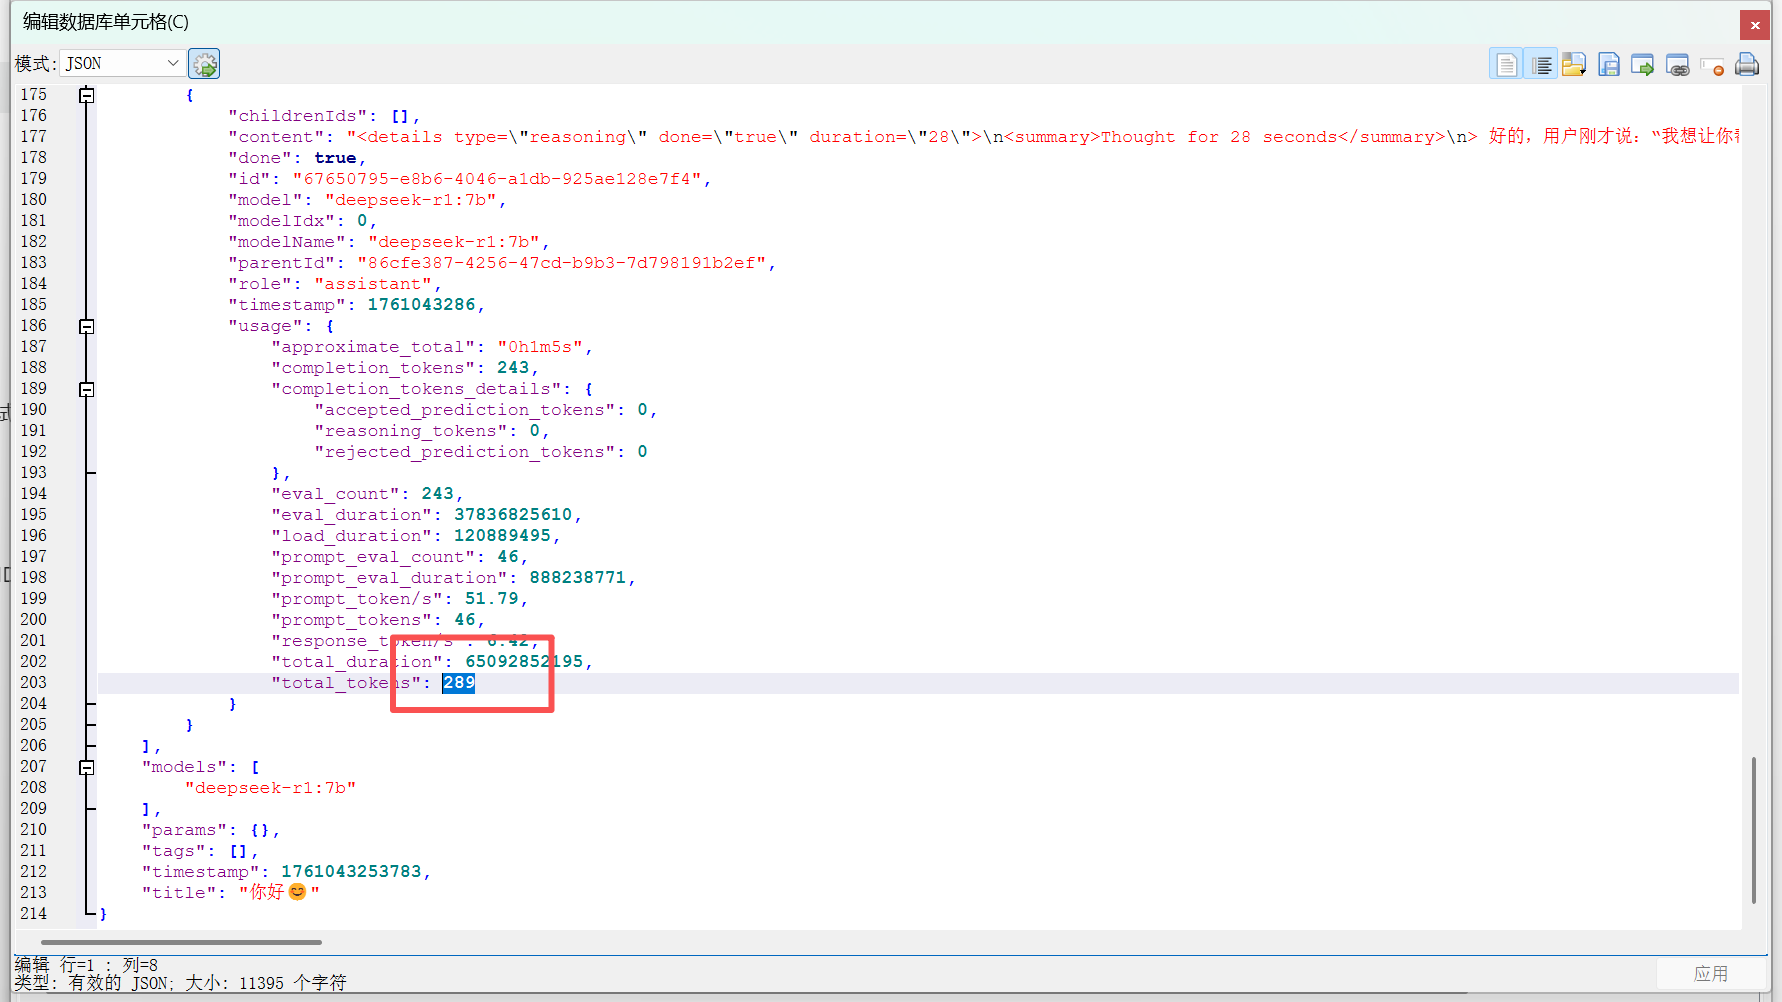
查看时间戳,是这个对话
查看chat对话,可以看到提问了两次
07 接上题,第二轮交互总计Token Consumption(令牌消耗)多少
289
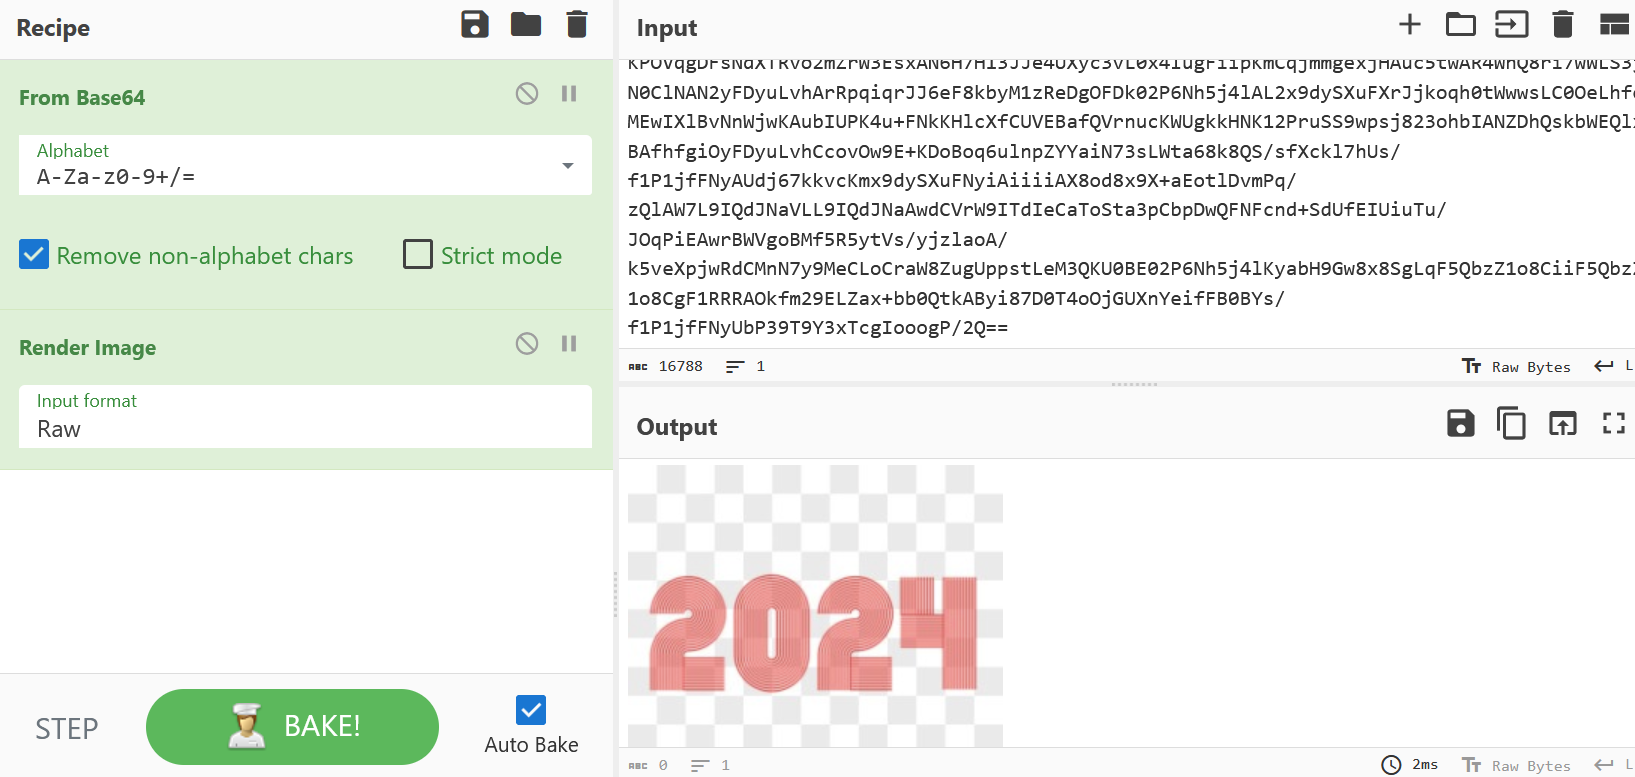
08 AI 模型在创建时注册的管理员账号的头像显示的数字是
2024
查看数据库中的user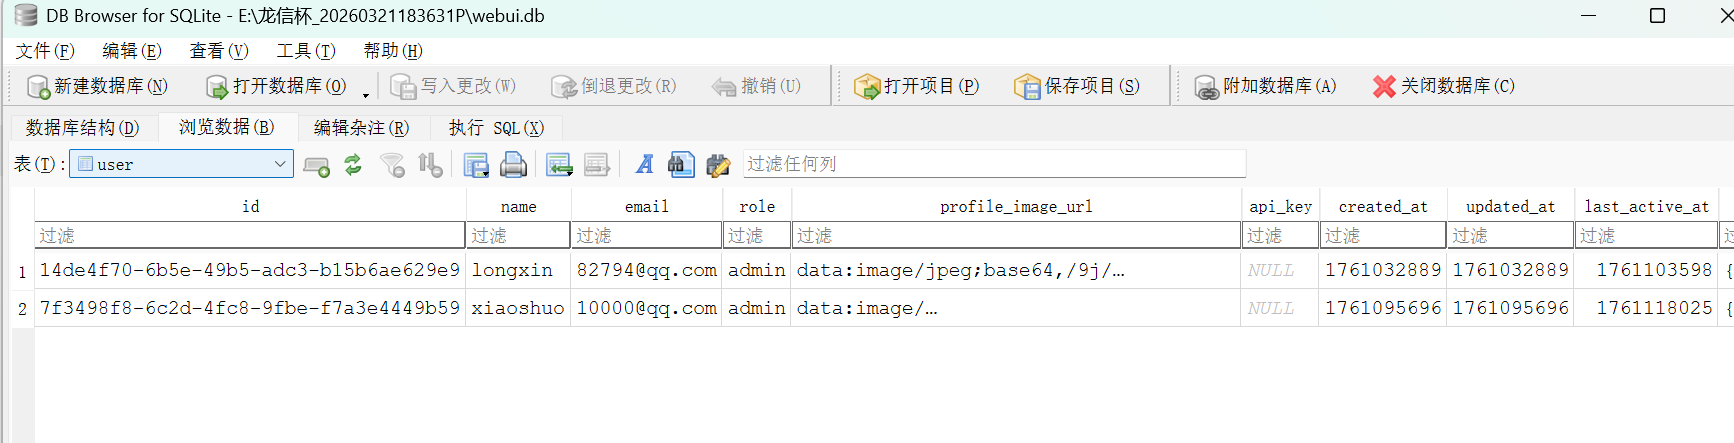
有两张图片,一张一张解码
09 卡密网站隔一段时间会自动删除后台管理员登录日志,日志最多保存多少小时
24
接下来问卡密网站,应该是web的那个服务器,同样的操作仿真一下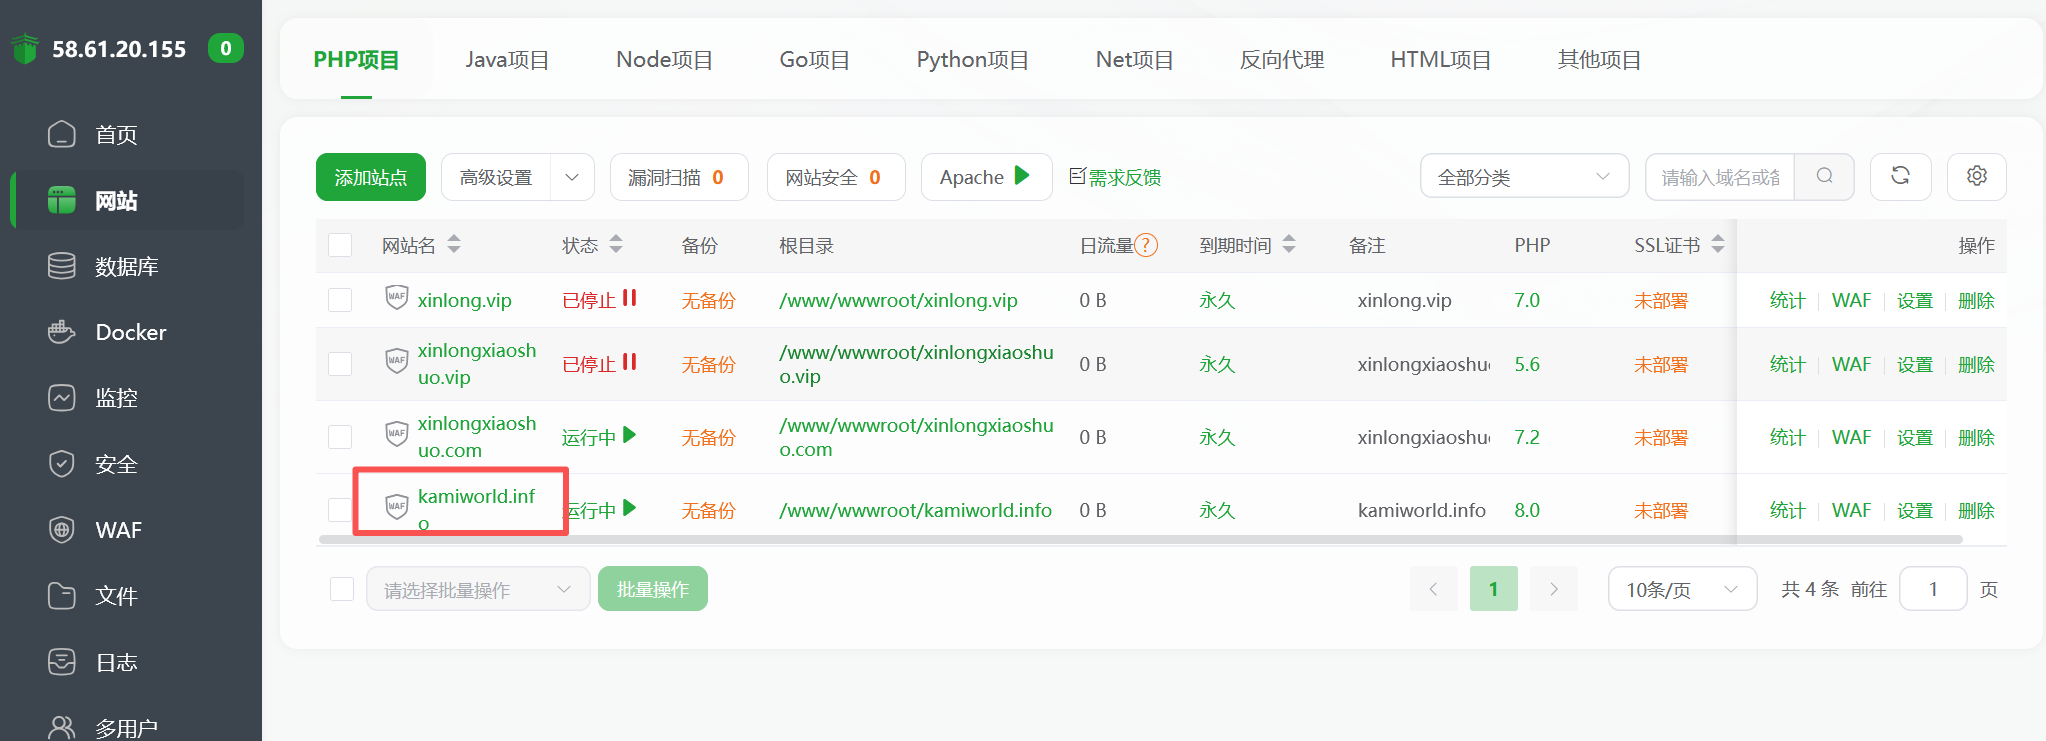
看到了卡密的网站,查看一下本地的文件,找到管理员登录页面
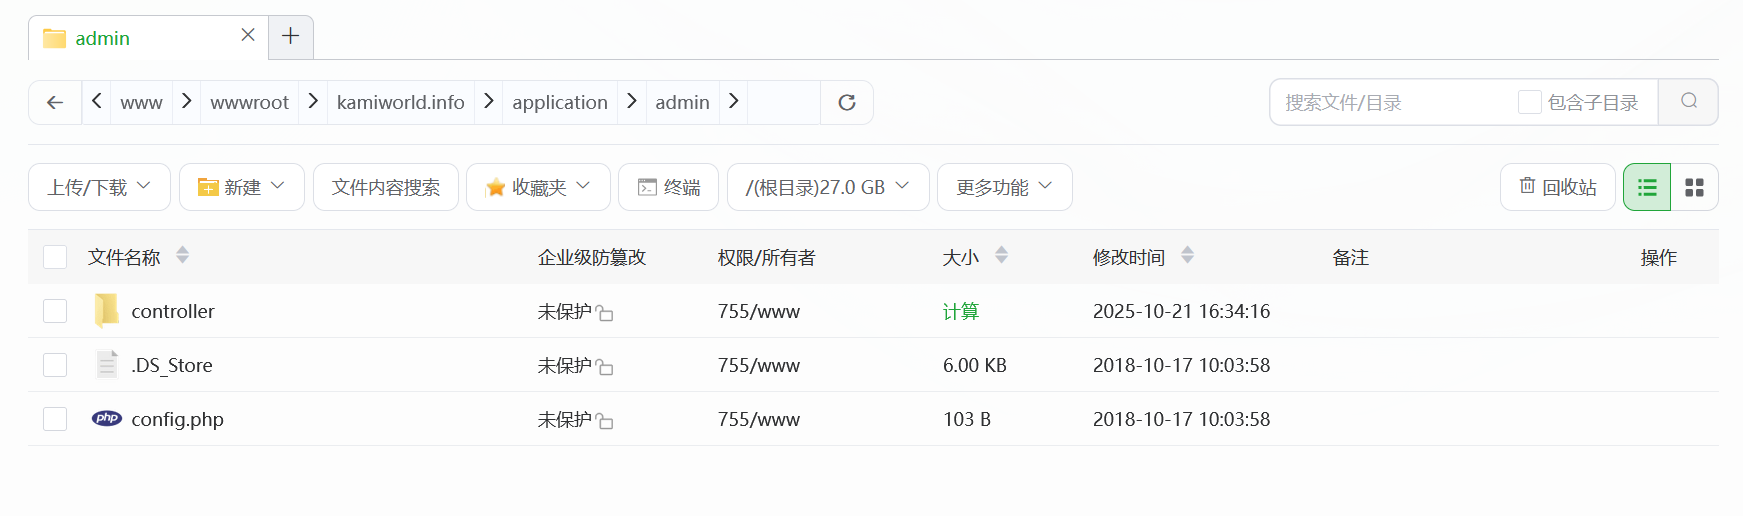
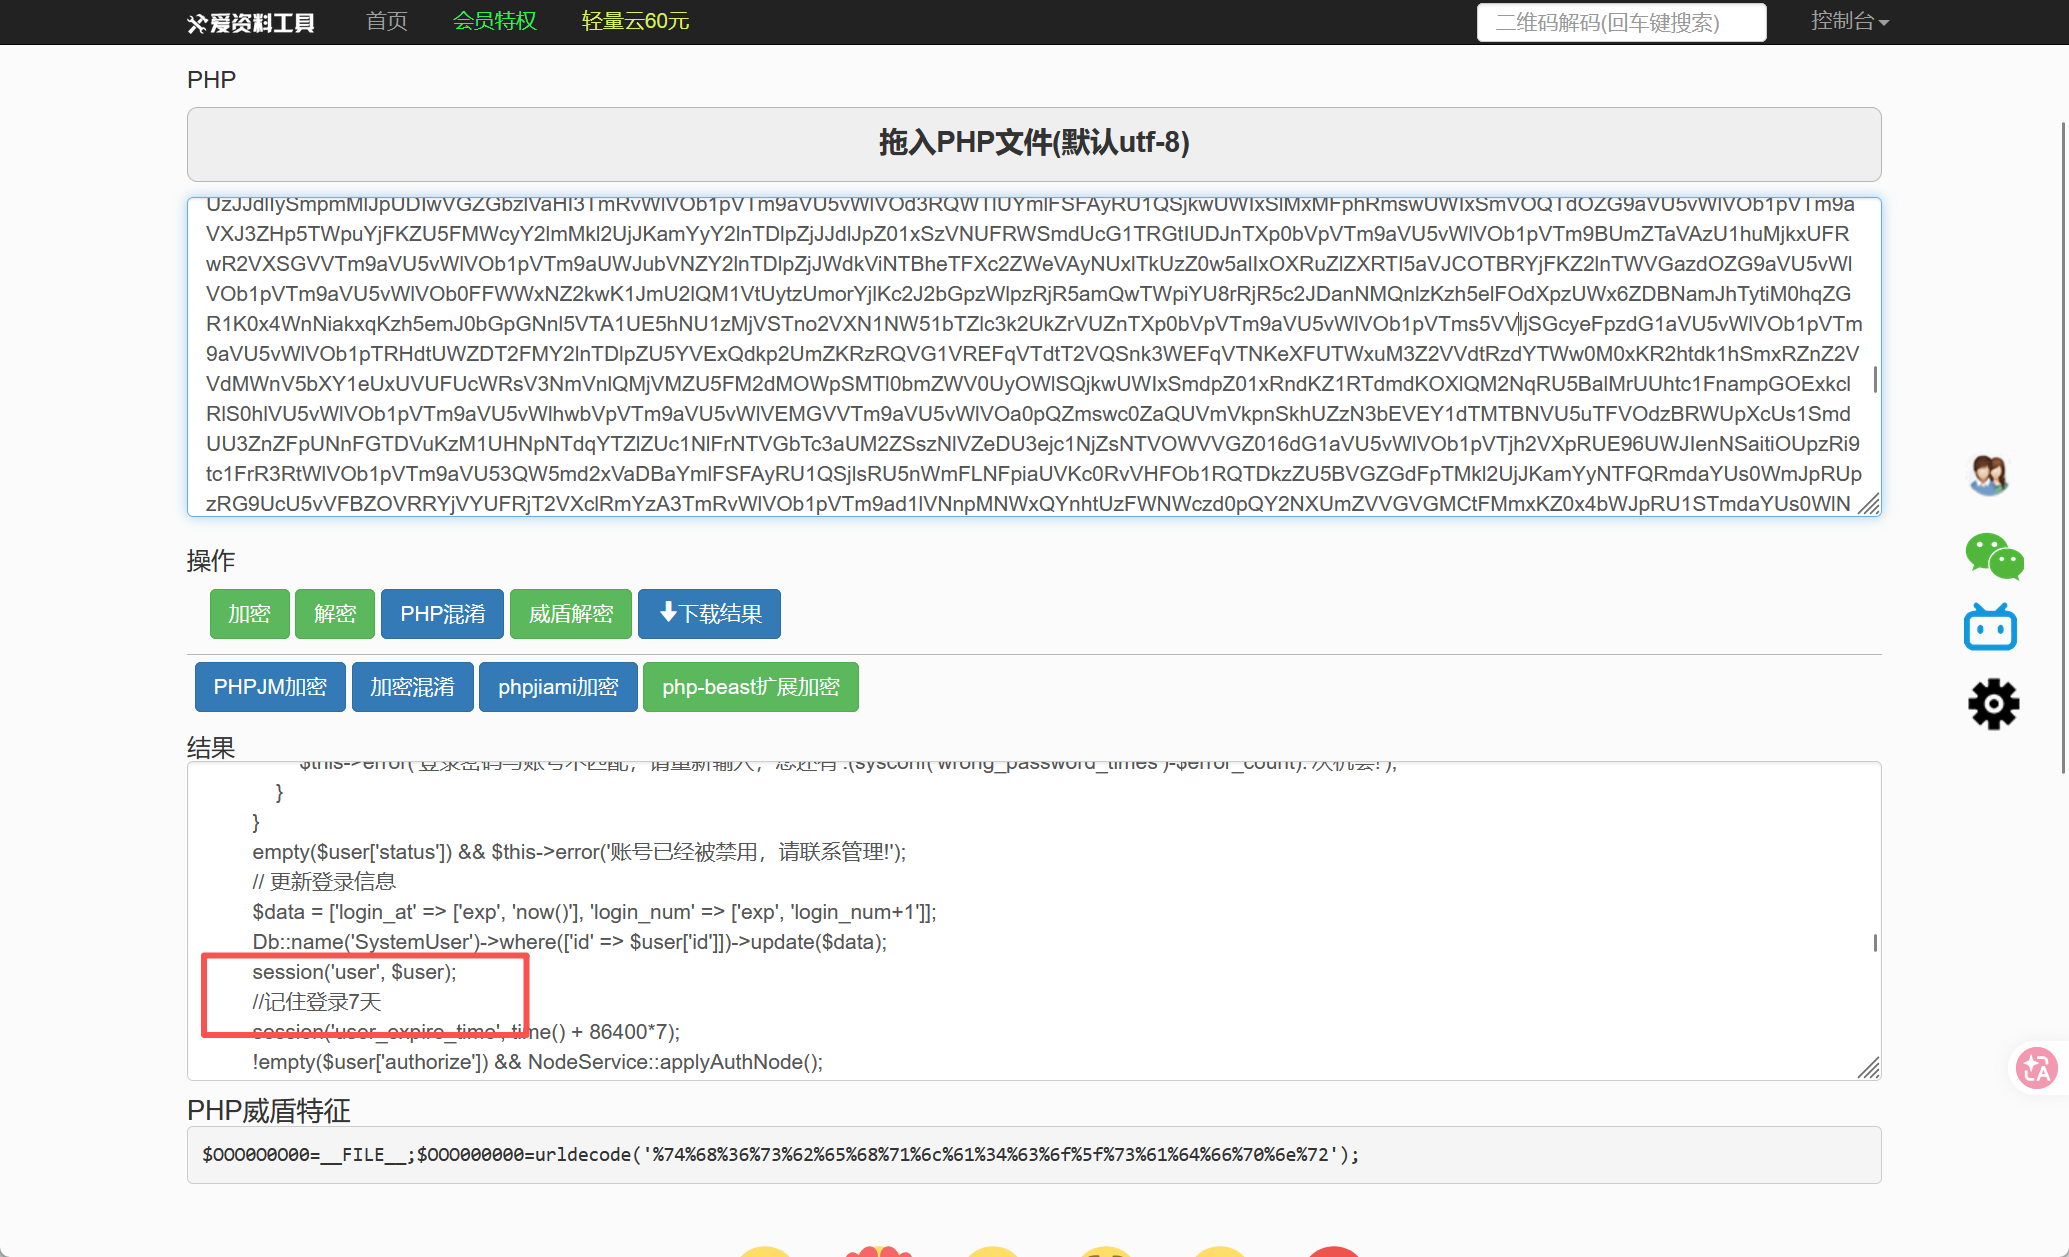
发现php代码混淆
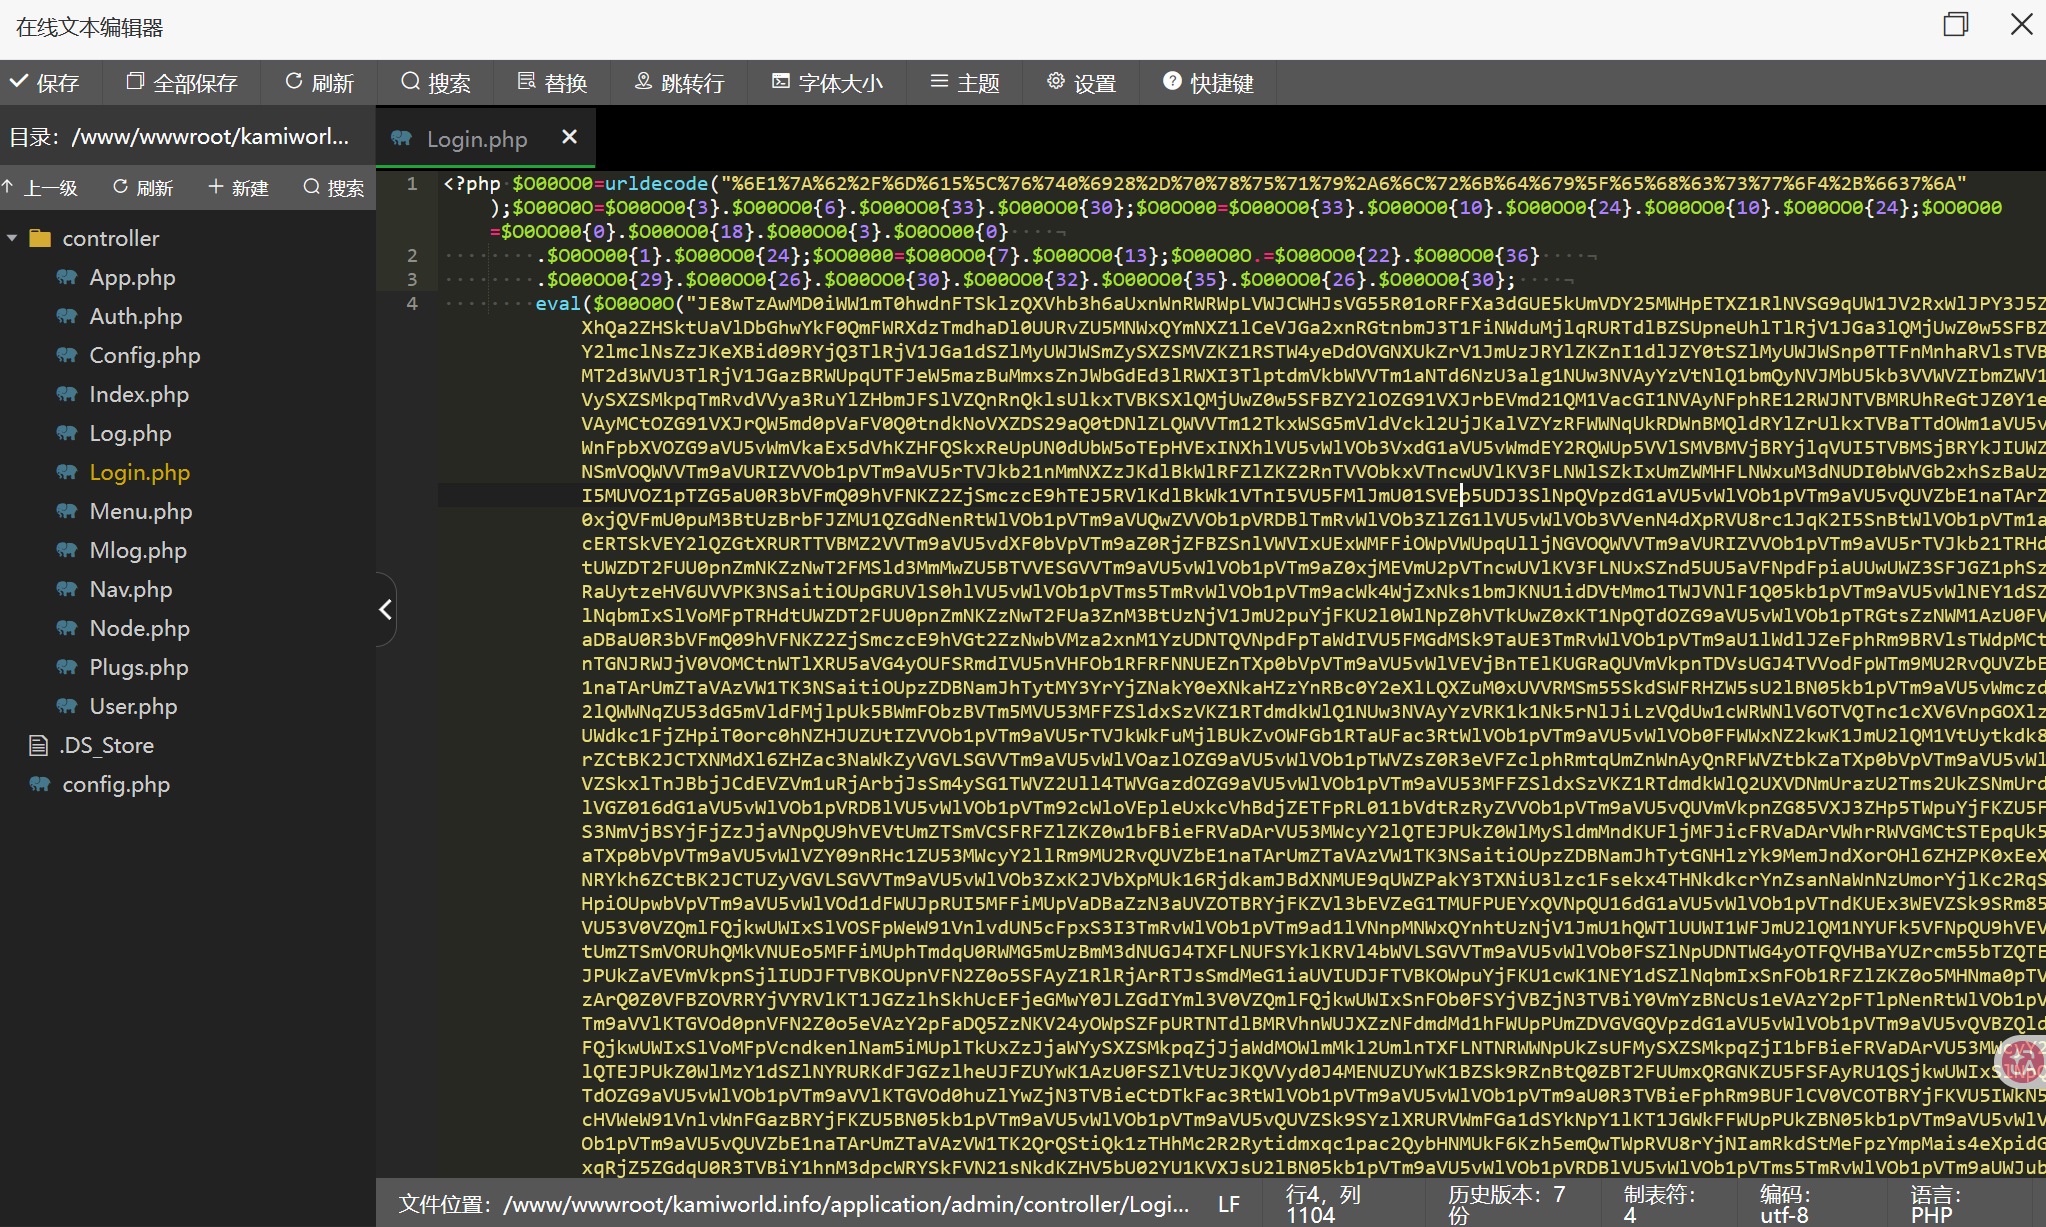
解密一下,找到日志保存时间
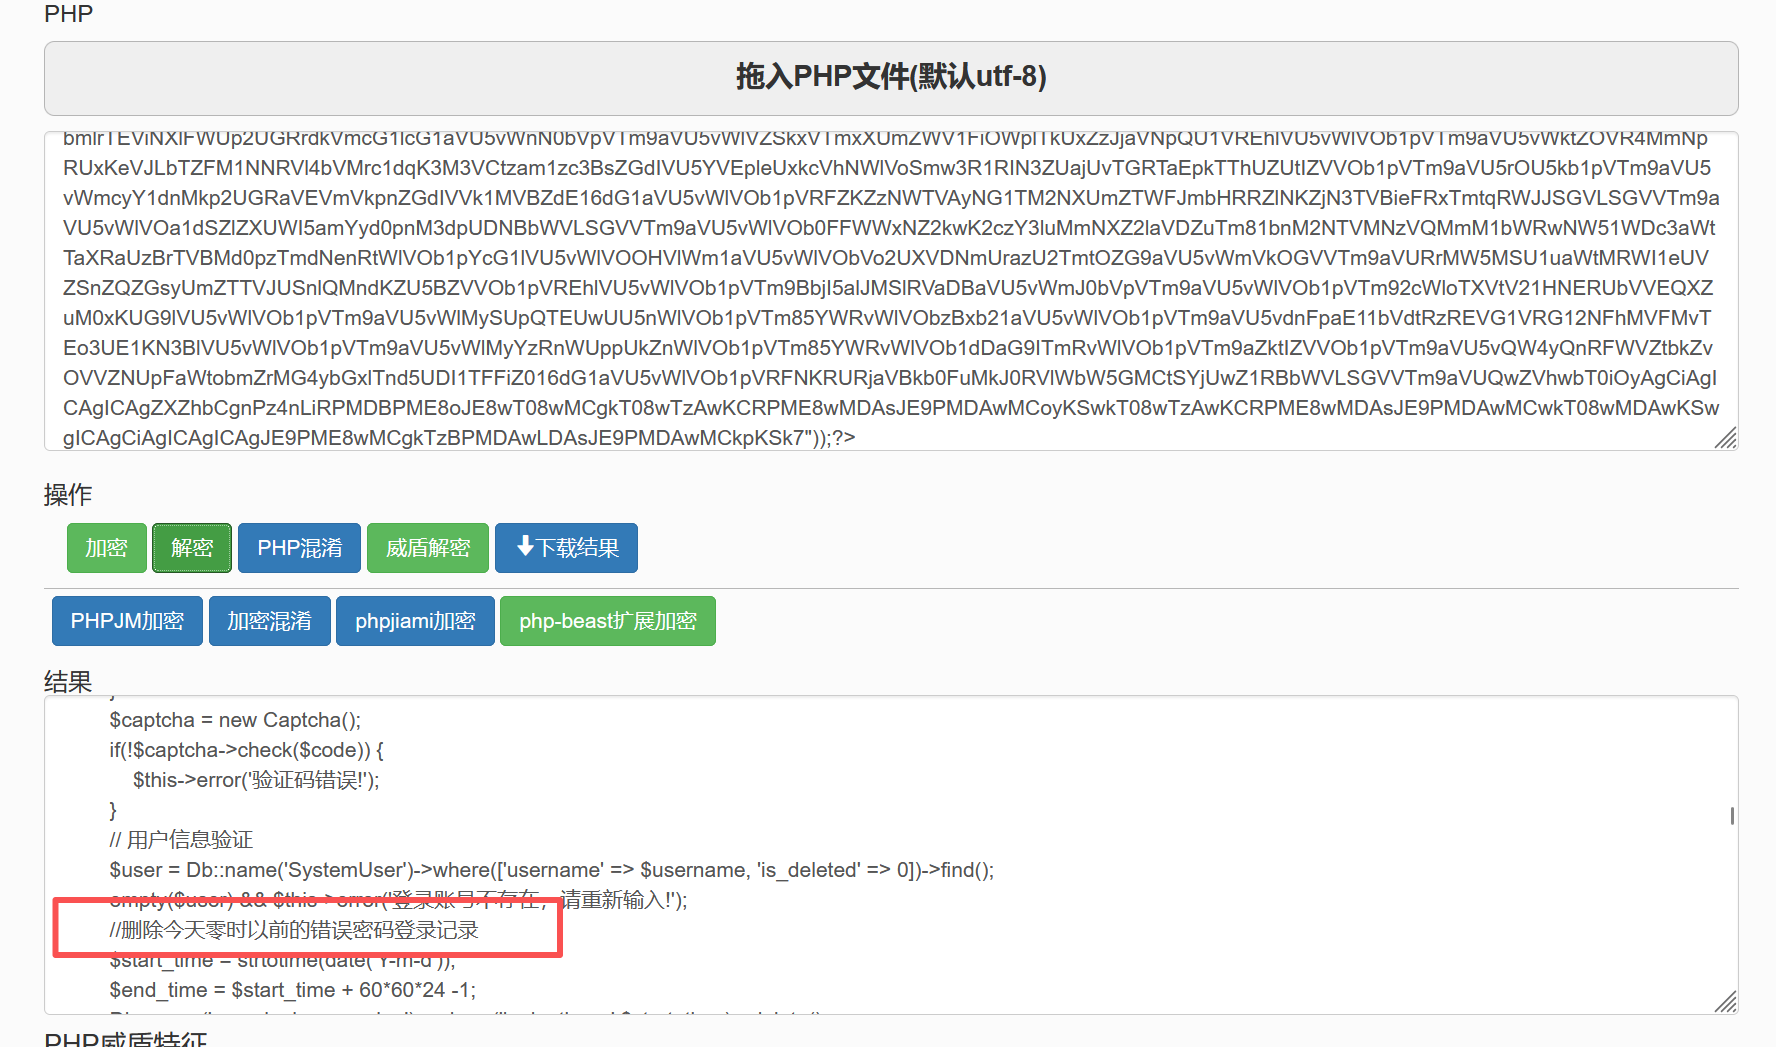
10 卡密网站后台管理员登录成功后多少小时内无需重新登录
168
同上
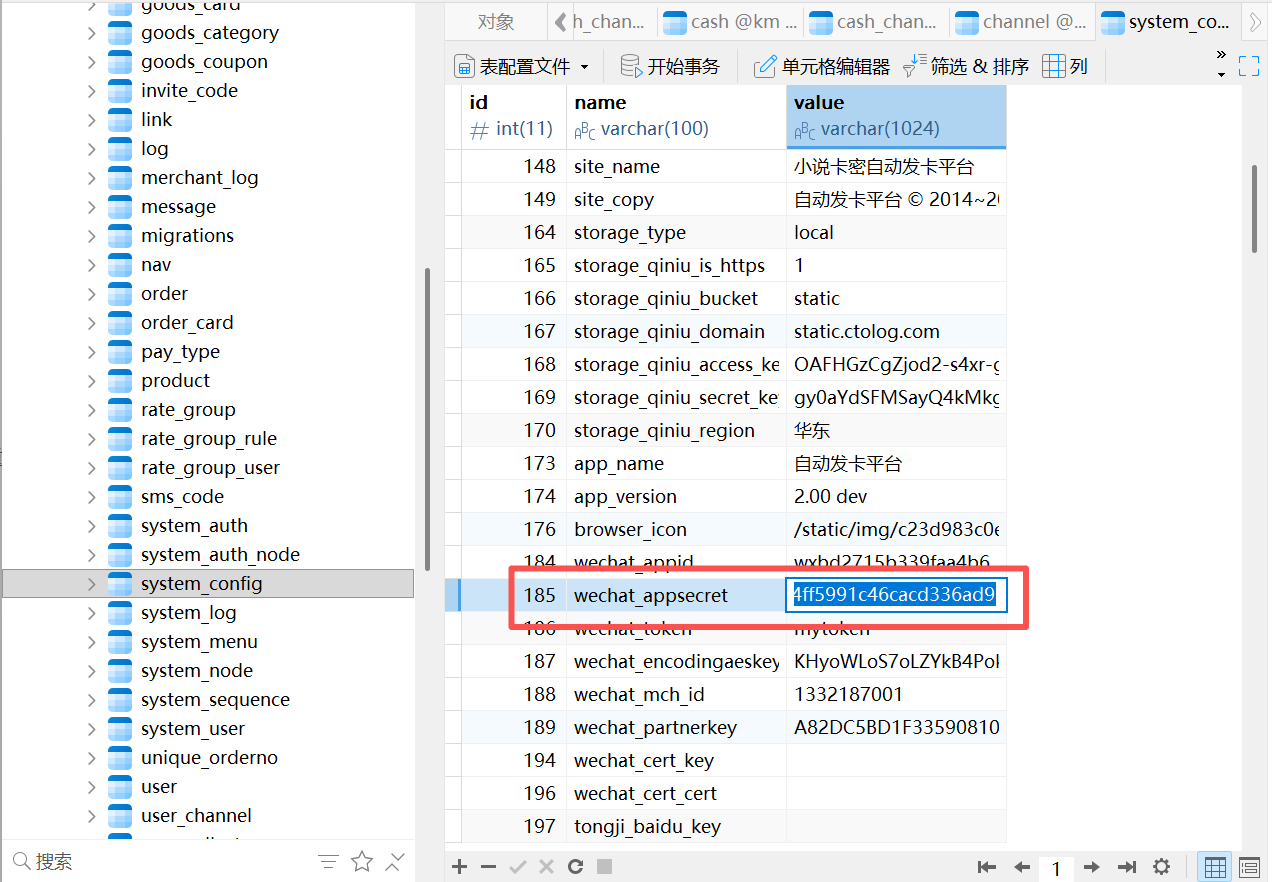
11 卡密网站微信接口配置的Appsecret
7e8055384f9c4ff5991c46cacd336ad9
连接一下数据库(账号密码在面板数据库中可以看到)
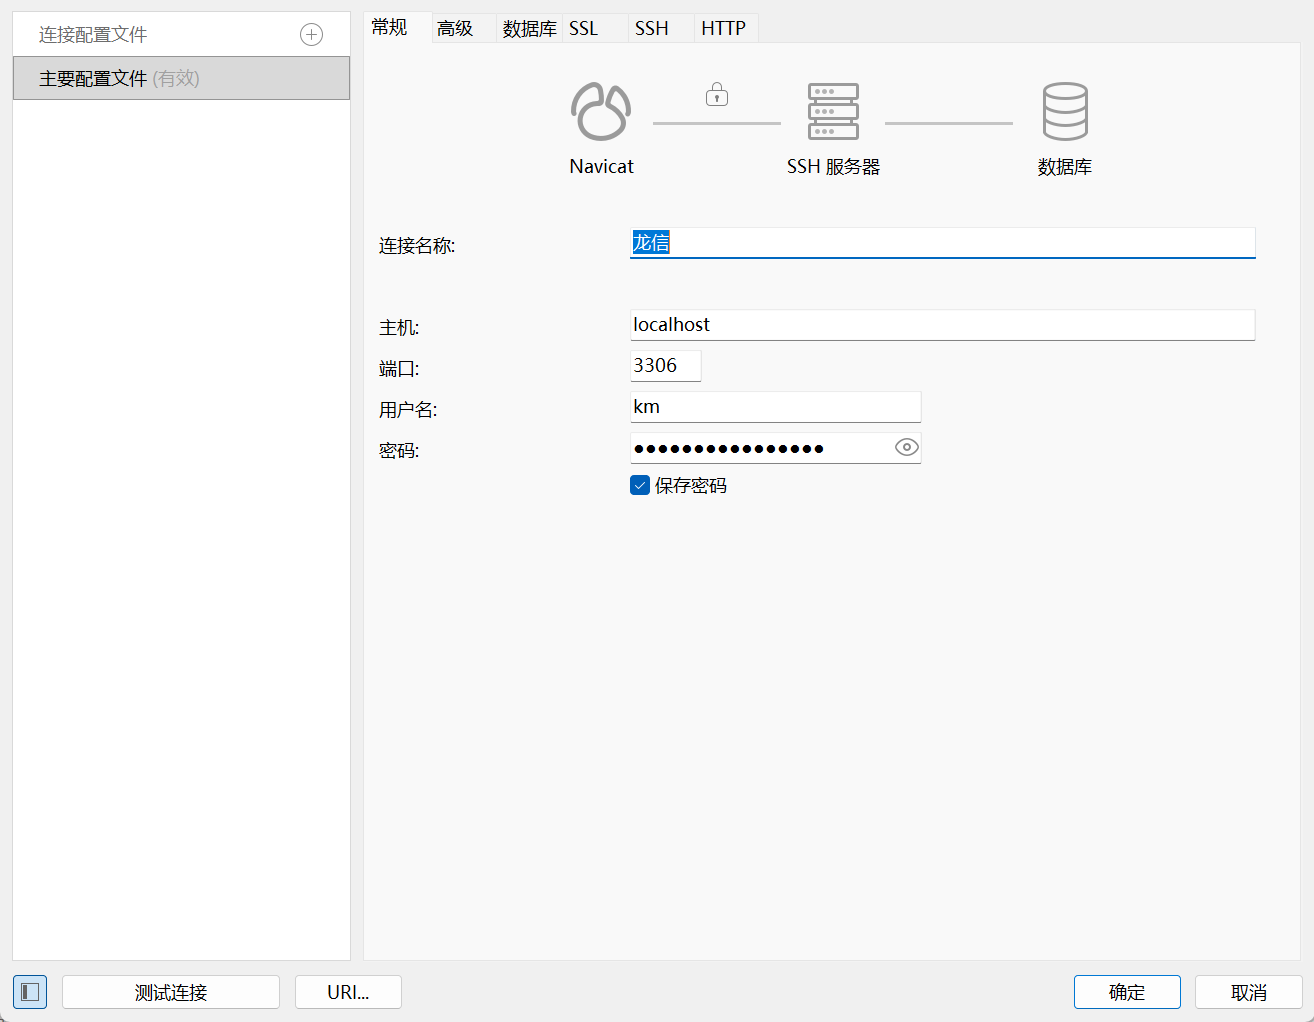
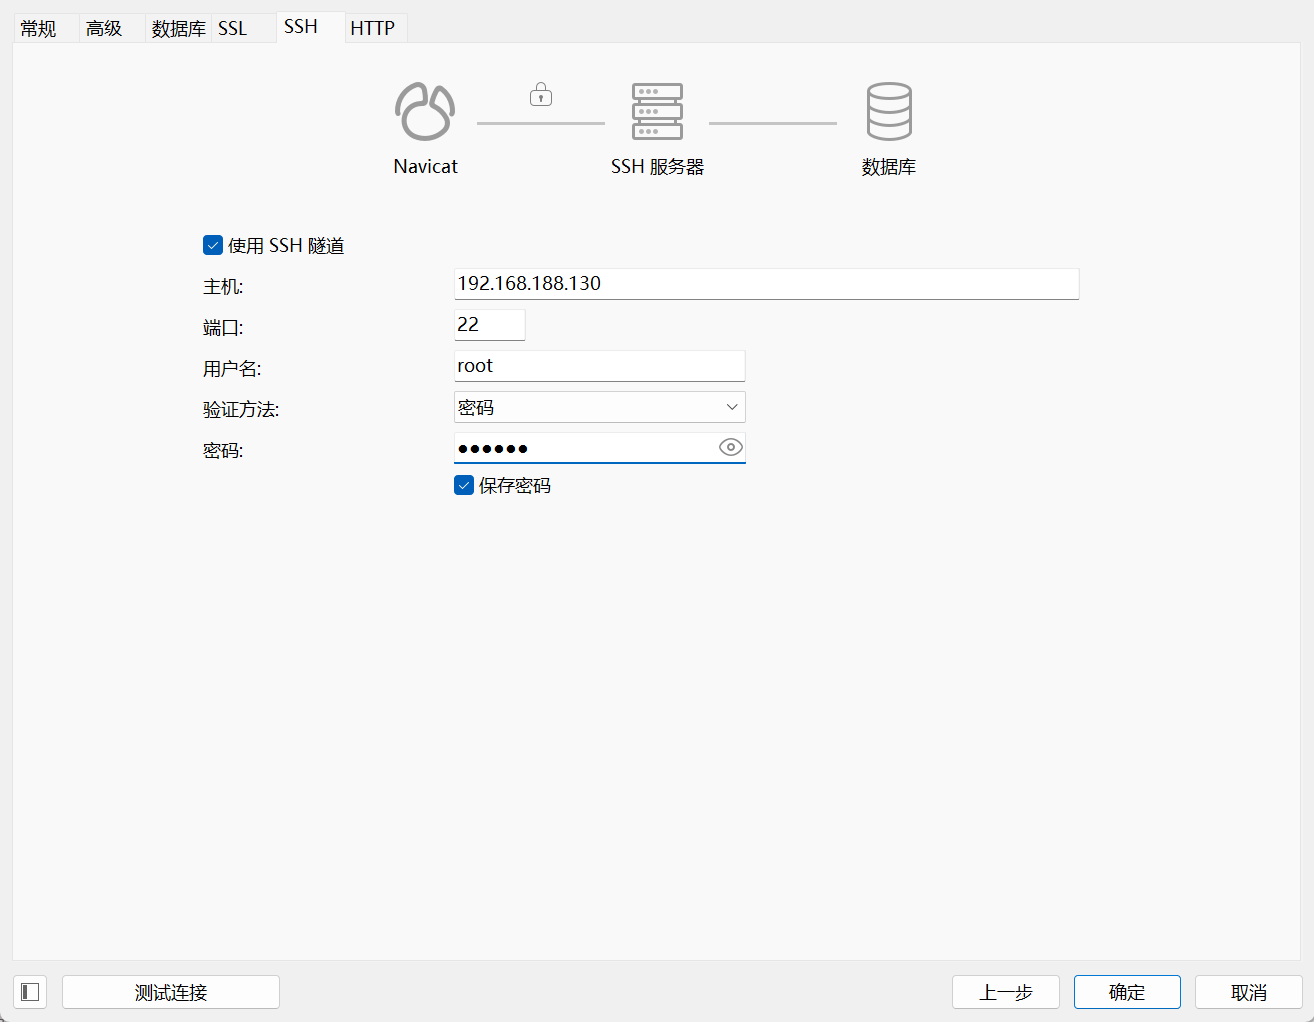
找到配置文件
12 卡密网站管理员注册了一个商户账号,商户编号是
10019
找到管理员的邮箱
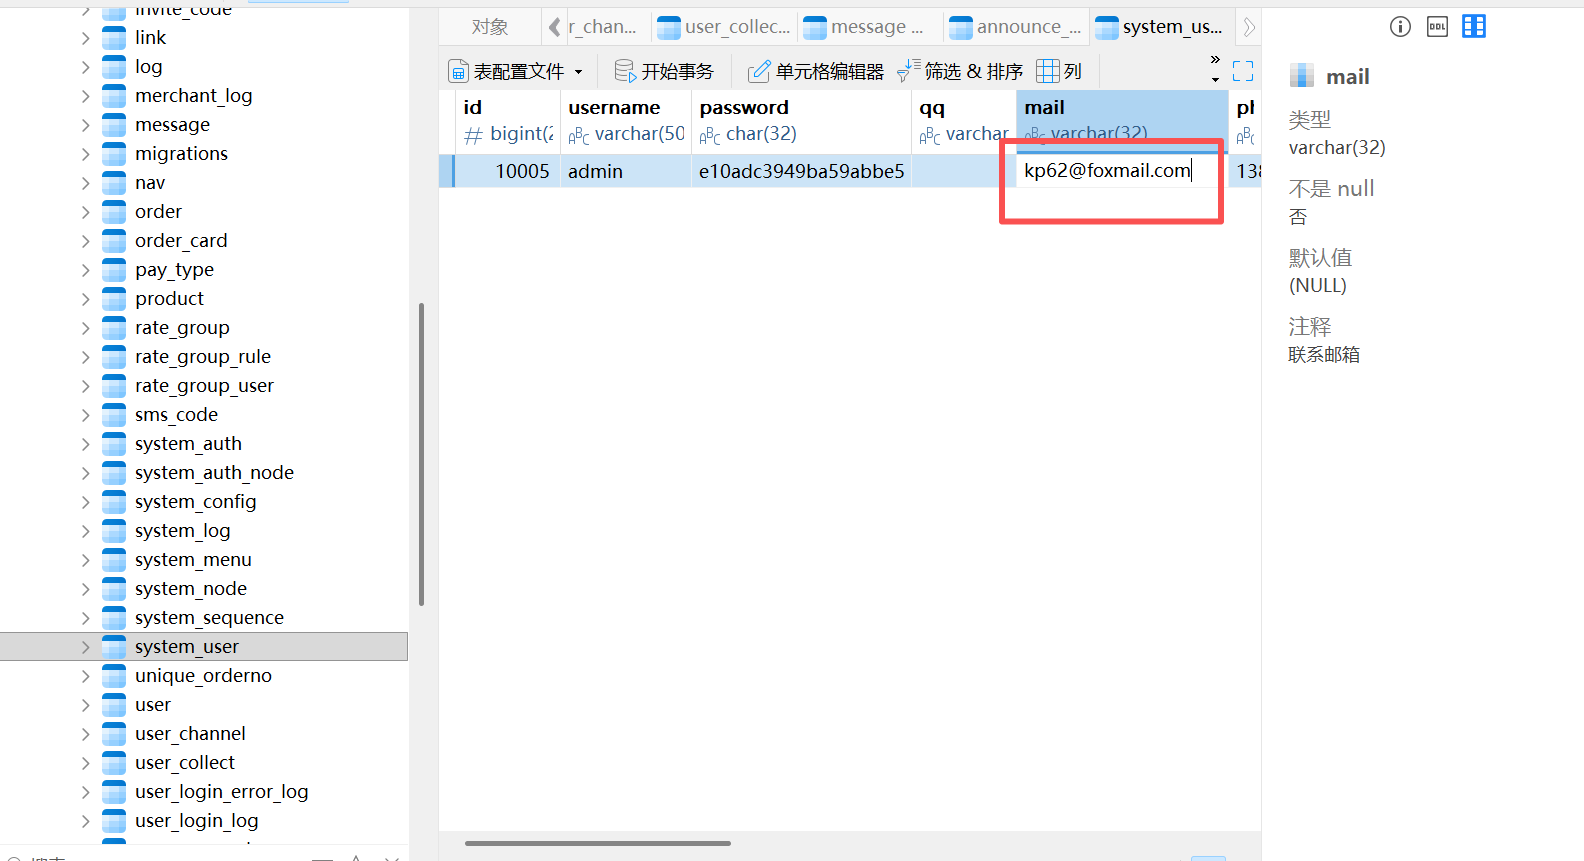
用户表中找到了相同的
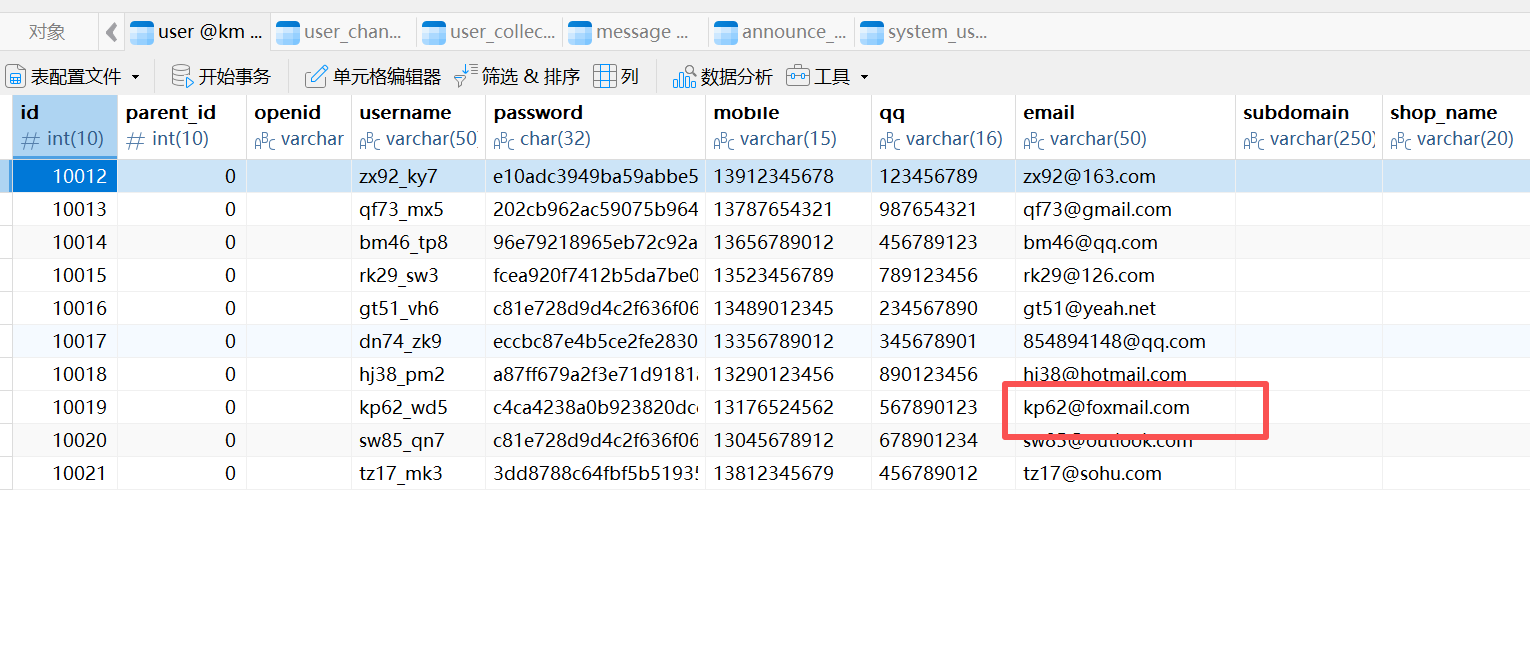
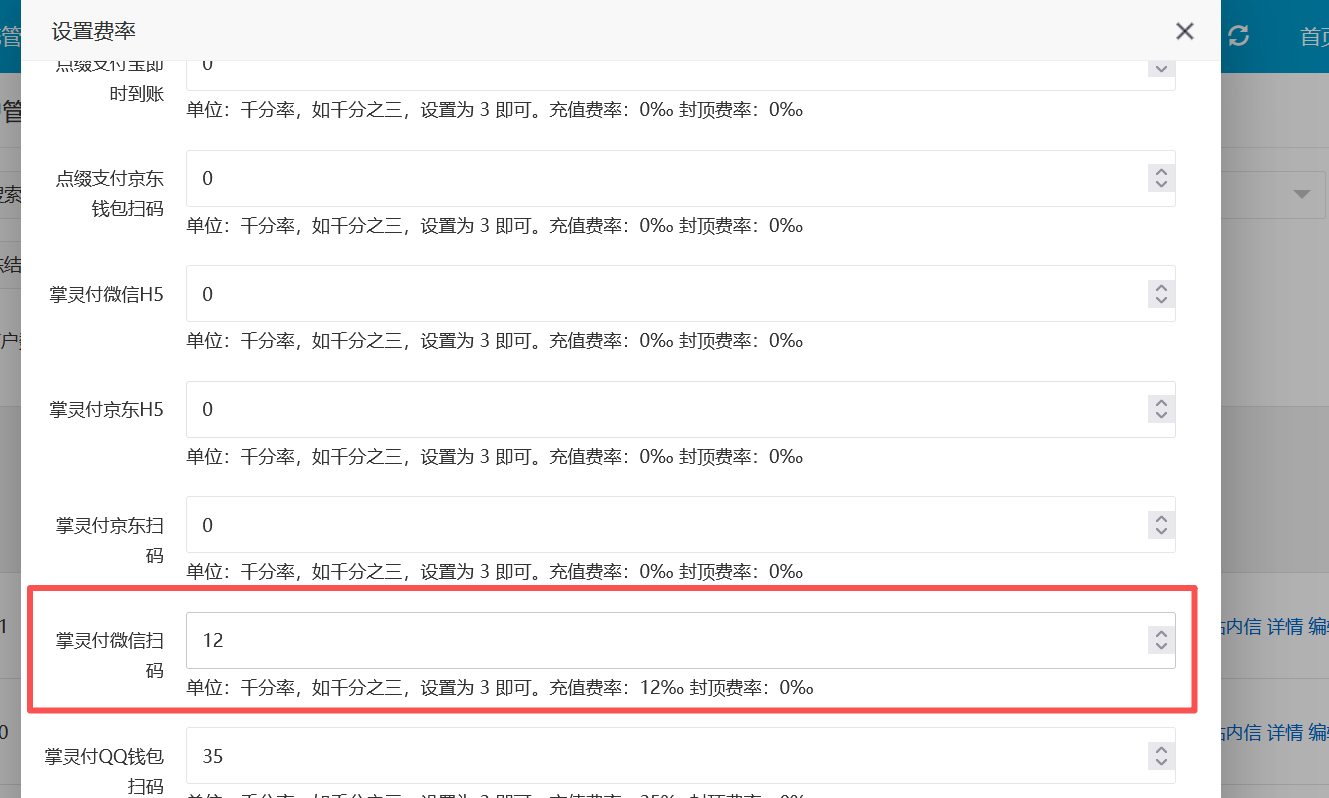
13 接上题,该商户掌灵付微信扫码设置的费率
1.2%
did平台上答案是13%,这就不太清楚了
这就得访问网站了,添加一下host
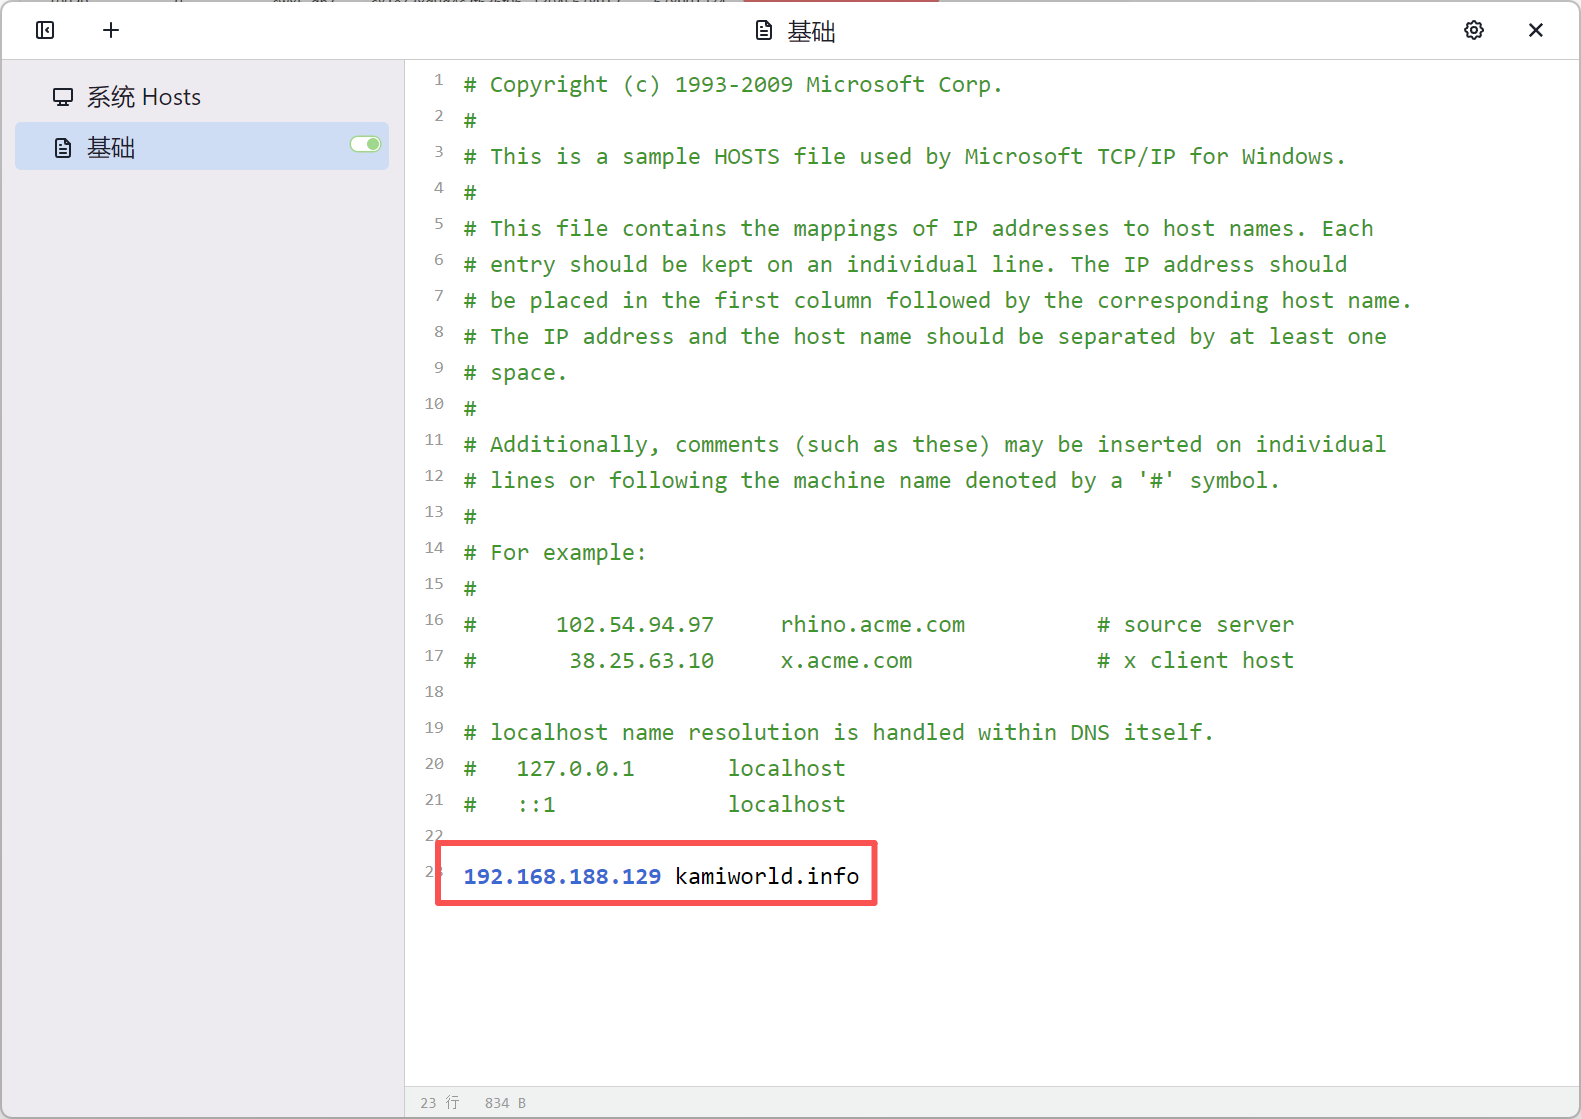
添加域名,然后访问网站,发现报错了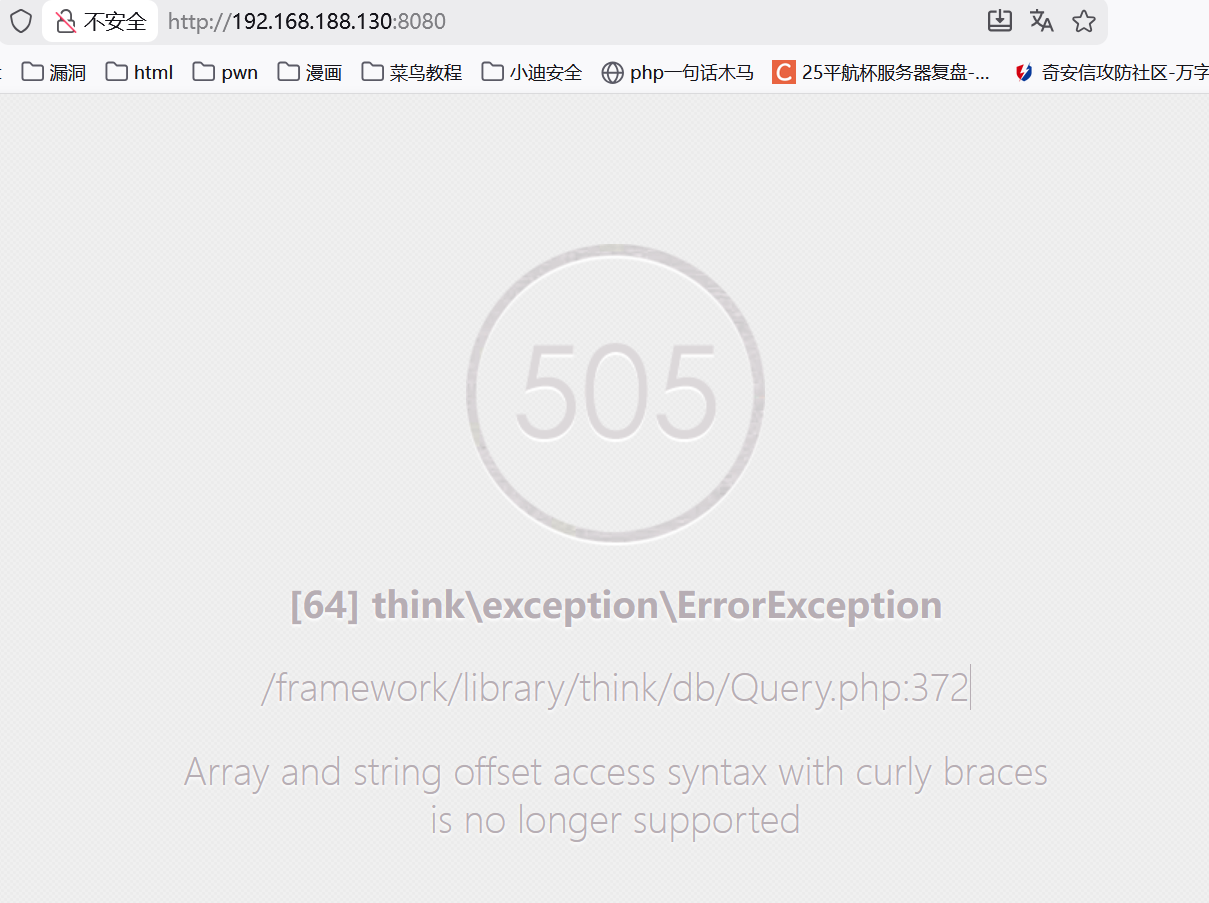
查一下发现是php版本太高,调一下php版本
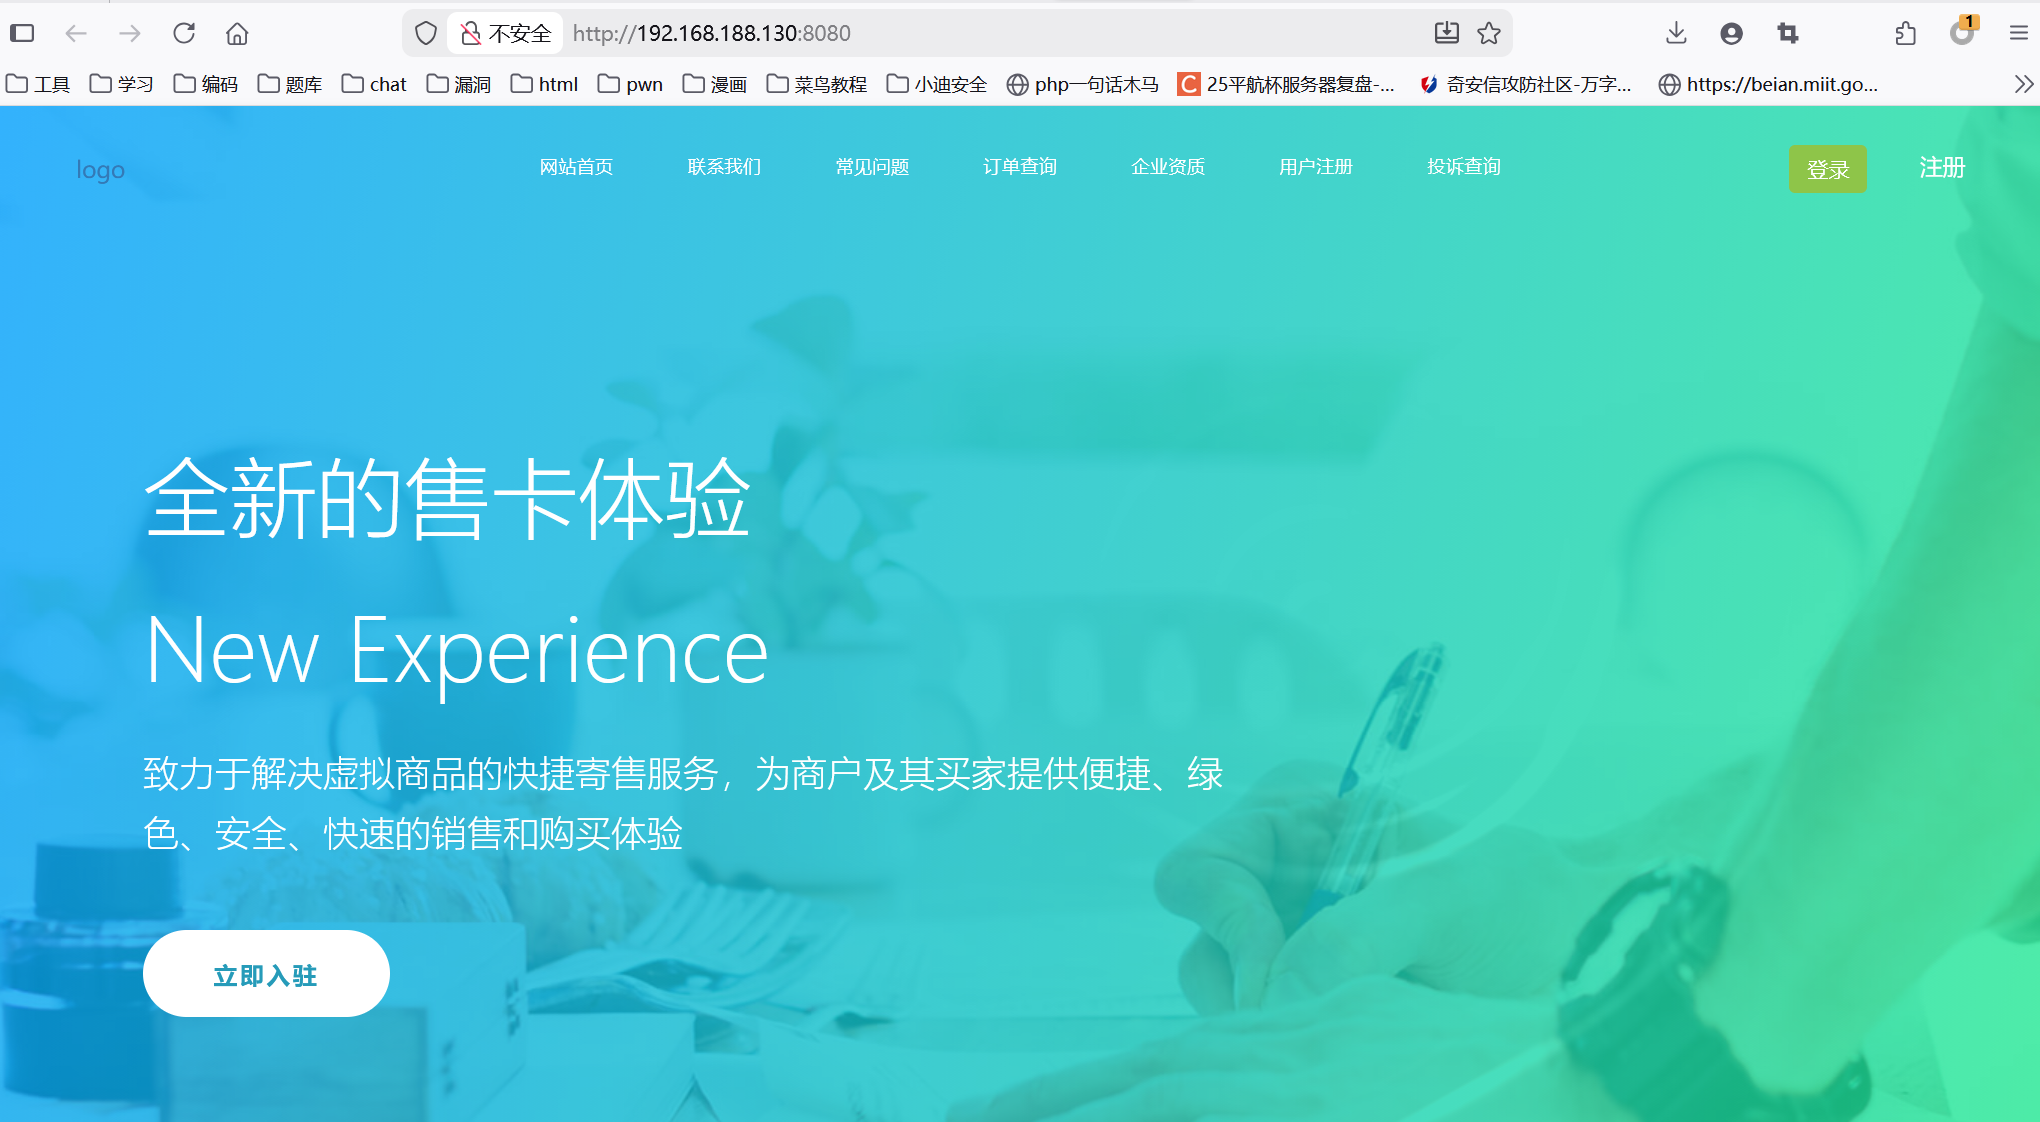
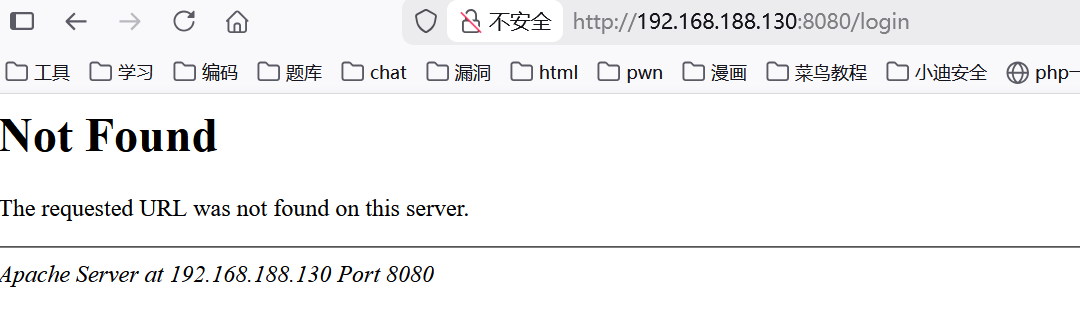
点击登录发现报错
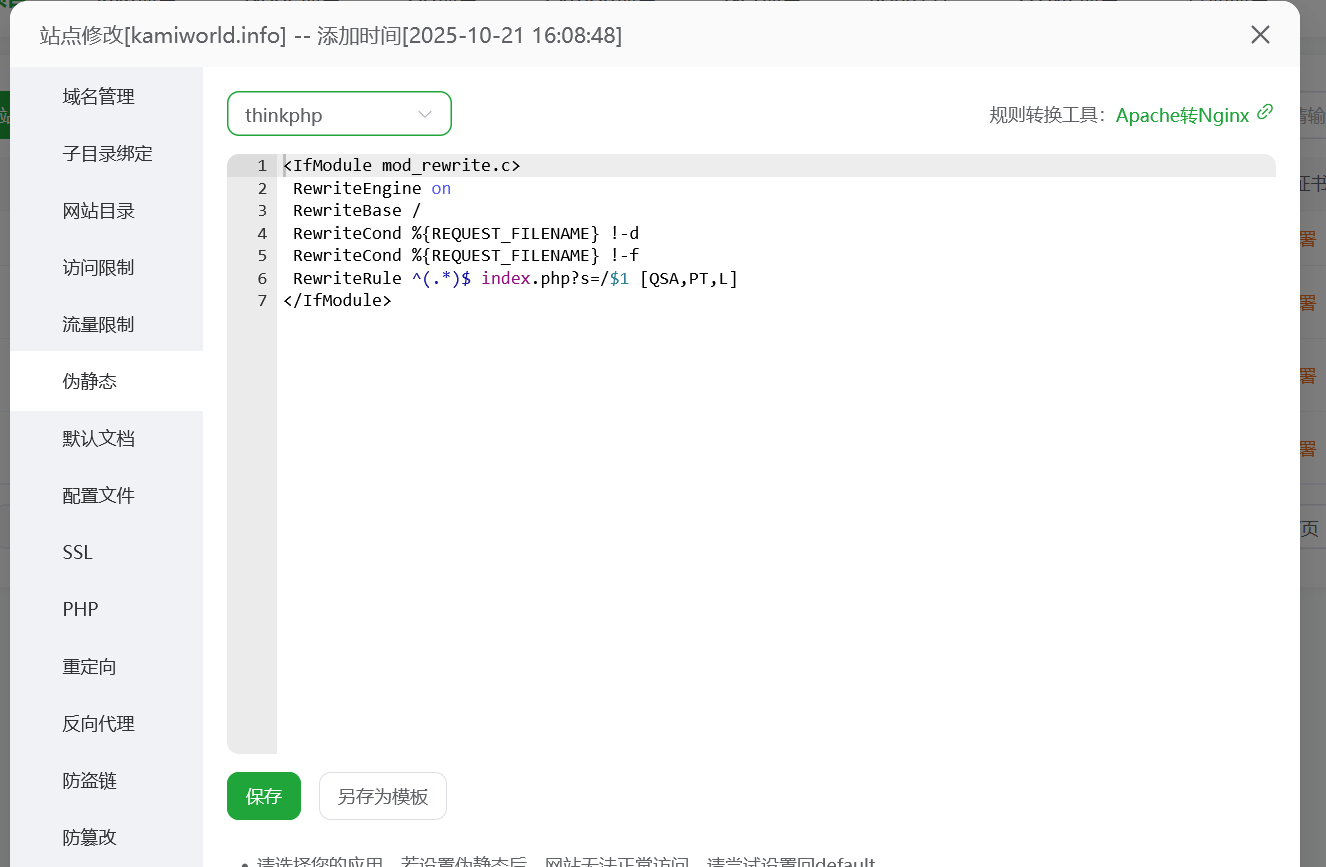
网站面板伪静态改为thinkphp
这样网站重构就完成了,登录一下网站后台/admin
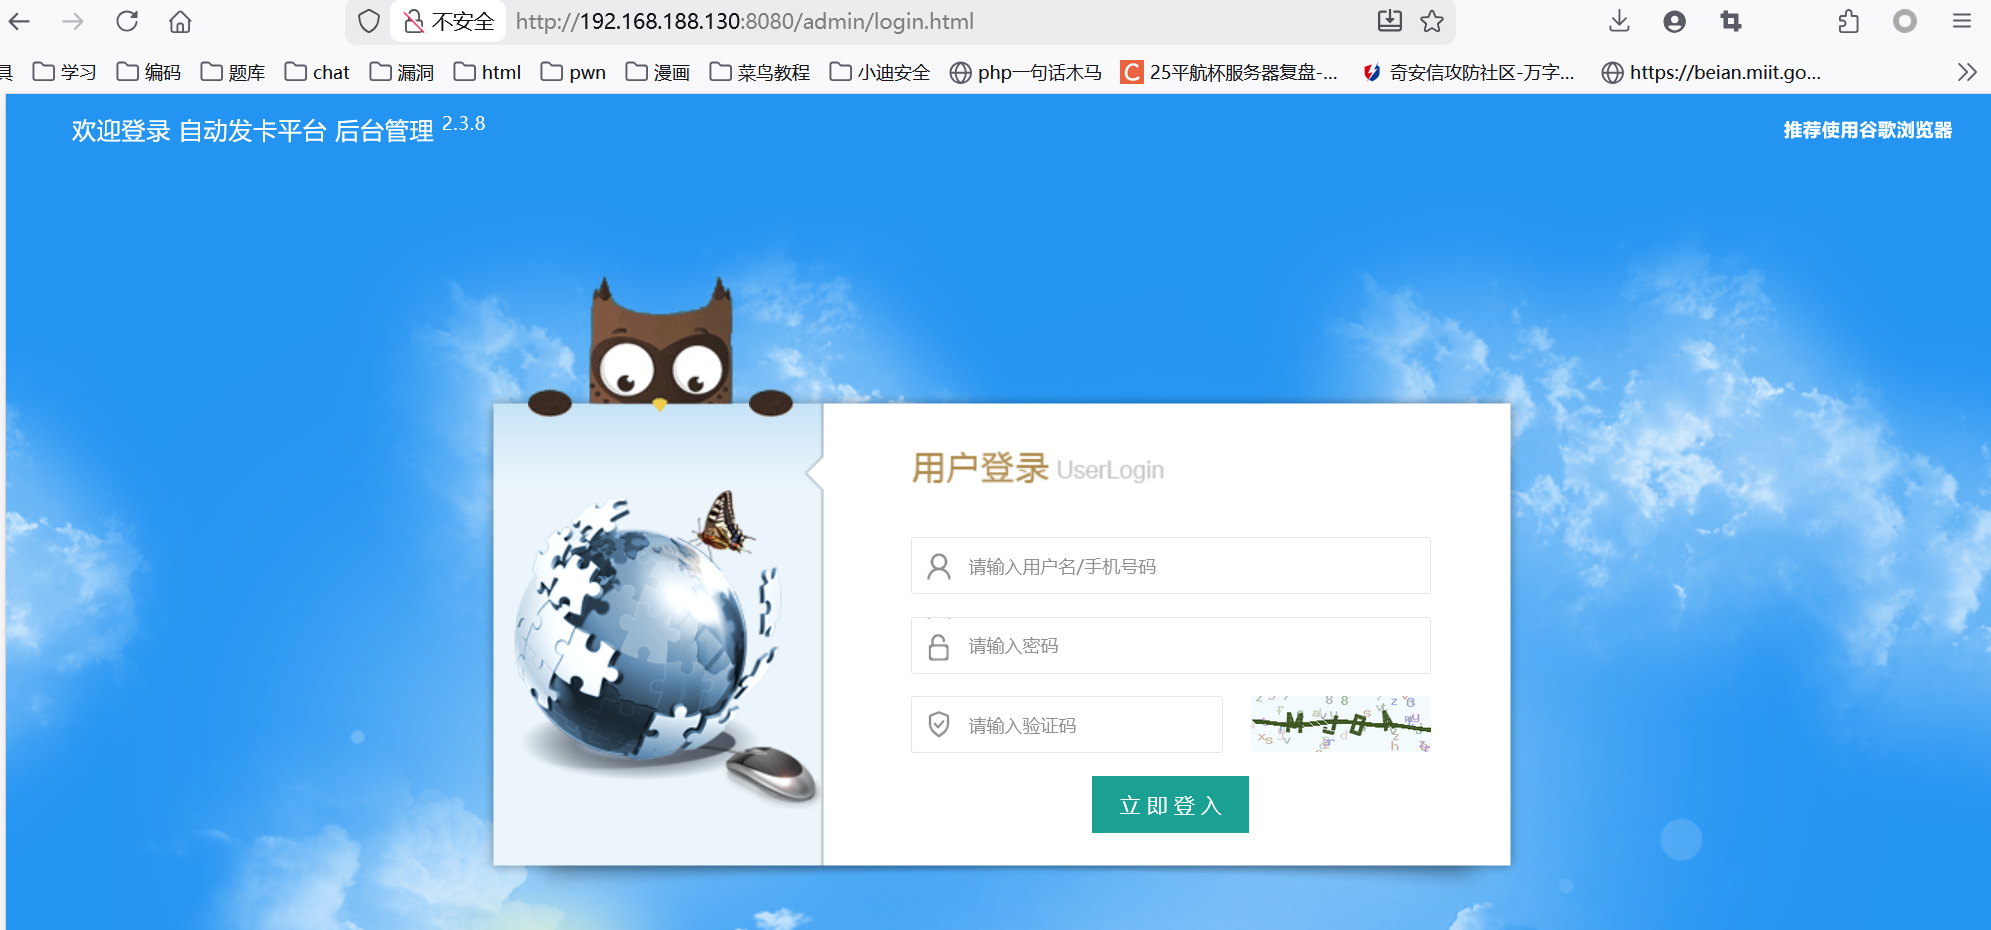
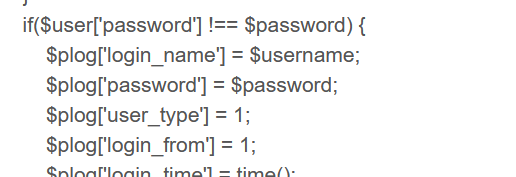
在login.php里看到密码是明文
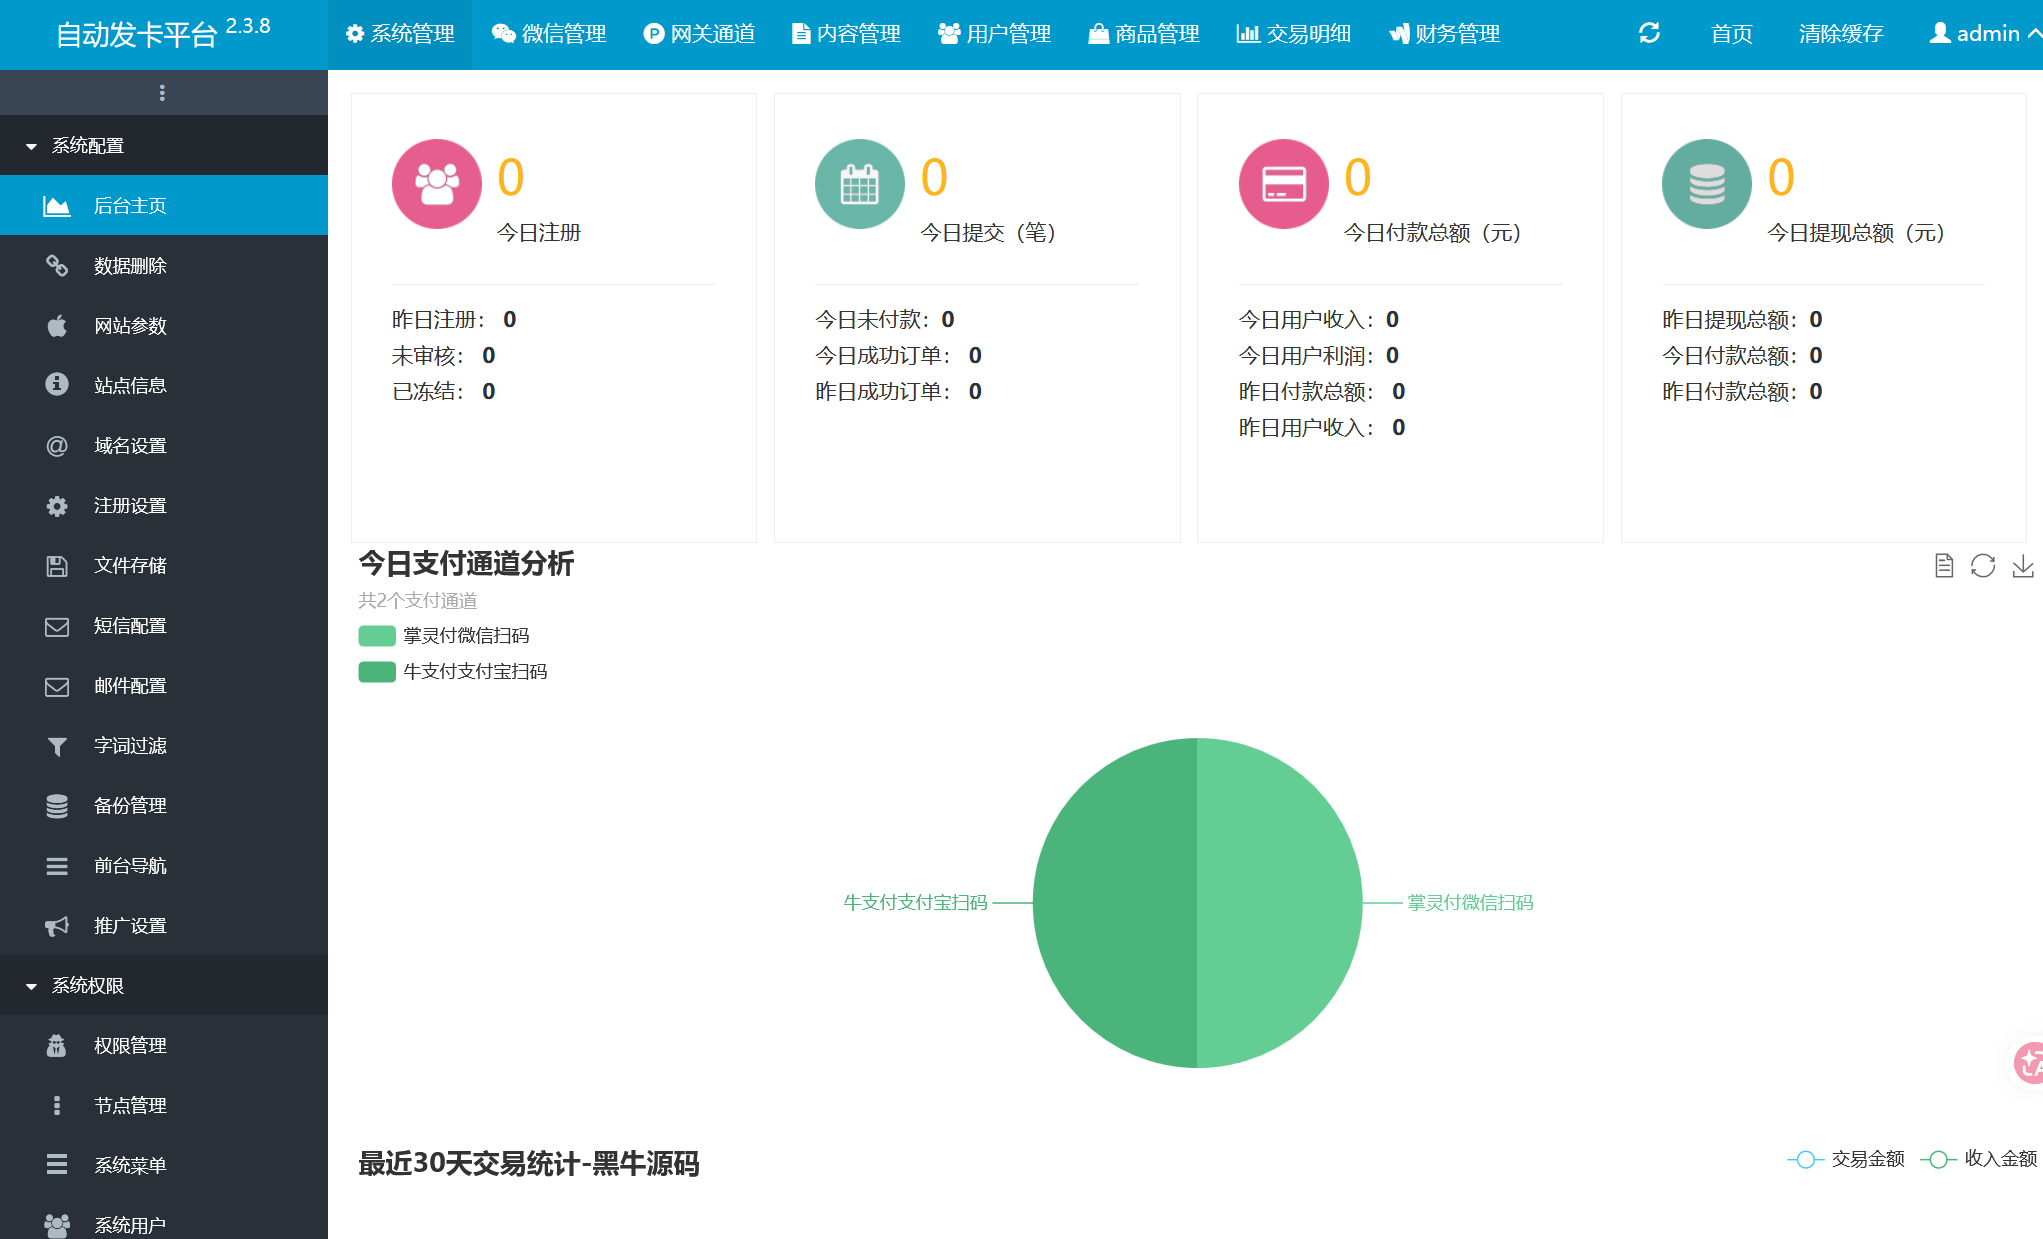
直接在数据库里找管理员的账号密码登录
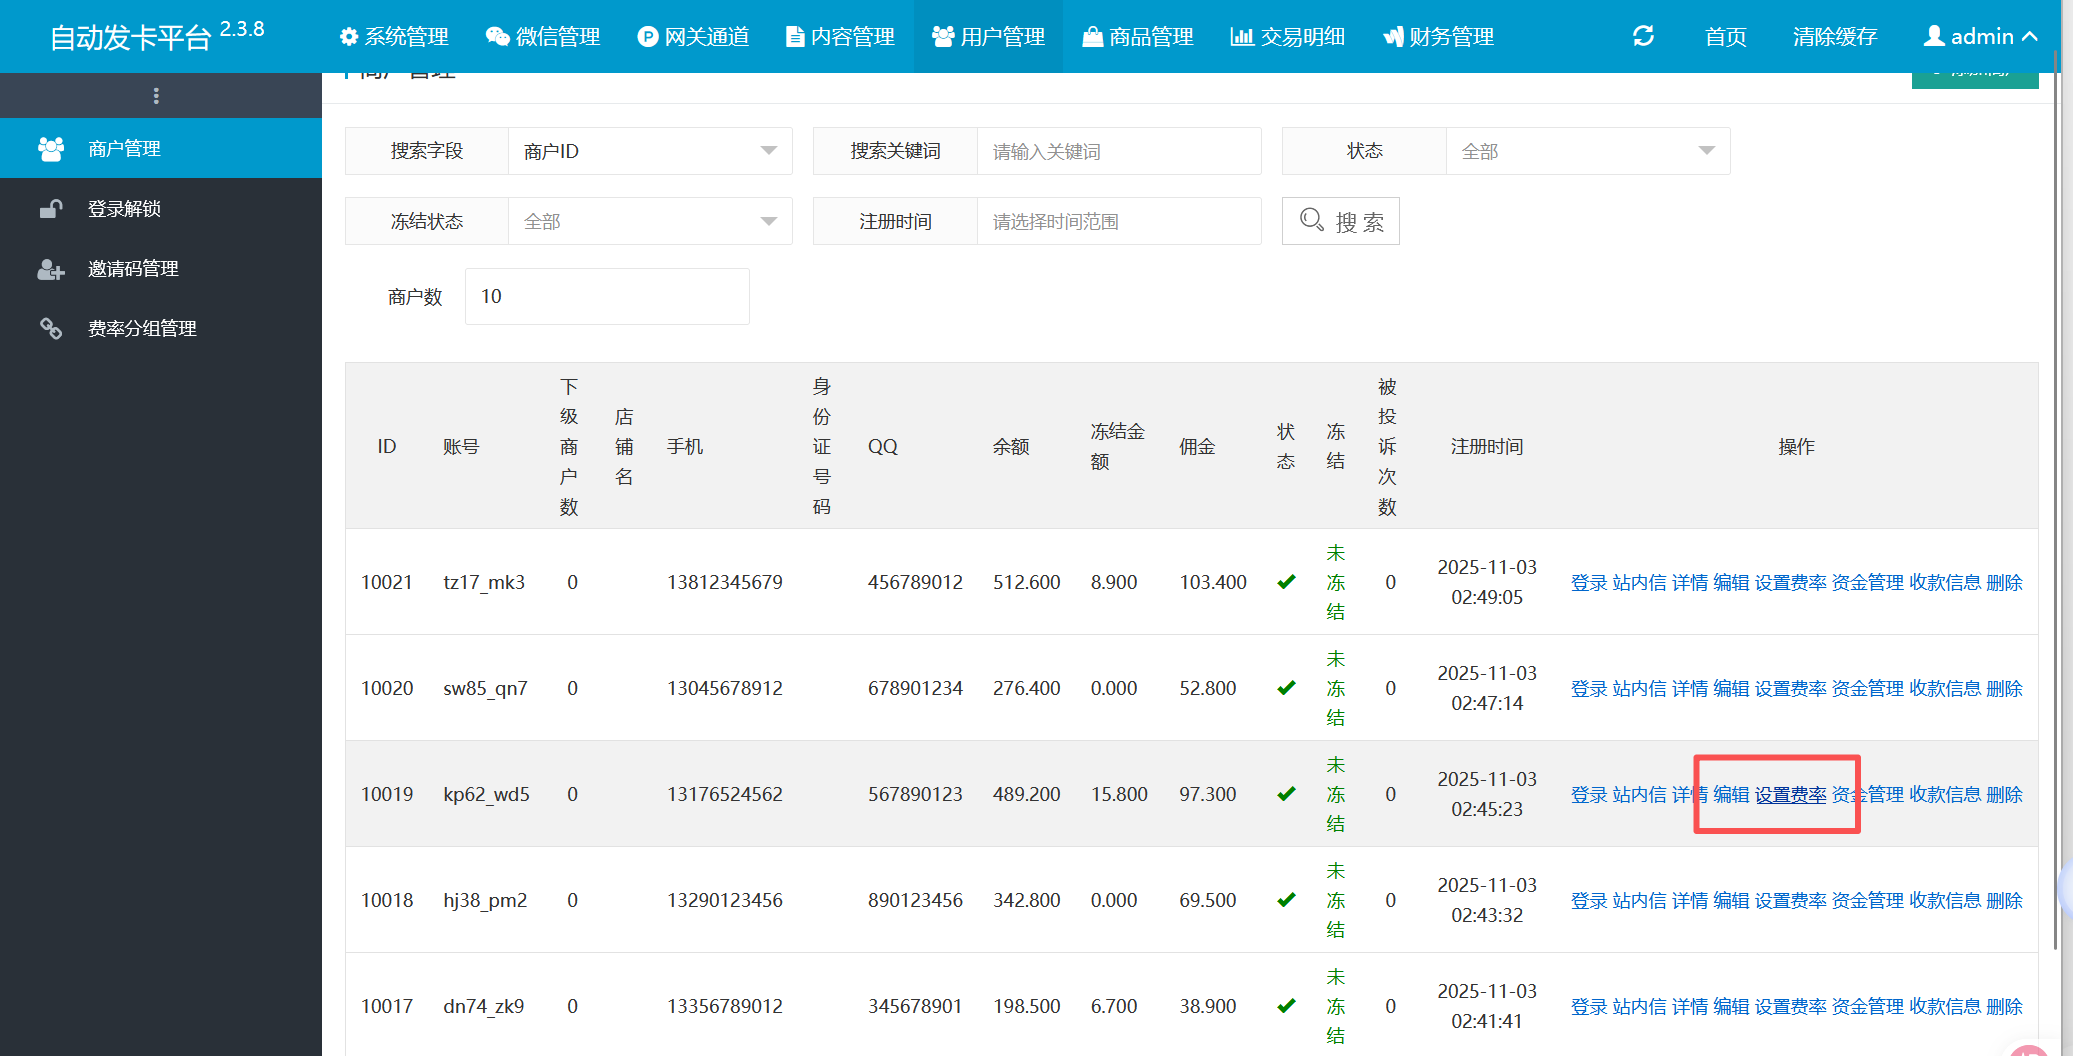
找到该商户,点击设置费率
注意千分率
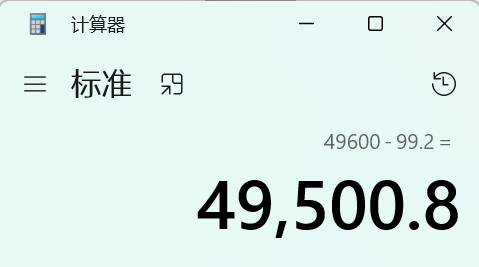
14 接上题,不考虑平台提现、网关通道费用的情况下,售卖的卡密共计净利多少元
49500.80
订单删除了,只能去看数据库
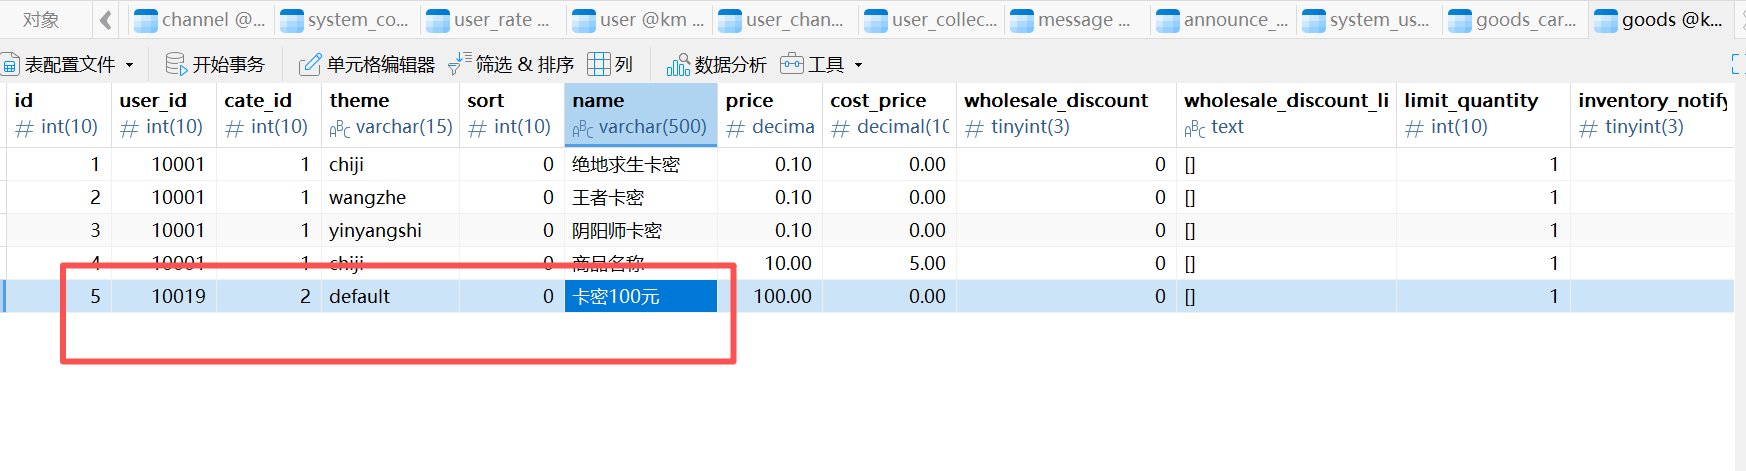
在数据库中看到卡密100元
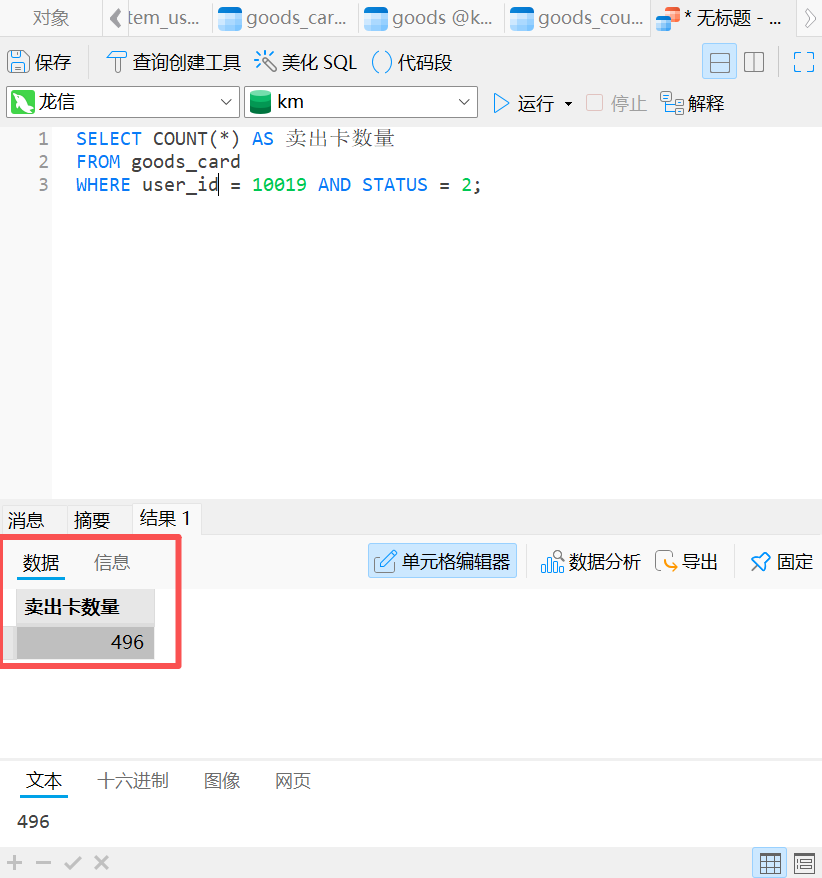
sql统计一下售卖了多少张
SELECT COUNT(*) AS 卖出卡数量
FROM goods_card
WHERE user_id = 10019 AND STATUS = 2;
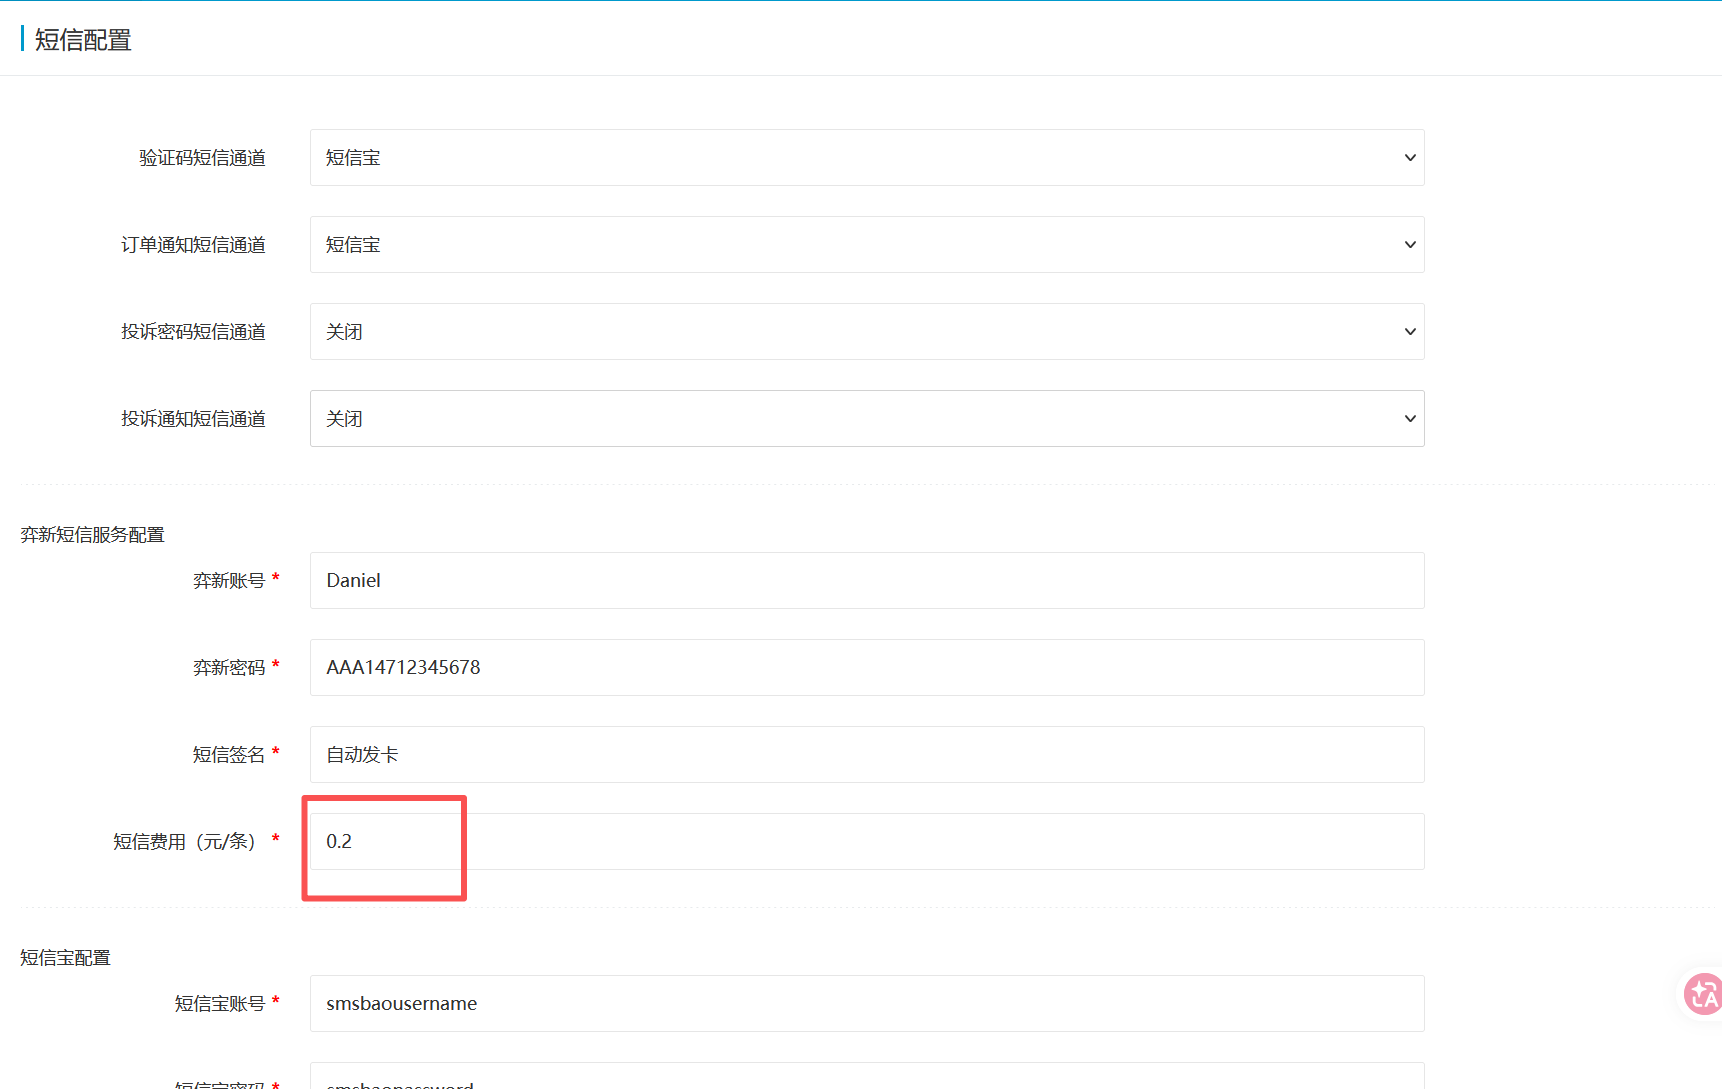
还得减去短信的钱
计算一下
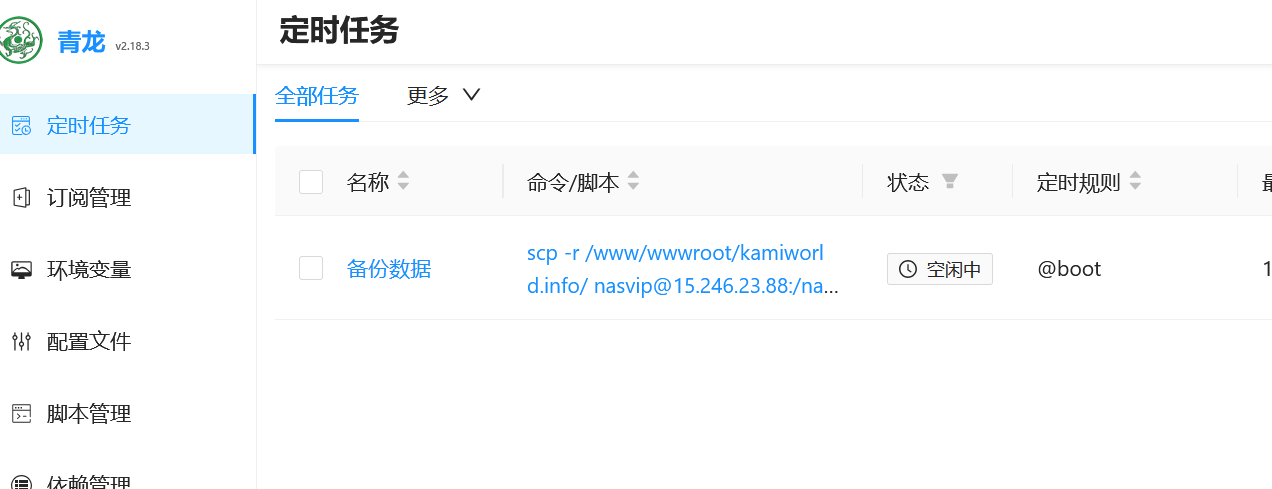
15 嫌疑人将卡密网站的数据定时备份至远程服务器,远程服务器IP
15.246.23.88
在docker服务中,看到还有青龙面板
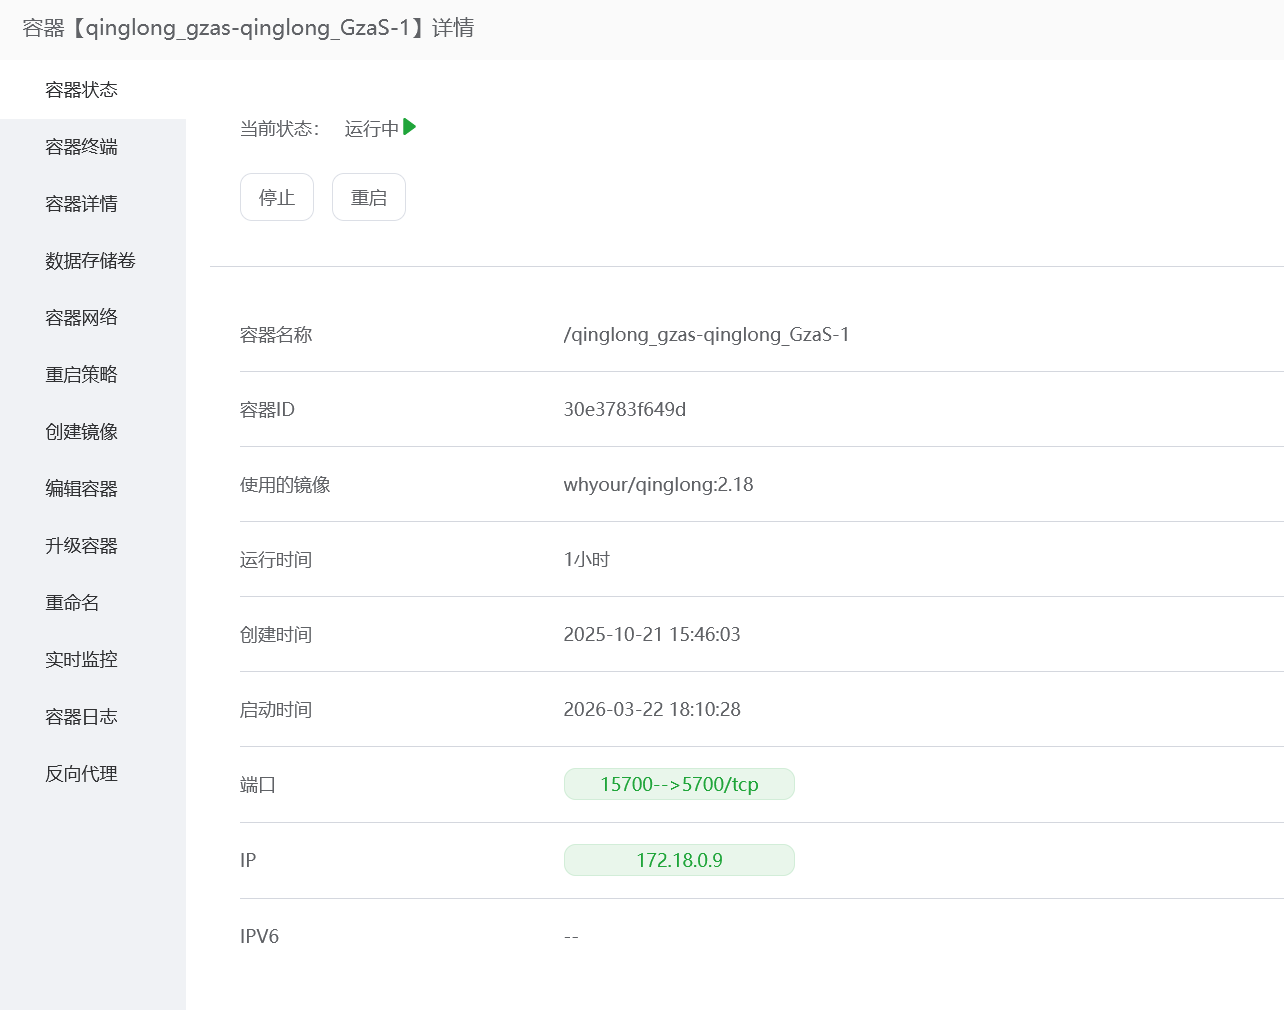
进入面板
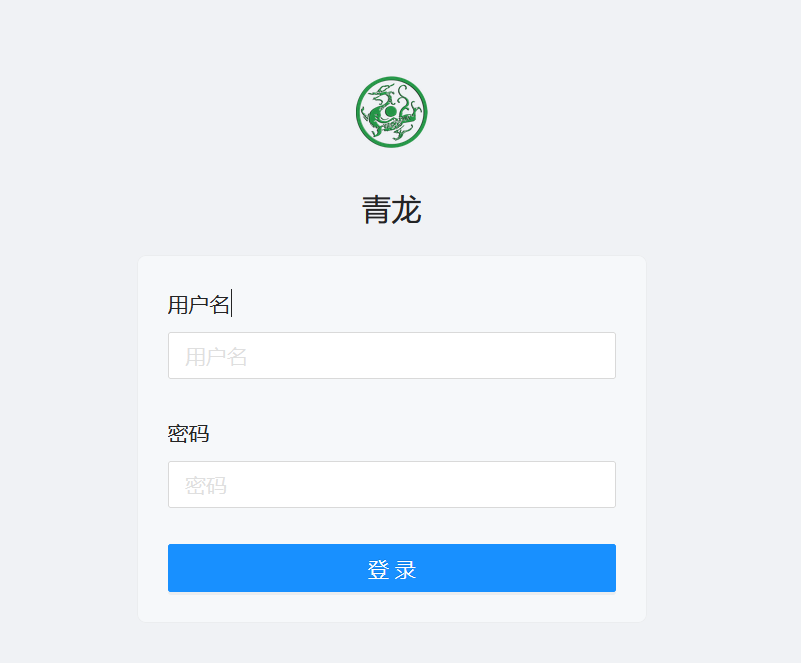
需要账号密码,在文件中找一下,找到数据库文件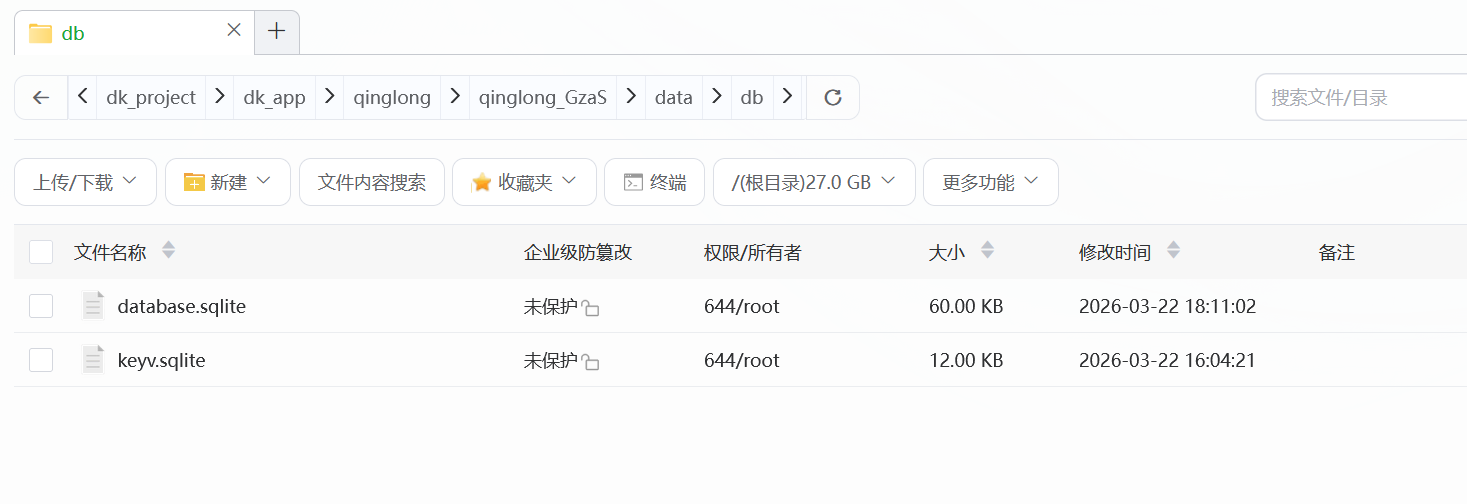
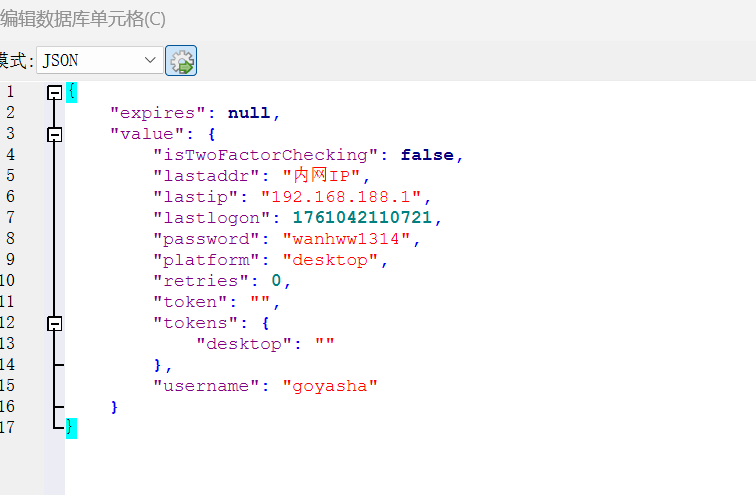
导出之后看到账号密码
进入面板,找到ip
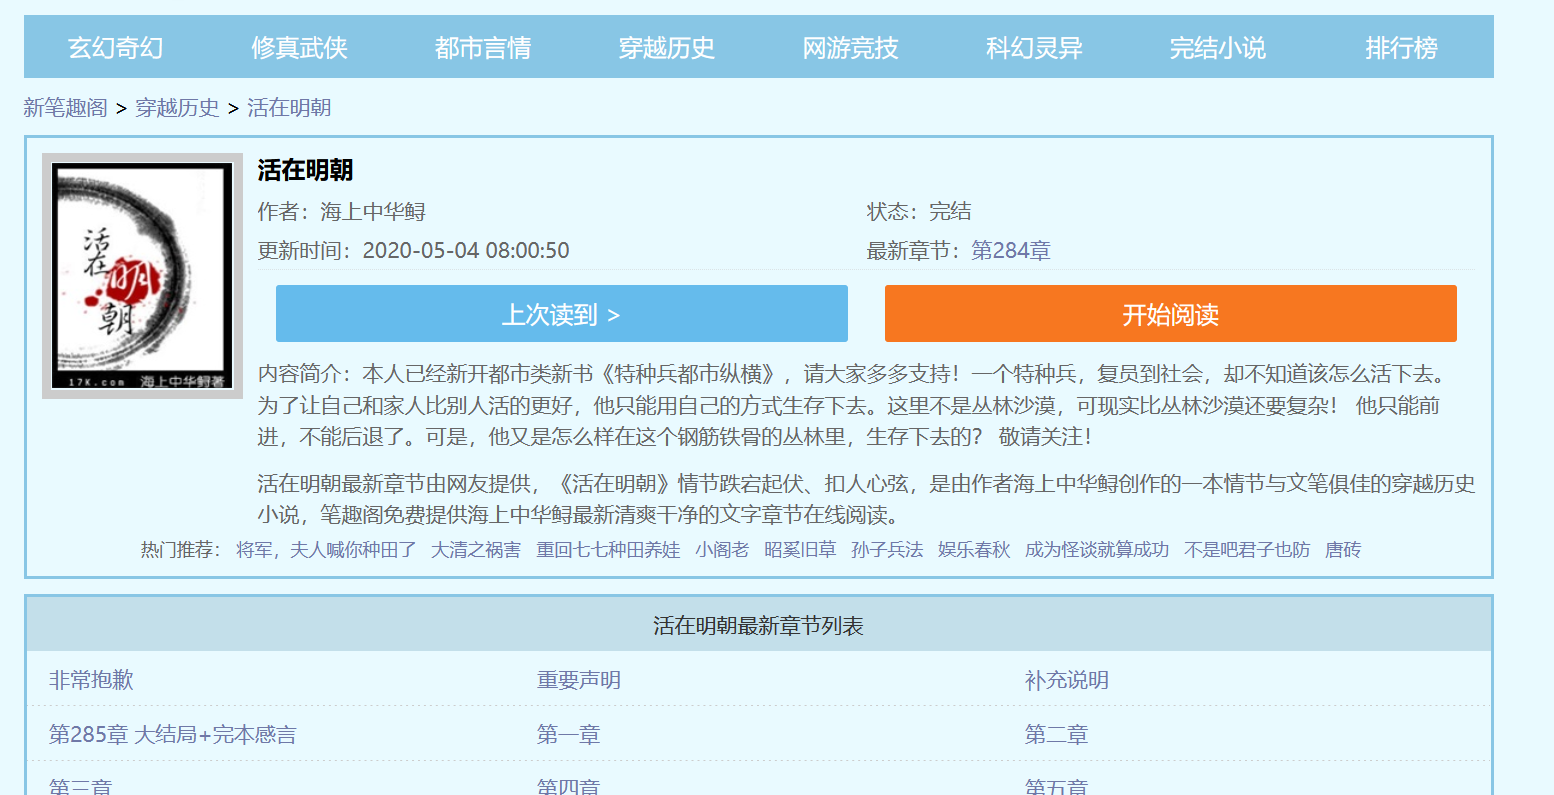
16 嫌疑人供述web虚拟机储存了一本名为"活在明朝"的小说,已经删除忘记怎么恢复了,请找到该小说并分析一共有多少章
285
docker容器中有koodoreader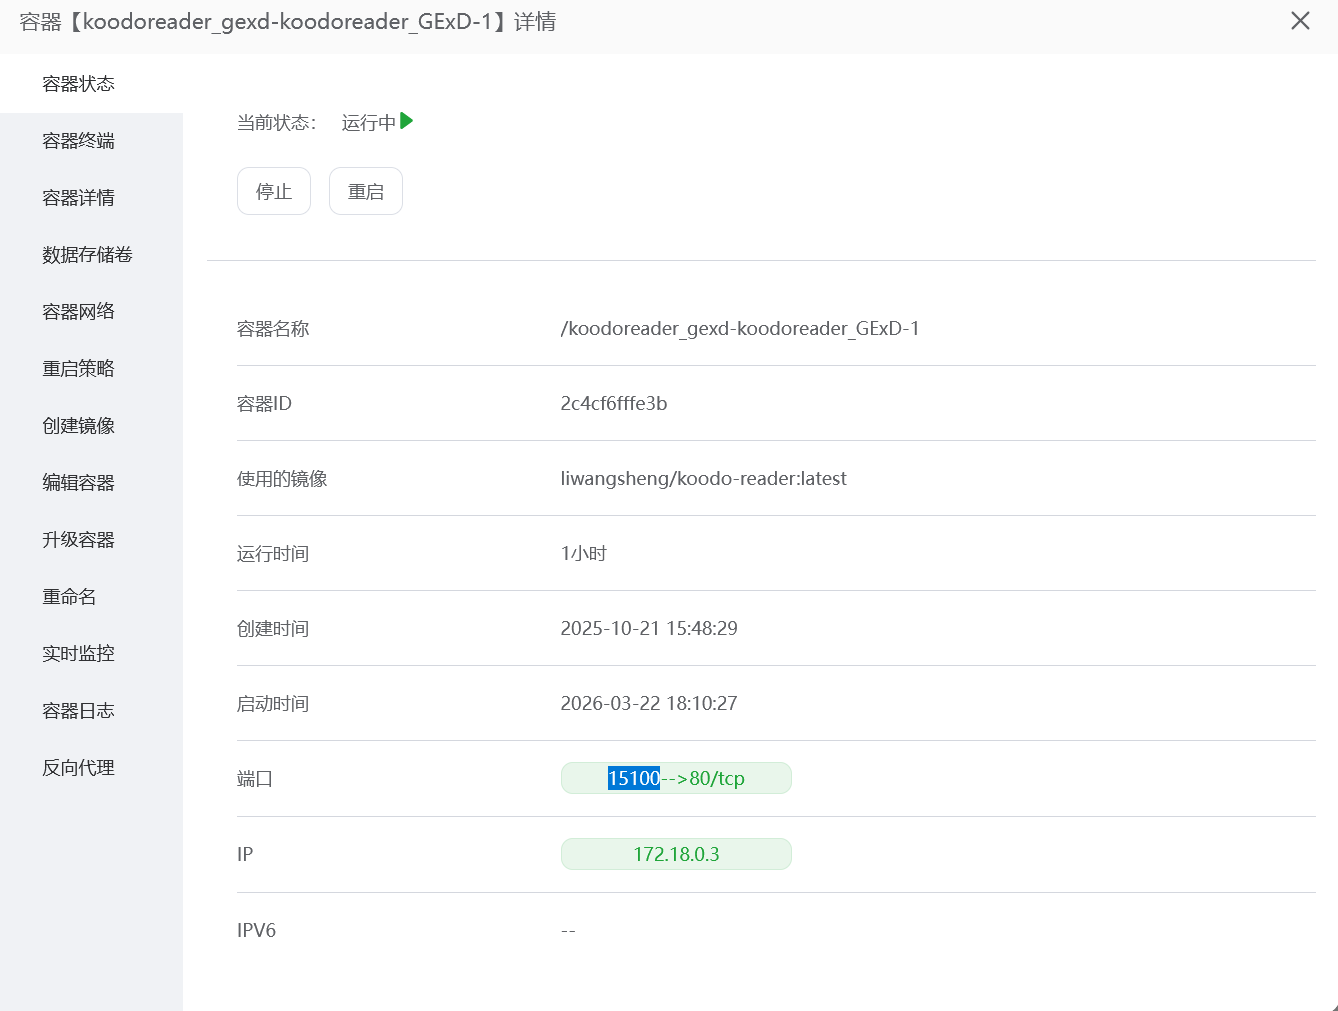
打开看一看
不知道为什么没有东西,搜索的话可以搜到
17 接上题,小说是什么时候删除的
20251021-183348
如果有内容的话,点击备份然后看delete的json文件可以看到
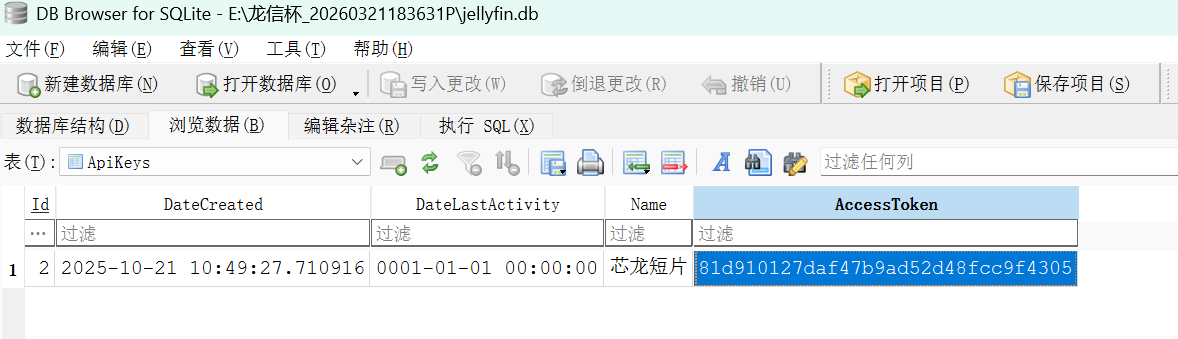
18 有一个外部程序"芯龙短片"跟web服务器媒体系统进行通信,其API通信密钥
81d910127daf47b9ad52d48fcc9f4305
在jellyfin容器里,需要账号密码
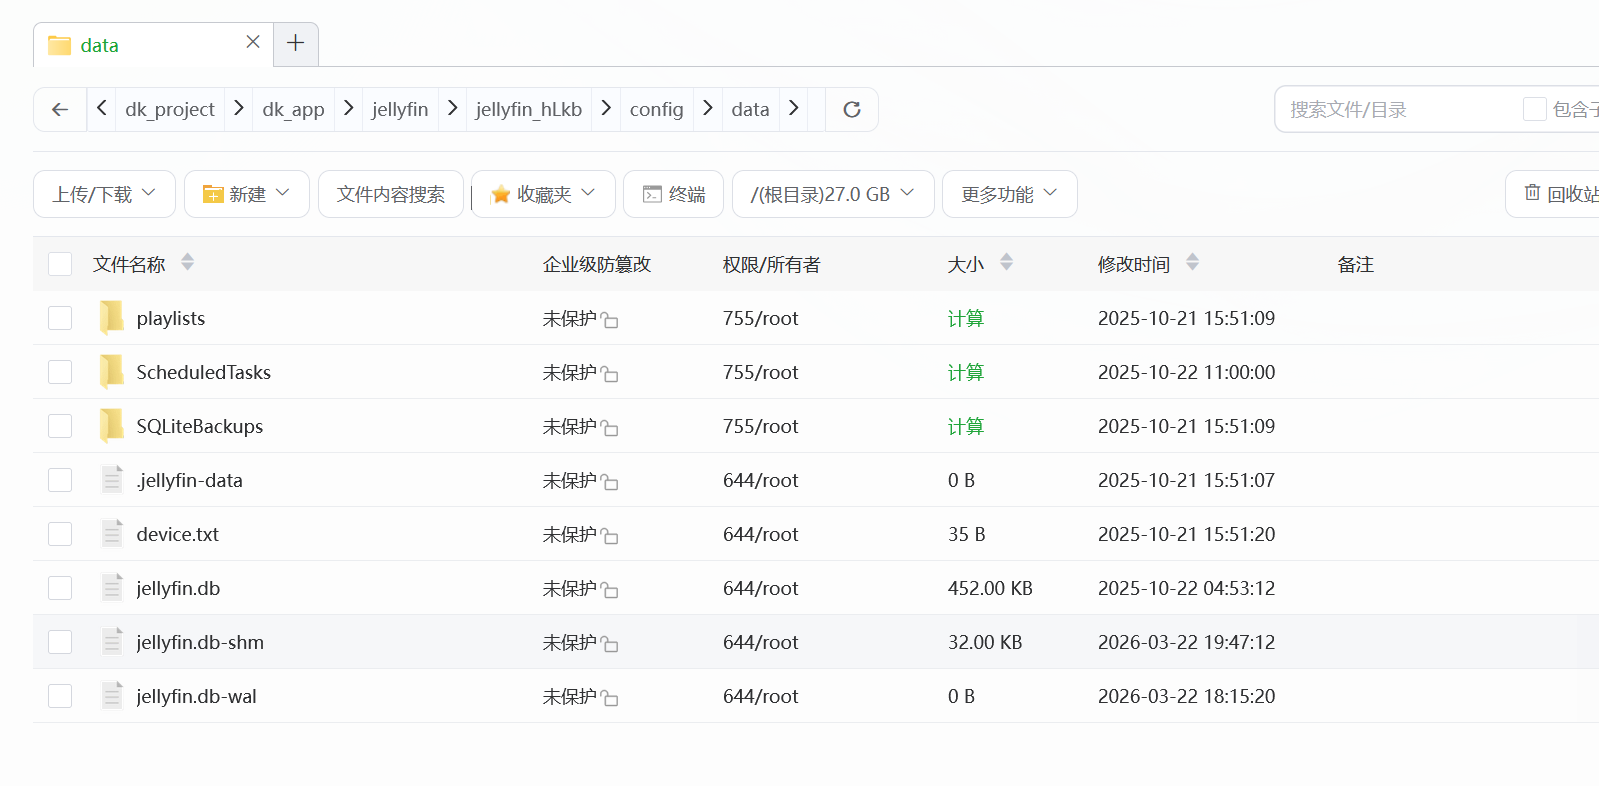
我们查看文件
导出查看一下,看到通信密钥
19 接上题,媒体系统管理员最后登录的时间
**20251021-184752 **
刚刚在config目录下看到了password,打开看到用户名
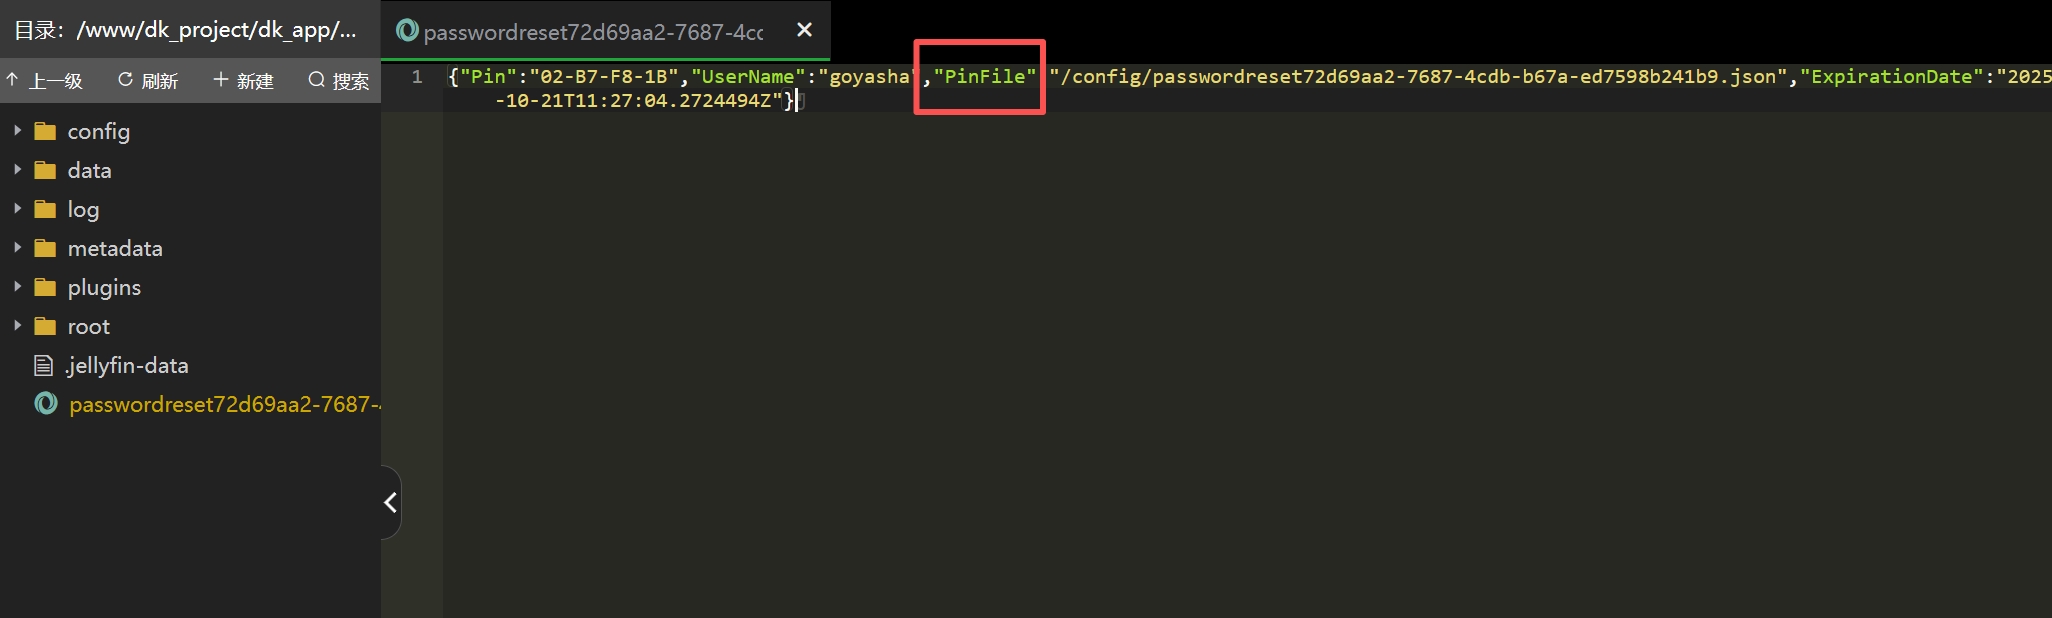
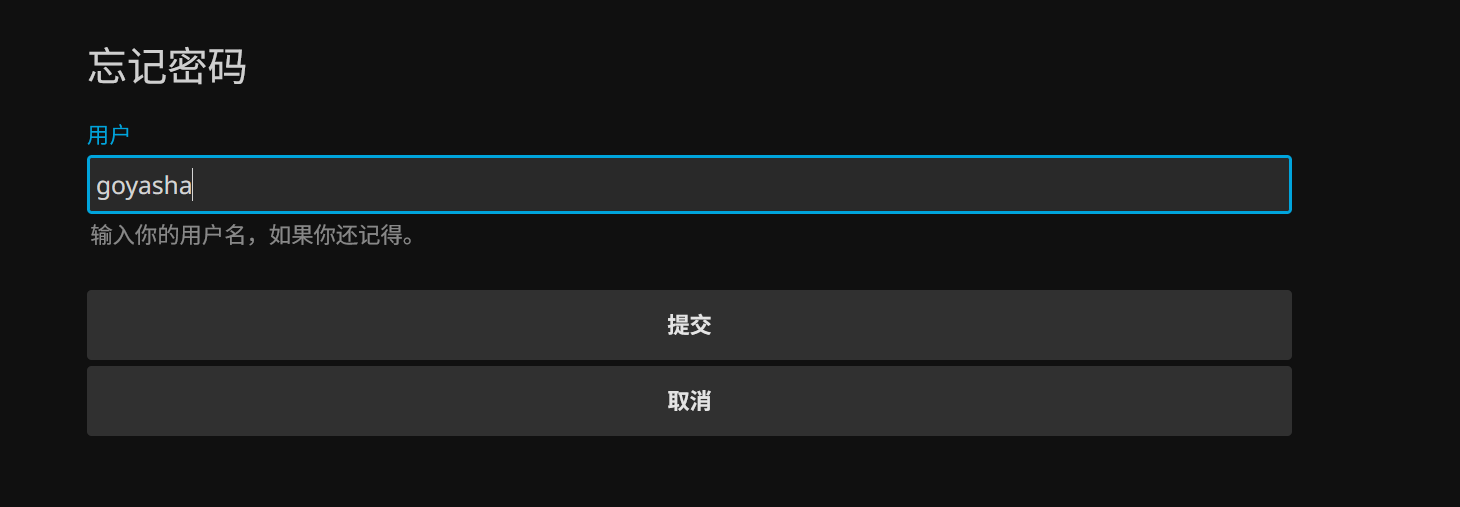
重置密码
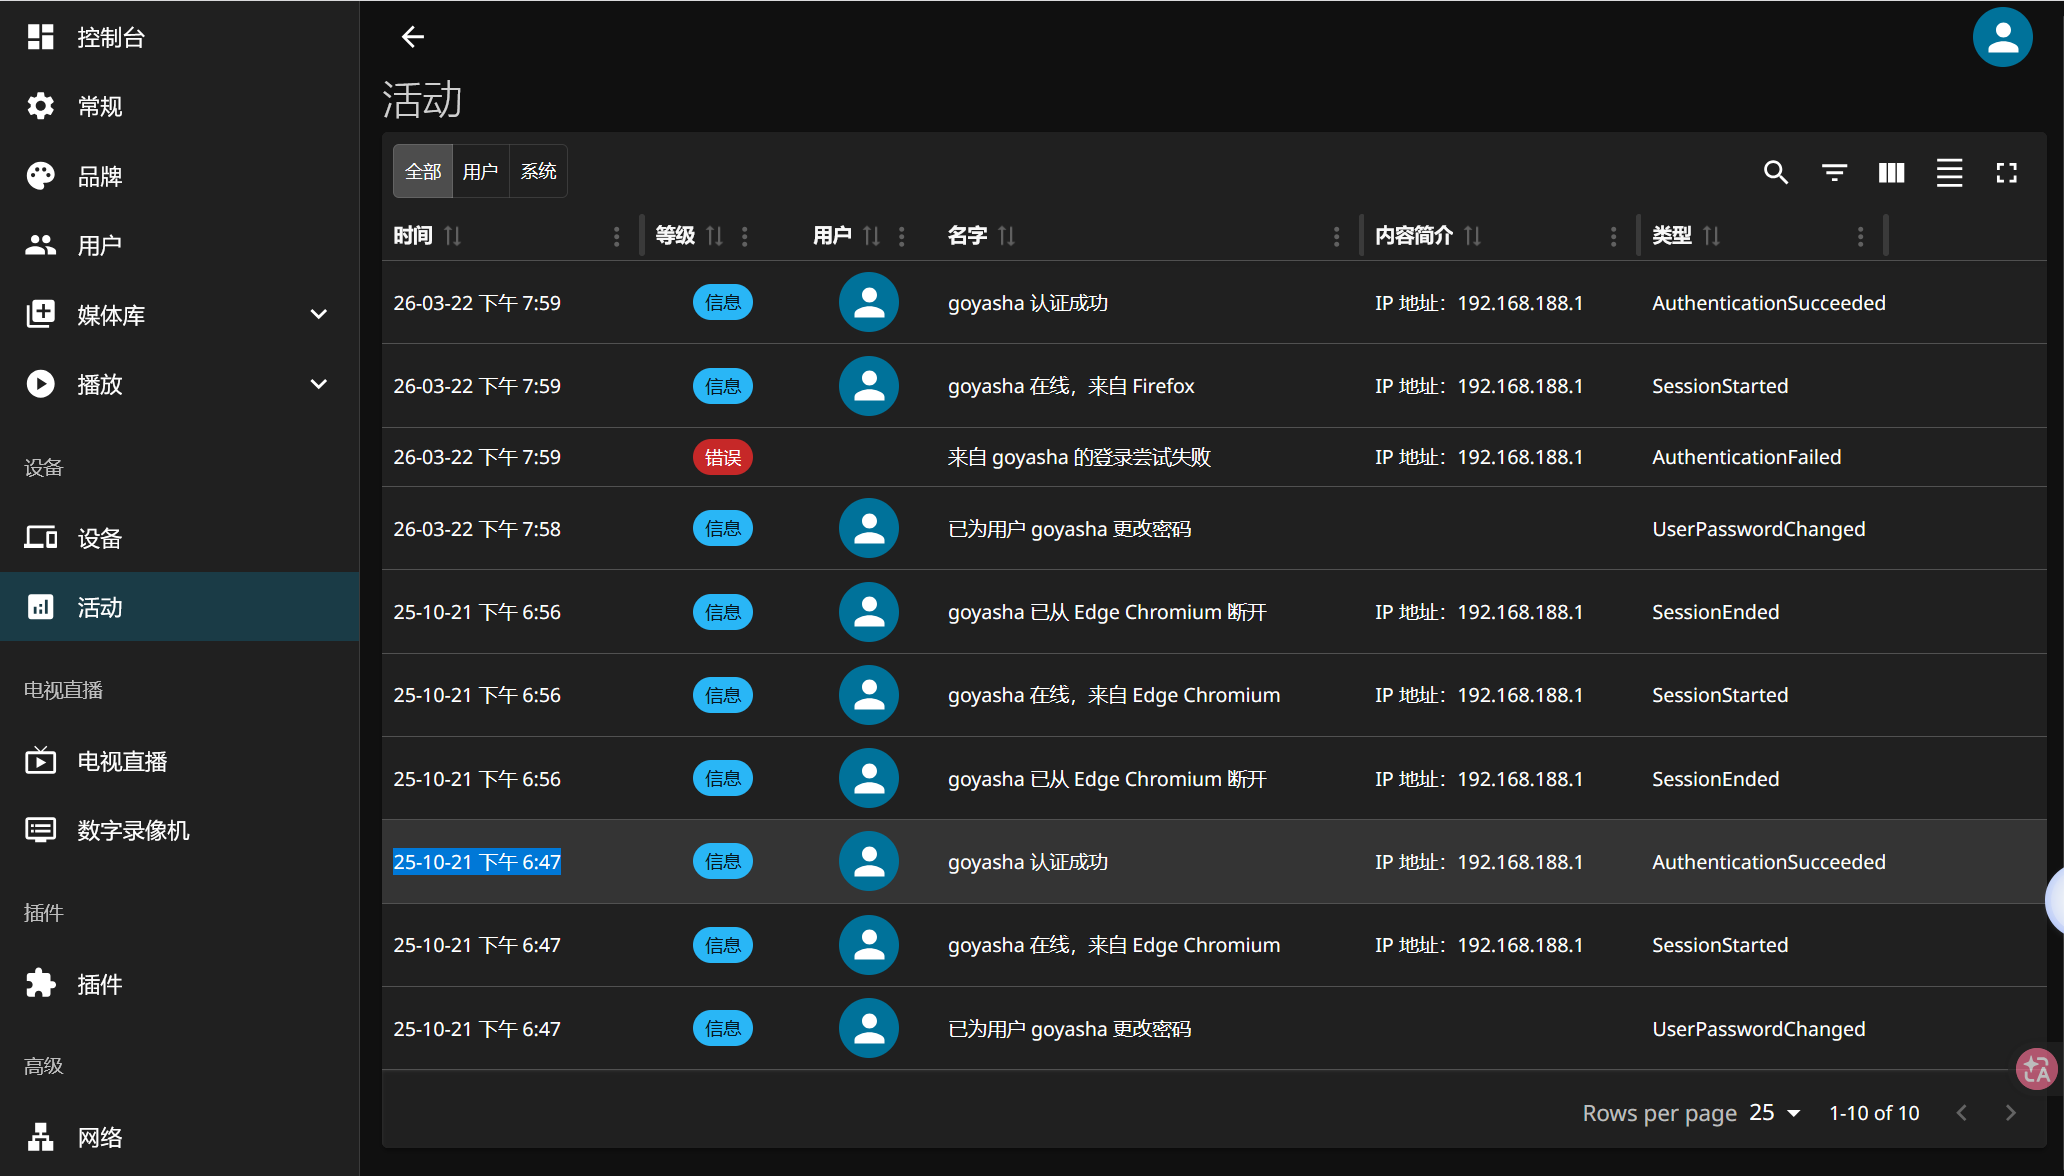
新的文件下找到密码,进入网站找到时间
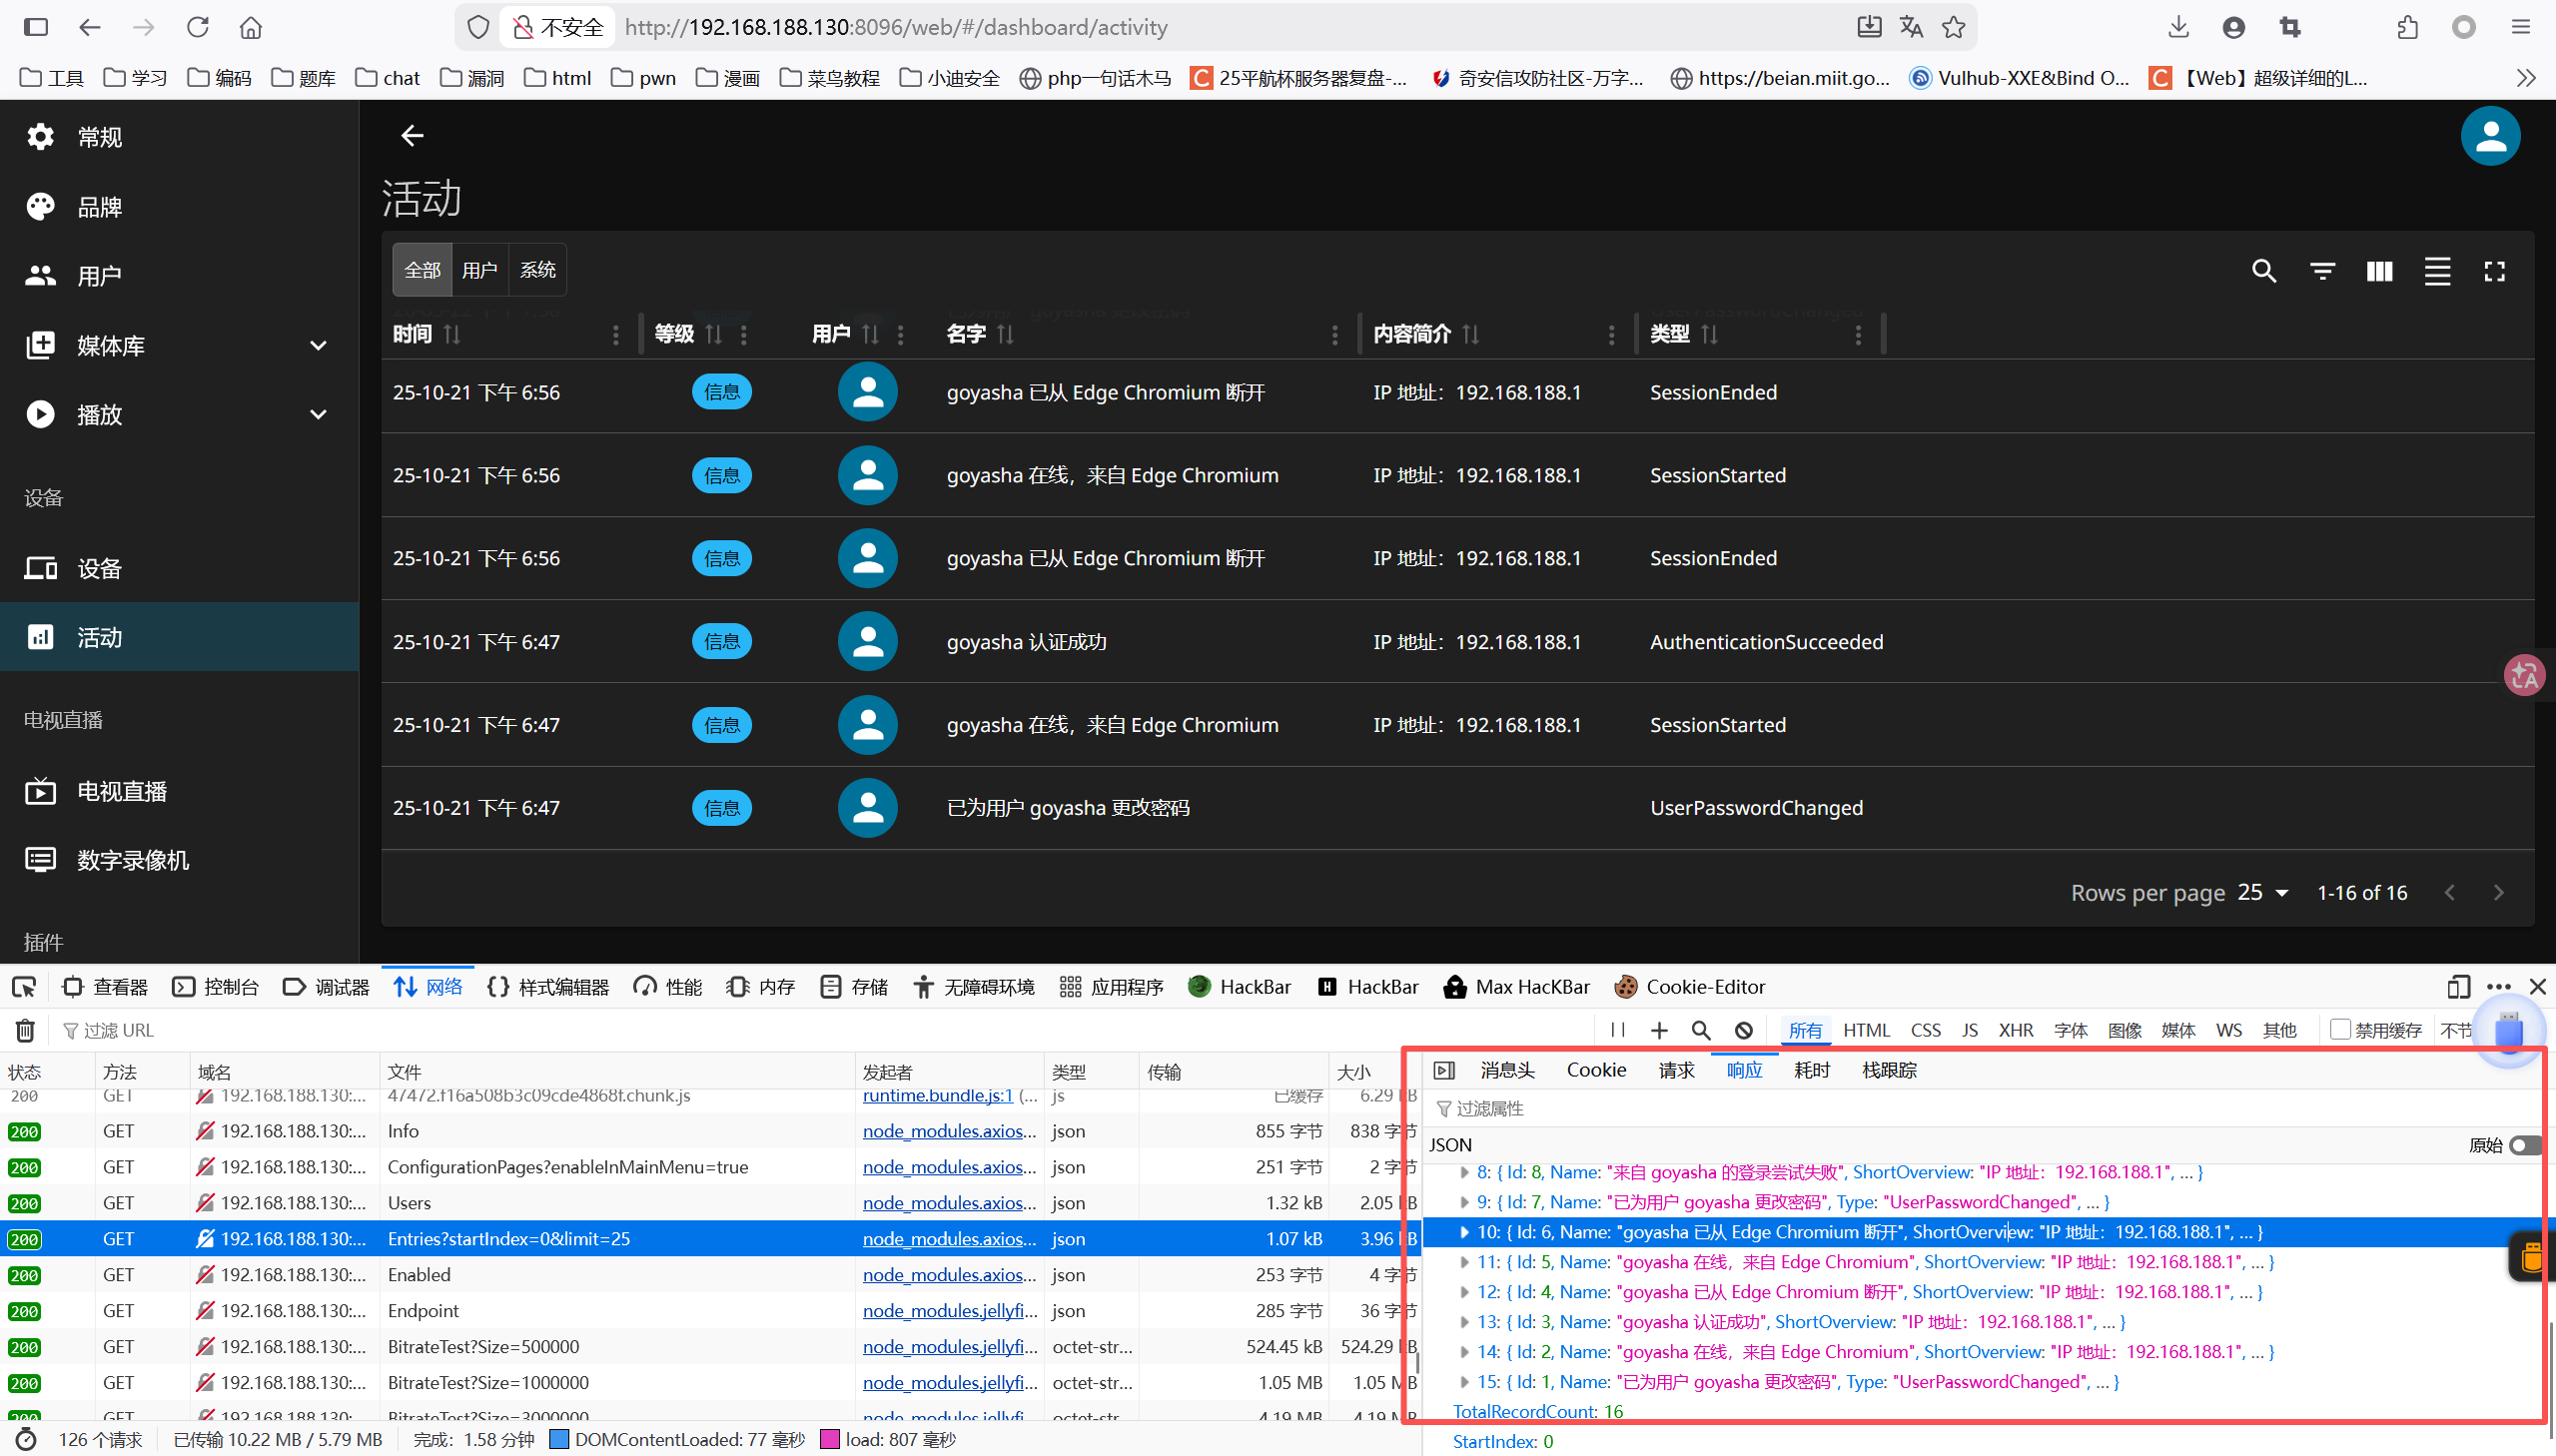
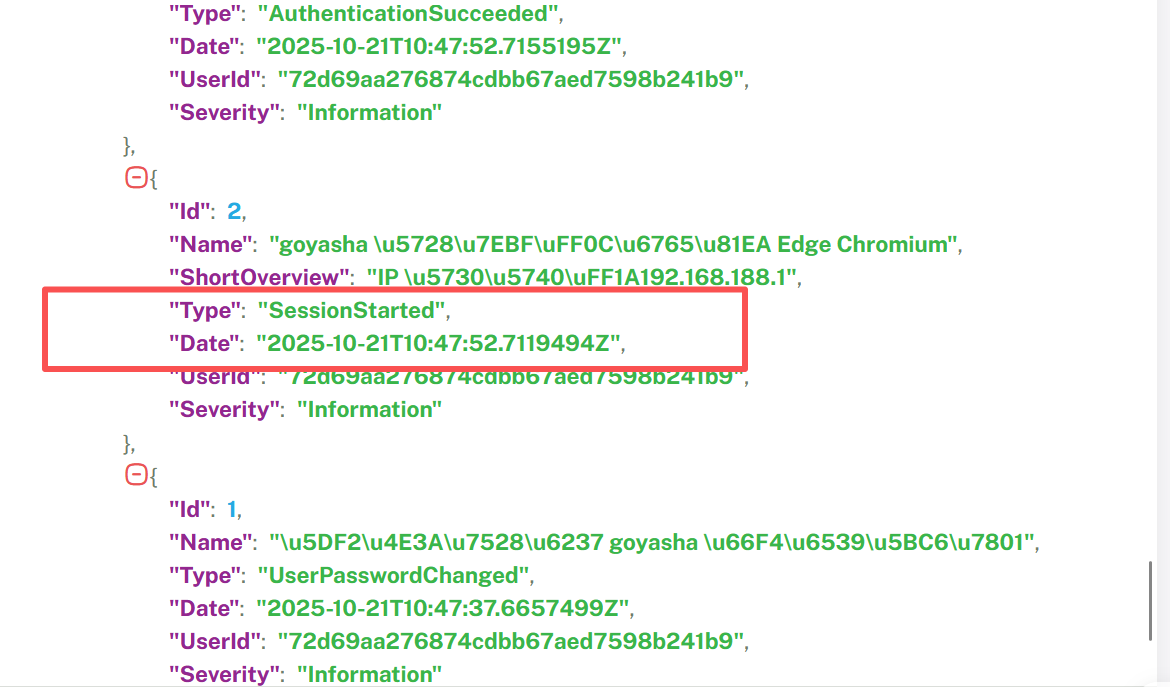
F12打开api精确到秒
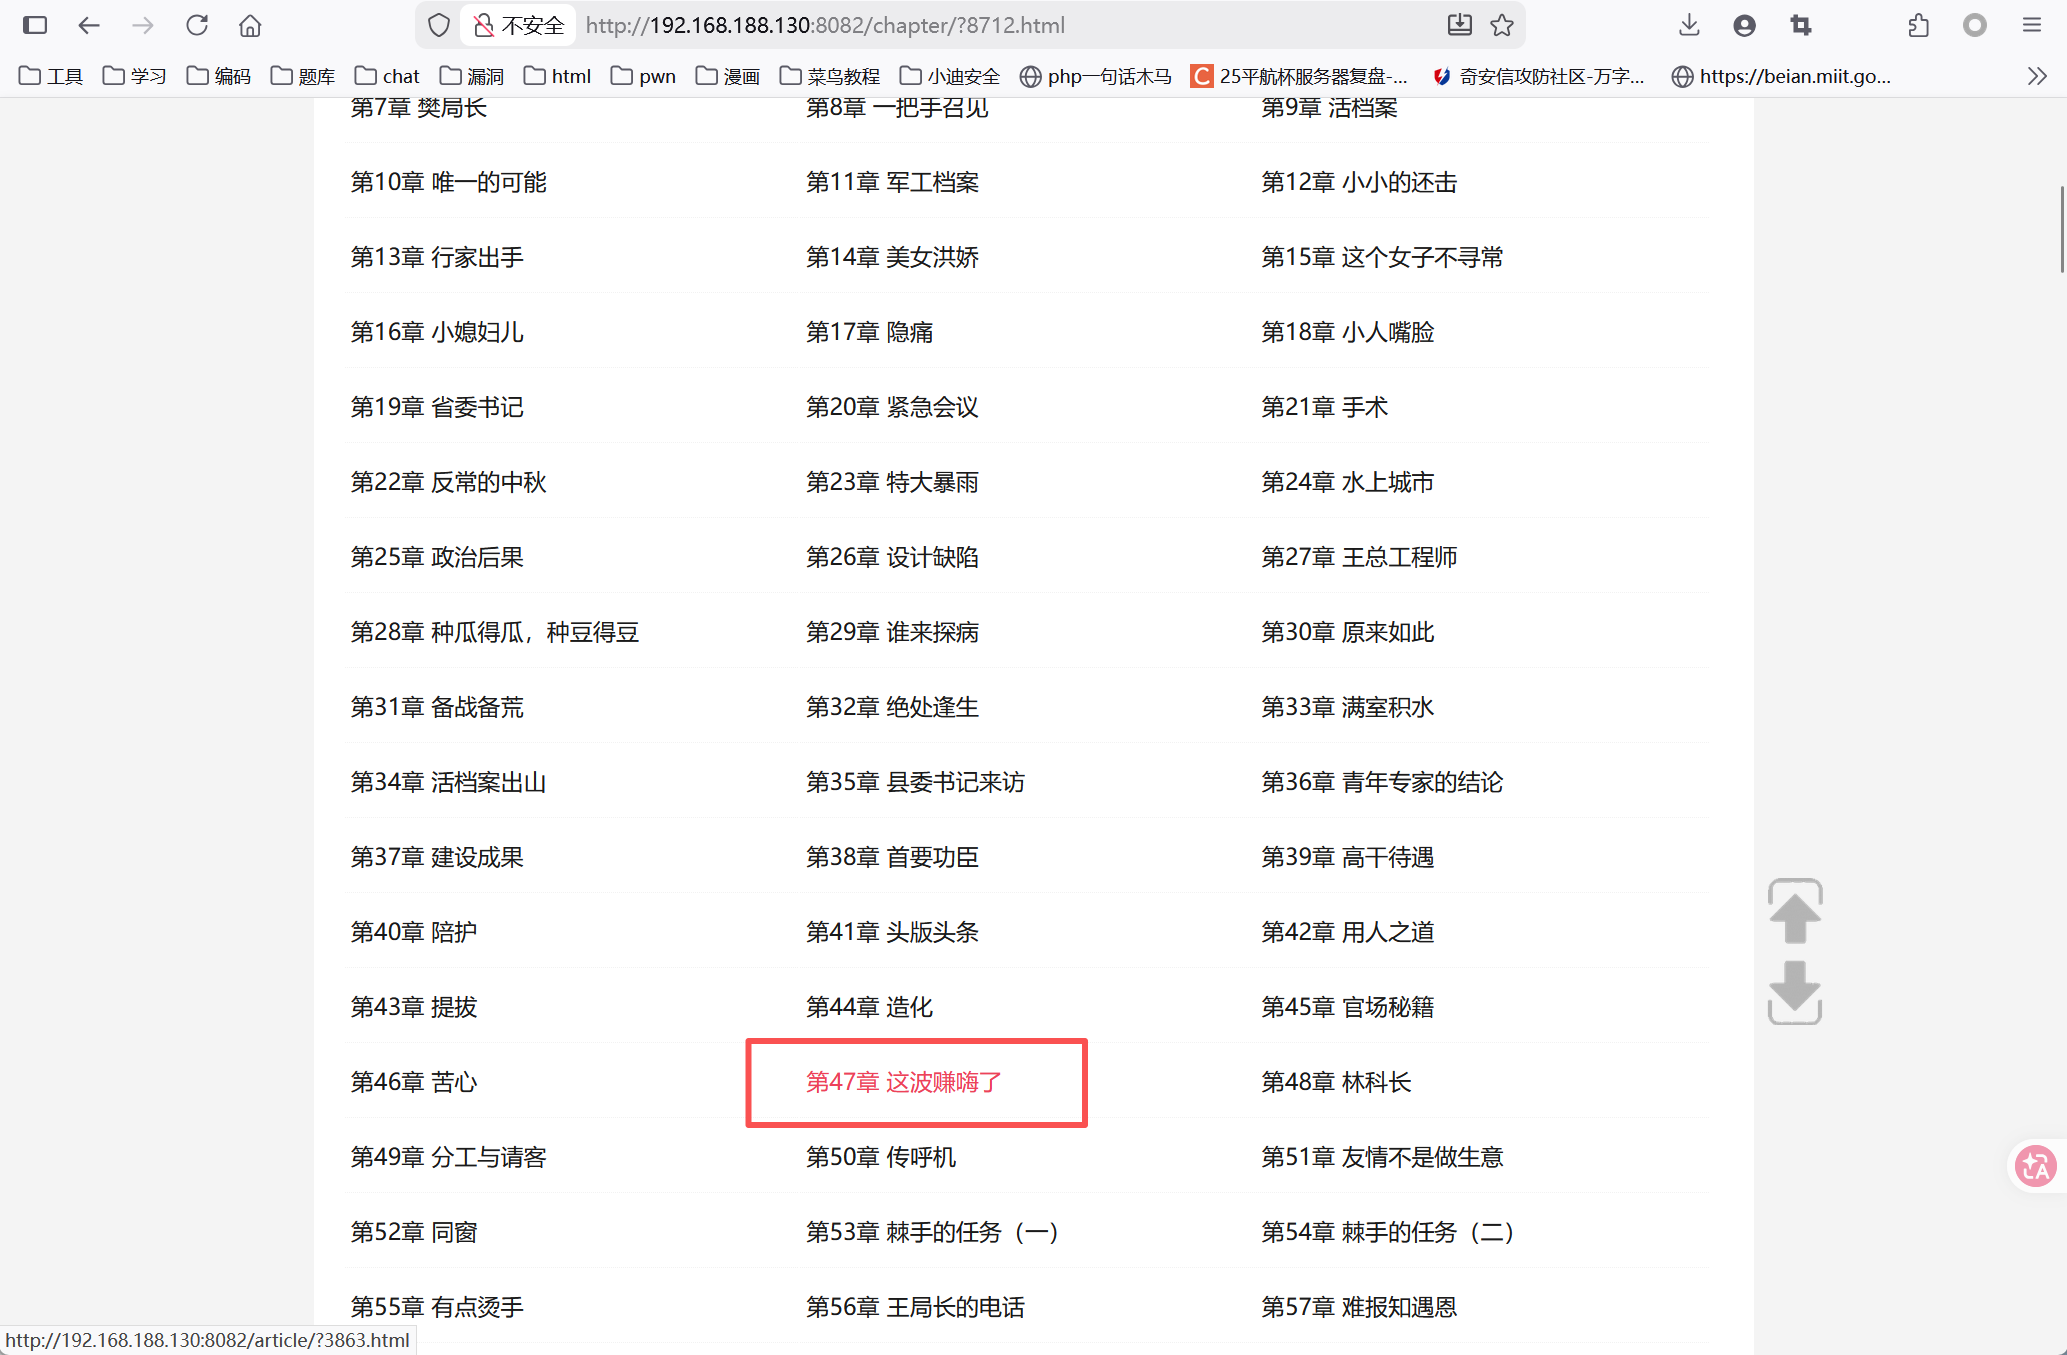
20 小说网站"升迁之路"小说第47章叫什么名字
这波赚嗨了
又开始构建小说网站,依旧先添加host
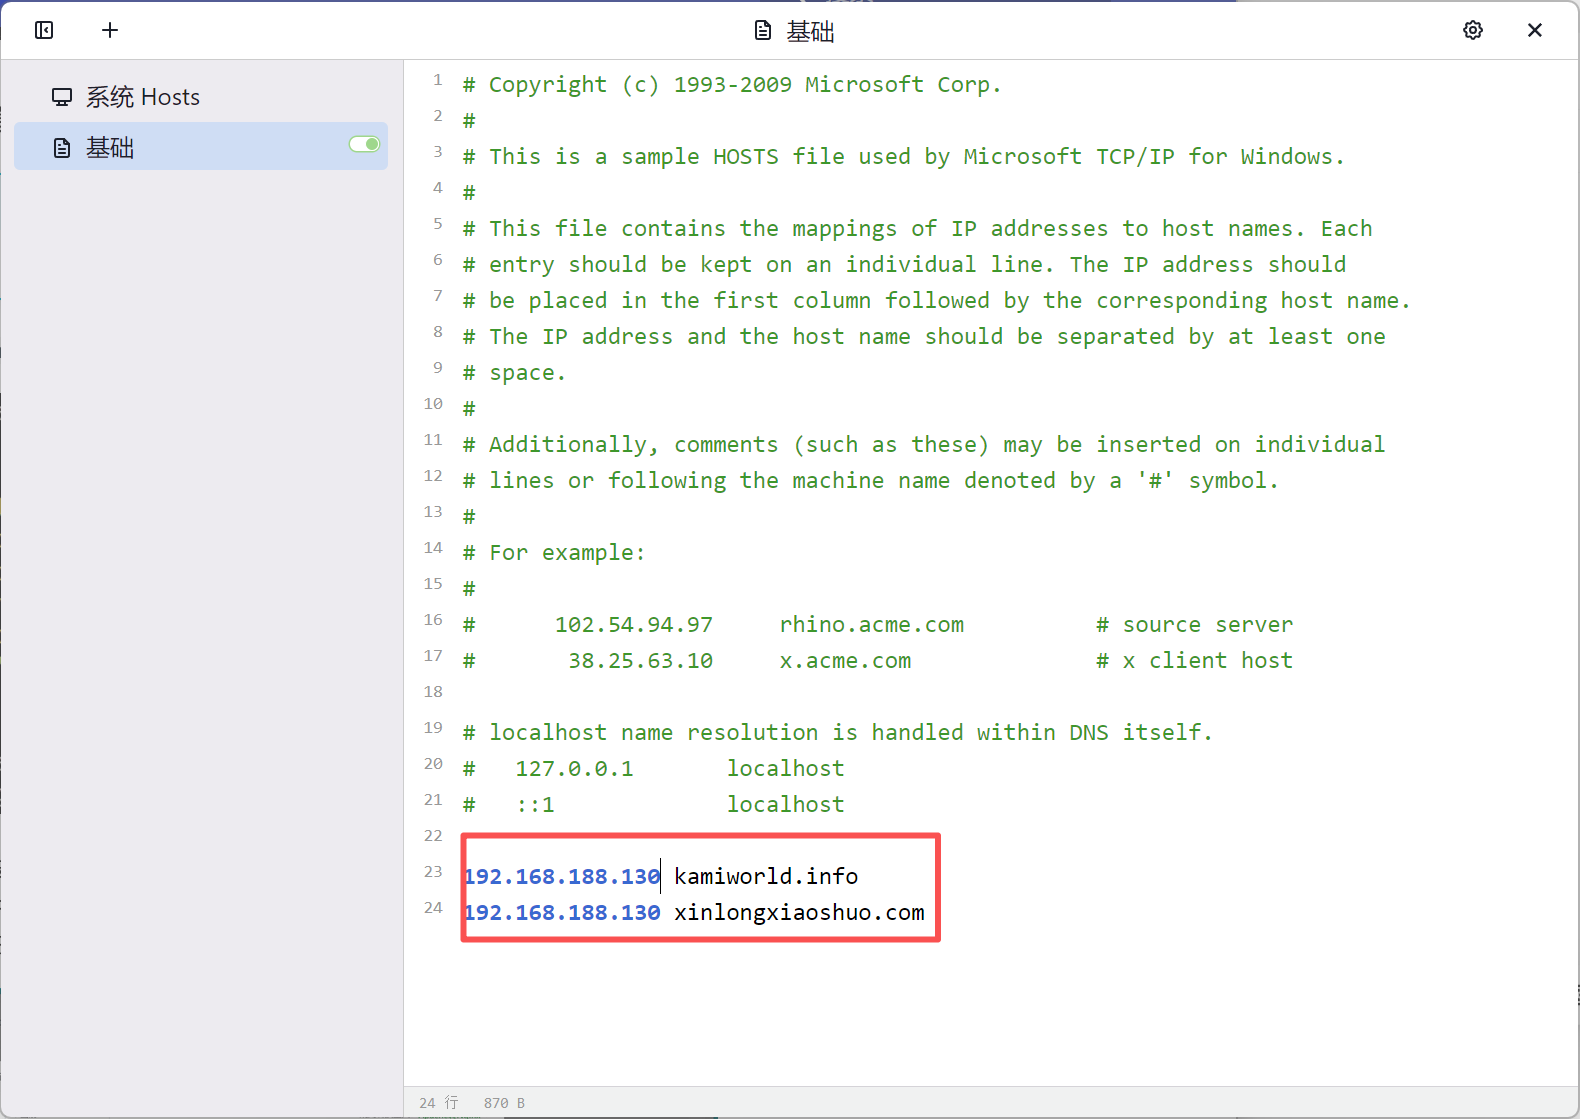
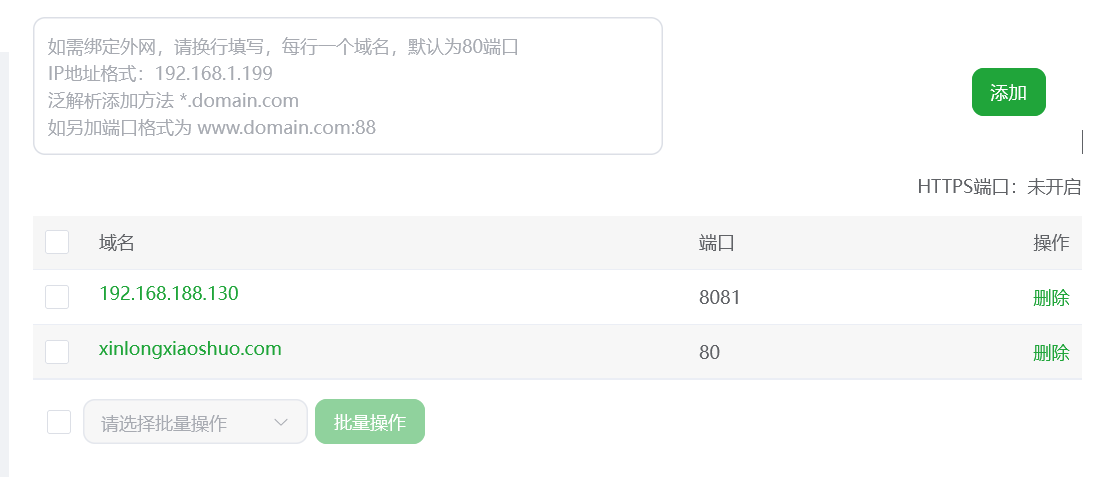
添加域名
打开网站依旧报错
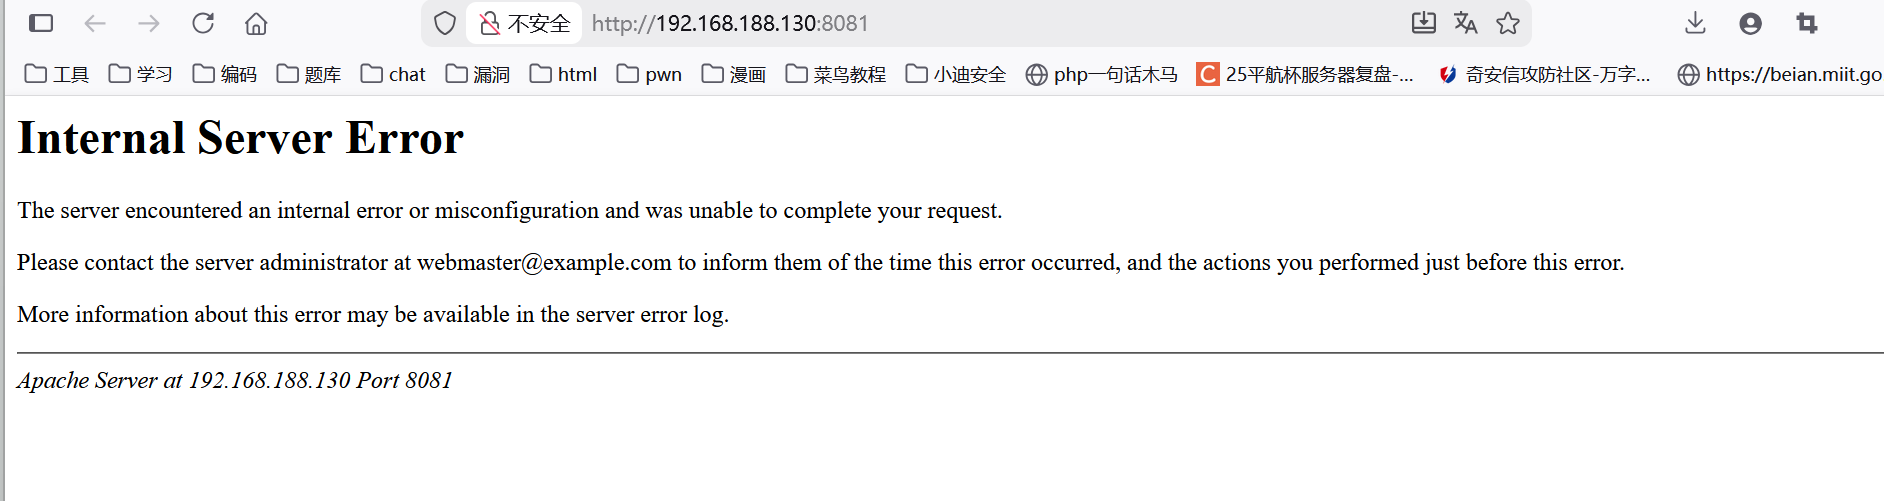
在网站根目录下找到备份的htaccess文件
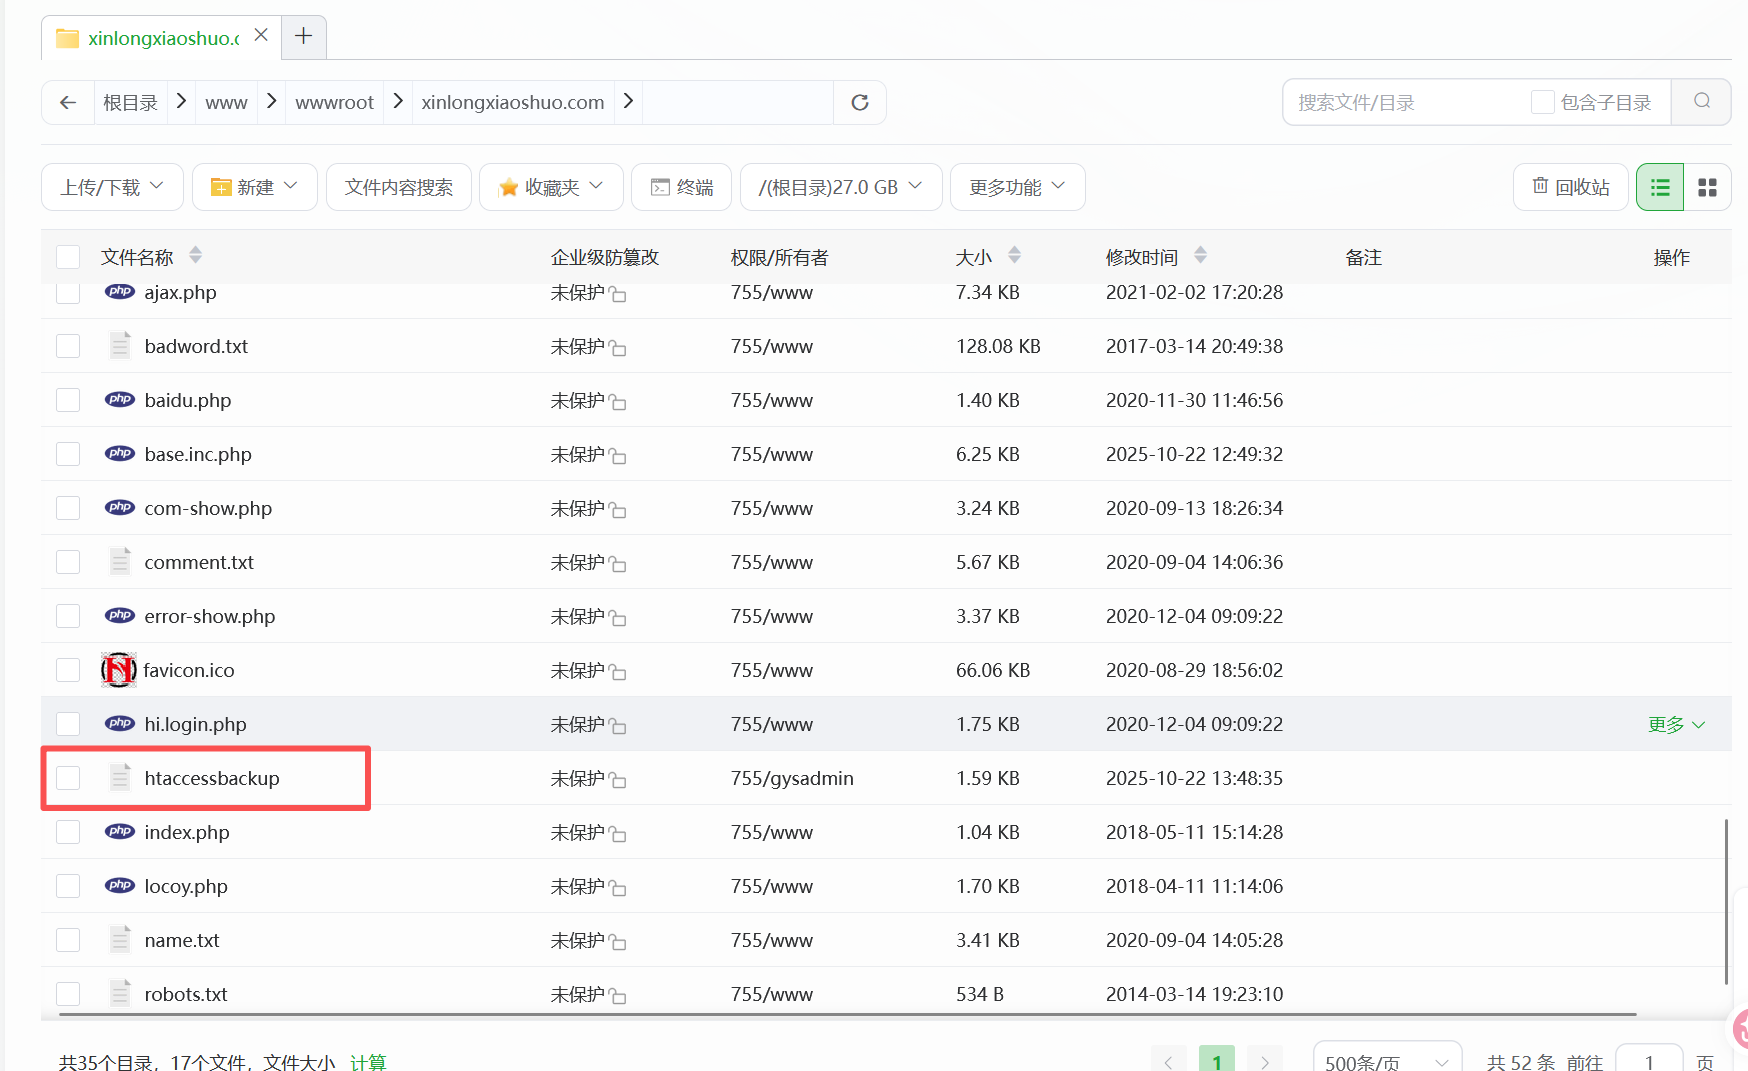
在根目录下将.htaccess修改为备份的.htaccess,php也记得改
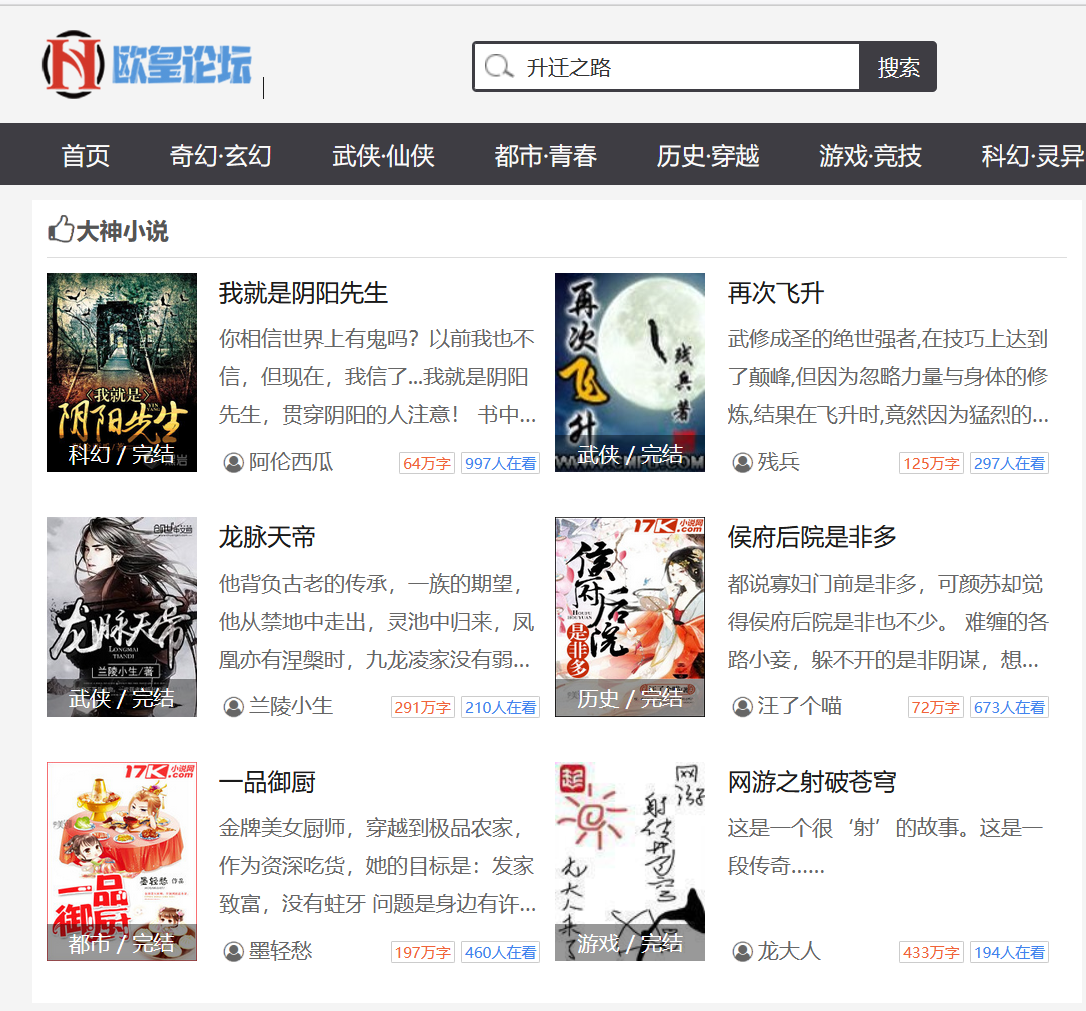
搜索升迁之路
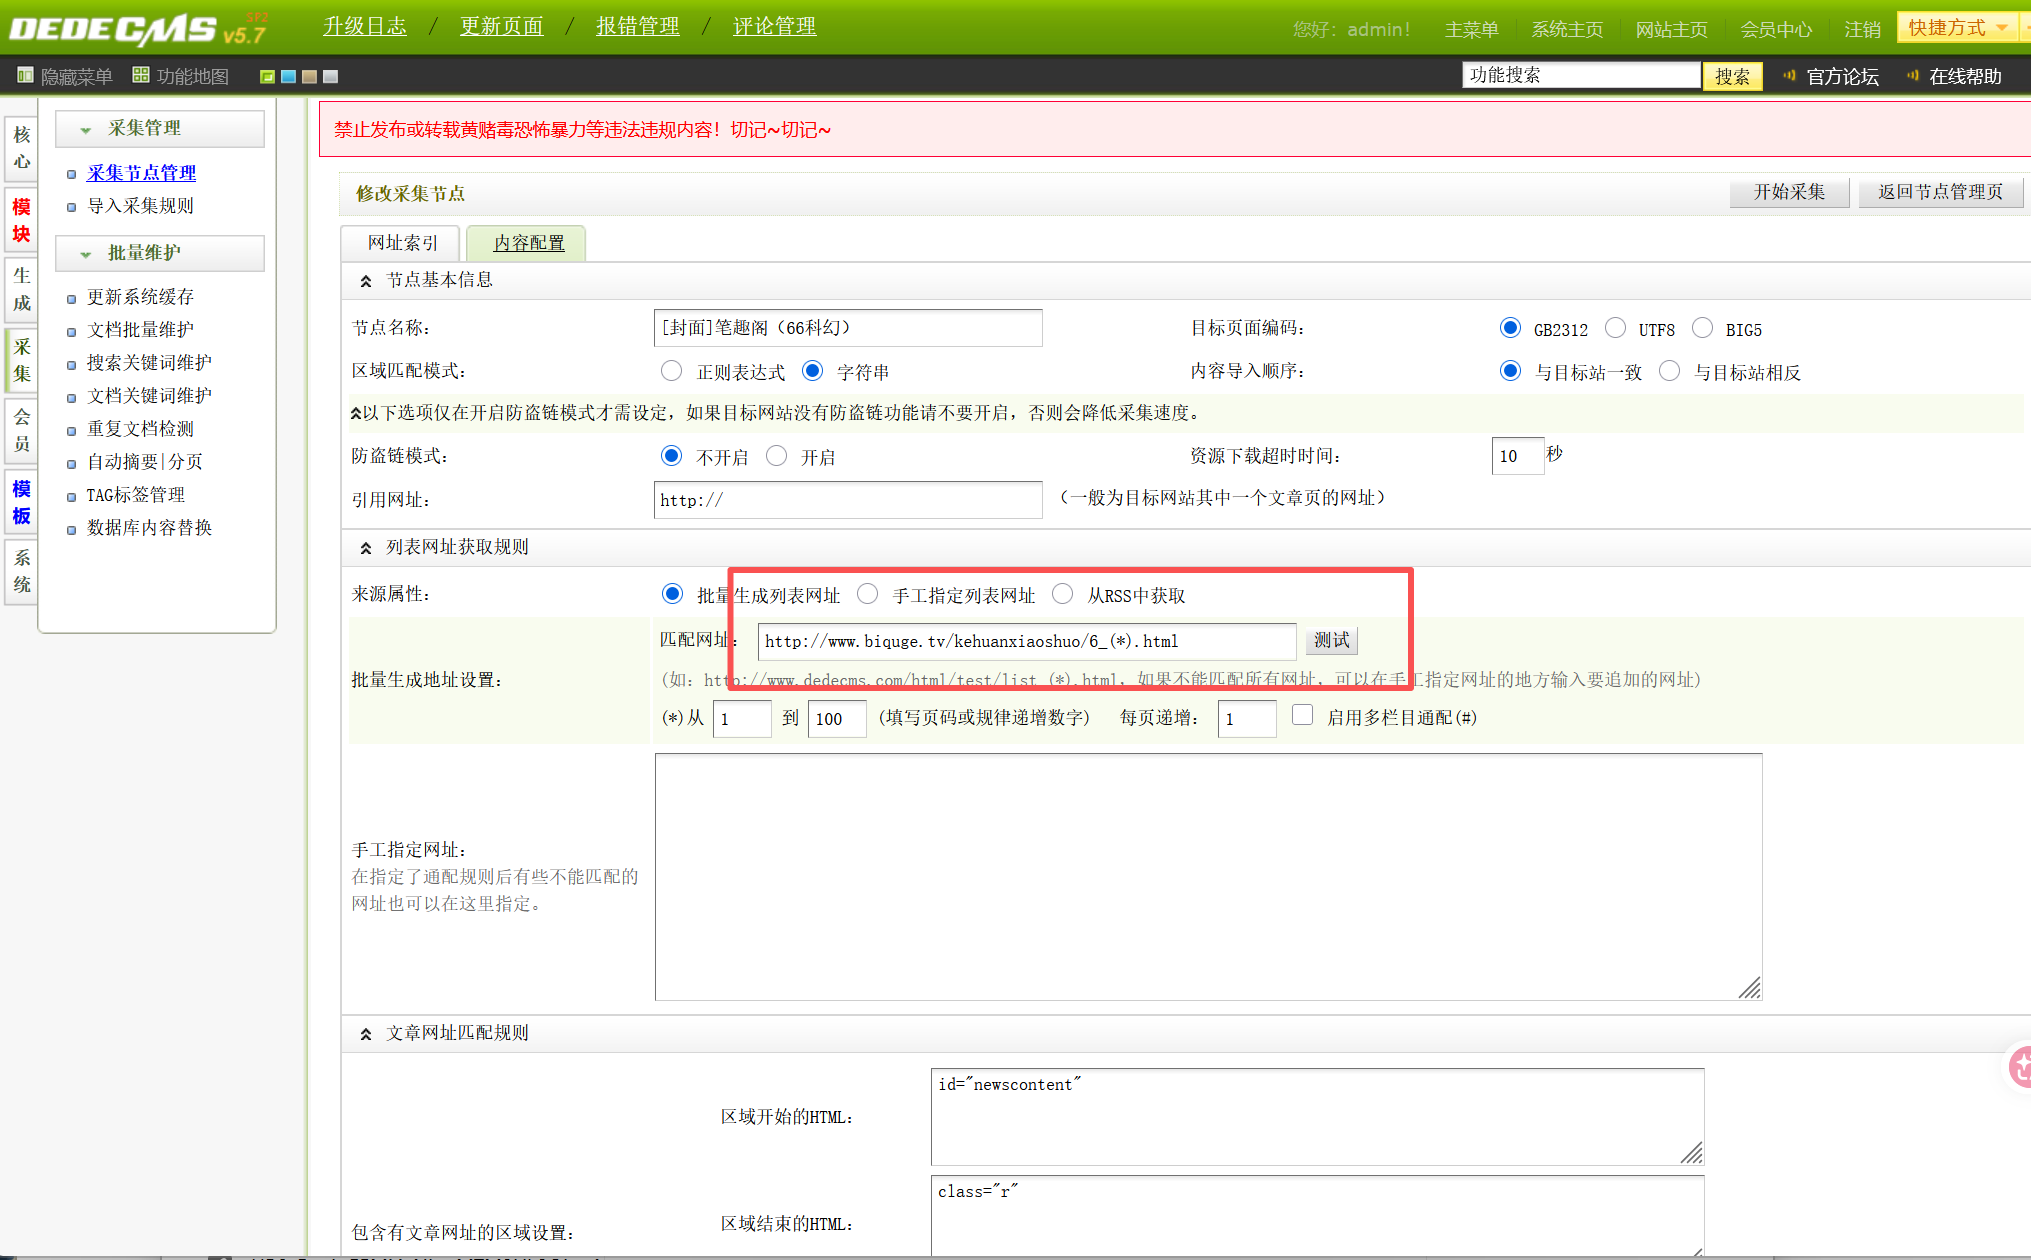
21 小说网站小说后台采集来源地址
**biquge.tv **
搜索一下后台的登录信息
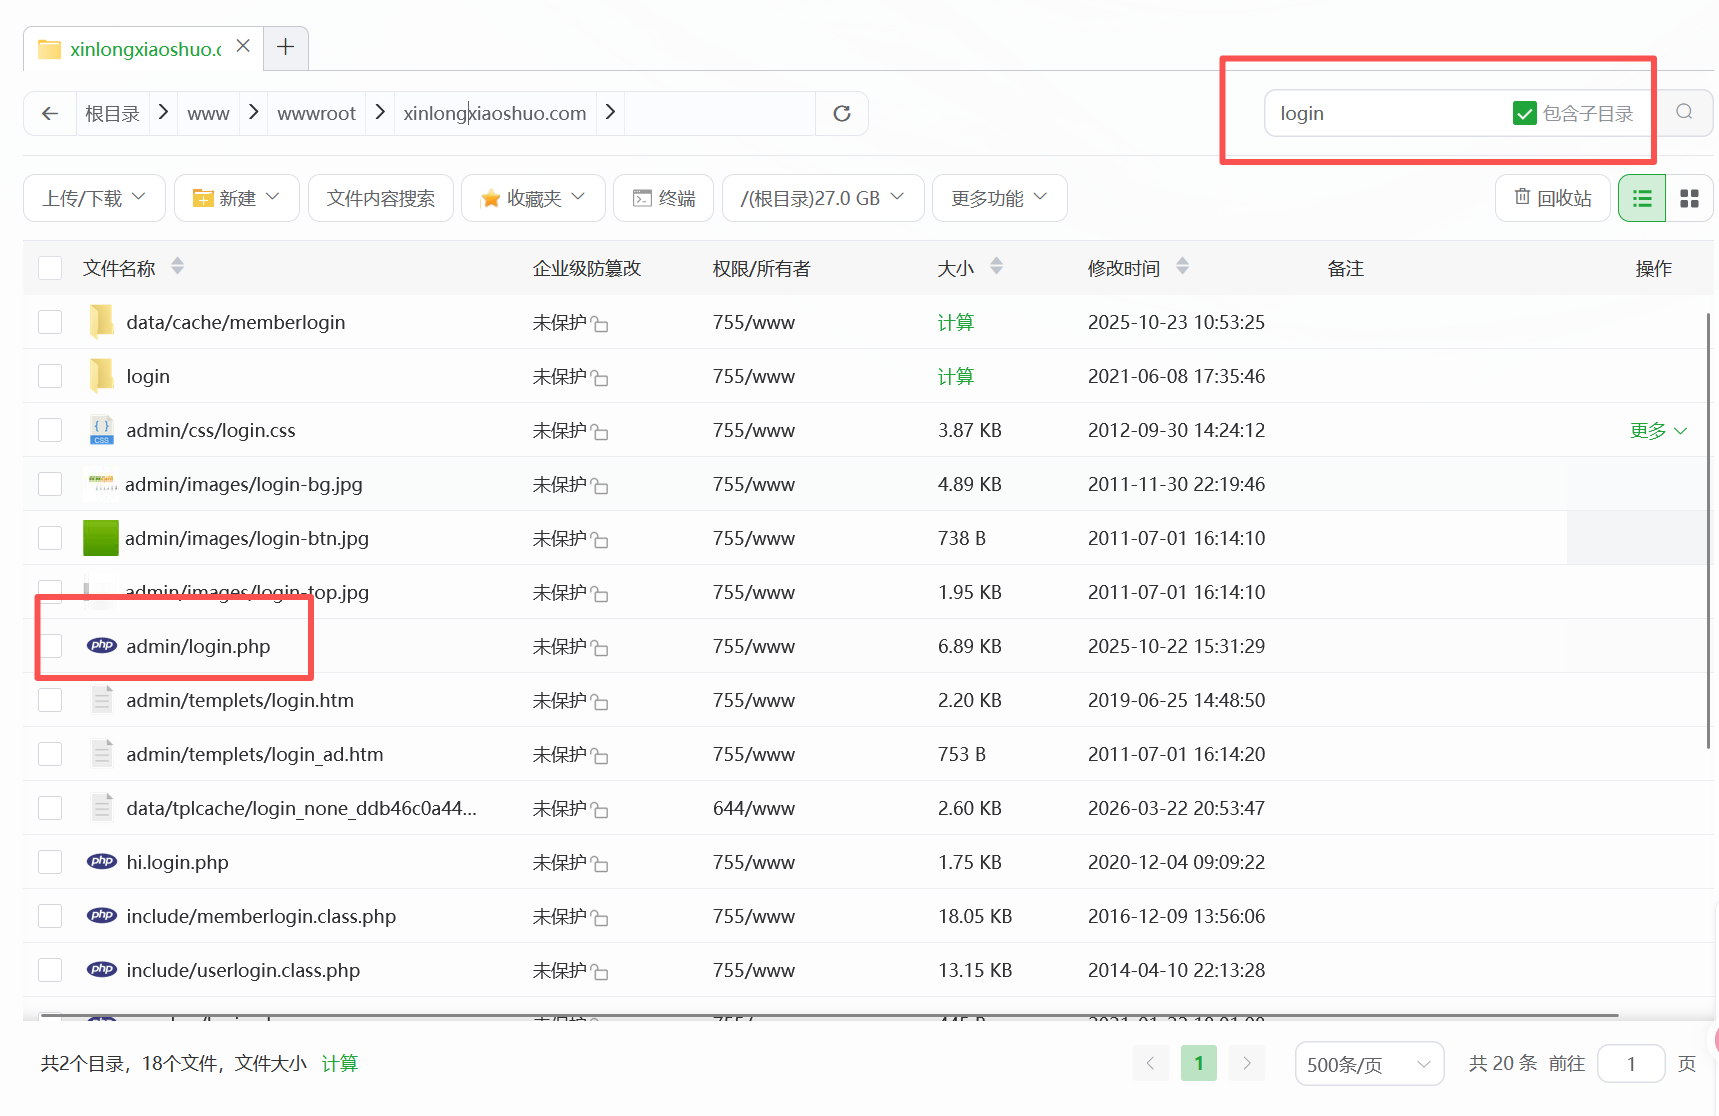
还是有混淆
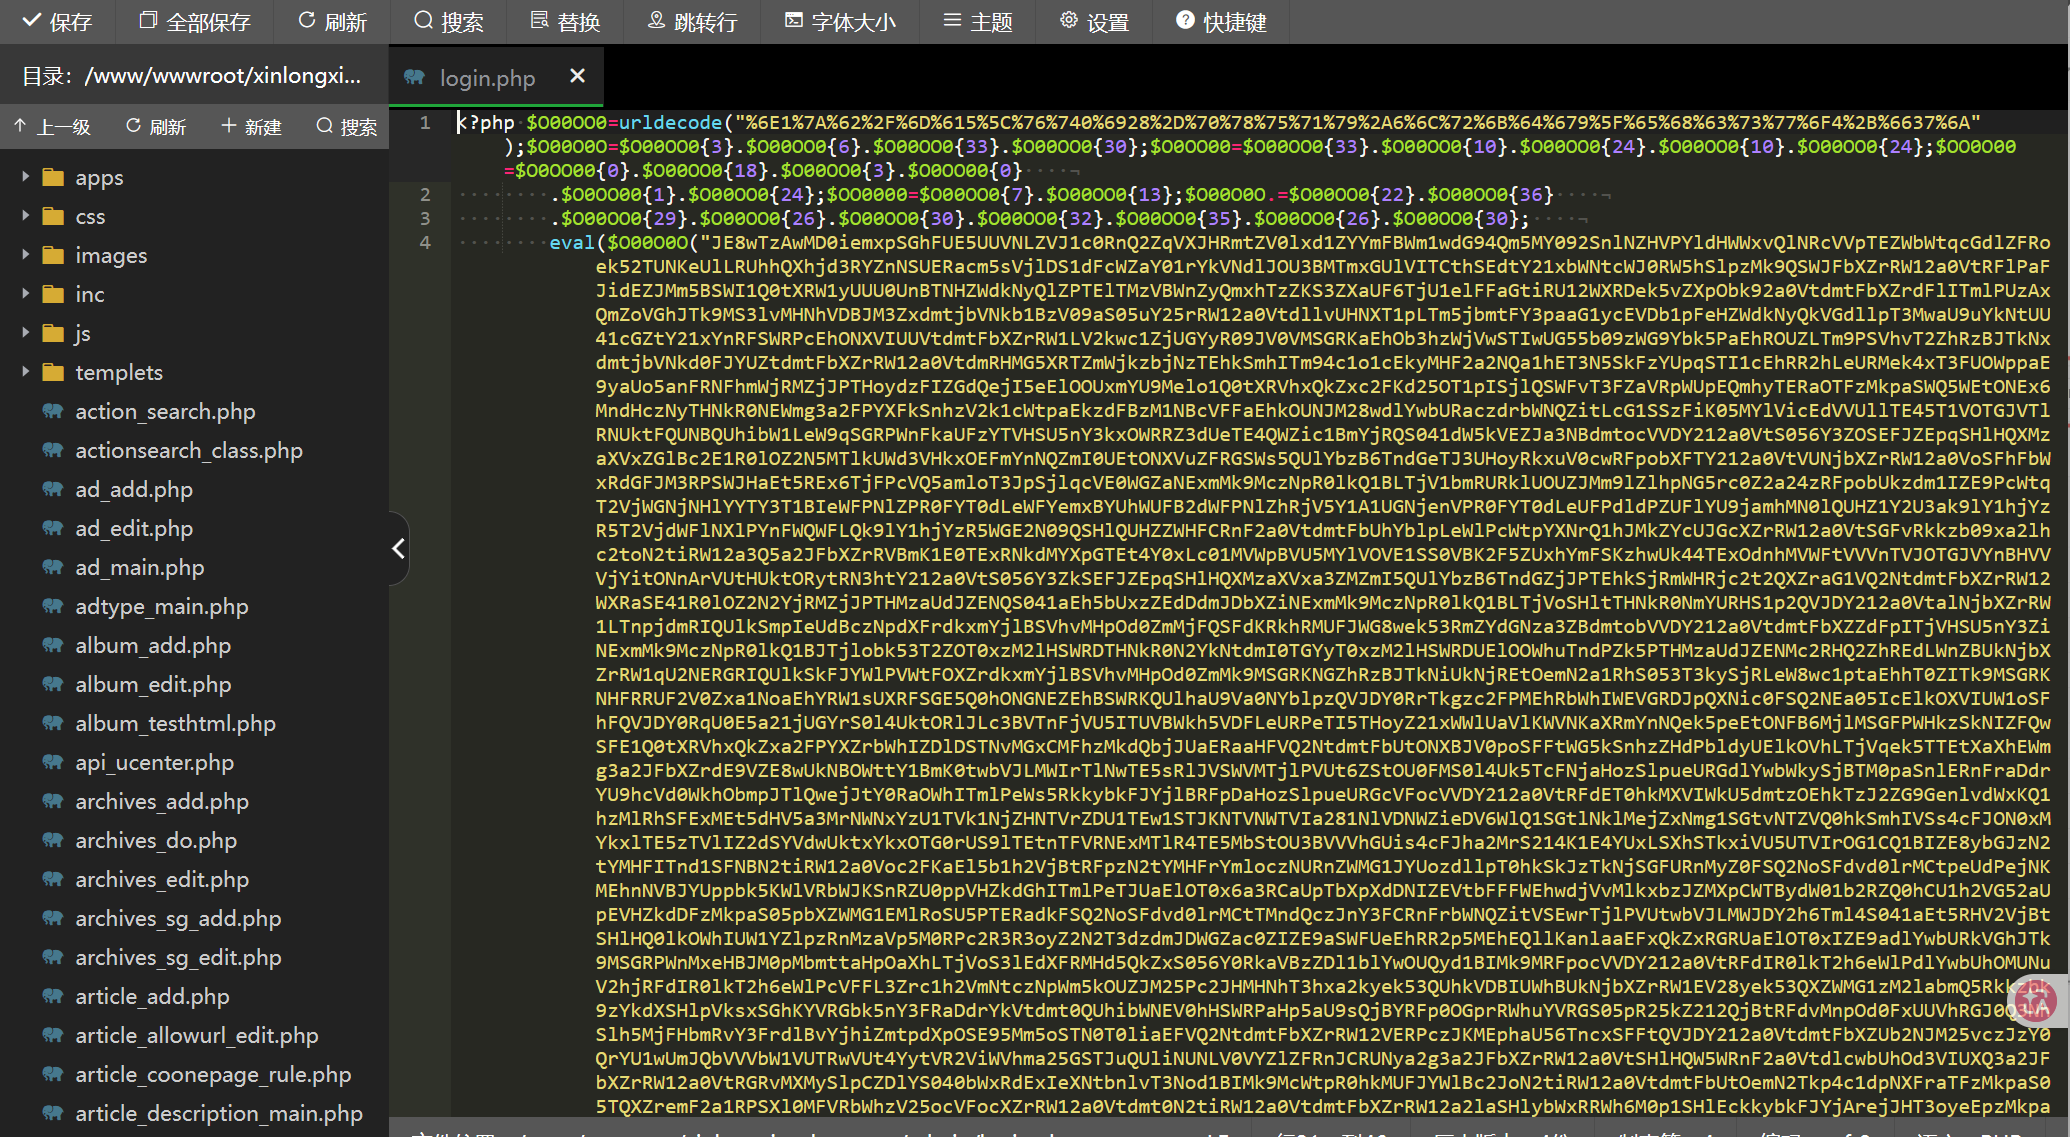
继续解密
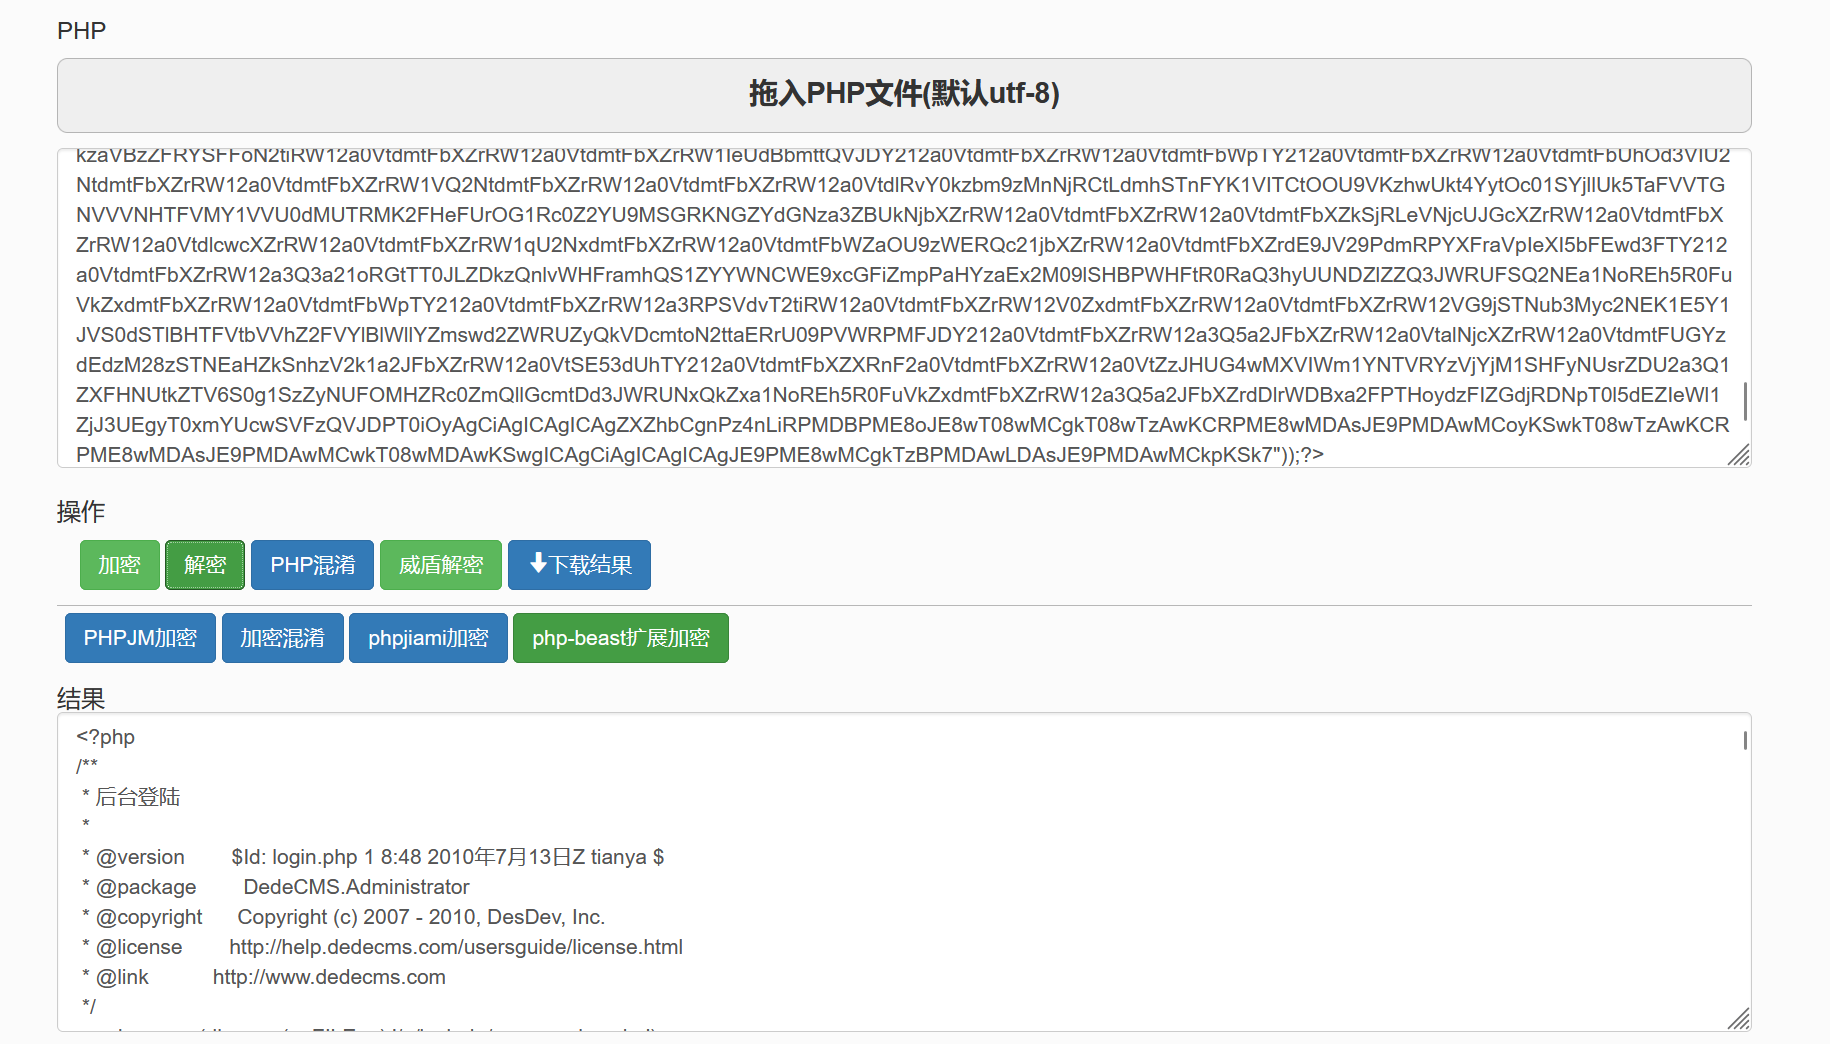
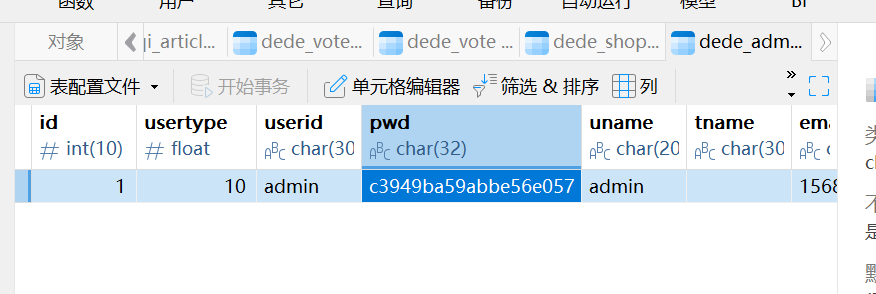
发现任何人都可以通过访问登录页面重置管理员密码为f297a57a5a143894a0e4,将这里删掉
然后找一下加密逻辑 ,在/include/userlogin.class.php
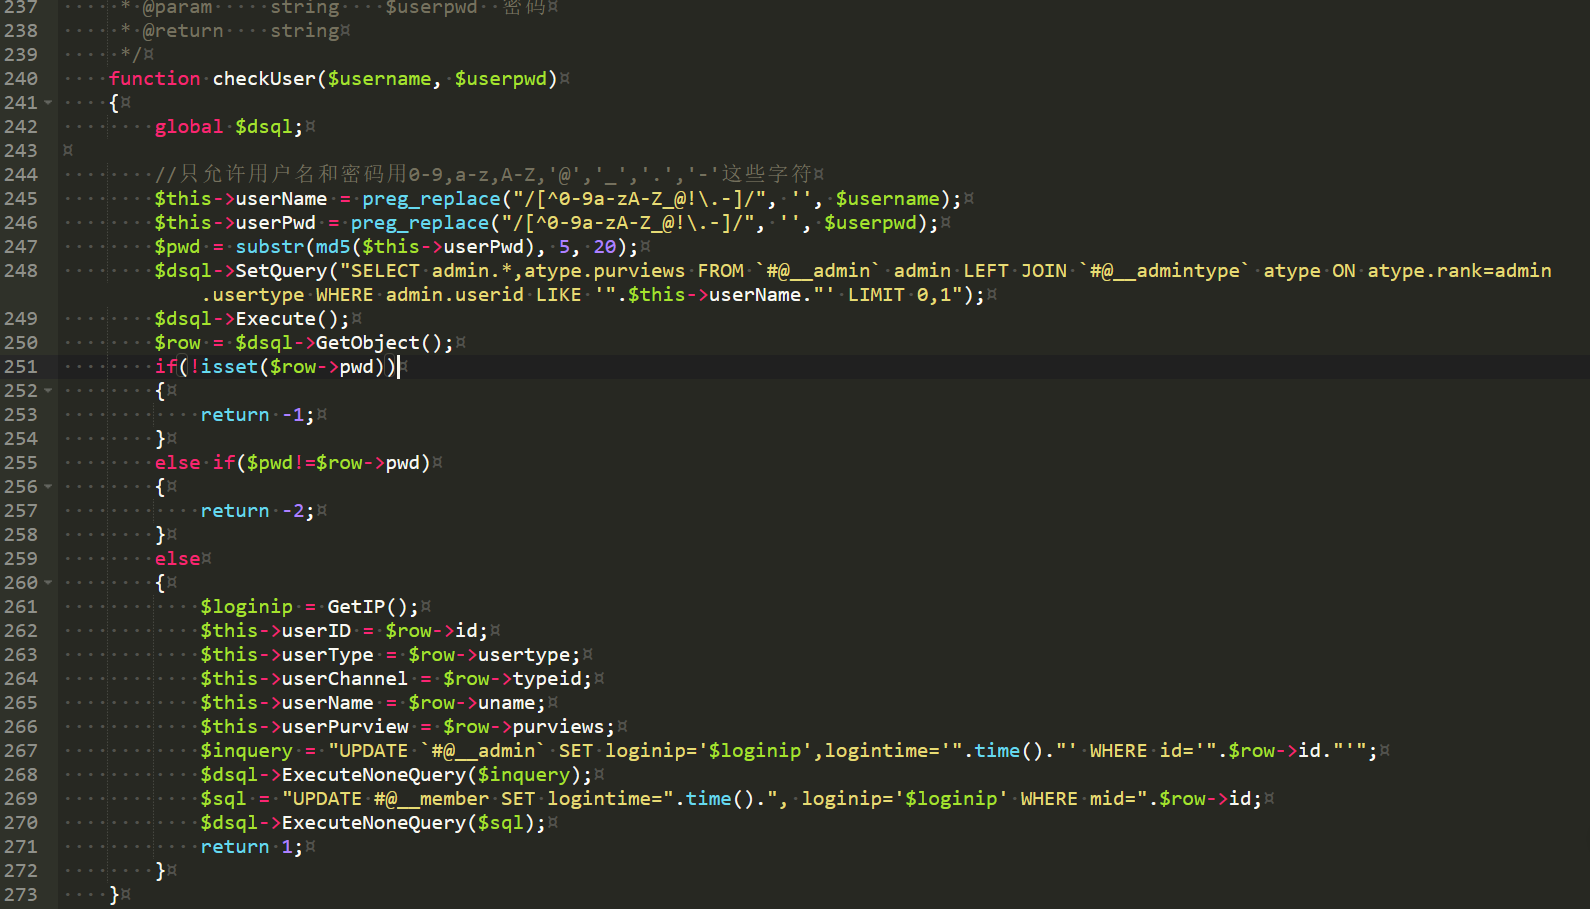
意思是对明文密码进行MD5计算,然后从第5位开始,截取20个字符,修改一下admin的密码
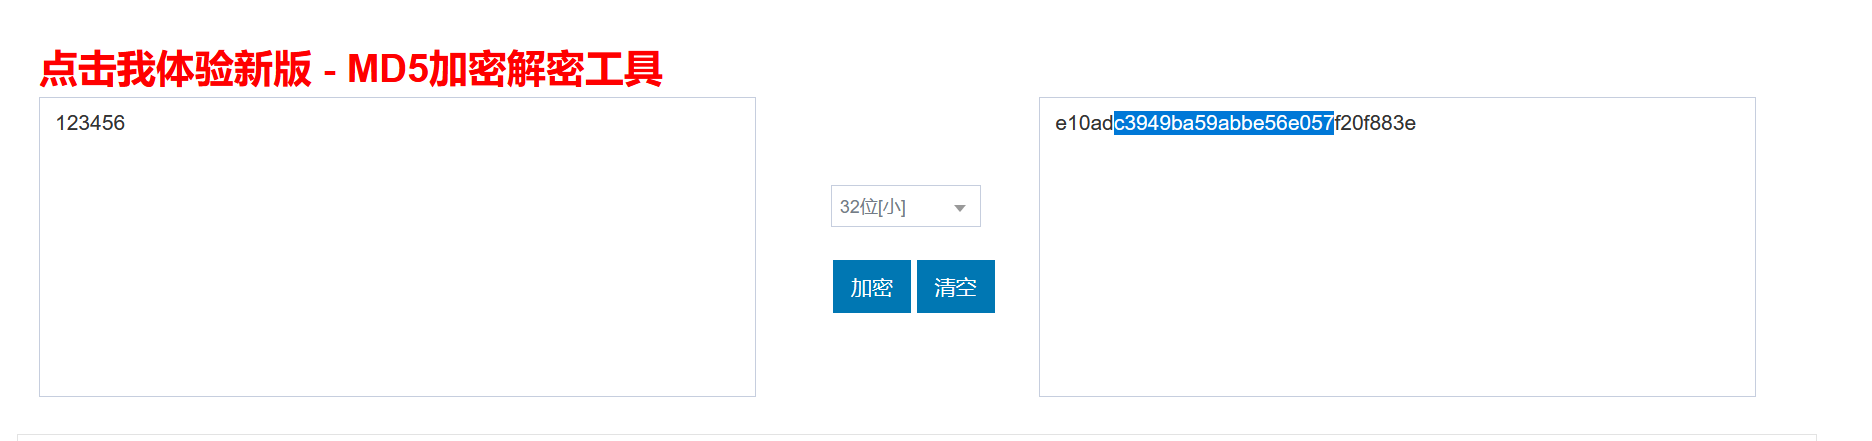
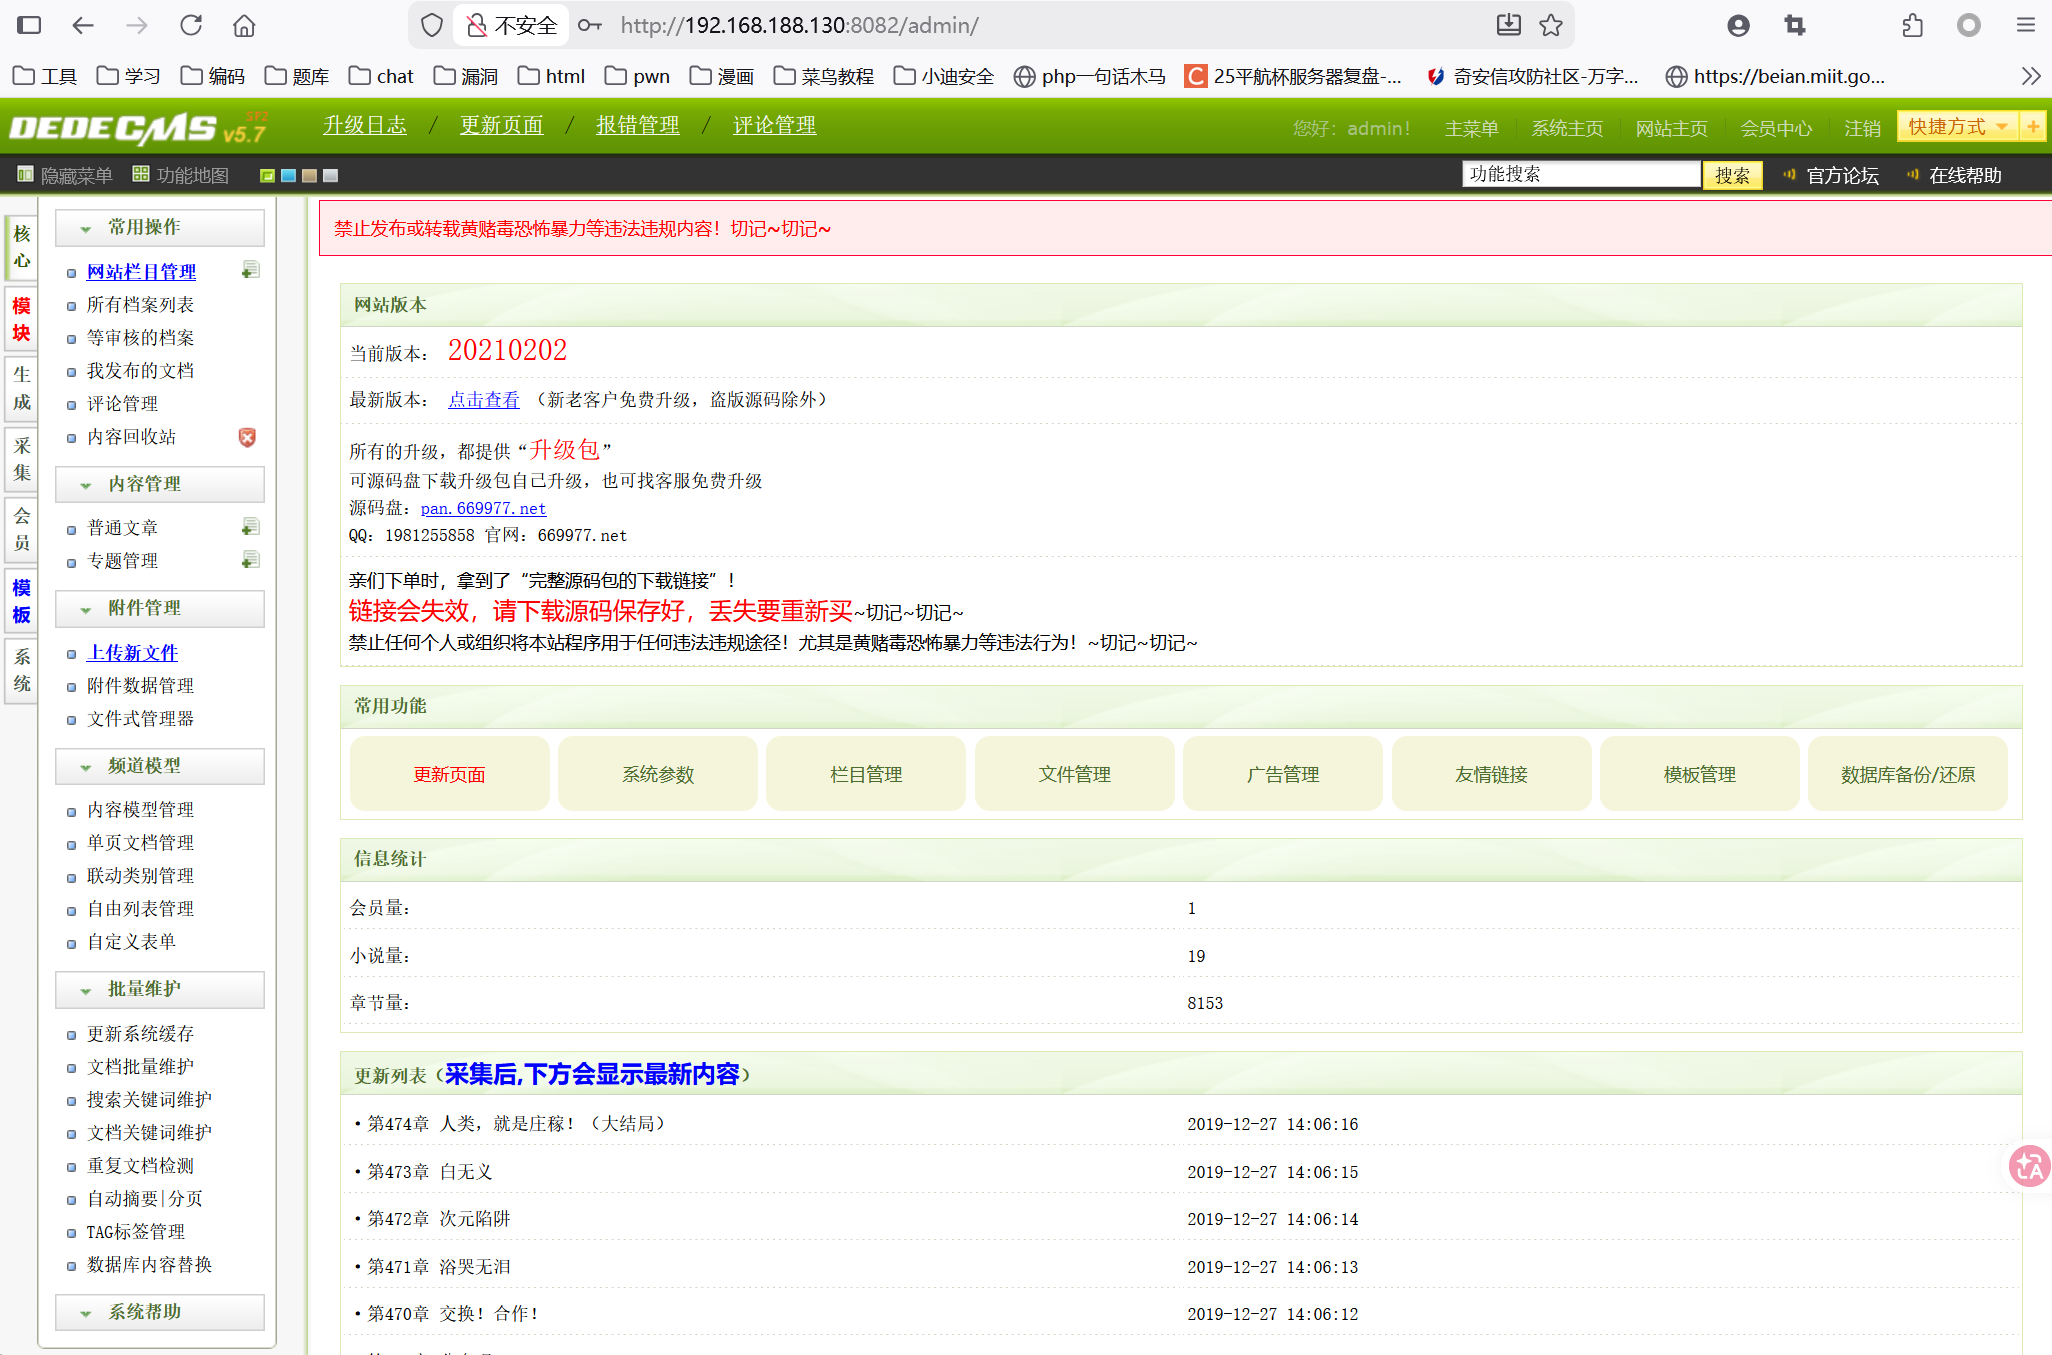
登录到后台
点击采集,采集管理,编辑一下就可以看到了
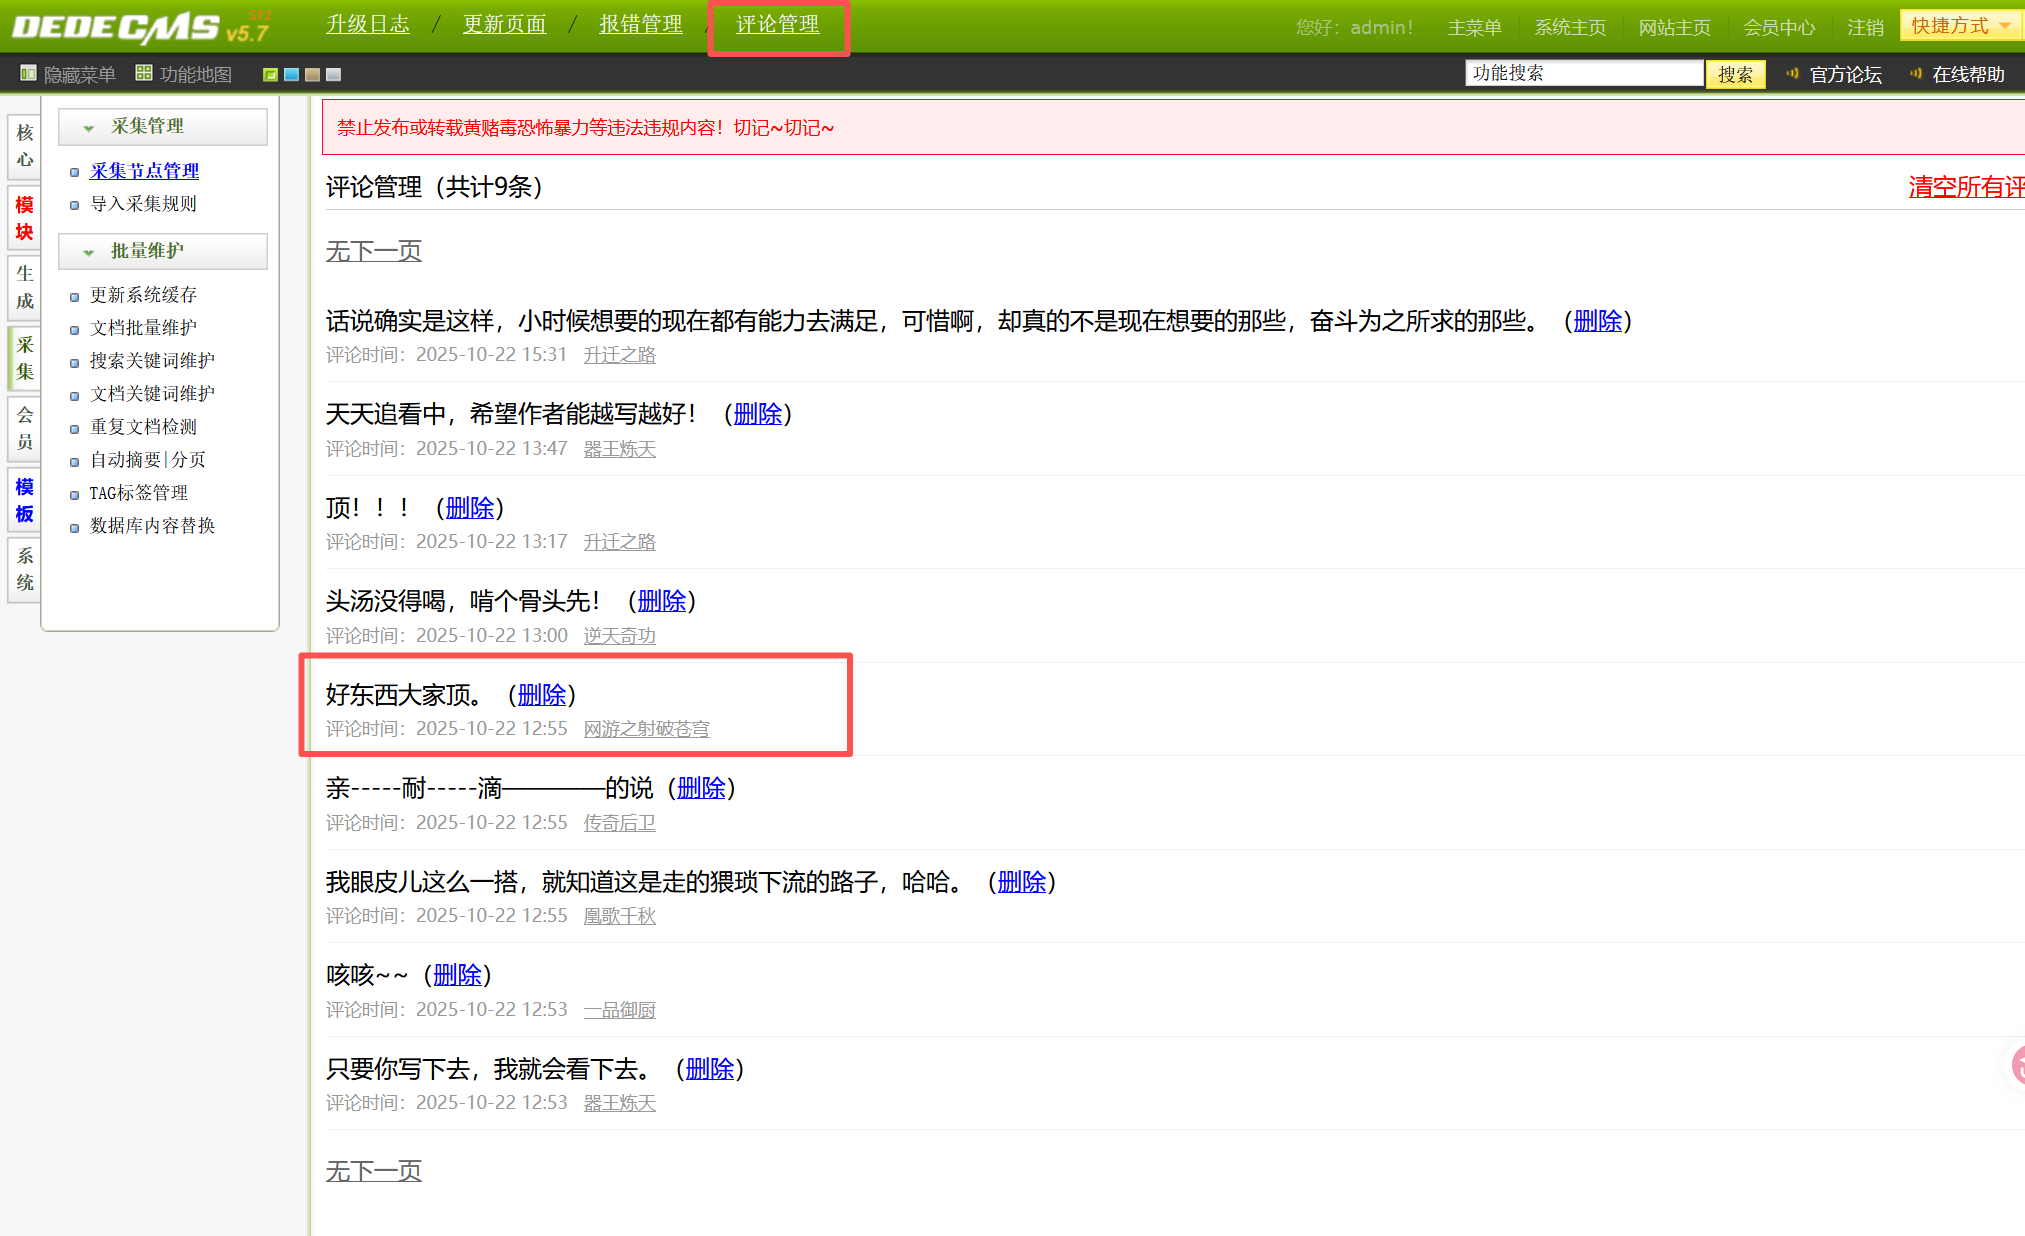
22 小说网站某用户评论"好东西大家顶"是哪篇小说
网游之射破苍穹
在评论管理这里可以看到,也可以去数据库找
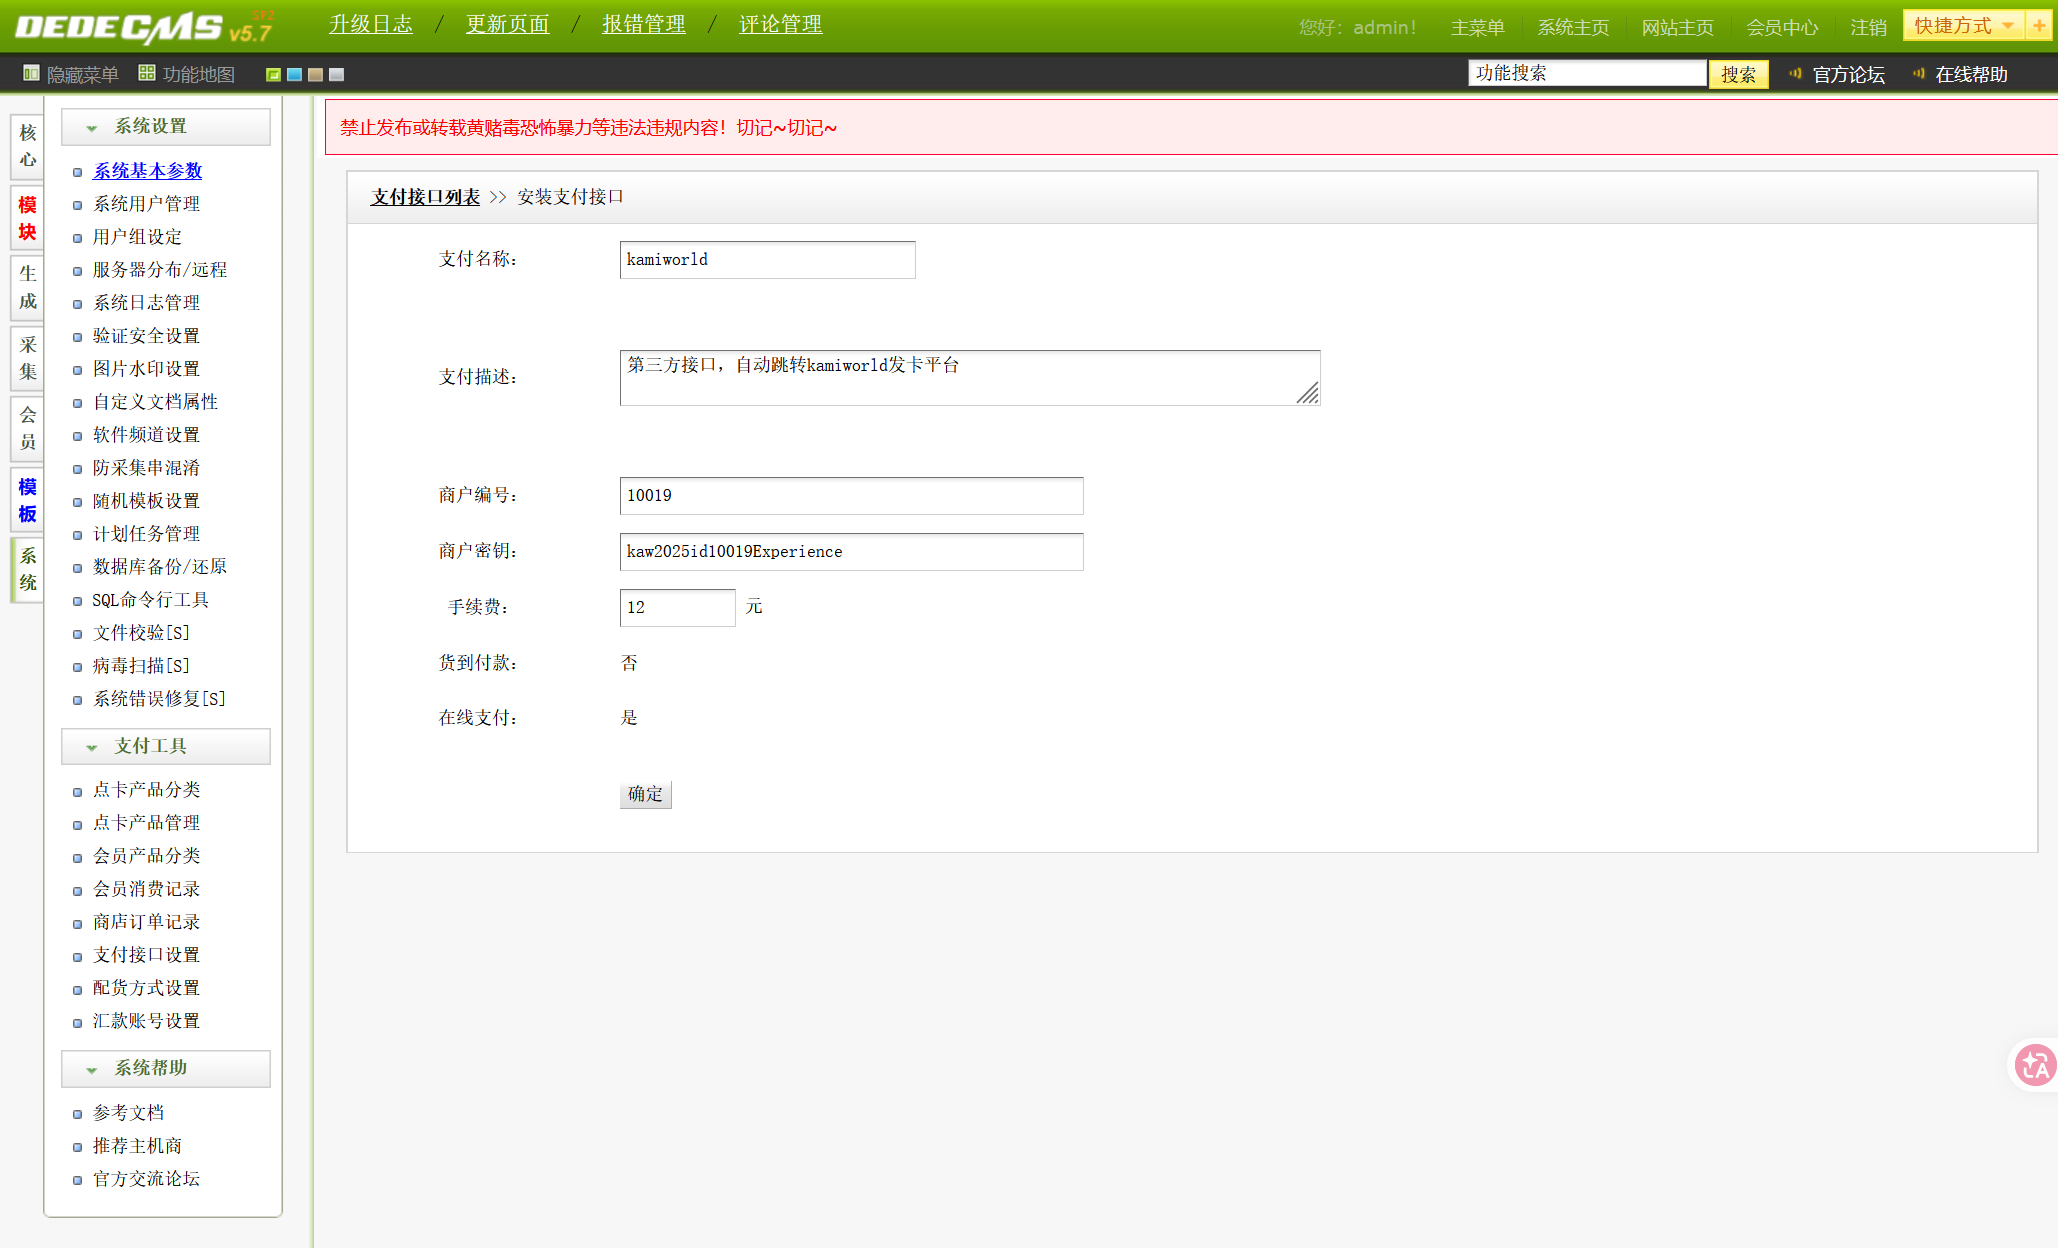
23 小说网站对接的第三方支付接口的商户密钥是
kaw2025id10019Experience
点击系统,支付接口设置
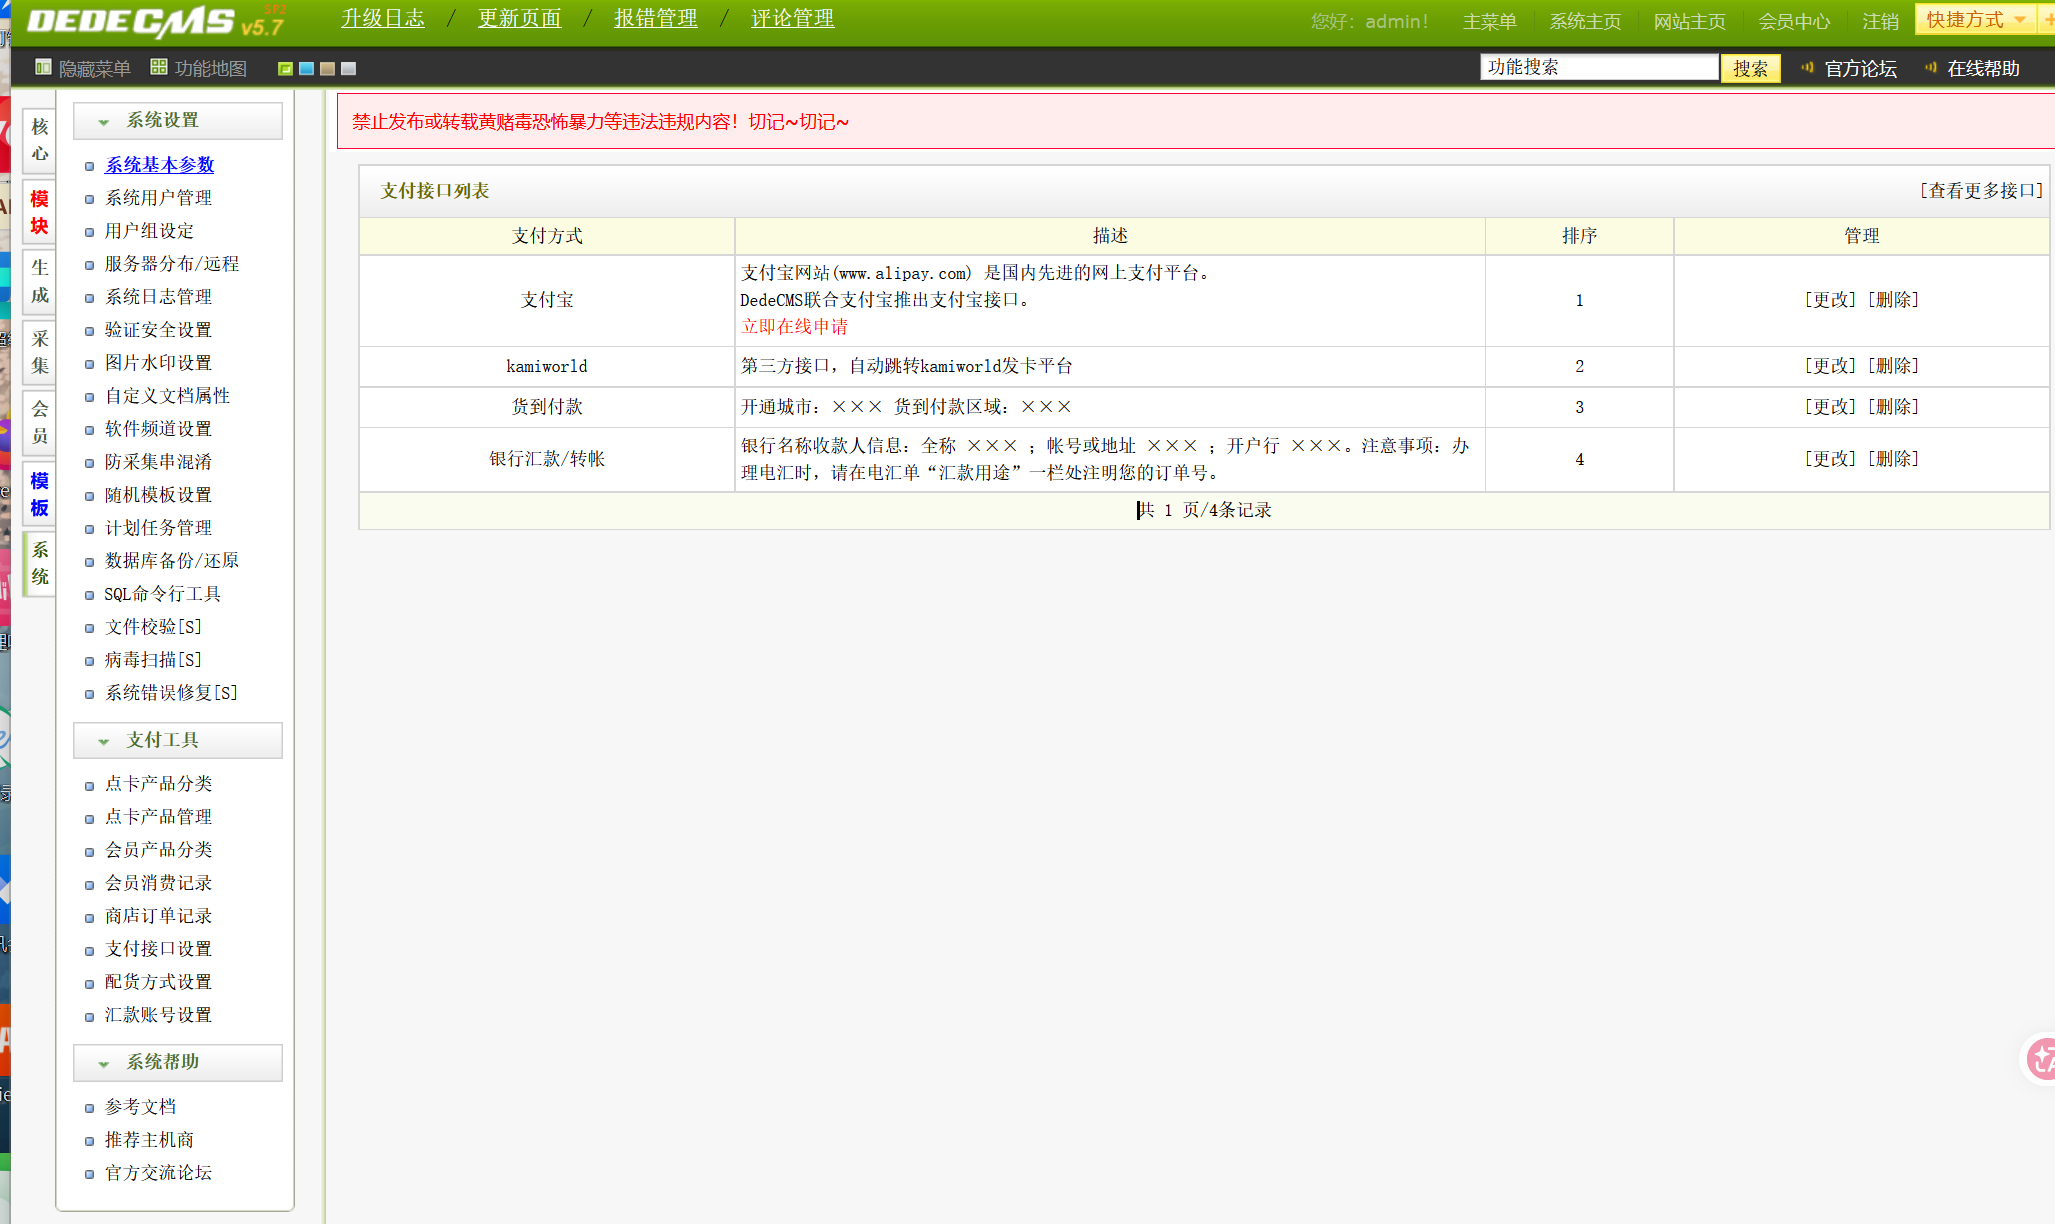
点击kamiworld,看到第三方接口
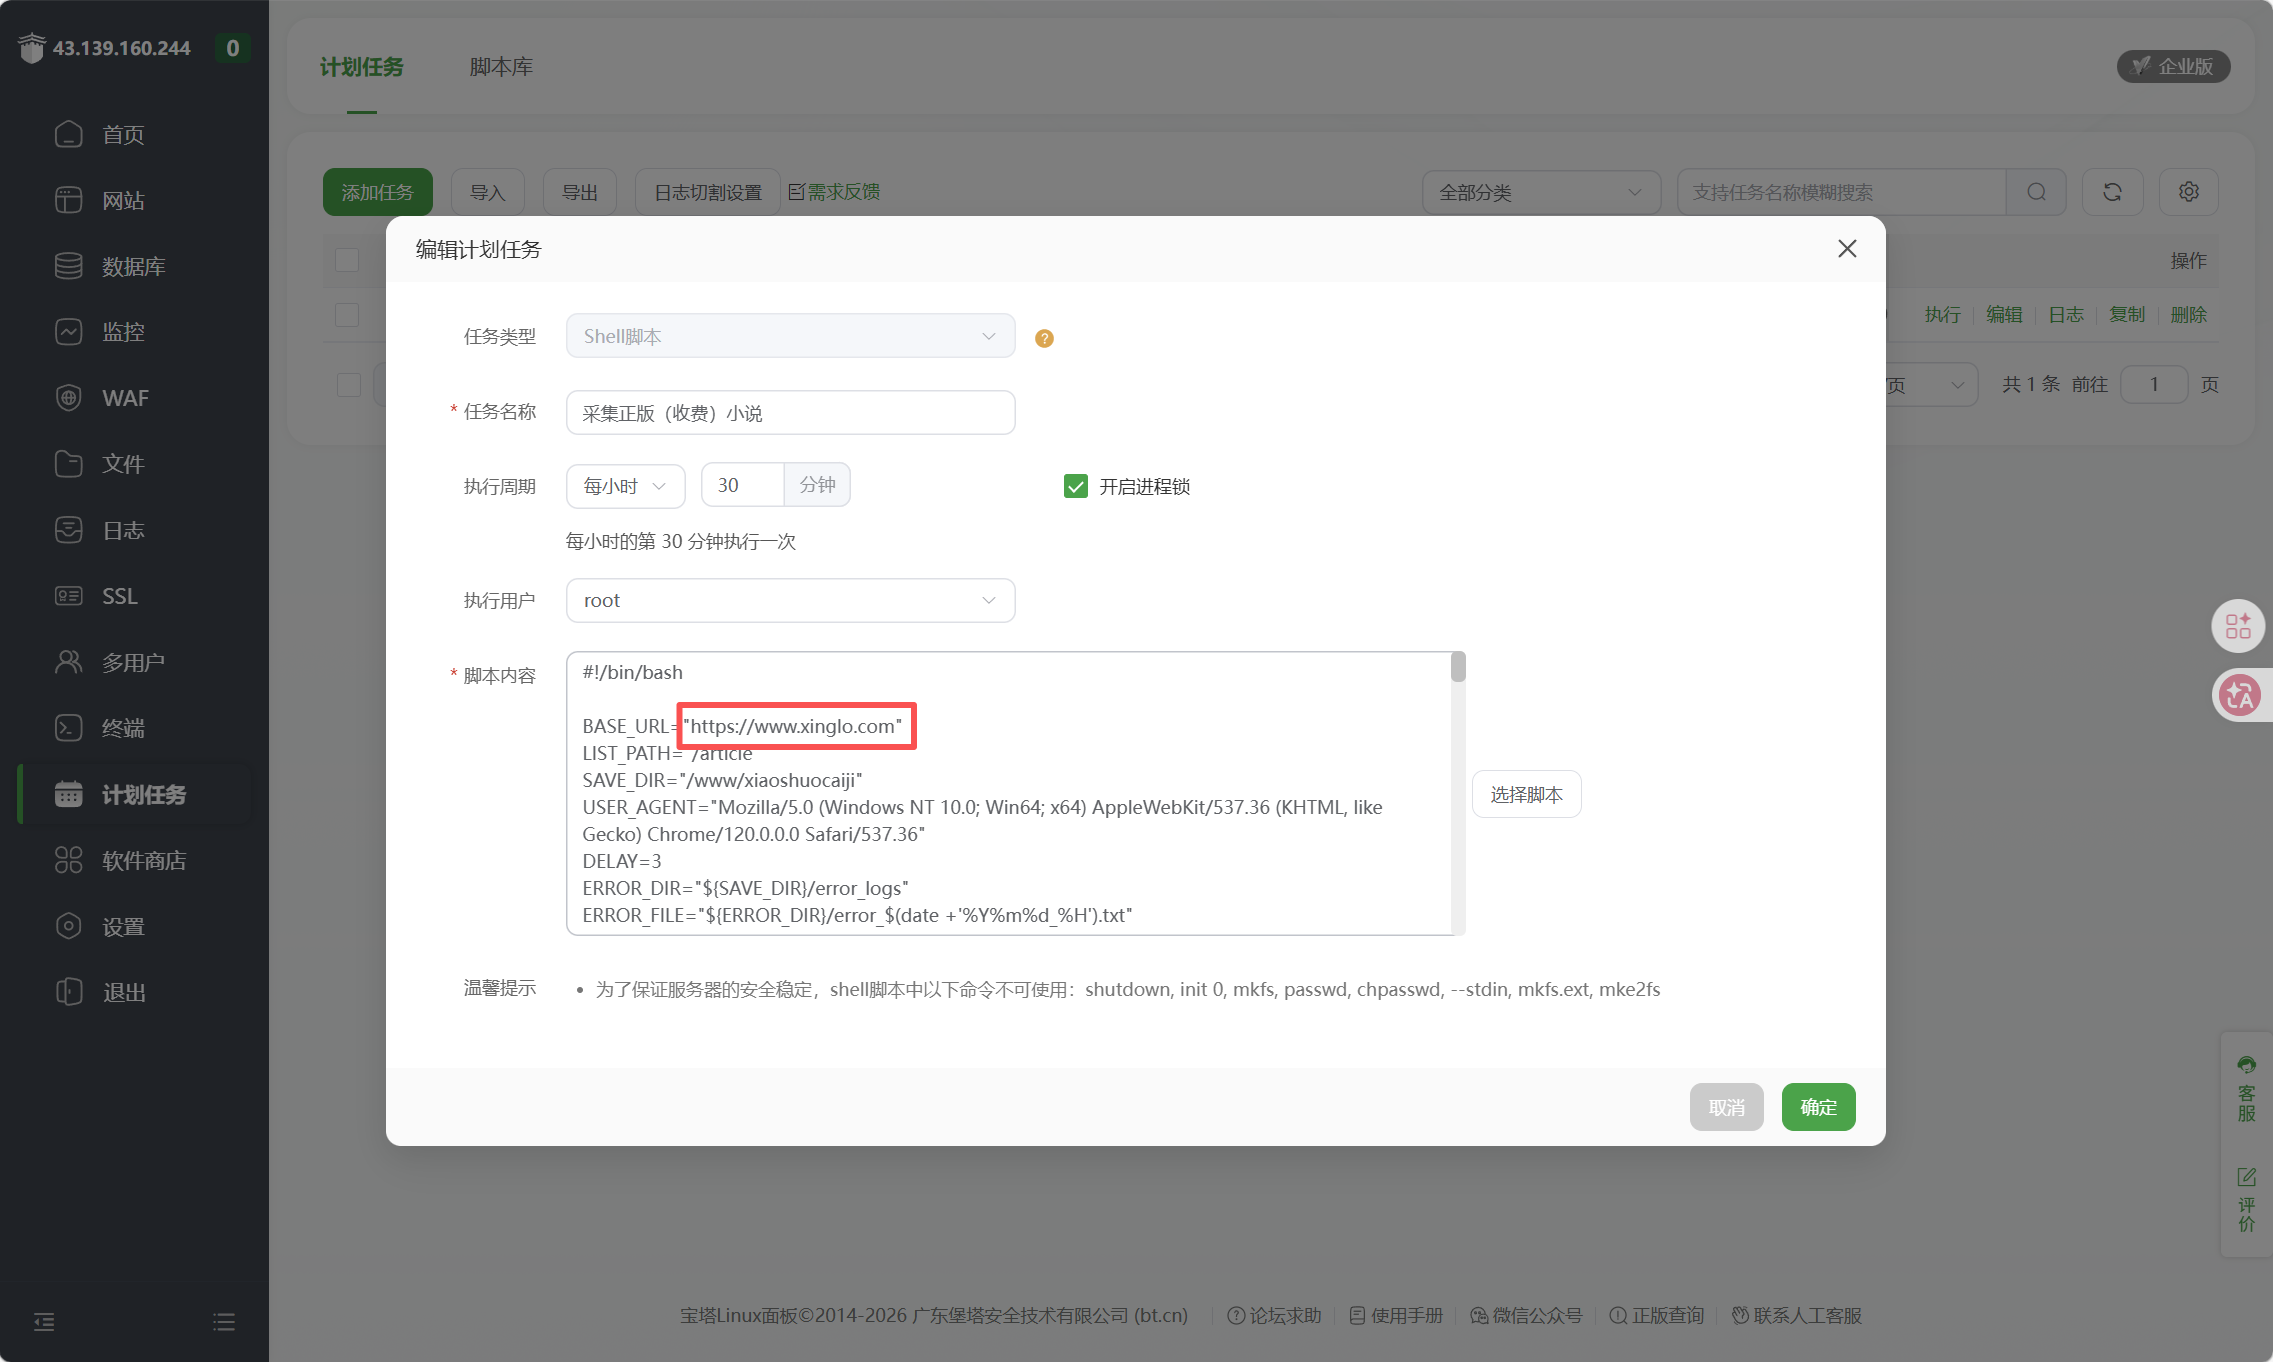
24 嫌疑人曾在web服务器中特定位置执行采集正版(收费)小说的脚本,采集的正版小说网址是
www.xinglo.com
发现宝塔里面还有个宝塔
启动一下
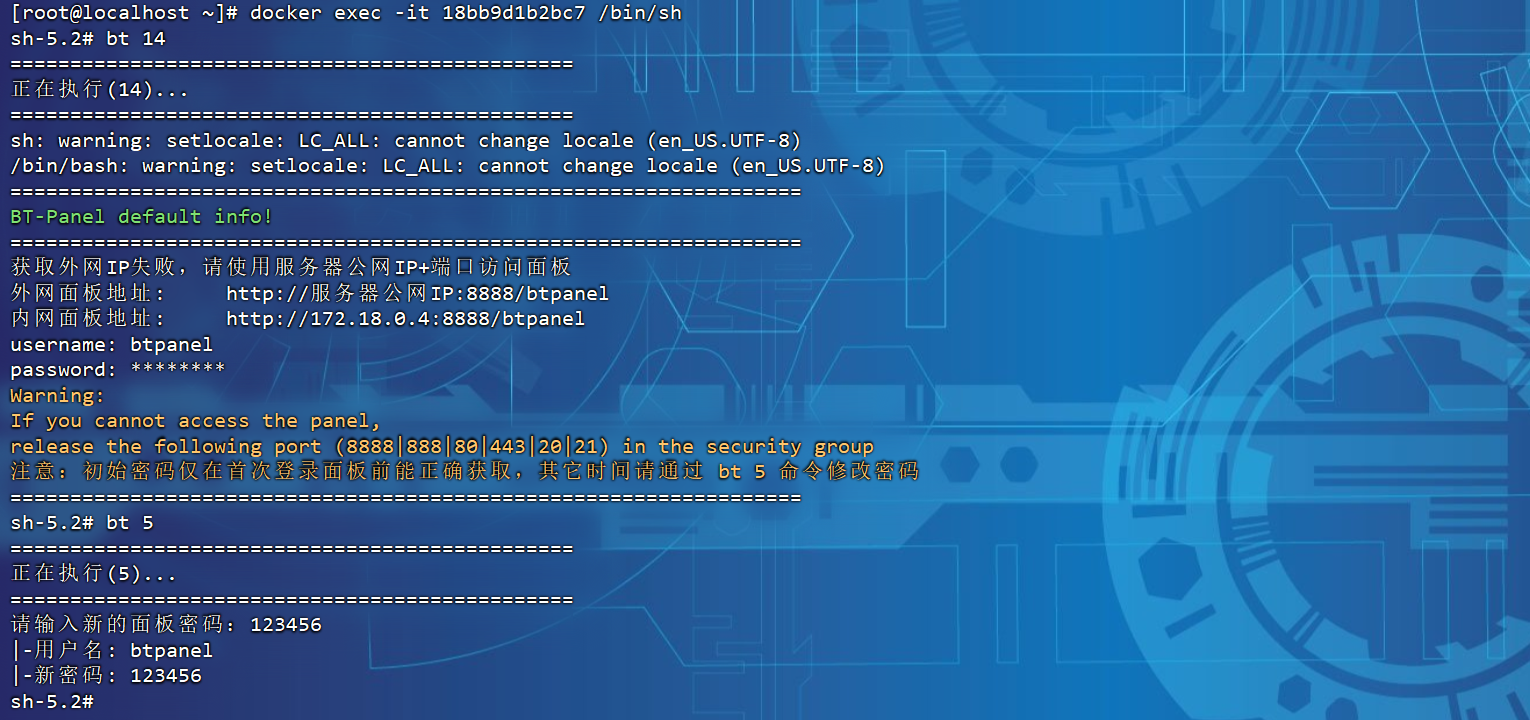
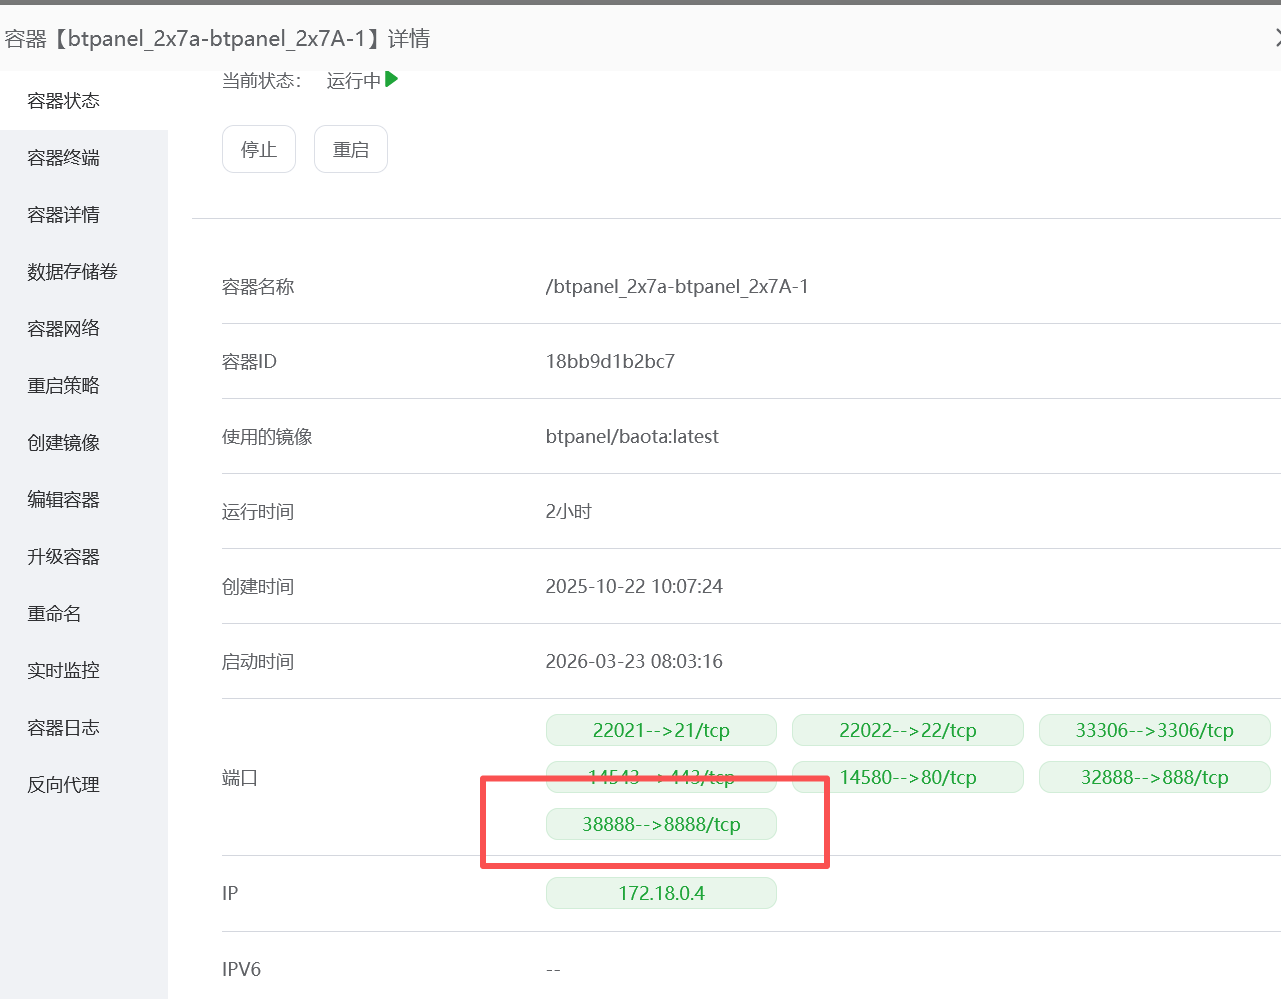
进入面板,在计划任务里看到
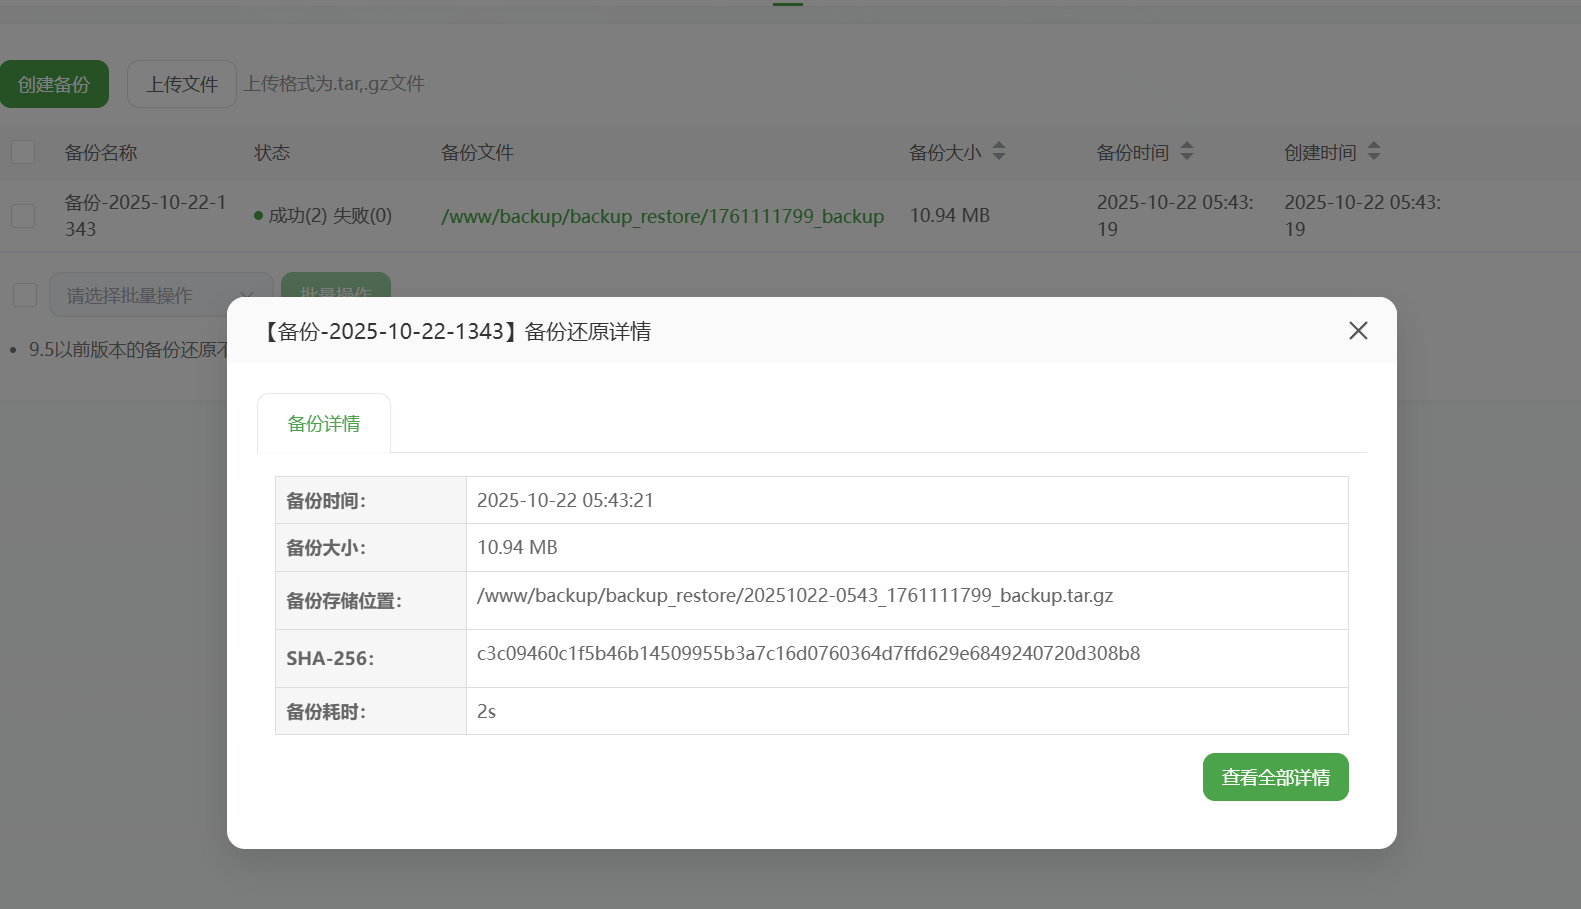
25 嫌疑人曾在web服务器中备份整套面板数据,面板备份数据包SHA256值
c3c09460c1f5b46b14509955b3a7c16d0760364d7ffd629e6849240720d308b8
打开设置,备份还原
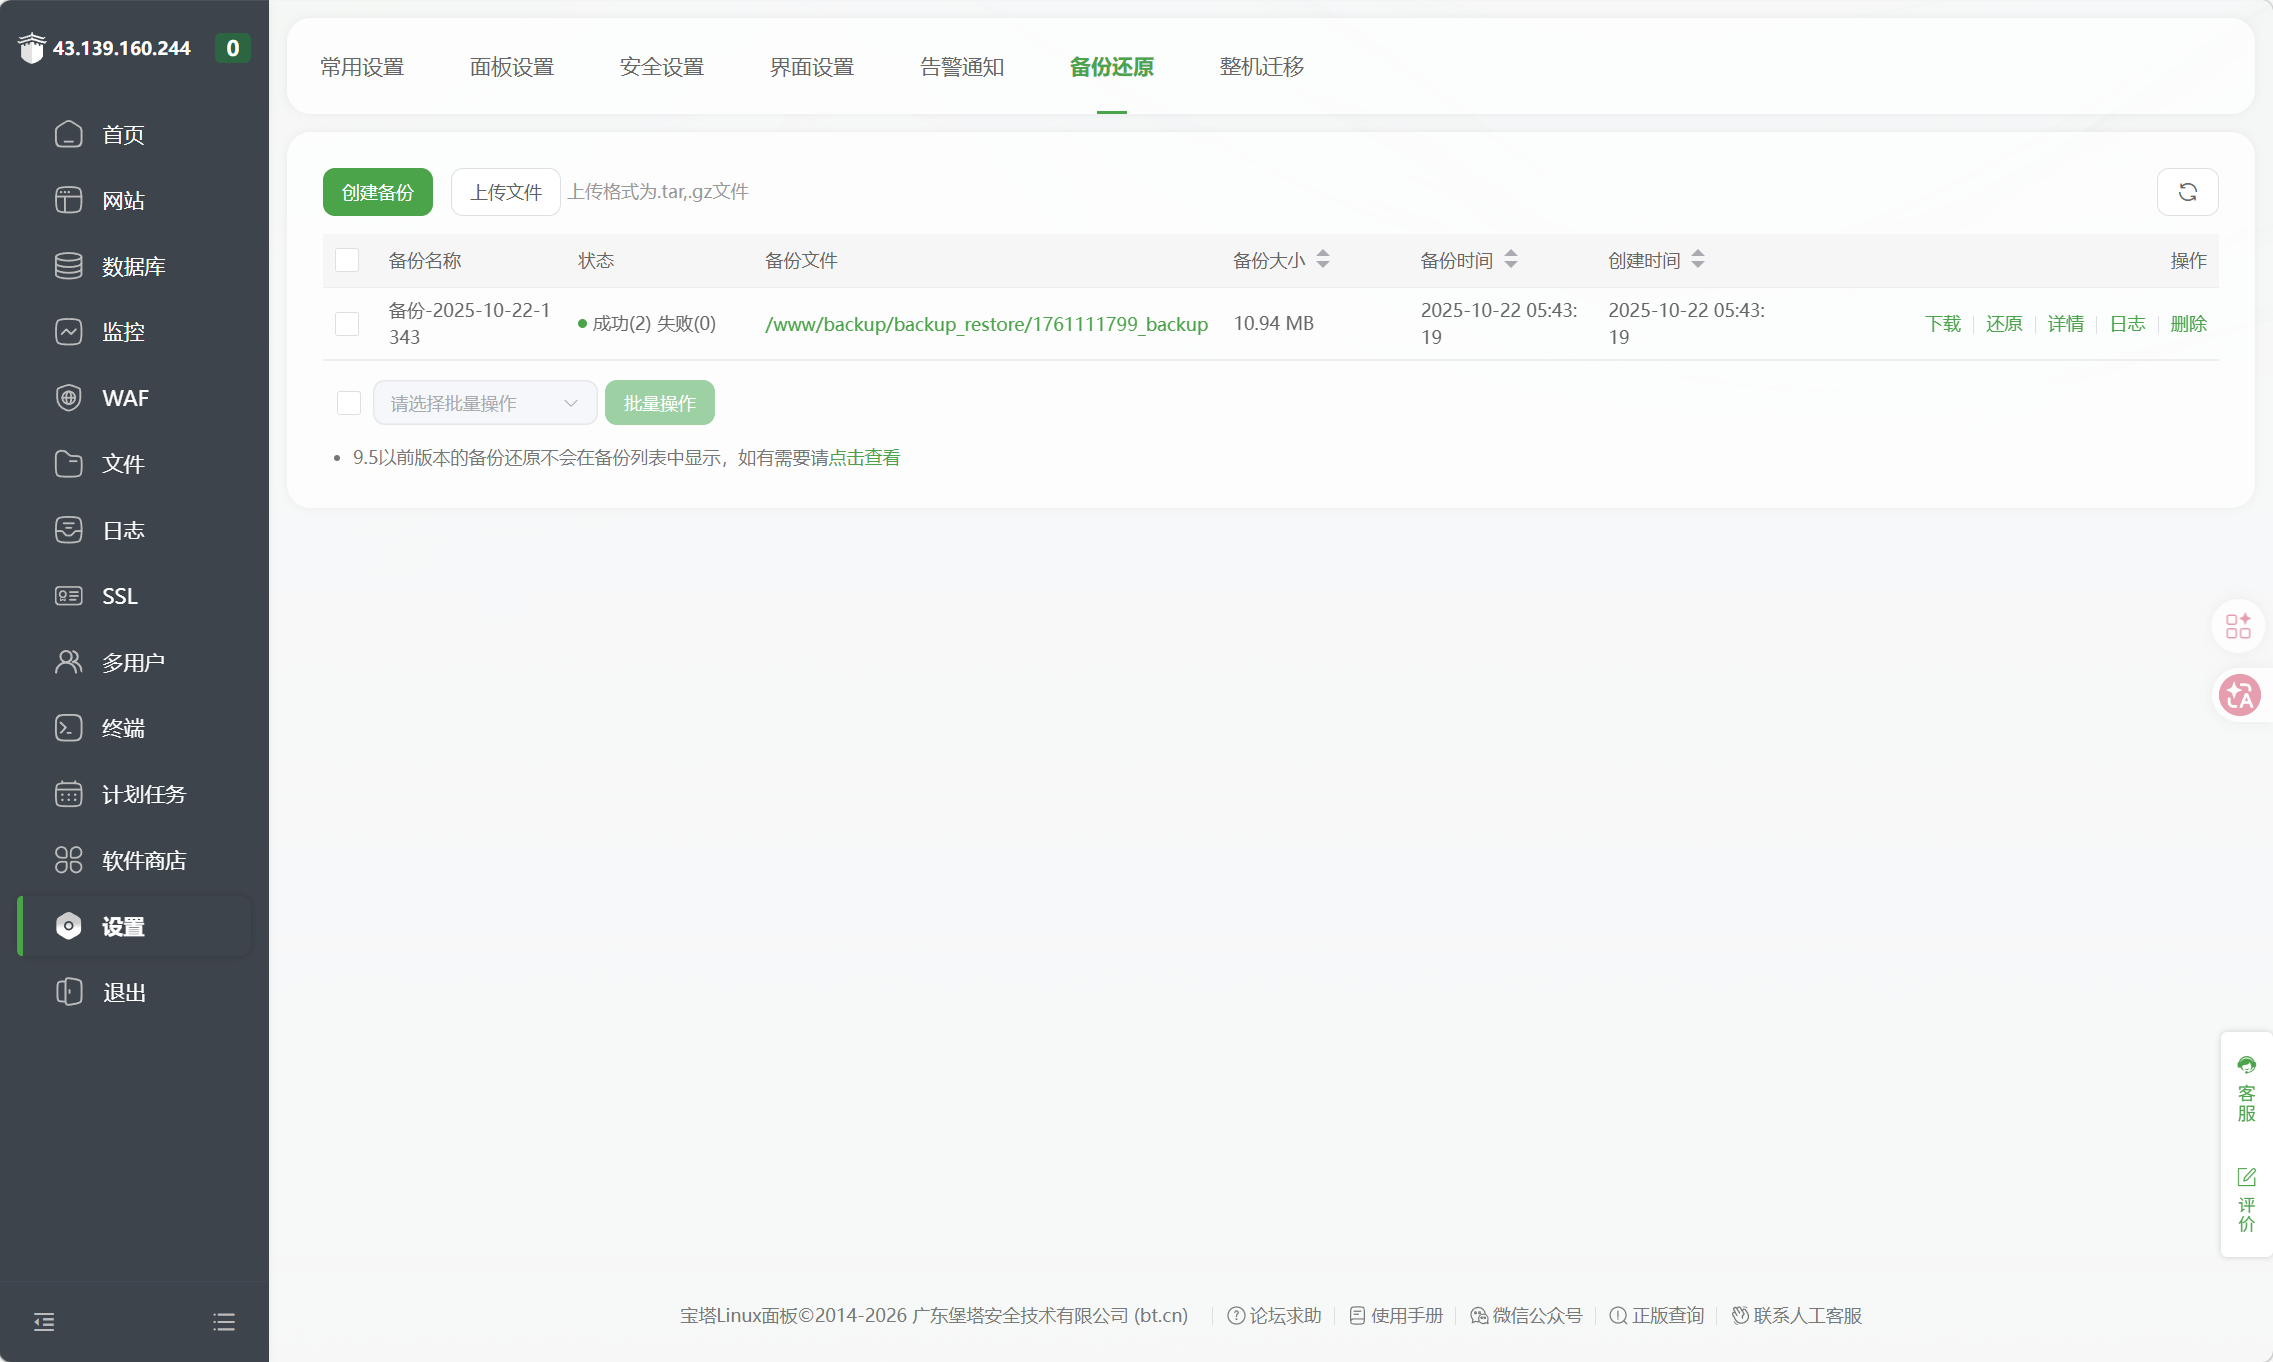
点击详情即可看到
流量取证
流量分析不是强项,可看https://mp.weixin.qq.com/s/TJtvrZ8iTlCUl7fGwL8vHQ
https://mp.weixin.qq.com/s/RBHczvDhIh3niZj0KoAnIQ

 浙公网安备 33010602011771号