
指针与数组深度解析:掌握C/C++核心内存操作技巧
在编程世界中,指针与数组的关系是C/C++开发者必须掌握的核心知识。无论你使用JavaScript、Go还是Python,理解底层内存操作都能让你写出更高效的代码。本文接续上一篇指针基础,深入探讨数组与指针的交互机制,帮助你彻底搞懂这些看似复杂的概念。
1 · 数组名的本质与例外
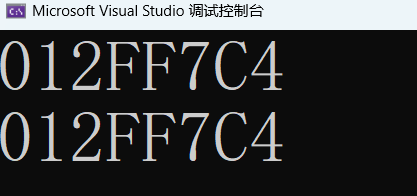
在大多数情况下,数组名代表首元素的地址,即 arr == &arr[0]。我们通过代码验证这一结论:
#include
int main()
{
    int arr[10] = { 0 };
    printf("%p\n", &arr[0]);
    printf("%p\n", arr);
    return 0;
}
运行结果如下:
⚠️ 但有两个重要例外需要特别注意:
sizeof(arr):此时返回整个数组的大小(字节),而非指针大小&arr:取出的是整个数组的地址,步长等于数组总大小
看下面的例子会更清晰:
#include
int main()
{
	int arr[10] = { 1,2,3,4,5,6,7,8,9,10 };
	printf("sizeof(arr)     == %zd\n", sizeof(arr));
	printf("sizeof(&arr[0]) == %zd\n", sizeof(&arr[0]));
	printf("&arr[0]   == %p\n", &arr[0]);
	printf("arr       == %p\n", arr);
	printf("&arr[0]+1 == %p\n", &arr[0] + 1);
	printf("&arr+1     == %p\n", &arr + 1);
	return 0;
} 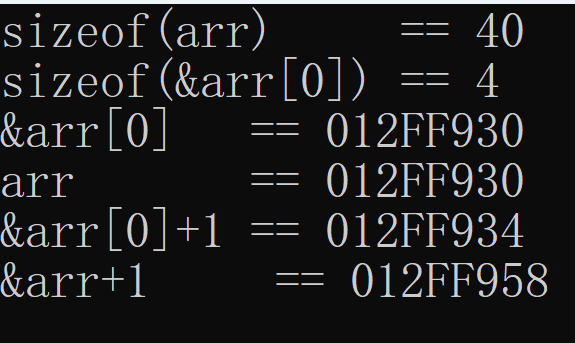
如果arr只是首元素地址,sizeof(arr)应为4或8字节,但实际输出40字节(10个int)。&arr + 1跳过了40字节,进一步印证了取的是整个数组的地址。
2 · 通过指针访问数组
既然数组名就是首元素地址,我们自然可以用指针来遍历数组:
#include
int main()
{
	int arr[10] = { 0 };
	int sz = sizeof(arr) / sizeof(arr[0]);
	int* p = arr;
	int i = 0;
	for (i = 0; i < sz; i++)
	{
		scanf("%d", p + i);
	}
	for (i = 0; i < sz; i++)
	{
		printf("%d ", *(p + i));
	}
	return 0;
} 有趣的是,指针变量p也可以使用下标操作符:
#include
int main()
{
	int arr[10] = { 1,2,3,4,5,6,7,8,9,10 };
	int sz = sizeof(arr) / sizeof(arr[0]);
	int* p = arr;
	int i = 0;
	for (i = 0; i < sz; i++)
	{
		printf("%d ", p[i]);
	}
	return 0;
} 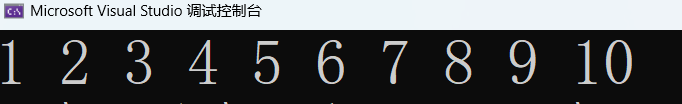
✅ 这是因为 p[i] 与 *(p+i) 在语法上是等价的。编译器会将 arr[i] 转换为 *(arr + i) 的形式。甚至 i[arr] 也能正常工作(虽然不推荐)。这种灵活性体现了C语言的设计哲学:数组操作本质上都是指针运算。
3 · 一维数组传参的本质
将数组作为参数传递时,传递的实际上是首元素的地址:
void Test1(int arr[])
{
	int i = 0;
	int sz = sizeof(arr) / sizeof(arr[0]);
	printf("Test1 中算出的 sz==%d\n", sz);
	for (i = 0; i < 10; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}
void Test2(int* arr)
{
	int i = 0;
	int sz = sizeof(arr) / sizeof(arr[0]);
	printf("Test2 中算出的 sz==%d\n", sz);
	for (i = 0; i < 10; i++)
	{
		printf("%d ", arr[i]);
	}
}
#include
int main()
{
	int arr[10] = { 0,1,2,3,4,5,6,7,8,9 };
	int sz = sizeof(arr) / sizeof(arr[0]);
	printf("main 中算出的 sz==%d\n", sz);
	Test1(arr);
	Test2(arr);
	return 0;
} 
关键发现:
- 形参
int arr[]本质上就是int *arr - 在函数内部无法通过
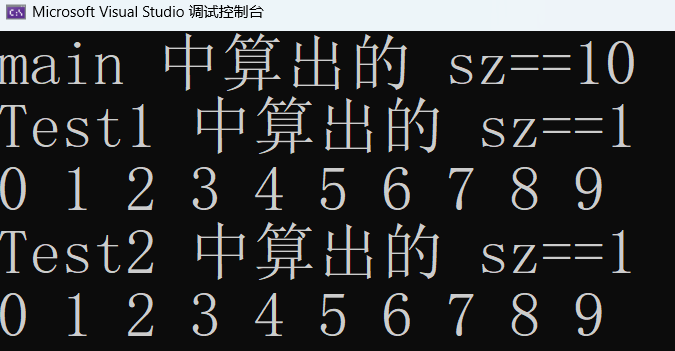
sizeof(arr)计算数组元素个数,因为此时arr已退化指针 - 形参和实参指向同一块内存,不会创建新数组
这与Java、Python中引用传递的概念有相似之处,但C/C++的指针操作更加底层和灵活。
4 · 冒泡排序与优化
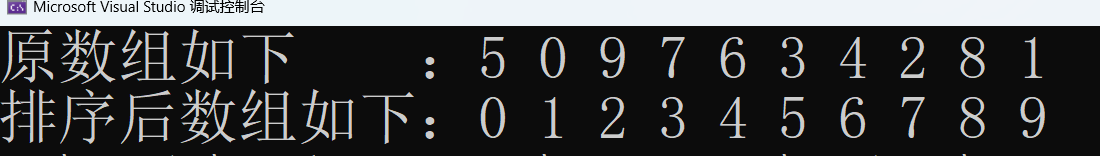
冒泡排序是经典的排序算法,其核心思想是两两相邻元素比较。对于n个元素,需要n-1趟排序:
#include
void BubbleSort(int* arr, int sz)
{
	int i = 1;
	int j = 0;
	int t = 0;
	//趟数
	for (i = 1; i <= sz - 1; i++)
	{
		//一次确定一个
		for (j = 0; j <= sz - i - 1; j++)
		{
			if (arr[j] > arr[j + 1])
			{
				//从小到大排,前者大就交换
				t = arr[j];
				arr[j] = arr[j + 1];
				arr[j + 1] = t;
			}
		}
	}
}
int main()
{
	int i = 0;
	int arr[] = { 5,0,9,7,6,3,4,2,8,1 };
	int sz = sizeof(arr) / sizeof(arr[0]);
	printf("原数组如下    :");
	for (i = 0; i < sz; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
	BubbleSort(arr, sz);
	printf("排序后数组如下:");
	for (i = 0; i < sz; i++)
	{
		printf("%d ", arr[i]);
	}
	return 0;
} 
优化策略:如果数组已经部分有序,可以提前终止:
void BubbleSort(int* arr, int sz)
{
	int i = 1;
	int j = 0;
	int t = 0;
	int flag = 1;
	//趟数
	for (i = 1; i <= sz - 1; i++)
	{
		int flag = 1;//判断是否提前排序完成
		//一次确定一个
		for (j = 0; j <= sz - i - 1; j++)
		{
			if (arr[j] > arr[j + 1])
			{
				//从小到大排,前者大就交换
				t = arr[j];
				arr[j] = arr[j + 1];
				arr[j + 1] = t;
				//如果发生交换,说明还在进行排序
				flag = 0;
			}
		}
		//如果一趟下来没发生交换,说明已排序完成
		if (flag)
		{
			break;
		}
	}
}通过设置标志位flag,当某一趟没有发生交换时,说明数组已有序,立即跳出循环。这种优化在处理近乎有序的数据时效果显著,类似于Go语言中常见的短路优化模式。
5 · 二级指针与指针数组
二级指针用于存放指针变量的地址:
#include
int main()
{
	int a = 10;
	int* p = &a;
	int** pp = &p;
	return 0;
}
int** 类型中,* 表示指针,int* 表示指向的类型。解引用一次得到一级指针,两次得到原始变量。
指针数组是存放指针的数组,每个元素都是地址:
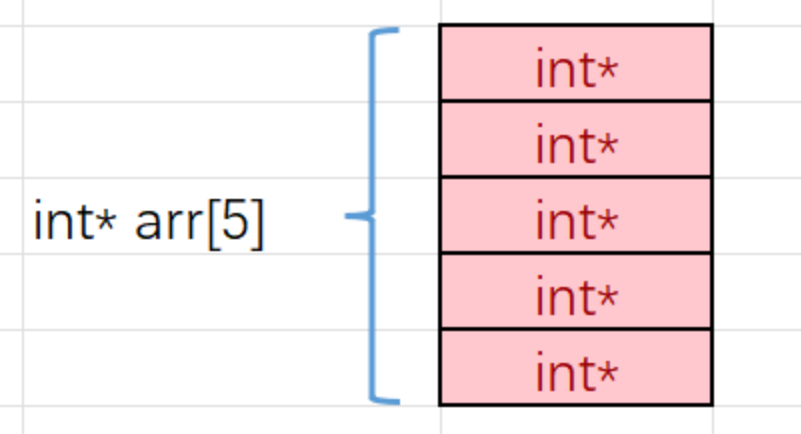
指针数组可以模拟二维数组:
#include
int main()
{
	int i = 0;
	int j = 0;
	int arr1[] = { 1,2,3,4,5 };
	int arr2[] = { 2,3,4,5,6 };
	int arr3[] = { 3,4,5,6,7 };
	int* parr[] = { arr1,arr2,arr3 };
	for (i = 0; i < 3; i++)
	{
		for (j = 0; j < 5; j++)
		{
			printf("%d ", parr[i][j]);
		}
		printf("\n");
	}
	return 0;
} 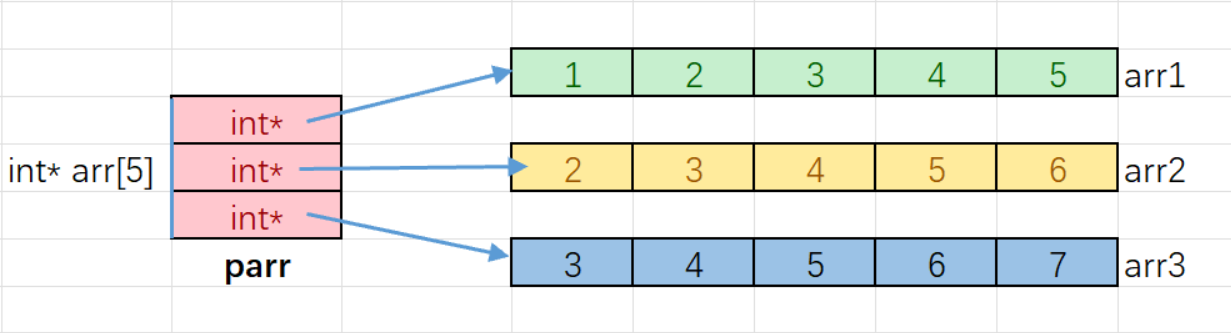
通过 parr[i][j] 访问时,实际上经历了两次解引用:*(*(parr+i)+j)。但与真正的二维数组不同,各一维数组的内存不连续。
6 · 字符指针与数组指针
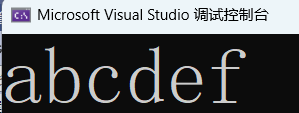
字符指针可以指向字符串常量:
int main()
{
 char ch = 'w';
 char *pc = &ch;
 *pc = 'w';
 return 0;
}
#include
int main()
{
const char* p = "abcdef";
printf("%s", p);
return 0;
} 
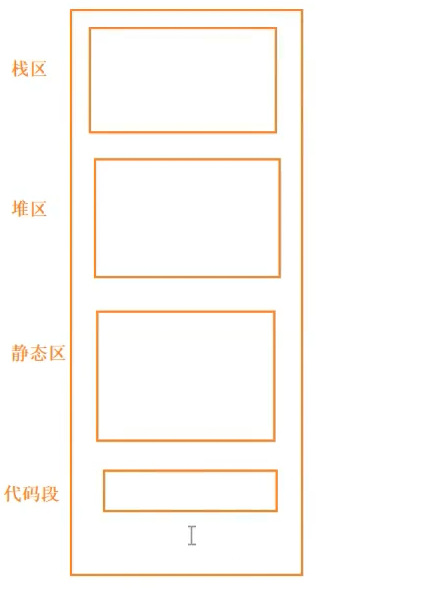
⚠️ 常量字符串存储在代码段,不可修改。多个指向同一常量字符串的指针会共享同一份数据:
数组指针是指向数组的指针:
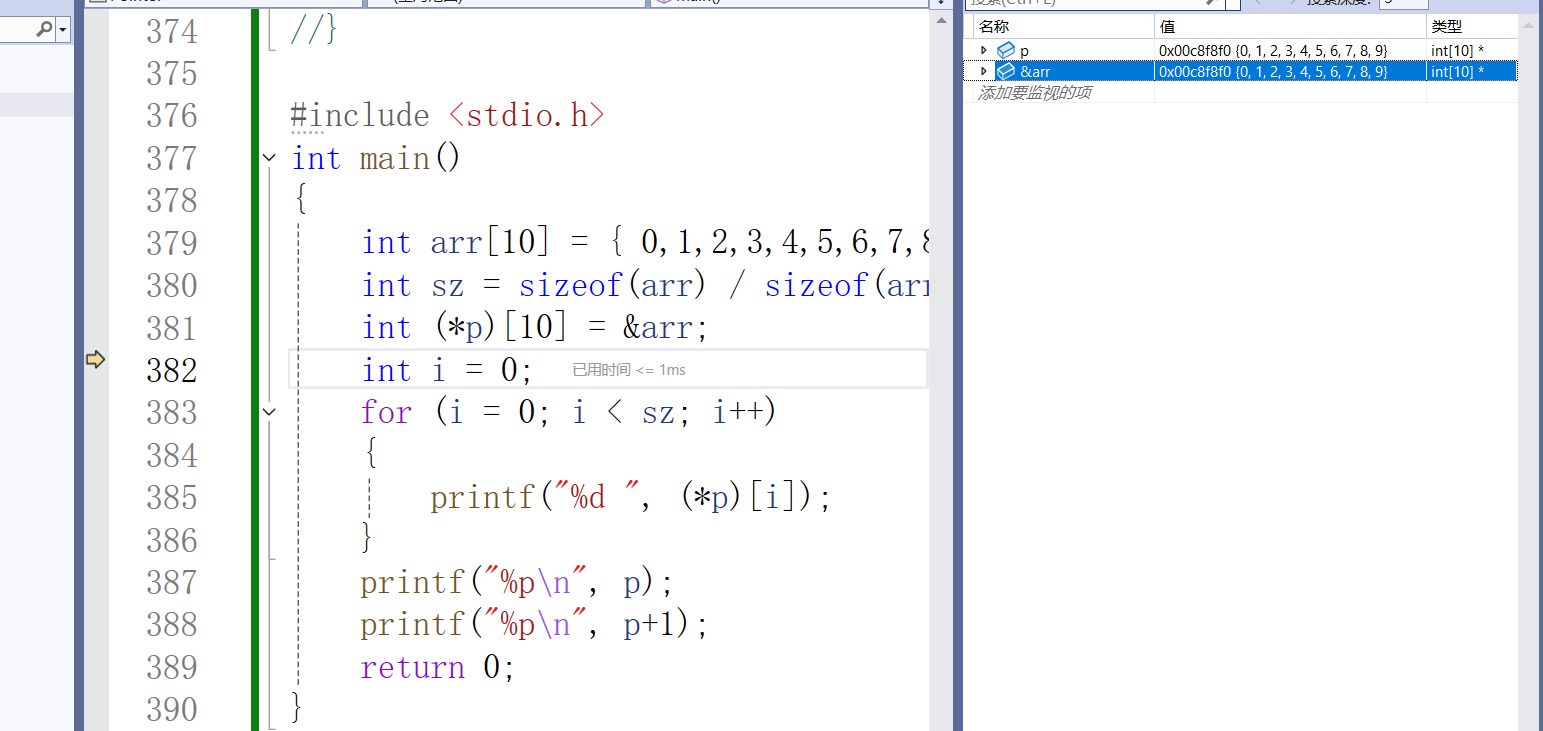
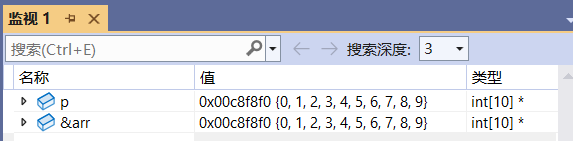
int (*p)[10]注意圆括号不能省略,否则会变成指针数组。其类型为:
int (*)[10]初始化时需要取数组的地址:
#include
int main()
{
	int arr[10] = { 0,1,2,3,4,5,6,7,8,9 };
	int sz = sizeof(arr) / sizeof(arr[0]);
	int (*p)[10] = &arr;
	int i = 0;
	for (i = 0; i < sz; i++)
	{
		printf("%d ", (*p)[i]);
	}
	return 0;
} 
[AFFILIATE_SLOT_1]
7 · 二维数组传参的本质
传统二维数组传参使用数组形式:
#include
void Print(int arr[3][5], int r, int c)
{
	int i = 0;
	int j = 0;
	for (i = 0; i < r; i++)
	{
		for (j = 0; j < c; j++)
		{
			printf("%d ", arr[i][j]);
		}
		printf("\n");
	}
}
int main()
{
	int arr[3][5] = { {1,2,3,4,5},{2,3,4,5,6},{3,4,5,6,7} };
	Print(arr, 3, 5);
	return 0;
} 但更本质的方式是使用数组指针:
void Print(int (*p)[5], int r, int c)
{
	int i = 0;
	int j = 0;
	for (i = 0; i < r; i++)
	{
		for (j = 0; j < c; j++)
		{
			printf("%d ", *(*(p + i) + j));
		}
		printf("\n");
	}
}
二维数组的首元素是一个一维数组,其地址类型为 int (*)[5]。因此,二维数组传参本质上是传递首元素的地址,接收方必须使用对应的数组指针类型。
[AFFILIATE_SLOT_2]
总结
本文深入剖析了指针与数组的交互机制,包括数组名的双重性、指针访问数组、传参本质、冒泡排序优化、二级指针、指针数组以及字符/数组指针。掌握这些概念,你就能在C/C++中写出更高效、更安全的代码。下一篇将继续探讨指针的高级应用,敬请期待!

 浙公网安备 33010602011771号