
性能测试连载 (23)-一次 cpu 指标异常的跟踪排查
问题描述
在测试环境的服务器上,发现cpu持续飙高。最高的时候达到了200%。经过反复重启无效之后,决定挖掘深层次的原因
执行top命令,观察到一个进程的cpu始终保持在100%
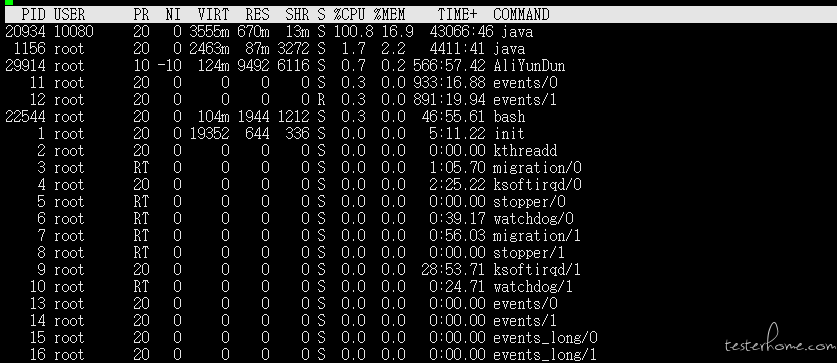
这张图可以看出系统的load average始终在100%左右
load average: 0.98, 0.95, 0.95
执行vmstat 1 10,观察一下cpu各项指标

发现一些有趣的事情。运行队列不是很长,但是上下文切换和中断的值特别大
in:表示每秒cpu中断的次数
cs:表示每秒产生的 上下文切换数。我们调用函数,就要进行上下文切换;线程间的切换,也要进程上下文切换。每次调用系统函数,我们的代码就会进入内核空间,导致上下文切换,这个很耗资源,要尽量避免频繁调用。
in和cs值越大,表示内核消耗的cpu越多
找出消耗cpu最大的进程,看一下关键进程的上下文切换数
top -Hp 20934
pidstat -p 21156 -w 1 10
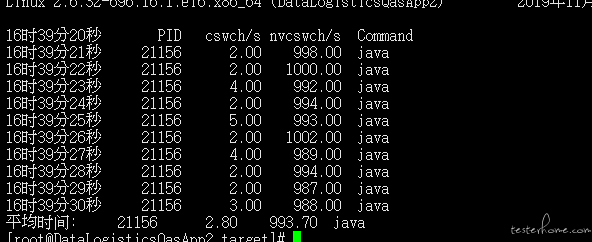
Cswch/s:每秒主动任务上下文切换数量
Nvcswch/s:每秒被动任务上下文切换数量
Command:命令名
可以看出该进程每秒都在被动的切换上下文,而且数量很大
猜测系统可能在做某种读取文件的操作,导致的线程阻塞
线程分析工具 show-busy-java-threads
在linux下执行 bash show-busy-java-threads找到阻塞的线程。发现runnable的线程都在读一个dubbo文件
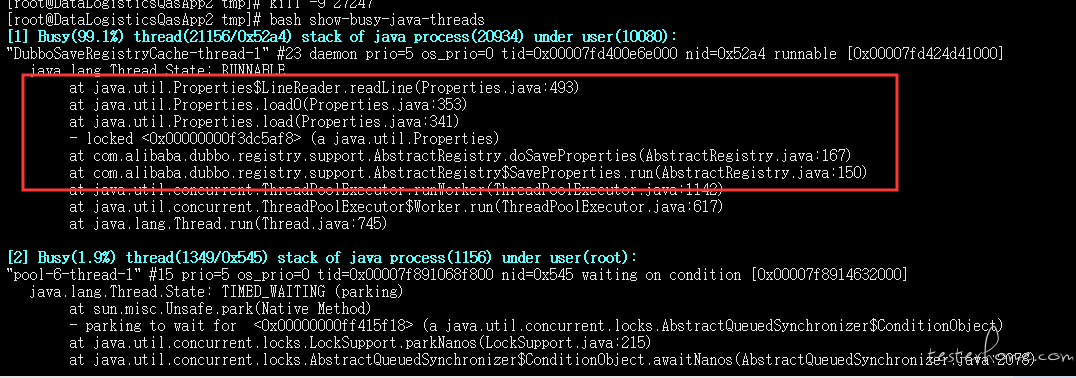
虽然找到了问题的根源,但是想要进一步解决它的话,需要更深层次的分析一下这个dubbo文件。于是我们就要取找到这个dubbo文件
strace命令
strace是做什么的呢?它是用来打开应用进程的黑盒,跟踪用户空间进程的系统调用和信号,然后打印进程日志的。
什么是系统调用?
系统调用又称为系统呼叫,指运行在用户空间的程序向操作系统内核请求需要更高权限运行的服务。
系统的进程空间分为用户空间和内核空间。
内核直接运行在硬件上,提供设备管理、内存管理、任务调度等功能
用户空间通过API请求内核空间的服务来完成其功能——内核提供给用户空间的这些API, 就是系统调用
Linux内核目前的系统调用主要分为几类:
1:文件和设备访问类 比如open/close/read/write/chmod等
2:进程管理类 fork/clone/execve/exit/getpid等
3:信号类 signal/sigaction/kill 等
4:内存管理 brk/mmap/mlock等
5:进程间通信IPC shmget/semget * 信号量,共享内存,消息队列等
6:网络通信 socket/connect/sendto/sendmsg 等
好了,现在我们用 strace -tt -T -v -f -e trace=file -o /tmp/strace.log -s 1024 -p 【pid】来找出系统在调用什么dubbo文件
-tt 在每行输出的前面,显示毫秒级别的时间
-T 显示每次系统调用所花费的时间
-v 对于某些相关调用,把完整的环境变量,文件stat结构等打出来。
-f 跟踪目标进程,以及目标进程创建的所有子进程
-e 控制要跟踪的事件和跟踪行为,比如指定要跟踪的系统调用名称
-o 把strace的输出单独写到指定的文件
-s 当系统调用的某个参数是字符串时,最多输出指定长度的内容,默认是32个字节
-p 指定要跟踪的进程pid, 要同时跟踪多个pid, 重复多次-p选项即可。
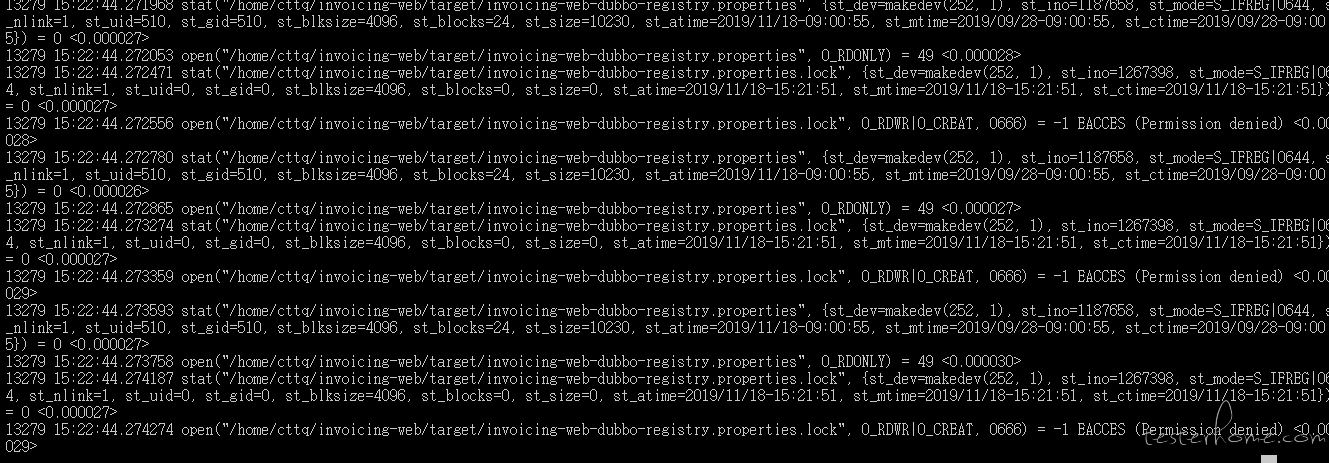
通过这个进程日志,可以很明显的看出,读取dubbo配置文件是时候因为权限不够所以反复读取,出现了一个死循环
通过这个进程找到了配置文件的路径。然后给这个lock文件赋权,完美的解决问题


 浙公网安备 33010602011771号