
Easy-es
避免版本冲突
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
            <exclusions>
                <exclusion>
                    <groupId>org.elasticsearch.client</groupId>
                    <artifactId>elasticsearch-rest-high-level-client</artifactId>
                </exclusion>
                <exclusion>
                    <groupId>org.elasticsearch.client</groupId>
                    <artifactId>elasticsearch-rest-client</artifactId>
                </exclusion>
                <exclusion>
                    <groupId>org.elasticsearch</groupId>
                    <artifactId>elasticsearch</artifactId>
                </exclusion>
            </exclusions>
        </dependency>
        <dependency>
            <groupId>org.elasticsearch.client</groupId>
            <artifactId>elasticsearch-rest-high-level-client</artifactId>
            <version>7.14.0</version>
        </dependency>
        <dependency>
            <groupId>org.elasticsearch.client</groupId>
            <artifactId>elasticsearch-rest-client</artifactId>
            <version>7.14.0</version>
        </dependency>
        <dependency>
            <groupId>org.elasticsearch</groupId>
            <artifactId>elasticsearch</artifactId>
            <version>7.14.0</version>
        </dependency>


        <!-- 引入easy-es最新版本的依赖-->
        <dependency>
            <groupId>org.dromara.easy-es</groupId>
            <artifactId>easy-es-boot-starter</artifactId>
            <!--这里Latest Version是指最新版本的依赖,比如2.0.0,可以通过下面的图片获取-->
            <version>2.0.0</version>
        </dependency>
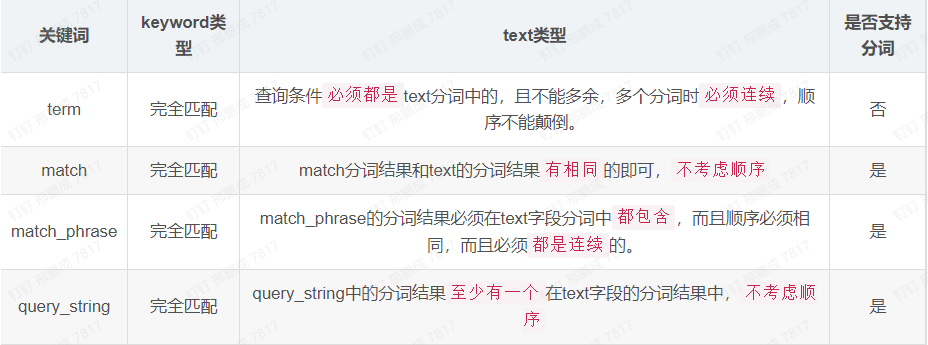
ES中的keyword类型,和MySQL中的字段基本上差不多,当我们需要对查询字段进行精确匹配,左模糊,右模糊,全模糊,排序聚合等操作时,需要该字段的索引类型为keyword类型,否则你会发现查询没有查出想要的结果,甚至报错. 比如EE中常用的API eq(),like(),distinct()等都需要字段类型为keyword类型.
当我们需要对字段进行分词查询时,需要该字段的类型为text类型,并且指定分词器(不指定就用ES默认分词器,效果通常不理想). 比如EE中常用的API match()等都需要字段类型为text类型. 当使用match查询时未查询到预期结果时,可以先检查索引类型,然后再检查分词器,因为如果一个词没被分词器分出来,那结果也是查询不出来的.
当同一个字段,我们既需要把它当keyword类型使用,又需要把它当text类型使用时,此时我们的索引类型为keyword_text类型,EE中不指定字段类型时,则默认该字段类型为此keyword+text双类型,双类型如下图所示,值得注意的是,当我们把该字段当做keyword类型查询时,ES要求传入的字段名称为"字段名.keyword",当把该字段当text类型查询时,直接使用原字段名即可. 值得庆幸的是,自2.0版本起,框架内部对此作了处理,默认会根据当前字段的索引类型和查询的类型来决定实际到底使用哪种类型,.keyword后缀框架会自动拼接,进一步减少了小白踩此坑的可能,如果您不希望框架自动根据上下文拼接.keyword后缀,您也可以通过配置文件关闭此项智能化功能, easy-es.global-config.db-config.smartAddKeywordSuffix=false
启动类加注解
@EsMapperScan("com.zidc.es.mapper")配置
# Easy-Es配置部分
easy-es:
  # 启用Easy-Es功能
  enable: true
  # 设置Elasticsearch服务器地址和端口
  address: 192.168.0.130:9200
  # username: elastic #若无 则可省略此行配置
  # password: WG7WVmuNMtM4GwNYkyWH #若无 则可省略此行配置
  # 全局配置项,设置是否打印执行的DSL语句(便于调试)
  global-config:
    print-dsl: true
@Data
@IndexName
public class Document {
    /**
     * es中的唯一id
     */
    private String id;
    /**
     * 文档标题
     */
    private String title;
    /**
     * 文档内容
     */
    private String content;
}
public interface DocumentMapper extends BaseEsMapper<Document> {
}
@RestController
@RequiredArgsConstructor(onConstructor = @__(@Autowired))
public class TestUseEeController {
    private final DocumentMapper documentMapper;

    @GetMapping("/createIndex")
    public Boolean createIndex() {
        // 1.初始化-> 创建索引(相当于mysql中的表)
        return documentMapper.createIndex();
    }

    @GetMapping("/insert")
    public Integer insert() {
        // 2.初始化-> 新增数据
        Document document = new Document();
        document.setTitle("老汉");
        document.setContent("推*技术过硬");
        return documentMapper.insert(document);
    }

    @GetMapping("/search")
    public List<Document> search() {
        // 3.查询出所有标题为老汉的文档列表
        LambdaEsQueryWrapper<Document> wrapper = new LambdaEsQueryWrapper<>();
        wrapper.eq(Document::getTitle, "老汉");
        return documentMapper.selectList(wrapper);
    }
}
注解
mapper文件扫描
@EsMapperScan("cn.easy-es-mapper")

//索引分片数  索引副本数  Settings提供类
@Settings(shardsNum = 3, replicasNum = 2, settingsProvider = MySettingsProvider.class)

//索引名称  分页返回的最大数据量maxResultWindow
@IndexName(value="IndexName",aliasName = "aliasName",maxResultWindow = 10000)


//id
IdType.NONE: 由ES自动生成,是默认缺省时的配置,无需您额外配置 推荐
IdType.UUID: 系统生成UUID,然后插入ES (不推荐)
IdType.CUSTOMIZE: 由用户自定义,用户自己对id值进行set,如果用户指定的id在es中不存在,则在insert时就会新增一条记录,如果用户指定的id在es中已存在记录,则自动更新该id对应的记录.
@IndexId


@IndexField
// 场景一:标记es中不存在的字段
@IndexField(exist = false)
// 场景二:更新时,此字段非空字符串才会被更新
@IndexField(strategy = FieldStrategy.NOT_EMPTY)
private String creator;
// 场景三: 指定fieldData
@IndexField(fieldType = FieldType.TEXT, fieldData = true)
private String filedData;
// 场景四:自定义字段名
@IndexField("wu-la")
private String ula;
// 场景五:支持日期字段在es索引中的format类型
@IndexField(fieldType = FieldType.DATE, dateFormat = "yyyy-MM-dd HH:mm:ss||yyyy-MM-dd||epoch_millis")
private String gmtCreate;
// 场景六:支持指定字段在es索引中的分词器类型
@IndexField(fieldType = FieldType.TEXT, analyzer = Analyzer.IK_SMART, searchAnalyzer = Analyzer.IK_MAX_WORD)
private String content;
// 场景七:支持指定字段在es的索引中忽略大小写,以便在term查询时不区分大小写,仅对keyword类型字段生效,es的规则,并非框架限制.
@IndexField(fieldType = FieldType.KEYWORD, ignoreCase = true)
 private String caseTest;
// 场景八:支持稠密向量类型 稠密向量类型,dims必须同时指定,非负 最大为2048
@IndexField(fieldType = FieldType.DENSE_VECTOR, dims = 3)
private double[] vector;

@HighLight
mappingField	String	否	""	高亮内容映射字段的名称,比如我想把高亮内容"老汉"赋值到字段pushCar上,就可以指定此属性值为pushCar
fragmentSize	int	否	100	高亮字段截取长度,默认为100
numberOfFragments	int	否	-1	搜索返回的高亮片段数量,默认全部返回
preTag	String	否	< em >	高亮标签,高亮内容将处于preTag之后
postTag	String	否	< /em >	高亮标签,高亮内容将处于postTag之前
highLightType	HighLightTypeEnum	否	UNIFIED	高亮类型
requireFieldMatch	boolean	否	true	高亮内容是否需要与查询字段匹配,默认值为true,当为否时,命中内容中非查询字段包含高亮内容时也会被高亮

 浙公网安备 33010602011771号