
kafka
1、概念
消息队列,是基础数据结构中“先进先出”的一种数据结构。指把要传输的数据(消息)放在队列中,用队列机制来实现消息传递——生产者产生消息并把消息放入队列,然后由消费者去处理。消费者可以到指定队列拉取消息(主动拉取),或者订阅相应的队列,由MQ服务端给其推送消息(自动推送)。
2、MQ解决的具体问题
1)异步通信:消息队列可以在应用程序之间提供异步通信,使得应用程序可以在不阻塞其他操作的情况下进行通信。
2)应用程序解耦:消息队列通过将消息的发送和接收分离实现应用程序的异步和解耦,使得它们不再相互依赖。
3)削峰:消息队列可以帮助应用程序应对高流量和大量请求,提高系统的可伸缩性。
4)消息持久化:消息队列可以提供消息持久化功能,使得消息在系统故障时不丢失。
5)实现分布式系统:消息队列可以帮助实现分布式系统,使得系统可以在多个节点上运行。
6)实现消息缓存:消息队列可以提供消息缓存功能,使得系统可以在瞬时高流量的情况下正常运行。
3、kafka简介
kafka是一个分布式、支持分区(partition)、多副本(replica)的,基于zookeeper协调的分布式消息系统
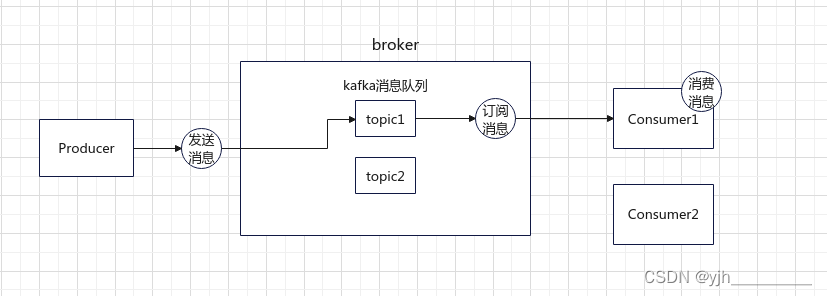
4、kafka的核心概念
- Producer:消息生产者,向broker发送消息的客户端
- Consumer:消息消费者,从broker读取消息的客户端
- Topic:主题,是一个逻辑概念,kafka根据topic对消息进行归类,发布到kafka集群的每条消息都需要指定一个topic
- Broker:中间人,是物理资源,消息中间件处理节点,一个kafka节点就是一个broker,一个或多个broker可以组成一个kafka集群
5、kafka和zookeeper的关系
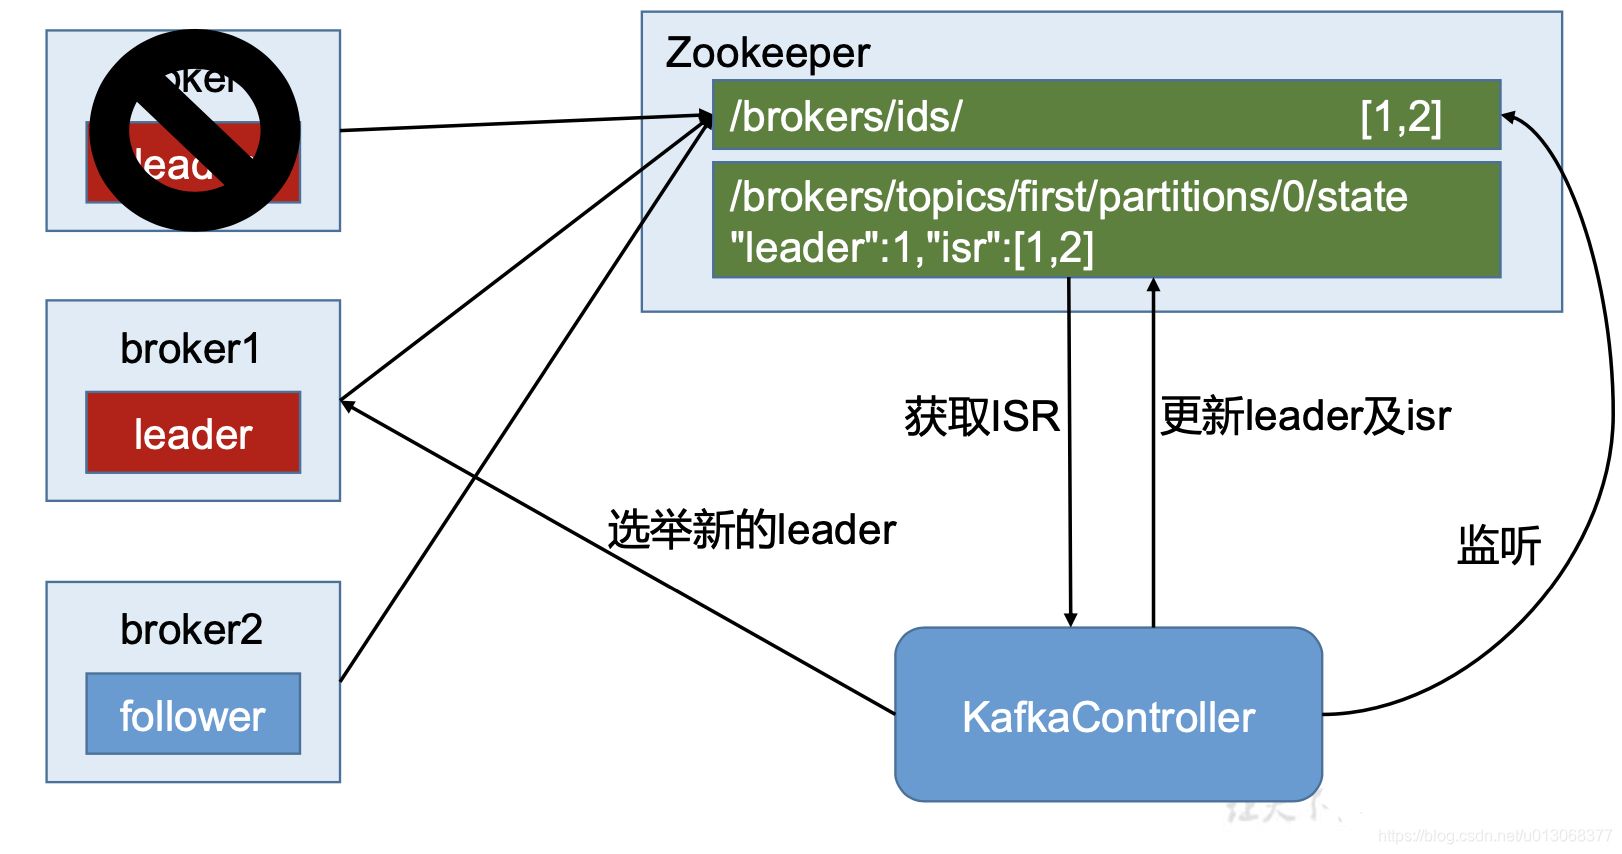
为了实现集群的无状态,将broker节点的数据都保存在ZK里面
①broker的管理,broker 会向 zookeeper发送心跳请求来上报自己的状态。在zookeeper上会有一个专门用来记录Broker服务器列表的节点,节点路径为/brokers/ids
②zookeeper 保存了 topic 相关配置,例如 topic 列表、每个 topic 的 partition数量、副本的位置等等。
③kafka 集群中有一个或多个broker,其中有一个会通过zookeeper被选举为leader控制器。leader负责管理整个集群所有分区和副本的状态,例如某个分区的 leader 故障了,zookeeper会选举新的 leader。
④kafka提供服务的端口是9092,ZK提供服务的端口是2181
为什么要用集群?
单机服务下,Kafka已经具备了非常高的性能。TPS能够达到百万级别。但是,在实际工作中使用时,单机搭建的Kafka会有很大的局限性。
一方面:消息太多,需要分开保存。Kafka是面向海量消息设计的,一个Topic下的消息会非常多,单机服务很难存得下来。这些消息就需要分成不同的Partition,分布到多个不同的Broker。这样每个Broker就只需要保存一部分数据。这些分区的个数就称为分区数。
另一方面:服务不稳定,数据容易丢失。单机服务下,如果服务崩溃,数据就丢失了。为了保证数据安全,就需要给每个Partitioni配置一个或多个备份,保证数据不丢失。Kafka的集群模式下,每个Partition都有一个或多个备份。Kafka会通过一个统一的Zookeeper集群作为选举中心,给每个Partition选举出一个主节点Leader,其他节点就是从节点Follower。主节点负责响应客户端的具体业务请求,并保存消息。而从节点则负责同步主节点的数据。当主节点发生故障时,Kfk会选举出一个从节点成为新的主节点。
最后:Kafka集群中的这些Broker信息,包括Partition的选举信息,都会保存在额外部署的Zookeeper集群当中,这样,kafka集群就不会因为某一些Broker服务崩溃而中断。
kafka发送消息
kafka自带了一个producer命令客户端,可以从本地文件中读取内容,或者我们也可以命令行中直接输入内容,并将这些内容已消息的形式发送到kafka集群中,在默认情况下,每一行会被当做成一个独立的消息。使用kafka发送消息的客户端,需要指定发送到的kafka服务器地址和topic。
消费者消费消息
对于consumer,kafka同样也携带了一个命令行客户端,会将获取到的内容在命令中进行输出,默认是消费最新的消息,使用kafka的消费者消息的客户端,从指定kafka服务器的指定topic中消费消息
1、消费者消费消息有两种形式:latest和earliest
① latest:消费者从当前主题中的最后一条消息的offset(偏移量)+ 1开始消费
② earliest:消费者从当前主题中的第一条消息开始消费2、 消息的保存和消费
① 生产者将消息发送给broker(服务器),broker会将消息保存在本地的日志文件中
② 消息的保存是有序的,通过offset来描述消息的有序性
③ 消费者消费消息时也是通过offset来描述当前要消费的那条消息的位置;
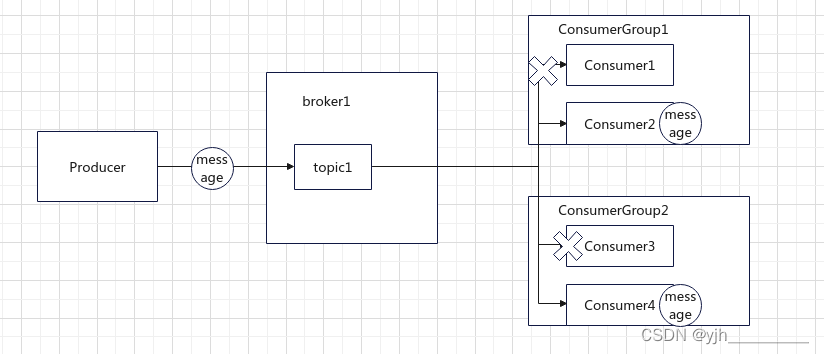
④ 单播消息:每个分区只能被同一个消费者组内的一个consumer来消费;
⑤多播消息:不同消费组中的消费者之前消费消息互不影响;
6、主题和分区
1、主题topic
① topic在kafka中是一个逻辑的概念,kafka通过topic将消息进行分类;
② 不同的topic会被订阅该topic的消费者消费
③ topic中的消息会被保存在log日志文件中,数据量庞大,为了解决这个文件过大的问题,kafka提出了分区partition的概念
注:每个broker中可以有多个topic
2、分区partition
partition是一个逻辑概念,将一个topic中的消息分为多个分区来存储,解决了统一存储文件过大的问题;提高了IO吞吐量,即读写可以同时在多个分区中进行;
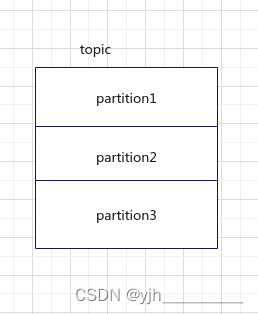
注:partition是通过kafka命令在ZK中创建的
7、kafka中消息日志中保存的内容
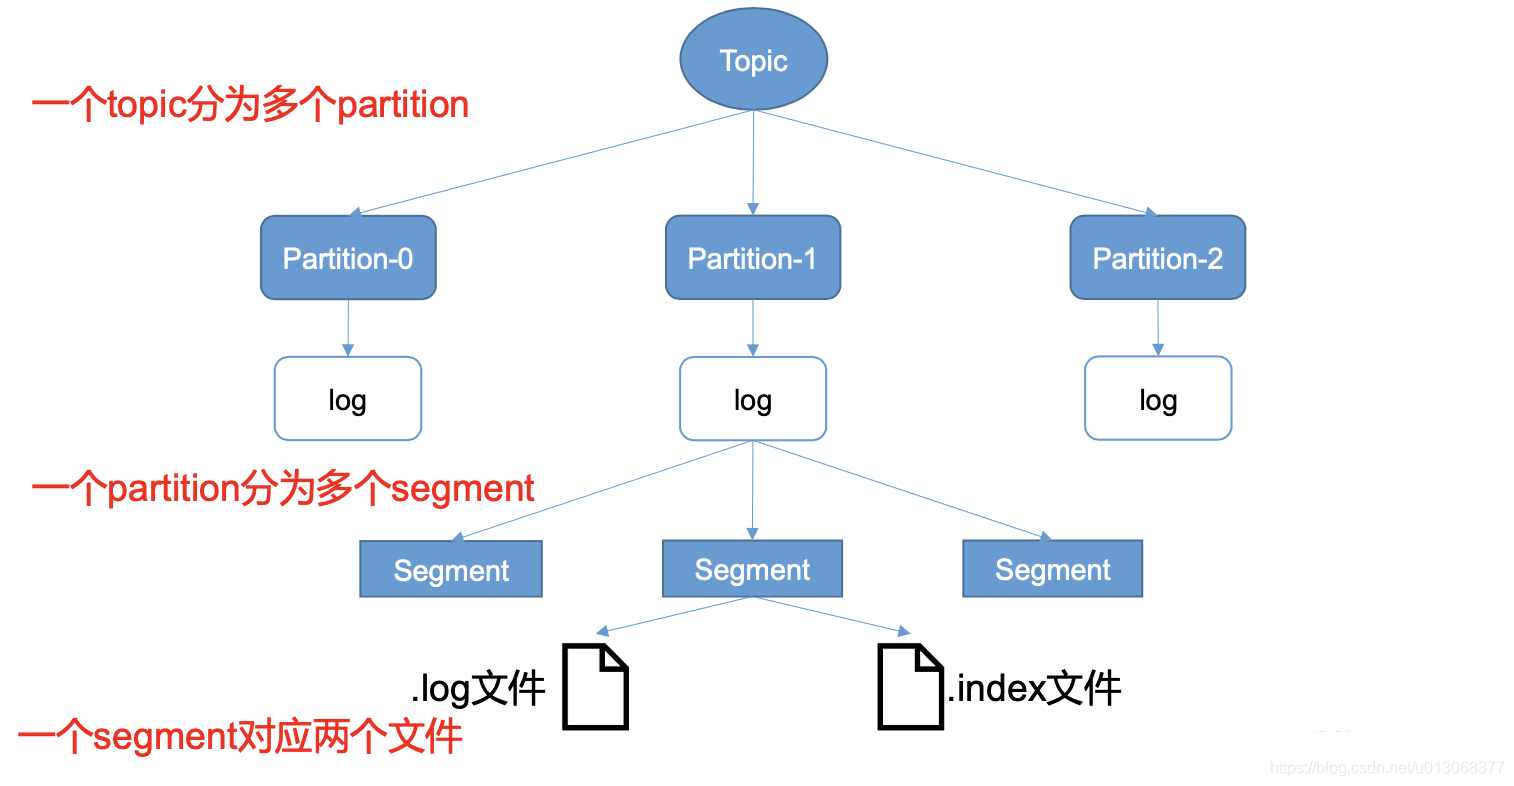
index 和 log 文件以当前 segment 的第一条消息的 offset 命名。
“.index”文件存储大量的索引信息,“.log”文件存储大量的数据,索引文件中的元数据指向对应数据文件中 message 的物理偏移地址。
消息日志中保存的是消息内容和偏移量
① 00000.log:保存消息(消息内容)
② _consumer_offsets_49:kafka内部自己创建了_consumer_offsets主题包含50个分区。这个主题用来存放consumer消费某个topic的偏移量。因为每个consumer都会自己维护消费的topic偏移量,也就是说每个consumer会把消费的主题偏移量自主上报给kafka中的默认主题_consumer_offsets_。因此kafka为了提升这个topic的并发性,默认设置了50个分区,可以让多个consumer并行提交消费的偏移量,至于提交到哪个分区,通过hash函数确定,提交内容为:key-消费者组id+topic+分区号,value-当前offset值
③ _consumer_offsets_49文件中保存的消息默认保存7天,7天后会被删除,因此一个消费者如果超过7天没有消费消息,那么之后它再消费消息则找不到当初的offset(偏移量只保存7天)
8、副本
副本是Topic中的Partition创建的多个备份,多个副本在kafka集群的多个Broker中,其中一个副本是Leader,其他的都是Follower (副本是Partition的副本)
① Leader:kafka的读写操作都发生在Leader上,Leader负责把数据同步给Follower;当Leader宕机(挂了),经过主从选举,从多个Follower中选举一个新的Leader。
② Follower:接收Leader同步的数据
③ ISR:是一个集合,用来存放可以同步和已同步的节点;如果ISR中的节点性能较差(同步较慢),会被踢出ISR集合
kafka集群中有多个Broker,创建Topic时可以指明主题有多个分区(把消息拆分到不同的分区中存储),可以为分区创建多个副本,不同的副本存放在不同的Broker里面
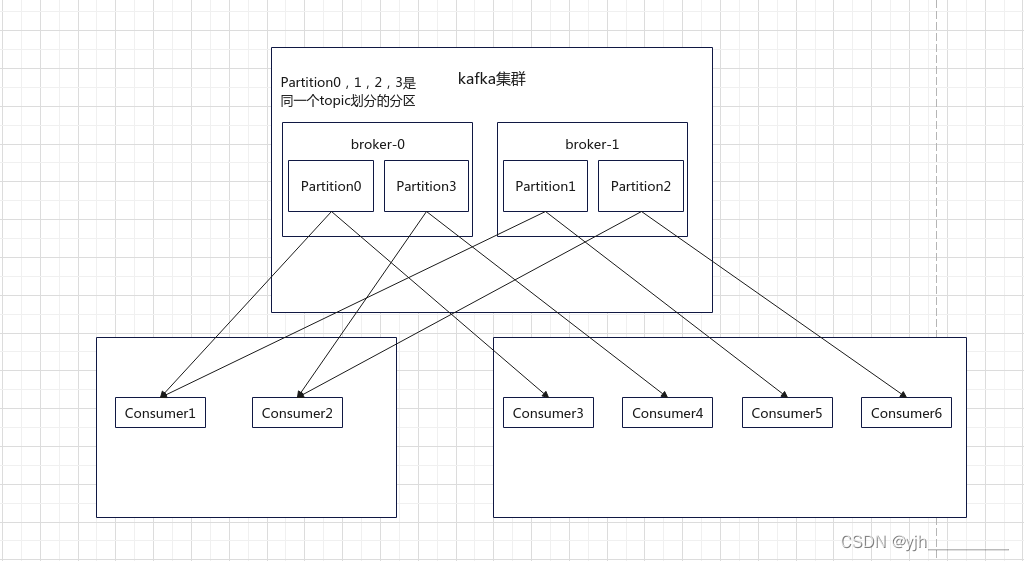
一个Partition只能被一个ConsumerGroup里面的某一个Comsumer消费,因为单个Comsumer消费单个Partition中的消息是顺序消费的,因此可以保证消费的顺序消费;在同一个Topic中的多个Partition之间不能保证总的消费顺序,因为消息从Producer传递到Topic中会有数据延迟,每个Comsumer消费能力也不同,因此不能保证总体的先进的消息被先消费。即kafka只在Partition范围内保证消息消费的局部顺序性
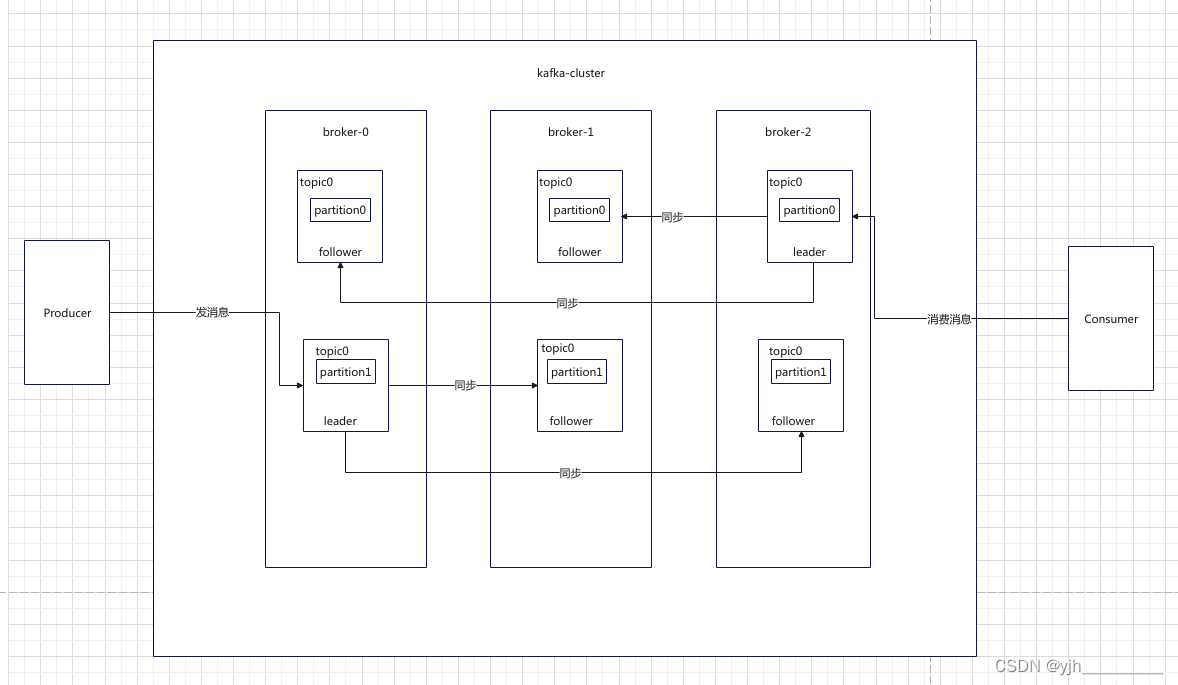
注:副本是Partition的副本
ConsumerGroup中Comsumer的数量不能比一个Topic中Partition数量多,否则多出来的Comsumer消费不到消息。如果某个Comsumer挂了,会触发rebalance机制,让其他Comsumer来消费该Partition。
9.Kafka 生产者
3.1、分区策略
分区的原因
方便在集群中扩展,每个 Partition 可以通过调整以适应它所在的机器,而一个 topic又可以有多个 Partition 组成,因此整个集群就可以适应任意大小的数据了;
可以提高并发,因为可以以 Partition 为单位读写了。
分区的原则:我们需要将 producer 发送的数据封装成一个 ProducerRecord 对象。
指明 partition 的情况下,直接将指明的值直接作为 partiton 值;
没有指明 partition 值但有 key 的情况下,将 key 的 hash 值与 topic 的 partition 数进行取余得到 partition 值;
既没有 partition 值又没有 key 值的情况下,第一次调用时随机生成一个整数(后面每次调用在这个整数上自增),将这个值与 topic 可用的 partition 总数取余得到 partition 值,也就是常说的 round-robin 算法。
3.2、数据可靠性保证
消息可靠性
为保证 producer 发送的数据,能可靠的发送到指定的 topic,topic 的每个 partition 收到 producer 发送的数据后,都需要向 producer 发送 ack(acknowledgement 确认收到),如果 producer 收到 ack,就会进行下一轮的发送,否则重新发送数据。
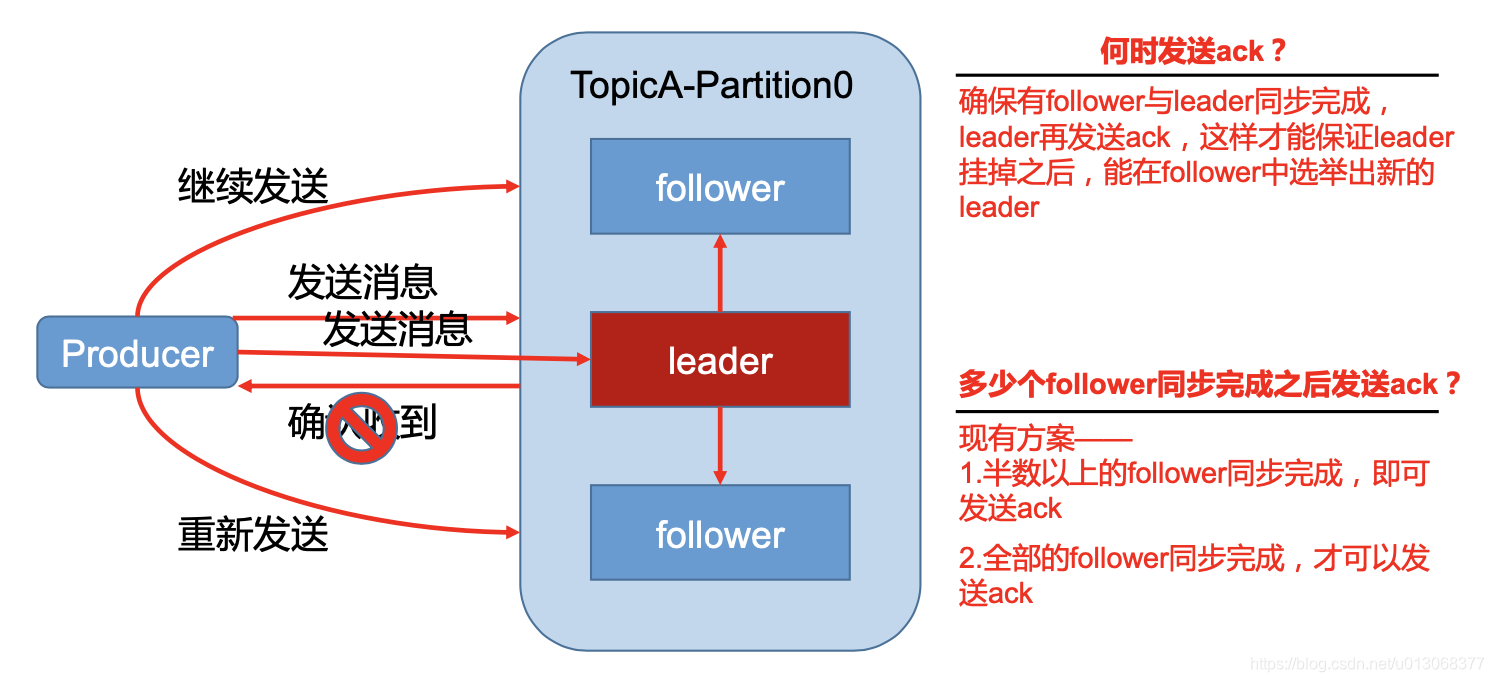
3.2.1、副本数据同步策略
|
方案 |
优点 |
缺点 |
|
半数以上完成同步,就发送 ack |
延迟低 |
选举新的 leader 时,容忍 n 台 节点的故障,需要 2n+1 个副本 |
|
全部完成同步,才发送ack |
选举新的 leader 时,容忍 n 台 节点的故障,需要 n+1 个副本 |
延迟高 |
Kafka 选择了第二种方案,原因如下:
同样为了容忍 n 台节点的故障,第一种方案需要 2n+1 个副本,而第二种方案只需要 n+1 个副本,而 Kafka 的每个分区都有大量的数据,第一种方案会造成大量数据的冗余。
虽然第二种方案的网络延迟会比较高,但网络延迟对 Kafka 的影响较小。
3.2.2、ISR
采用第二种方案之后,设想以下情景:leader 收到数据,所有 follower 都开始同步数据, 但有一个 follower,因为某种故障,迟迟不能与 leader 进行同步,那 leader 就要一直等下去, 直到它完成同步,才能发送 ack。这个问题怎么解决呢?
Leader 维护了一个动态的 in-sync replica set (ISR),意为和 leader 保持同步的 follower 集合。当 ISR 中的 follower 完成数据的同步之后,leader 就会给 follower 发送 ack。如果 follower 长时间未向 leader 同步数据,则该 follower 将被踢出 ISR,该时间阈值由 replica.lag.time.max.ms 参数设定。Leader 发生故障之后,就会从 ISR 中选举新的 leader。
3.2.3、ack 应答机制
对于某些不太重要的数据,对数据的可靠性要求不是很高,能够容忍数据的少量丢失, 所以没必要等 ISR 中的 follower 全部接收成功。
所以 Kafka 为用户提供了三种可靠性级别,用户根据对可靠性和延迟的要求进行权衡, 选择以下的配置,acks 参数配置: acks:
0:producer 不等待 broker 的 ack,这一操作提供了一个最低的延迟,broker 一接收到还没有写入磁盘就已经返回,当 broker 故障时有可能丢失数据;
1:producer 等待 broker 的 ack,partition 的 leader 落盘成功后返回 ack,如果在 follower 同步成功之前 leader 故障,那么将会丢失数据;
-1(all):producer 等待 broker 的 ack,partition 的 leader 和 follower 全部落盘成功后才 返回 ack。但是如果在 follower 同步完成后,broker 发送 ack 之前,leader 发生故障,那么会造成数据重复。
3.2.4、故障处理细节
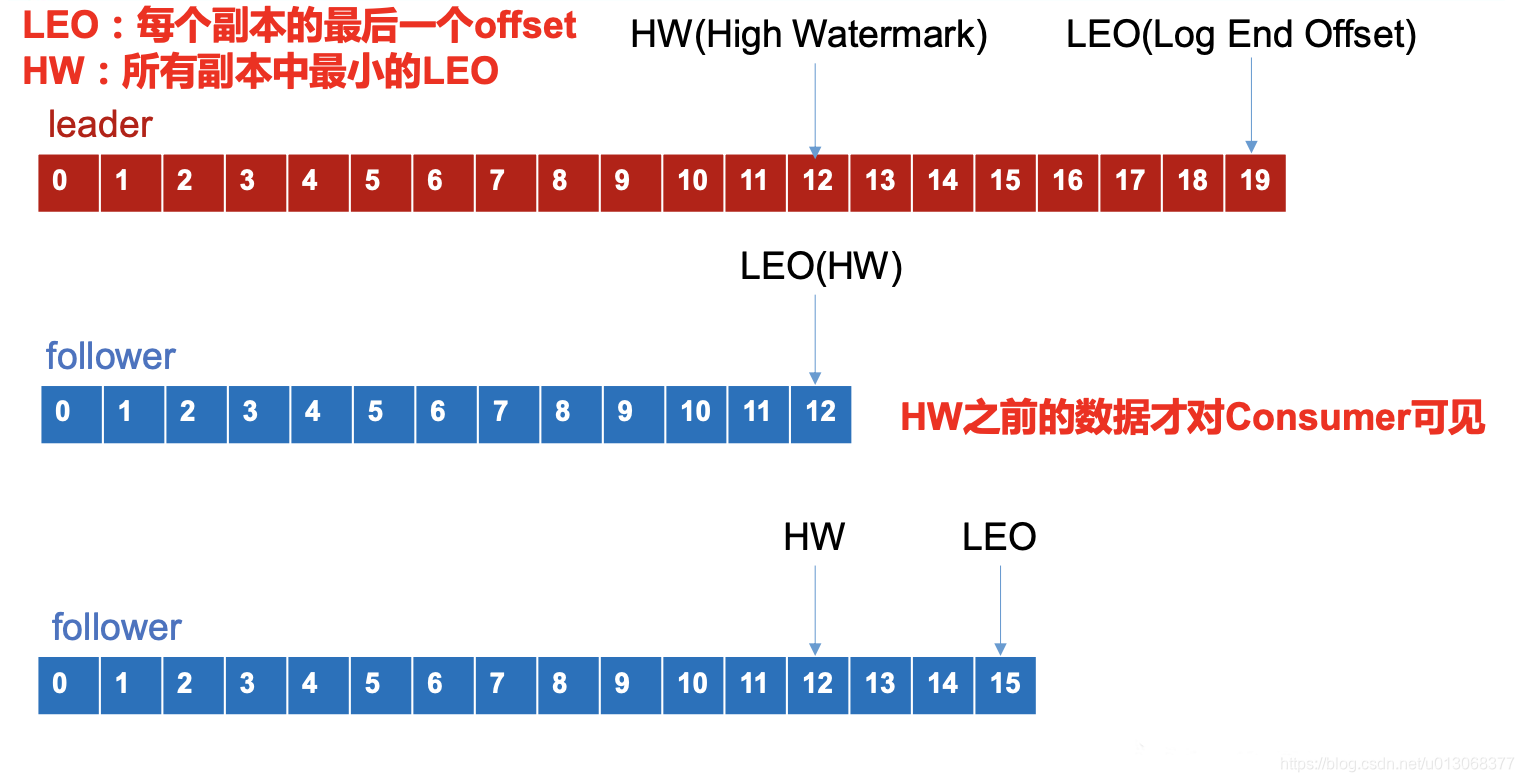
LEO:指的是 topic 分区中每个副本最大的 offset;
HW:指的是消费者能见到的最大的 offset,ISR 队列中最小的 LEO;
follower 故障
follower 发生故障后会被临时踢出 ISR,待该 follower 恢复后,follower 会读取本地磁盘记录的上次的 HW,并将 log 文件高于 HW 的部分截取掉,从 HW 开始向 leader 进行同步。 等该 follower 的 LEO 大于等于该 Partition 的 HW,即 follower 追上 leader 之后,就可以重新加入 ISR 了。
leader 故障
leader 发生故障之后,会从 ISR 中选出一个新的 leader,之后,为保证多个副本之间的数据一致性,新的 leader 先会以 HW 为目标,多退少补;其余的 follower 会以新的 leader 的 LEO 为目标,多退少补,同步数据。
注意:这只能保证副本之间的数据一致性,并不能保证数据不丢失或者不重复。
10、Kafka消费者
10.1、消费方式
consumer 采用 pull(拉) 模式从 broker 中读取数据。
push(推) 模式很难适应消费速率不同的消费者,因为消息发送速率是由 broker 决定的。它的目标是尽可能以最快速度传递消息,但是这样很容易造成 consumer 来不及处理消息,典型的表现就是拒绝服务以及网络拥塞。而 pull 模式则可以根据 consumer 的消费能力以适当的速率消费消息。
pull 模式不足之处是,如果 kafka 没有数据,消费者可能会陷入循环中,一直返回空数 据。针对这一点,Kafka 的消费者在消费数据时会传入一个时长参数 timeout,如果当前没有 数据可供消费,consumer 会等待一段时间之后再返回,这段时长即为 timeout。
① 默认情况下,消费者一次会poll 500条消息
② 代码中设置了长轮询的时间是1s:如果一次poll到500条,则停止poll,开始消费;如果一次没有poll满500条,且时间在1秒内,那么长轮询继续poll,如果时间到了,还没有满500条,则停止poll,开始消费
③ 消费者如果两次poll的时间间隔超过30s,集群会认为该消费者的消费能力弱,会将其提出消费组,触发rebalance机制,该机制会造成性能开销
1、消费者offset的自动提交和手动提交
自动提交:消息poll下来,直接提交offset
手动提交:在消费消息时/后再提交offset
自动提交会丢消息,如果消费者还没有消费完poll下来的消息就自动提交了offset,此时消费者挂了,下一个消费者就会从已提交的offset的下一个位置开始消费消息,之前未被消费的消息就丢失了
2、消费者提交内容
消费者无论手动提交还是自动提交都需要把:所属的消费组+消费的主题+消费的分区+消费的偏移量等信息提交到集群的_consumer_offsets主题里面
3、手动提交的分类
① 手动同步提交:在消费完消息后调用同步提交的方法,在集群返回ack之前一直阻塞,返回ack表示提交成功,执行之后的逻辑
② 手动异步提交:在消息消费完后提交,直接执行之后的逻辑,可以设置一个回调方法,供集群调用
10.2、分区分配策略
一个 consumer group 中有多个 consumer,一个 topic 有多个 partition,所以必然会涉及到 partition 的分配问题,即确定那个 partition 由哪个 consumer 来消费。
Kafka 有两种分配策略,一是 RoundRobin,一是 Range。
10.2.1、RoundRobin
使用RoundRobin策略有两个前提条件必须满足:
同一个Consumer Group里面的所有消费者的num.streams必须相等;
每个消费者订阅的主题必须相同。
所以这里假设前面提到的2个消费者的num.streams = 2。RoundRobin策略的工作原理:将所有主题的分区组成 TopicAndPartition 列表,然后对 TopicAndPartition 列表按照 hashCode 进行排序,分发给每一个消费者。(其实就是按分区名hash排序后平均分配给每一个消费者的线程)
10.2.2、Range
是对每个主题而言的。首先按照分区序号排序,然后将消费者排序。分区数/消费者数=m,如果m!=0,前m个消费者多消费一个分区(每个主题)
总结:目前我们还不能自定义分区分配策略,只能通过partition.assignment.strategy参数选择 range 或 roundrobin。partition.assignment.strategy参数默认的值是range。
10.3、offset 的维护
由于 consumer 在消费过程中可能会出现断电宕机等故障,consumer 恢复后,需要从故障前的位置的继续消费,所以 consumer 需要实时记录自己消费到了哪个 offset,以便故障恢复后继续消费。
Kafka 0.9 版本之前,consumer 默认将 offset 保存在 Zookeeper 中,从 0.9 版本开始, consumer 默认将 offset 保存在 Kafka 一个内置的 topic 中,该 topic 为__consumer_offsets。
11、消息发送的缓冲区
① kafka的消息是批量发送的
② kafka默认会创建一个消息缓冲区,用来存放要发送的消息,缓冲区的大小为32Mb
③ kafka本地线程会去缓冲区中一次拉16kb的数据,发送到broker
④ 如果线程拉取的数据不到16kb,在10ms时间内会多次拉取,如果时间到了还是没有拉取满16kb,也会将已拉取的数据发送到broker
13、消费者的健康状态检查
消费者每隔1s向kafka集群发送心跳,如果集群发现超过10s,没有收到消费者发送的消息,其会被提出消费组,触发消费组的rebalance机制,将该分区交给消费组里面的其他消费者进行消费。
如果有消费组中有新的消费者启动,默认会从当前分区的最后一条消息的offset+1开始消费
14、kafka集群中的Controller、Rebalance和HW
1、Controller控制器
① kafka集群中的broker在zk中创建临时序号节点,序号最小的节点(最先创建的节点)将作为集群的controller,负责管理整个集群中的所有分区和副本的状态
② 当某个Partition中的Leader副本出现故障时,由Controller负责为该分区选举新的Leader副本
③ 当检测到某个分区的ISR集合发生变化时,由Controller负责通知所有Broker更新其元数据信息
④ 当使用kafka-topic.sh脚本为某个Topic增加分区数量时,同样还是由Controller负责让新分区被其他节点感知到
2、Rebalance机制
前提:消费者没有指明分区消费。当消费组里消费者和分区的关系发生变化时,Rebalance机制触发,重新调整消费者消费的分区
消费者消费分区的三种策略
① range:通过公式(分区数/消费者数 + 1 或 分区数/消费者数 )来计算某个消费者消费哪个分区
② 轮询
③ sticky(粘合):在触发rebalance机制以后,在消费者消费的原有分区不变的基础上进行调整,没有宕机的消费者原来消费哪些分区,之后依旧消费哪些分区,宕机的消费者空出来的分区被没有宕机的消费者重新分配
HW和LEO
LEO(log-end-offset)是某个副本最后消息的消费位置
HW(high-waterline)是已完成同步的位置,消息在写入broker时,且每个broker完成这条消息的同步后,HW才会变化;消息未同步好,即消息刚刚开始同步,HW没有变化时,消费者是消费不到当前消息的,在消息完成同步,HW更新之后,消费者才能消费到这条消息,这样的目的是为了防止消息丢失。
15、kafka的线上问题优化
1、防止数据丢失
发送方:同步发送,ack是1或者-1/all可以放置消息丢失,如果要做到99.9999%,ack设成all,把min.insync.replicas配置成分区备份数
消费方:把自动提交改为手动提交
2、防止重复消费
在防止消息丢失的方案中,如果生产者发送完消息后,因为网络抖动,没有收到ack,但实际上Broker已经收到了,此时生产者会进行重试,于是Broker就会收到多条相同的消息,而造成消费者的重复消费
生产者关闭重试:会造成消息丢失(不建议)
消费者:解决非幂等性问题
解决非幂等性问题的方案:①在数据库中创建联合主键,防止相同的主键创建出多条记录;②使用分布式锁,以业务id为锁,保证只有一条记录能创建成功
3、确保顺序消费
发送方:在发生消息时将ack不能设置为0,不能关闭重试。使用同步发送,等到发送成功再发送下一条,确保消息是顺序发送的
接收方:topic只能设置一个分区,消费组中只能有一个消费者
kafka的顺序消费使用场景不多,因为牺牲掉性能,如果要做顺序消费,可以使用rocketMQ
4、解决消息积压问题
① 问题产生原因
消息的消费者的消费速度远赶不上生产者的生产消息的速度,导致kafka中有大量的数据没有被消费,随着没有被消费的数据堆积越多,消费者寻址的性能越来越差,最后导致整个kafka对外提供的服务的性能越来越差,其他服务访问速度也变慢,造成服务雪崩
② 解决方案
(1)在这个消费者中,使用多线程,充分利用机器的性能进行消息消费
(2)创建多个消费组,多个消费者,部署到其他机器上,一起消费,提高消费者的消费速度
(3)创建一个消费者,该消费者在kafka另建一个主题,配上多个分区,多个分区再配上多个消费者,该消费者将poll下来的消息不进行消费,直接转发到新建的主题上,此时,新的主题的多个分区的多个消费者就开始一起消费了(不常用)
(4)通过业务的架构设计,提升业务层消费的性能
5、延迟队列
① 应用场景:订单创建后,超过30分钟没有支付,则需要取消订单,这种场景可以通过延时队列来实现
② 具体方案
(1)kafka中创建相应的主题
(2)消费者消费该主题的消息(轮询)
(3)消费者消费消息时判断消息的创建时间和当前时间之间的差值是否超过30分钟(订单未支付):如果是,则去数据库中修改订单状态为已取消;如果不是,则记录当前消息的offset,并不再继续消费之后的消息,等待一分钟后,再次向kafka拉取该offset及之后的消息,继续进行判断,依次反复;
注:幂等性是指多次访问的结果都是一样的,对于rest的请求,CRUD中只有C是非幂等的
16、kafka安装
Kafka对于zookeeper是强依赖,保存kafka相关的节点数据,所以安装Kafka之前必须先安装zookeeper
- Docker安装zookeeper
docker pull zookeeper:3.4.14
docker run -d --name zookeeper -p 2181:2181 zookeeper:3.4.14- Docker安装kafka
docker pull wurstmeister/kafka:2.12-2.3.1

docker run -d --name kafka \
--env KAFKA_ADVERTISED_HOST_NAME=192.168.200.130 \
--env KAFKA_ZOOKEEPER_CONNECT=192.168.200.130:2181 \
--env KAFKA_ADVERTISED_LISTENERS=PLAINTEXT://192.168.200.130:9092 \
--env KAFKA_LISTENERS=PLAINTEXT://0.0.0.0:9092 \
--env KAFKA_HEAP_OPTS="-Xmx256M -Xms256M" \
--net=host wurstmeister/kafka:2.12-2.3.1
1.导入spring-kafka依赖信息
<dependencies>
  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
  </dependency>
  <!-- kafkfa -->
  <dependency>
    <groupId>org.springframework.kafka</groupId>
    <artifactId>spring-kafka</artifactId>
    <exclusions>
      <exclusion>
        <groupId>org.apache.kafka</groupId>
        <artifactId>kafka-clients</artifactId>
      </exclusion>
    </exclusions>
  </dependency>
  <dependency>
    <groupId>org.apache.kafka</groupId>
    <artifactId>kafka-clients</artifactId>
  </dependency>
  <dependency>
    <groupId>com.alibaba</groupId>
    <artifactId>fastjson</artifactId>
  </dependency>
</dependencies>
2.在resources下创建文件application.yml
server:
  port: 9991
spring:
  application:
    name: kafka-demo
  kafka:
    bootstrap-servers: 192.168.200.130:9092
    producer:
      retries: 10
      key-serializer: org.apache.kafka.common.serialization.StringSerializer
      value-serializer: org.apache.kafka.common.serialization.StringSerializer
    consumer:
      group-id: ${spring.application.name}-test
      key-deserializer: org.apache.kafka.common.serialization.StringDeserializer
      value-deserializer: org.apache.kafka.common.serialization.StringDeserializer
3.消息生产者
package com.heima.kafka.controller;

import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.kafka.core.KafkaTemplate;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@RestController
public class HelloController {

    @Autowired
    private KafkaTemplate<String,String> kafkaTemplate;

    @GetMapping("/hello")
    public String hello(){
        kafkaTemplate.send("itcast-topic","黑马程序员");
        return "ok";
    }
}
4.消息消费者
package com.heima.kafka.listener;

import org.springframework.kafka.annotation.KafkaListener;
import org.springframework.stereotype.Component;
import org.springframework.util.StringUtils;

@Component
public class HelloListener {

    @KafkaListener(topics = "itcast-topic")
    public void onMessage(String message){
        if(!StringUtils.isEmpty(message)){
            System.out.println(message);
        }

    }
}
2.2传递消息为对象
目前springboot整合后的kafka,因为序列化器是StringSerializer,这个时候如果需要传递对象可以有两种方式
方式一:可以自定义序列化器,对象类型众多,这种方式通用性不强,本章节不介绍
方式二:可以把要传递的对象进行转json字符串,接收消息后再转为对象即可,本项目采用这种方式
- 发送消息
@GetMapping("/hello")
public String hello(){
    User user = new User();
    user.setUsername("xiaowang");
    user.setAge(18);

    kafkaTemplate.send("user-topic", JSON.toJSONString(user));

    return "ok";
}
- 接收消息
package com.heima.kafka.listener;

import com.alibaba.fastjson.JSON;
import com.heima.kafka.pojo.User;
import org.springframework.kafka.annotation.KafkaListener;
import org.springframework.stereotype.Component;
import org.springframework.util.StringUtils;

@Component
public class HelloListener {

    @KafkaListener(topics = "user-topic")
    public void onMessage(String message){
        if(!StringUtils.isEmpty(message)){
            User user = JSON.parseObject(message, User.class);
            System.out.println(user);
        }

    }
}

 浙公网安备 33010602011771号