
Paper Reading: Neural Oblivious Decision Ensembles for Deep Learning on Tabular Data
Paper Reading 是从个人角度进行的一些总结分享,受到个人关注点的侧重和实力所限,可能有理解不到位的地方。具体的细节还需要以原文的内容为准,博客中的图表若未另外说明则均来自原文。
| 论文概况 | 详细 |
|---|---|
| 标题 | 《Neural Oblivious Decision Ensembles for Deep Learning on Tabular Data》 |
| 作者 | Sergei Popov, Stanislav Morozov, Artem Babenko |
| 发表会议 | 8th International Conference on Learning Representations, ICLR 2020 |
| 发表年份 | 2020 |
| 会议等级 | CCF-A |
| 论文代码 | https://github.com/Qwicen/node |
作者单位:
- Yandex
- Lomonosov Moscow State University
- National Research University
- Higher School of Economics
研究动机
深度神经网络在计算机视觉、自然语言处理和语音识别等领域取得了突破性进展,其成功主要归功于基于反向传播的梯度优化和分层表示学习的能力。然而,在处理异构表格数据时,深度神经网络的性能优势并不明确。在实践中,诸如梯度提升决策树等浅层模型(如 XGBoost、LightGBM、CatBoost)是解决表格数据问题的首选,是目前事实上的SOTA。虽然已有许多研究工作尝试将深度学习应用于表格数据,但所提出的 DNN 方法并未能持续、显著地超越最先进的浅层模型。基于上述背景,论文旨在解决一个问题:如何构建一种 DNN 架构,使其在处理异构表格数据时,能够持续、显著地超越以 GBDT 为代表的最先进的浅层模型?
文章贡献
本文提出一种表格深度学习架构 NODE,旨在解决深度学习方法在异构表格数据上未能稳定超越 GBDT 的难题。其核心思想是将传统的集成树模型,特别是CatBoost 中使用的遗忘决策树转化为可微分的模块,从而构建可端到端训练的深度 GBDT。该模型利用 α-entmax 变换来软化和稀疏化特征选择与决策路由,并通过类似 DenseNet 的多层连接结构,使得早期层学习基础特征,深层树利用这些特征进行复杂决策。在 6 个公开表格数据集上通过默认参数和调参两种模式,与 GBDT 方法进行对比实验,证明了 NODE 在大多数任务上的性能优势。
预备知识
Oblivious Decision Tree
Oblivious Decision Tree 是一种特殊类型的决策树,它在树的每一层(同一深度)都使用完全相同的特征和分裂阈值。
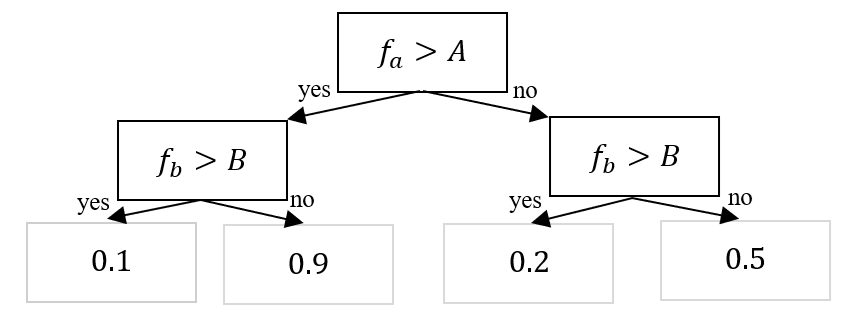
每棵 ODT 在本质上是一个决策表,它沿着 \(d\) 个分裂特征对数据进行分割,并将每个特征与一个学习的阈值进行比较,然后根据比较结果返回 \(2^d\) 个可能响应中的一个。一棵 ODT 由其分裂特征 \(\mathbf{f} \in \mathbb{R}^{d}\)、分裂阈值 \(\mathbf{b} \in \mathbb{R}^{d}\) 和一个 \(d\) 维响应张量 \(\mathbf{R} \in \mathbb{R}^{2^d}\) 决定。其输出函数为:
其中,\(\mathbb{1}(\cdot)\) 是 Heaviside 函数,它将所有负输入映射为 0,将所有正输入映射为 1。最常见的定义是:
Entmax 函数
Softmax 是神经网络中最常用的激活函数,它将一个实数向量(logits)转换成一个概率分布,最常用于多分类问题的输出层。该函数的特性是处处稠密,只要 logits 值不是无穷大,Softmax 对每一个元素都会分配一个非零的概率,无论这个概率多小。在某些任务中,这种的特性并不是优点。例如在机器翻译或摘要生成中,我们更希望模型能够聚焦于少数几个相关的单词,而完全忽略其他不相关的单词。Softmax 产生的微弱概率可以看作是“噪声”。
为了解决这个问题,Sparsemax 函数被提出,它的目标是产生一个稀疏的概率分布,即将一部分元素的概率直接置为 0。Sparsemax 对 logits 向量进行一个欧几里得投影,这个投影过程会找到一个分布使得它与 logits 的欧氏距离最小。输出一个概率分布中,其中一部分概率严格大于 0,另一部分严格等于 0,这实现了“聚焦”机制。
Entmax 的核心贡献是将 Softmax 和 Sparsemax 统一到了一个函数家族中,并通过一个参数 α(alpha)来控制稀疏程度。Entmax 函数的通用形式由以下优化问题定义:
其中相关的符号含义如下:
| 符号 | 含义 |
|---|---|
| \(\mathbf{z}\) | 输入 logits 向量 |
| \(\Delta^{d-1}\) | 概率单纯形 |
| \(H_\alpha^\mathrm{Tsallis}\) | Tsallis α-熵 |
对于 α 参数,它的几种取值的含义为:
- 当 α = 1 时,Tsallis 熵退化为香农熵,此时的 Entmax 就是标准的 Softmax 函数。
- 当 α = 2 时,Entmax 变成 Sparsemax 函数,输出是稀疏的。
- 当 α > 1 时,随着 α 的增大,输出的稀疏性会增强(更多的值变为 0)。
- 当 α < 1 时,理论上会产生“稀疏性”,但概率可能为负,不符合分布要求,所以通常只关注 α ≥ 1 的情况。
Entmax 函数具有以下一些有点:
- 能够使模型不需要依赖外部设计的启发式方法,使其根据数据自适应学习稀疏模式;
- 在注意力机制中应用 Entmax(替换 Softmax)后,得到的注意力权重图会非常稀疏,实现提高可解释性;
- 在一些任务中,特别是需要模型做出“硬决策”的任务上(如文本生成、关系抽取),强制模型聚焦于关键信息可以带来性能的提升;
- 权重为 0 的部分在后续计算中可以跳过,能够提升计算效率。
本文方法
可微分 ODT
本文提出的 NODE 模型的核心是一个 NODE 层,该层由 \(m\) 棵具有相同深度 \(d\) 的可微分 ODT 构成。为了使传统 ODT 可微,使其可以通过反向传播进行端到端优化,论文实现了软特征选择。

该操作通过一个可学习的特征选择矩阵 \(\mathbf{F} \in \mathbb{R}^{d \times n}\),利用 \(\alpha\)-entmax 变换计算一个加权和来软化特征选择过程:
entmax 的优势在于它能学习到稀疏的选择,模拟决策树只依赖少数关键特征的行为,比 softmax 和 Gumbel-Softmax 更适合。接着实现软决策路由,将硬性阶跃函数 \(\mathbb{1}(f_i(\mathbf{x}) - b_i)\) 松弛为两类 entmax 函数,记为:
考虑到不同特征尺度不同,作者使用了带缩放参数的版本。其中 \(b_i\) 和 \(\tau_i\) 是可学习的阈值和尺度参数。
接着构建选择张量与最终预测。基于 \(c_i(\mathbf{x})\) 值,计算一个与响应张量 \(\mathbf{R}\) 尺寸相同的选择张量 \(\mathbf{C}(\mathbf{x})\),其形状为 \(\underbrace{2\times 2\times \ldots \times 2}_{d}\):
可微分 ODT 的最终预测输出 \(\hat{h}(\mathbf{x})\) 是响应张量条目与选择张量权重的加权线性组合:
当特征选择和阈值决策都达到独热状态,即 entmax 仅对单一特征返回非零权重,且 \(c_i\) 恰好返回 0 或 1 时,此松弛的模型就退化为非可微分 ODT \(h(\mathbf{x})\)。整个 NODE 层的输出是其中所有 \(m\) 棵可微分 ODT 输出的拼接:
对于分类问题,单棵树的输出可以扩展为多维向量 \(\hat{h}(\mathbf{x}) \in \mathbb{R}^{|C|}\)(\(|C|\) 为类别数),以直接预测各类别的概率。
更深层的 NODE
构建深层架构的设计灵感来源于DenseNet。此时模型由 \(k\) 个 NODE 层顺序堆叠而成,每个 NODE 层的输入是其之前所有层输出特征的拼接。模型的第一层(输入层)对应原始的输入特征 \(\mathbf{x}\),并且这些原始特征也被提供给其后的每一层。类似 DenseNet 的连接方式使 NODE 能够学习浅层和深层的决策规则:位于第 \(i\) 层的单个决策树将其前面 \(i-1\) 层的输出作为特征,从而捕捉更复杂的依赖关系。

模型的最终预测结果是所有层中所有决策树输出值的简单平均。在多层架构中,前置 NODE 层的输出 \(\hat{h}(\mathbf{x})\) 会被用作后续层的输入,因此 \(\hat{h}(\mathbf{x})\) 的维度不必须等于类别数量。作者允许 \(\hat{h}(\mathbf{x})\) 具有一个任意的输出维度 \(l\),这意味着每棵树的响应张量 \(\mathbf{R}\) 的维度变为 \(\mathbb{R}^{\underbrace{2\times 2\times \ldots \times 2}_{d} \times l}\)。\(l\) 是一个新的超参数,其典型取值范围是 [1, 3]。在进行最终预测时:
- 分类问题:只使用 \(\hat{h}(\mathbf{x})\) 向量的前 \(|C|\) 个坐标,\(|C|\) 为类别数。
- 回归问题:只使用第一个坐标。
NODE 训练
为了确保训练的稳定性和更快的收敛,作者在训练前对所有数据特征应用了分位数变换,以将它们转换为服从正态分布。接着采用了一种数据感知的初始化策略以获得良好的初始参数值:
| 参数 | 符号 | 初始化方法 |
|---|---|---|
| 特征选择矩阵 | \(\mathbf{F}\) | 初始化为均匀分布 \(\mathbf{F}_{ij} \sim U(0,1)\)。 |
| 阈值 | \(\mathbf{b}\) | 从第一个训练数据批次中观察到的随机特征值 \(f_i(\mathbf{x})\) 进行初始化。 |
| 尺度 | \(\tau_i\) | 令第一个批次中的所有样本都位于 \(\sigma_{\alpha}\) 函数的线性区域内,从而确保所有样本都能获得非零梯度。 |
| 响应张量 | \(\mathbf{R}\) | 其条目以标准正态分布进行初始化 \(\mathbf{R}[i_1,\ldots,i_d] \sim N(0,1)\)。 |
NODE 架构与现有 DNN 类似,通过小批量随机梯度下降进行端到端训练。NODE 同时优化所有模型参数,包括特征选择矩阵 \(\mathbf{F}\)、阈值 \(\mathbf{b}\)、尺度 \(\mathbf{\tau}\) 和响应张量 \(\mathbf{R}\)。论文中作者使用了传统的目标函数,分类问题使用交叉熵损失,回归和排序任务使用均方误差,优化器使用了准双曲 Adam 优化器。采用模型参数平均策略,对连续的 \(c=5\) 个检查点进行平均,以获得更稳健的模型。在独立的验证集上选择最佳停止点,以防止过拟合。
在训练期间,相当一部分时间用于计算 entmax 函数和选择张量的乘法。模型训练完成后,可以预计算 entmax 特征选择器的输出,并将其存储为稀疏向量。这种优化可以显著提高推理速度,使其在效率上足以与高度优化的 GBDT 库相媲美。
实验结果
数据集和实验设置
本文在 6 个公开的表格数据集上进行了实验,包括:Epsilon, YearPrediction, Higgs, Microsoft, Yahoo, Click。这些数据集涵盖分类、回归和排序任务,所有数据集均已划分好训练/测试集,并从训练集中额外划分 20% 作为验证集用于调参。比较方法包括 CatBoost、XGBoost、FCNN,其中 FCNN 为由若干全连接层和 ReLU 激活函数组成的深度神经网络。比较模式分为两种:
- 默认超参数:NODE 使用与 CatBoost 类似的默认设置,即单层、2048 棵深度为 6 的树。
- 调优超参数:在验证集上对所有方法进行超参数调优,NODE 的最佳配置包含 2~8 个 NODE 层,总树数不超过 2048。
对比实验结果
在默认超参数下,NODE 在所有 6 个数据集上均优于 CatBoost 和 XGBoost,这表明 NODE 可以作为一个方可用的表格数据模型。

在调优超参数下,NODE 在大部分任务上仍然优于竞争对手,但在 Yahoo 和 Microsoft 两个数据集上,调优后的 XGBoost 表现最佳。这可能意味着遗忘决策树的归纳偏置不适用于 Yahoo 数据集。FCNN 在部分数据集上表现优于 GBDT,但是性能不稳定,而 NODE 则表现出了更强的稳定性。论文还尝试与多层非可微架构(如 mGBDT 和 DeepForest)进行了比较,但这些方法要么代码不可用,要么存在扩展性问题(易导致内存溢出)。在可用数据集上,调优后的 GBDT 通常优于它们。

消融实验
本节分析决定 NODE 模型性能的架构组件,首先论文对比了四种选择函数:
| 选择函数 | 说明 |
|---|---|
| Softmax | 学习稠密的决策规则,所有权重非零。 |
| Gumbel-Softmax | 学习随机采样单个元素。 |
| Sparsemax | 学习稀疏的决策规则,仅少量权重非零。 |
| Entmax | Sparsemax 和 Softmax 的推广,能学习稀疏规则,且比 Sparsemax 更平滑。 |
结果显示 Entmax(\(\alpha=1.5\))的表现均优于其他选择函数,Gumbel-Softmax由于随机性,无法学习深层架构。

特征重要性分析
通过排列特征重要性分析发现,早期层(第一层)的特征被使用得最频繁,特征重要性随深度增加而降低。然而,从树对最终预测的平均绝对贡献来看,深层树的贡献更大。这种反相关关系表明:早期层的主要作用是产生信息丰富的特征,而深层树则主要利用这些特征进行更精确的预测。

运行时间
在 YearPrediction 数据集上比较了运行时间,使用 8 层 NODE 的训练和推理时间与拥有相同总树数的浅层模型(XGBoost, CatBoost)相当。尽管 NODE 是在纯 PyTorch 中实现(无自定义内核),但其效率仍可与高度优化的 GBDT 库相媲美。

优点和创新点
个人认为,本文有如下一些优点和创新点可供参考学习:
- NODE 将 ODT 泛化为可微的形式,实现了类似 GBDT 的深度结构,并能通过反向传播进行端到端梯度优化。
- 本文采用 α-entmax 变换来软化特征选择和决策路由,使其既能学习稀疏决策规则(模拟传统决策树),又比 Gumbel-Softmax、Sparsemax 等方法更平滑、稳定。
- 基于 DenseNet 思想构建多层结构,每层输入是之前所有层输出的拼接,使得模型能学习复杂的特征依赖(浅层生成特征,深层利用特征预测)。

 浙公网安备 33010602011771号