
k8s 通过kafka operator部署kafka集群 4.x版本
注意:如果在一个k8s集群用operator部署了多个kafka集群,想删除一个kafka集群,不能kc delete -f strimzi-install.yaml,否则会删除k8s所有的
用operator部署的kafka集群
使用的operator是strimzi,官方文档:https://strimzi.io/quickstarts/
1、应用 Strimzi 安装文件,包括 `<Strimzi-install-files>`ClusterRoles和ClusterRoleBindings一些自定义资源定义( CRD)。CRD 定义了用于自定义资源(例如` CRDs<Cafka-container-class>` 等)的模式,这些资源将用于管理 Kafka 集群、主题和用户。
kubectl create -f 'https://strimzi.io/install/latest?namespace=kafka-2' -n kafka-2
配置节点亲和性和容忍让operator部署在特定节点组的机器(可选)
wget -O strimzi-install.yaml 'https://strimzi.io/install/latest?namespace=kafka-2'
大概在24785行,搜索Deployment比较准确
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: strimzi-cluster-operator
  labels:
    app: strimzi
  namespace: kafka-2
spec:
  replicas: 1
  selector:
    matchLabels:
      name: strimzi-cluster-operator
      strimzi.io/kind: cluster-operator
  template:
    metadata:
      labels:
        name: strimzi-cluster-operator
        strimzi.io/kind: cluster-operator
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              # 使用正确的标签键
              - key: eks.amazonaws.com/nodegroup
                operator: In
                values:
                - EKS-Prod-StatefulSet-1V31
      # 在这里添加 tolerations
      tolerations:
      - key: "app"
        operator: "Equal"
        value: "statefulset"
        effect: "NoSchedule"
      serviceAccountName: strimzi-cluster-operator
2、查看操作员的日志
kubectl logs deployment/strimzi-cluster-operator -n kafka -f
3、创建一个新的 Kafka 自定义资源,以获取 Apache Kafka 集群
vim kafka-cluster.yaml
pod亲和性和容忍自行添加(可选)
apiVersion: kafka.strimzi.io/v1
kind: KafkaNodePool
metadata:
  name: kafka
  namespace: kafka-2
  labels:
    strimzi.io/cluster: mq
spec:
  replicas: 3
  roles:
    - controller
    - broker
  storage:
    type: jbod
    volumes:
      - id: 0
        type: persistent-claim
        size: 100Gi
        deleteClaim: false
        kraftMetadata: shared
        class: gp3-us-west-2b
  resources:
    requests:
      cpu: "300m"
      memory: "1Gi"
    limits:
      cpu: "1000m"
      memory: "2Gi"
  template:
    pod:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: eks.amazonaws.com/nodegroup
                operator: In
                values:
                - EKS-Prod-Kafka-Logging
      tolerations:
      - key: "app"
        operator: "Equal"
        value: "kafka"
        effect: "NoSchedule"
---
apiVersion: kafka.strimzi.io/v1
kind: Kafka
metadata:
  name: mq
  namespace: kafka-2
spec:
  kafka:
    version: 4.1.1
    metadataVersion: 4.1-IV1
    listeners:
      - name: plain
        port: 9092
        type: internal
        tls: false
      - name: tls
        port: 9093
        type: internal
        tls: true
      - name: external
        port: 9094
        type: loadbalancer
        tls: false
        configuration:
          bootstrap:
            annotations: &aws-nlb
              service.beta.kubernetes.io/aws-load-balancer-type: "nlb"
              service.beta.kubernetes.io/aws-load-balancer-scheme: "internal"
              service.beta.kubernetes.io/aws-load-balancer-cross-zone-load-balancing-enabled: "true"
          brokers:
            - broker: 0
              annotations: *aws-nlb
            - broker: 1
              annotations: *aws-nlb
            - broker: 2
              annotations: *aws-nlb
    config:
      auto.create.topics.enable: false            # 关闭自动创建主题
      offsets.topic.replication.factor: 2         # 消费者位移(offset)存储主题 `__consumer_offsets` 的**副本数**
      transaction.state.log.replication.factor: 2     #事务状态主题 `__transaction_state` 的副本数
      transaction.state.log.min.isr: 2           # 事务主题的最小同步副本数,代表:写入事务数据时,**至少要有 2 个副本确认写入成功才算成功**,保证事务元数据不丢
      default.replication.factor: 3                # 新建主题默认副本因子
      num.partitions: 5                            # 新建topic默认分区数
      min.insync.replicas: 2                        # Topic 层面最小同步副本数,配合生产者 `acks=all` 使用。含义:生产者设置 `acks=all` 时,写入成功条件:**至少 2 个副本写完**。
      log.retention.hours: 8                       # 消息保留时长:Broker 上的消息最多保留 **8 小时**,超过 8 小时旧消息自动删除。
      log.segment.bytes: 1073741824       # Kafka 不会一直往一个文件写日志;每个日志段文件最大到 1GB,就关闭当前文件,新建下一个 segment 文件
      message.max.bytes: 69206016         # 66MB ,64MB 消息本身 + Kafka 协议头部开销,多留出 2MB‑4MB 余量, Broker 允许接收**单条消息最大字节大小**
      replica.fetch.max.bytes: 73400320   # 70MB 副本同步的时候,follower broker 一次从 leader 最多拉取多少字节数据。值必须 **>= message.max.bytes**,否则副本同步大消息失败
      fetch.max.bytes: 75497472          #  **`72MB`**普通消费者一次 fetch 请求,broker 返回给消费者最大总字节数
      # 可选:确保外部listener的通告地址正确(Strimzi会自动生成,此配置可省略)
      advertised.listeners: "#{KAFKA_ADVERTISED_LISTENERS}"
  entityOperator:
    topicOperator: {}
    userOperator: {}
    # 修正:使用正确的template语法
    template:
      pod:
        # 修正:在entityOperator的template下直接配置
        metadata:
          labels:
            eks.amazonaws.com/nodegroup: EKS-Prod-Kafka-Logging
        # 修正:这里可能需要使用affinity而不是nodeSelector
        affinity:
          nodeAffinity:
            requiredDuringSchedulingIgnoredDuringExecution:
              nodeSelectorTerms:
              - matchExpressions:
                - key: eks.amazonaws.com/nodegroup
                  operator: In
                  values:
                  - EKS-Prod-Kafka-Logging
        tolerations:
          - key: "app"
            operator: "Equal"
            value: "kafka"
            effect: "NoSchedule"
      # 为deployment配置
      deployment:
        metadata:
          labels:
            eks.amazonaws.com/nodegroup: EKS-Prod-Kafka-Logging
提供外部访问和ip白名单(可选)
让 3 个 Kafka broker 强制分散在 3 台不同 EC2 节点(可选)
apiVersion: kafka.strimzi.io/v1
kind: KafkaNodePool
metadata:
  name: kafka
  namespace: kafka-2
  labels:
    strimzi.io/cluster: mq
spec:
  replicas: 3
  roles:
    - controller
    - broker
  storage:
    type: jbod
    volumes:
      - id: 0
        type: persistent-claim
        size: 100Gi
        deleteClaim: false
        kraftMetadata: shared
        class: gp3-us-west-2c
  resources:
    requests:
      cpu: "300m"
      memory: "1Gi"
  template:
    pod:
      affinity:
        # 新增:Pod 反亲和性,强制 broker 分散在不同节点
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: strimzi.io/cluster
                operator: In
                values:
                - mq
            topologyKey: kubernetes.io/hostname
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: eks.amazonaws.com/nodegroup
                operator: In
                values:
                - EKS-Prod-Kafka-Logging
      tolerations:
      - key: "app"
        operator: "Equal"
        value: "kafka"
        effect: "NoSchedule"
---
apiVersion: kafka.strimzi.io/v1
kind: Kafka
metadata:
  name: mq
  namespace: kafka-2
spec:
  kafka:
    version: 4.1.1
    metadataVersion: 4.1-IV1
    listeners:
      - name: plain
        port: 9092
        type: internal
        tls: false
      - name: tls
        port: 9093
        type: internal
        tls: true
      # 新增外部NodePort listener(核心修改)
      - name: external
        port: 9094  # 容器内独立端口,避免和内部9092冲突
        type: nodeport
        tls: false
        configuration:
          # service.beta.kubernetes.io/aws-load-balancer-scheme: "internet-facing" 外网类型,内网类型是internal
          # 白名单:写在 configuration 这一层(不是 bootstrap/brokers 下)
          loadBalancerSourceRanges:
            - 44.225.239.134/32
            - 47.77.191.101/32
            - 100.20.188.187/32
          bootstrap:
            annotations:
              service.beta.kubernetes.io/aws-load-balancer-type: "nlb"
              service.beta.kubernetes.io/aws-load-balancer-scheme: "internet-facing"
              service.beta.kubernetes.io/aws-load-balancer-cross-zone-load-balancing-enabled: "true"
            nodePort: 32518
          brokers:
            - broker: 0
              nodePort: 32519
              annotations:
                service.beta.kubernetes.io/aws-load-balancer-type: "nlb"
                service.beta.kubernetes.io/aws-load-balancer-scheme: "internet-facing"
                service.beta.kubernetes.io/aws-load-balancer-cross-zone-load-balancing-enabled: "true"
            - broker: 1
              nodePort: 32520
              annotations:
                service.beta.kubernetes.io/aws-load-balancer-type: "nlb"
                service.beta.kubernetes.io/aws-load-balancer-scheme: "internet-facing"
                service.beta.kubernetes.io/aws-load-balancer-cross-zone-load-balancing-enabled: "true"
            - broker: 2
              nodePort: 32521
              annotations:
                service.beta.kubernetes.io/aws-load-balancer-type: "nlb"
                service.beta.kubernetes.io/aws-load-balancer-scheme: "internet-facing"
                service.beta.kubernetes.io/aws-load-balancer-cross-zone-load-balancing-enabled: "true"
    config:
      auto.create.topics.enable: false            # 关闭自动创建主题
      offsets.topic.replication.factor: 2         # 消费者位移(offset)存储主题 `__consumer_offsets` 的**副本数**
      transaction.state.log.replication.factor: 2     #事务状态主题 `__transaction_state` 的副本数
      transaction.state.log.min.isr: 2           # 事务主题的最小同步副本数,代表:写入事务数据时,**至少要有 2 个副本确认写入成功才算成功**,保证事务元数据不丢
      default.replication.factor: 3                # 新建主题默认副本因子
      num.partitions: 5                            # 新建topic默认分区数
      min.insync.replicas: 2                        # Topic 层面最小同步副本数,配合生产者 `acks=all` 使用。含义:生产者设置 `acks=all` 时,写入成功条件:**至少 2 个副本写完**。
      log.retention.hours: 8                       # 消息保留时长:Broker 上的消息最多保留 **8 小时**,超过 8 小时旧消息自动删除。
      log.segment.bytes: 1073741824       # Kafka 不会一直往一个文件写日志;每个日志段文件最大到 1GB,就关闭当前文件,新建下一个 segment 文件
      message.max.bytes: 69206016         # 66MB ,64MB 消息本身 + Kafka 协议头部开销,多留出 2MB‑4MB 余量, Broker 允许接收**单条消息最大字节大小**
      replica.fetch.max.bytes: 73400320   # 70MB 副本同步的时候,follower broker 一次从 leader 最多拉取多少字节数据。值必须 **>= message.max.bytes**,否则副本同步大消息失败
      fetch.max.bytes: 75497472          #  **`72MB`**普通消费者一次 fetch 请求,broker 返回给消费者最大总字节数
      # 可选:确保外部listener的通告地址正确(Strimzi会自动生成,此配置可省略)
      advertised.listeners: "#{KAFKA_ADVERTISED_LISTENERS}"
  entityOperator:
    topicOperator: {}
    userOperator: {}
    # 修正:使用正确的template语法
    template:
      pod:
        # 修正:在entityOperator的template下直接配置
        metadata:
          labels:
            eks.amazonaws.com/nodegroup: EKS-Prod-Kafka-Logging
        # 修正:这里可能需要使用affinity而不是nodeSelector
        affinity:
          nodeAffinity:
            requiredDuringSchedulingIgnoredDuringExecution:
              nodeSelectorTerms:
              - matchExpressions:
                - key: eks.amazonaws.com/nodegroup
                  operator: In
                  values:
                  - EKS-Prod-Kafka-Logging
        tolerations:
          - key: "app"
            operator: "Equal"
            value: "kafka"
            effect: "NoSchedule"
      # 为deployment配置
      deployment:
        metadata:
          labels:
            eks.amazonaws.com/nodegroup: EKS-Prod-Kafka-Logging
kc apply -f kafka-single-node.yaml
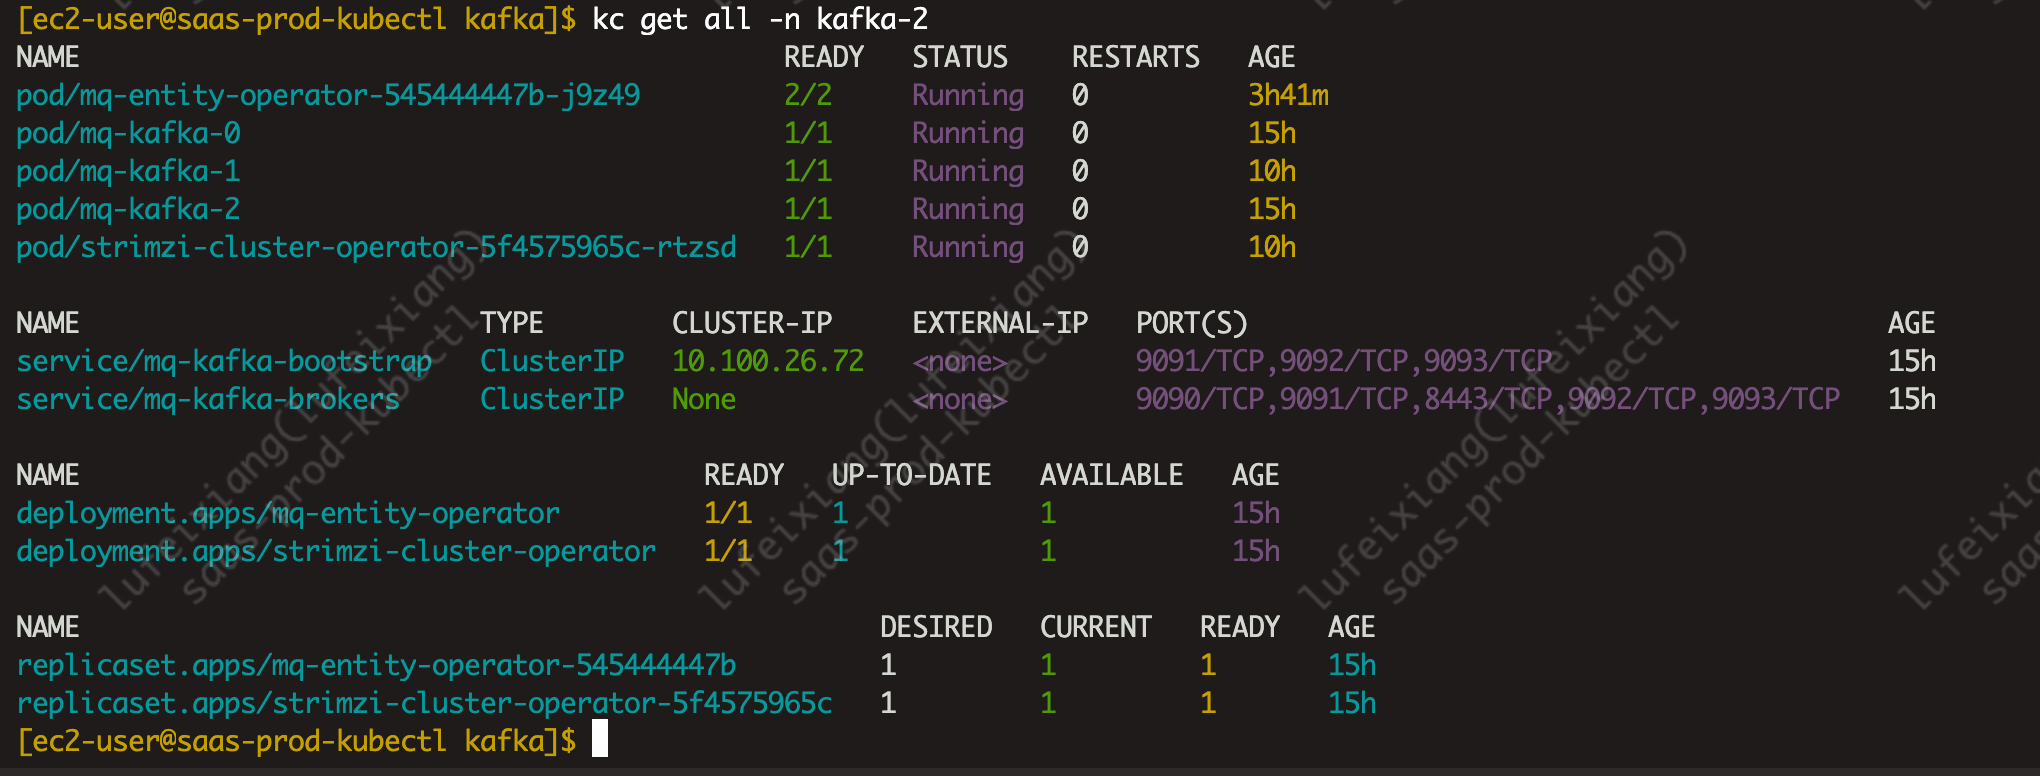
4、查看pod运行状态

 浙公网安备 33010602011771号