
BS4爬取豆瓣电影
爬取豆瓣top250部电影
创建表:
connect.py
from sqlalchemy import create_engine
# HOSTNAME='localhost'
# PORT='3306'
# USERNAME='root'
# PASSWORD='123456'
# DATABASE='douban'
db_url='mysql+pymysql://root:123456@localhost:3306/douban?charset=utf8'
engine=create_engine(db_url)
#创建映像
from sqlalchemy.ext.declarative import declarative_base
Base=declarative_base(engine)
创建会话
from sqlalchemy.orm import sessionmaker
Session=sessionmaker(engine)
session=Session()
##################创建表
from sqlalchemy import Column,String,Integer,DateTime
from datetime import datetime
class Douban(Base):
tablename='douban'
id=Column(Integer,primary_key=True,autoincrement=True)
name=Column(String(50))
author=Column(String(100),nullable=True)
actor=Column(String(100))
time=Column(String(50))
country=Column(String(100))
type=Column(String(100))
createtime=Column(DateTime,default=datetime.now)
def repr(self):
return '<Douban(id=%s,name=%s,author=%s,actor=%s,time=%s,country=%s,type=%s,createtime=%s)>'%(
self.id,
self.name,
self.author,
self.actor,
self.time,
self.country,
self.type,
self.creatime
)
if name=='main':
Base.metadata.create_all()
# user=Douban()
# user.type='你好'
# user.country='你'
# user.author='666'
# user.actor='你好啊'
# session.add(user)
# session.commit()
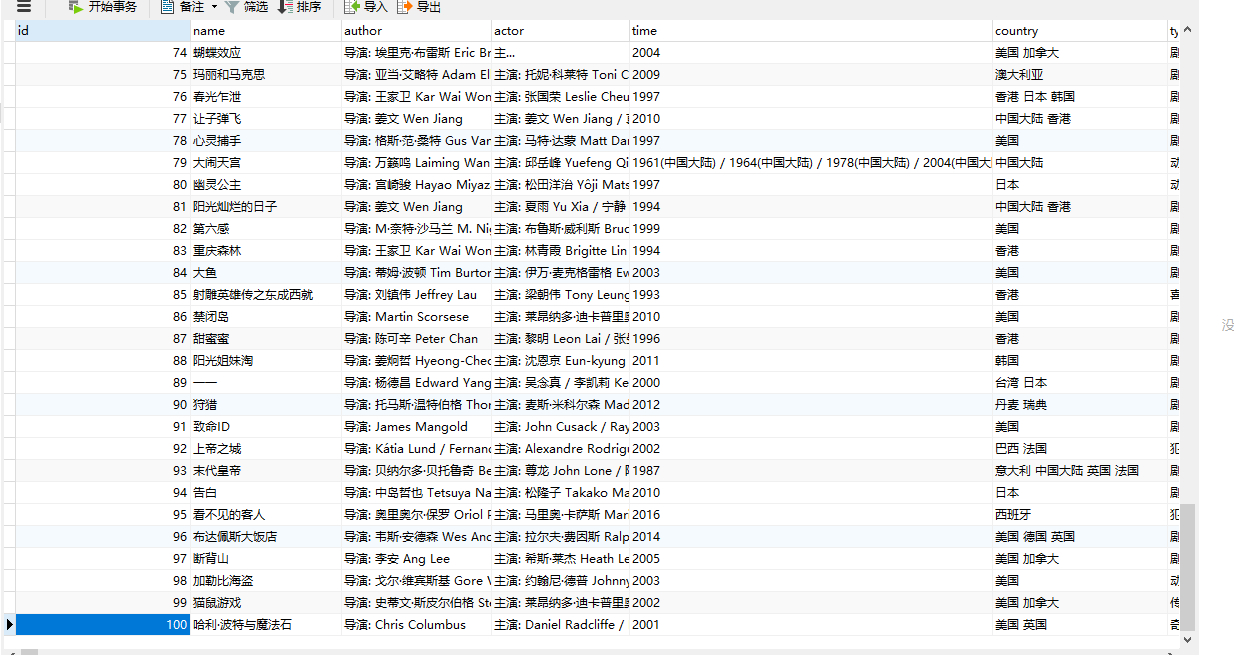
爬取数据并保存到数据库:
douban.py
import requests,re
from bs4 import BeautifulSoup
import time,datetime
import pymysql
conn=pymysql.connect(host='127.0.0.1',user='root',passwd='123456',db='mysql',charset='utf8')
cur=conn.cursor()
cur.execute('use douban;')
cur.execute("insert into douban.douban(author,actor,country) VALUES('aa','bb','bb')")
conn.commit()
导入sqlalchemy
from connect import Douban,session
headers={'Referer':'https://movie.douban.com/explore',
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; '
'WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}
def get_html(x):
num = 0
for n in range(x+1):
url='https://movie.douban.com/top250?start=%s&filter='%(n*25)
html=requests.get(url,headers=headers).text
soup=BeautifulSoup(html,'lxml')
# print(type(soup))
content_all=soup.select('div[class="item"]')
for m in content_all:
num+=1
title=m.select('span[class="title"]')[0].string
print(title)
content=m.select('div[class="bd"] > p[class=""]')[0]
返回字符串迭代器
text=content.stripped_strings
li = []
for i in text:
i=str(i)
# print(i)
li.append(i)
print(li)
#获取演员和国家列表
author_list=li[0].split('\xa0\xa0\xa0')
country_list=li[1].split('\xa0/\xa0')
# print(author_list)
# print(country_list)
从列表取出数据
author=author_list[0]
actor=author_list[1]
time=country_list[0]
country=country_list[1]
type=country_list[2]
print(author)
print(actor)
print(time)
print(country,type+'\n\n')
print('总共获取%s' % num)
第一种插入方式特别注意,此处用单双引号来区分内容,且%s要加引号,否则会报错
sql="insert into douban(name,author,actor,time,country,type) VALUES('%s','%s','%s','%s','%s','%s')"%(
title,
author,
actor,
time,
country,
type
)
cur.execute(sql)
conn.commit()
第二种插入方法,使用sqlalchemy插入
data=Douban(name=title,
author=author,
actor=actor,
#字符串格式需转换成日期格式
time=time,
# time=datetime.strptime(time,'%Y')
country=country,
type=type,
)
session.add(data)
session.commit()
if name=='main':
x=input('输入数字:')
x=int(x)
get_html(x)
# conn.close()

 浙公网安备 33010602011771号