
HIT-机器学习 | 从一条带噪声的正弦曲线开始,我第一次让模型自己找边界
机器学习实验是我第一次明显感觉到,模型并不会因为公式写对了就自动给出漂亮结果。数据有噪声,特征有尺度,类别可能不平衡,模型也可能在训练集上很自信、换到测试集就开始犹豫。
这个仓库里的四个实验,从多项式拟合正弦曲线,到逻辑回归、K-means/EM,再到 PCA 和图像重建。它们没有大模型,也没有复杂框架,却把机器学习里最基础、也最容易被忽略的几件事都摆到了我面前:目标函数、优化、泛化、聚类和降维。
仓库地址:HIT-Machine-Learning-Labs。
实验一:一条带噪声的 sin(x),先学会拟合而不是背公式
第一组实验用多项式去拟合带噪声的正弦曲线,比较 OLS、岭回归、梯度下降和共轭梯度。刚开始我只觉得这是在画一条更接近数据的曲线,后来才意识到,不同方法其实在回答不同的优化问题。
阶数太低,模型表达能力不够;阶数太高,曲线可能开始追着噪声上下摆。正规方程写起来直接,但高阶时矩阵条件和求逆稳定性会变差。梯度下降更像是在山谷里一步步走,学习率太小很慢,太大又可能来回跳。
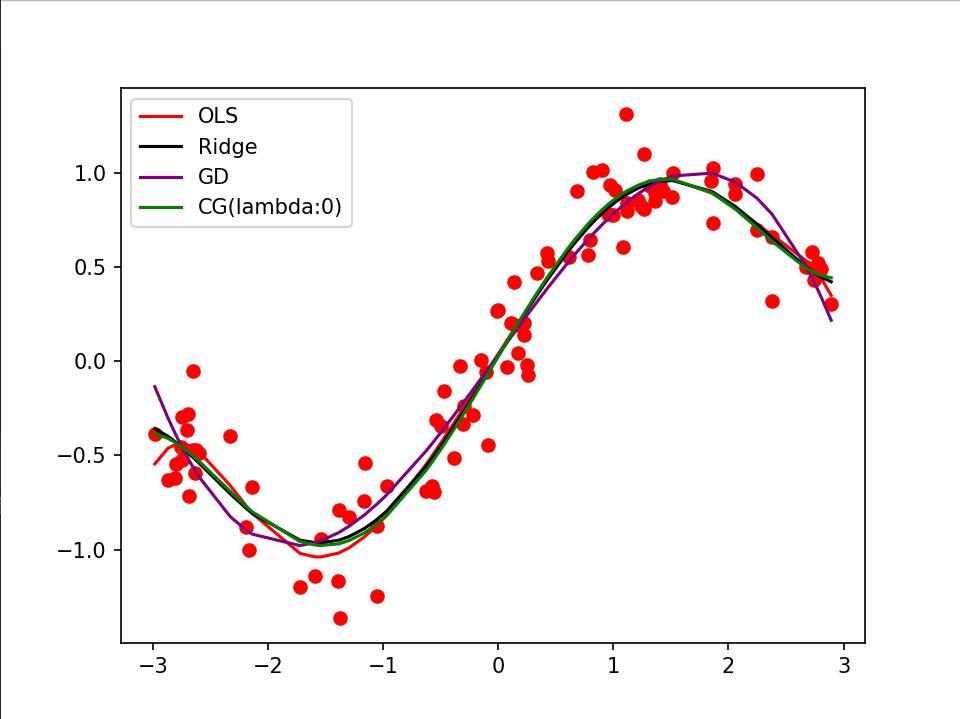
这次实验给我的第一个感觉是:拟合得像,不等于学得好。曲线贴着训练数据并不自动意味着它能解释新的数据。
实验二:逻辑回归,模型怎样画出一条决策边界
逻辑回归实验从连续输出走到二分类。模型先把线性组合送进 sigmoid,再通过损失函数和梯度下降调整参数。输入是样本特征,输出却不再是一个连续数,而是对两个类别的判断。
实验里比较了高斯数据、Skin Segmentation 和 Haberman Survival 等数据。不同数据集的特征尺度和分布差异很大,模型不能只靠一套直觉工作。报告里的结果也很有代表性:有的数据几乎能被一条边界分开,有的数据本身就更难。
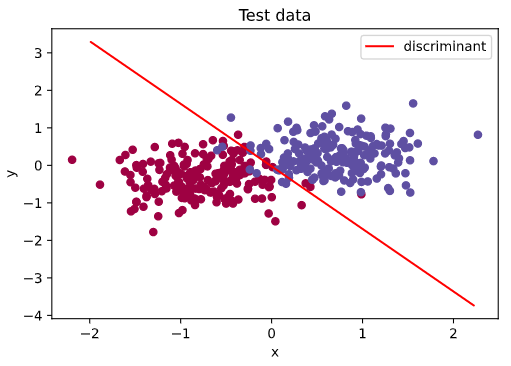
我最容易犯的错是只看训练准确率。后来开始同时看测试准确率和迭代次数,才发现模型表现和训练过程需要一起理解。L2 惩罚也不只是一个参数,它是在提醒模型不要为了训练数据把边界画得过分极端。
实验三:K-means 和 EM,聚类时没有人告诉模型答案
分类问题至少有标签,聚类没有。K-means 需要自己反复分配样本、更新中心,直到结果逐渐稳定。它的过程很直观:离哪个中心近,就先归到哪个簇;然后再根据簇里的样本重新计算中心。
但初始中心不同,结果可能不同;簇的形状不合适时,K-means 也会把数据切得很勉强。实验里还保留了 GMM/EM 的辅助思路,让我看到硬分配和概率分配之间的区别。
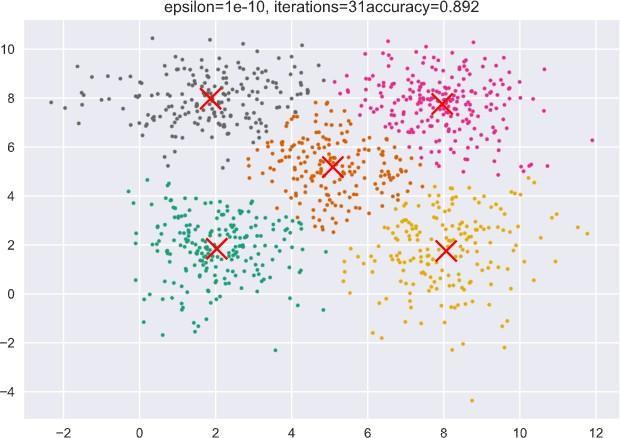
做这个实验时,我开始理解为什么聚类结果不能只看一张彩色图。图上分得好看,不代表模型真的找到了稳定结构;初始值、距离度量和数据分布都可能影响最终结果。
实验四:PCA,降维以后还能不能把重要信息带回来
PCA 实验通过特征分解寻找主要方向,再把数据投影到低维空间。它的直觉很像把一团散乱的点旋转到一个更适合观察的角度,保留变化最大的方向,舍弃相对次要的方向。
我第一次做图像重建时,最关心的是少几个维度以后图像会不会完全认不出来。结果发现,维度降低会损失细节,但主要轮廓仍然可能保留下来。降维不是无损压缩,它是在表示成本和信息保留之间做取舍。
四个实验连起来,机器学习开始变得具体
多项式拟合让我看到模型复杂度和噪声之间的拉扯;逻辑回归让我看到优化如何产生分类边界;K-means/EM 让我面对没有标签的数据;PCA 则让我开始考虑怎样用更少的维度保留主要结构。
这些实验没有让我马上掌握机器学习,但它们改变了我看结果的方式。以后看到一个准确率或一条曲线,我会多问几句:数据怎么来的?训练和测试有没有分开?参数是否影响了结论?结果是模型能力,还是某种数据特征带来的偶然优势?
现在回头看,最值得留下的是那些“不稳定”
这个仓库里的随机实验没有统一固定种子,正规方程在高阶时可能不稳定,sigmoid 和 loss 对极端值的保护也不够完整。它们不是现代机器学习项目里的最佳实践,却很真实地记录了我当时第一次碰到这些问题的过程。
如果重新做,我会补更系统的数据预处理、随机种子、交叉验证和数值稳定性保护。但我不想把这些历史痕迹全部擦掉,因为学习机器学习的过程本来就不是从完美代码开始的。
仓库地址:HIT-Machine-Learning-Labs。
说明:本文根据个人历史课程实验和公开仓库整理,部分文字经过 AI 辅助润色;实验指标和图片属于历史记录。课程资料仅用于学习回顾和个人作品整理,不用于当前课程作业或考试。

 浙公网安备 33010602011771号