
HIT-人工智能导论 | 从“猴子摘香蕉”到 LeNet,我第一次把规则和训练放在一起
我第一次接触这门课时,对“人工智能实验”的想象其实很朴素:写一段程序,让它把题目做出来,然后看见一个正确答案。真正做完这组实验以后,我才发现,人工智能至少有两种完全不同的味道。
第一种是把问题表示清楚,再用规则一步步推理;第二种是把数据交给模型,让它从样本里自己找规律。这个仓库里的两个实验刚好站在这条分界线的两边:实验一是猴子摘香蕉,实验二是 MindSpore、LeNet-5 和 MNIST。一个像在搭积木,一个像在等一条曲线慢慢往下走。
仓库地址:KALEsky/HIT-Introduction-to-AI-Labs。这是本科阶段的历史课程实验整理,里面保留了源码、训练脚本、结果图和相关课程资料,MNIST 数据和训练 checkpoint 没有直接放进仓库。
实验一:猴子摘香蕉,先把“想要什么”说清楚
猴子摘香蕉这个问题现在看起来有点可爱,但它很适合用来理解早期人工智能里的问题表示。猴子站在哪里,箱子在哪里,香蕉挂在哪里,猴子手里有没有箱子,这些都不能只存在于人的脑子里,必须被程序明确写成状态。
我一开始觉得这个问题应该很简单:猴子走过去,推箱子,爬上去,摘香蕉。可一旦开始写代码,就会发现每个动作都有前提。猴子不在箱子旁边,就不能推;箱子没有到合适位置,就不能爬;猴子没有站到箱子上,就不可能够到香蕉。
所以这个实验真正的重点不是“猴子”或者“香蕉”,而是把世界拆成一组可以判断的状态,再为状态之间的变化写出规则。每一条规则都像一个小门:条件满足,动作才能通过;条件不满足,程序就必须换一条路继续试。
当时我还没有很强的搜索算法直觉,写着写着经常会把动作顺序和状态更新混在一起。后来我把问题拆成了几类信息:当前位置、箱子位置、是否已经拿到目标。这样一来,程序不再是一串写死的动作,而更像是在状态空间里寻找一条能够到达目标的路径。
这个实验带给我的第一个人工智能经验很朴素:所谓“智能”,有时不是程序知道很多,而是我们有没有把问题描述得足够清楚。如果状态表示含糊,后面再聪明的搜索也没有用。
从规则走到训练:同一门课里,思路突然换了
做完猴子摘香蕉以后,我已经习惯了给每一个动作写条件。到了 LeNet 实验,思路突然变了:不再告诉程序“看到什么就做什么”,而是给它很多带标签的数字图片,让模型自己调整参数。
这种变化刚开始让我有点不适应。规则推理的过程是可以跟踪的,哪一步不对,通常能找到是哪条规则出了问题;神经网络训练则像在雾里走路,刚开始准确率很低,loss 会上下波动,你只能根据曲线、参数和数据处理方式猜模型到底有没有学到东西。
实验二:从一张 28×28 的数字图片开始
MNIST 的图片并不大,每张图都是手写数字。可在真正送进网络之前,仍然要处理尺寸、批次、标签和数据格式。仓库里的实验把输入整理成适配 LeNet 全连接层的尺寸,训练过程使用 Momentum 优化器,并通过 checkpoint 保存训练状态。
这些步骤看起来像准备工作,却经常决定实验能不能正常开始。数据尺寸对不上,模型在第一层就会报错;标签格式不对,loss 可能完全不合理;训练脚本能启动,也不代表模型真的收到了正确的数据。
我第一次看到训练日志里 loss 逐渐下降时,感觉和猴子摘香蕉完全不一样。前一个实验是我告诉程序下一步做什么;这一次则是模型在很多次参数更新以后,慢慢变得更会区分数字。那种变化不容易用一两行代码解释,但曲线会把它记录下来。
LeNet-5:卷积、池化和全连接层怎样接在一起
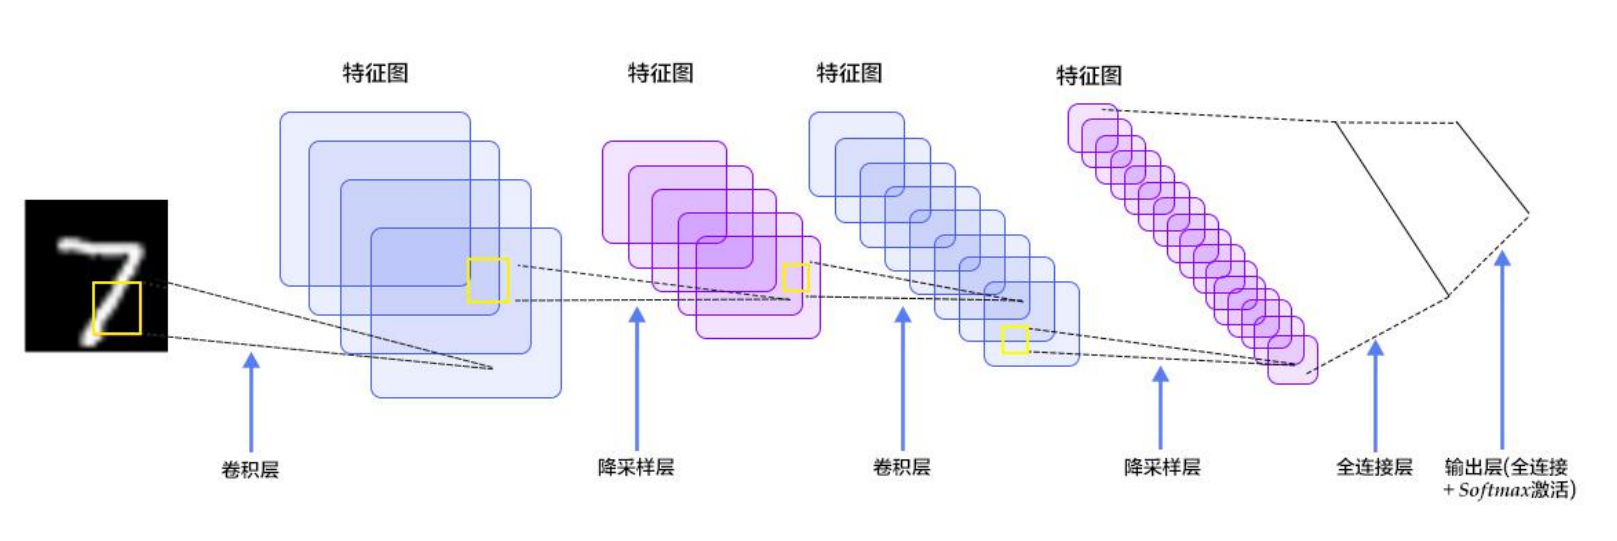
LeNet-5 的结构并不复杂,但它很适合做第一次完整的卷积神经网络实验。卷积层负责从局部区域提取特征,池化层压缩空间信息,后面的全连接层再根据这些特征判断最终类别。
我以前看到网络结构图,很容易把它当成一串层名:卷积、池化、卷积、池化、全连接。真正结合代码和图片看以后,才发现每一层都在改变数据的形状。通道数变了,宽高变了,最后送进全连接层的维度也必须精确计算出来。只要前面某一层的尺寸理解错,后面就不是“效果差一点”,而是根本无法运行。
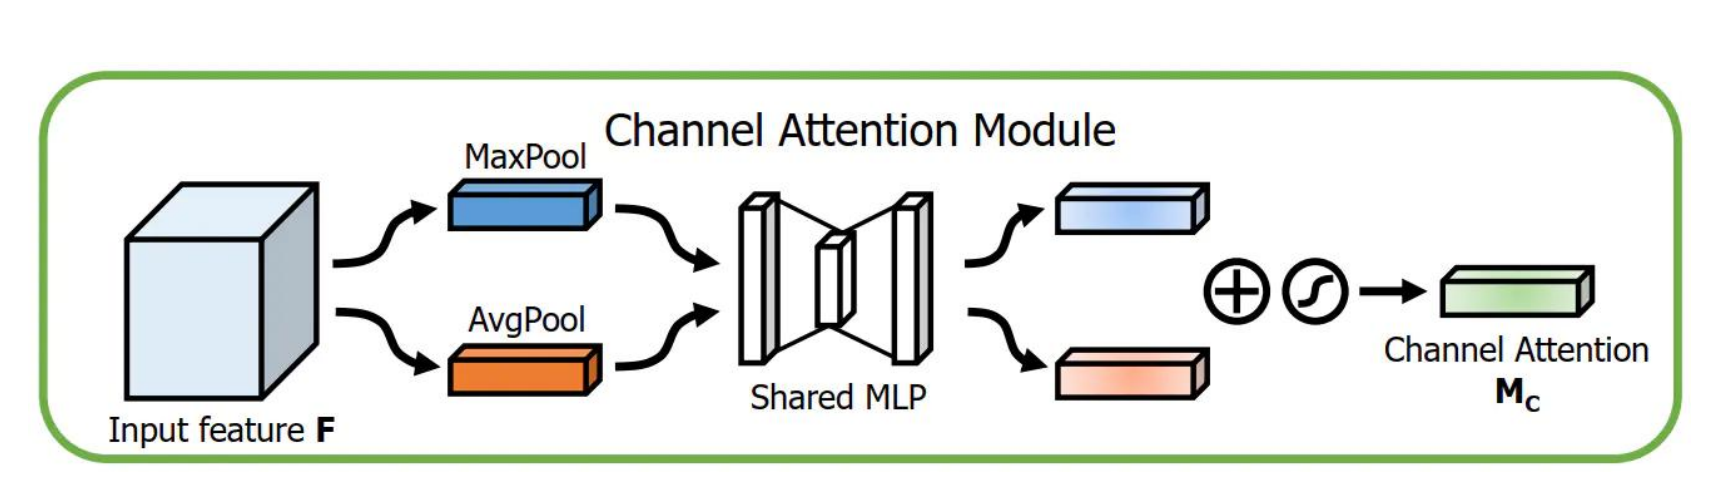
报告里还保留了卷积、池化以及通道注意力思路的图。它们让我开始思考一个问题:模型看到一张图片时,并不是把所有像素平均看待,而是在不断组合局部模式,逐步形成更有意义的特征。
训练时最容易忽略的事情:曲线不会替你解释原因
实验配置里有学习率、动量、epoch 数、batch size 和 checkpoint 间隔。参数写在代码里很直观,真正训练以后却不能只盯着最终准确率。loss 降得很慢,可能是学习率;训练准确率很高但测试表现不好,可能是过拟合;曲线突然异常,也可能是数据格式或输入归一化出了问题。
我当时最想做的是赶紧把模型训完,看最后的数字。但回头整理时,我觉得更值得留下的是那些中间过程。训练不是按下一个按钮就结束,它需要不断看日志、对照配置、确认数据,并判断“这次结果不好”究竟是模型能力不够,还是实验流程本身没有接对。
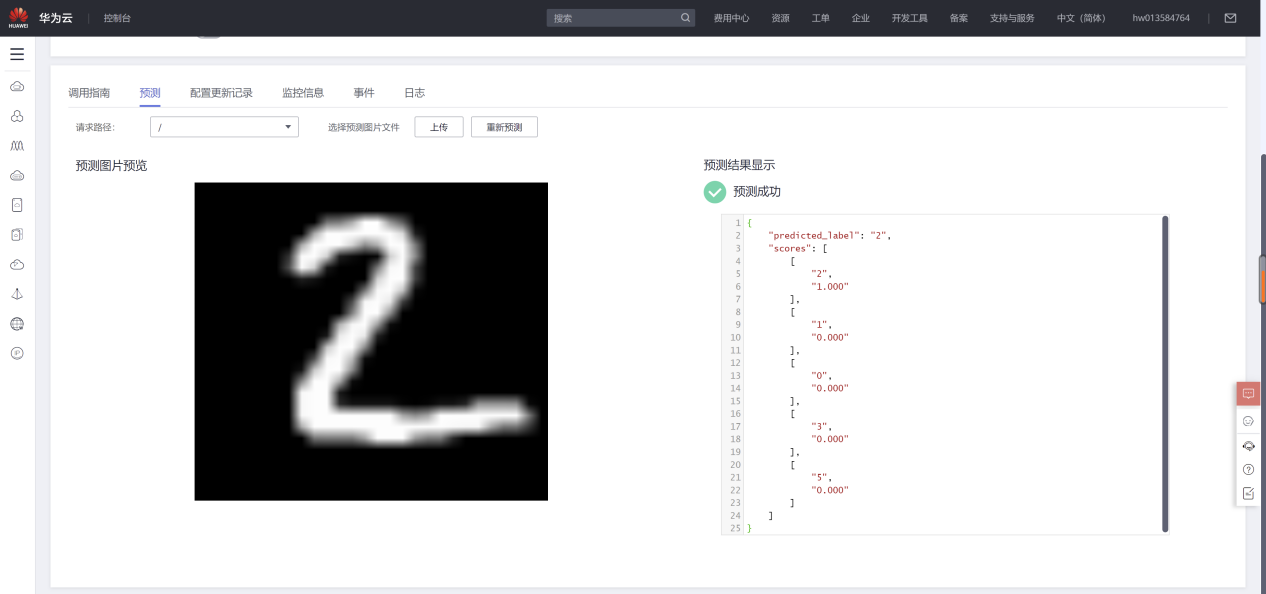
原始 LeNet README 里记录的历史测试准确率约为 0.9842。这个数字属于当时的旧 MindSpore 环境和课程实验记录,不能理解成我现在重新训练得到的新基准。把这个边界写清楚很重要,否则一个历史结果很容易被误读成当前环境下的保证。
从猴子摘香蕉到 LeNet,我真正感受到的是两种“智能”
实验一里,程序的每一步都可以解释成一条规则:如果猴子在这里、箱子在那里,就执行某个动作。实验二里,模型的判断来自训练出来的参数,过程不再像一条人手写好的路线,而是通过数据和优化逐渐形成。
前者让我知道,问题表示会决定搜索能不能进行;后者让我知道,数据处理、网络结构和训练过程会共同决定模型能不能学到东西。它们并不是谁取代谁,而是两种不同的解决问题方式。
我也是在这组实验里第一次意识到,人工智能实验的难点往往不在于把一个模型类写出来,而在于把问题、数据、训练和评价连成一条可信的链路。只给出最后一个准确率,不足以说明模型为什么有效;只写出几条规则,也不等于程序真正理解了问题。
现在回头看,这组代码为什么值得保留
这不是一个现代化的机器学习项目。它依赖较早的 MindSpore 环境,没有把数据集、训练缓存和 checkpoint 全部打包,也没有声称在今天的框架版本里可以一键复现。但它记录了我从符号规则走向神经网络训练的那个阶段。
如果重新做一次,我会更早记录数据形状、训练参数和每次实验的变化;会把“为什么这样设置”写得比“最后是多少”更清楚;也会在第一次训练前就准备好更可靠的验证方法。
仓库地址:HIT-Introduction-to-AI-Labs。如果你想同时看看规则推理和卷积网络,这个仓库正好可以从实验一读到实验二。
说明:本文根据个人历史实验材料、课程指导书和公开仓库整理,部分文字经过 AI 辅助润色;报告与结果图属于历史课程实验记录。课程资料仅用于学习回顾和个人作品整理,不用于当前课程作业或考试。

 浙公网安备 33010602011771号