在Web开发的世界里,无论是使用JavaScript、TypeScript构建现代前端应用,还是用Python进行数据采集,理解HTML的底层布局机制都是不可或缺的基本功。本文将带你深入掌握<div>容器的组织艺术与<table>表格的经典布局技巧,并延伸至Python爬虫的实战应用,帮助你建立从页面结构到数据获取的完整知识链路。
一、容器思维:用<div>构建页面骨架
在HTML中,容器是指那些用于包裹和组织其他元素的标签。容器本身通常不直接呈现内容,而是作为父元素存在,通过CSS样式来影响其内部子元素的布局与外观。这就好比Java中的类与对象关系——容器是类定义,内部元素是实例化的对象,继承父级的样式属性。
<div>style
语法结构如下:
其他标签来看一个直观的示例:
  我是标题1

    我是标题2
    我这里可以输入一个段落
运行后你会发现,<h1>不在<div>中,因此不受背景色样式影响;而<h2>和<p>在<div>中,会显示容器设置的antiquewhite背景色。✅ 这种继承关系是CSS层叠样式表的核心机制之一。
二、布局设置:尺寸与浮动控制
要实现精确的页面布局,需要掌握以下几个关键CSS属性:
widthheightfloatleftrighttopbottom
语法结构如下:
下面是一个嵌套容器的完整示例:
  我是标题1

    我是标题2

      我这里可以输入一个段落
      python 办公 自动化


      我是标题3

    最后一段内容
布局说明:
- 外层容器:宽度500px,高度400px,背景色antiquewhite(古董白)
- 内层左侧容器:宽度200px,高度300px,背景色brown(棕色),向左浮动
- 内层右侧容器:宽度300px,高度300px,背景色darkcyan(深青色),向右浮动
- 内容结构:标题层级为h1 > h2 > h3,段落文本包含Python办公自动化相关内容,使用了span标签设置蓝色文字
这个布局展示了基本的CSS浮动布局,左右两个子容器并排显示,总宽度为500px(200px + 300px),高度都为300px,外层容器高度为400px,底部还有一段文本内容。⚠️ 需要注意的是,浮动布局虽然经典,但在现代开发中更推荐使用Flexbox或Grid,尤其是在TypeScript配合React或Vue的项目中。
[AFFILIATE_SLOT_1]三、表格布局:结构化数据的经典方案
HTML表格不仅是展示数据的工具,在早期Web开发中更是页面布局的主力军。虽然现代开发更倾向于CSS布局,但掌握表格标签对于数据展示和后台管理系统仍然至关重要。
核心表格标签包括:
<table>border<tr><td>
行数由<tr><td>
  创建表格


      第1行中的第1格
      第1行中的第2格


      第2行中的第1格
      第2行中的第2格
要添加表头,可以使用:
<th>colspanrowspan
  我是标题1

    我是表格表头内容

      第1行中的第1格
      第1行中的第2格


      第2行中的第1格
      第2行中的第2格
表格标题通过<caption><table>
  添加表格标题

    我是表格标题

      第1行中的第1格
      第1行中的第2格


      第2行中的第1格
      第2行中的第2格
四、项目实战:好书推荐网站
让我们通过一个完整的项目案例来巩固所学知识。使用<table><div><a>
完整项目代码如下:
好书推荐网站
好书推荐网站
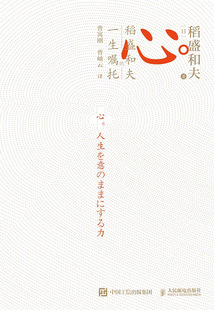


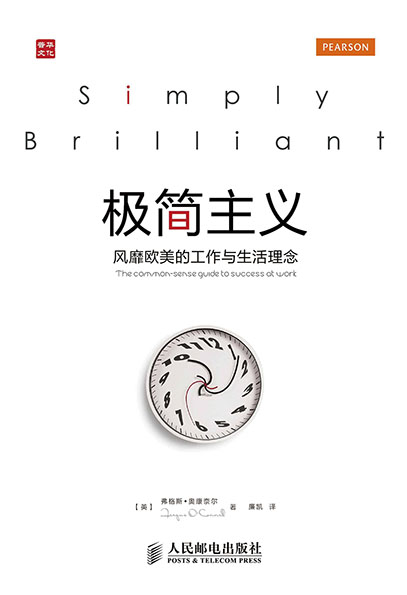


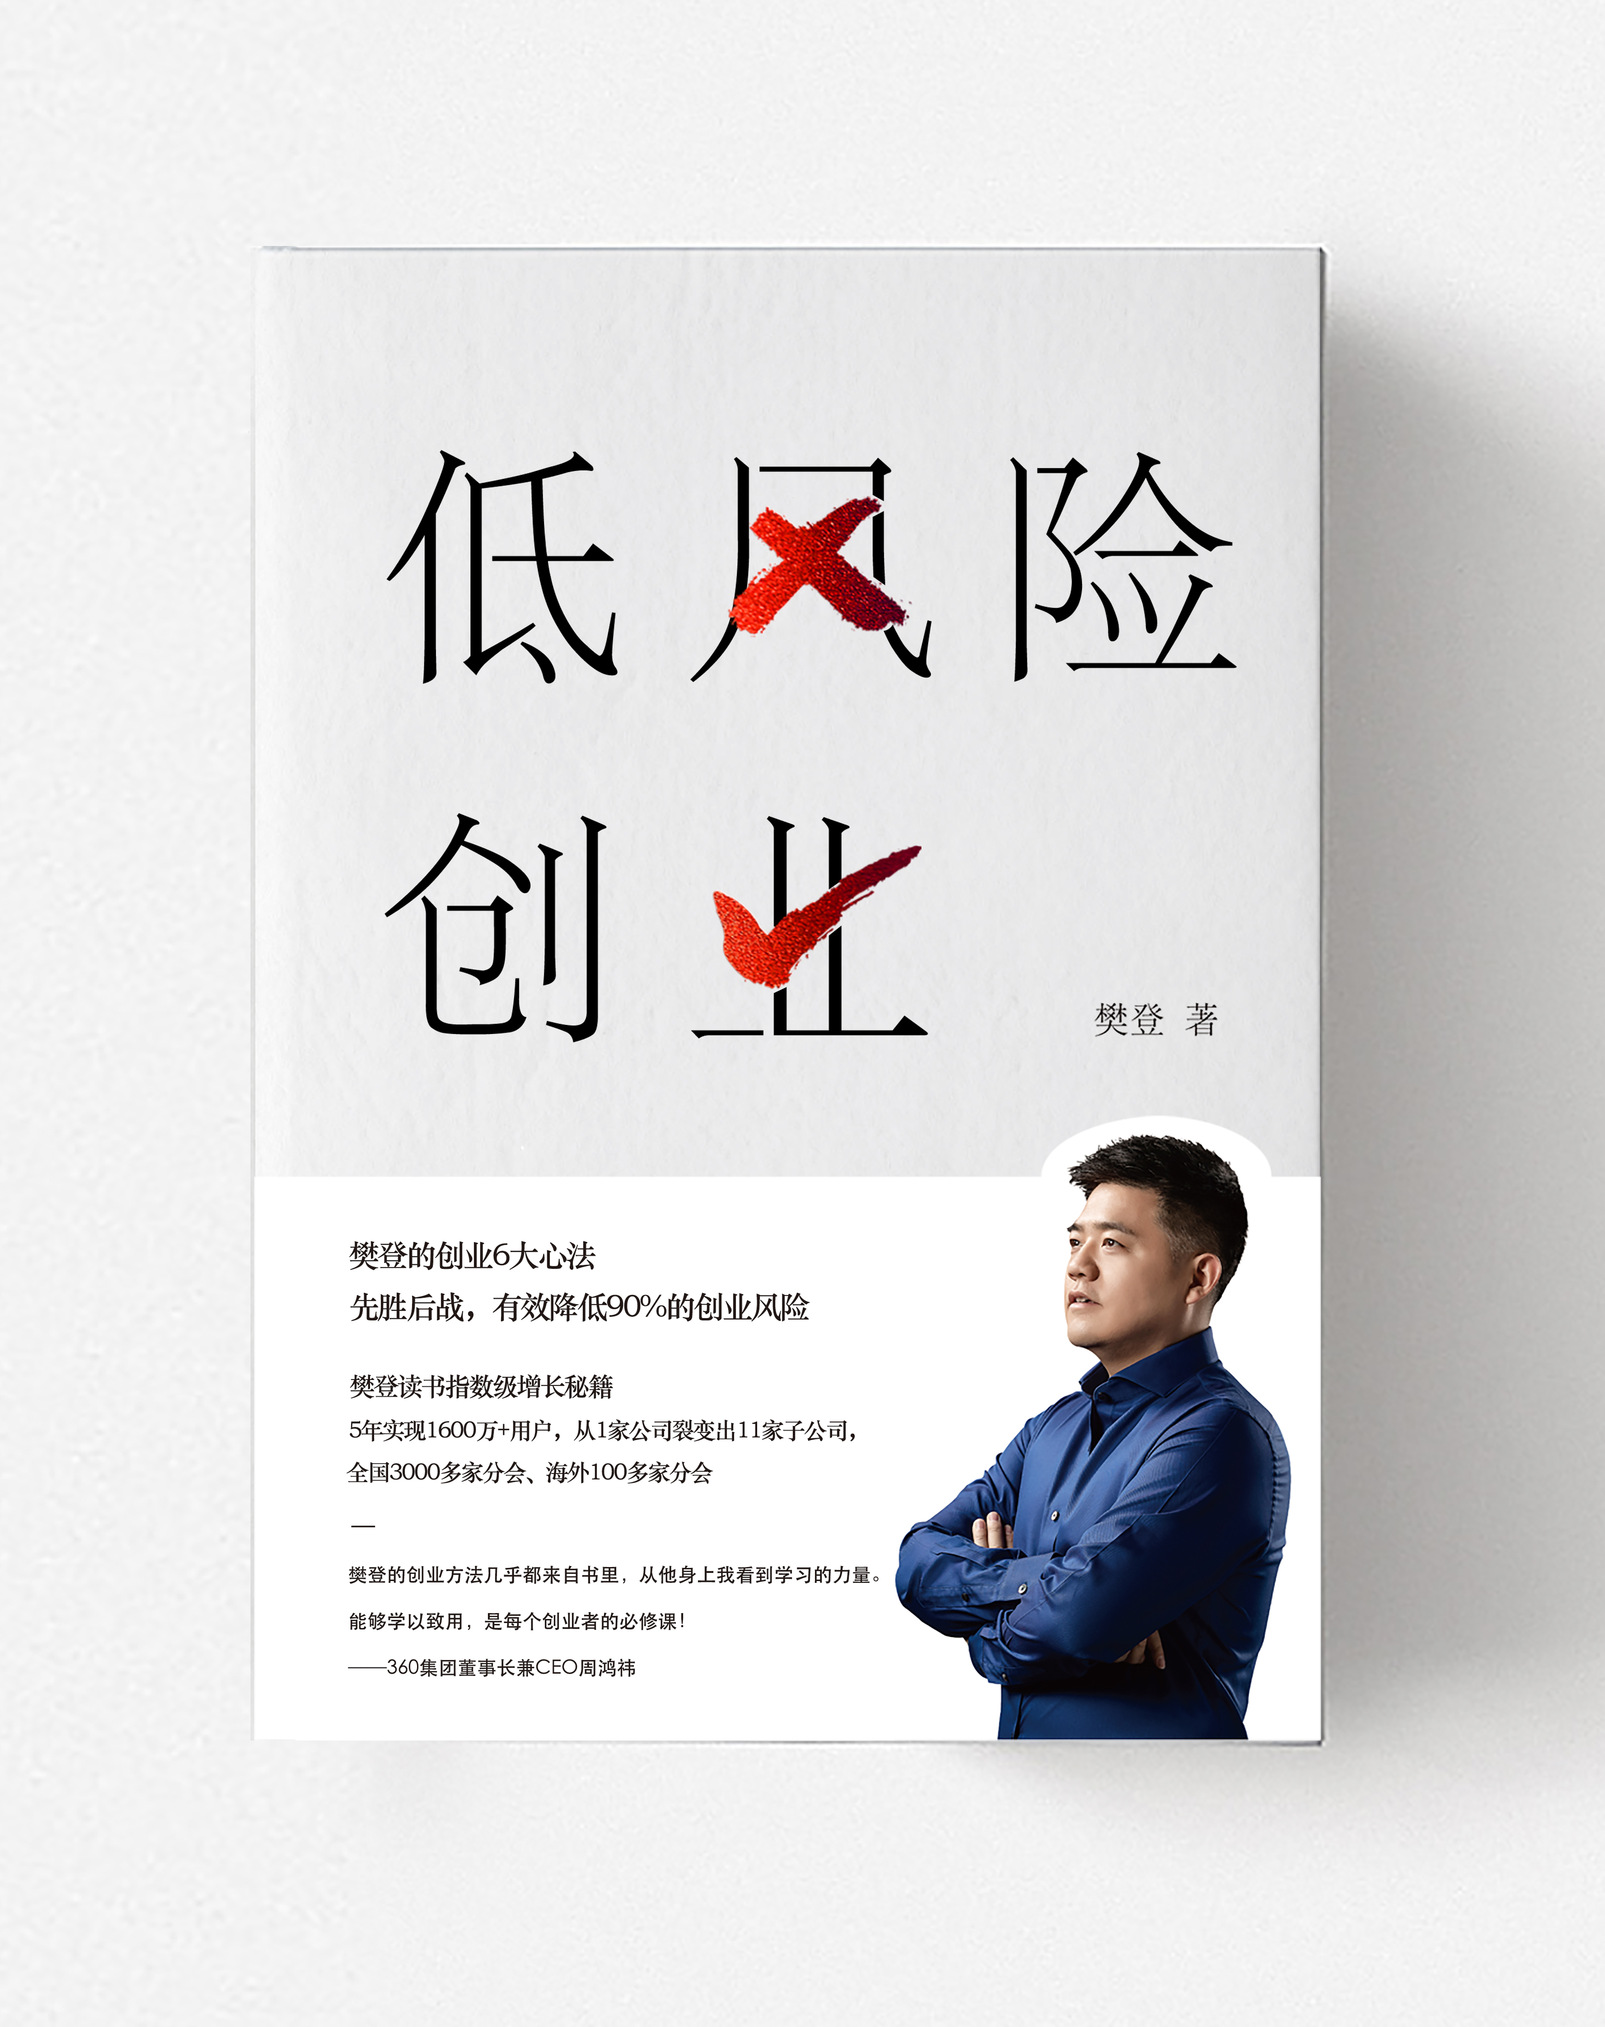

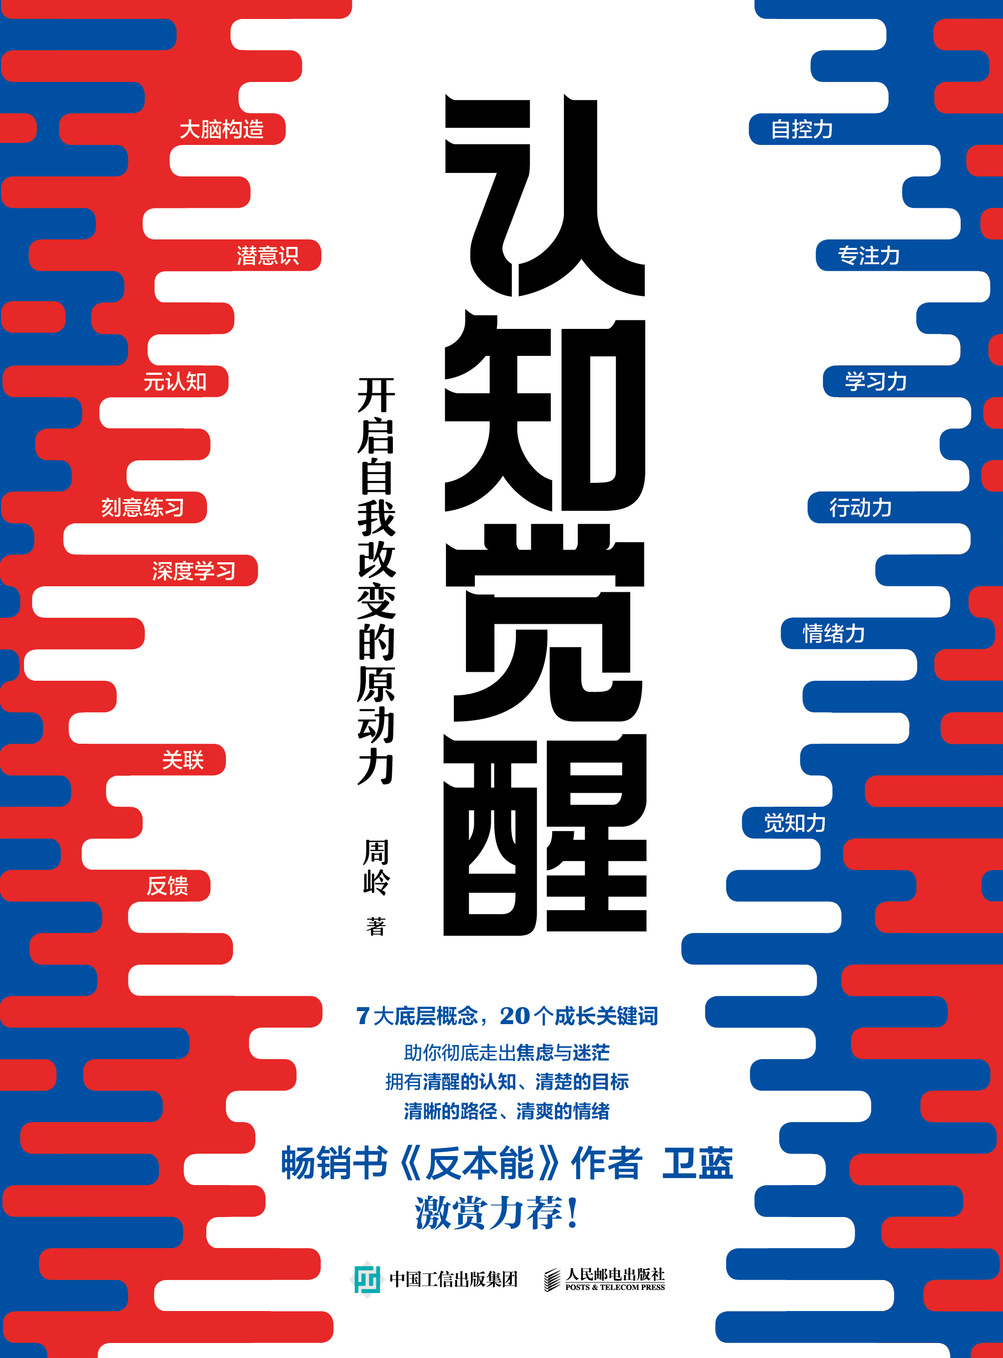
运行结果:
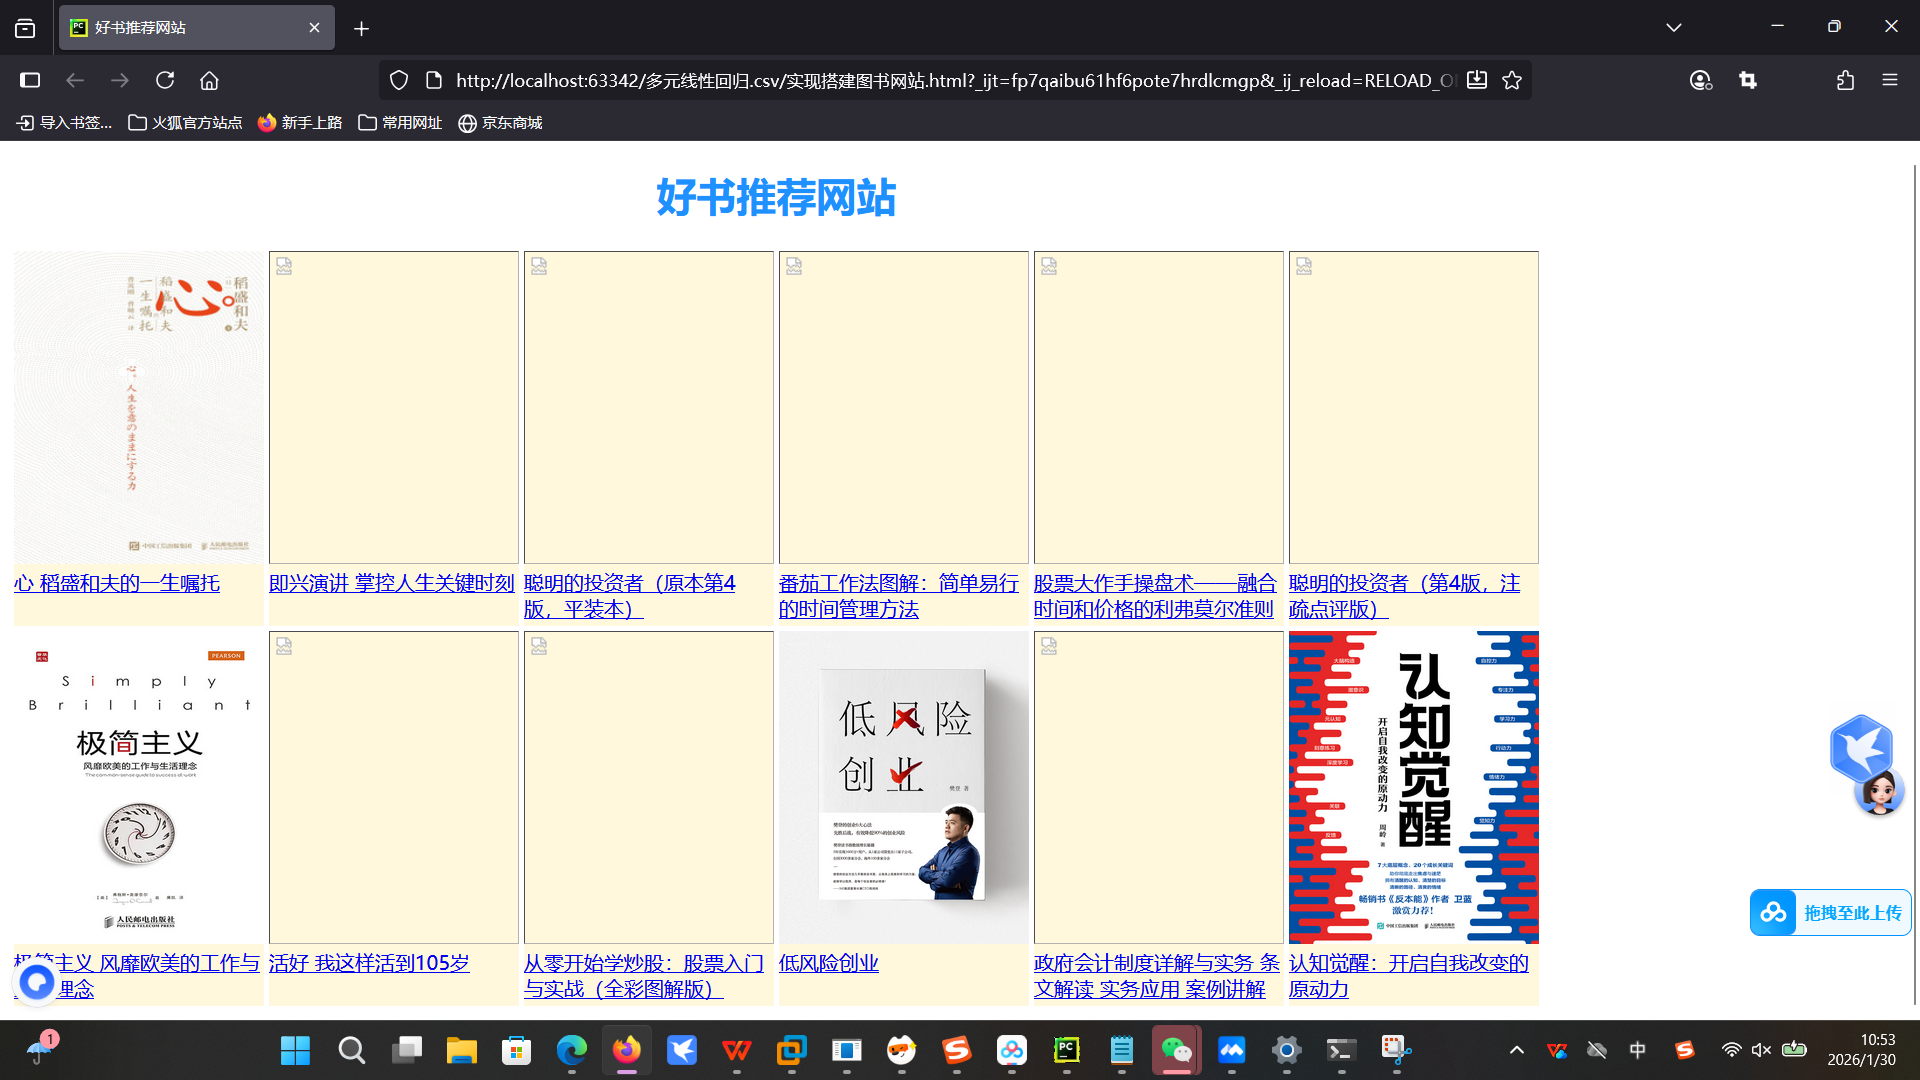
这个案例巧妙结合了表格的结构化布局和div容器的样式控制,是学习HTML布局的绝佳练习。 如果你熟悉C++或Java的GUI编程,会发现这种嵌套思维在桌面应用开发中同样适用。
五、延伸应用:Python网络爬虫入门
掌握了HTML结构之后,我们就可以用Python编写网络爬虫,自动获取网页中的关键信息(数据、图片、视频等)。网络爬虫的本质是通过代码将HTML网页内容下载到本地,再从中提取有价值的数据。
常用的Python网络爬虫库包括:
- urllib库:Python自带的标准库,无需下载安装,但代码编写较复杂
- requests库:第三方库,基于urllib构建,使用更简洁方便
- scrapy库:专业爬虫框架,适用于大型应用开发
- selenium库:可驱动浏览器执行命令,实现办公自动化和Web应用测试
⚠️ 在编写爬虫之前,必须了解robots.txt规则。该文件存在于网站根目录,声明了禁止访问和允许访问的URL。访问方式为在域名后加上/robots.txt。其规则内容包括:User-agent(访问网站的搜索引擎,*表示所有类型)、Disallow(不允许访问的URL)、Allow(允许访问的URL)、Sitemap(网站地图)、Crawl-delay(访问延迟建议)、#(注释)。
务必注意:访问网站前需阅读robots.txt规则并严格遵守;有些网站可能没有该规则,但仍需遵守《中华人民共和国网络安全法》等法律法规;当网站没有robots.txt规则时,一般默认允许使用爬虫工具访问。
安装requests库:
pip install requests -i https://pypi.tuna.tsinghua.edu.cn/simplerequests.get()是最基础也是最常用的方法,用于向服务器发起HTTP GET请求。搜索信息时:
import requests
r = requests.get('https://www.ryjiaoyu.com//search?keyword=python')
print(r.text)
添加信息时:
import requests
info ={'keyword':'excel' }
r = requests.get('https://www.bilibili.com/search',params=info)
print(r.url)
print(r.text)返回的Response对象包含多个属性,其中status_code (状态码)、headers(响应头)、url响应的最终url位置、cookies服务器返回的文件
总结
本文从HTML容器与表格布局出发,系统讲解了<div>容器的嵌套与浮动布局、<table>表格的结构化数据展示,并通过好书推荐网站项目进行了实战演练。最后延伸到Python网络爬虫的基础知识,包括requests库的使用和robots.txt规则的遵守。无论你使用JavaScript、TypeScript还是Python,这些底层HTML知识都是构建Web应用和进行数据采集的坚实基石。


 浙公网安备 33010602011771号