ESP32网页开发中,中文乱码是困扰无数开发者的经典问题。本文将带你从编码原理出发,深入剖析UTF-8与GBK的底层差异,并提供一套完整的实战排查方案,帮你彻底告别"å°æ¬¢ç‰›é€¼"式的乱码困扰。
乱码的本质:当UTF-8遇上GBK
如果你在ESP32网页上看到类似 å°æ¬¢ç‰›é€¼ 的字符,恭喜你,遇到了典型的编码解码不匹配问题。这不是数据传输错误,而是浏览器用错误的"字典"去翻译了正确的字节流。
从自然语言处理的角度看,这就像用英语音标去读汉语拼音——发音规则完全不同,结果自然面目全非。ESP32发送的是UTF-8编码的中文字节,而浏览器却用GBK去解码,每个汉字被拆解成两个乱码字符,于是就成了你看到的"天书"。
理解这一点至关重要:数据本身没有错,错的是翻译规则。就像机器学习模型需要正确的标签映射一样,字符编码也需要收发双方约定一致的"字典"。
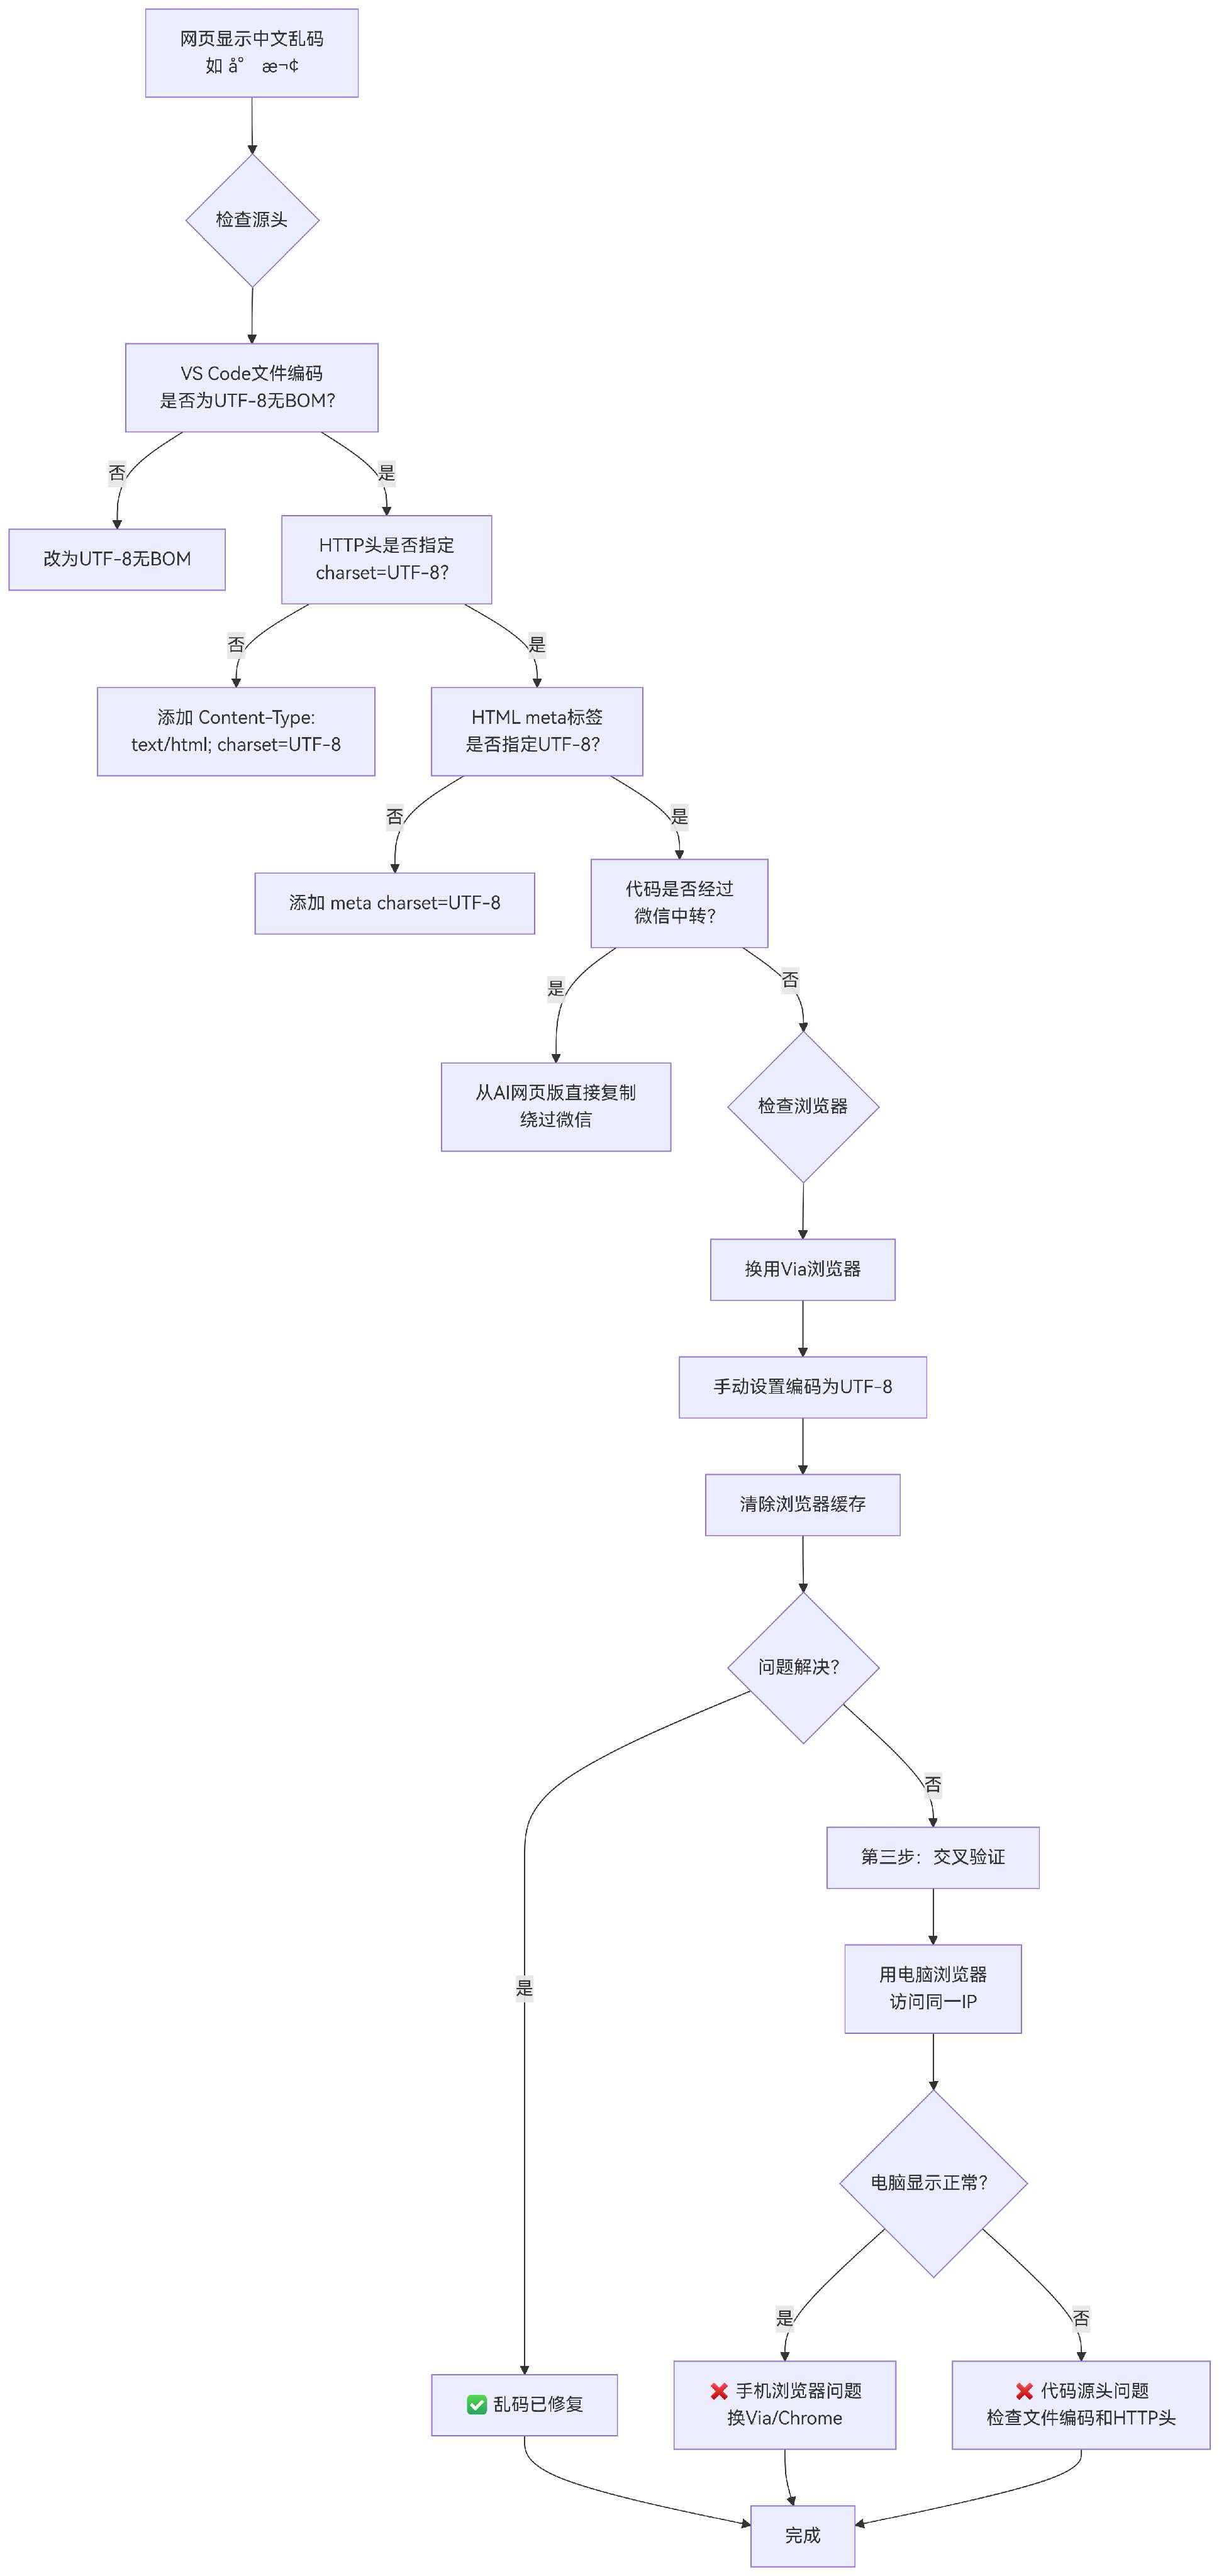
✅ 三步排查法:从源头到终端
按照以下顺序排查,90%的乱码问题都能解决:
- 检查源头代码:VS Code文件编码必须设为UTF-8(无BOM)。按
Ctrl+Shift+P→ Change File Encoding → Save with Encoding → 选 UTF-8。这一步相当于为深度学习模型准备干净的训练数据,源头污染了后面全白搭。 - 检查HTTP响应头:确保代码中包含
client.println("Content-Type: text/html; charset=UTF-8");,这是告诉浏览器"请用UTF-8字典"的关键指令。 - 检查HTML元标签:在
<head>中加入<meta charset="UTF-8">,双重保险确保浏览器不会"自作聪明"。
⚠️ 特别提醒:代码不要经过微信中转!微信可能会污染中文字符,直接从AI网页版复制粘贴到VS Code。这个坑我踩过不止一次。
如果以上都试了还是乱码,换用Via浏览器(华为应用市场可下载),在菜单中手动选择UTF-8编码。或者用电脑浏览器访问同一IP,如果电脑正常而手机乱码,那就是手机浏览器的问题。
[AFFILIATE_SLOT_1]从WiFi连接到Web服务器:一次完整的调试历程
新板子到货那天,我插上USB线,设备管理器里COM3如期出现。这次我格外小心,新建PlatformIO项目,板子选ESP32-S3-DevKitC-1,框架用Arduino。
先用最简代码测试板子是否存活:串口打印"活着"和"我还活着"。上传成功,串口监视器里字符稳稳输出,我松了一口气——这块板子没搞我。
接下来是WiFi连接。手机热点设为"1234",密码"12345678",代码里加入WiFi连接逻辑。上传后,串口开始吐点号,一个、两个、十个……我盯着屏幕默念"求你了"。突然,手机热点页面闪了一下——设备连上了!串口显示IP地址192.168.43.5,Web服务器已启动。
那一刻我从椅子上弹起来,差点打翻旁边的西瓜。但冷静下来一想,还得用手机访问这个IP看看效果。
编码背后的底层逻辑:从ASCII到汉字点阵
等待网页加载的时候,我想起了老师讲的内容。ASCII编码是1960年代美国人定的,用7位二进制表示128个字符,只够英文使用。后来扩展到8位,256个字符,但汉字有几万个,远远不够。
于是有了GB2312、GBK、GB18030,再到Unicode和UTF-8。这就像神经网络的层级结构——每一层都在做翻译和映射,从输入到输出经过多次转换。
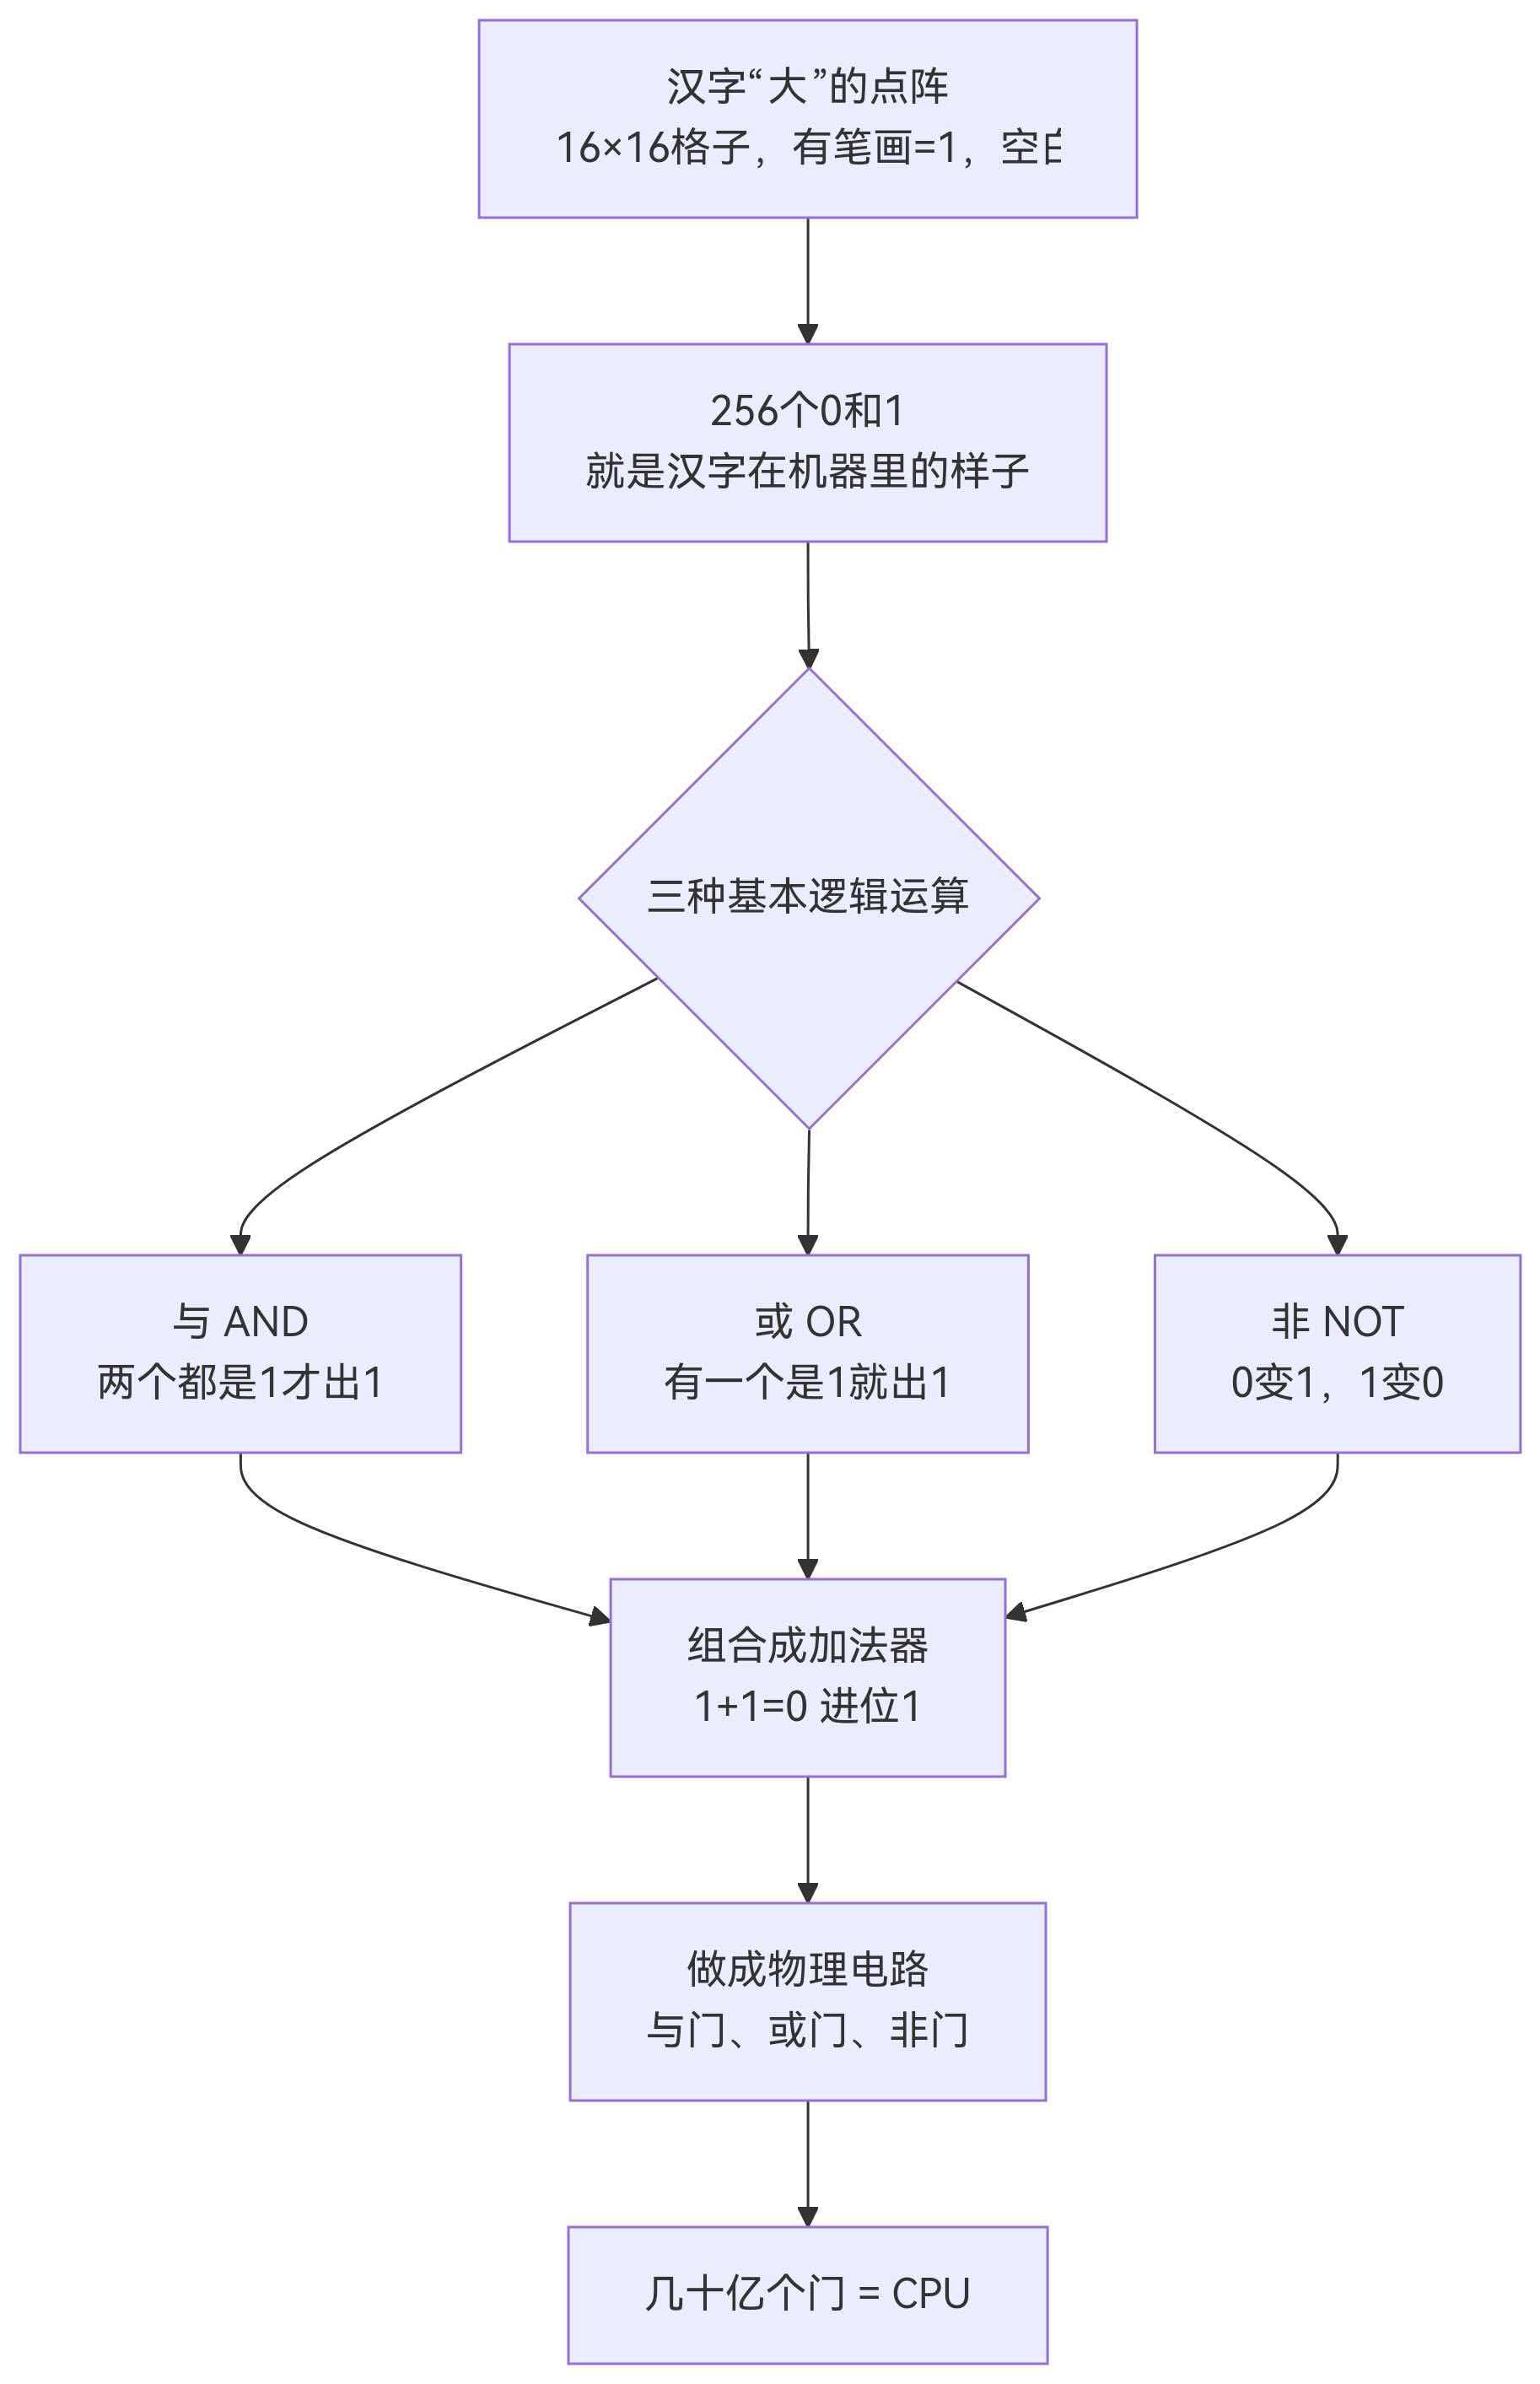
汉字在机器里怎么表示?老师用"大"字举例:在16×16的格子里,有笔画的地方是1,空白是0,从上到下、从左到右读出来就是256个0和1。这就是点阵表示。如果换一种读取顺序,得到的01串完全不同——这和编码解码是一个道理。
与、或、非三种基本逻辑运算,加上异或,可以组合出任何复杂计算。几十亿个逻辑门组合在一起,就是CPU。我手机按一下,ESP32收到1,通过逻辑门计算,回我一个1——网页就应该出来。但现在它没出来,说明逻辑门执行了,但返回的内容浏览器不认。
为什么是乱码:UTF-8与GBK的翻译战争
AI给了段新代码,我复制粘贴上传重启。网页出来了,但全是乱码:å°æ¬¢ç‰›é€¼。
原因很简单:ESP32返回的网页内容是UTF-8编码,但手机浏览器可能用了GBK去读。UTF-8对英文字符用1个字节,对汉字用3个字节。比如"小"字的UTF-8编码是 E5 B0 8F。如果浏览器误以为这是GB2312编码,就会把这三个字节当成两个汉字去读,读出来就是乱码。
这就像自然语言处理中的分词错误——同样的字符序列,用不同的分词规则去切分,得到完全不同的语义。数据传对了,但翻译字典用错了。
从物理层到应用层,每一层都在翻译、校验、确保0和1传得对。最后浏览器没显示对,只是因为编码表用错了。就像你拿着拼音读汉字,能读出声,但不懂意思。
终极解决方案与避坑指南
经过反复折腾,我总结了以下避坑要点:
- ✅ VS Code文件编码设为UTF-8(无BOM)
- ✅ HTTP响应头指定
charset=UTF-8 - ✅ HTML中加入
<meta charset="UTF-8"> - ✅ 代码不要经过微信中转,直接从AI网页版复制
- ✅ 使用Via浏览器,手动选择UTF-8编码
- ⚠️ 华为自带浏览器编码识别有问题,建议换用Via或Chrome
最后成功的那一刻,屏幕上清清楚楚显示着"ESP32 成功啦!",真的有点想哭。这块新板子没搞我,它让我把ASCII、汉字点阵、与或非逻辑、编码转换全部串了起来。
老师还提了一嘴中国的八卦——阴爻阳爻,其实就是01。古人用这套规则解释世界,我们现在用这套规则造机器。规则变了,底层逻辑没变。
[AFFILIATE_SLOT_2]总结
ESP32中文乱码的本质是UTF-8与GBK的编码解码不匹配。排查顺序为:源头代码编码→HTTP响应头→HTML元标签→浏览器编码设置。核心原则是收发双方约定一致的编码字典。推荐使用Via浏览器手动指定UTF-8,避免使用华为自带浏览器。理解编码原理,比记住排查步骤更重要——这就像理解机器学习的底层数学,比会调包更有价值。


 浙公网安备 33010602011771号