目标追踪是计算机视觉的核心技术之一,广泛应用于安防监控、自动驾驶和体育转播等领域。本文将系统讲解OpenCV中的目标追踪算法,从经典方法到深度学习模型,并提供完整的Python实战代码。
一、目标追踪的核心挑战与应用场景
目标追踪旨在从视频序列中持续定位感兴趣目标的位置。根据任务类型可分为单目标追踪和多目标追踪,此外还包括行人重识别(Person Re-ID)和多摄像头多目标追踪(MTMCT)等高级任务。按处理方式又分为在线追踪(实时处理)和离线追踪(可访问未来帧,精度更高)。
实际应用中,目标追踪面临四大核心挑战:
- 形态变化:目标姿态改变导致外观模型失效,如运动员动作变化
- 尺度变化:跟踪框无法自适应调整,导致背景信息混入或目标信息缺失
- 遮挡与消失:目标被遮挡时跟踪框漂移到遮挡物上,完全遮挡则导致跟踪失败
- 图像模糊:光照变化、快速运动或低分辨率造成特征提取困难
这些问题限制了追踪算法在复杂场景中的表现,也是算法选型时需要重点考量的因素。
[AFFILIATE_SLOT_1]二、目标追踪方法演进:从生成式到深度学习
目标追踪方法按模式可分为生成式模型和鉴别式模型两大类。生成式模型(如光流法、Meanshift、粒子滤波)仅对目标建模,忽略背景信息,在遮挡和光照变化下容易失败。鉴别式模型同时考虑目标和背景,通过分类器区分两者,显著提升了鲁棒性。
按时间顺序,追踪算法经历了三个发展阶段:
- 经典跟踪算法:包括光流法、Meanshift和粒子滤波。光流法依赖亮度恒定假设,仅适用于缓慢运动;Meanshift基于概率密度梯度迭代,适合色彩差异大的场景;粒子滤波通过粒子分布统计估计目标位置。这些方法速度慢(约10 FPS),难以满足实时需求。
- 核相关滤波算法:将通信领域的相关滤波引入追踪,代表算法有MOSSE、KCF、CSRT等。速度可达数百FPS,适合实时系统。其中SAMF和BACF在OTB数据集和VOT竞赛中表现优异。
- 深度学习算法:利用卷积网络提取深度特征,表达能力远超HOG和CN特征。初期将深度特征融入相关滤波框架(如DeepSRDCF),后续发展出端到端的跟踪网络。精度显著提升,但计算量也随之增加。
总结来看,相关滤波类算法速度更快,深度学习类方法精度更高。多特征融合和强分类器是实现良好跟踪的关键,尺度自适应和模型更新机制同样影响最终效果。
三、OpenCV内置的八种追踪算法对比
OpenCV提供了八种目标追踪算法,各有适用场景:
- BOOSTING:基于AdaBoost,速度慢且表现一般(OpenCV 3.0.0+)
- MIL:比BOOSTING精确,但失败率较高(OpenCV 3.0.0+)
- KCF:速度快于BOOSTING和MIL,但遮挡场景表现不佳(OpenCV 3.1.0+)
- CSRT:比KCF更精确,速度稍慢(OpenCV 3.4.2+)
- MedianFlow:故障报告出色,适合可预测运动,快速跳动场景易失效(OpenCV 3.0.0+)
- TLD:多帧遮挡下效果最好,但误报多(OpenCV 3.0.0+)
- MOSSE:速度极快,准确率低于CSRT和KCF(OpenCV 3.4.1+)
- GOTURN:唯一基于深度学习的追踪器,需额外模型文件(OpenCV 3.2.0+)
选择建议:追求速度选MOSSE,平衡精度和速度选KCF或CSRT,遮挡场景可尝试TLD。
主要追踪数据集的对比结果如下图所示:
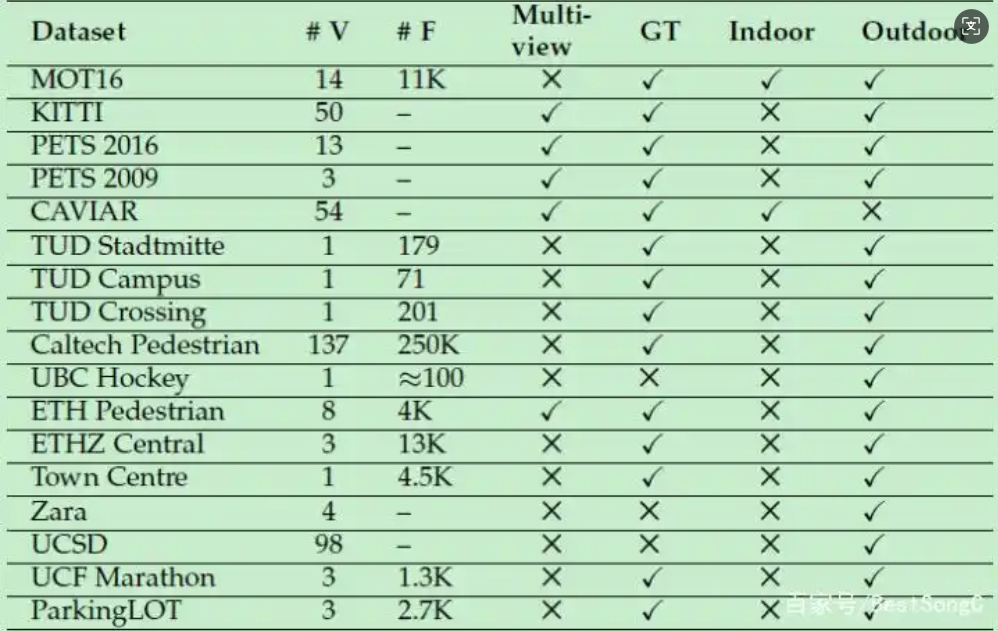
17.1-目标追踪数据集
四、OpenCV多目标追踪实战
使用OpenCV实现多目标追踪的流程非常清晰:
- 创建MultiTracker对象
- 读取视频或摄像头数据
- 框选ROI区域(感兴趣区域)
- 为MultiTracker添加具体的追踪算法
- 逐帧执行目标追踪
以下是Jupyter Notebook中的完整实现代码:
import cv2
import argparse
# ap=argparse.ArgumentParser()
# ap.add_argument('-v','--video',type=str,help='path to input video file')
# ap.add_argument('-t','--tracker',type=str,default='kef',help='OpenCV object tracker type')
# args=vars(ap.parse_args())
#MultiTracker_create以及以后的一些目标追踪算法在opencv4.5以后换了地方
#cv2.legacy.MultiTracker_create
#定义OPenCV中的七种目标追踪算法
OPENCV_OBJECT_TRACKERS={
    'boosting':cv2.TrackerBoosting_create,
    'csrt':cv2.TrackerCSRT_create,
    'kef':cv2.TrackerKCF_create,
    'mil':cv2.TrackerMIL_create,
    'tid':cv2.TrackerTLD_create,
    'medianflow':cv2.TrackerMedianFlow_create,
    'mosse':cv2.TrackerMOSSE_create
}
trackers=cv2.MultiTracker_create()
cap=cv2.VideoCapture('./vehicles.mp4')
while True:
    flag,frame=cap.read()
    if frame is None:
        break
    #变成黑白的
    # gray=cv2.cvtColor(frame,cv2.COLOR_BGR2GRAY)
    #追踪目标
    success,boxes=trackers.update(frame)
    #绘制追踪到的矩形区域
    for box in boxes:
        #box是给浮点数,画图需要整理
        (x,y,w,h)=[int(v) for v in box]
        cv2.rectangle(frame,(x,y),(x+w,y+h),(0,255,0),2)
    cv2.imshow('frame',frame)
    key=cv2.waitKey(100)
    if key==ord('s'):
        #框选ROI区域
        roi=cv2.selectROI('frame',frame,showCrosshair=True,fromCenter=False)
        # print(roi)
        #创建一个实际的目标追踪器
        tracker=OPENCV_OBJECT_TRACKERS['kef']()
        trackers.add(tracker,frame,roi)
    elif key==27:
        break
cap.release()
cv2.destroyAllWindows()
运行结果展示了多目标追踪的实际效果:
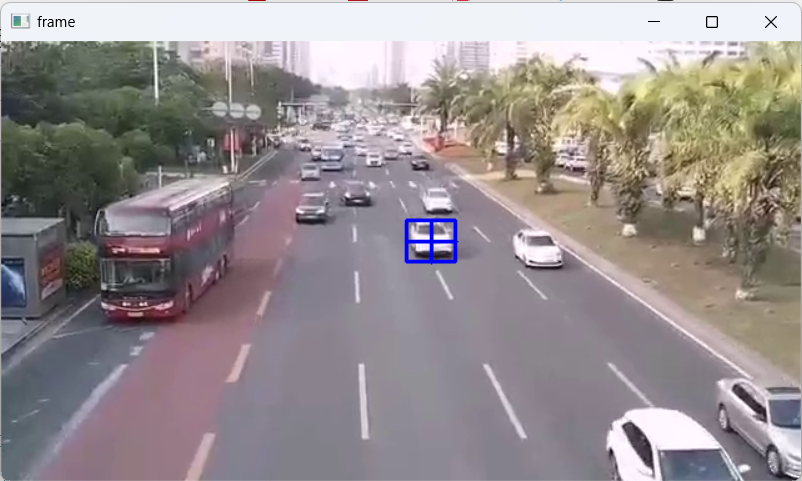
17.2-目标追踪检测(1)
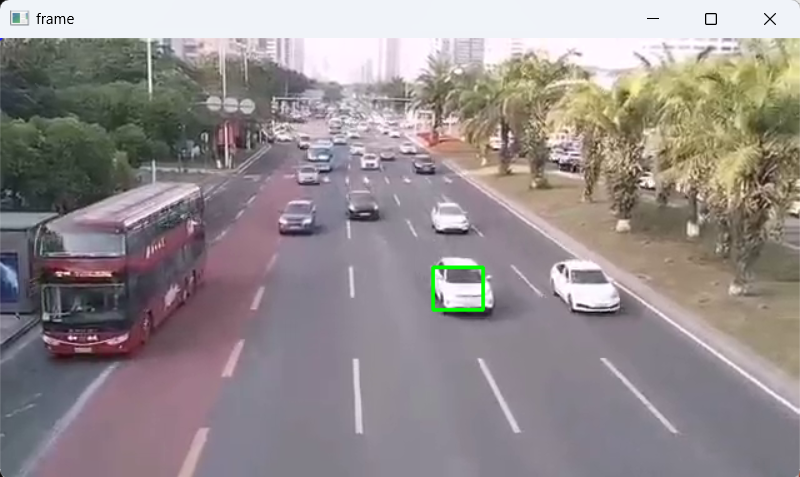
17.3-目标追踪检测(2)
如果需要在独立脚本中运行,可以使用以下Python文件方式:
import cv2
import argparse
ap=argparse.ArgumentParser()
ap.add_argument('-v','--video',type=str,help='path to input video file')
ap.add_argument('-t','--tracker',type=str,default='kef',help='OpenCV object tracker type')
args=vars(ap.parse_args())
#MultiTracker_create以及以后的一些目标追踪算法在opencv4.5以后换了地方
#cv2.legacy.MultiTracker_create
#定义OPenCV中的七种目标追踪算法
OPENCV_OBJECT_TRACKERS={
    'boosting':cv2.TrackerBoosting_create,
    'csrt':cv2.TrackerCSRT_create,
    'kef':cv2.TrackerKCF_create,
    'mil':cv2.TrackerMIL_create,
    'tid':cv2.TrackerTLD_create,
    'medianflow':cv2.TrackerMedianFlow_create,
    'mosse':cv2.TrackerMOSSE_create
}
trackers=cv2.MultiTracker_create()
cap=cv2.VideoCapture('./vehicles.mp4')
while True:
    flag,frame=cap.read()
    if frame is None:
        break
    #变成黑白的
    # gray=cv2.cvtColor(frame,cv2.COLOR_BGR2GRAY)
    #追踪目标
    success,boxes=trackers.update(frame)
    #绘制追踪到的矩形区域
    for box in boxes:
        #box是给浮点数,画图需要整理
        (x,y,w,h)=[int(v) for v in box]
        cv2.rectangle(frame,(x,y),(x+w,y+h),(0,255,0),2)
    cv2.imshow('frame',frame)
    key=cv2.waitKey(100)
    if key==ord('s'):
        #框选ROI区域
        roi=cv2.selectROI('frame',frame,showCrosshair=True,fromCenter=False)
        # print(roi)
        #创建一个实际的目标追踪器
        tracker=OPENCV_OBJECT_TRACKERS['kef']()
        trackers.add(tracker,frame,roi)
    elif key==27:
        break
cap.release()
cv2.destroyAllWindows()
提示:在实际项目中,可以结合Java或C++的高性能特性进行部署,Python适合快速原型验证,而Go语言在并发处理多路视频流时表现出色。
五、OpenCV与深度学习模型集成
OpenCV的DNN模块支持加载多种深度学习框架训练的模型,包括Caffe、Darknet、TensorFlow和Torch。这为在OpenCV中直接使用深度学习模型提供了便利。
核心API包括:
cv2.dnn.readNet()及系列方法:加载不同框架的模型cv2.dnn.blobFromImage():将图像转换为网络输入的tensornet.setInput()和net.forward():设置输入并执行前向推理
基本使用流程为:加载模型 → 图像转tensor → 输入网络 → 前向推理 → 解析结果。
以下示例展示了使用Caffe模型进行图像分类的完整代码:
#OpenCV和深度学习结合
config='./bvlc_googlenet.prototxt'
model='./bvlc_googlenet.caffemodel'
import cv2
import numpy as np
net=cv2.dnn.readNetFromCaffe(config,model)
#读图片(金毛狗和拉布拉多犬)
img=cv2.imread('./dog.jpg')
# img=cv2.imread('./dog1.jpg')
#转化为tensor
blob=cv2.dnn.blobFromImage(img,1.0,(224,224),(104,117,123))
net.setInput(blob)
r=net.forward()
# print(r)
#返回的是属于1000个物体的概率
print(r.shape)
#希望看一下概率前三的是社么物体
#读类别
classes=[]
with open('./synset_words.txt','r') as fp:
    #返回找到字符串的索引
    classes=[x[x.find(' ')+1:] for x in fp]
# print(classes)
#对得到的结果排序
order=sorted(r[0],reverse=True)
#只要前三的概率
z=list(range(3))
for i in range(3):
    #返回的是满足条件的索引
    z[i]=np.where(r[0]==order[i])[0][0]
    print('第',i+1,'项匹配',classes[z[i]],end='')
    print('类所在行:',z[i]+1,' ','可能性:',order[i])
测试图像分别为金毛犬和拉布拉多犬:
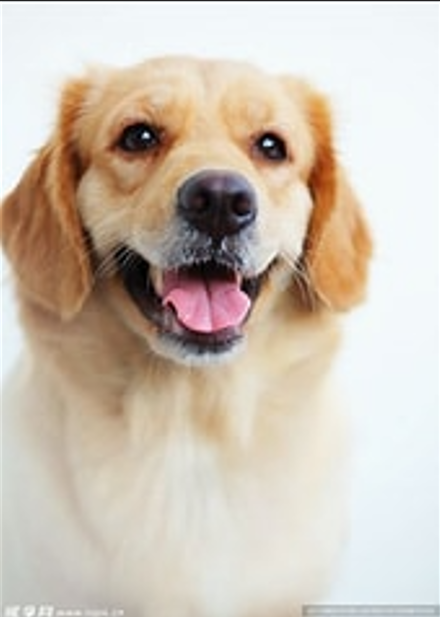
17.4-金毛犬
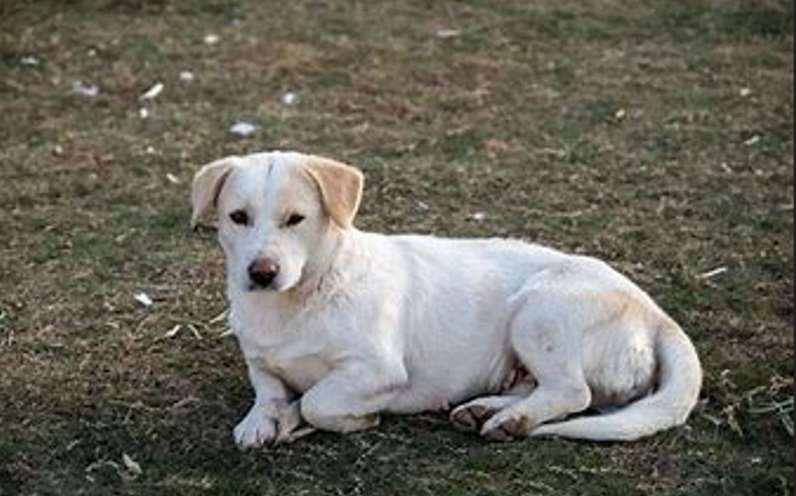
17.5-拉布拉多犬
金毛犬的深度学习匹配结果如下:
(1, 1000)
第 1 项匹配 golden retriever
类所在行: 208   可能性: 0.8343014
第 2 项匹配 Labrador retriever
类所在行: 209   可能性: 0.028573554
第 3 项匹配 clumber, clumber spaniel
类所在行: 217   可能性: 0.026441319
拉布拉多犬的匹配结果如下:
(1, 1000)
第 1 项匹配 Labrador retriever
类所在行: 209   可能性: 0.9073125
第 2 项匹配 American Staffordshire terrier, Staffordshire terrier, American pit bull terrier, pit bull terrier
类所在行: 181   可能性: 0.031111853
第 3 项匹配 golden retriever
类所在行: 208 可能性: 0.009617143总结
本文系统梳理了OpenCV目标追踪的技术体系:从生成式到鉴别式的方法演进,从经典算法到深度学习的性能跃迁。OpenCV提供了八种内置追踪器,其中KCF和CSRT在精度与速度间取得了较好平衡。通过DNN模块,OpenCV还能无缝集成深度学习模型,拓展了应用边界。建议根据实际场景的精度和速度需求选择合适的算法,并结合Python、C++或Go等语言特性进行工程化部署。


 浙公网安备 33010602011771号