在人工智能的演进历程中,2024年是一个分水岭。以OpenAI o1和DeepSeek-R1为代表的新一代推理模型,引入了一种全新的思维范式——慢思考(Slow Thinking)与深度推理(Deep Reasoning)。这不再是简单的“快问快答”,而是让AI在回答前经历一场“内心的风暴”。本文将用通俗的语言,为你拆解这一技术变革的核心,并探讨它对开发者(尤其是使用TypeScript、Java、Python等语言的工程师)意味着什么。
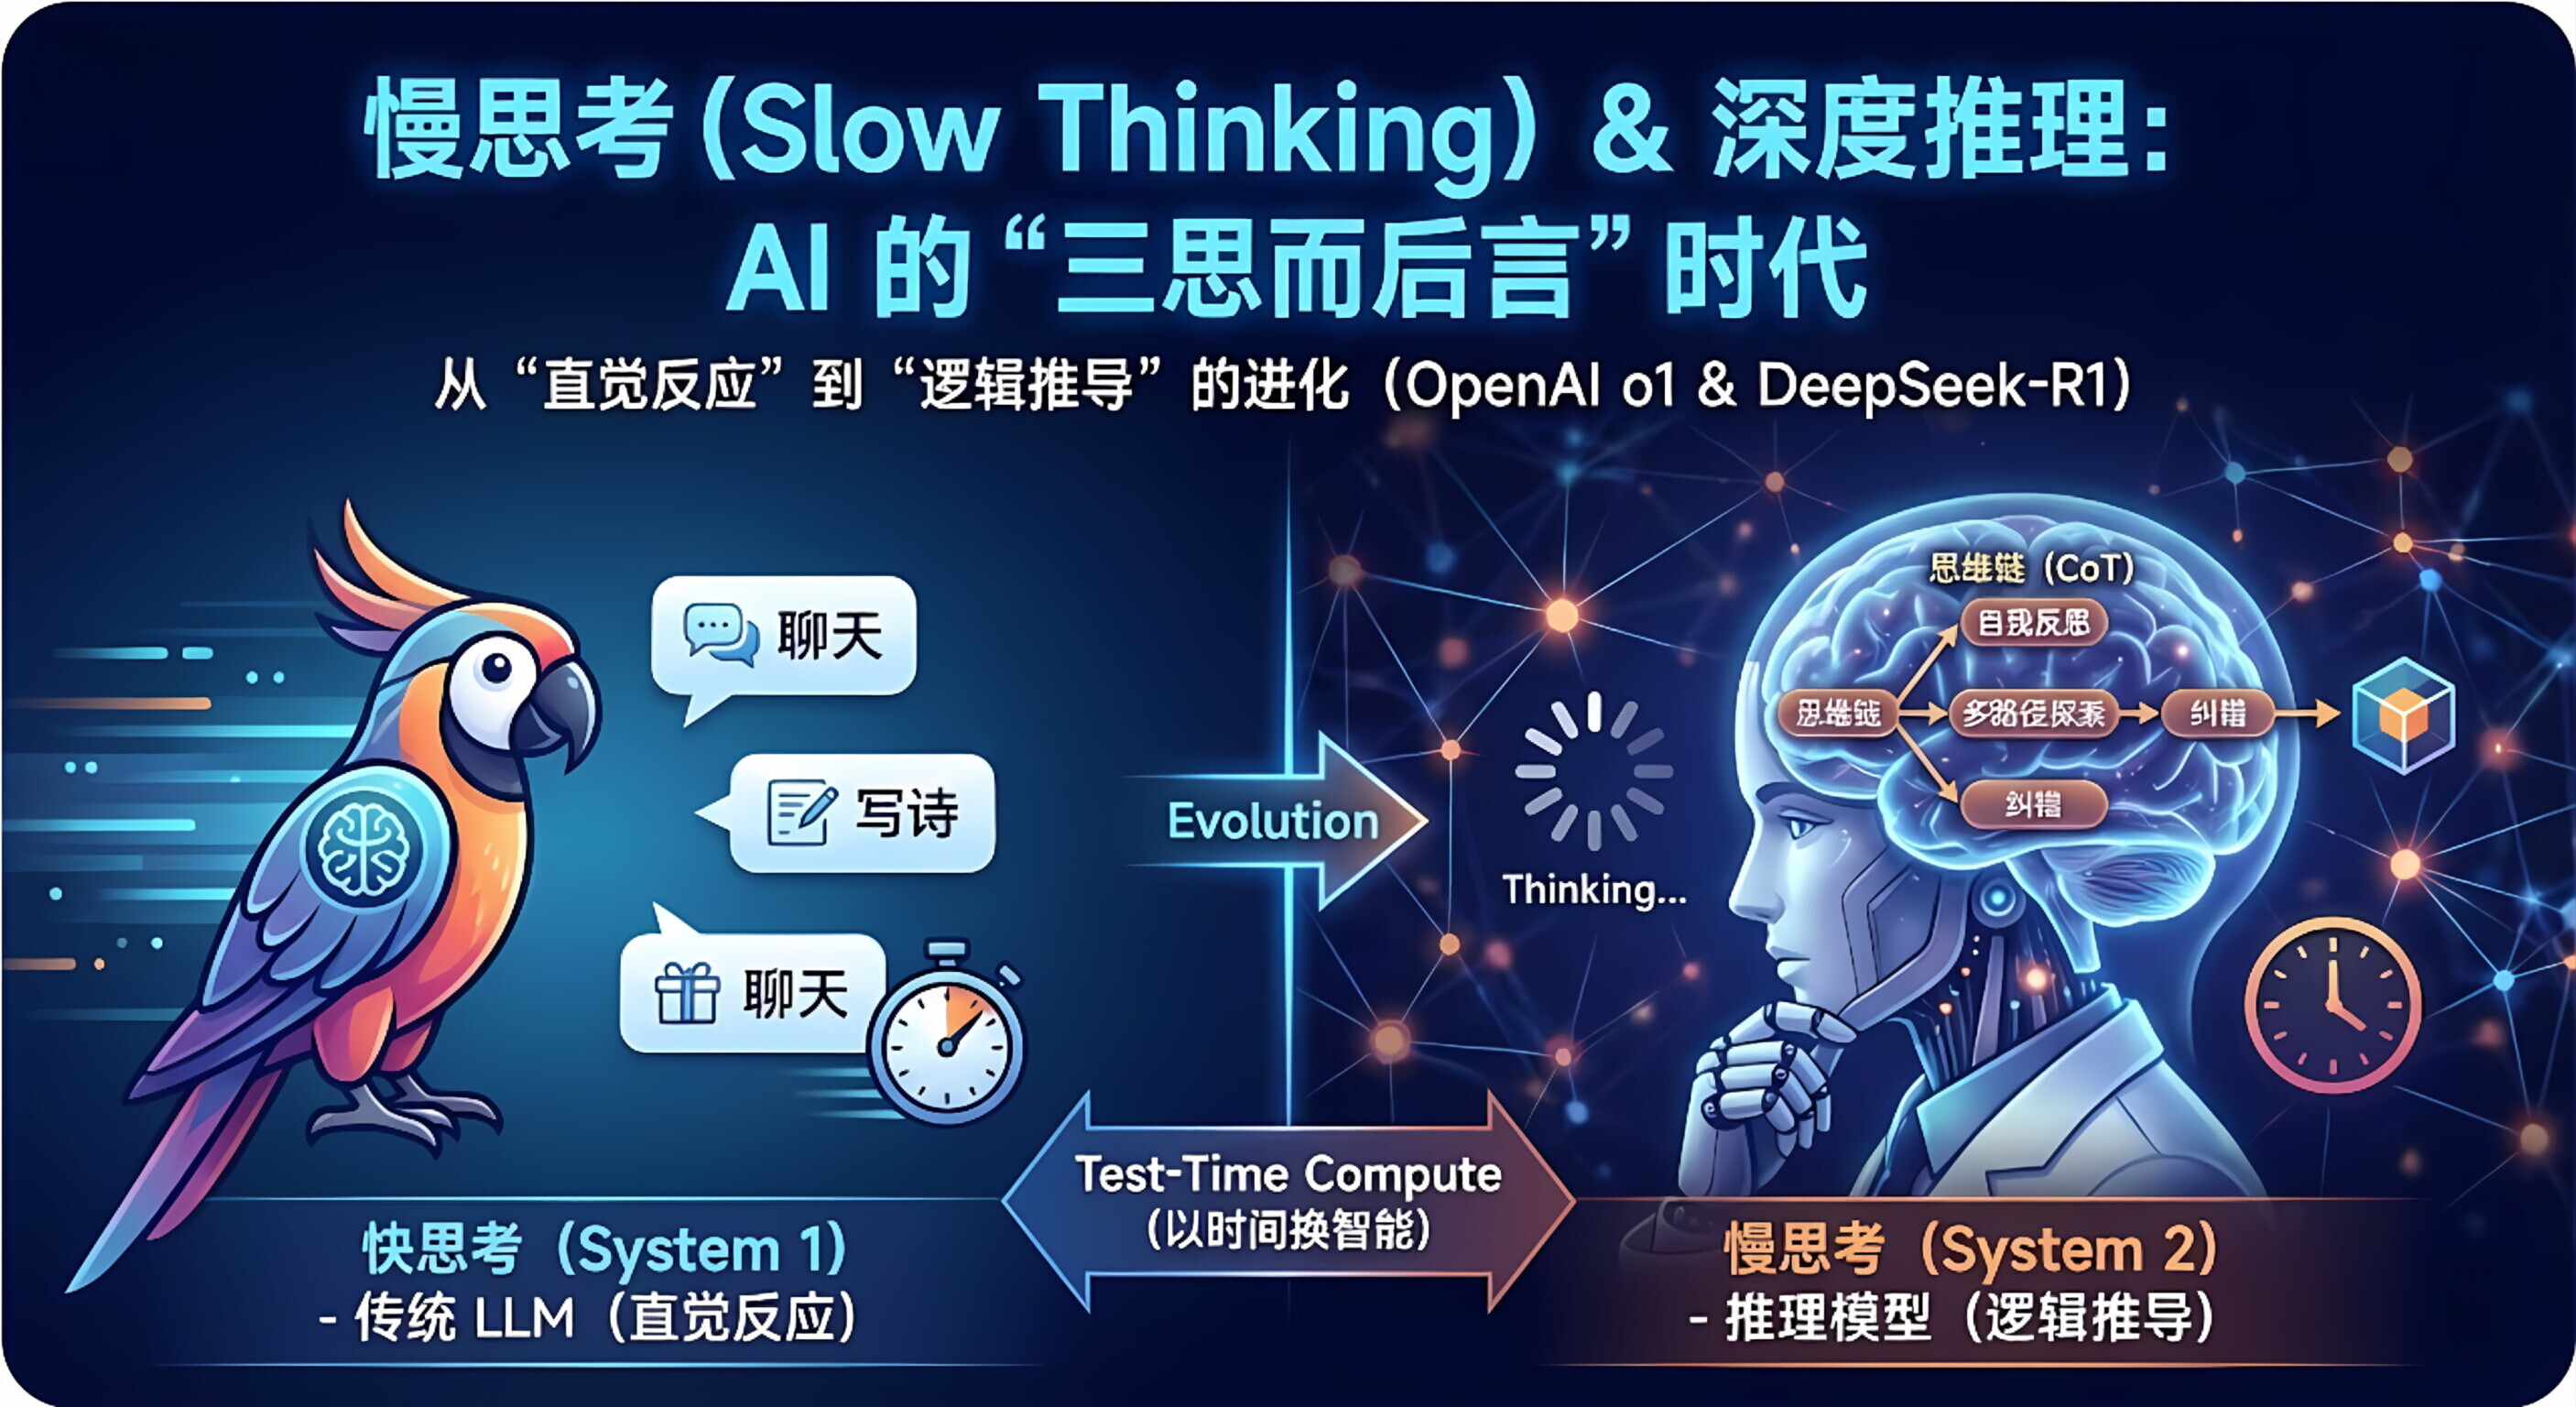
从心理学到AI:系统1与系统2的终极对决
要理解慢思考,我们不妨借用诺贝尔经济学奖得主丹尼尔·卡尼曼在《思考,快与慢》中的经典框架。他将人类认知分为两个系统:系统1(快思考)和系统2(慢思考)。这一模型如今完美映射到了大语言模型(LLM)的进化上。
传统LLM(如GPT-4o、Claude 3.5)更像系统1——它们依赖模式匹配和直觉,看到问题立即给出答案。例如,当你问“Python中如何用列表推导式生成平方数?”它会瞬间输出[x**2 for x in range(10)]。这种快速响应在简单任务上表现出色,但一旦遇到数学证明、复杂逻辑链或多步骤规划,它就容易“胡言乱语”,产生幻觉。
新一代推理模型(如o1、DeepSeek-R1)则模拟系统2——它们在回答前会进行内部推演、回溯和验证。想象一下,你让一个AI用Java实现一个红黑树,传统模型可能直接给出有缺陷的代码,而推理模型会在“脑海”中先模拟插入、旋转、变色等步骤,再输出经过验证的代码。这种“慢”不是延迟,而是智慧的沉淀。
⚙️ 技术解剖:推理时计算如何让AI“思考”?
慢思考背后的技术核心是Test-Time Compute(推理时计算),即模型在生成答案前,利用额外的计算资源进行“预演”。这并非简单的重复,而是包含三个关键机制:
- 思维链(Chain of Thought, CoT):模型被迫生成一段长长的“内心独白”,将问题分解为多个子步骤。例如,用Go语言编写一个并发爬虫时,它会先规划goroutine调度,再考虑channel通信,最后才写代码。
- 自我反思与纠错(Self-Correction):这是质的飞跃。传统模型一旦开头写错,就会将错就错;而推理模型能检测到矛盾,主动回溯。比如在调试JavaScript的异步回调时,它会发现“这里可能有竞态条件”,然后重新设计Promise链。
- 多路径探索(Search):模型会尝试多种解题路径,就像AlphaGo评估棋局一样。它会选择置信度最高的方案,甚至组合不同路径的优点。
值得注意的是,这些“思维Token”通常对用户不可见。当你看到ChatGPT的“Thinking...”状态栏时,它可能正在内部生成数千个Token来验证一个TypeScript类型定义的正确性。这就是用“时间”换“智能”的代价与回报。
| 特性 | 快思考 (标准 LLM) | 慢思考 (推理 LLM) |
| 响应速度 | 极快 (秒回) | 较慢 (可能思考 10-60 秒) |
| 工作模式 | 概率预测 (Next Token Prediction) | 强化学习搜索 (RL Search) + 验证 |
| 擅长任务 | 创意写作、聊天、摘要、翻译 | 数学竞赛、复杂代码、科学研究、逻辑谜题 |
| 用户体验 | 像一个博学的文科生 | 像一个严谨的理科教授 |
| 成本 | 较低 | 较高 (后台生成了大量看不见的 Token) |
快思考 vs. 慢思考:一张表看懂差异
为了让你更直观地理解两者的区别,我们来看下表。请注意,这里的关键不是“谁更好”,而是“谁更适合什么场景”。
如上表所示,快思考模型擅长即时响应,适合日常对话、文本摘要等低风险任务。而慢思考模型则专攻高难度推理,比如数学证明、代码生成与调试、复杂决策分析。例如,用Python处理一个涉及多表关联的SQL优化问题,推理模型会先分析执行计划,再考虑索引策略,最后给出完整方案,而非直接甩出一个可能低效的查询。
⚠️ 实践建议:如果你是开发者,在调用API时,应根据任务复杂度选择模型。简单代码补全(如JavaScript的变量命名)用快模型即可;但涉及架构设计或算法实现(如用Go编写分布式共识算法),务必启用推理模式。这样既能控制成本,又能保证质量。
Scaling Laws的新篇章:算力从训练转向推理
慢思考的兴起,标志着AI能力提升的范式转移。过去十年,我们依赖Training-Time Compute(训练时算力),即通过增加参数量、扩大数据集来提升模型能力。这就像培养一个学生,只靠多读书、多背书,但从不让他做难题。
而Inference-Time Compute(推理时算力)则完全不同——它允许模型在“考试”时多花时间思考。这意味着,一个70亿参数的小模型,经过专门的推理训练,可能在数学或代码任务上击败一个700亿参数的“死记硬背”大模型。这就像让一个普通学生带着草稿纸和计算器参加考试,反而可能超过天才。
技术延伸:对于开发者社区,这带来了新的优化思路。例如,在构建AI Agent时,你可以设计“多轮自我反思”的Prompt,让模型先输出初版答案,再让它用Python写一个单元测试来验证,最后修正。这种“手动慢思考”技巧,能有效提升现有API的推理能力,而无需等待下一代模型发布。
[AFFILIATE_SLOT_1]
️ 如何利用慢思考模型优化你的编程工作流?
既然理解了原理,你可能会问:这对我日常使用TypeScript、Java或JavaScript有什么实际帮助?答案是巨大的。以下三个场景能让你的效率倍增:
- 代码审查与重构:将旧代码片段粘贴给推理模型,它会分析潜在的反模式,并提出基于Java Stream API或TypeScript泛型的改进方案。它甚至能模拟运行,检查边界条件。
- 测试用例生成:要求模型为你的Python函数生成覆盖所有分支的pytest测试。推理模型会先枚举可能输入,再考虑异常路径,而不是只给出几个“快乐路径”用例。
- 跨语言迁移:如果你需要将一段Go代码转换为Java,慢思考模型会先理解原逻辑,再考虑Java的并发模型差异,而不是逐行翻译——那是早期机器翻译的水平。
✅ 注意事项:尽管慢思考强大,但它并非万能。对于事实性查询(如“法国首都是哪?”)或创造性写作(如“写首关于春天的诗”),快思考模型反而更自然、更经济。记住,推理是手段,不是目的。合理搭配,才能真正发挥AI的潜力。
结语:AI的“思考”时代已来
慢思考与深度推理,是AI从“语言模仿者”向“问题解决者”跃迁的关键一步。它让模型在数学、编程、科学等严谨领域表现出色,甚至能像人类科学家一样试错、反思。下一次,当你看到o1或DeepSeek-R1的“Thinking...”转圈时,请多一份耐心——那个AI正在为你“绞尽脑汁”,而这份“慢”,正是通往真正智能的必经之路。
[AFFILIATE_SLOT_2]


 浙公网安备 33010602011771号