在当今互联网技术架构中,Redis 凭借其卓越的性能和丰富的数据结构,已成为后端开发与微服务体系中不可或缺的一环。无论是作为高并发场景下的缓存层,还是实现分布式锁、实时排行榜等功能,Redis 都展现出强大的实力。本文将从零开始,为你梳理 Redis 的基础知识,助你快速上手这一热门的内存数据库。
为什么是 Redis?—— 初识分布式缓存利器
在传统的单体应用中,数据通常存储在关系型数据库中。然而,随着微服务架构的普及和用户量的激增,数据库面临的读写压力越来越大,磁盘 I/O 成为了性能瓶颈。此时,Redis 作为一款基于内存的键值对数据库,凭借其微秒级的响应速度,成为了解决这一痛点的绝佳方案。它就像一个位于应用和数据库之间的高速缓冲层,将热点数据存储在内存中,从而极大减轻了底层数据库的压力,提升了整个服务端的吞吐能力。
简单来说,Redis 不仅是一个缓存工具,更是一个功能齐全的数据结构服务器。它支持字符串、哈希、列表、集合等多种类型,能够灵活应对各种复杂的业务场景。在正式开始操作之前,我们先来了解一下分布式系统的基础概念,这有助于你更好地理解 Redis 在架构中的位置。
分布式系统是由多台独立计算机(节点)通过网络连接,无 中央大脑 却能按规则协同完成任务的系统,核心是用多节点分工合作突破单机瓶颈。
它最突出的优势有三点:
- 一是水平扩容,无需更换高端服务器,增加普通节点即可承载海量数据与访问,成本灵活;
- 二是高可用,数据和任务分散存储,单个节点故障不影响整体服务,容错性强;
- 三是高性能,多节点并行处理任务,效率远超单机串行运算。
其核心难题是数据一致性,网络延迟、节点故障易导致数据不同步,需依赖专门算法解决。如今广泛应用于电商高并发、云盘存储、大数据分析等场景,是支撑互联网服务的重要基石。
环境准备:Redis 的安装与启动
要开始使用 Redis,第一步自然是完成安装。无论是本地开发环境还是生产服务器,安装过程都相对简单。在 Linux 或 macOS 系统下,我们可以通过包管理器轻松完成安装。
ubuntu执行以下命令即可完成安装:
apt install redis安装过程结束后,Redis 服务通常会自动启动。你可以通过以下命令验证 Redis 服务是否正在运行:
redis查看服务状态:

是 客户端-服务器程序
自定义配置与重启
默认情况下,Redis 的配置文件位于安装目录下,文件名为 redis.conf。在实际生产环境中,我们通常需要根据服务器资源调整配置,例如设置密码、修改端口或调整内存策略。
Redis修改完配置文件后,必须重启 Redis 服务才能使改动生效。重启命令如下:
service redis-server restart核心数据结构:不仅仅是 Key-Value
Redis 采用客户端-服务器(C/S)模式,我们通过 Redis 命令行客户端来发送指令。在终端中输入 redis-cli 命令,即可连接到本机的 Redis 服务。
redis-cliRedis 作为 NoSQL 数据库,其数据模型是键值对(Key-Value)。其中,Key 永远是字符串类型,而 Value 则支持多种丰富的数据结构,以满足不同的业务需求:
- String(字符串):最基础的类型,可用于存储用户信息、计数器等。
- Hash(哈希):适合存储对象,如商品详情、用户资料。
- Set(集合):无序去重的集合,适合做标签、去重统计。
- List(列表):有序可重复的列表,适合做消息队列、时间线。
- ZSet(有序集合):带权重的集合,适合做排行榜、延迟队列。
redis通用命令实战:掌握数据操作的基本功
了解数据结构后,我们来看看最常用的通用命令。这些命令是操作 Redis 的基础,也是日常开发中与缓存交互的核心 API。
1. set 与 get:读写数据
set 命令用于存储键值对,get 命令用于获取数据。这是最基础的操作。
set key value
get key
设置一个 Key 为 name,Value 为 tom 的数据:
set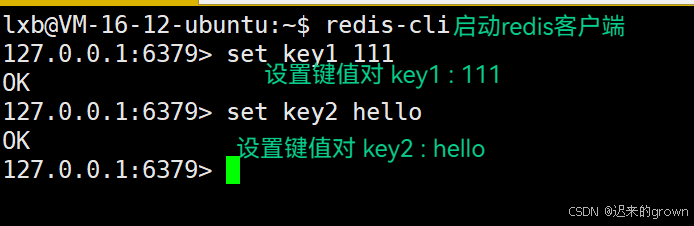
获取该 Key 对应的 Value:
get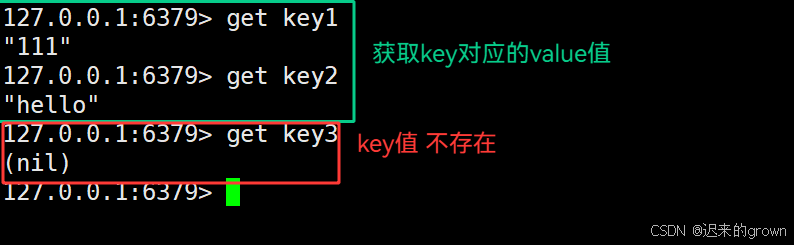
2. keys:模式匹配查找
当 Key 数量增多时,我们需要根据模式来查找 Key。keys 命令支持通配符匹配。
keys pattern
- : 匹配任意一个字符
- : 匹配任意多个字符
- : 匹配中的任意一个字符
- : 匹配除以外的所有字符
- : 匹配中的任意一个字符
查看当前库中的所有 Key:
keys *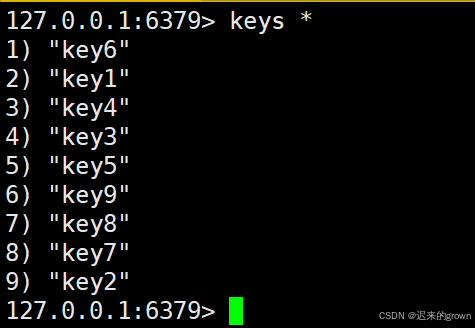
匹配指定前缀的 Key(如 key1):
keys key?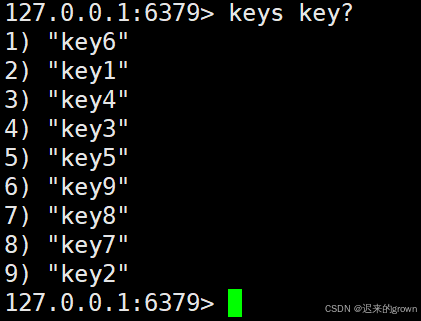
匹配包含特定字符的 Key(如 key1 和 key2):
keys key[12]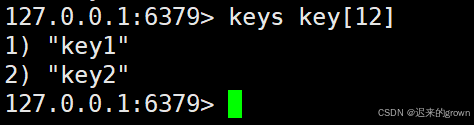
排除特定 Key 进行匹配:
key key[^1]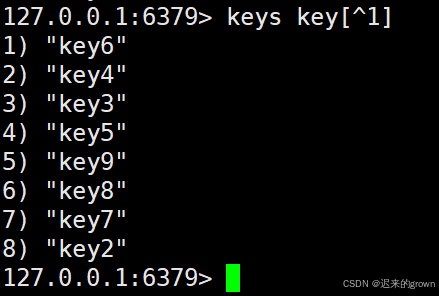
匹配区间范围内的 Key(如 key1 至 key4):
keys key[2-4]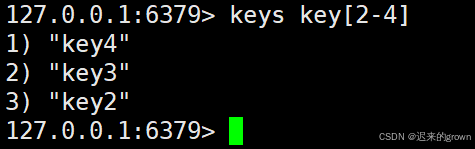
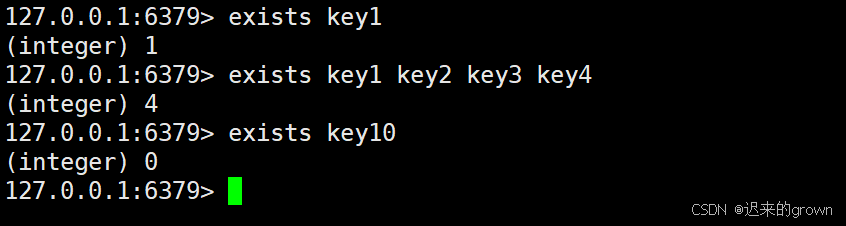
3. exists:检查 Key 是否存在
在业务逻辑中,我们经常需要判断某个 Key 是否存在,以避免重复写入或读取空值。
exists key [key...]该命令支持同时判断多个 Key,返回值是存在的 Key 的数量。
4. del:删除键值对
删除不再使用的数据是保持缓存干净的重要操作。del 命令可以删除一个或多个 Key。
del key [key...]返回值表示实际删除成功的键值对数量。
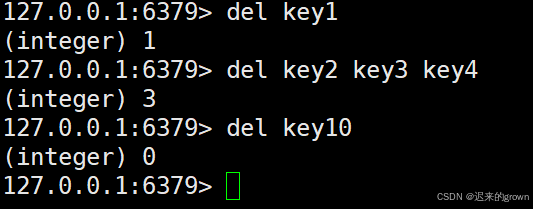
5. expire 与 ttl:管理 Key 的生命周期
为 Key 设置过期时间是 Redis 的一大亮点,特别适合处理验证码、限时优惠等场景。
expire key seconds [NX|XX|GT|LT]设置 Key 在 10 秒后过期:
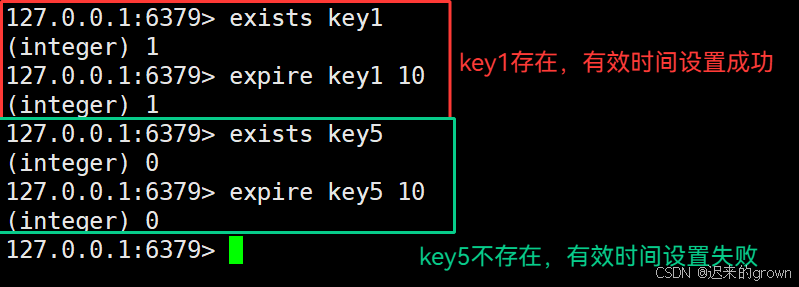
- : 键值不存在时才设置
- : 键值存在时,才进行设置
- : 大于当前过期时间时,才进行设置
- : 小于当前过期时间时,才进行设置
通过 ttl 命令可以查看 Key 剩余的存活时间。
ttl key返回值有三种情况:
- 大于 0:表示 Key 剩余的有效秒数。
- -1:表示 Key 存在,但未设置过期时间。
- -2:表示 Key 不存在。
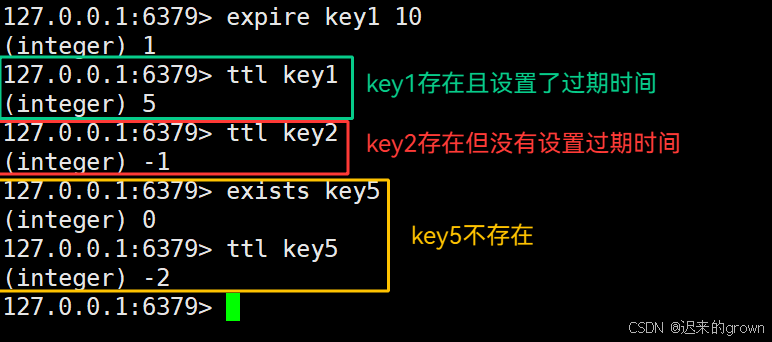
6. type:查看数据类型
由于 Redis 的 Value 类型多样,在开发中我们可能需要确认某个 Key 存储的是哪种类型。
type key中是字符串类型,而支持多种数据类型:
、、、等等
进阶探索:内部编码与单线程架构
虽然我们通过命令操作的是 String、List 等数据类型,但在 Redis 内部,为了节省内存和提升效率,会根据实际情况采用不同的内部编码实现。
- String:可能使用
int、embstr或raw编码。 - Hash:可能使用
ziplist或hashtable编码。 - List:可能使用
ziplist或linkedlist编码。 - Set:可能使用
intset或hashtable编码。 - ZSet:可能使用
ziplist或skiplist编码。
这种设计对开发者是透明的,但能让 Redis 在不同场景下发挥最佳性能。例如,当列表元素较少且长度较短时,使用 ziplist 可以显著节省内存;当数据量增大时,会自动转换为更适合的编码结构。
type另一个值得关注的设计是 Redis 的单线程模型。Redis 的核心业务逻辑(接收命令、解析、执行、返回)是由一个单线程完成的。这并非性能瓶颈,反而避免了多线程上下文切换和锁竞争带来的开销,使得 Redis 在纯内存操作下能达到极高的吞吐量。
采用单线程架构,那为什么还这么快?
- 的所有数据都存储在内存当中,内存的读写速度快
- 采用单线程架构,减少了线程上下文切换、锁竞争的开销
- 采用 IO多路复用 解决单线程的IO阻塞问题
结语:打好基础,迈向高并发架构
本文从安装配置、核心数据结构到常用命令,为你梳理了 Redis 的入门知识。掌握这些基础,你就已经具备了在日常项目中使用 Redis 进行缓存读写、数据管理的能力。在后续的微服务架构设计中,Redis 还将与 API 网关、数据库等组件深度协同,发挥更大的价值。希望这篇教程能成为你探索 Redis 世界的坚实起点。
实践建议:技术的学习离不开动手操作。建议你搭建一个本地环境,逐一敲一遍上述命令,观察返回结果,这比单纯阅读文章印象会深刻得多。
延伸思考:在理解了基础操作后,你可以进一步思考缓存穿透、缓存击穿、缓存雪崩等经典问题,以及 Redis 持久化机制(RDB 和 AOF)的适用场景,这些都是后端架构师进阶的必经之路。
Redis?*[az]{'a', 'z'}[^a]a[a-z]['a', 'z']NXkeyXXkeyGTLTrediskeyValuestringhashlistsetredisredisredisredisredis


 浙公网安备 33010602011771号