深度学习作为AI领域的核心驱动力,正深刻改变着图像识别、自然语言处理等技术的面貌。本文为你梳理一条从PyTorch基础到神经网络、CNN及NLP的完整学习路径,帮助你快速建立知识框架。
一、深度学习与机器学习:核心差异
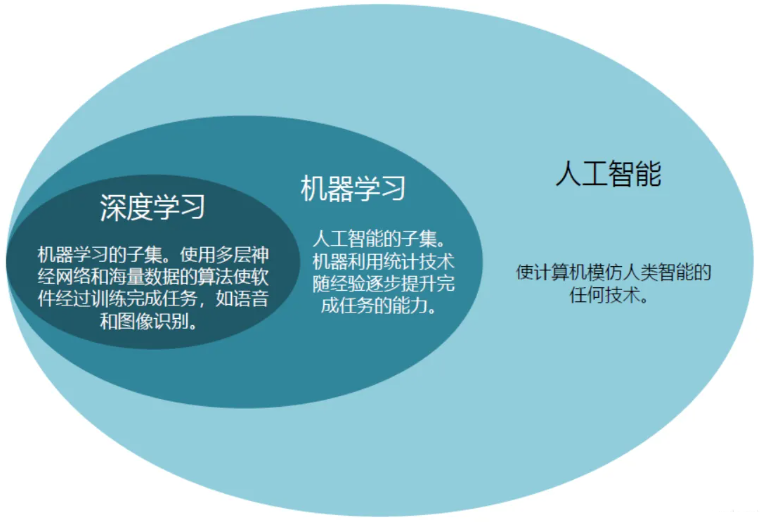
深度学习(Deep Learning)属于机器学习的一个子类,其灵感源自人类大脑的工作机制,通过构建包含多个隐含层的深度神经网络来自动提取数据特征。它与传统机器学习的主要区别体现在以下几个方面:
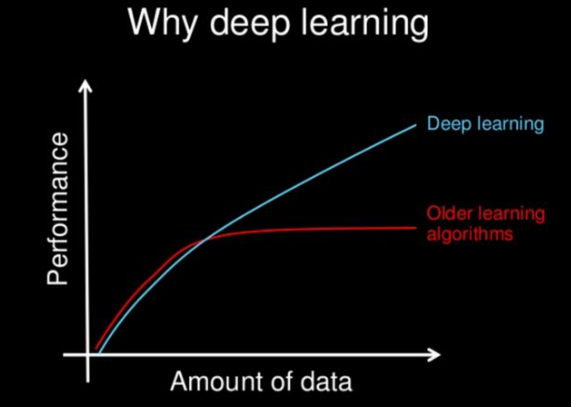
- ✅ 数据依赖性:深度学习在数据规模庞大时性能优势明显,而机器学习在数据量较小时表现更佳。
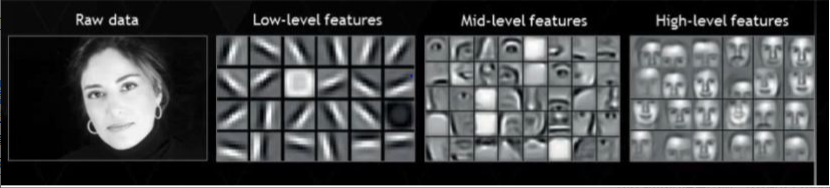
- ✅ 特征处理:机器学习依赖专家手动设计特征;深度学习则尝试从原始数据中直接学习高级特征,例如卷积神经网络(CNN)会先从边缘、线条等低级特征开始,逐步学习到人脸等高级描述。
- ✅ 执行时间与可解释性:深度学习因参数众多、数据量大,训练耗时更长,且其预测结果难以解释;机器学习则规则明确,可解释性强。
二、PyTorch入门:Tensor与自动微分
PyTorch是目前最流行的深度学习框架之一,其核心数据类型是Tensor(张量),可以理解为NumPy数组的增强版,并支持GPU加速。Tensor的创建方法多样,且支持丰富的数学运算、线性代数运算以及连接、切片和变形操作。
PyTorch的"前世今生":
- PyTorch的前身是Torch,但因Torch采用了小众的编程语言是Lua,所以流行度不高,这也就有了PyTorch的出现
- PyTorch主要由Facebook的人工智能小组开发
安装PyTorch相对简单,CPU版本可通过pip命令快速完成。
import torch
print(torch.__version__) # 1.11.0+cpu
import torchvision
print(torchvision.__version__) # 0.12.0+cpu
注意:
本课程安装的torch版本是‘1.11.0+cpu’,torchvision版本是'0.12.0+cpu',经测试环境稳定。
GPU版本的安装则需要配置CUDA和cuDNN等加速库,对电脑硬件有一定要求。
比较:
- 标量是只有大小没有方向的量,如1、2、3等;
- 向量是既有大小又有方向的量,如u=(2,5,8);
- 矩阵是由多个向量组成的数表;
- 而标量、向量、矩阵都是张量的特例: 标量是零维张量、向量是一维张量、矩阵是二维张量。 张量还可以向更高维推广。
Tensor的常用创建方法及运算代码如下:
import torch
a = torch.Tensor(2,4) # 创建一个2x4的矩阵Tensor
b = torch.DoubleTensor(2,3,4) # 创建2x3x4的64位浮点数Tensor
c = torch.zeros(2,4) # 创建全0的Tensor
d = torch.ones(2,4) # 创建2x4的全1的Tensor
e = torch.eye(3) # 创建3x3的单位矩阵Tensor
x = torch.rand(2,4) # 创建2x4的数据为区间[0,1)的随机数的Tensor
y = torch.arange(1,4) # 创建在指定区间(不包括结尾数)的一维Tensor
z = torch.arange(1,4,0.5) # 第三个参数指定步长
import torch
a = torch.Tensor([[1,2,3],[4,5,6]])
b = torch.ones(2,3)
b.add(a) # 直接使用Tensor实例调用数学操作方法
torch.add(a,b) # 使用torch库的方法
b.add_(a) #注意:该方法带有下划线,此时返回值将覆盖对象(张量b被结果覆盖)
a + b # 使用加法运算符直接相加
#  还可以让Tensor中的每个元素都加上同一个标量
a = torch.rand(3)
a + 2  # 第一种方式
torch.add(a,2) # 第二种方式
a.add(2) # 第三种方式
# 返回Tensor中每个元素的绝对值
torch.abs(torch.Tensor([[-5,-4,-3],[-3,-2,-1]]))
# 对Tensor中的每个元素向上取整
a = torch.Tensor([0.2,1.5,3.4])
torch.ceil(a)
# 返回Tensor中每个元素的以e为底的指数
torch.exp(torch.Tensor([1,2,3]))
# 返回Tensor中所有元素的最大值
torch.max(torch.Tensor([1,2,3]))
import torch
# 向量与向量的点积(内积)
a = torch.Tensor([1,2,3])
b = torch.Tensor([2,3,4])
torch.dot(a,b) # 第一种方式
a.dot(b) # 第二种方式
# 矩阵与向量的乘法
a = torch.Tensor([[1,2,3],[2,3,4],[3,4,5]])
b = torch.Tensor([1,2,3])
torch.mv(a,b) # 第一种方式
a.mv(b) # 第二种方式
# 两个矩阵相乘
a = torch.Tensor([[1,2,3],[2,3,4],[3,4,5]])
b = torch.Tensor([[2,3,4],[3,4,5],[4,5,6]])
torch.mm(a,b) # 第一种方式
a.mm(b) # 第二种方式
# 转置矩阵
a = torch.rand(2,2)
torch.t(a) # 返回a的转置矩阵
a.T # 调用T属性
import torch
# 连接
a = torch.rand(2,2)
b = torch.rand(2,2)
torch.cat((a,b),0) # 在0维度(垂直方向)上连接
torch.cat((a,b),1) # 在1维度(水平方向)上连接
# 切片
c = torch.rand(2,4)
torch.chunk(c,2,1) # 将张量c按第二个维度切分为两块
# 使用view( )变形
x = torch.rand(2,3,4)
x.size()
y = x.view(2,12)
y.size()
z = x.view(-1,1) # -1参数代表该维度数目自动计算
z.size() 自动微分(Autograd)是PyTorch优化神经网络的核心。它将复杂计算抽象为计算图,并自动计算梯度。Tensor中与自动微分相关的三个重要属性是:requires_grad(是否需要梯度)、grad(存储梯度值)和grad_fn(存储梯度函数)。
注意:
- 当叶子节点的requires_grad为True时,信息流经过该节点时,所有中间节点的
requires_grad属性都会变成True
只要在输出节点调用反向传播函数backward( ),PyTorch就会自动求出叶子节点
的微分值并更新存储在叶子节点的grad属性中。需要注意的是,只有叶子节点的grad属性能被更新
三、神经网络基础:从感知器到反向传播
人工神经网络(ANN)通过模拟生物神经元的连接方式对输入输出关系建模。全连接神经网络是其中结构最简单的一种,某一层的每个节点都与上一层所有节点相连。感知器作为单层神经网络,是构成网络的最小单元。
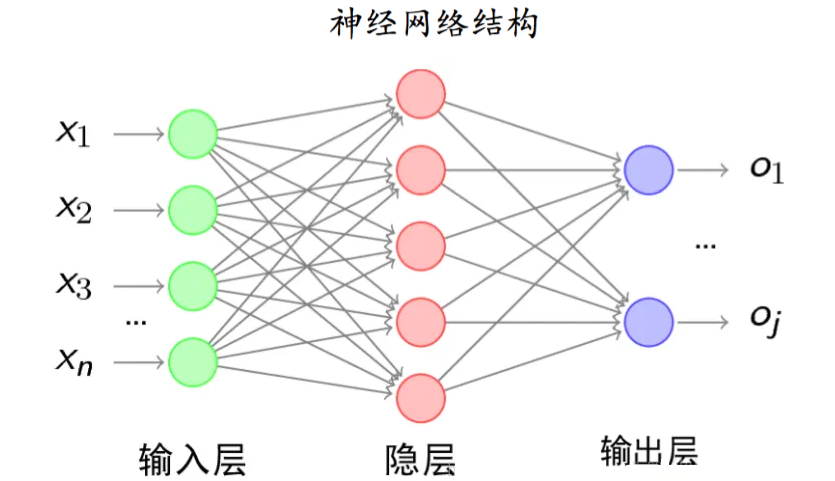
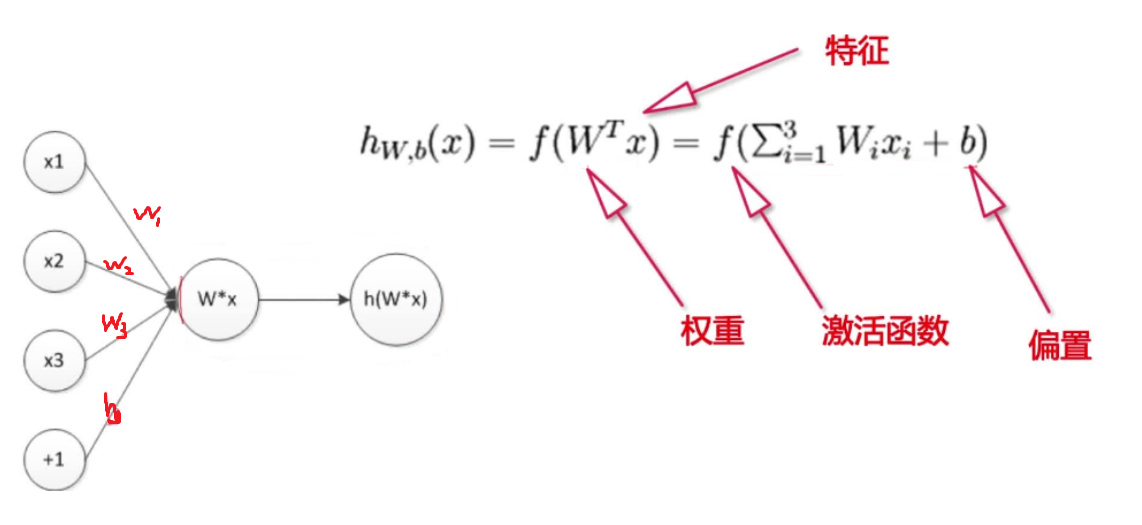
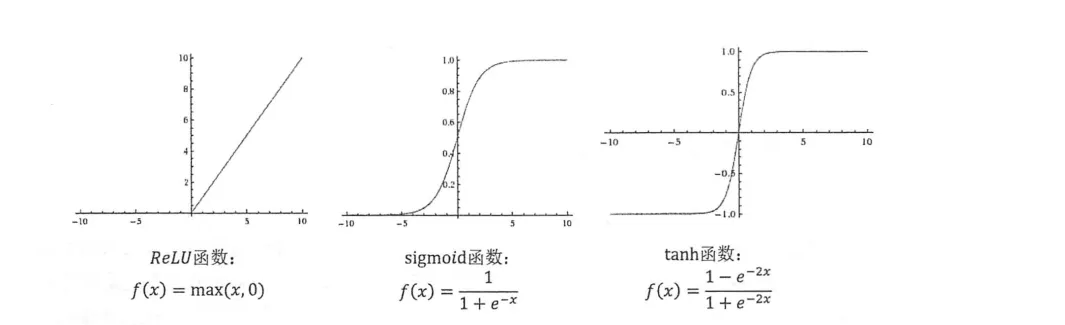
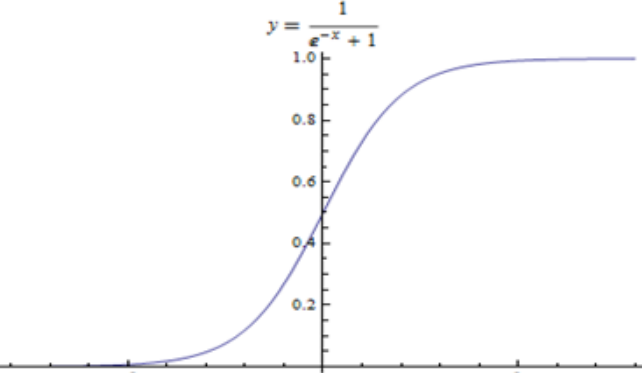
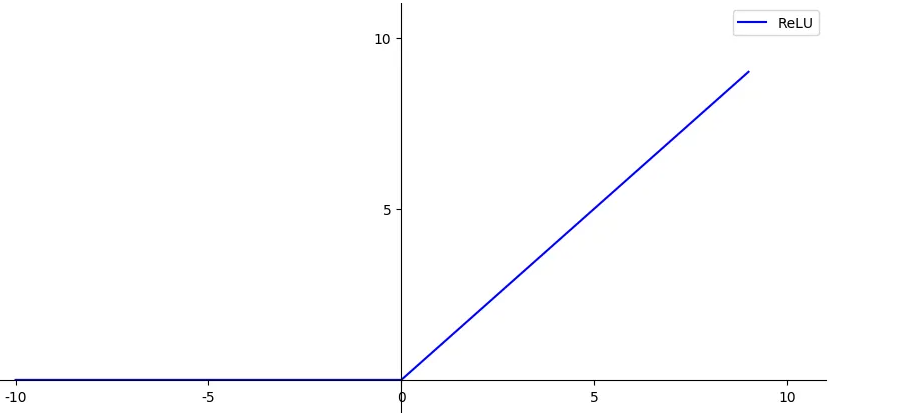
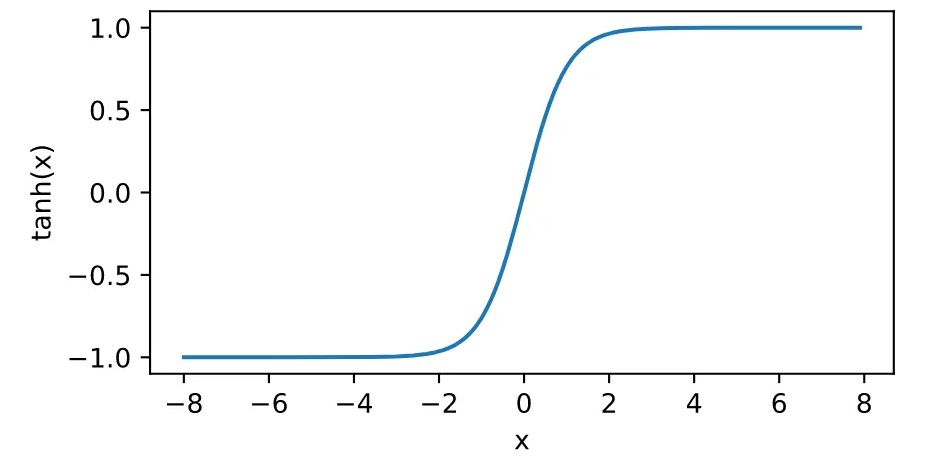
为了提升模型的非线性表达能力,需要引入激活函数。常见的激活函数包括:
- Sigmoid:将输出压缩到(0,1)区间。
- ReLU:
y=max(0,x),计算简单,能有效缓解梯度消失。 - Tanh:将输出映射到(-1,1)区间。
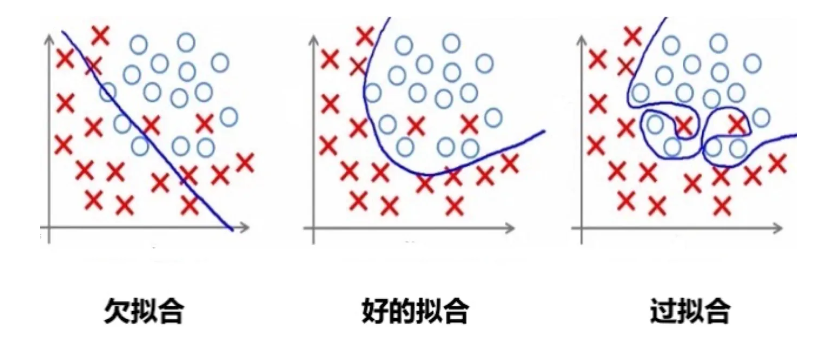
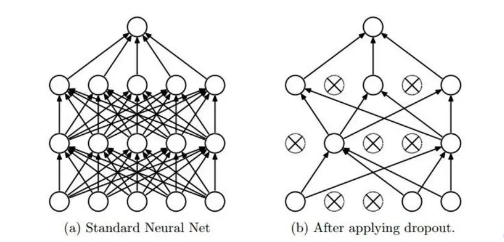
⚠️ 网络层数加深容易引发过拟合问题,即模型在训练集上表现优异,但在测试集上泛化能力差。常用的解决方法包括正则化(如L1、L2)和Dropout(随机失活神经元)。
注意:
- 对于不同神经元个数的神经网络层,可以设置不同的失活或保留概率
- 如果担心某些层所含神经元较多或比其他层更容易发生过拟合,则可以将该层的失活概率设置得更高一些
前向传播是计算网络输出的过程,而反向传播(BP)则通过计算输出与真实值的损失,逐层调整网络参数。PyTorch通过调用backward()方法即可自动完成梯度计算。
import torch
x = torch.ones(2)
# 在前向传播时就应该修改该属性值,目的是在反向传播时可以自动计算微分
x.requires_grad = True
# 可以查看此时x的grad、grad_fn属性,均没有值
z = 4 * x  # 向量与实数相乘
y = z.norm() # 求z向量的长度
print(y)
y.backward() # 调用输出节点的backward()方法对整个图进行反向传播
print(x.grad) # 此时x向量的grad属性已更新为x向量的微分值实战:线性回归与多分类
使用PyTorch实现线性回归和多分类任务,核心步骤包括定义网络模型、选择损失函数和优化器。对于多分类问题,通常在输出层使用Softmax函数将得分转换为概率分布。
from torch import nn,optim
class LR(nn.Module):  # 神经网络模型需要继承nn.Module类
  def __init__(self):
    super(LR,self).__init__() # 先调用父类的构造方法
    self.linear = nn.Linear(in_features=1,out_features=1)
  def forward(self,x): # 前向传播方法,x参数接收输入特征
    out = self.linear(x) # 线性加权操作
    return out
criterion = nn.MSELoss() # 训练数据集均方误差作为损失函数
# 随机梯度下降优化器
optimizer = optim.SGD(LR_module.parameters(),lr=1e-4)
import torch.nn.functional as F
from torch import nn,optim
# 构建神经网络类
class Net(nn.Module):
  def __init__(self,input_feature,num_hidden,outputs):
    super(Net,self).__init__()
    # 从输入层到隐层的线性加权
    self.hidden = nn.Linear(in_features=input_feature,out_features=num_hidden)
    # 从隐层到输出层的线性加权
    self.out = nn.Linear(in_features=num_hidden,out_features=outputs)
  def forward(self,x): # 前向传播
    temp1 = F.relu(self.hidden(x))# 从输入层到隐层,添加relu函数
    temp2 = self.out(temp1) # 从隐层到输出层的线性加权
    results = F.softmax(temp2) # 对线性加权结果使用Softmax函数
    return results
criterion = nn.CrossEntropyLoss() # 交叉熵损失函数
# 随机梯度下降法优化器
optimizer = optim.SGD(net.parameters(),lr=0.02)四、卷积神经网络(CNN)与经典架构
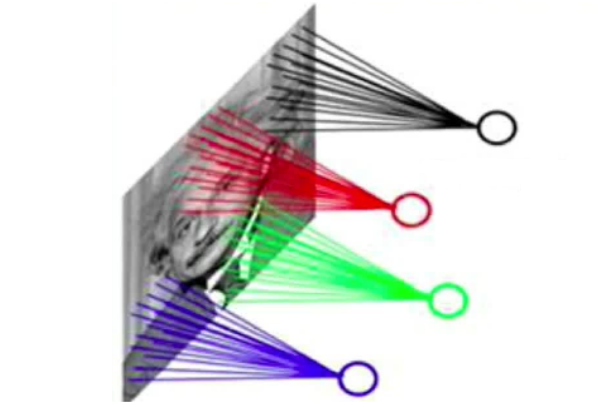
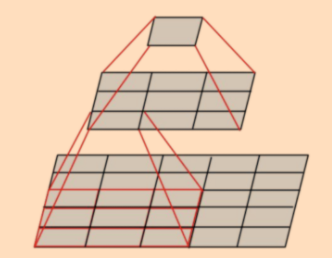
卷积神经网络(CNN)是图像识别领域的里程碑。它通过局部连接和参数共享大幅减少了参数数量,并利用卷积核提取图像的层级特征。
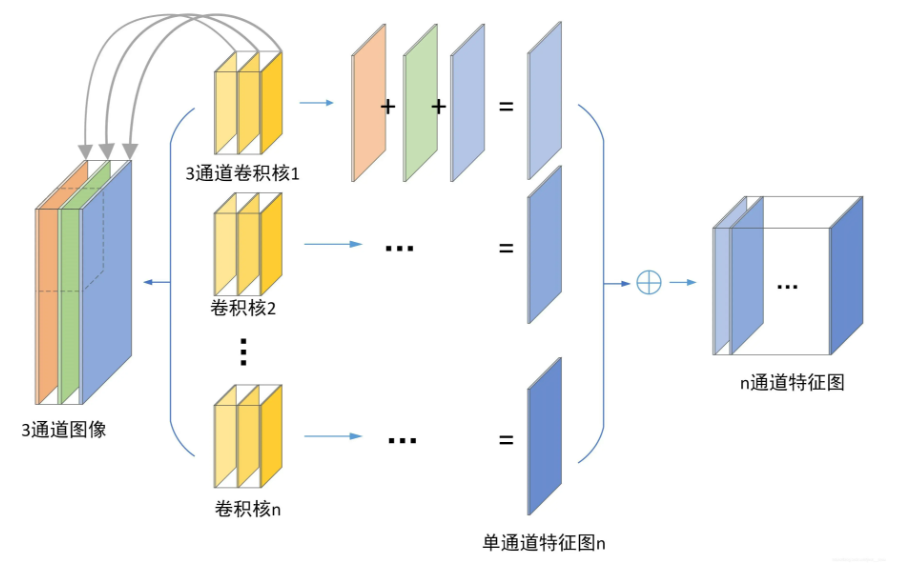
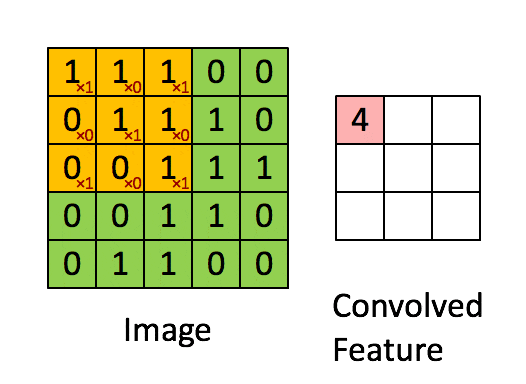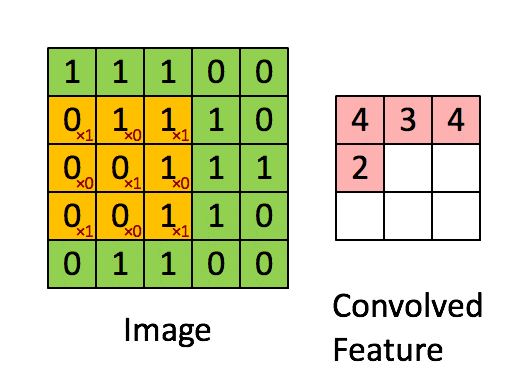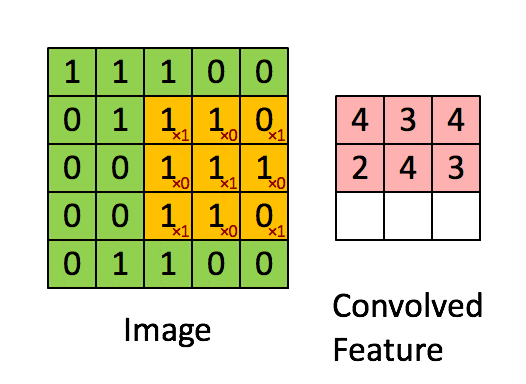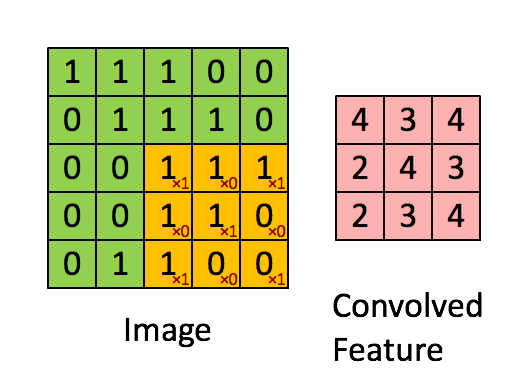
注意:
- 卷积核的通道数与输入数据的通道数相同
- 卷积核的个数与输出的通道数相同
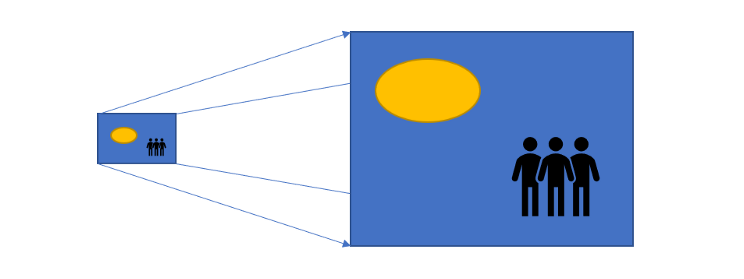
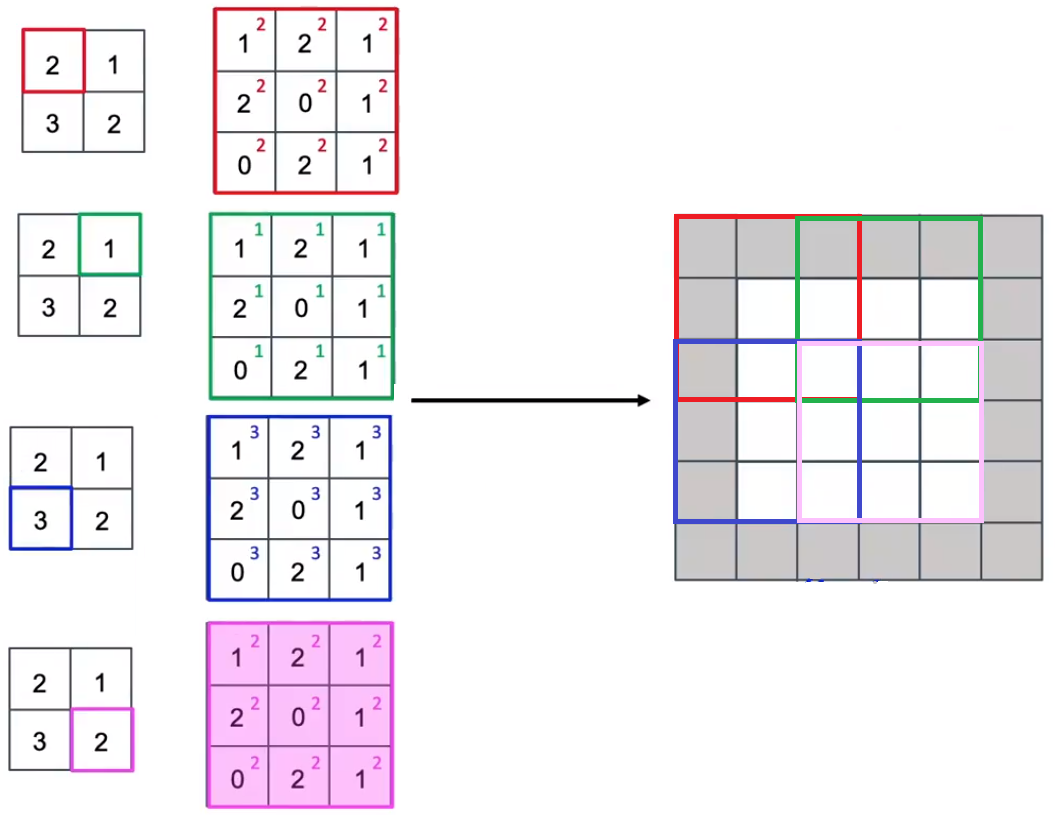
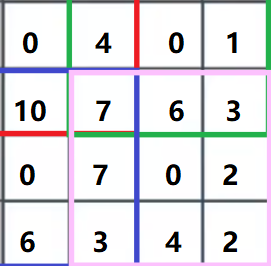
Padding(填充)用于解决边缘像素参与计算次数少的问题,卷积输出尺寸的计算公式为:(n+2p-f)/s+1。池化(Pooling)则通过下采样减小数据尺寸,常见的有最大值池化和平均值池化。反卷积(转置卷积)则用于从特征中还原图像。
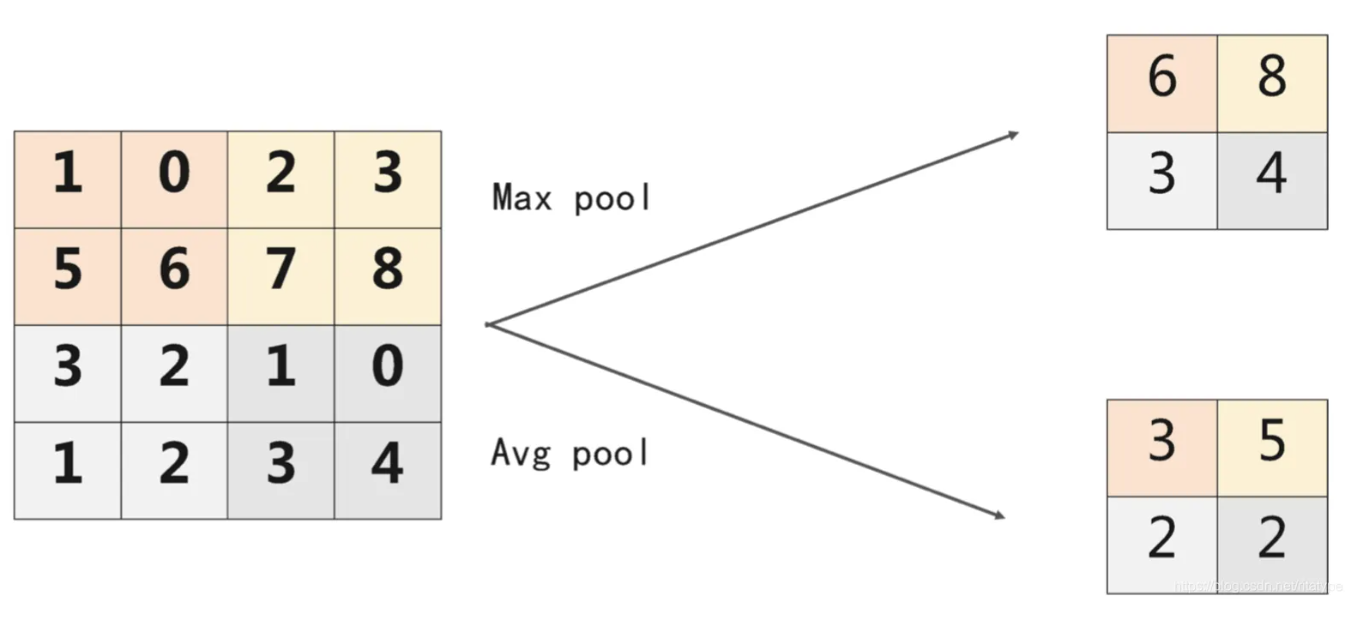
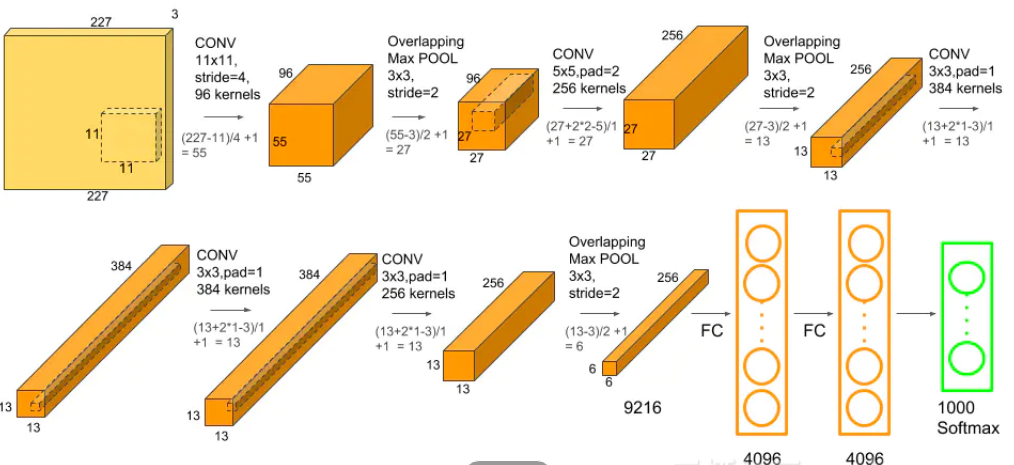
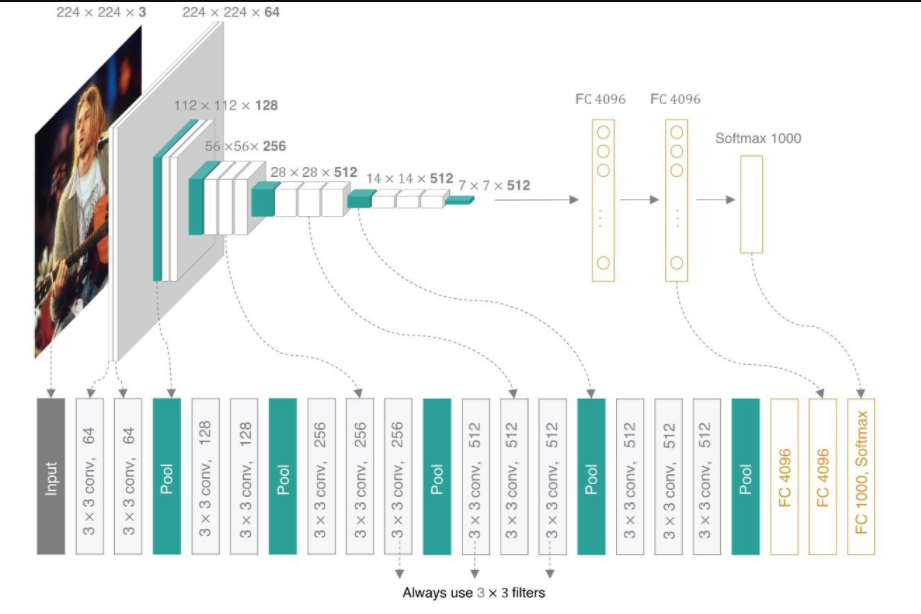
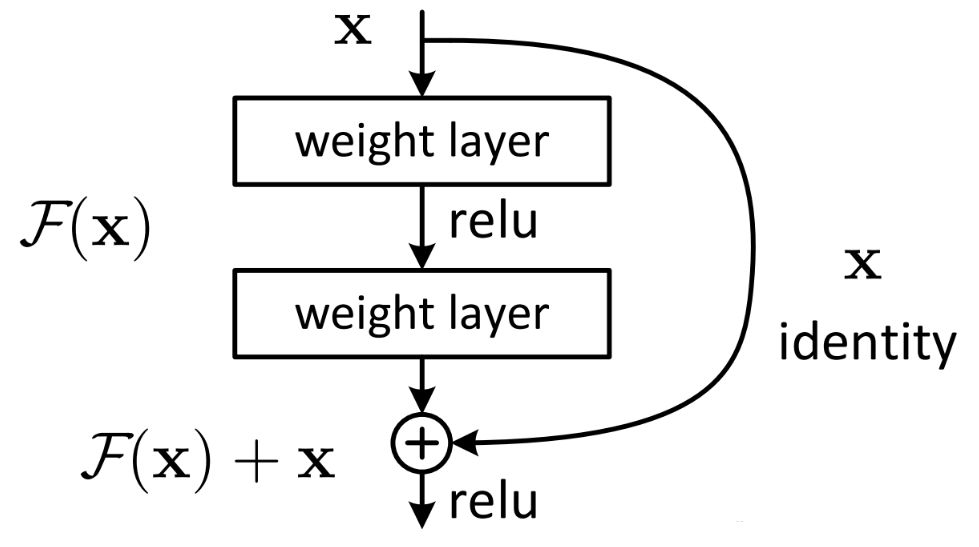
经典CNN架构中,AlexNet赢得了2012年ImageNet竞赛,确立了CNN在视觉领域的地位;VGGNet证明了堆叠小卷积核(3x3)可以在减少参数的同时增加网络深度;ResNet通过引入残差连接(shortcut connection)解决了深层网络的“退化”问题。
五、迁移学习与生成对抗网络(GAN)
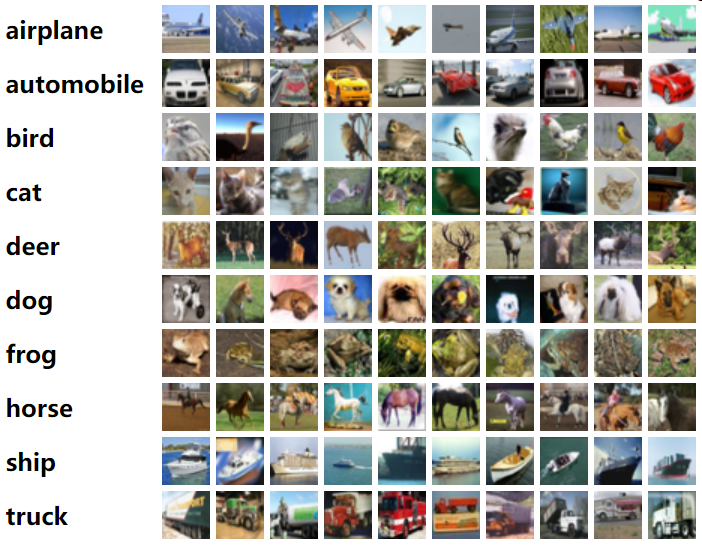
迁移学习允许我们将在大规模数据集(如ImageNet)上预训练好的模型应用到新的任务中,极大地降低了训练成本和时间。例如,使用预训练的AlexNet进行图片识别就是典型的迁移学习实战。
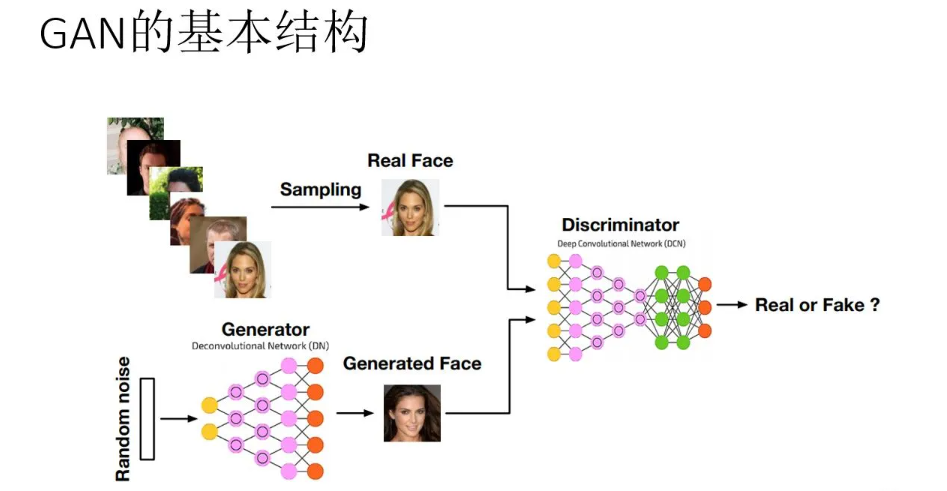
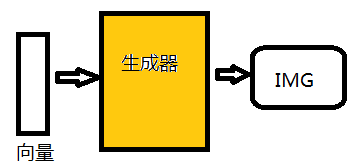
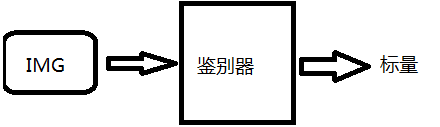
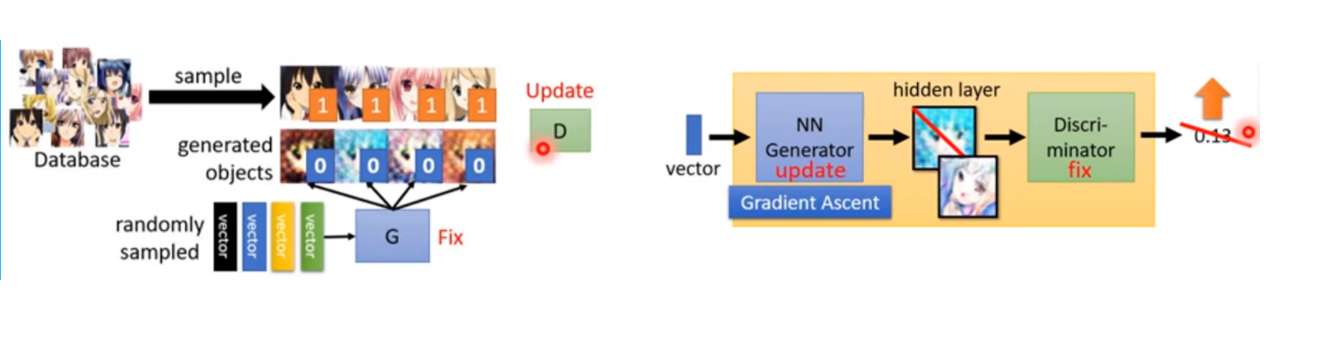
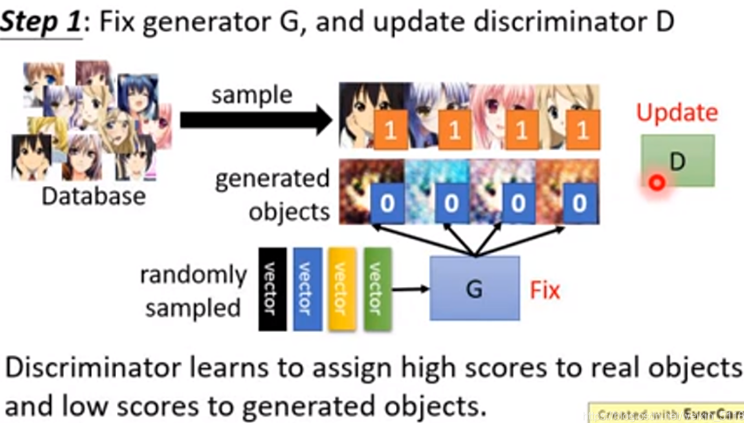
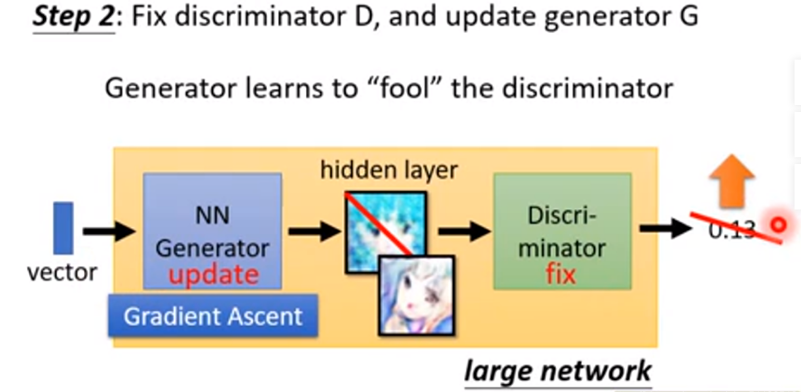
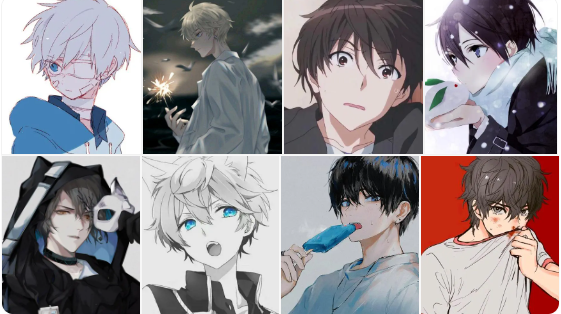
生成对抗网络(GAN)由生成器和判别器组成,通过对抗训练生成以假乱真的数据。GAN在图像生成领域应用广泛,例如生成二次元头像。TorchGAN等框架进一步简化了GAN的实现。
 [AFFILIATE_SLOT_1]
六、目标检测与循环神经网络(RNN)
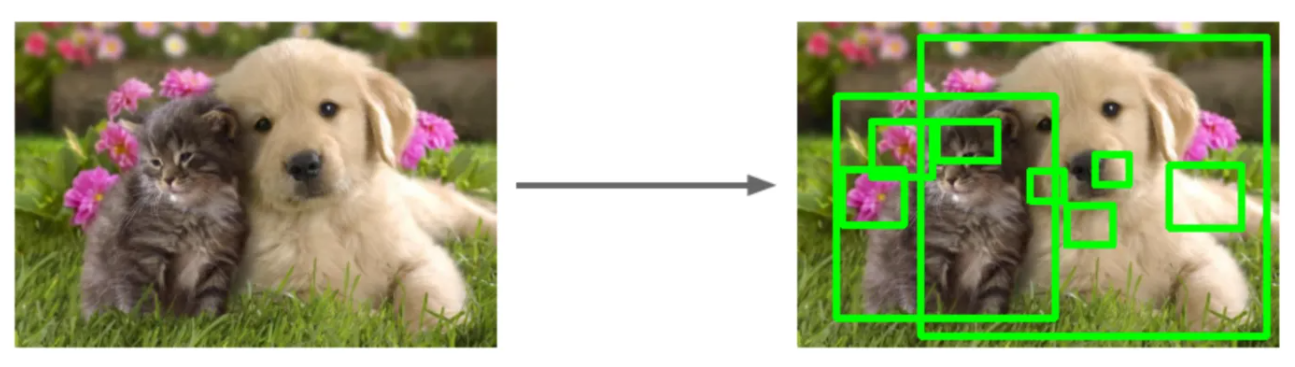
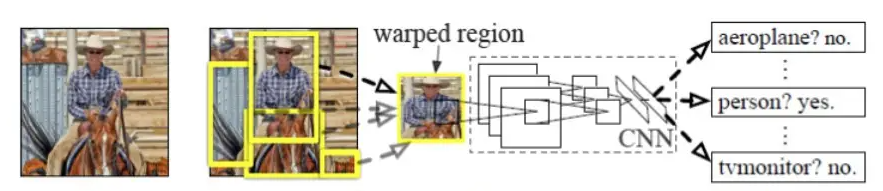
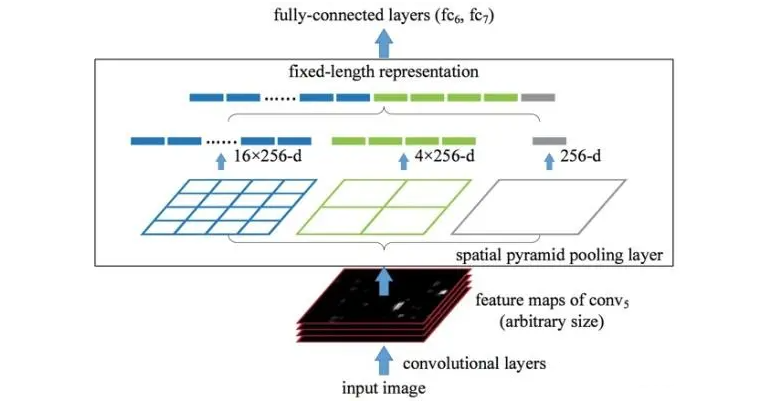
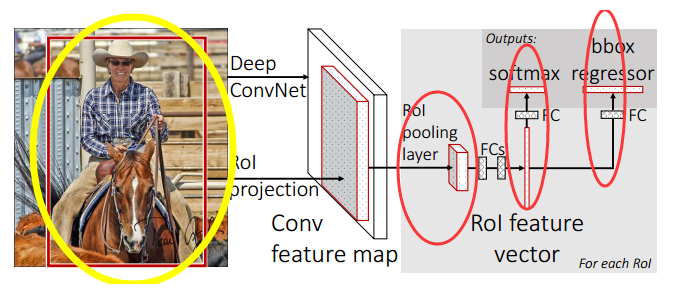
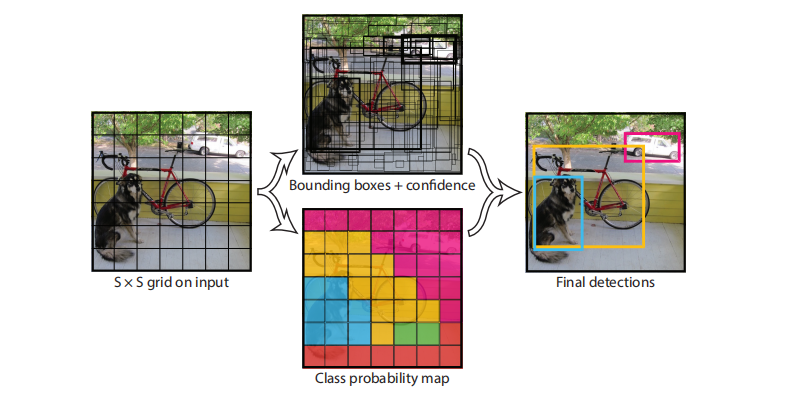
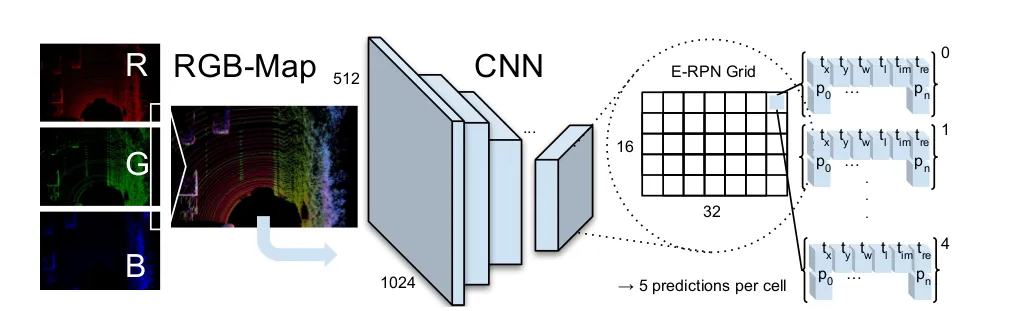
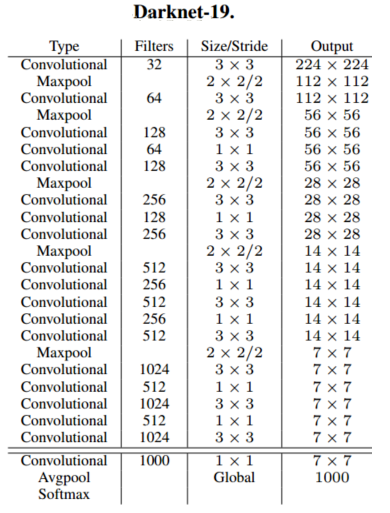
目标检测不仅要识别图像中的物体类别,还要定位其位置。主流算法分为两大流派:Two-Stage(如RCNN系列)和One-Stage(如YOLO系列)。RCNN通过候选区域加分类器实现检测;YOLO则直接回归边界框和类别,速度更快。
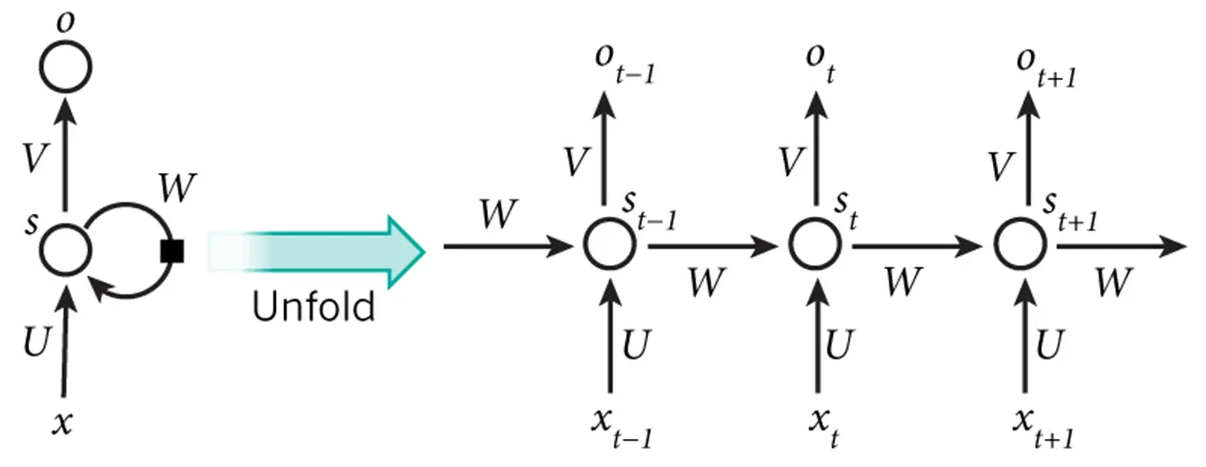
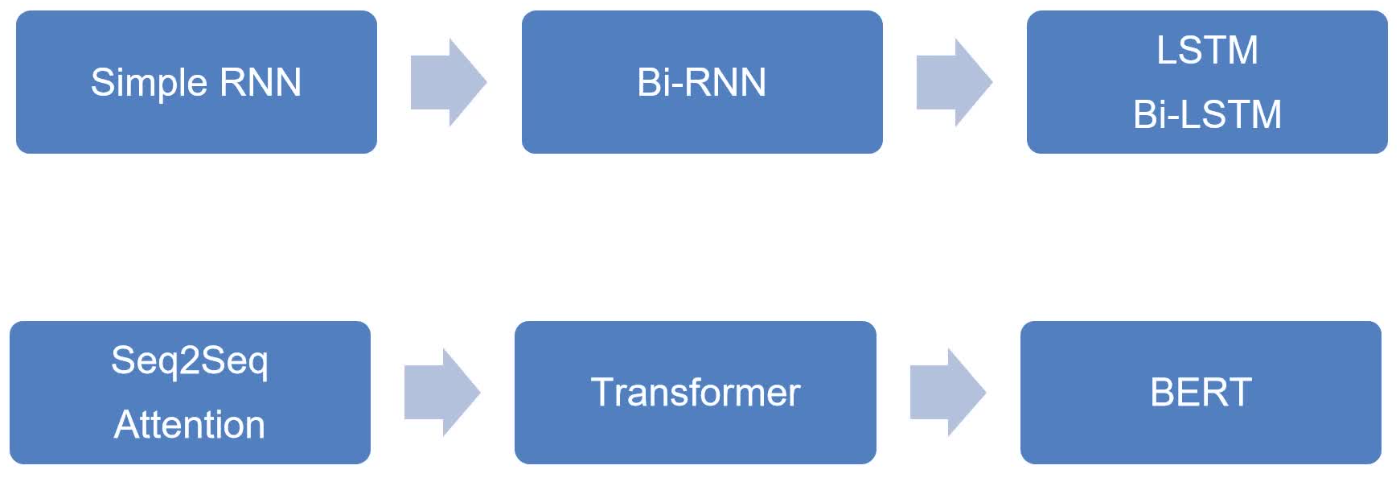
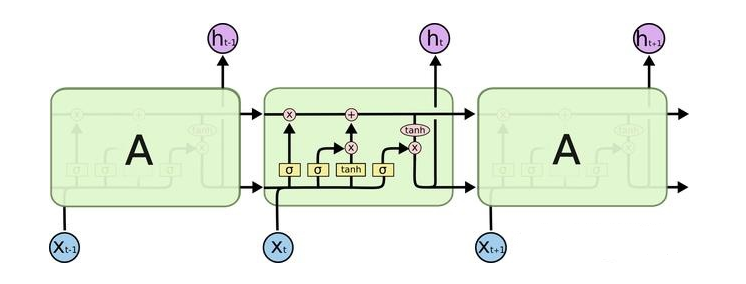
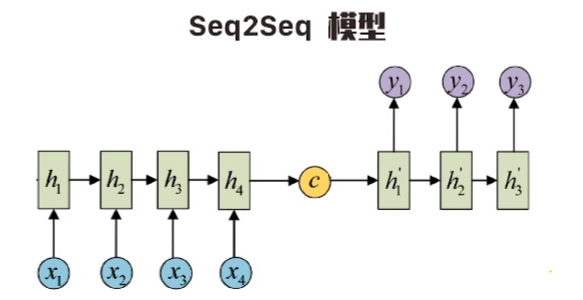
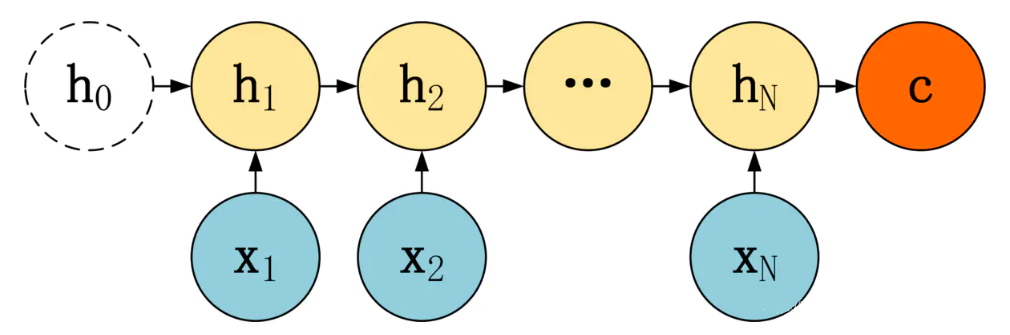
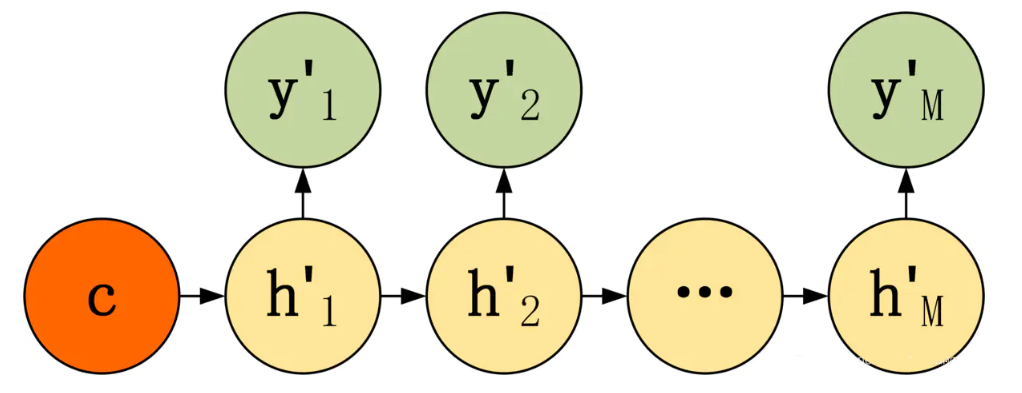
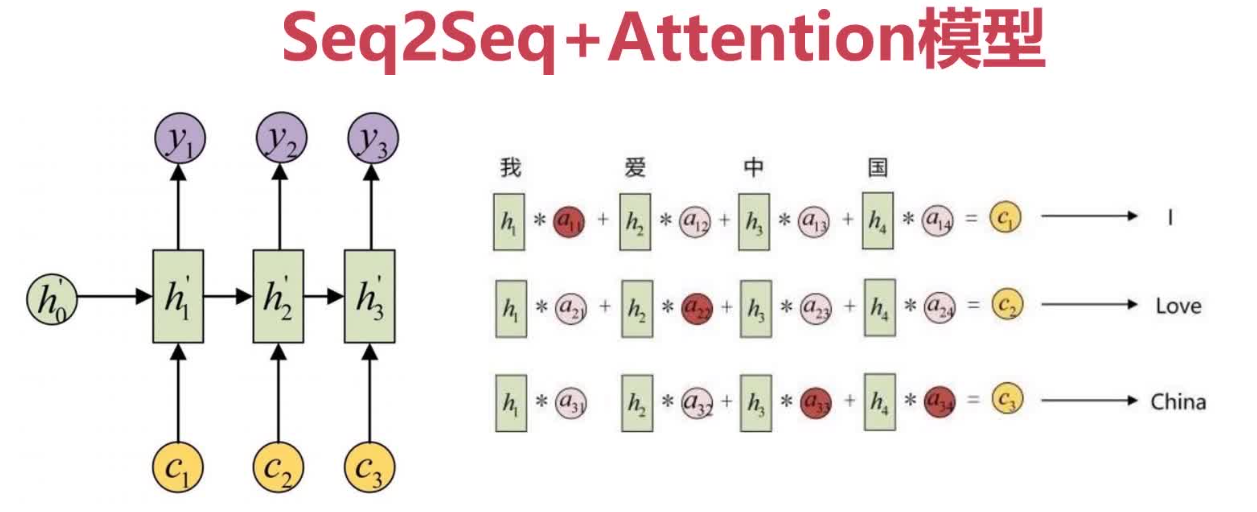
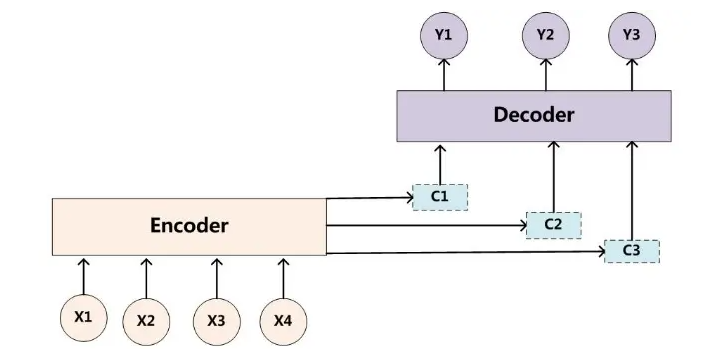
在自然语言处理(NLP)领域,循环神经网络(RNN)及其变体LSTM是处理序列数据的经典模型。LSTM通过精巧的“门结构”有效缓解了长序列中的梯度消失问题。在此基础上,Seq2Seq模型和Attention机制的引入,极大地推动了机器翻译、文本摘要等任务的发展。
提示:
两个识别任务越相似,两者的高级特征(在晚期的卷积层提取)就越相似。
提示:
YOLO:you only look once,指的是只需要浏览一次就可以识别出图中物体的类别和位置
七、词汇表征与Word2Vec
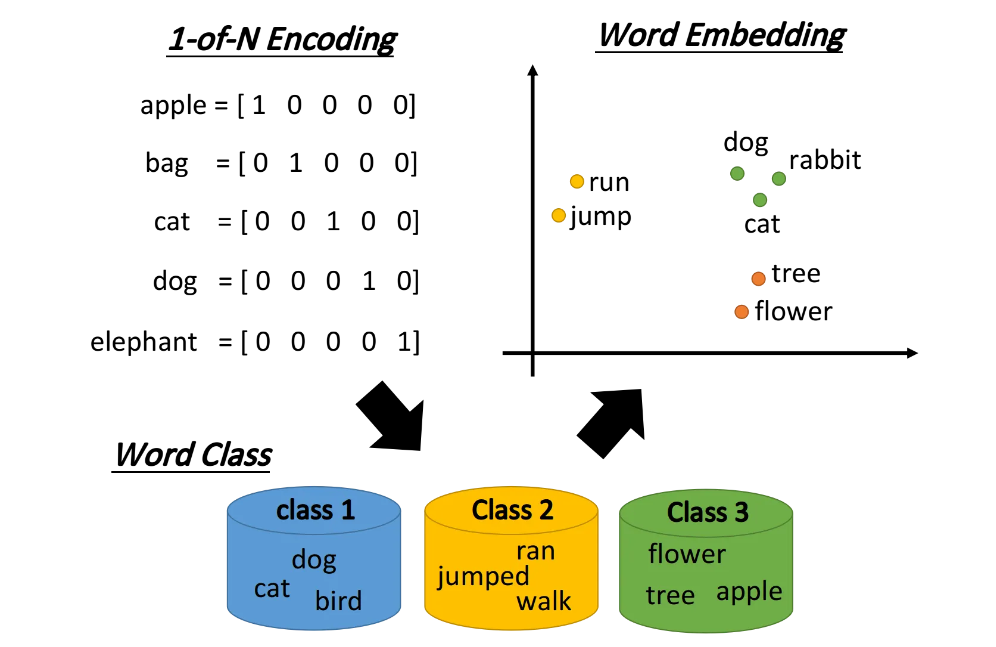
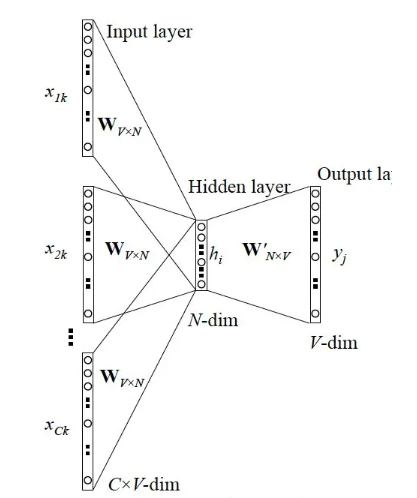
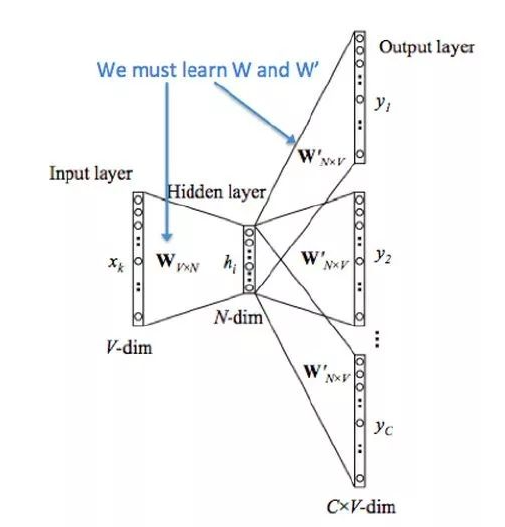
在NLP中,如何将文字转换为机器可理解的向量是关键。词汇表征方式经历了从One-Hot到分布式表示的演进。Word2Vec作为最经典的词嵌入方法之一,通过训练神经网络模型将词语映射到稠密的向量空间,使得语义相近的词在向量空间中也彼此靠近。
[AFFILIATE_SLOT_2]总结
本文系统梳理了深度学习的核心知识体系:从PyTorch基础操作、神经网络原理,到CNN经典架构、迁移学习、GAN、目标检测以及RNN与NLP基础。掌握这些内容,你就拥有了进一步探索AI世界的坚实基石。记住,动手实践是掌握这些概念的最佳途径!


 浙公网安备 33010602011771号