在强化学习的世界里,当我们需要处理图像输入时,传统的状态向量往往力不从心。本文将带你深入 Stable-Baselines3 (SB3),手把手教你如何为自定义环境接入卷积神经网络(CNN)策略,实现从像素到决策的完整AI训练流程。
一、SB3自定义环境接入:两大核心准备
想要将SB3(Stable-Baselines3)与自定义环境无缝对接,核心在于两步走:首先,深入理解你的任务,明确观测空间(Observation Space)、动作空间(Action Space)以及奖励函数(Reward Function)的设计;其次,熟悉Gym环境的配置规范,知道需要手写哪些函数、配置哪些参数。
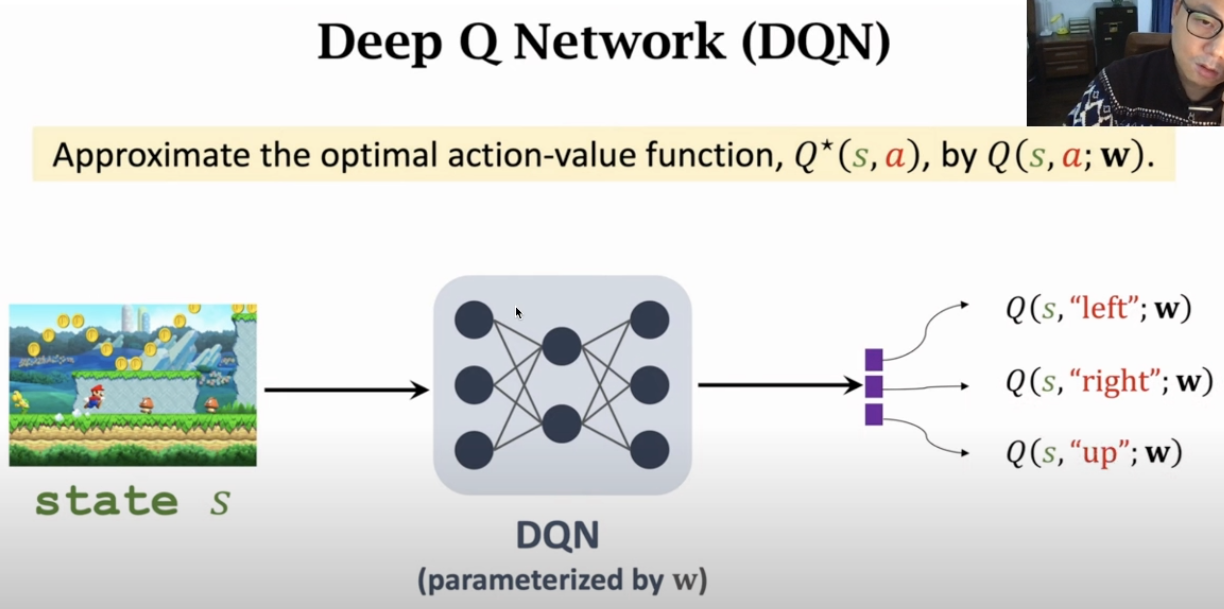
之前我们使用状态向量作为输入,但许多场景下,直接读取图像更为直观。此时,只需给神经网络添加卷积层即可实现。让我们在SB3官方示例中寻找图像输入的参考实现。
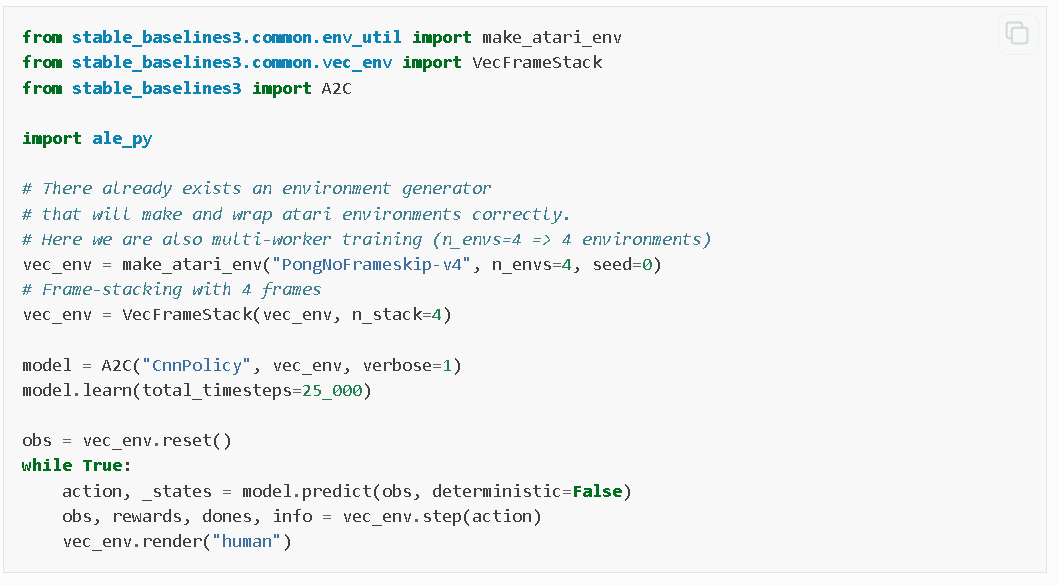
在SB3的 Examples 目录下,我们可以找到 AtariGame 的示例代码。其中带有 CnnPolicy 字样的配置即表示采用图像输入模式。
二、理解A2C模型的三种策略模式
要对本地代码进行定制,首先需要理解A2C模型的 Policy 属性。A2C(Advantage Actor-Critic)提供了三种策略选择:
- MlpPolicy:处理状态向量输入,是我们之前常用的模式。
- CnnPolicy:专为图像输入设计,本次实战的核心。
- MultiInputPolicy:适用于多模态输入,如多按键游戏。
因此,在创建模型时,我们选择第二个 CnnPolicy 作为策略基础:
model = A2C("CnnPolicy",
            env,
            verbose=0,
            tensorboard_log='./logs',
            learning_rate=1e-3
           )
model.policy
三、修改观测空间:图像通道的布局艺术
使用图像输入时,observation_space 必须按照官方文档规范进行修改。SB3支持前置通道(Channel First)与后置通道(Channel Last)两种布局。
    def __init__(self, arg1, arg2, ...):
        super().__init__()
        # Define action and observation space
        # They must be gym.spaces objects
        # Example when using discrete actions:
        self.action_space = spaces.Discrete(N_DISCRETE_ACTIONS)
        # Example for using image as input (channel-first; channel-last also works):
        self.observation_space = spaces.Box(low=0, high=255,
                                            shape=(N_CHANNELS, HEIGHT, WIDTH), dtype=np.uint8)
根据我们定义的 OBSERVATION_SPACE_VALUES,采用的是后置通道格式。
Example for using image as input (channel-first; channel-last also works):
self.observation_space = spaces.Box(low=0, high=255,
shape=(N_CHANNELS, HEIGHT, WIDTH), dtype=np.uint8)
前置通道 vs 后置通道
- 前置通道(PyTorch标准):格式为
(C, H, W),即先声明3个颜色通道,再声明256x256的矩阵尺寸。 - 后置通道(TensorFlow/OpenCV标准):格式为
(H, W, C),先声明256x256矩阵,再声明每个像素点的3个数值。
(C, H, W)(3, 256, 256)(H, W, C)(256, 256, 3)选择后置通道的原因在于 get_image() 函数中,使用“往 [x][y] 位置画颜色”的逻辑更易理解。若使用前置通道,则需先写颜色(通道数)再写位置,逻辑上不够直观。因此,N_CHANNELS(RGB通道数3)应放在第三参数位置。
    def get_image(self):
        img = np.zeros(self.OBSERVATION_SPACE_VALUES,dtype= np.uint8)
        img[self.food.x][self.food.y] = self.d[self.FOOD_N]
        img[self.player.x][self.player.y] = self.d[self.PLAYER_N]
        img[self.enemy.x][self.enemy.y] = self.d[self.ENEMY_N]
        return img
#self.observation_space = gym.spaces.Box(low=-SIZE+1, high=SIZE-1,
#shape=(4,), dtype=int)
self.observation_space = gym.spaces.Box(low=0, high=255,
shape=(self.SIZE, self.SIZE,self.N_CHANNELS), dtype=np.uint8)self.OBSERVATION_SPACE_VALUES=(SIZE,SIZE,self.N_CHANNELS)class envCube(gym.Env):
# 设定三个部分的颜色分别是蓝、绿、红
d = {1: (255, 0, 0), # blue
2: (0, 255, 0), # green
3: (0, 0, 255)} # red
PLAYER_N = 1
FOOD_N = 2
ENEMY_N = 3
N_CHANNELS=3⚠️ 注意:需将图像尺寸 SIZE 调整为40,因为默认模型架构的卷积核较大,10x10的输入会报错。
class envCube(gym.Env):
    # 设定三个部分的颜色分别是蓝、绿、红
    d = {1: (255, 0, 0),  # blue
        2: (0, 255, 0),  # green
        3: (0, 0, 255)}  # red
    PLAYER_N = 1
    FOOD_N = 2
    ENEMY_N = 3
    N_CHANNELS=3
metadata = {"render_modes": ["human"], "render_fps": 30}
def __init__(self,SIZE=40,
ACTION_SPACE_VALUES = 9,
RETURN_IMAGE = True,
MAX_STEP=200,
FOOD_REWARD = 25,
ENEMY_PENALITY = -300,
MOVE_PENALITY = -1):
super(envCube,self).__init__()
self.SIZE=SIZE
self.OBSERVATION_SPACE_VALUES=(SIZE,SIZE,self.N_CHANNELS)
self.ACTION_SPACE_VALUES=ACTION_SPACE_VALUES
#self.OBSERVATION_SPACE_VALUES=(4,)
#self.ACTION_SPACE_VALUES=ACTION_SPACE_VALUES
self.RETURN_IMAGE = RETURN_IMAGE # 考虑返回值是否图像
self.MAX_STEP=MAX_STEP
self.FOOD_REWARD = FOOD_REWARD # agent获得食物的奖励
self.ENEMY_PENALITY = ENEMY_PENALITY # 遇上对手的惩罚
self.MOVE_PENALITY = MOVE_PENALITY # 每移动一步的惩罚
self.action_space = gym.spaces.Discrete(self.ACTION_SPACE_VALUES)
self.observation_space = gym.spaces.Box(low=0, high=255,
shape=(self.SIZE, self.SIZE,self.N_CHANNELS), dtype=np.uint8)
#self.observation_space = gym.spaces.Box(low=-SIZE+1, high=SIZE-1,
# shape=(4,), dtype=int)
# 环境重置
def reset(self,seed=None, options=None):
self.player = Cube(self.SIZE)
self.food = Cube(self.SIZE)
self.enemy = Cube(self.SIZE)
# 如果玩家和食物初始位置相同,重置食物的位置,直到位置不同
while self.player == self.food:
self.food = Cube(self.SIZE)
# 如果敌人和玩家或食物的初始位置相同,重置敌人的位置,直到位置不同
while self.player == self.enemy or self.food == self.enemy:
self.enemy = Cube(self.SIZE)
# 判断观测是图像和数字
if self.RETURN_IMAGE:
observation = self.get_image()
else:
observation = (self.player - self.food)+(self.player - self.enemy)
observation=np.array(observation)
self.episode_step = 0
info={}
return observation,info
def step(self,action):
self.episode_step+=1
self.player.action(action)
self.food.move()
self.enemy.move()
# 分类讨论输出new_obs
if self.RETURN_IMAGE:
new_observation = self.get_image()
else:
new_observation = (self.player - self.food)+(self.player - self.enemy)
new_observation=np.array(new_observation)
#获取reward值
if self.player == self.food:
reward=self.FOOD_REWARD
elif self.player==self.enemy:
reward=self.ENEMY_PENALITY
else:
reward=self.MOVE_PENALITY
#检测截止情况
terminated = False
truncated = False
# 4. 判断结束条件
if self.player == self.food or self.player == self.enemy:
terminated = True
if self.episode_step >= self.MAX_STEP:
truncated = True
info={}
return new_observation,reward,terminated,truncated,info
def render(self,mode='human'):
img=self.get_image()
img = Image.fromarray(img,'RGB')
img = img.resize((200,200))
cv2.imshow('Predator',np.array(img))
if self.player == self.food or self.player == self.enemy or self.episode_step >= self.MAX_STEP:
cv2.waitKey(1500)
else:
cv2.waitKey(1)
def get_image(self):
img = np.zeros(self.OBSERVATION_SPACE_VALUES,dtype= np.uint8)
img[self.food.x][self.food.y] = self.d[self.FOOD_N]
img[self.player.x][self.player.y] = self.d[self.PLAYER_N]
img[self.enemy.x][self.enemy.y] = self.d[self.ENEMY_N]
return img四、环境验证与A2C模型创建
完成环境配置后,需验证Gym环境的完整性。若输出形状为 (10, 10, 3),则说明环境配置正确。
env=envCube()
print(env.OBSERVATION_SPACE_VALUES)
check_env(env)
接下来,导入主循环依赖库并创建A2C模型:
import gymnasium as gym
from stable_baselines3 import DQN,A2C
from stable_baselines3.common.evaluation import evaluate_policy
import os
import stable_baselines3 as sb3
import torch as th
print(sb3.__version__)
os.environ['KMP_DUPLICATE_LIB_OK']='True'
model = A2C("CnnPolicy",
env,
verbose=0,
tensorboard_log='./logs',
learning_rate=1e-3
)
model.policy通过 model.policy 可以查看默认的模型架构:
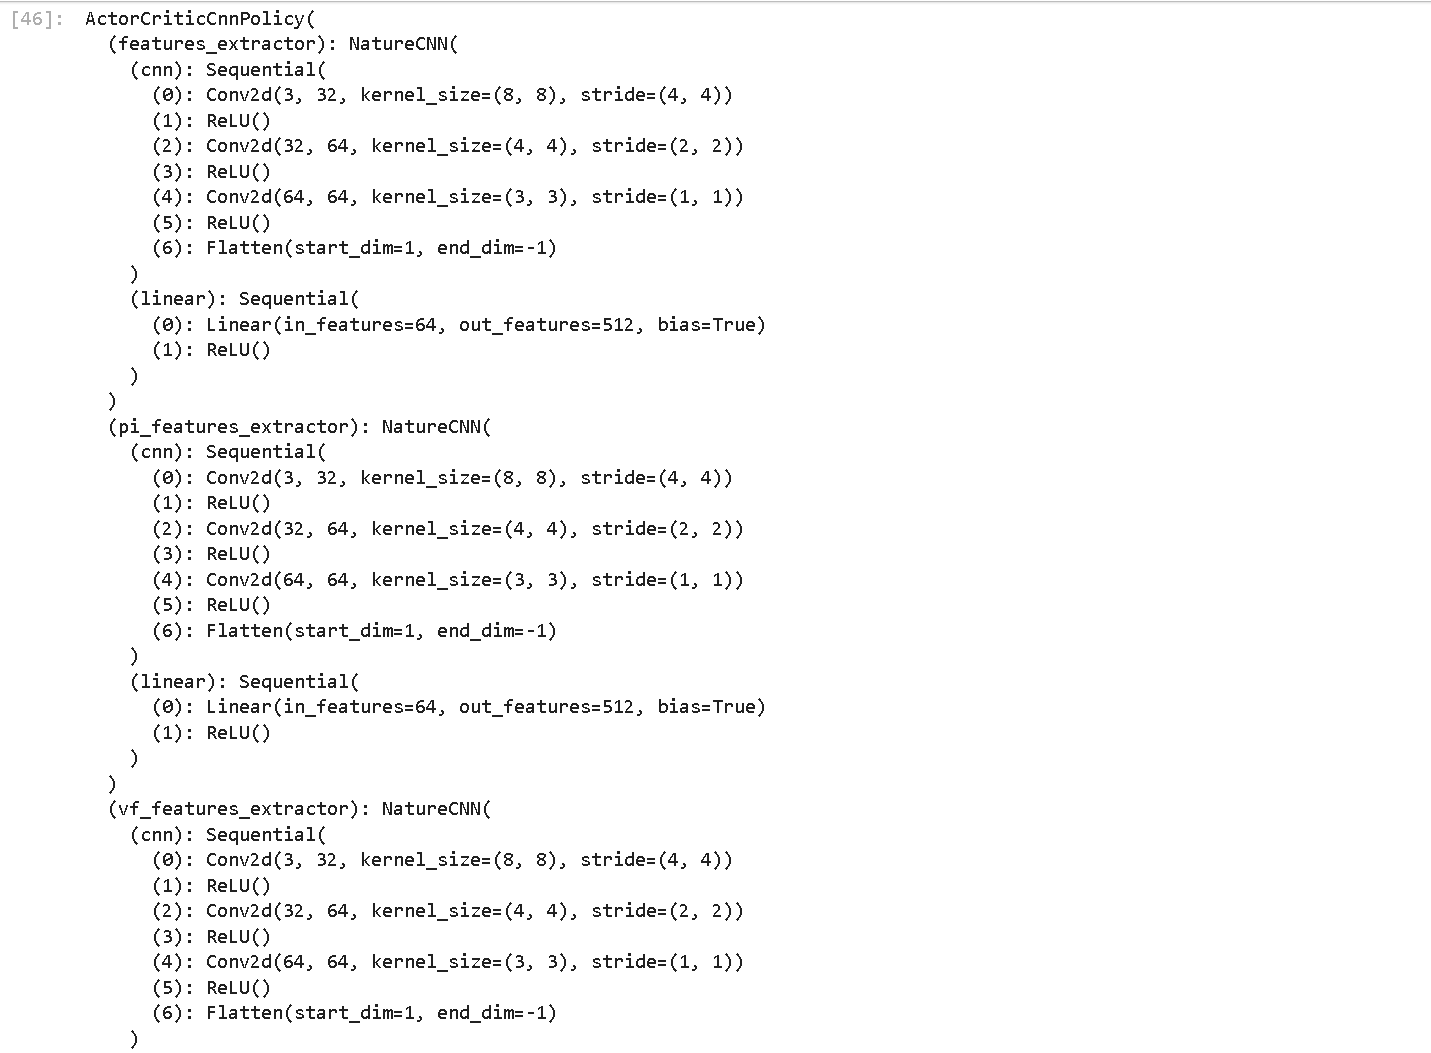
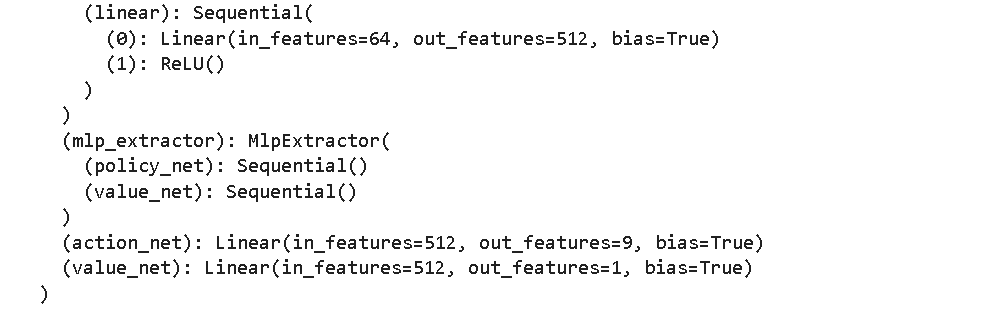
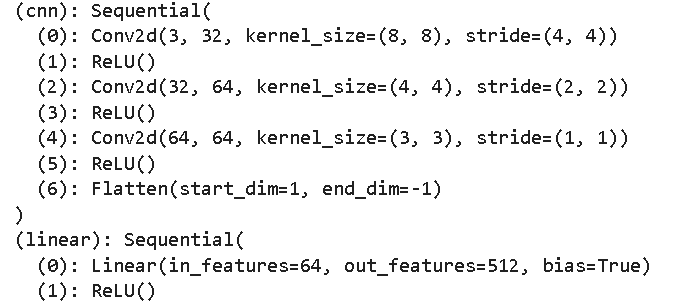
该架构首先创建了一个 Sequential 容器,Conv2d 首层输入3个特征,输出32个特征,卷积核大小为8x8,步长为4。后续两层 Conv2d 隐藏层用于提取更高维度的特征。随后进入 Flatten 展平层,将特征块展开为一维向量,最后通过全连接层输出。

值得注意的是,CNN网络与Value网络架构相同,但不共享参数,采用多头输出机制。最终的全连接层输出维度分别对应动作空间(9)和价值函数。
obs
   /            \
 <128>          <128>
  |              |
 <128>          <128>
  |              |
action         value
开始训练,本次保存为 'Custom_CNN_A2C_netDefault_1M',共训练100万步。训练完成后保存权重参数,并加载模型进行测试。
# Train the agent and display a progress bar
model.learn(total_timesteps=int(1e6), progress_bar=True,tb_log_name='Custom_CNN_A2C_netDefault_1M')
model.save("Custom_CNN_A2C_netDefault_1M")
del model #清除model对象model=A2C.load('Custom_CNN_A2C_netDefault_1M',env=env)
# Evaluate the agent
# NOTE: If you use wrappers with your environment that modify rewards,
# this will be reflected here. To evaluate with original rewards,
# wrap environment in a "Monitor" wrapper before other wrappers.
mean_reward, std_reward = evaluate_policy(model, model.get_env(), render=False,n_eval_episodes=10)
print(mean_reward,std_reward)然而,训练效果并不理想:
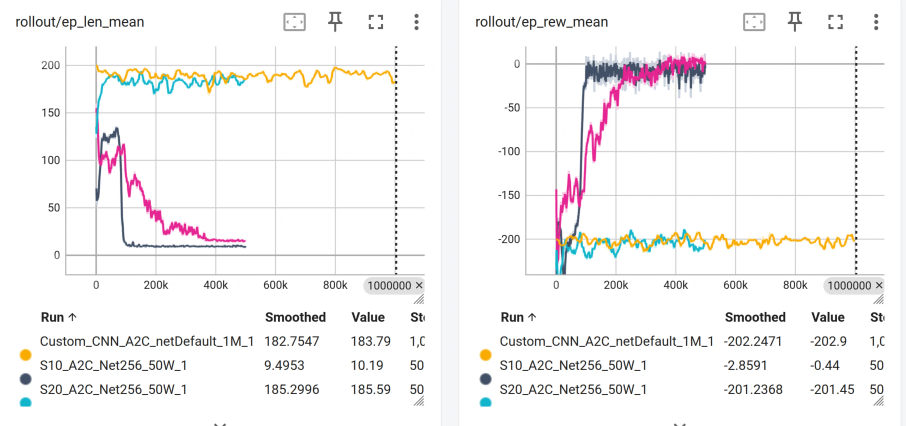
40x40的图像对当前模型而言过于吃力,因此考虑回归10x10的图像。但问题随之而来:默认的图像输入要求大于36x36,否则需要自定义特征提取器。
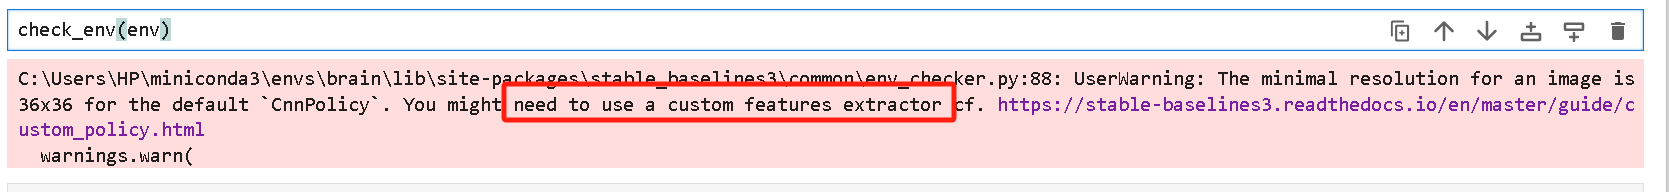
五、模型优化:自定义特征提取器
整个模型有三个可优化方向:观测空间(离散/连续)、全连接层(通过 policy_kwargs 的 net_arch 项修改)、以及特征提取器。
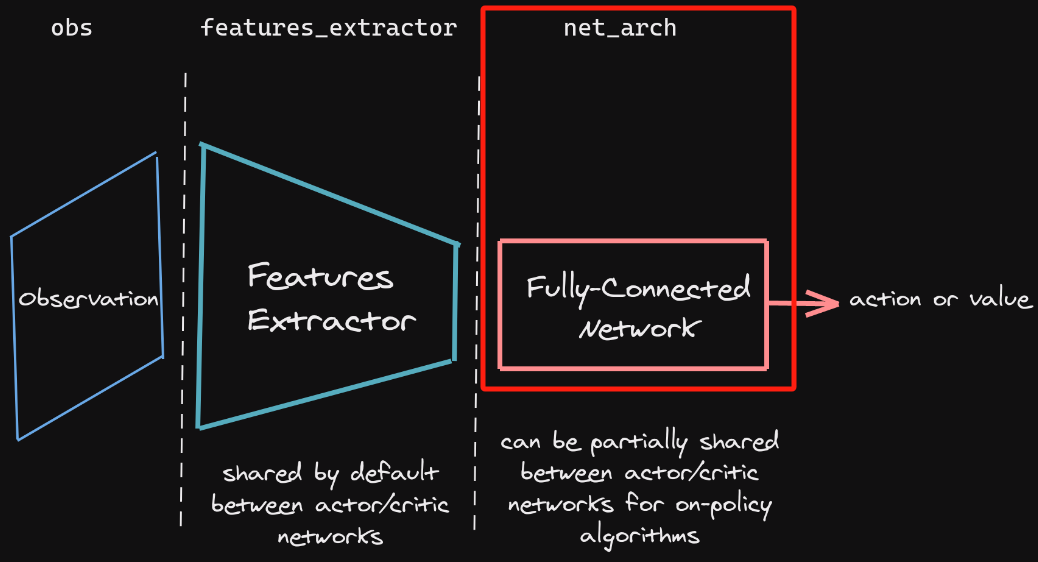
在官方文档中找到自定义特征提取器的示例,我们可参考并修改:
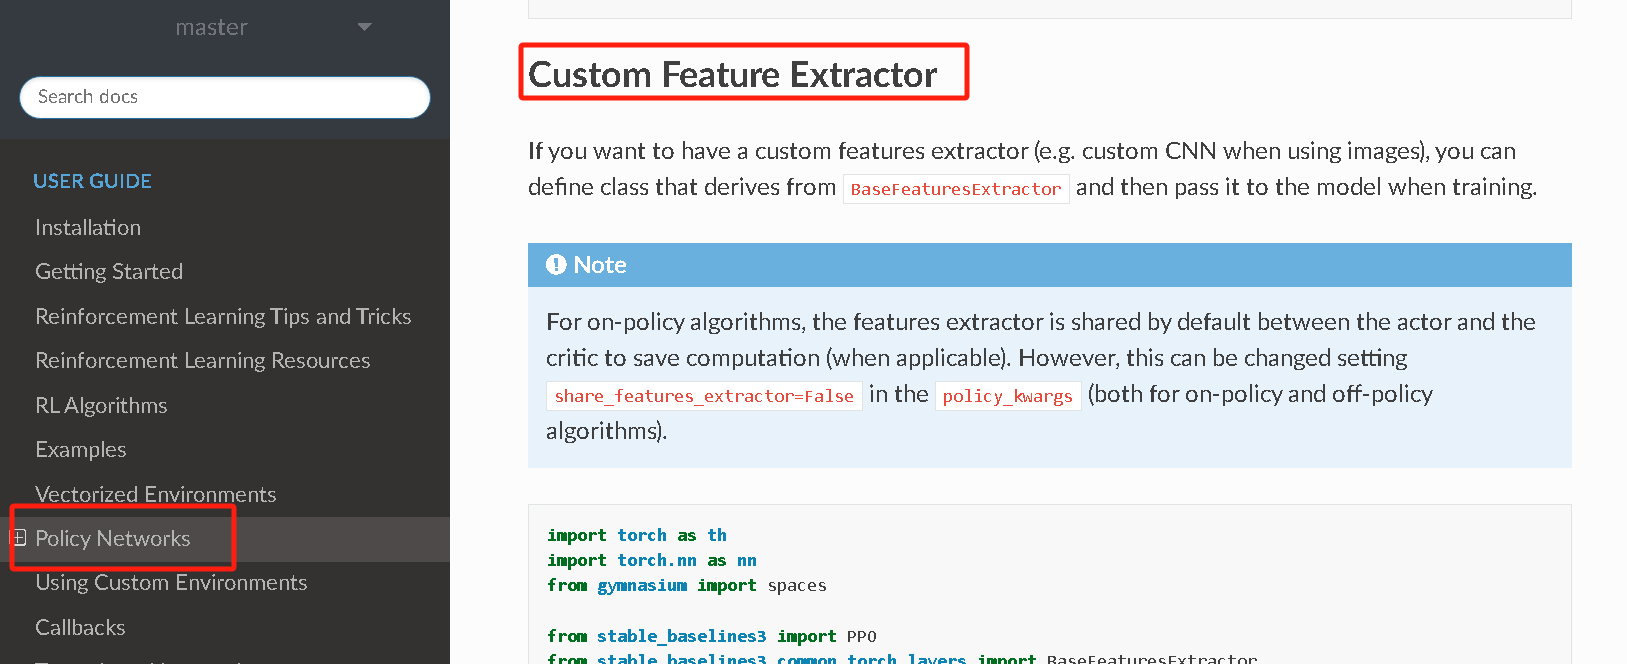
import torch as th
import torch.nn as nn
from gymnasium import spaces
from stable_baselines3 import PPO
from stable_baselines3.common.torch_layers import BaseFeaturesExtractor
class CustomCNN(BaseFeaturesExtractor):
    """
    :param observation_space: (gym.Space)
    :param features_dim: (int) Number of features extracted.
        This corresponds to the number of unit for the last layer.
    """
    def __init__(self, observation_space: spaces.Box, features_dim: int = 256):
        super().__init__(observation_space, features_dim)
        # We assume CxHxW images (channels first)
        # Re-ordering will be done by pre-preprocessing or wrapper
        n_input_channels = observation_space.shape[0]
        self.cnn = nn.Sequential(
            nn.Conv2d(n_input_channels, 32, kernel_size=8, stride=4, padding=0),
            nn.ReLU(),
            nn.Conv2d(32, 64, kernel_size=4, stride=2, padding=0),
            nn.ReLU(),
            nn.Flatten(),
        )
        # Compute shape by doing one forward pass
        with th.no_grad():
            n_flatten = self.cnn(
                th.as_tensor(observation_space.sample()[None]).float()
            ).shape[1]
        self.linear = nn.Sequential(nn.Linear(n_flatten, features_dim), nn.ReLU())
    def forward(self, observations: th.Tensor) -> th.Tensor:
        return self.linear(self.cnn(observations))
policy_kwargs = dict(
    features_extractor_class=CustomCNN,
    features_extractor_kwargs=dict(features_dim=128),
)
model = PPO("CnnPolicy", "BreakoutNoFrameskip-v4", policy_kwargs=policy_kwargs, verbose=1)
model.learn(1000)
1. 观测空间的维度调整
这里要求将通道置于首参,但若不想改变参数顺序,可使用 numpy 的 moveaxis 函数进行轴移动。
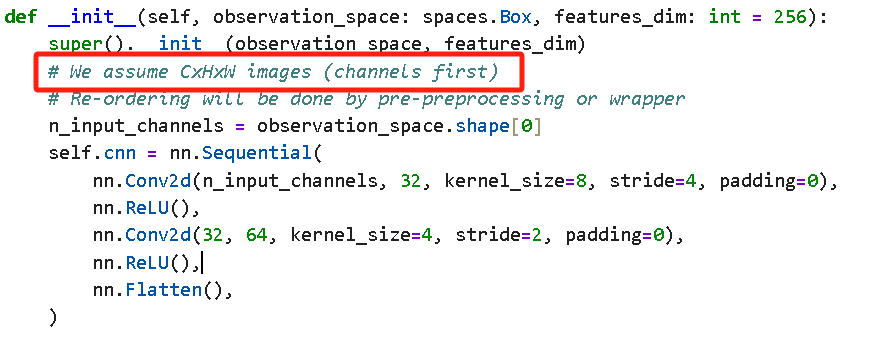
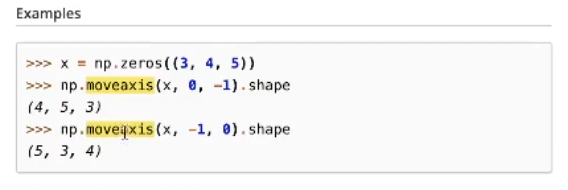
在应用中,将待移动对象置于首参:
        # 判断观测是图像和数字
        if self.RETURN_IMAGE:
            observation = self.get_image()
            observation=np.array(observation)
            observation=np.moveaxis(observation,-1,0)
        else:
            observation = (self.player - self.food)+(self.player - self.enemy)
            observation=np.array(observation)
observation=np.moveaxis(observation,-1,0)同时,new_observation 也需要同样处理:
        # 分类讨论输出new_obs
        if self.RETURN_IMAGE:
            new_observation = self.get_image()
            new_observation=np.array(new_observation)
            new_observation=np.moveaxis(new_observation,-1,0)
        else:
            new_observation = (self.player - self.food)+(self.player - self.enemy)
            new_observation=np.array(new_observation)
            new_observation=np.moveaxis(new_observation,-1,0)
验证修改是否成功:
env=envCube()
print(env.observation_space.shape)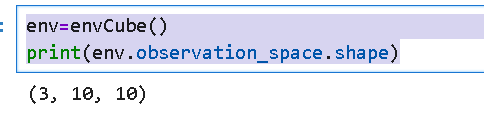
输出 (3, 10, 10),符合预期。
2. 卷积层参数调整
默认的8x8卷积核对于10x10的输入来说过于庞大,且步长4无填充会直接越界。我们改用3x3卷积核,步长为1。需注意 Conv2d 的首参为输入特征数,次参为输出特征数,层与层之间需保持维度匹配。
self.cnn = nn.Sequential(
            nn.Conv2d(n_input_channels, 32, kernel_size=8, stride=4, padding=0),
            nn.ReLU(),
            nn.Conv2d(32, 64, kernel_size=4, stride=2, padding=0),
            nn.ReLU(),
            nn.Flatten(),
        )
n_input_channels = observation_space.shape[0]
self.cnn = nn.Sequential(
nn.Conv2d(n_input_channels, 32, kernel_size=(3,3), stride=(1,1), padding=0),
nn.ReLU(),
nn.Conv2d(32, 64, kernel_size=(3,3), stride=(1,1), padding=0),
nn.ReLU(),
nn.Conv2d(64, 64, kernel_size=(3,3), stride=(1,1), padding=0),
nn.ReLU(),
nn.Flatten(),
)3. 全连接层与激活函数
参考之前学习的 net_arch 修改方法,直接在 policy_kwargs 中调整:
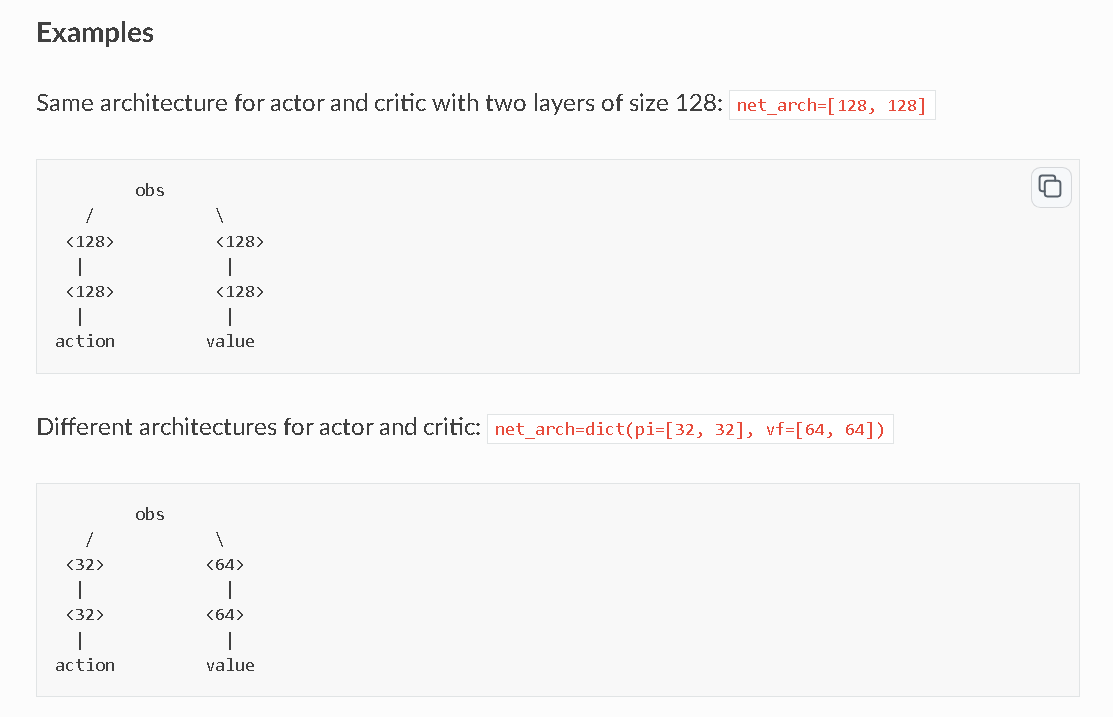
policy_kwargs = dict(
features_extractor_class=CustomCNN,
features_extractor_kwargs=dict(features_dim=128),
net_arch=dict(pi=[32, 32], vf=[64, 64])
)同时,可以添加激活函数增强非线性表达能力:
policy_kwargs = dict(
features_extractor_class=CustomCNN,
features_extractor_kwargs=dict(features_dim=128),
net_arch=dict(pi=[32, 32], vf=[64, 64]),
activation_fn=th.nn.ReLU,
)最终,完整的特征提取继承类代码如下:
import torch as th
import torch.nn as nn
from gymnasium import spaces
from stable_baselines3 import PPO
from stable_baselines3.common.torch_layers import BaseFeaturesExtractor
class CustomCNN(BaseFeaturesExtractor):
"""
:param observation_space: (gym.Space)
:param features_dim: (int) Number of features extracted.
This corresponds to the number of unit for the last layer.
"""
def __init__(self, observation_space: spaces.Box, features_dim: int = 256):
super().__init__(observation_space, features_dim)
# We assume CxHxW images (channels first)
# Re-ordering will be done by pre-preprocessing or wrapper
        n_input_channels = observation_space.shape[0]
        self.cnn = nn.Sequential(
            nn.Conv2d(n_input_channels, 32, kernel_size=(3,3), stride=(1,1), padding=0),
            nn.ReLU(),
            nn.Conv2d(32, 64, kernel_size=(3,3), stride=(1,1), padding=0),
            nn.ReLU(),
            nn.Conv2d(64, 64, kernel_size=(3,3), stride=(1,1), padding=0),
            nn.ReLU(),
            nn.Flatten(),
        )
# Compute shape by doing one forward pass
with th.no_grad():
n_flatten = self.cnn(
th.as_tensor(observation_space.sample()[None]).float()
).shape[1]
self.linear = nn.Sequential(nn.Linear(n_flatten, features_dim), nn.ReLU())
def forward(self, observations: th.Tensor) -> th.Tensor:
return self.linear(self.cnn(observations))
policy_kwargs = dict(
    features_extractor_class=CustomCNN,
    features_extractor_kwargs=dict(features_dim=128),
    net_arch=dict(pi=[32, 32], vf=[64, 64]),
    activation_fn=th.nn.ReLU,
)最后两行展示了如何在训练代码中挂载自定义特征提取器,直接将 policy_kwargs 传入即可:
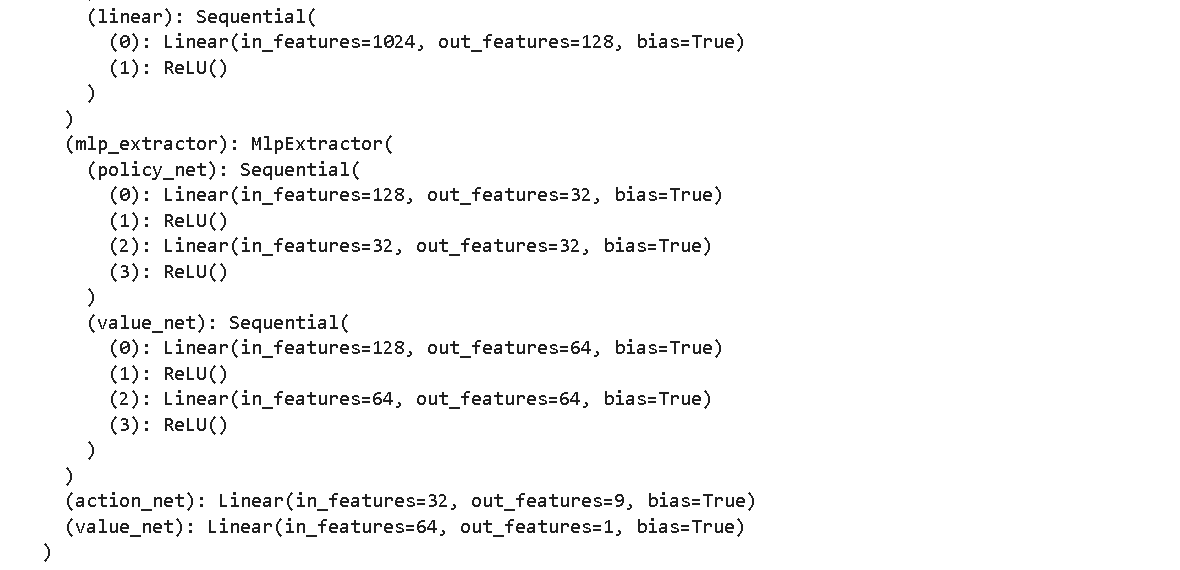
model = PPO("CnnPolicy", "BreakoutNoFrameskip-v4", policy_kwargs=policy_kwargs, verbose=1)model = A2C("CnnPolicy",
env,
verbose=1,
tensorboard_log='./logs',
learning_rate=1e-3,
policy_kwargs=policy_kwargs
)通过 model.policy 即可查看构建好的网络结构:
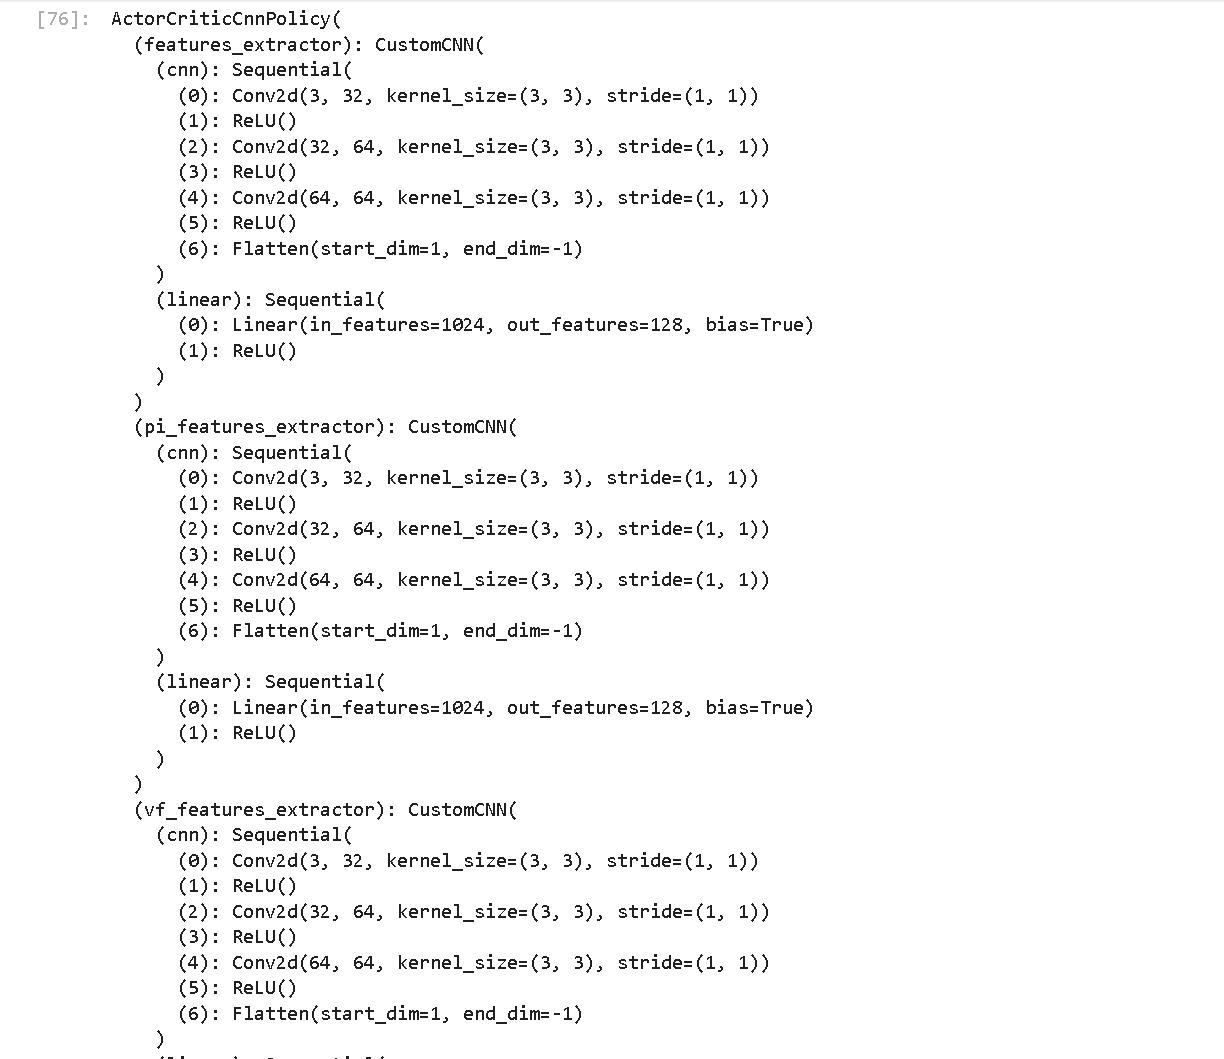
六、Callback机制:自动保存最优模型
由于训练过程存在波动,最终模型不一定是最优的。SB3提供了 Callback 机制,可每K步评估一次并保存最优模型。
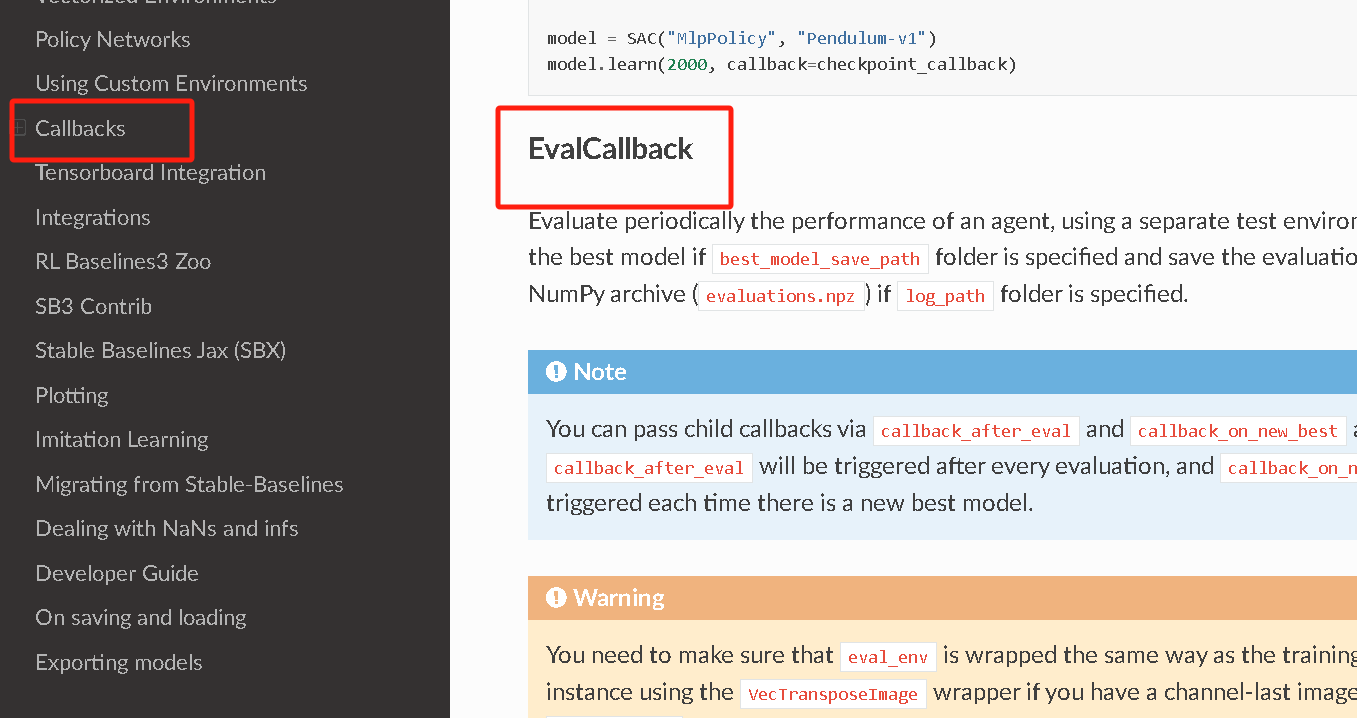
参考官方文档,首先导入依赖库:
from stable_baselines3.common.callbacks import EvalCallback设定 callbacks 参数。其中 eval_freq 决定评估频率,我们将最优参数和日志保存在 "./logs/bestModel/" 目录下:
# Use deterministic actions for evaluation
eval_callback = EvalCallback(env, best_model_save_path="./logs/bestModel/",
log_path="./logs/bestModel/", eval_freq=500,
deterministic=True, render=False)启动训练!
# Train the agent and display a progress bar
model.learn(total_timesteps=int(2e6), progress_bar=True,tb_log_name='Custom_CNN_A2C_net128X48_2M')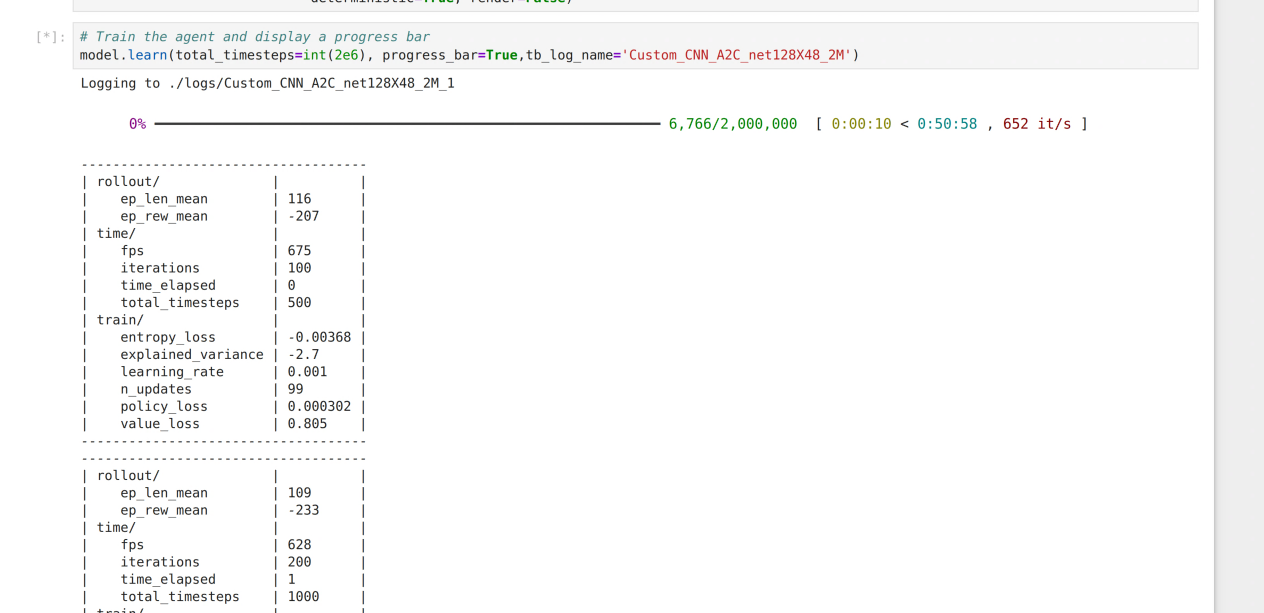
训练完成后,保存模型并加载最优模型:
model.save("Custom_CNN_A2C_net128X48_2M")
del modelbest_model=A2C.load('./logs/bestModel/best_model.zip',env=env)七、完整代码实战
以下是整个流程的完整代码,涵盖环境定义、模型训练与评估:
1. 导入依赖库
#将学习环境所需要的依赖库导入
import gymnasium as gym
import numpy as np
from gymnasium import spaces
import cv2
from PIL import Image
import time
import pickle #对象到文件的处理
import matplotlib.pyplot as plt
from matplotlib import style
from stable_baselines3.common.env_checker import check_env
from stable_baselines3.common.callbacks import EvalCallback
style.use('ggplot')2. 环境参数设定
#环境参数设定
#SIZE=10 #3个对象在10*10的范围内
EPISODES=30000 #智能体玩的游戏轮数
SHOW_EVERY=3000 #每3000局展示一次游玩过程
#奖励与惩罚
#FOOD_REWARD=25#吃食物的奖励
#ENEMY_PENALITY=300 #被敌人抓住的惩罚
#MOVE_PENALITY=1 #移动惩罚
#环境计算参数
epsilon=0.6 #在强化学习时抽取随机动作的概率 40%使用最大价值期望动作
EPS_DECAY=0.9998 #每玩一局游戏就让随机动作概率乘以这个数,到最后基本就定性了
DISCOUNT=0.95 #折扣回报 未来奖励的折扣
LEARNING_RATE=0.1 #学习率 步长
#q_table_file = "q_table_save.pkl"
#q_table = None
q_table = "qtable_1775227149.pickle"
#d = {1:(255,0,0), #蓝色——玩家
# 2:(0,255,0), #绿色——食物
# 3:(0,0,255)} #红色——敌人
#PLAYER_N=1
#FOOD_N=2
#ENEMY_N=33. 创建Cube对象类
#为三个对象创建类
class Cube:
def __init__(self,size):#初始位置
self.size=size
self.x=np.random.randint(0,self.size-1)
self.y=np.random.randint(0,self.size-1)
def __str__(self): #打印当前位置
return f'{self.x},{self.y}'
def __sub__(self,other):#这个类的另一个实体
return (self.x-other.x,self.y-other.y)
def __eq__(self,other):
return self.x == other.x and self.y == other.y
def action(self,choise):
if choise == 0:
self.move(x=1,y=1)
elif choise == 1:
self.move(x=-1,y=1)
elif choise == 2:
self.move(x=1,y=-1)
elif choise == 3:
self.move(x=-1,y=-1)
elif choise == 4:
self.move(x=0,y=1)
elif choise == 5:
self.move(x=0,y=-1)
elif choise == 6:
self.move(x=1,y=0)
elif choise == 7:
self.move(x=-1,y=0)
elif choise == 8:
self.move(x=0,y=0)
def move(self,x=False,y=False):
if not x:#如果x没有给值
self.x += np.random.randint(-1,2)
else:
self.x += x
if not y:#如果y没有给值
self.y += np.random.randint(-1,2)
else:
self.y += y
#考虑边界
if self.x<0:
self.x=0
elif self.x>=self.size:
self.x=self.size-1
if self.y<0:
self.y=0
elif self.y>=self.size:
self.y=self.size-14. 创建envCube环境类
class envCube(gym.Env):
# 设定三个部分的颜色分别是蓝、绿、红
d = {1: (255, 0, 0), # blue
2: (0, 255, 0), # green
3: (0, 0, 255)} # red
PLAYER_N = 1
FOOD_N = 2
ENEMY_N = 3
N_CHANNELS=3
metadata = {"render_modes": ["human"], "render_fps": 30}
def __init__(self,SIZE=10,
ACTION_SPACE_VALUES = 9,
RETURN_IMAGE = True,
MAX_STEP=200,
FOOD_REWARD = 25,
ENEMY_PENALITY = -300,
MOVE_PENALITY = -1):
super(envCube,self).__init__()
self.SIZE=SIZE
self.OBSERVATION_SPACE_VALUES=(SIZE,SIZE,self.N_CHANNELS)
self.ACTION_SPACE_VALUES=ACTION_SPACE_VALUES
#self.OBSERVATION_SPACE_VALUES=(4,)
#self.ACTION_SPACE_VALUES=ACTION_SPACE_VALUES
self.RETURN_IMAGE = RETURN_IMAGE # 考虑返回值是否图像
self.MAX_STEP=MAX_STEP
self.FOOD_REWARD = FOOD_REWARD # agent获得食物的奖励
self.ENEMY_PENALITY = ENEMY_PENALITY # 遇上对手的惩罚
self.MOVE_PENALITY = MOVE_PENALITY # 每移动一步的惩罚
self.action_space = gym.spaces.Discrete(self.ACTION_SPACE_VALUES)
self.observation_space = gym.spaces.Box(low=0, high=255,
shape=(self.N_CHANNELS,self.SIZE, self.SIZE), dtype=np.uint8)
#self.observation_space = gym.spaces.Box(low=-SIZE+1, high=SIZE-1,
# shape=(4,), dtype=int)
# 环境重置
def reset(self,seed=None, options=None):
self.player = Cube(self.SIZE)
self.food = Cube(self.SIZE)
self.enemy = Cube(self.SIZE)
# 如果玩家和食物初始位置相同,重置食物的位置,直到位置不同
while self.player == self.food:
self.food = Cube(self.SIZE)
# 如果敌人和玩家或食物的初始位置相同,重置敌人的位置,直到位置不同
while self.player == self.enemy or self.food == self.enemy:
self.enemy = Cube(self.SIZE)
# 判断观测是图像和数字
if self.RETURN_IMAGE:
observation = self.get_image()
observation=np.array(observation)
observation=np.moveaxis(observation,-1,0)
else:
observation = (self.player - self.food)+(self.player - self.enemy)
observation=np.array(observation)
observation=np.moveaxis(observation,-1,0)
self.episode_step = 0
info={}
return observation,info
def step(self,action):
self.episode_step+=1
self.player.action(action)
self.food.move()
self.enemy.move()
# 分类讨论输出new_obs
if self.RETURN_IMAGE:
new_observation = self.get_image()
new_observation=np.array(new_observation)
new_observation=np.moveaxis(new_observation,-1,0)
else:
new_observation = (self.player - self.food)+(self.player - self.enemy)
new_observation=np.array(new_observation)
new_observation=np.moveaxis(new_observation,-1,0)
#获取reward值
if self.player == self.food:
reward=self.FOOD_REWARD
elif self.player==self.enemy:
reward=self.ENEMY_PENALITY
else:
reward=self.MOVE_PENALITY
#检测截止情况
terminated = False
truncated = False
# 4. 判断结束条件
if self.player == self.food or self.player == self.enemy:
terminated = True
if self.episode_step >= self.MAX_STEP:
truncated = True
info={}
return new_observation,reward,terminated,truncated,info
def render(self,mode='human'):
img=self.get_image()
img = Image.fromarray(img,'RGB')
img = img.resize((200,200))
cv2.imshow('Predator',np.array(img))
if self.player == self.food or self.player == self.enemy or self.episode_step >= self.MAX_STEP:
cv2.waitKey(1500)
else:
cv2.waitKey(1)
def get_image(self):
img = np.zeros(self.OBSERVATION_SPACE_VALUES,dtype= np.uint8)
img[self.food.x][self.food.y] = self.d[self.FOOD_N]
img[self.player.x][self.player.y] = self.d[self.PLAYER_N]
img[self.enemy.x][self.enemy.y] = self.d[self.ENEMY_N]
return img5. 实例化环境并检测完整性
env=envCube()
print(env.observation_space.shape)check_env(env)6. 导入主函数依赖库与自定义特征提取器
import gymnasium as gym
from stable_baselines3 import DQN,A2C
from stable_baselines3.common.evaluation import evaluate_policy
import os
import stable_baselines3 as sb3
import torch as th
print(sb3.__version__)
os.environ['KMP_DUPLICATE_LIB_OK']='True'import torch as th
import torch.nn as nn
from gymnasium import spaces
from stable_baselines3 import PPO
from stable_baselines3.common.torch_layers import BaseFeaturesExtractor
class CustomCNN(BaseFeaturesExtractor):
"""
:param observation_space: (gym.Space)
:param features_dim: (int) Number of features extracted.
This corresponds to the number of unit for the last layer.
"""
def __init__(self, observation_space: spaces.Box, features_dim: int = 256):
super().__init__(observation_space, features_dim)
# We assume CxHxW images (channels first)
# Re-ordering will be done by pre-preprocessing or wrapper
n_input_channels = observation_space.shape[0]
self.cnn = nn.Sequential(
nn.Conv2d(n_input_channels, 32, kernel_size=(3,3), stride=(1,1), padding=0),
nn.ReLU(),
nn.Conv2d(32, 64, kernel_size=(3,3), stride=(1,1), padding=0),
nn.ReLU(),
nn.Conv2d(64, 64, kernel_size=(3,3), stride=(1,1), padding=0),
nn.ReLU(),
nn.Flatten(),
)
# Compute shape by doing one forward pass
with th.no_grad():
n_flatten = self.cnn(
th.as_tensor(observation_space.sample()[None]).float()
).shape[1]
self.linear = nn.Sequential(nn.Linear(n_flatten, features_dim), nn.ReLU())
def forward(self, observations: th.Tensor) -> th.Tensor:
return self.linear(self.cnn(observations))
policy_kwargs = dict(
features_extractor_class=CustomCNN,
features_extractor_kwargs=dict(features_dim=128),
net_arch=dict(pi=[32, 32], vf=[64, 64]),
activation_fn=th.nn.ReLU,
)7. 创建模型实例并使用Callbacks保存最佳权重
model = A2C("CnnPolicy",
            env,
            verbose=1,
            tensorboard_log='./logs',
            learning_rate=1e-3,
            policy_kwargs=policy_kwargs
           )
model.policy# Use deterministic actions for evaluation
eval_callback = EvalCallback(env, best_model_save_path="./logs/bestModel/",
log_path="./logs/bestModel/", eval_freq=500,
deterministic=True, render=False)8. 训练、保存与加载模型
# Train the agent and display a progress bar
model.learn(total_timesteps=int(2e6), progress_bar=True,tb_log_name='Custom_CNN_A2C_net128X48_2M')model.save("Custom_CNN_A2C_net128X48_2M")
del modelmodel=A2C.load('Custom_CNN_A2C_net128X48_2M',env=env)best_model=A2C.load('./logs/bestModel/best_model.zip',env=env)# Evaluate the agent
# NOTE: If you use wrappers with your environment that modify rewards,
# this will be reflected here. To evaluate with original rewards,
# wrap environment in a "Monitor" wrapper before other wrappers.
mean_reward, std_reward = evaluate_policy(model, model.get_env(), render=False,n_eval_episodes=10)
print(mean_reward,std_reward)总结
自定义特征提取器是处理图像输入的关键,核心要点如下:
- ✅ 确认图像输入是否为 Channel First,若非则使用
np.moveaxis调整。 - ✅ 卷积层修改在
__init__()中完成。 - ✅ 全连接层修改通过
policy_kwargs中的net_arch实现。 - ✅ 创建模型时传入
policy_kwargs=policy_kwargs即可生效。
掌握这些技巧,你就能灵活运用SB3处理各类图像输入任务,让AI在像素世界中游刃有余!
[AFFILIATE_SLOT_1]如果你觉得本文对你有帮助,欢迎关注更多强化学习实战教程!
[AFFILIATE_SLOT_2]

 浙公网安备 33010602011771号