在大数据与容器化部署日益融合的今天,使用Docker搭建Hadoop集群已成为开发与测试环境的标准实践。本文将带你从零开始,基于Ubuntu系统,通过Docker容器编排技术,完整部署一个包含1个Master和2个Worker节点的Hadoop 3.3.0集群。无论你是大数据新手还是运维老手,都能通过本文快速掌握容器化Hadoop的核心步骤与避坑技巧。
一、环境准备与基础镜像构建
在开始之前,请确保你的宿主机已安装Docker(可参考《Docker部署Hadoop-01-Docker安装》),并熟悉基本操作(参考《Docker部署Hadoop-02-Docker常见操作》)。我们将以Ubuntu为基础镜像,构建包含Java和Hadoop运行环境的自定义镜像。
首先,准备Hadoop安装包:从官网下载hadoop-3.3.0.tar.gz,并放置于工作目录。同时,创建Docker网络,确保容器间通信顺畅:
# 更新系统
sudo apt update && sudo apt upgrade -y
# 安装Docker
sudo apt install docker.io -y #安装不了要换(清华、阿里等)源
sudo systemctl start docker #现在启动
sudo systemctl enable docker #开机自启动
# 验证Docker安装
docker --version
# 创建专用目录
mkdir ~/hadoop-docker && cd ~/hadoop-docker

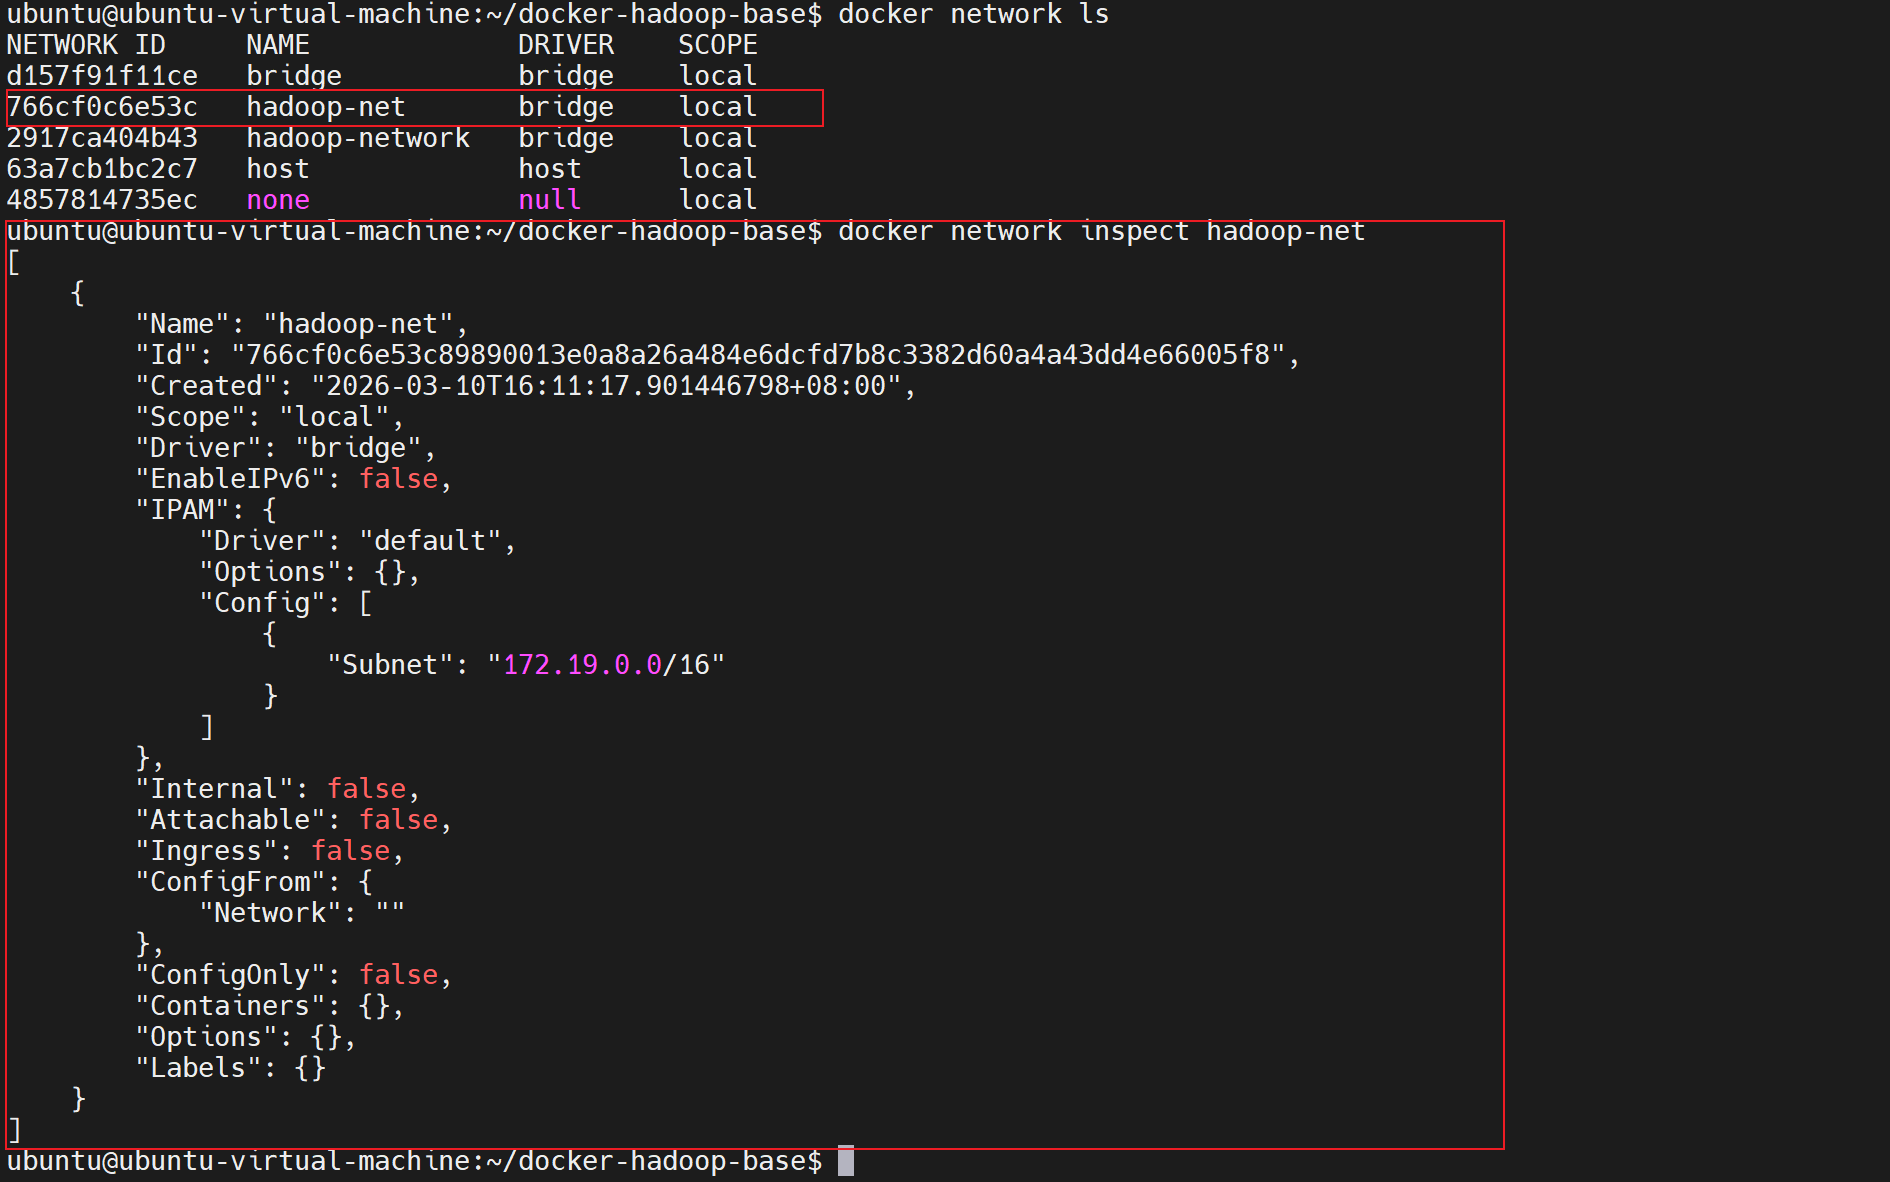
最佳实践:网络名称建议使用hadoop-net,便于后续管理。创建完成后,使用docker network ls验证网络是否成功创建。
docker network create \
  --driver bridge \
  --subnet=172.19.0.0/16 \
  hadoop-net
docker network inspect hadoop-net
二、构建基础镜像与启动容器
接下来,创建启动脚本和Dockerfile。启动脚本负责配置SSH、设置环境变量等初始化工作,而Dockerfile则定义镜像的构建过程。
sudo nano entrypoint.sh#!/bin/bash
# 启动SSH服务
service ssh start
# 生成SSH密钥(如果不存在)
if [ ! -f ~/.ssh/id_rsa ]; then
ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa
cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys
chmod 600 ~/.ssh/authorized_keys
fi
# 保持容器运行
tail -f /dev/nullsudo nano DockerfileFROM ubuntu:22.04
# 设置时区避免交互提示
ENV DEBIAN_FRONTEND=noninteractive
# 安装基础工具
RUN apt update && apt install -y \
openssh-server \
openjdk-11-jdk \
wget \
vim \
net-tools \
iputils-ping \
dnsutils
# 配置SSH
RUN mkdir /var/run/sshd
RUN echo 'root:root' | chpasswd
RUN sed -i 's/#PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config
RUN sed -i 's/#PasswordAuthentication yes/PasswordAuthentication yes/' /etc/ssh/sshd_config
# 安装Hadoop
#ENV HADOOP_VERSION=3.4.1
#ENV HADOOP_URL=https://downloads.apache.org/hadoop/common/hadoop-$HADOOP_VERSION/hadoop-$HADOOP_VERSION.tar.gz
#RUN wget $HADOOP_URL -O hadoop.tar.gz && \
# tar -xzvf hadoop.tar.gz -C /usr/local/ && \
# rm hadoop.tar.gz && \
# mv /usr/local/hadoop-$HADOOP_VERSION /usr/local/hadoop
# 复制本地Hadoop安装包(核心修改:不再从网上下载)
ENV HADOOP_VERSION=3.3.0
COPY ./hadoop-$HADOOP_VERSION.tar.gz /tmp/
# 安装Hadoop(使用本地包)
RUN tar -xzvf /tmp/hadoop-$HADOOP_VERSION.tar.gz -C /usr/local/ \
&& rm /tmp/hadoop-$HADOOP_VERSION.tar.gz \
&& mv /usr/local/hadoop-$HADOOP_VERSION /usr/local/hadoop \
&& chown -R root:root /usr/local/hadoop
# 设置环境变量
ENV JAVA_HOME=/usr/lib/jvm/java-11-openjdk-amd64
ENV HADOOP_HOME=/usr/local/hadoop
ENV HADOOP_MAPRED_HOME=/usr/local/hadoop # 新增这一行
ENV PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
# 创建数据目录
RUN mkdir -p /usr/local/hadoop/namenode_dir
RUN mkdir -p /usr/local/hadoop/datanode_dir
RUN mkdir -p /usr/local/hadoop/tmp
# 暴露端口
EXPOSE 22 9870 8088 9000 50070 50010
# 启动脚本
COPY entrypoint.sh /entrypoint.sh
RUN chmod +x /entrypoint.sh
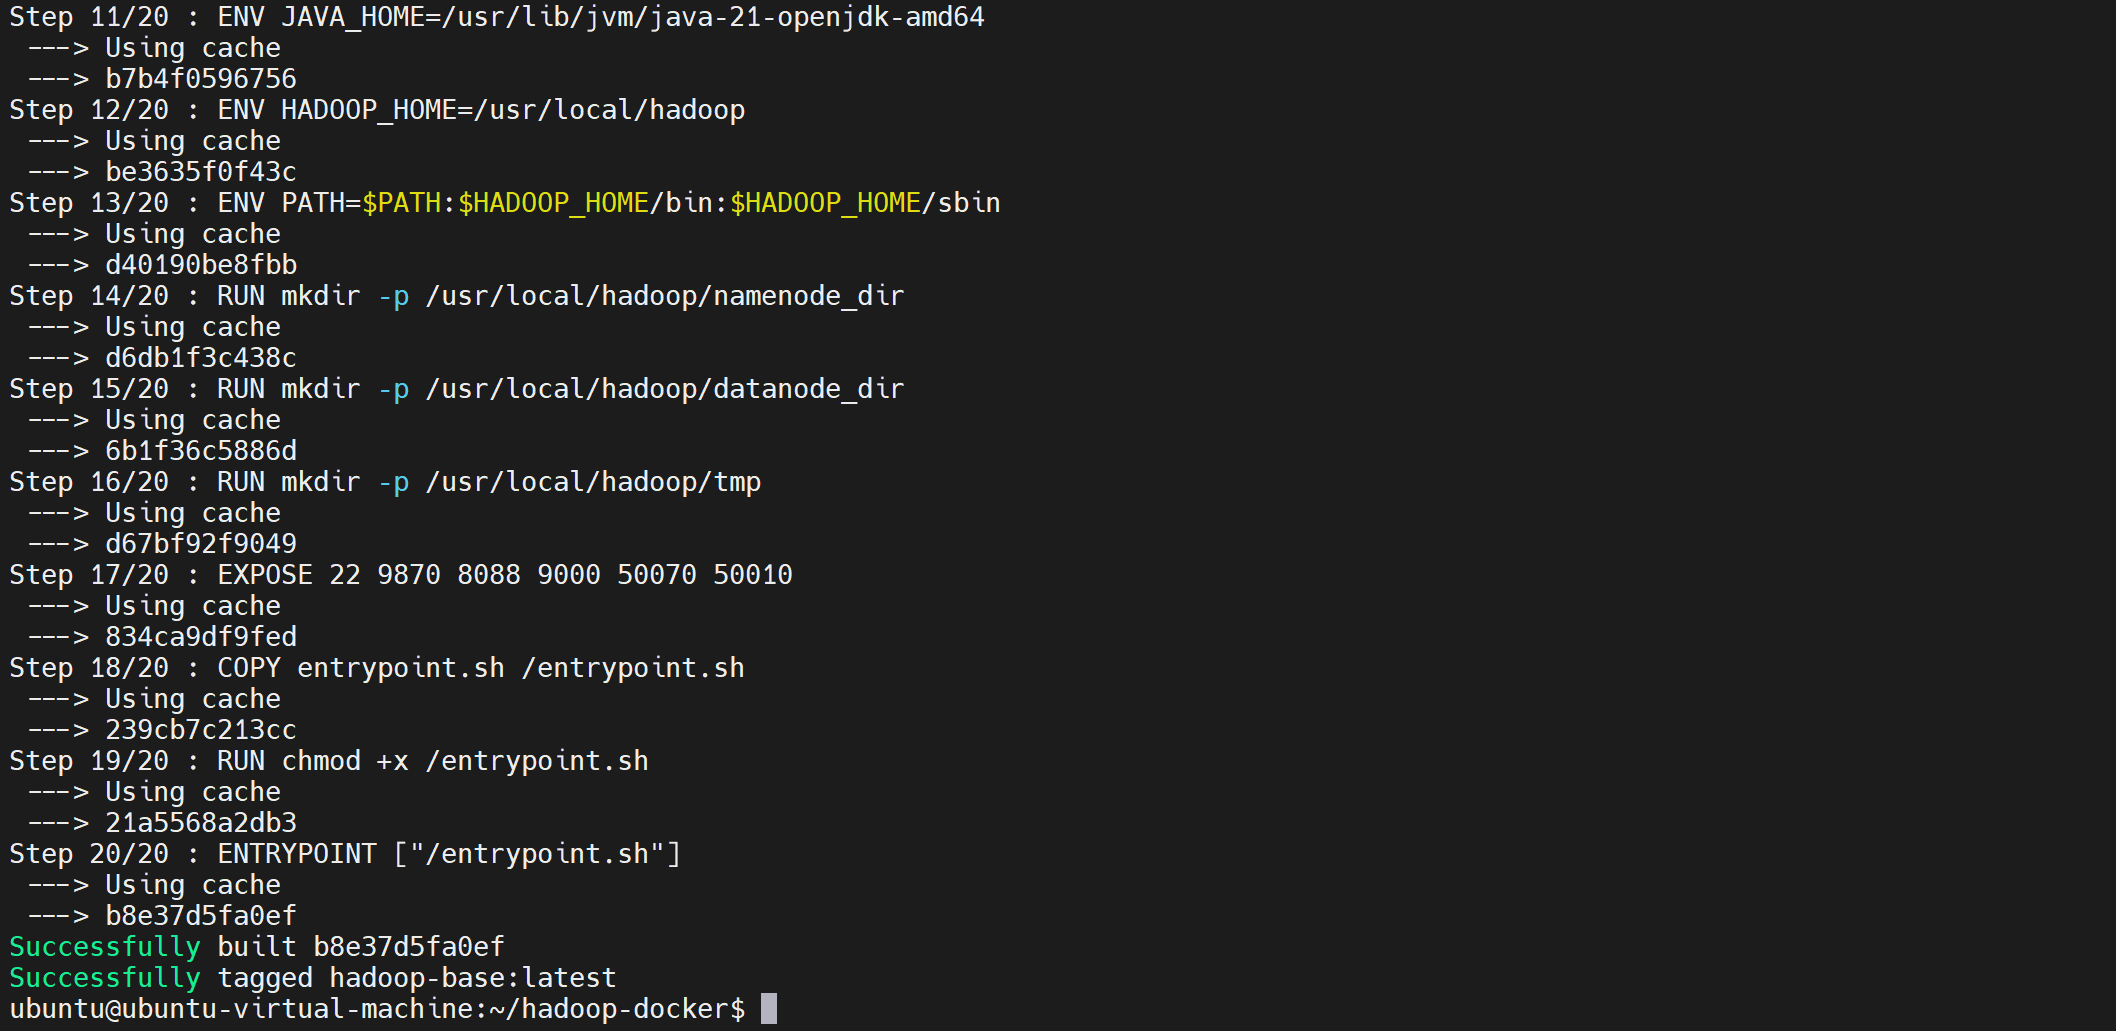
ENTRYPOINT ["/entrypoint.sh"]⚠️ 常见问题:如果构建镜像时出现网络超时,请检查Docker镜像源,建议使用国内镜像加速器。构建成功后,你会看到类似下面的镜像列表:

docker build -t hadoop-base .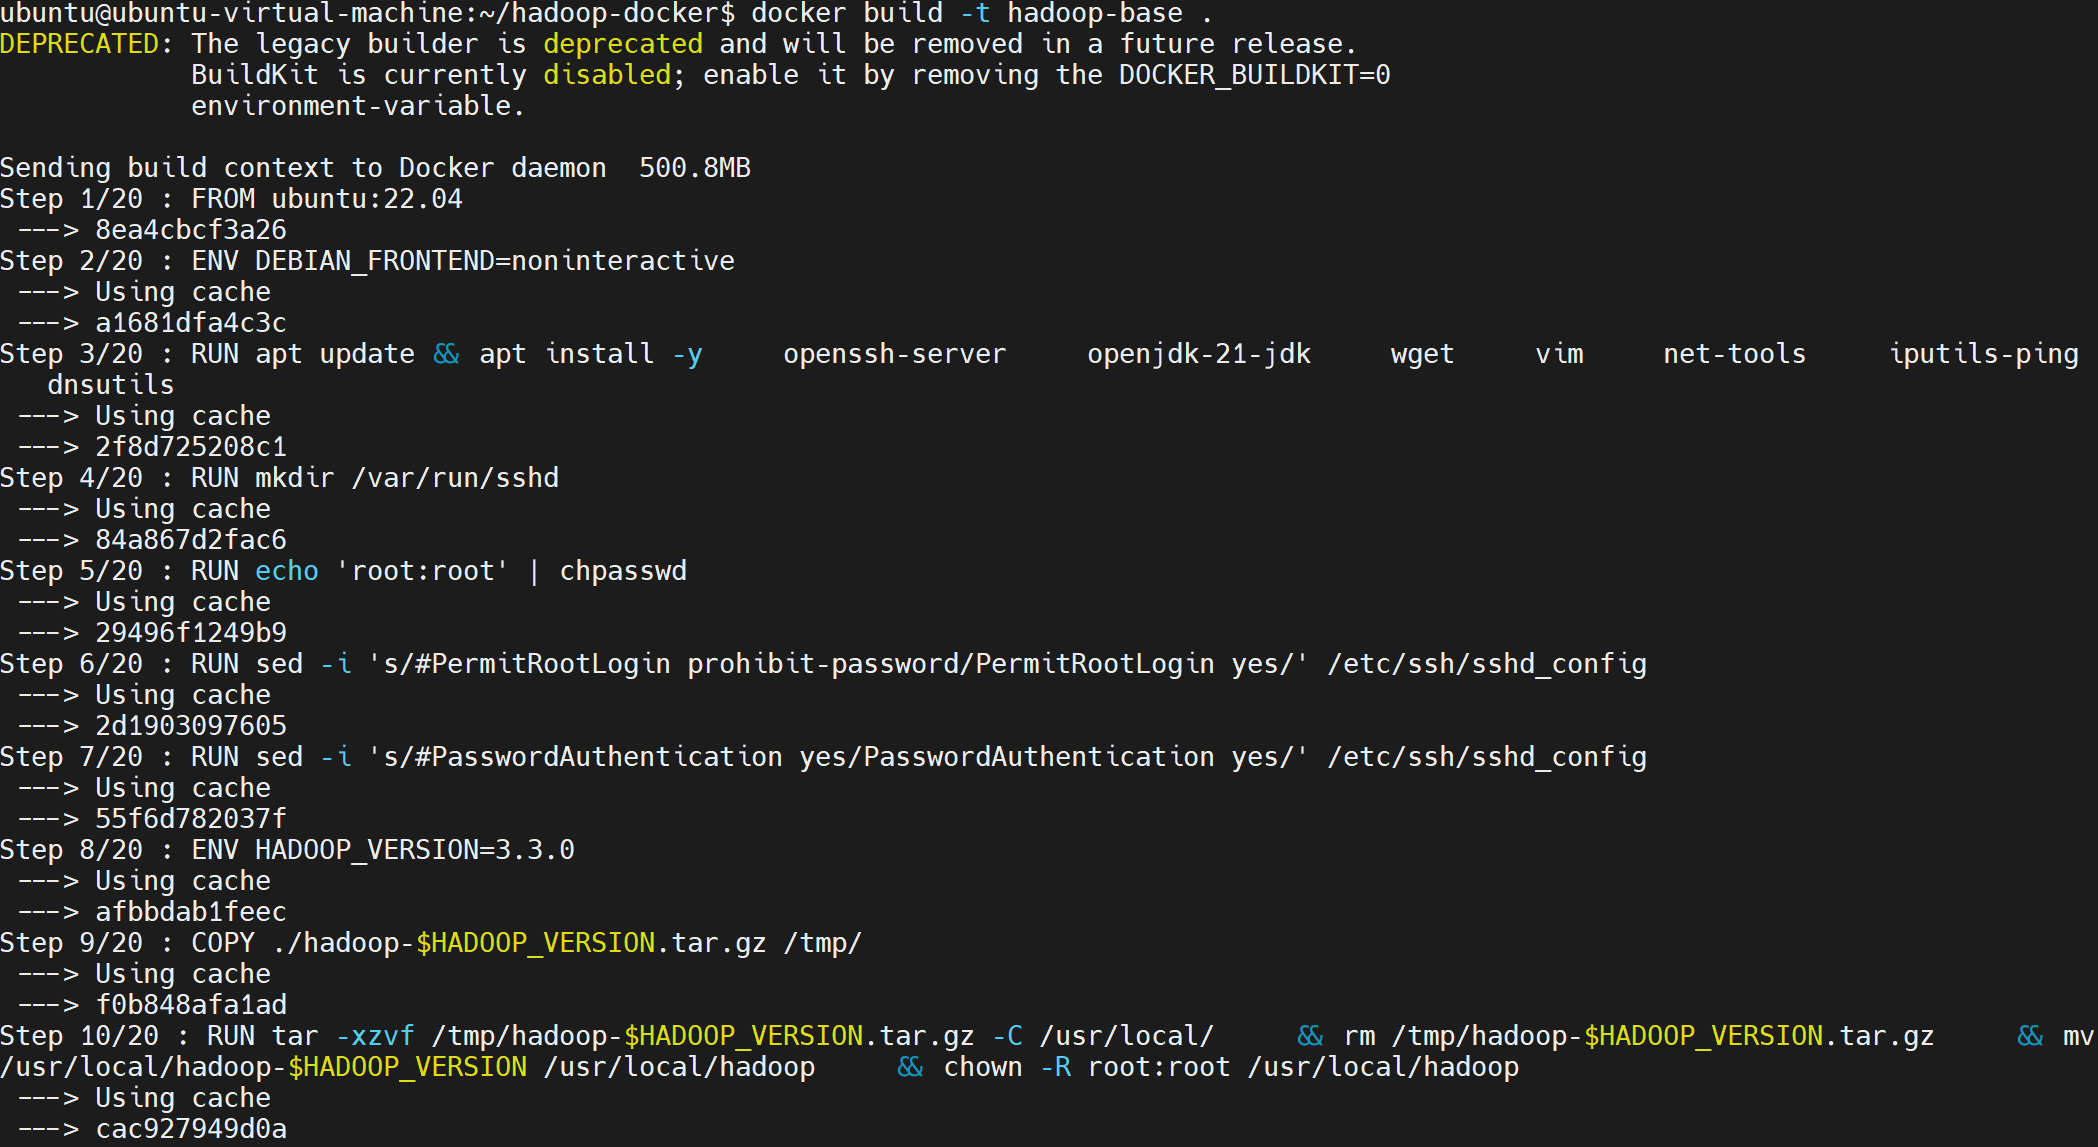
如果需要删除镜像,可执行以下命令:
构建镜像:
```bash
docker rmi hadoop-base:latest
## 四、启动Hadoop集群
1. 启动Master节点
```bash
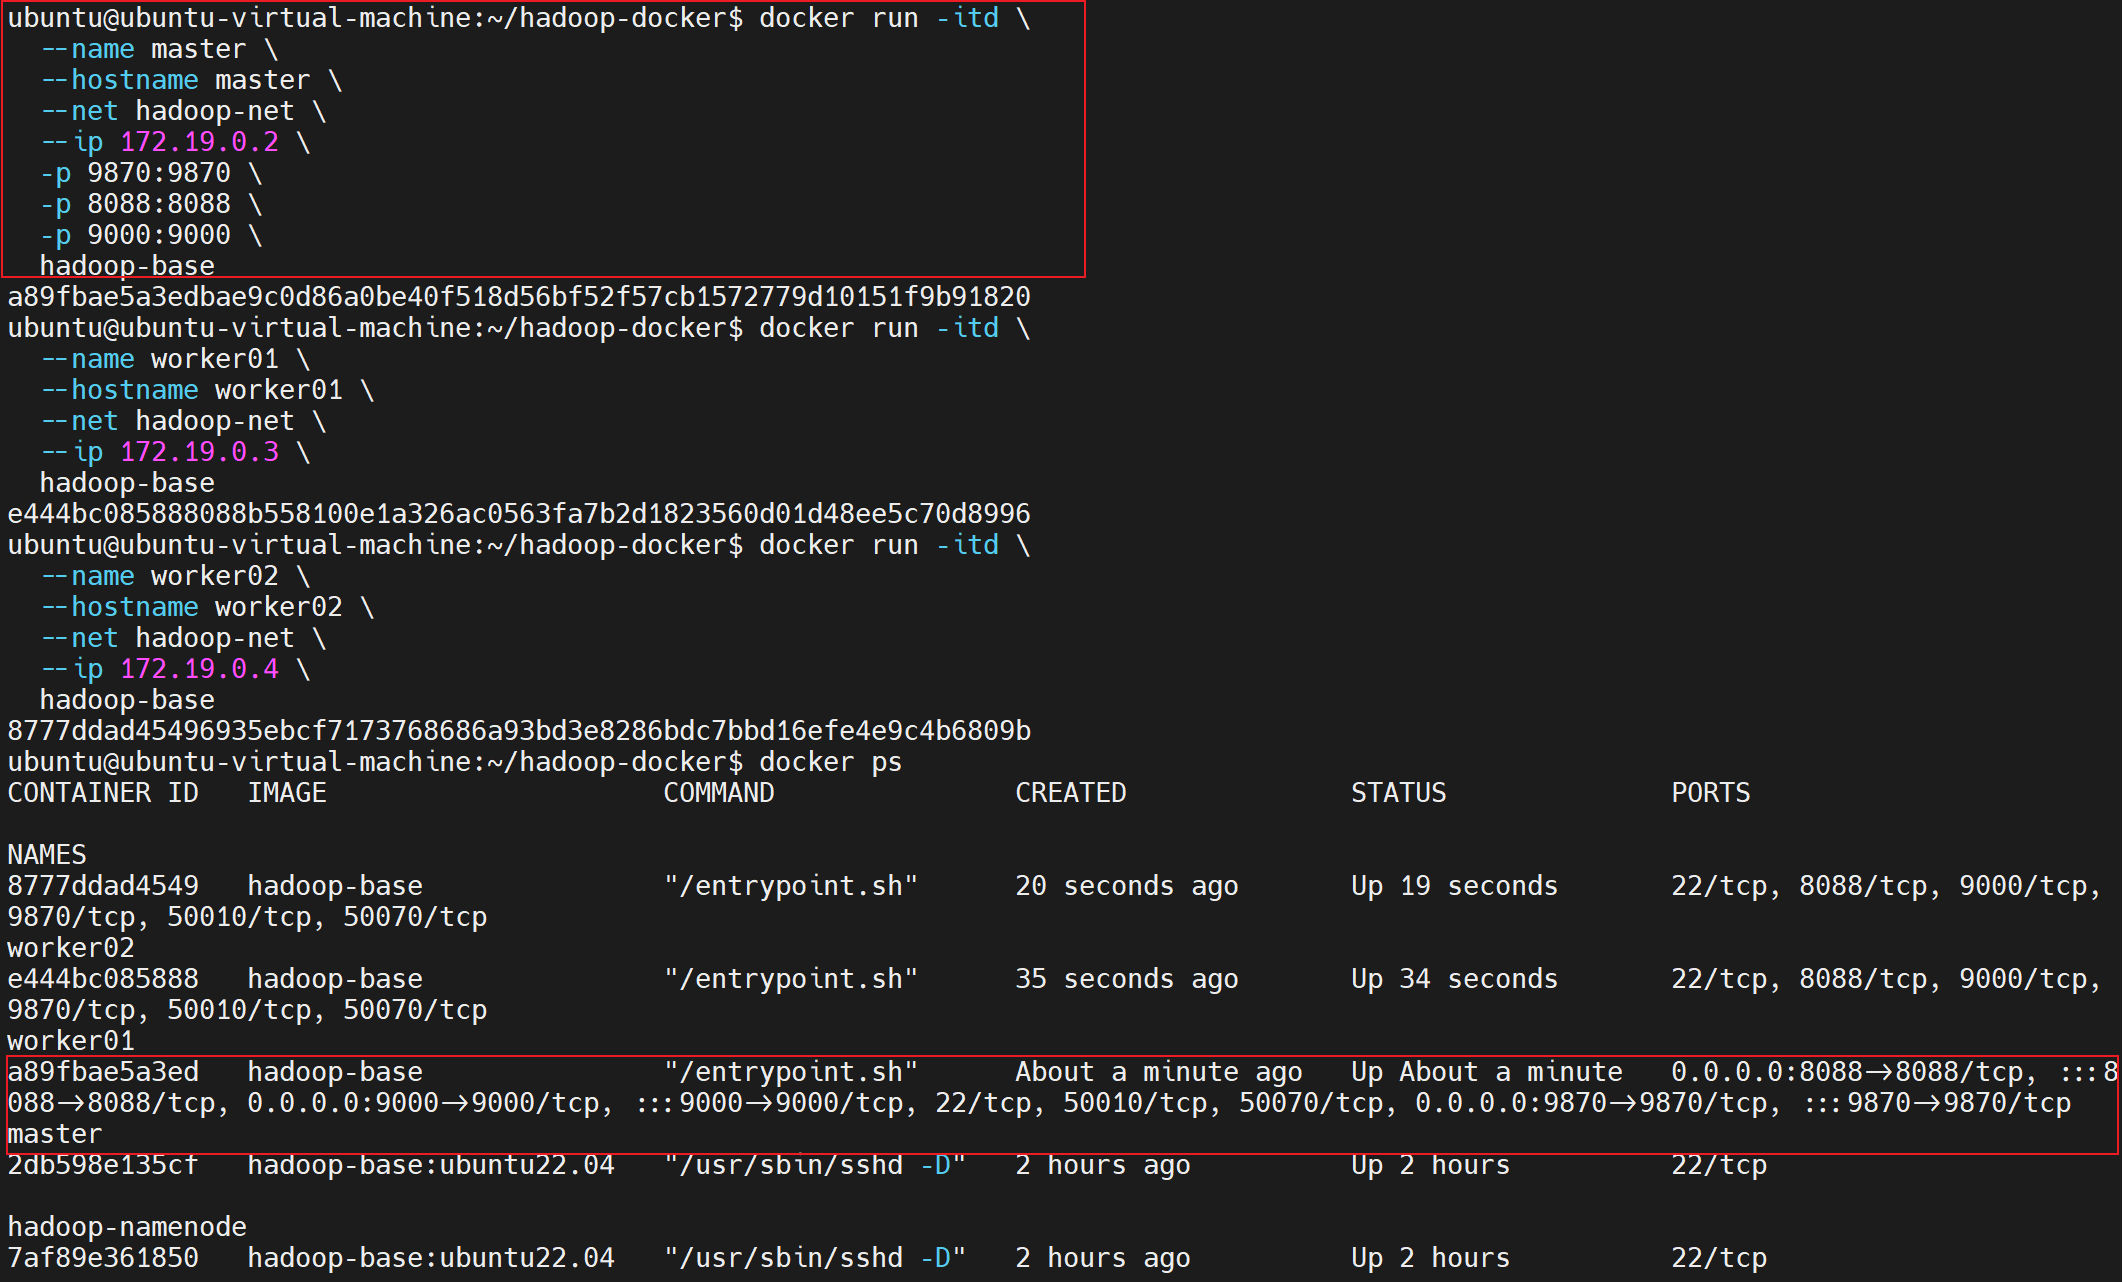
docker run -itd \
--name master \
--hostname master \
--net hadoop-net \
--ip 172.19.0.2 \
-p 9870:9870 \
-p 8088:8088 \
-p 9000:9000 \
hadoop-base然后,启动Worker节点:
docker run -itd \
--name worker01 \
--hostname worker01 \
--net hadoop-net \
--ip 172.19.0.3 \
hadoop-base
docker run -itd \
--name worker02 \
--hostname worker02 \
--net hadoop-net \
--ip 172.19.0.4 \
hadoop-base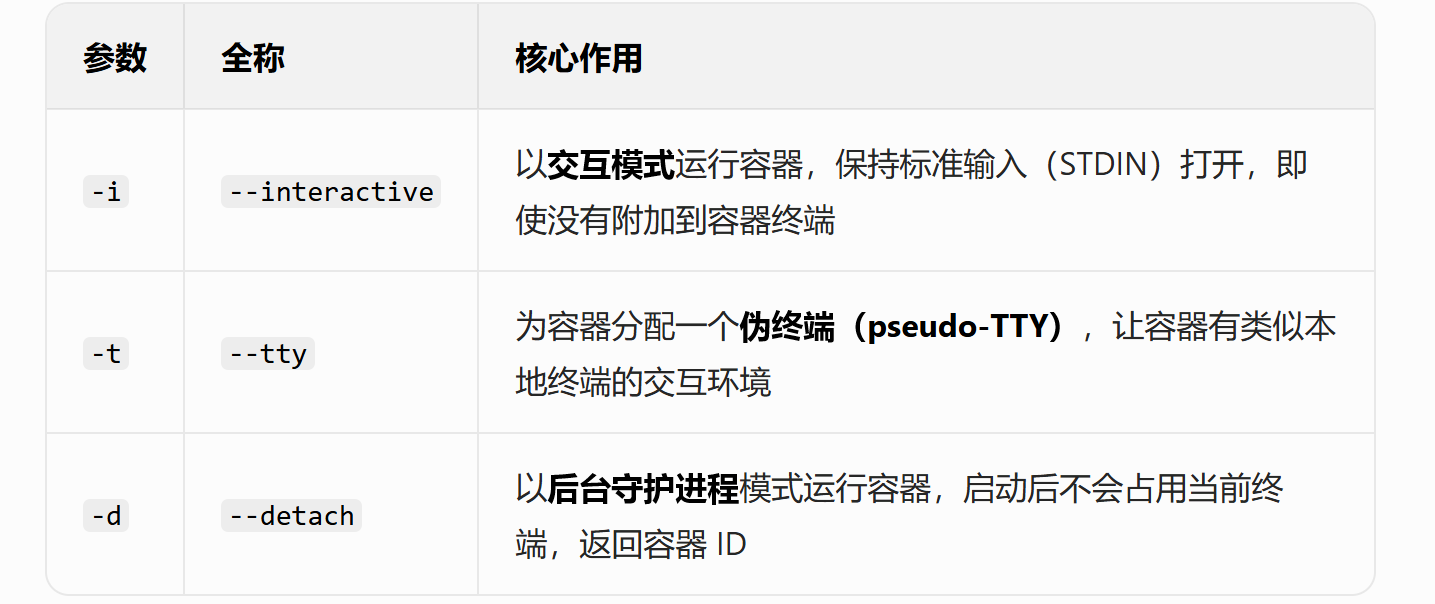
三、配置主机解析与SSH免密登录
Hadoop集群依赖主机名进行通信,因此需要在每个容器中配置/etc/hosts。同时,SSH免密登录是Hadoop分布式架构的基础,确保Master能无密码访问所有Worker节点。
在Master节点中配置主机解析:
docker exec master bash -c "echo '172.19.0.2 master' >> /etc/hosts"
docker exec master bash -c "echo '172.19.0.3 worker01' >> /etc/hosts"
docker exec master bash -c "echo '172.19.0.4 worker02' >> /etc/hosts"
在Worker01节点中:
docker exec worker01 bash -c "echo '172.19.0.2 master' >> /etc/hosts"
docker exec worker01 bash -c "echo '172.19.0.3 worker01' >> /etc/hosts"
docker exec worker01 bash -c "echo '172.19.0.4 worker02' >> /etc/hosts"
在Worker02节点中:
docker exec worker02 bash -c "echo '172.19.0.2 master' >> /etc/hosts"
docker exec worker02 bash -c "echo '172.19.0.3 worker01' >> /etc/hosts"
docker exec worker02 bash -c "echo '172.19.0.4 worker02' >> /etc/hosts"
接着,进入Master容器配置SSH:
docker exec -it master bash生成SSH密钥(这一步通常已执行,可跳过):
ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa配置免密登录:
# 将公钥复制到所有节点
ssh-copy-id master
ssh-copy-id worker01
ssh-copy-id worker02
# 测试免密登录
ssh worker01 hostname # 应返回 worker01
ssh worker02 hostname # 应返回 worker02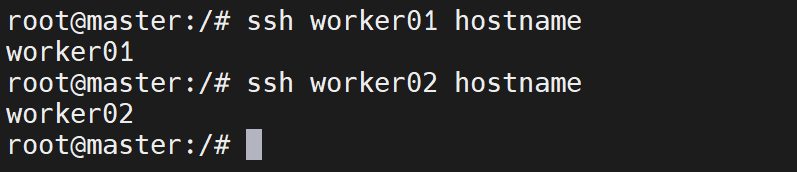
✅ 故障排查:如果ssh-copy-id worker01报错,按以下步骤修复:
# 这个是命令说明不用执行
ssh-copy-id master
# 等价
# 手动复制公钥(替代 ssh-copy-id master)
cat ~/.ssh/id_rsa.pub | ssh root@master "mkdir -p ~/.ssh && cat >> ~/.ssh/authorized_keys && chmod 600 ~/.ssh/authorized_keys && chmod 700 ~/.ssh"步骤1:登录worker01容器,检查并修复SSH配置:
# 从宿主机直接进入 worker01 容器(绕开 SSH,直接操作)
docker exec -it worker01 bash
# 1. 重置 root 密码为 root(确保密码正确)
echo 'root:root' | chpasswd
# 2. 确认 SSH 配置中开启密码登录(关键)
sed -i 's/#PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config
sed -i 's/#PasswordAuthentication yes/PasswordAuthentication yes/' /etc/ssh/sshd_config
# 3. 重启 SSH 服务,让配置生效
service ssh restart
# 4. 退出 worker01 容器
exit步骤2:回到ssh-copy-id worker01容器,重新执行:
# 在 master 容器内执行
ssh-copy-id worker01此时提示Are you sure you want to continue connecting (yes/no/[fingerprint])?,输入yes;接着提示root@worker01's password:,输入root(重置后的密码)。
步骤3:同理修复worker02:
# 宿主机执行:进入 worker02 容器
docker exec -it worker02 bash
# 重置密码+开启SSH密码登录
echo 'root:root' | chpasswd
sed -i 's/#PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config
sed -i 's/#PasswordAuthentication yes/PasswordAuthentication yes/' /etc/ssh/sshd_config
service ssh restart
exit
# master 容器内执行:复制公钥到 worker02
ssh-copy-id worker02
步骤4:验证免密登录:
# 在 master 容器内测试
ssh worker01  # 应直接登录,无密码提示
ssh worker02  # 同理
四、Hadoop集群配置与启动
现在进入核心环节——配置Hadoop。创建配置文件目录,并逐一编写core-site.xml、hdfs-site.xml、mapred-site.xml、yarn-site.xml以及workers文件。
mkdir /usr/local/hadoop/etc/hadoop/config
cd /usr/local/hadoop/etc/hadoop/config
vi core-site.xml<configuration>
<property>
<name>fs.defaultFS</name>
<value>hdfs://master:9000</value>
</property>
<property>
<name>hadoop.tmp.dir</name>
<value>/usr/local/hadoop/tmp</value>
</property>
</configuration>vi hdfs-site.xml<configuration>
<property>
<name>dfs.replication</name>
<value>2</value>
</property>
<property>
<name>dfs.namenode.name.dir</name>
<value>/usr/local/hadoop/namenode_dir</value>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/usr/local/hadoop/datanode_dir</value>
</property>
<property>
<name>dfs.permissions</name>
<value>false</value>
</property>
</configuration>vi mapred-site.xml<configuration>
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
<property>
<name>yarn.app.mapreduce.am.env</name>
<value>HADOOP_MAPRED_HOME=$HADOOP_HOME</value>
</property>
<property>
<name>mapreduce.map.env</name>
<value>HADOOP_MAPRED_HOME=$HADOOP_HOME</value>
</property>
<property>
<name>mapreduce.reduce.env</name>
<value>HADOOP_MAPRED_HOME=$HADOOP_HOME</value>
</property>
</configuration>vi yarn-site.xml<configuration>
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<property>
<name>yarn.resourcemanager.hostname</name>
<value>master</value>
</property>
<property>
<name>yarn.nodemanager.env-whitelist</name>
<value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
</property>
<property>
<name>yarn.application.classpath</name>
<value>
$HADOOP_HOME/etc/hadoop,
$HADOOP_HOME/share/hadoop/common/*,
$HADOOP_HOME/share/hadoop/common/lib/*,
$HADOOP_HOME/share/hadoop/hdfs/*,
$HADOOP_HOME/share/hadoop/hdfs/lib/*,
$HADOOP_HOME/share/hadoop/mapreduce/*,
$HADOOP_HOME/share/hadoop/mapreduce/lib/*,
$HADOOP_HOME/share/hadoop/yarn/*,
$HADOOP_HOME/share/hadoop/yarn/lib/*
</value>
</property>
</configuration>vi workersworker01
worker02配置环境变量:
vi /usr/local/hadoop/etc/hadoop/hadoop-env.shexport JAVA_HOME=/usr/lib/jvm/java-11-openjdk-amd64
export HADOOP_HOME=/usr/local/hadoop
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export HDFS_NAMENODE_USER=root
export HDFS_DATANODE_USER=root
export HDFS_SECONDARYNAMENODE_USER=root
export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root分发配置到Worker节点:
# 在Master容器中执行
for worker in worker01 worker02; do
scp -r $HADOOP_HOME/etc/hadoop/config/* $worker:$HADOOP_HOME/etc/hadoop/
scp $HADOOP_HOME/etc/hadoop/hadoop-env.sh $worker:$HADOOP_HOME/etc/hadoop/
done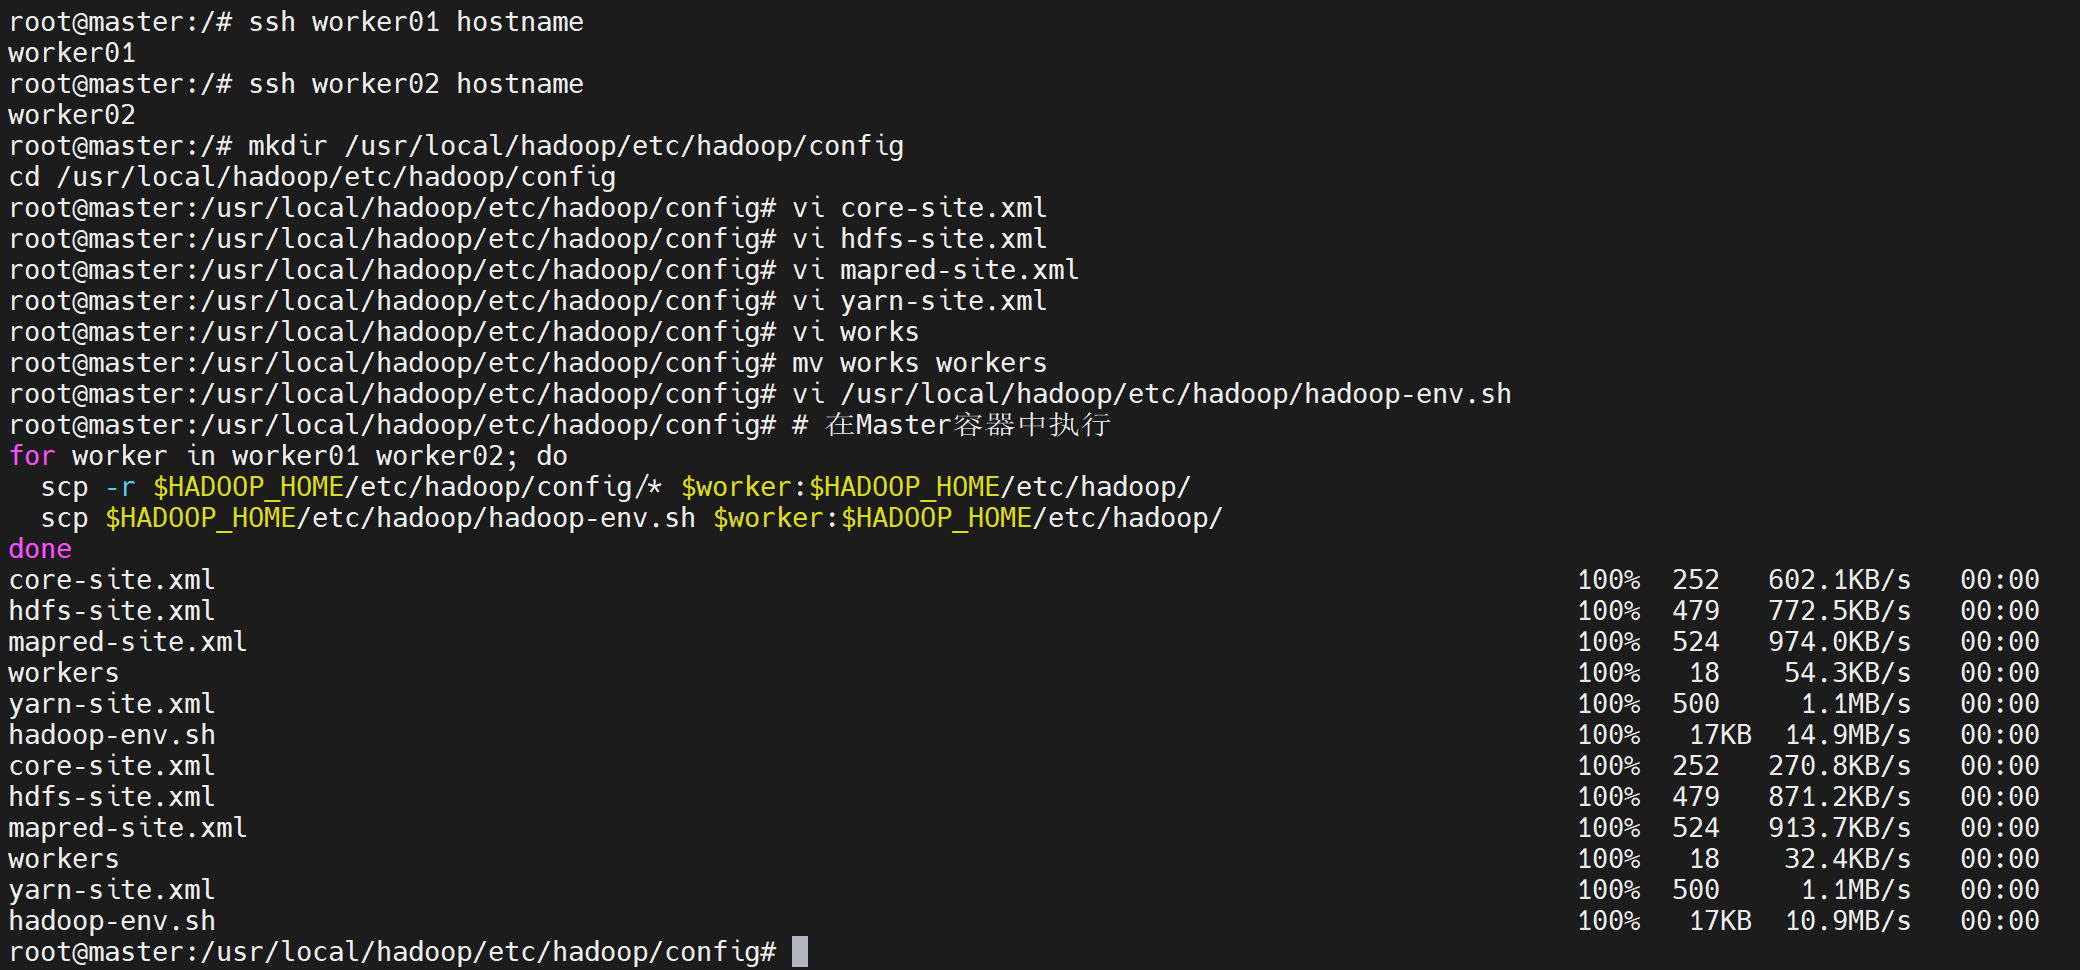
将Master容器中的文件覆盖到/etc/hadoop:
# 进入 Hadoop 配置根目录
cd /usr/local/hadoop/etc/hadoop/
# 强制覆盖:将 config 目录下的所有配置文件复制到当前目录(覆盖原有文件)
cp -f config/* ./
# 验证覆盖结果(查看核心文件是否已更新)
ls -l core-site.xml hdfs-site.xml yarn-site.xml mapred-site.xml workers
启动集群
先格式化NameNode:
hdfs namenode -format成功标志:看到Storage directory has been successfully formatted信息。
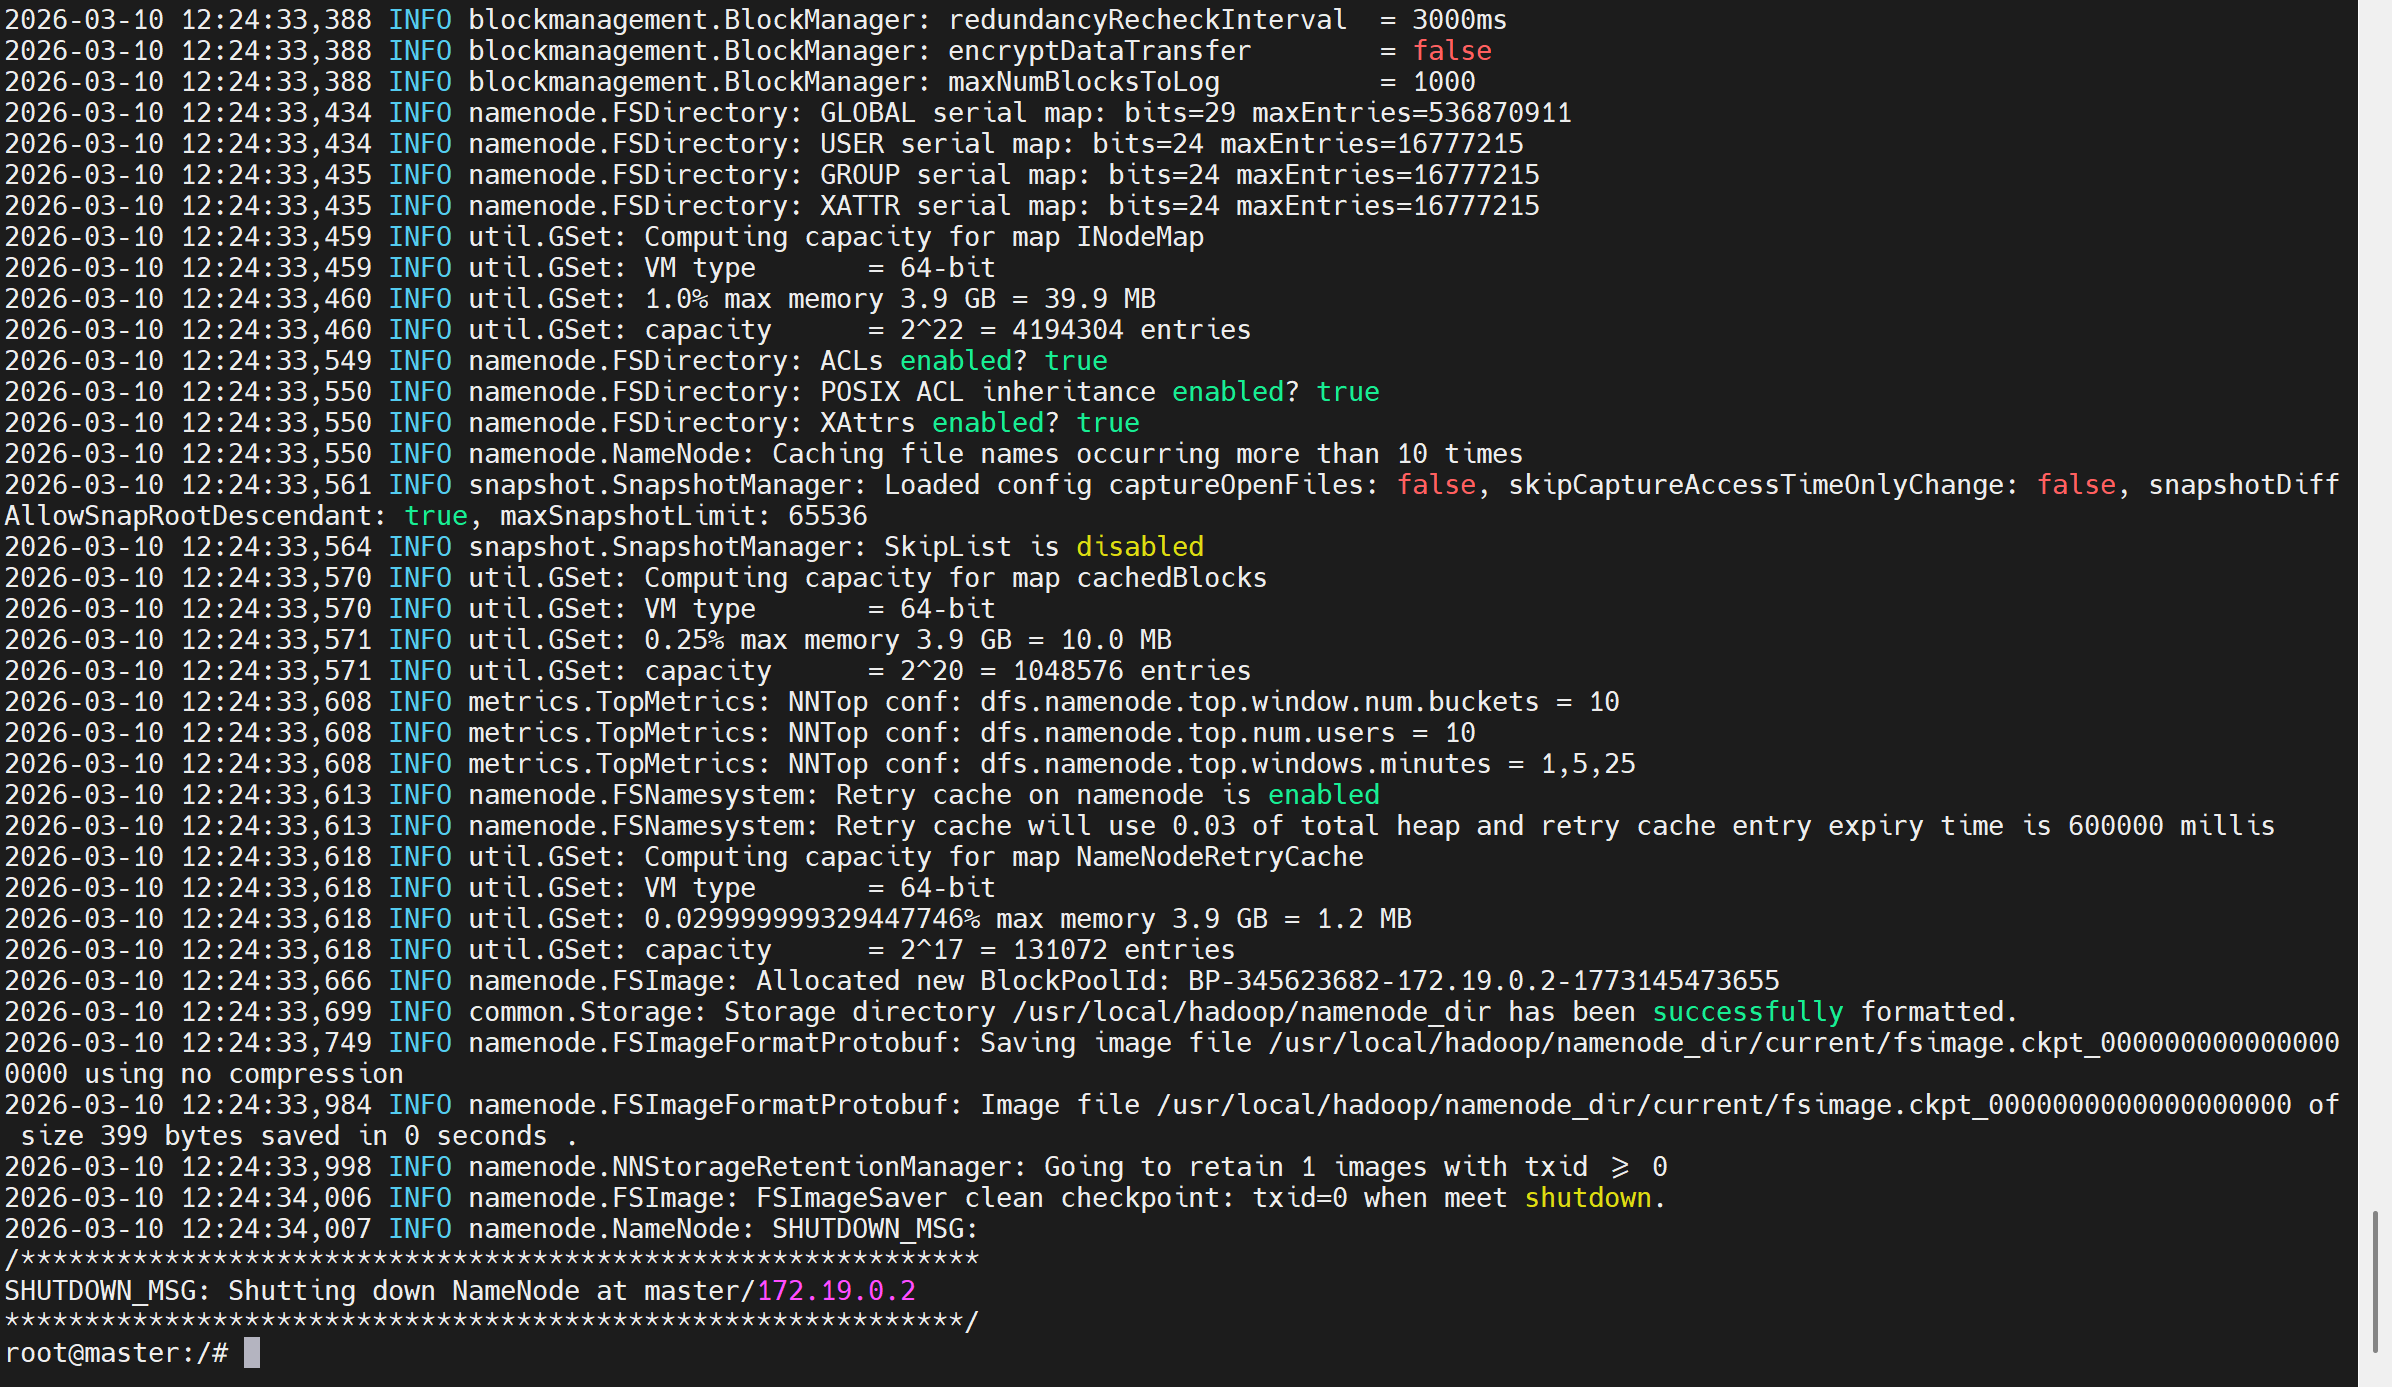
如果失败,需重新格式化前删除原有数据:
# 清空 NameNode 元数据目录(namenode_dir)
rm -rf /usr/local/hadoop/namenode_dir/*
# 清空 DataNode 数据目录(datanode_dir)
rm -rf /usr/local/hadoop/datanode_dir/*
# 清空 Hadoop 临时目录(tmp)
rm -rf /usr/local/hadoop/tmp/*
# 验证清空结果(目录为空,输出 total 0)
echo "=== 验证目录清空结果 ==="
ls -l /usr/local/hadoop/namenode_dir/
ls -l /usr/local/hadoop/datanode_dir/
ls -l /usr/local/hadoop/tmp/
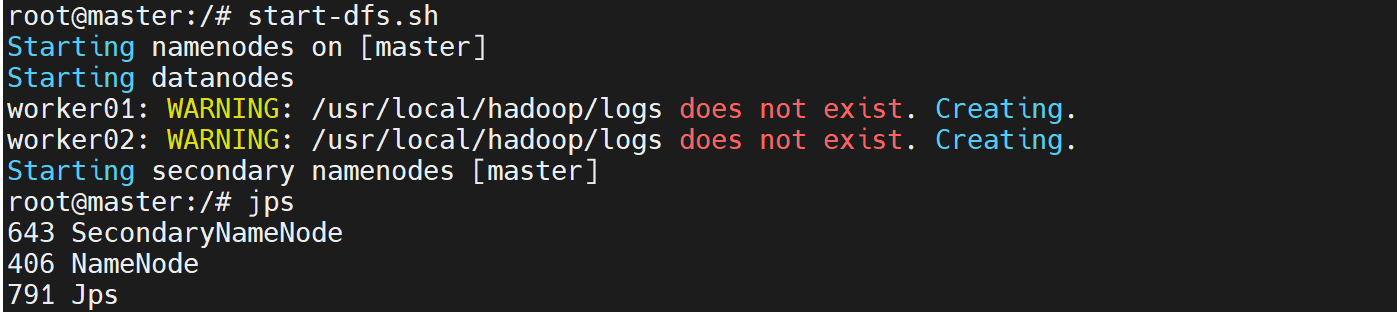
启动HDFS:
start-dfs.sh验证:
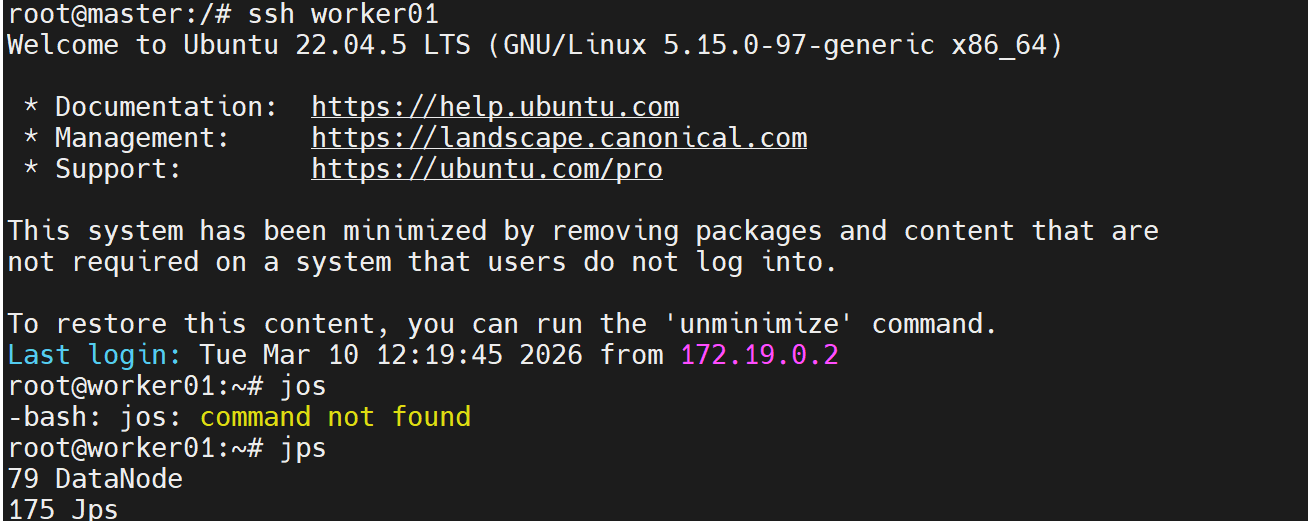
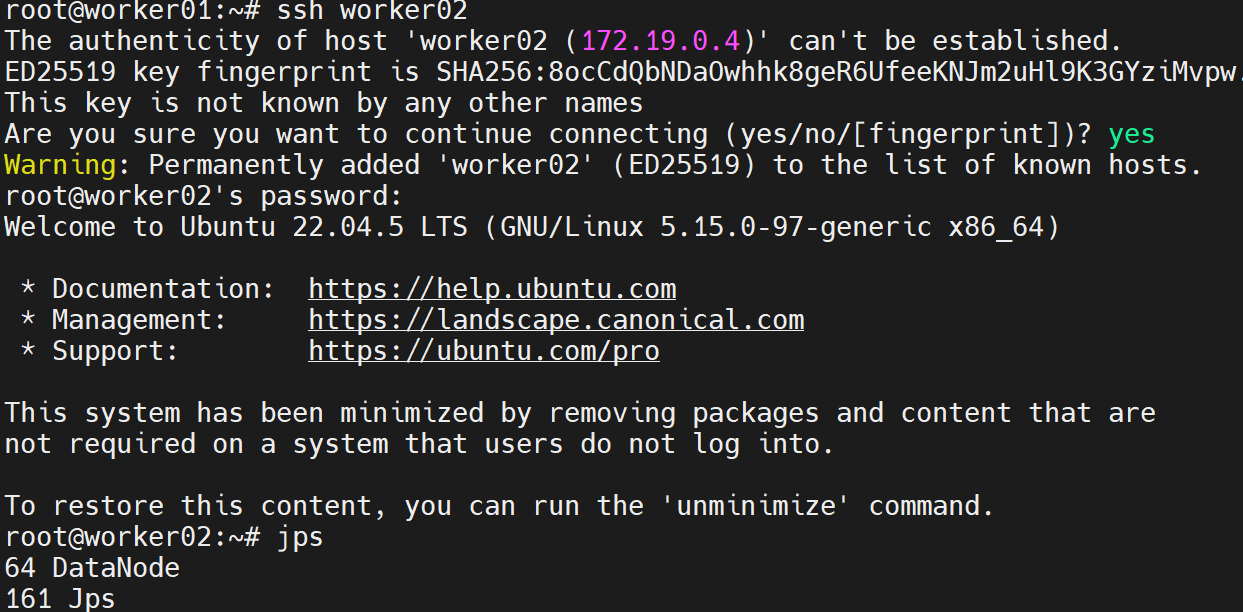
jps应看到:xxxxx NameNode xxxxx DataNode xxxxx SecondaryNameNode
启动YARN:
start-yarn.sh验证:
jps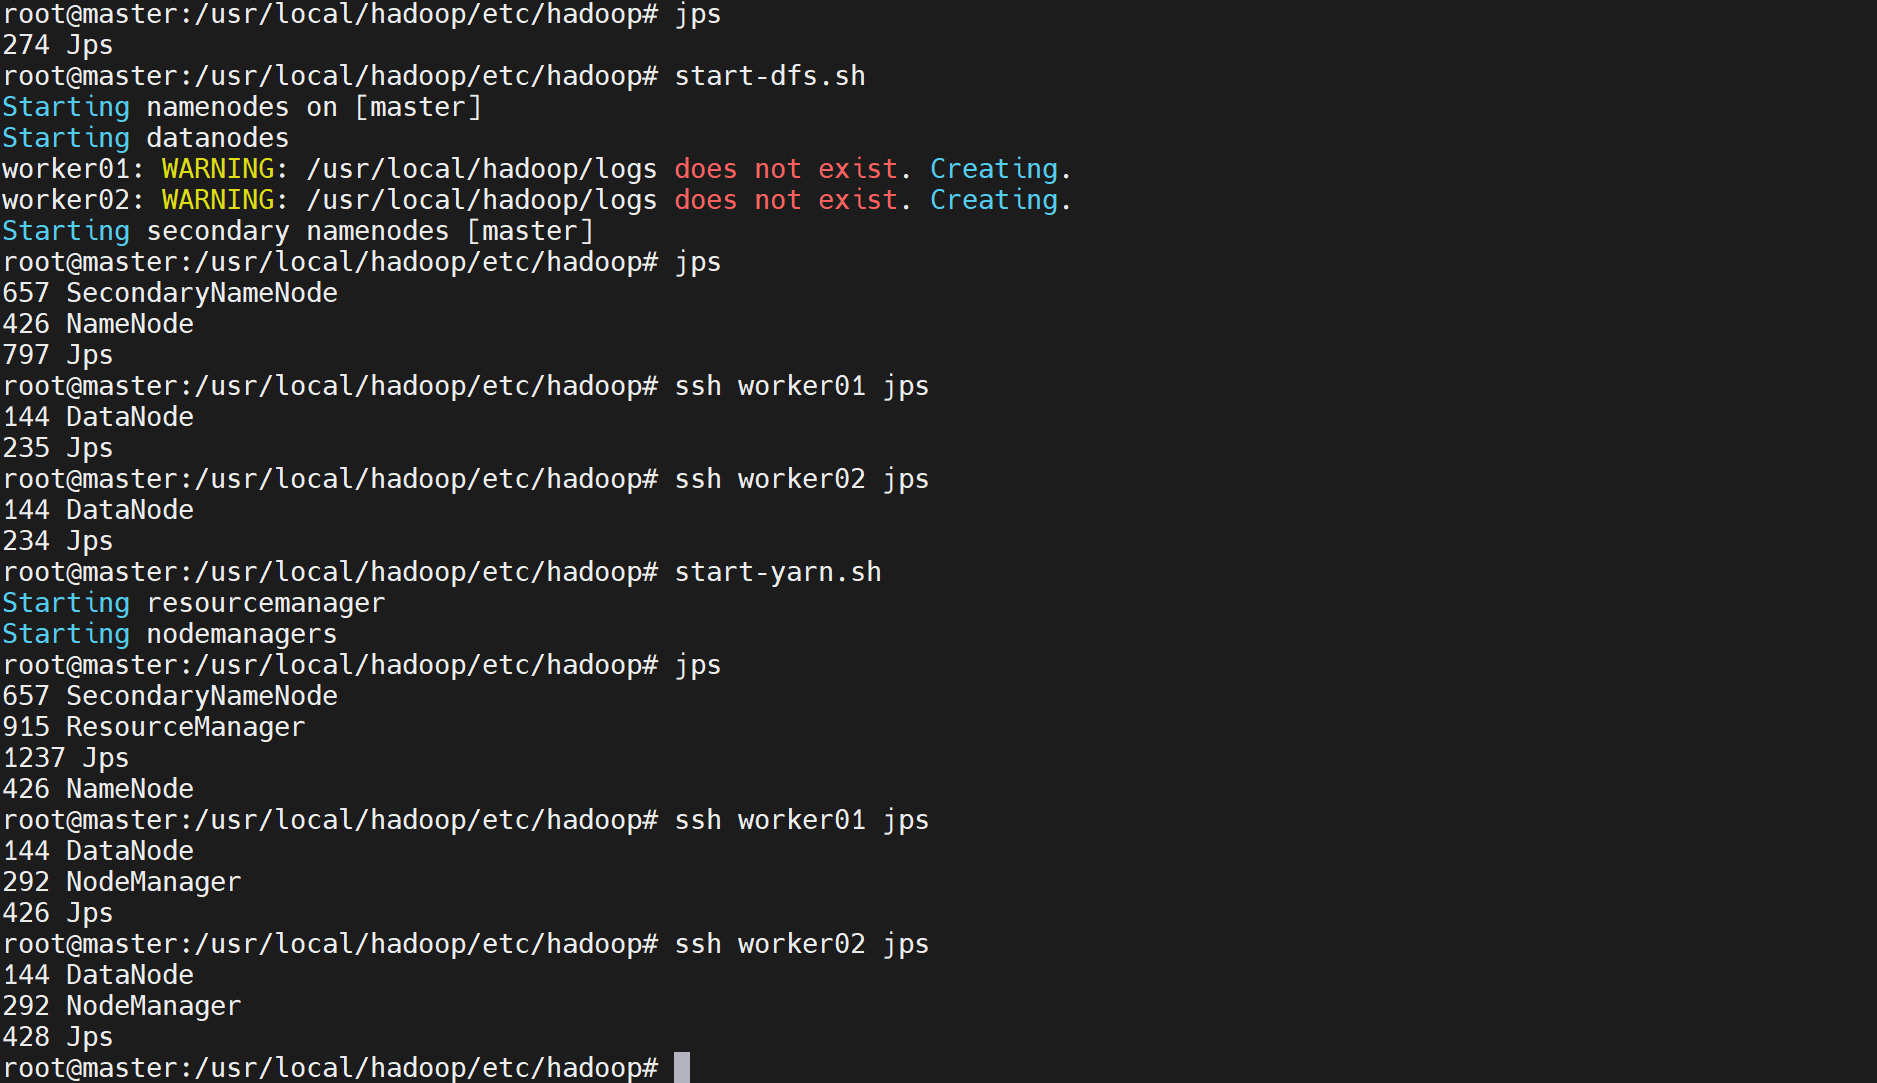
五、验证集群功能与WordCount测试
集群启动后,进行功能验证。创建测试目录并上传文件:
hdfs dfs -mkdir -p /user/root/inputecho "Hello Hadoop World" > test.txt
hdfs dfs -put test.txt /user/root/input查看HDFS内容:
hdfs dfs -ls /user/root/input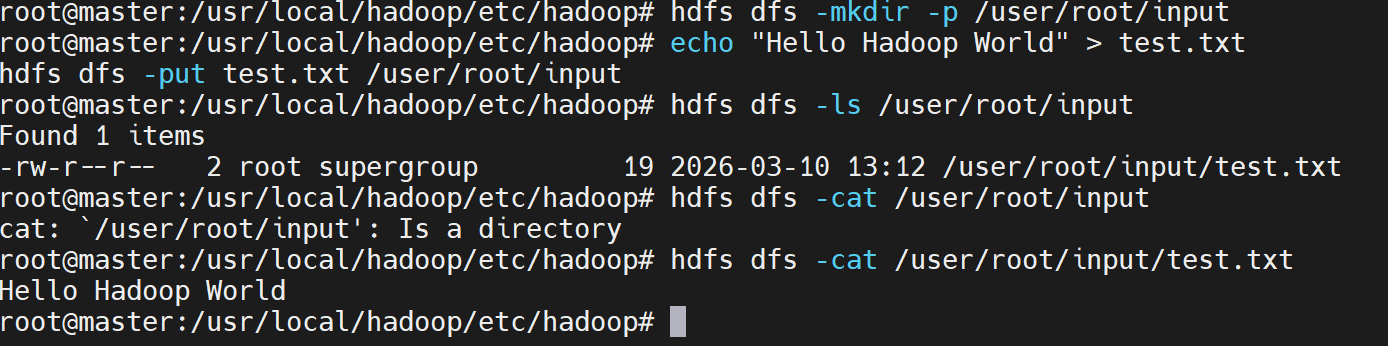
运行WordCount示例:
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.0.jar wordcount /user/root/input /user/root/output如果出现问题,强制执行:
# 终极兜底命令(复制粘贴直接运行)
hadoop jar \
$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.0.jar \
wordcount \
-Dmapreduce.application.classpath=$(hadoop classpath) \
-Dyarn.app.mapreduce.am.env="HADOOP_MAPRED_HOME=/usr/local/hadoop" \
-Dmapreduce.map.env="HADOOP_MAPRED_HOME=/usr/local/hadoop" \
-Dmapreduce.reduce.env="HADOOP_MAPRED_HOME=/usr/local/hadoop" \
/user/root/input \
/user/root/output
查看结果:
hdfs dfs -cat /user/root/output/part-r-00000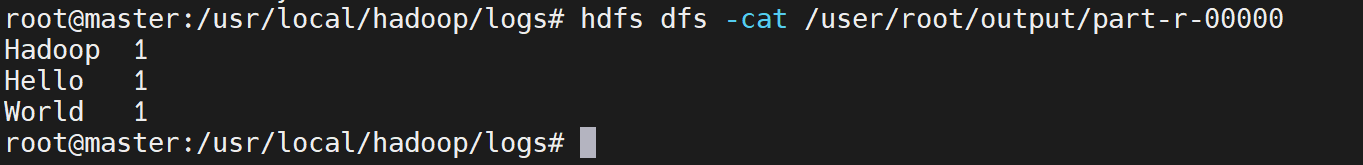
如果环境变量未生效,可尝试全局设置(但此方法可能无效):
echo "export HADOOP_MAPRED_HOME=/usr/local/hadoop" >> /etc/profile
source /etc/profile
# 同步到 worker 节点
for node in worker01 worker02; do
ssh $node "echo 'export HADOOP_MAPRED_HOME=/usr/local/hadoop' >> /etc/profile && source /etc/profile"
done六、容器编排与生产化思考
虽然本文使用Docker Compose完成了单机集群部署,但在生产环境中,容器编排工具如Kubernetes(K8s)才是更优选择。K8s能自动管理容器生命周期、实现弹性伸缩、服务发现和故障恢复。如果你的集群需要长期稳定运行,建议将Hadoop容器化部署迁移到Kubernetes上,利用其强大的调度能力。
扩展建议:可以尝试使用Helm Chart一键部署Hadoop on K8s,或者结合Hadoop YARN的容器化版本(如Hadoop 3.x的YARN Federation)实现更细粒度的资源管理。
[AFFILIATE_SLOT_2]总结
本文从环境准备、镜像构建、容器启动到集群配置与验证,完整演示了Docker部署Hadoop 3.3.0集群的全流程。通过容器化部署,你可以在几分钟内搭建一个可用的Hadoop环境,非常适合开发测试与学习。未来,结合Kubernetes等容器编排技术,还能实现更高效、更弹性的大数据平台。希望本文能帮助你快速上手,并在实践中避开常见陷阱。


 浙公网安备 33010602011771号