在流处理领域,Flink凭借其强大的状态管理能力成为业界标杆。当作业需要动态调整并行度以应对流量变化时,RocksDB状态如何高效迁移是一个关键问题。本文将深入剖析其核心机制,帮助开发者理解并优化生产环境中的状态恢复性能。
一、Key Group分片模型:状态迁移的数学基础
要理解并行度变更时RocksDB状态如何迁移,首先需要掌握Flink如何组织状态。Flink并不直接将Key分配给SubTask,而是通过一个稳定的中间层——Key Group——来实现灵活的分片。具体来说,Flink利用 MurmurHash(key) % maxParallelism 将整个Key空间映射到 [0, maxParallelism) 个Key Group,然后将这些Key Group连续地分配给各个SubTask。
这里的关键在于 maxParallelism(最大并行度)是一个作业启动时固定的上界,默认值为128,且在整个作业生命周期内永不改变。当并行度发生变化时,只有Key Group的分配关系会调整,Key Group本身以及Key到Key Group的映射关系保持不变。这意味着通过简单的切割或合并Key Group区间,就能实现任意并行度的调整,无需重新哈希任何一条数据。这种设计类似于Go语言中通过固定大小的桶来管理并发任务,既高效又稳定。
二、RocksDB中的状态组织与SST文件结构
在RocksDB中,每个Column Family对应一个Flink State(例如一个 ValueState<Long>)。每条记录的Key编码格式为:
[key_group (2B)] [key_serialized] [namespace_serialized]当执行Checkpoint并写入HDFS/S3时,RocksDB会为每个Key Group区间生成独立的SST文件集。每个SST文件都携带元数据,标注它属于哪个Key Group范围。这种设计类似于Python中的字典分区,可以快速定位数据所在区域。下图展示了这一过程: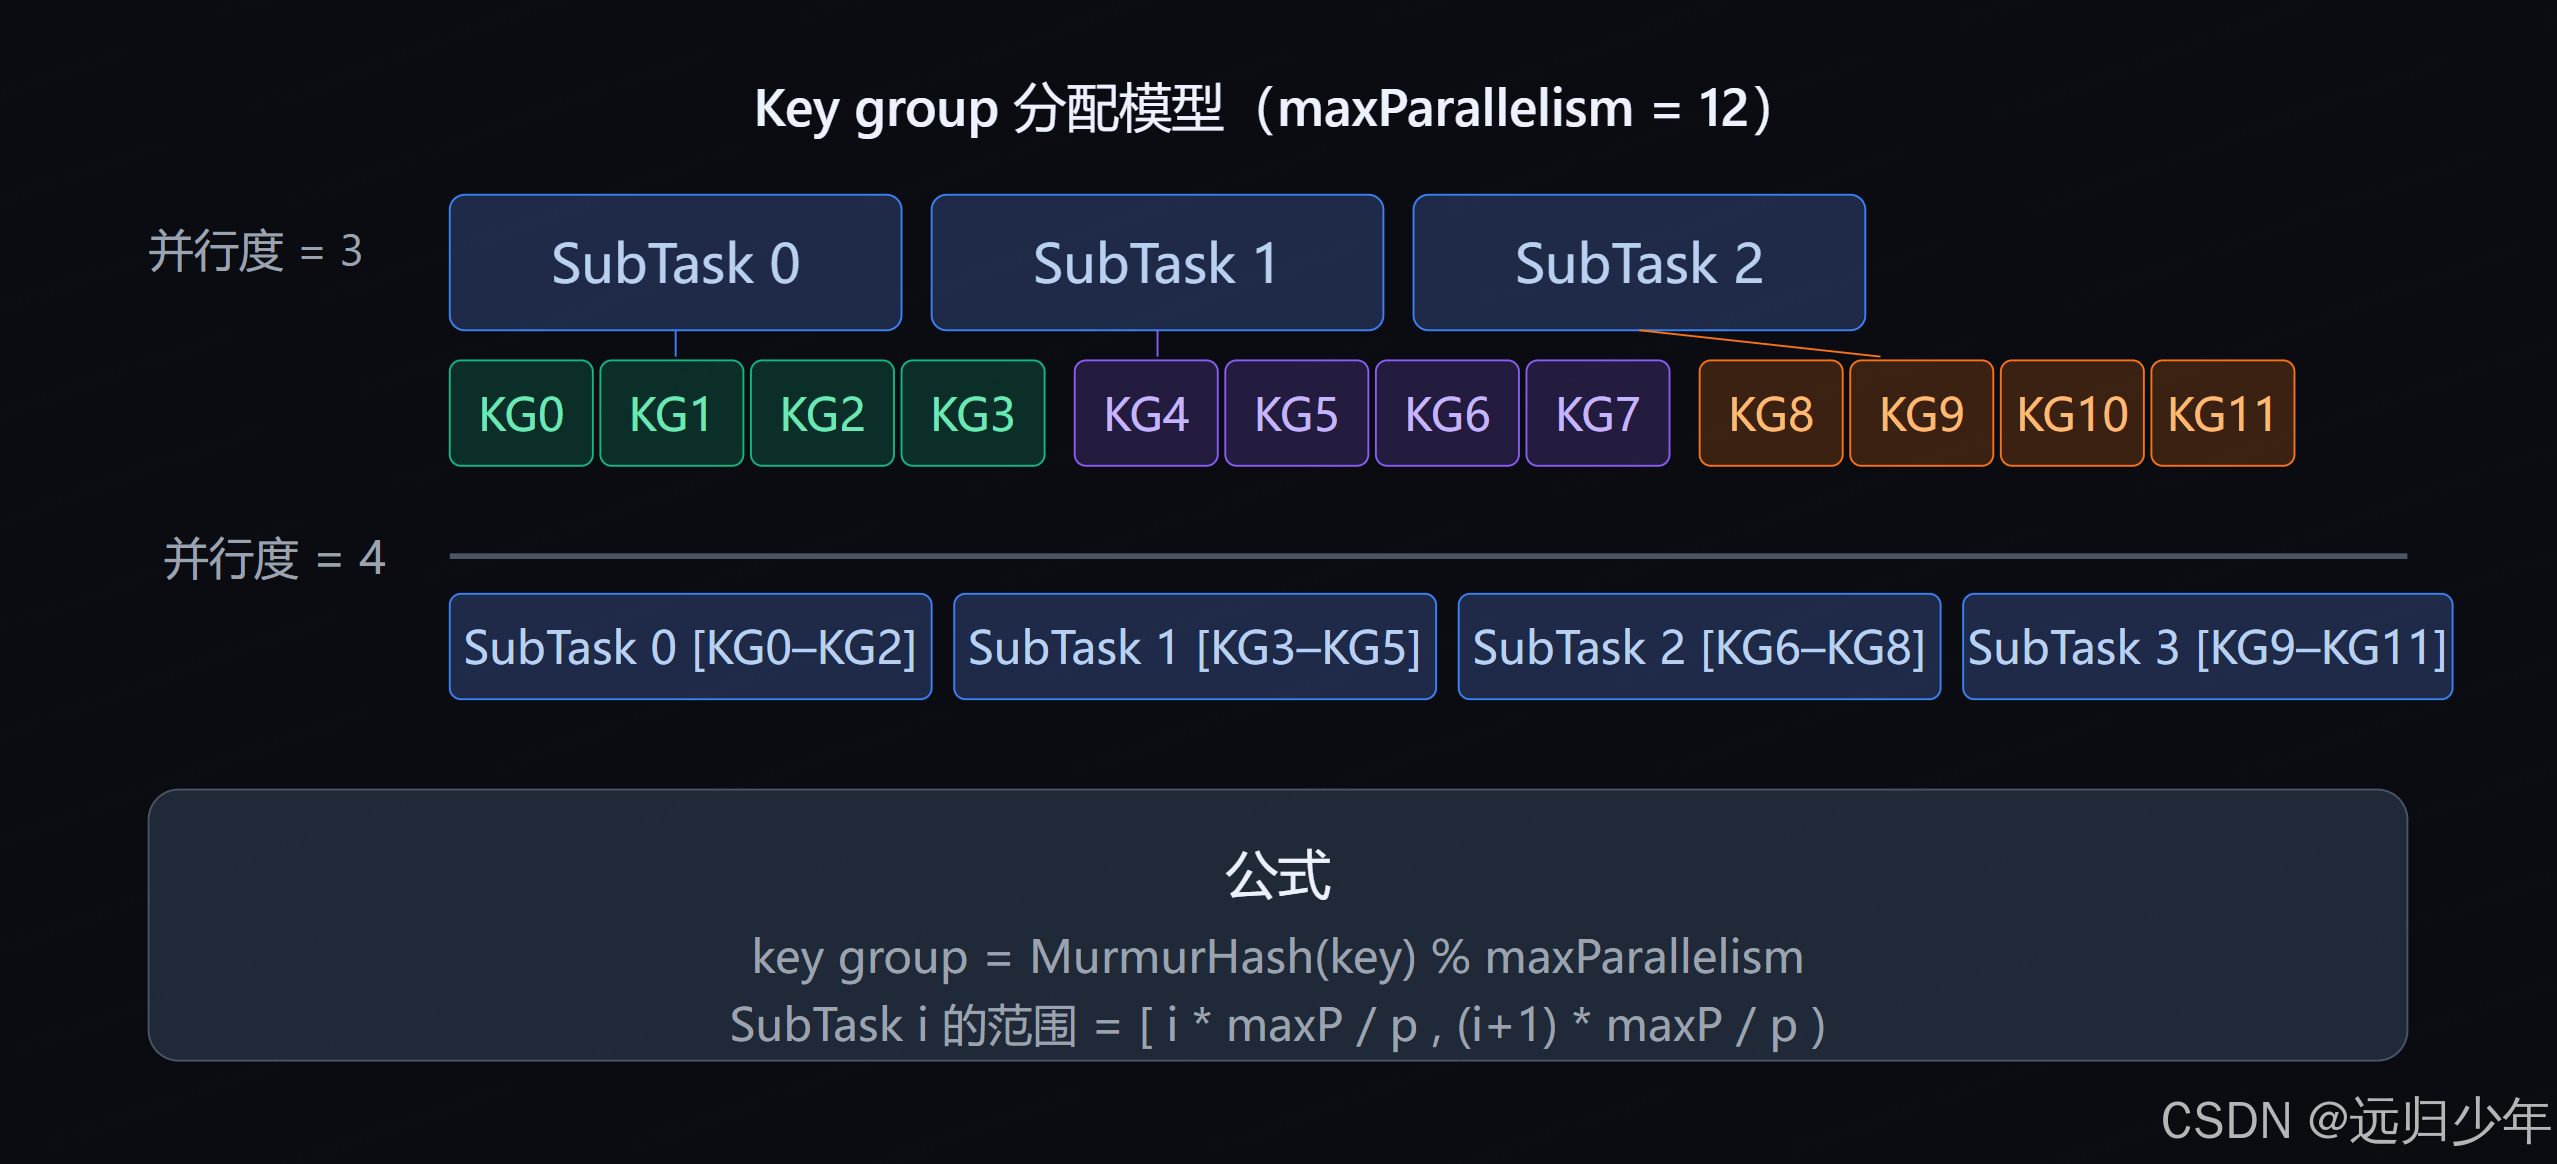
三、扩容流程:并行度从p₁增加到p₂
扩容是最常见的场景。原来每个SubTask管理较大的Key Group区间,扩容后每个SubTask只负责更小的区间。核心优势在于:这个拆分不需要重写任何KV数据。新SubTask直接下载包含目标Key Group范围的SST文件,然后通过 IngestExternalFile 在本地导入。Flink的 KeyGroupRangeOffsets 元数据会告知RocksDB只扫描属于自己的Key Group前缀即可。
一个容易被忽视的细节:新SubTask下载的SST文件中可能包含比它实际需要更多的Key Group(因为原始SST文件是按旧SubTask的整个Key Group范围打包的)。新SubTask会先将整个SST文件ingest进本地RocksDB,读写时只操作自己Key Group范围内的前缀。多余的数据通过后台compaction逐步清理,不影响正确性和可用性。这种设计类似于JavaScript中的懒加载模式——先加载全部,再按需处理。
下图展示了扩容时SST文件的分发路径: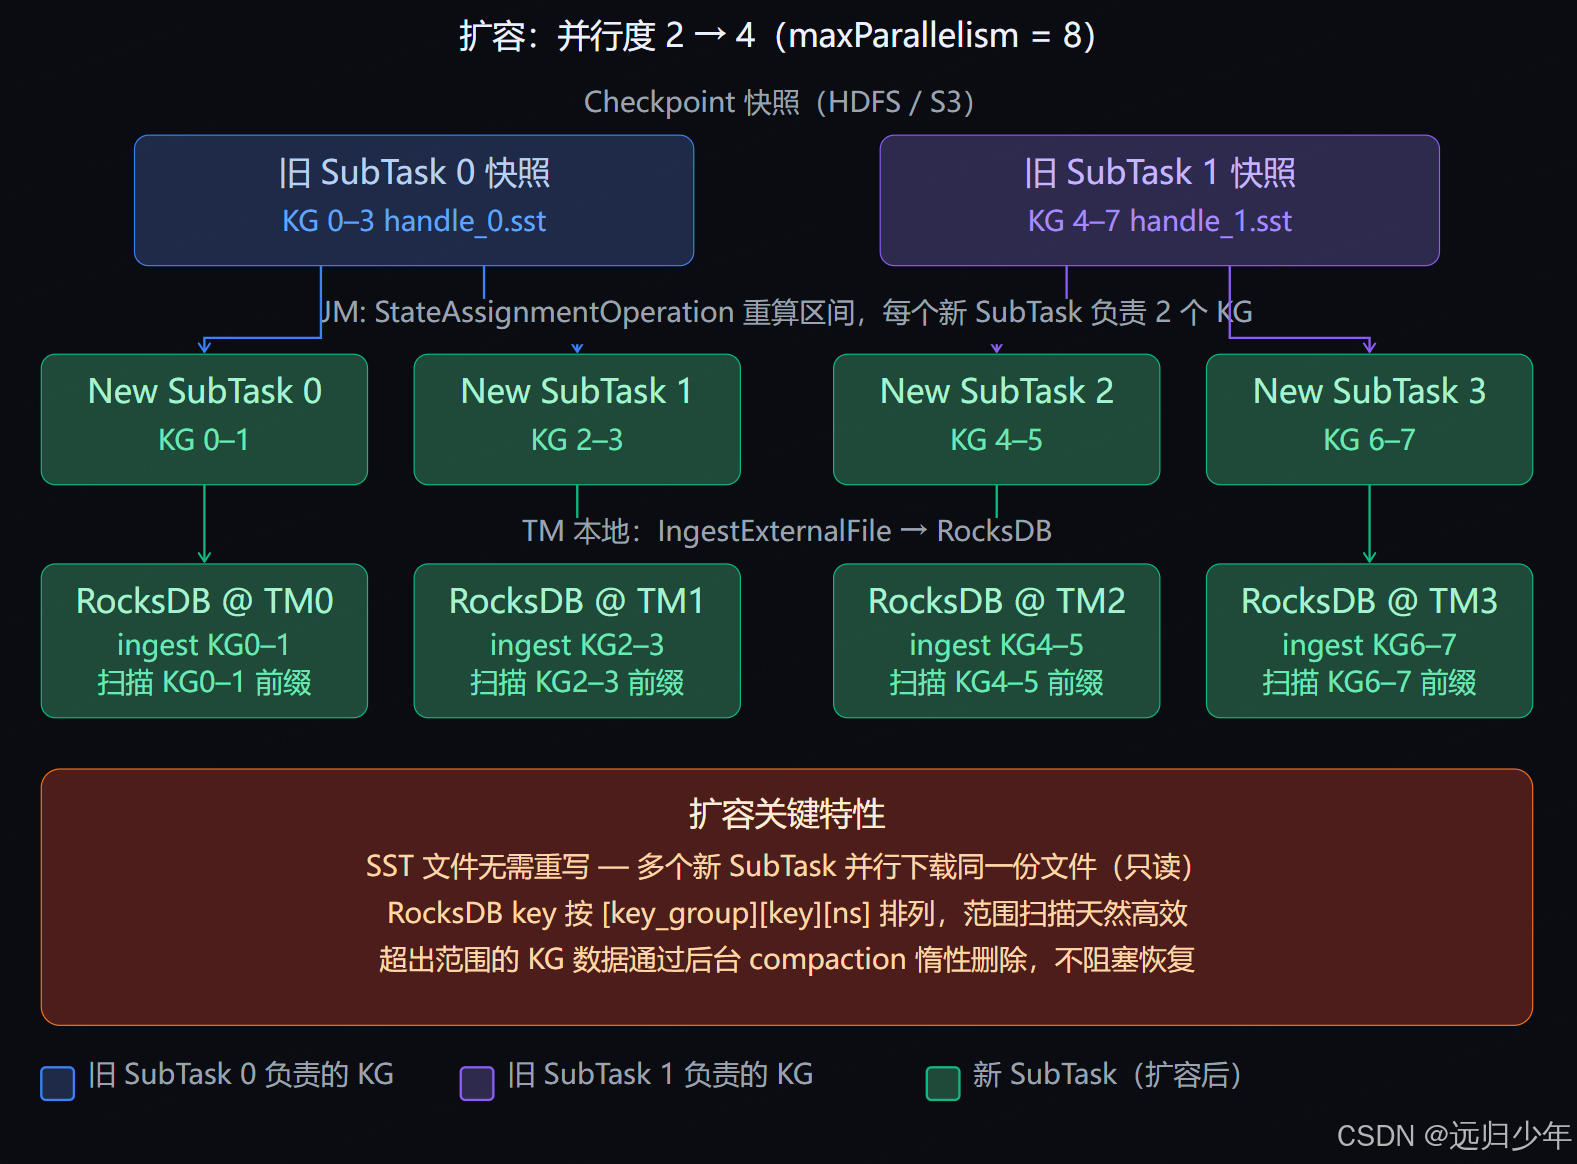
四、缩容流程:并行度从p₁减少到p₂
缩容与扩容是镜像关系:原来多个SubTask各持有一片Key Group,现在要合并给更少的SubTask。每个新SubTask需要从多个旧快照中分别下载对应的SST文件,然后合并导入同一个RocksDB实例。下图展示了这一过程: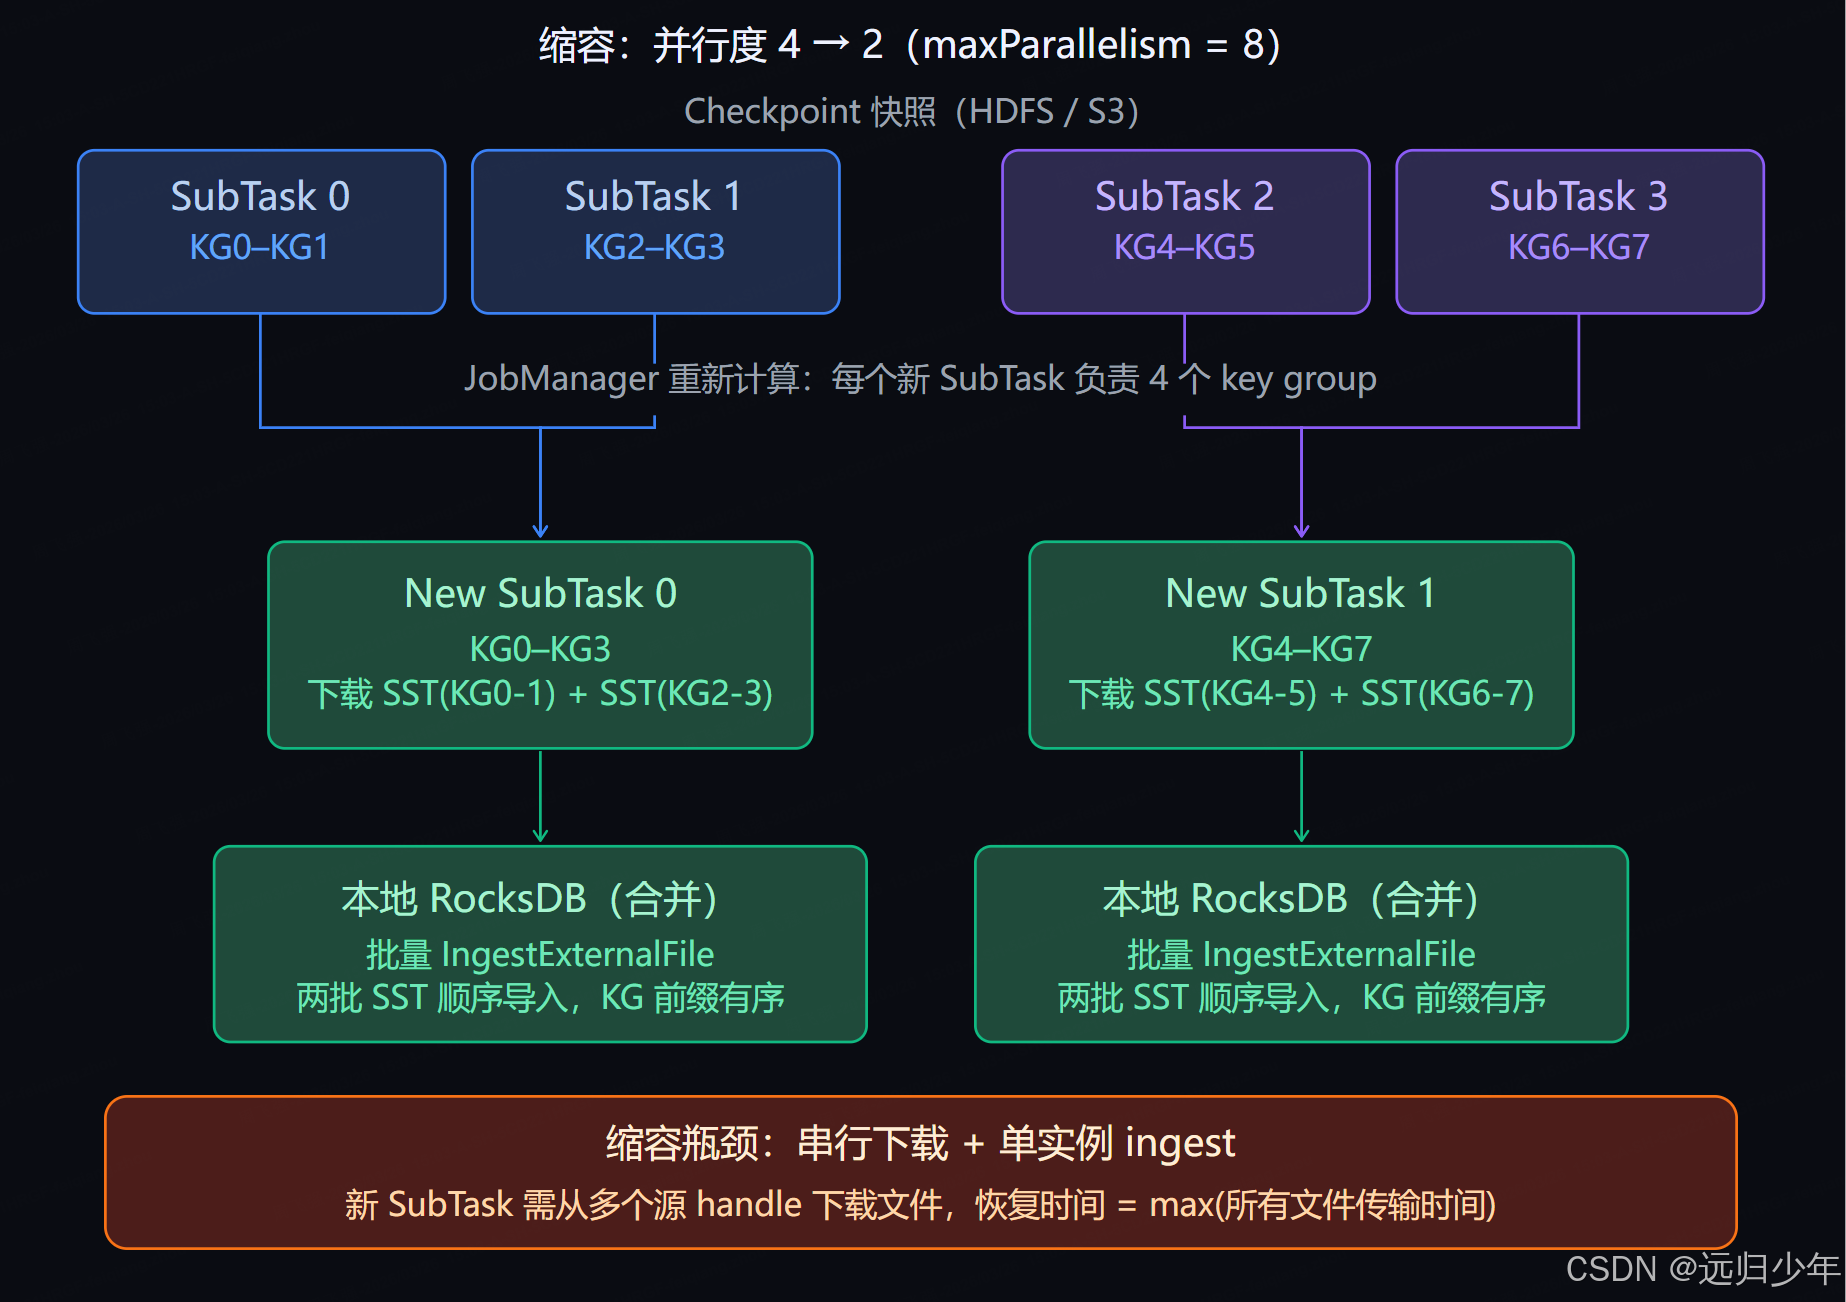
⚠️ 缩容与扩容的一个关键不对称之处:扩容时多个新SubTask可以并行下载同一份SST文件(只读),互不干扰;而缩容时每个新SubTask需要串行地将多份来自不同旧SubTask的SST文件ingest到同一个RocksDB实例。这导致存在单点聚合的串行瓶颈——状态越大、旧并行度越高,恢复时间就越长。在TypeScript中,这种场景类似于Promise.all与串行await的性能差异。
五、完整状态迁移编排流程
从Savepoint/Checkpoint触发到新SubTask完成状态加载,整个过程由 JobManager 的 CheckpointCoordinator 和 StateAssignmentOperation 协同编排。下图展示了完整的编排流程: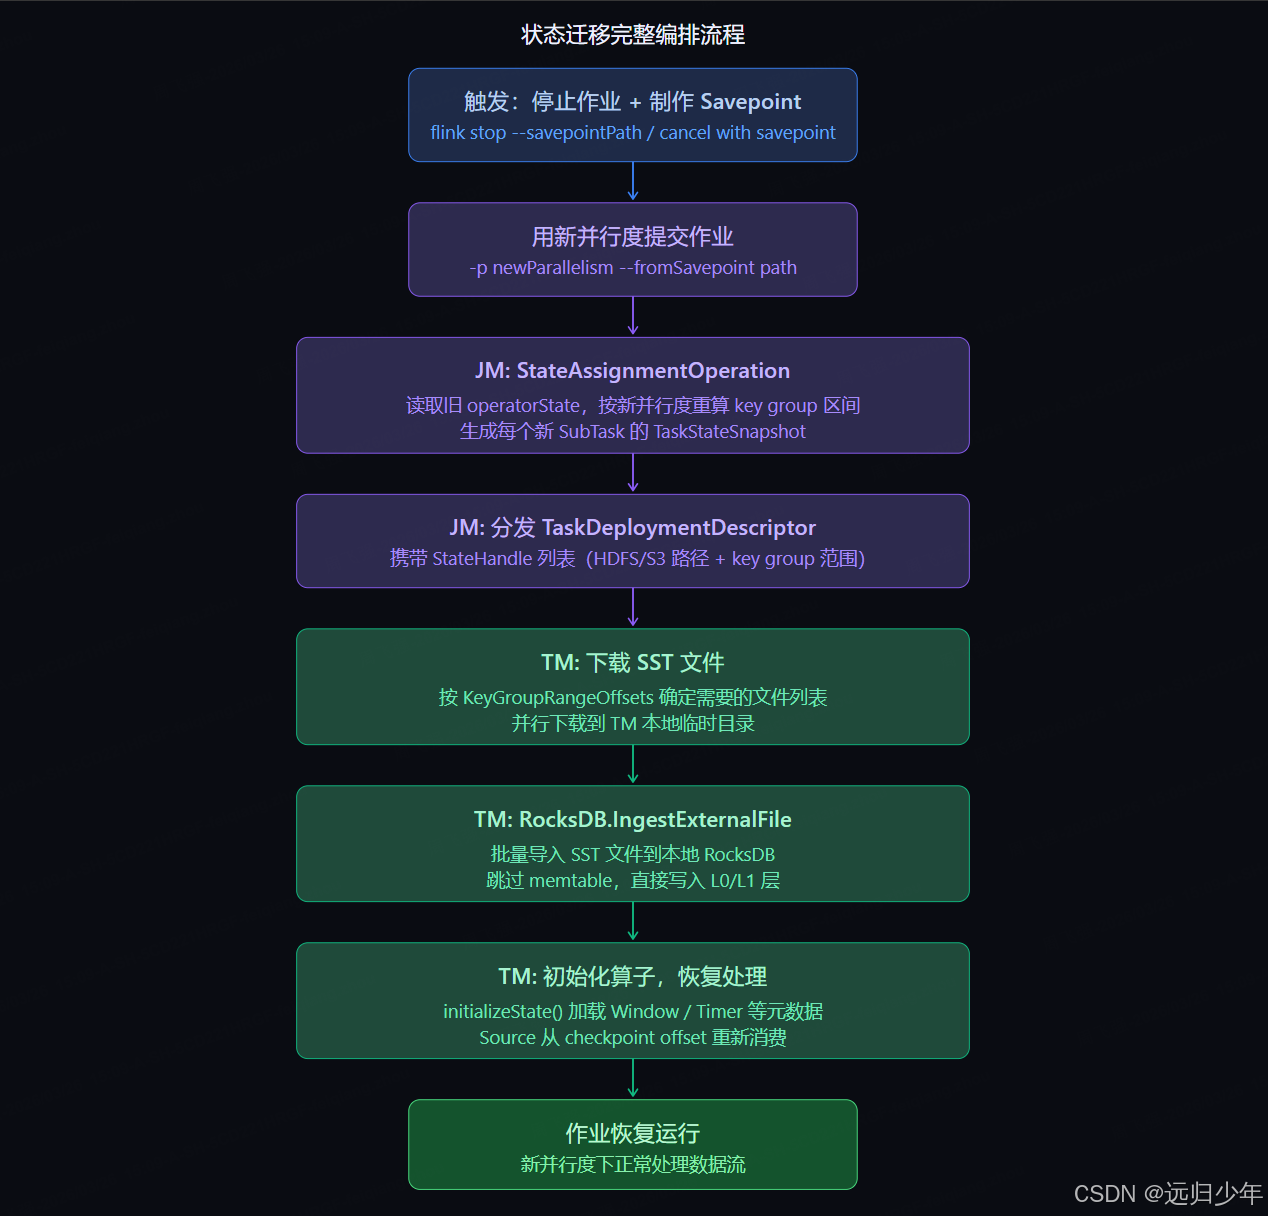
这个流程涉及多个阶段:JobManager读取旧快照元数据,计算新的Key Group分配方案,通知TaskManager下载对应的SST文件,最后通过RocksDB的ingest操作完成状态加载。整个过程类似于C++中的多线程调度——需要精确协调各个组件的时序。
六、增量Checkpoint下的特殊处理
增量Checkpoint使问题更加复杂。在增量模式下,RocksDB只上传新增的SST文件,每次快照的 StateHandle 不是一个完整镜像,而是一棵SST文件的增量树。并行度变更时,JobManager需要沿引用链回溯,找到覆盖目标Key Group范围所需的所有增量SST文件(可能跨越多个历史Checkpoint),然后按从旧到新的顺序依次ingest,让RocksDB的compaction将它们合并成最终一致的状态。
这就是为什么大状态 + 增量Checkpoint + 高频调整并行度会显著拖慢恢复时间——每次都要重建完整的SST文件依赖链。在Python中,这类似于递归遍历一棵深度较大的树,时间复杂度会随深度增加而增长。
七、maxParallelism约束与常见陷阱
这是生产中最容易踩的坑,值得单独说明:maxParallelism 一旦在作业首次启动时确定(通过 maxParallelism 或默认值128),就永久固化在Savepoint元数据里。如果用新的 env.setMaxParallelism(N) 值重启作业,Flink会拒绝从旧Savepoint恢复,因为整个Key Group分片方案已经失效。
代码示例:
env.setMaxParallelism(512);   // 设置为预期最大并行度的 2–3 倍
env.setParallelism(4);        // 实际并行度可以远低于 maxParallelism
// 调整并行度时只改这里,maxParallelism 保持不变
env.setParallelism(8);核心原则:maxParallelism 决定分片粒度上限,实际并行度必须 ≤ maxParallelism。并行度变更完全在这个范围内进行,不触碰maxParallelism。在Go语言中,这类似于使用固定大小的channel缓冲区——一旦设置就不能更改。
八、Operator State的迁移策略
上述所有分析针对的是 maxParallelism(Keyed State)。对于 KeyedState(Operator State,如Kafka Source的offset、OperatorState),没有Key Group概念,并行度变更时有两种策略:
- Even split(偶数拆分):使用
ListState策略,将旧并行度的所有ListState条目收集到一起,按轮询方式均分给新的各SubTask。 - Broadcast(广播):使用
ListState策略,每个新SubTask都获得全量的旧状态列表,自行决定使用哪部分(常用于广播配置)。
这种设计类似于JavaScript中的数组分片与全量复制的区别——前者节省内存但需要重新分配,后者简单粗暴但可能导致数据冗余。
总结
Flink并行度变更时的状态迁移能做到相对高效,根本原因在于三个设计决策的组合:Key Group作为稳定的中间层屏蔽了Key到SubTask的直接绑定;RocksDB的Key Group前缀排列使SST文件天然可按范围切割;以及 UnionListState 绕过memtable直接写入L0层,实现高速批量导入。这三者缺一不可。理解这些机制,可以帮助开发者在生产环境中更好地配置和调优Flink作业,避免常见的性能陷阱。


 浙公网安备 33010602011771号