在大数据与物联网浪潮中,时序数据已成为服务端和微服务架构的核心资产。面对海量设备高并发写入、低成本存储与毫秒级查询的挑战,如何选择一款适配后端架构的时序数据库?本文将从选型核心维度出发,深度解析 Apache IoTDB 的技术优势,并提供实践建议,帮助技术团队做出明智决策。
一、时序数据库选型的六大核心维度
时序数据具备 高写入、高压缩、高查询、多设备、强时序、易扩展 六大特征,选型需从业务场景出发,综合评估以下维度,而非仅关注单一性能指标:
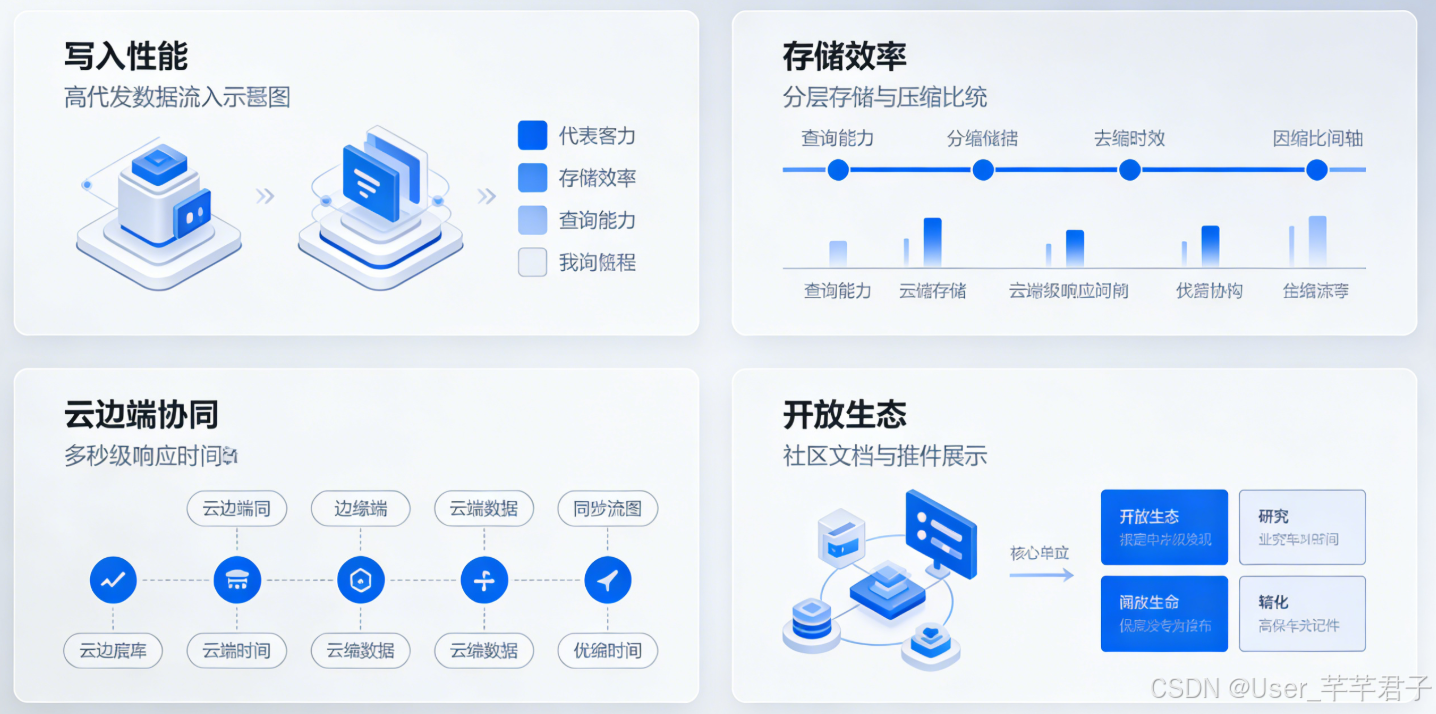
- 写入性能:支撑千万级设备并发接入,支持乱序写入与批量写入,避免数据堆积导致业务中断。
- 存储效率:专用存储格式实现10倍以上无损压缩,支持冷热数据分层,降低TCO。
- 查询能力:毫秒级响应多维度时序分析,原生支持时间窗口聚合、趋势分析等。
- 云边端协同:适配端-边-云分布式部署,边缘端轻量运行,云端可集群扩容。
- 开源生态与本土化:活跃社区、中文文档、国产化适配,实现自主可控。
- 工业友好性:适配Modbus、OPC UA等数百种工业协议,满足7×24小时高可用。
二、国内外时序数据库核心差异对比
当前市场主流产品在架构设计、场景适配与性能上存在显著差异。国外产品多基于通用数据库改造,在写入瓶颈、存储效率与云边协同上存在短板;国内产品则更贴合本土大数据场景。以下表格从多个技术维度进行对比,为后端架构选型提供参考:
| 对比维度 | 国外主流时序数据库 | 国内开源时序数据库(以Apache IoTDB为代表) |
|---|---|---|
| 写入性能 | 单节点十万级点/秒,乱序写入处理效率低 | 单节点千万级点/秒,原生支持乱序写入、批量写入 |
| 存储格式 | 基于通用格式改造,无损压缩比3-5倍 | 自研TsFile专用格式,无损压缩比10倍以上,可有效节省存储成本 |
| 云边协同 | 云端架构为主,边缘端适配能力弱,云边同步带宽消耗大 | 端-边-云一体化架构,边缘端轻量部署,压缩后同步可降低80%带宽消耗 |
| 开源生态 | 部分闭源,开源版本功能受限,社区响应速度较慢 | 100%开源(Apache 2.0协议),国内社区活跃,定制化开发更便捷 |
| 本土化适配 | 不支持中文字符标识符,适配国产软硬件难度较大 | 原生支持中文字符,适配麒麟、统信等国产系统,可实现自主可控 |
| 工业友好性 | 工业协议适配较少,无专属工业运维功能 | 适配数百种工业协议,支持一键备份、故障预警,满足工业7×24小时运行需求 |
| 查询能力 | 通用SQL查询,时序函数较少,TB级数据查询响应为秒级 | 原生时序SQL,丰富的时序聚合函数,TB级数据查询响应可达毫秒级 |
| 从技术特性对比可以看出,国外产品受限于最初的设计场景和地域适配性,在高并发写入、云边协同、本土化适配等方面难以满足国内大数据场景的实际需求,而以Apache IoTDB为代表的国内开源产品,基于国内企业的业务场景特点设计,在核心性能和场景适配性上更具优势,更适合国内企业的技术架构和业务需求。 |
三、Apache IoTDB 技术深度解析
Apache IoTDB 由清华大学发起,是 Apache 软件基金会顶级项目,专为物联网、工业互联网等大数据场景设计。其技术特性与后端架构、微服务场景高度契合,以下从六大维度逐一解析。
3.1 极致写入性能:千万级设备并发接入
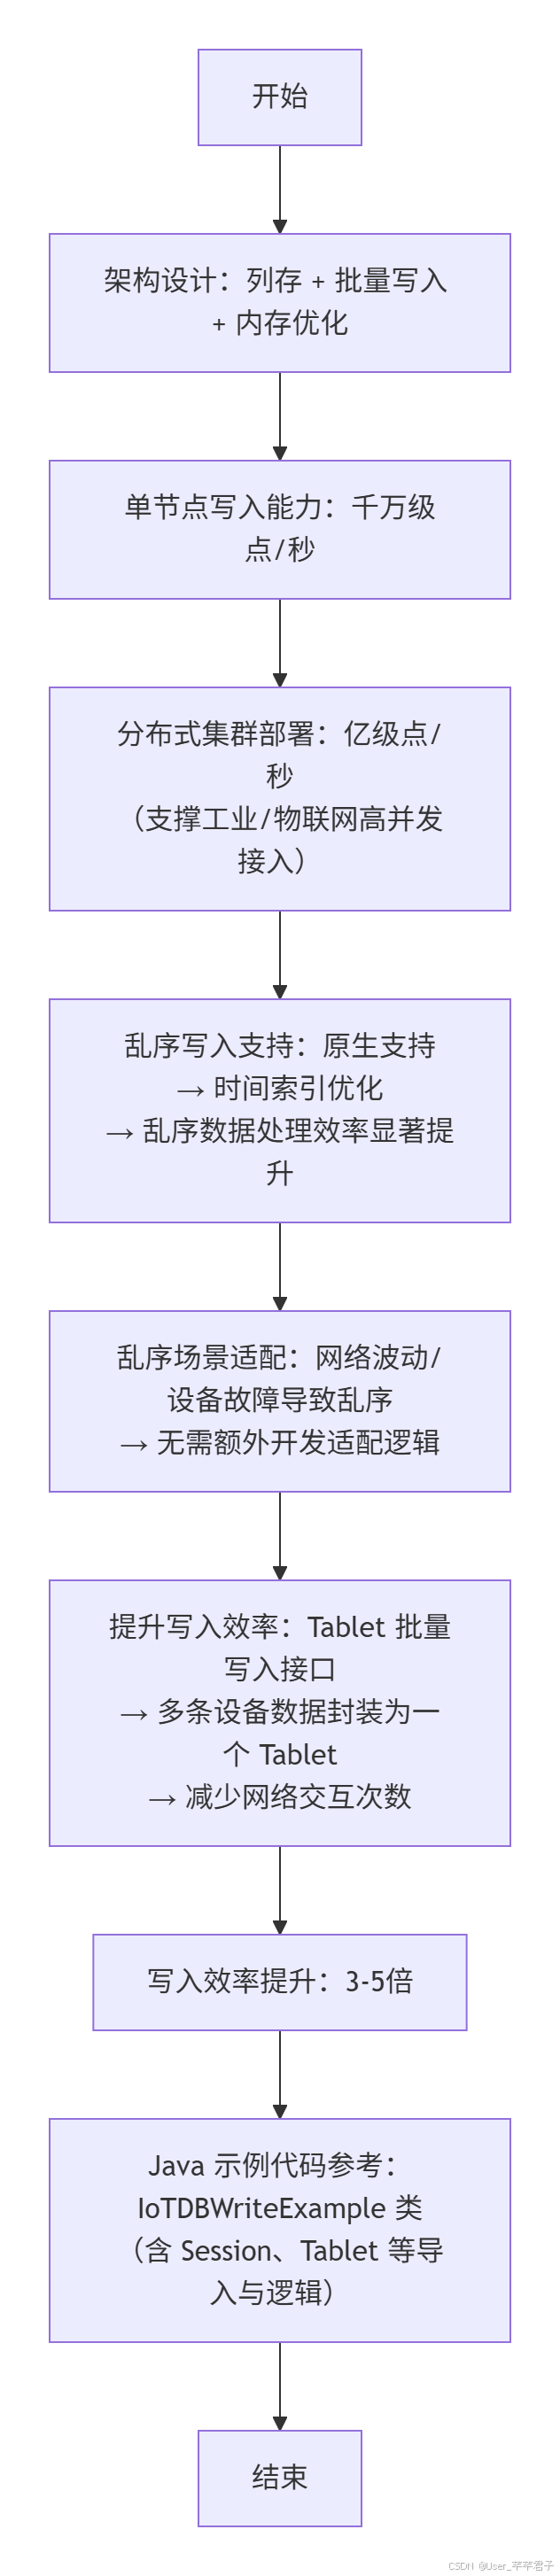
IoTDB 采用 列存架构 + 批量写入 + 内存优化 的组合设计,单节点写入能力可达千万级点/秒,分布式集群更可突破亿级。它原生支持乱序写入,通过时间索引优化,解决网络波动导致的乱序问题,无需额外开发适配层。此外,Tablet 批量写入接口 可将写入效率提升 3-5 倍,极大降低 API 调用频率,是后端服务与微服务集成的理想选择。
package org.apache.iotdb;
import org.apache.iotdb.rpc.IoTDBConnectionException;
import org.apache.iotdb.rpc.StatementExecutionException;
import org.apache.iotdb.session.Session;
import org.apache.iotdb.tsfile.write.record.Tablet;
import org.apache.iotdb.tsfile.write.schema.MeasurementSchema;
import java.util.ArrayList;
import java.util.List;
public class IoTDBWriteExample {
private static Session session;
public static void main(String[] args) throws IoTDBConnectionException, StatementExecutionException {
// 初始化连接
session = new Session.Builder()
.host("127.0.0.1")
.port(6667)
.username("root")
.password("root")
.build();
session.open(false);
// 定义测点schema
List<MeasurementSchema> schemaList = new ArrayList<>();
  schemaList.add(new MeasurementSchema("temperature", TSDataType.FLOAT));
  schemaList.add(new MeasurementSchema("humidity", TSDataType.FLOAT));
  schemaList.add(new MeasurementSchema("pressure", TSDataType.DOUBLE));
  // 创建Tablet,批量写入10条数据
  Tablet tablet = new Tablet("root.industrial.prod1", schemaList, 10);
  long timestamp = System.currentTimeMillis();
  // 批量添加数据
  for (int i = 0; i < 10; i++) {
  tablet.addTimestamp(i, timestamp + i * 1000);
  tablet.addValue("temperature", i, 25.6f + i);
  tablet.addValue("humidity", i, 60.2f - i);
  tablet.addValue("pressure", i, 101.325 + i * 0.01);
  tablet.rowSize++;
  }
  // 执行批量写入
  session.insertTablet(tablet);
  tablet.reset();
  System.out.println("批量写入成功!");
  session.close();
  }
  }
3.2 自研 TsFile 存储格式:存储成本降低 90%
IoTDB 自研的 TsFile 存储格式 专为时序数据设计,采用“时间轴压缩+值压缩+空间索引”多层压缩策略,无损压缩比达 10 倍以上,有损压缩比可达 100 倍。同时,TsFile 支持冷热数据分层存储,热数据存于 SSD 保证查询速度,冷数据下沉至 HDFS 或 S3 降低成本。作为自描述格式,TsFile 可独立运行,边缘端数据直接以该格式同步至云端,减少中间件转换开销,显著提升云边同步效率。
3.3 毫秒级查询响应:原生支持时序分析
IoTDB 提供 原生时序 SQL 接口,扩展了时间窗口聚合、趋势分析、插值补全等丰富函数。通过分区索引、列存过滤与预聚合技术,TB 级数据查询可在毫秒级完成。例如,对 10 亿条工业设备数据的时间窗口聚合,响应时间仅约 200ms。以下为典型查询示例:
-- 查询某设备近1小时的温度数据,按5分钟窗口求平均值
SELECT AVG(temperature) FROM root.industrial.prod1
WHERE time >= NOW() - 3600000
GROUP BY TIME_SLICE(time, 300000);
-- 多设备联合查询,筛选温度大于30℃的记录
SELECT temperature, humidity FROM root.industrial.*
WHERE temperature > 30 AND time >= NOW() - 86400000;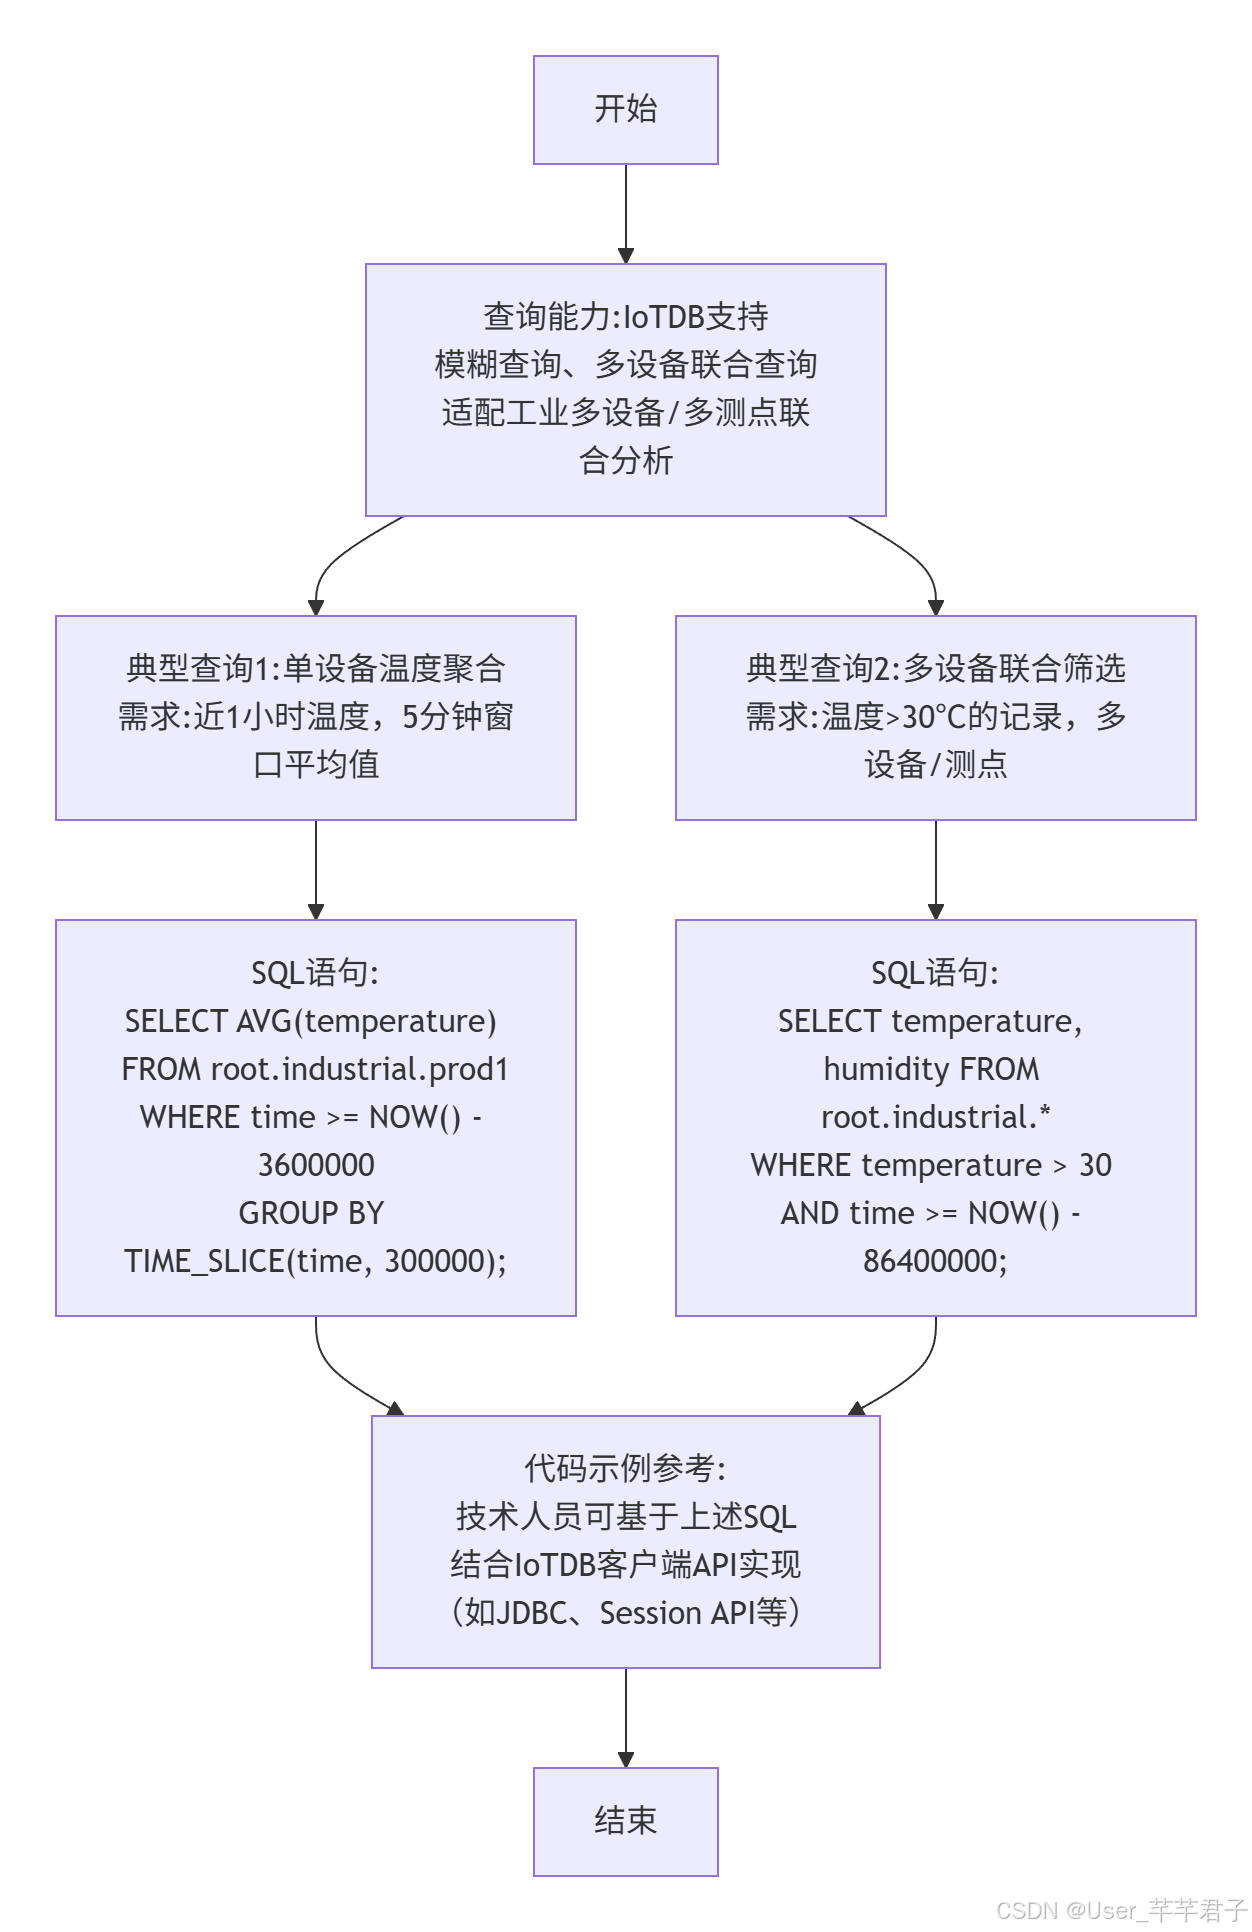
3.4 端-边-云一体化:适配分布式大数据场景
IoTDB 专为分布式场景设计,提供轻量级边缘端与云端集群版本,实现 端-边-云一体化 部署:
- 端侧:超轻量部署(内存占用仅几十 MB),支持断网缓存与联网自动同步,保障数据不丢失。
- 边缘侧:支持本地数据预处理与过滤,仅同步核心数据,降低网络带宽消耗 80% 以上。
- 云端:支持集群秒级扩容,无需数据迁移,实现千万级设备统一管理与全局分析。
这种架构对后端微服务特别友好,边缘端可作为数据预处理的中间件,减轻云端服务压力,提升整体系统稳定性。
3.5 100% 开源生态:自主可控,本土化适配完善
IoTDB 遵循 Apache 2.0 协议,完全开源,企业可自由定制。社区活跃,文档与教程均提供中文版本,降低学习成本。本土化方面,它原生支持 中文字符标识符,已适配麒麟、统信等国产操作系统及鲲鹏、飞腾硬件,无缝融入信创体系。对于后端架构团队,这意味着更低的集成门槛和更高的技术自主性。
3.6 工业友好性:深度适配工业大数据场景
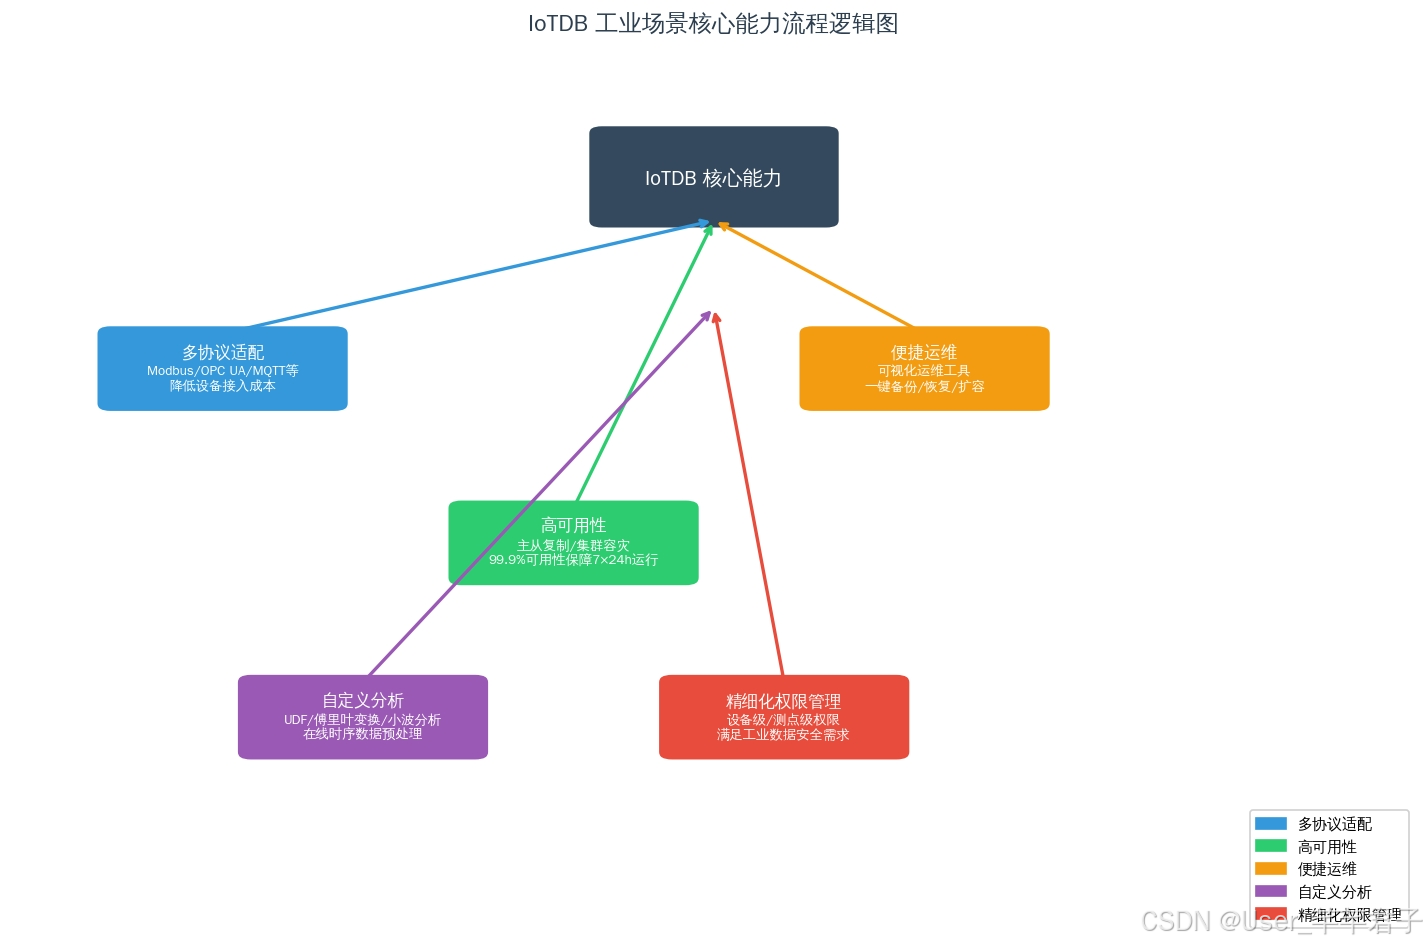
IoTDB 内置数百种工业采集协议(Modbus、OPC UA、MQTT 等),无需额外开发采集插件。同时提供 设备级权限管理、一键备份恢复、用户自定义函数(UDF)等特性,满足工业生产 7×24 小时高可用需求。这些特性使其成为工业互联网、电力、智能制造等领域的首选时序数据库中间件。
[AFFILIATE_SLOT_1]四、生态建设与上手指南
Apache IoTDB 已与 Spark、Flink、HDFS、Hive 等主流大数据组件深度集成,支持 Java、Python、C++、Go 等多语言客户端,并提供 Grafana、Superset 等可视化插件。部署方式灵活,支持一键安装与 Docker/K8s 容器化部署,方便后端团队快速集成。
获取资源建议:
- 官方下载:https://iotdb.apache.org/zh/Download/
- 企业级支持:https://timecho.com
- 官方文档:覆盖从部署到开发的全流程,助力快速上手。
版本升级策略完善,同大版本内可无缝升级,跨大版本提供专用迁移工具,如从 v0.13.x 到 v1.0.x 可通过 LOAD 功能平滑迁移,确保业务连续性。
[AFFILIATE_SLOT_2]五、总结
在大数据时代,时序数据库选型需综合考量场景适配、成本控制、生态兼容与技术自主性。Apache IoTDB 凭借 极致写入性能、10 倍以上存储压缩、毫秒级查询、云边端协同 等优势,以及开源可控与本土化适配特性,成为后端架构与微服务场景下的理想时序数据中间件。它不仅降低了企业 IT 成本,更为海量时序数据的全生命周期管理提供了高效、可靠的解决方案。


 浙公网安备 33010602011771号