Redis作为高性能的键值存储系统,其丰富的数据结构是支撑其强大功能的核心。其中,Set(集合)和Zset(有序集合)是两种功能强大且应用广泛的数据类型。理解它们的特性、命令及内部实现,对于使用Java、Python或JavaScript等语言进行高效缓存设计、排行榜实现和去重统计等场景至关重要。本文将带你深入探索这两种数据结构的奥秘,并通过实际案例展示其强大威力。
一、Set集合:无序且唯一的元素容器
Redis的Set类型用于存储多个字符串元素,其核心特性是元素无序且不允许重复。一个集合最多可容纳2^32-1个元素。除了基础的增删改查,Redis Set还原生支持求交集、并集和差集等集合运算,这为解决许多实际问题(如共同好友、兴趣标签推荐)提供了优雅的方案。
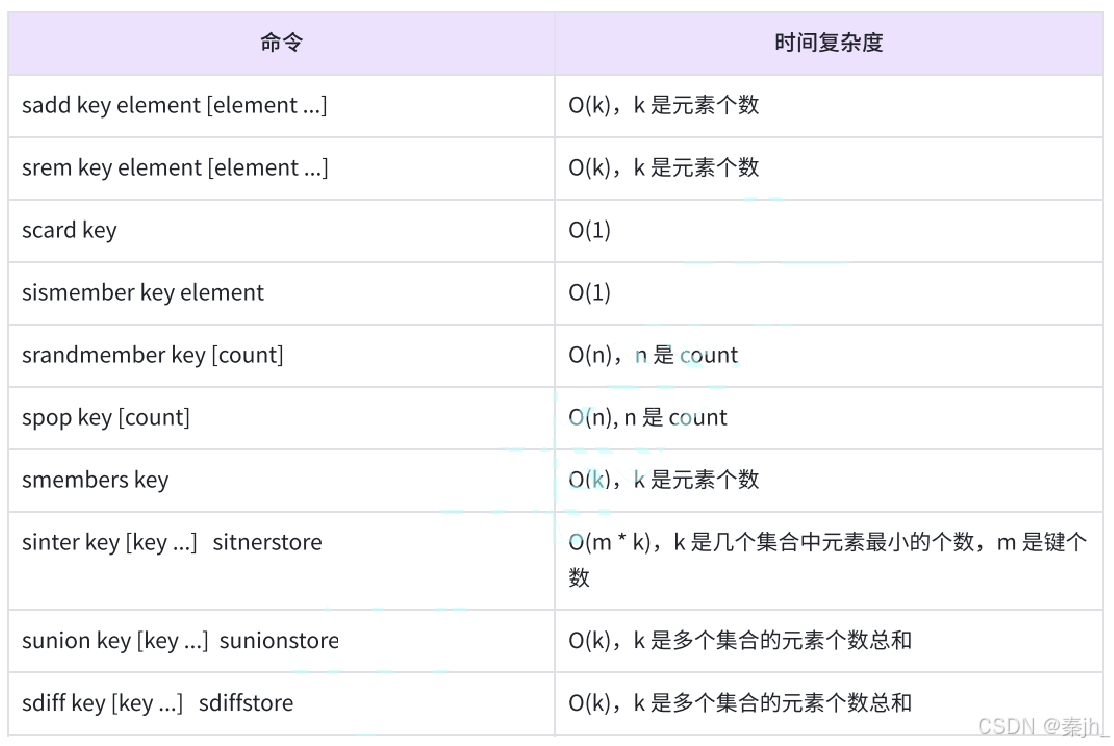
Set的核心操作命令包括:
- SADD key member [member ...]:添加一个或多个元素。
- SMEMBERS key:获取集合中所有元素。
- SISMEMBER key member:判断元素是否在集合中。
- SCARD key:获取集合元素个数。
- SREM key member [member ...]:移除指定元素。
例如,在Python或Java的社交应用中,可以使用SADD为每个用户添加兴趣标签,后续通过集合运算快速找到有共同兴趣的用户群体。
集合间操作是Set的亮点:
- SINTER/SINTERSTORE:求交集并(可选)存储结果。
- SUNION/SUNIONSTORE:求并集并(可选)存储结果。
- SDIFF/SDIFFSTORE:求差集并(可选)存储结果。
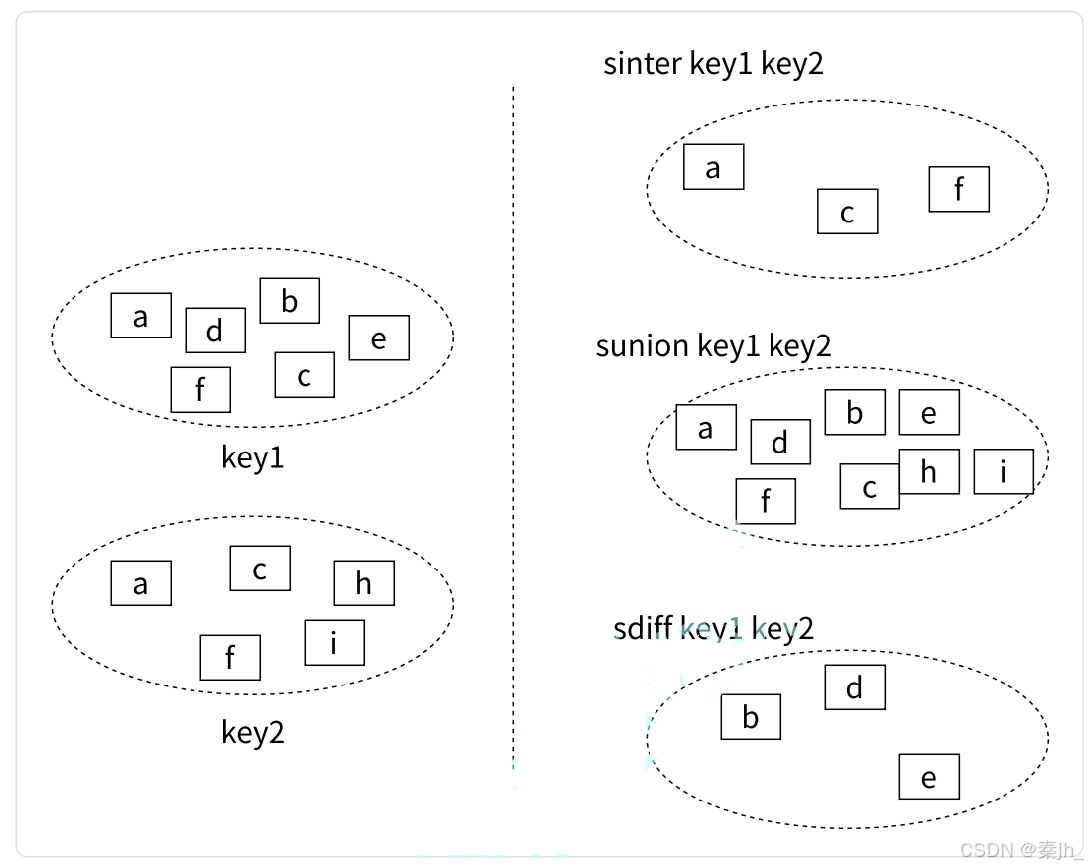
下面通过一个命令示例展示交集操作:
SINTER key [key ...]
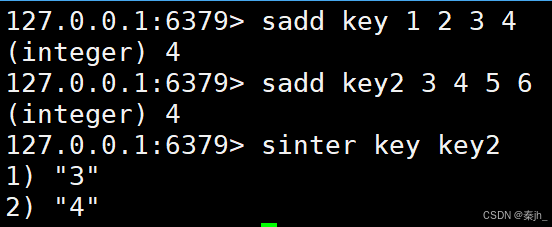
二、Set的内部编码与实战应用
Redis为了优化内存和性能,为Set提供了两种内部编码:
- intset(整数集合):当集合所有元素都是整数且数量较少(默认小于512个)时启用,能极大节省内存。
- hashtable(哈希表):不满足intset条件时的后备实现。
Set的典型使用场景包括:
- 标签系统:用户画像、内容分类。例如,电商网站用Set存储商品的标签(如“数码”、“促销”),通过SINTER快速找出同时满足多个标签的商品。
- 共同好友/关注:社交网络中,将用户的好友ID存入Set,使用SINTER即可计算出两个用户的共同好友。
- 随机抽奖:利用SPOP或SRANDMEMBER命令,可以公平、高效地实现抽奖逻辑,避免在应用层(如使用JavaScript数组)处理带来的性能瓶颈。
- 数据去重:在数据爬虫(Python)或日志处理中,利用Set的天然去重特性,快速过滤重复URL或IP。
三、Zset有序集合:带权重的排行榜利器
Zset在Set的基础上,为每个元素关联了一个分数(score),一个double类型的浮点数。元素依然唯一,但集合会根据分数进行升序排序。这使得Zset成为实现排行榜、延迟队列等功能的理想选择。
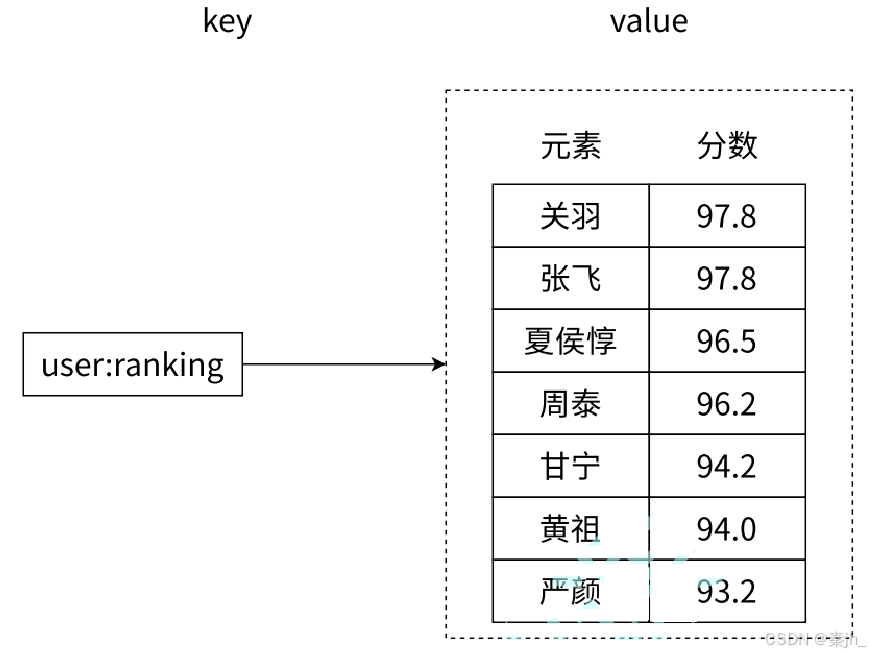
与列表(List)和集合(Set)相比,Zset兼具了唯一性和有序性。其核心操作围绕分数和排名展开:
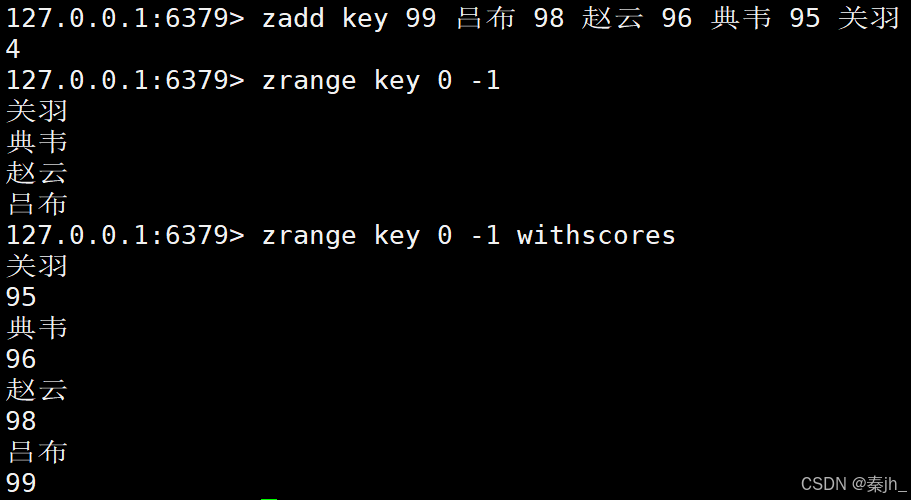
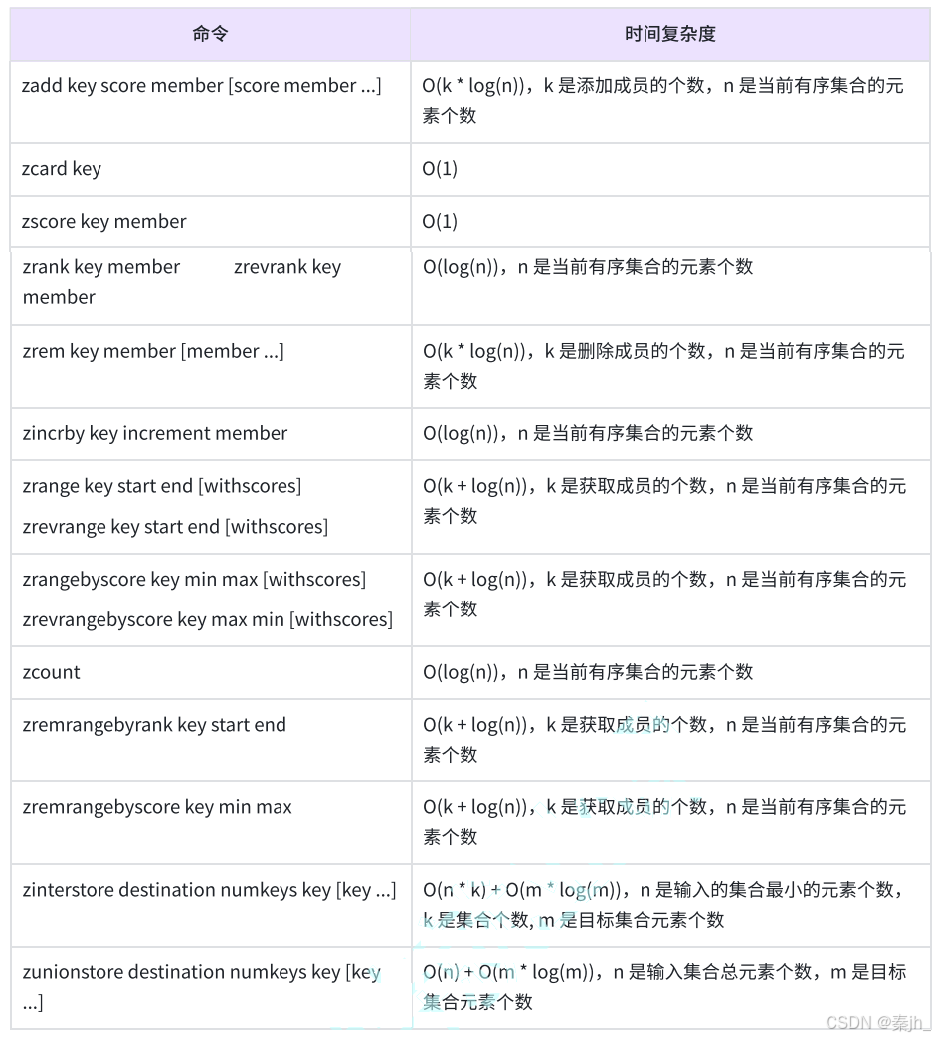
- ZADD key [NX|XX] [CH] [INCR] score member [score member ...]:添加或更新元素。选项XX/NX用于控制更新/新增行为,INCR用于原子性地增加分数。
- ZRANGE/ZREVRANGE key start stop [WITHSCORES]:按分数升序/降序返回指定排名区间的元素。
- ZRANGEBYSCORE key min max [WITHSCORES]:返回指定分数区间的元素。
- ZRANK/ZREVRANK key member:获取元素的升序/降序排名。
- ZSCORE key member:获取元素的分数。
- ZINCRBY key increment member:为元素的分数增加指定值。
例如,在游戏服务器(C++/Java)中,可以使用ZINCRBY实时更新玩家积分,并用ZREVRANGE快速获取Top 10玩家列表。
ZADD key [NX | XX] [GT | LT] [CH] [INCR] score member [score member ...]
四、Zset的集合运算与内部编码
与Set类似,Zset也支持交集和并集运算,但更为复杂,因为需要处理分数的聚合。
- ZINTERSTORE/ZUNIONSTORE destination numkeys key [key ...] [WEIGHTS weight] [AGGREGATE SUM|MIN|MAX]
这两个命令允许指定权重和聚合方式(SUM求和、MIN取最小值、MAX取最大值)。例如,在新闻推荐系统中,可以综合文章的“热度分”和“新鲜度分”,通过加权并集计算出一个综合排序。
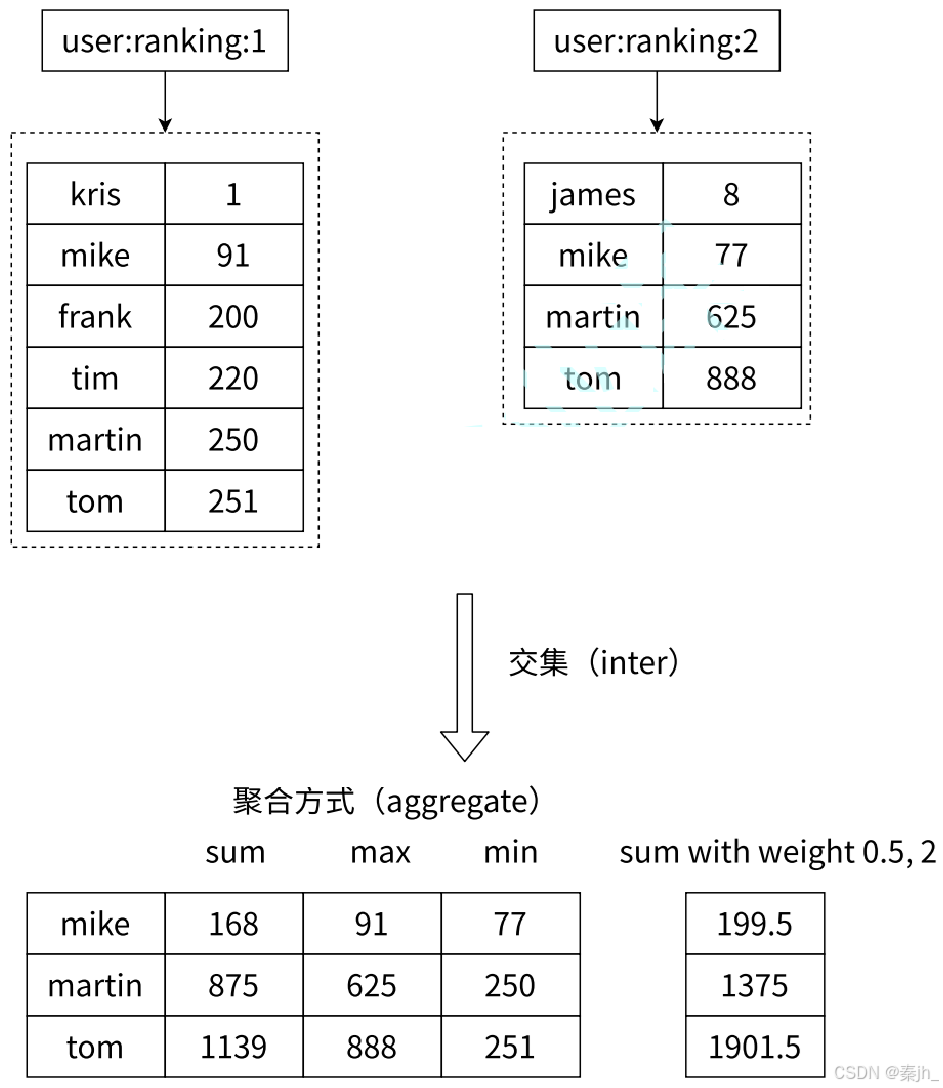
ZINTERSTORE destination numkeys key [key ...] [WEIGHTS weight [weight ...]] [AGGREGATE <SUM | MIN | MAX>]
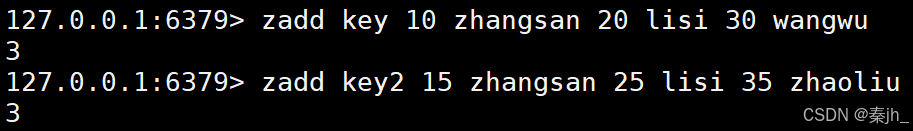
Zset的内部编码也有两种:
- ziplist(压缩列表):元素少(默认小于128个)且值小(默认小于64字节)时使用,内存紧凑。
- skiplist(跳表):不满足ziplist条件时使用,保证了范围查询、插入和删除的高效性,平均时间复杂度为O(log N)。
五、渐进式遍历与数据库管理
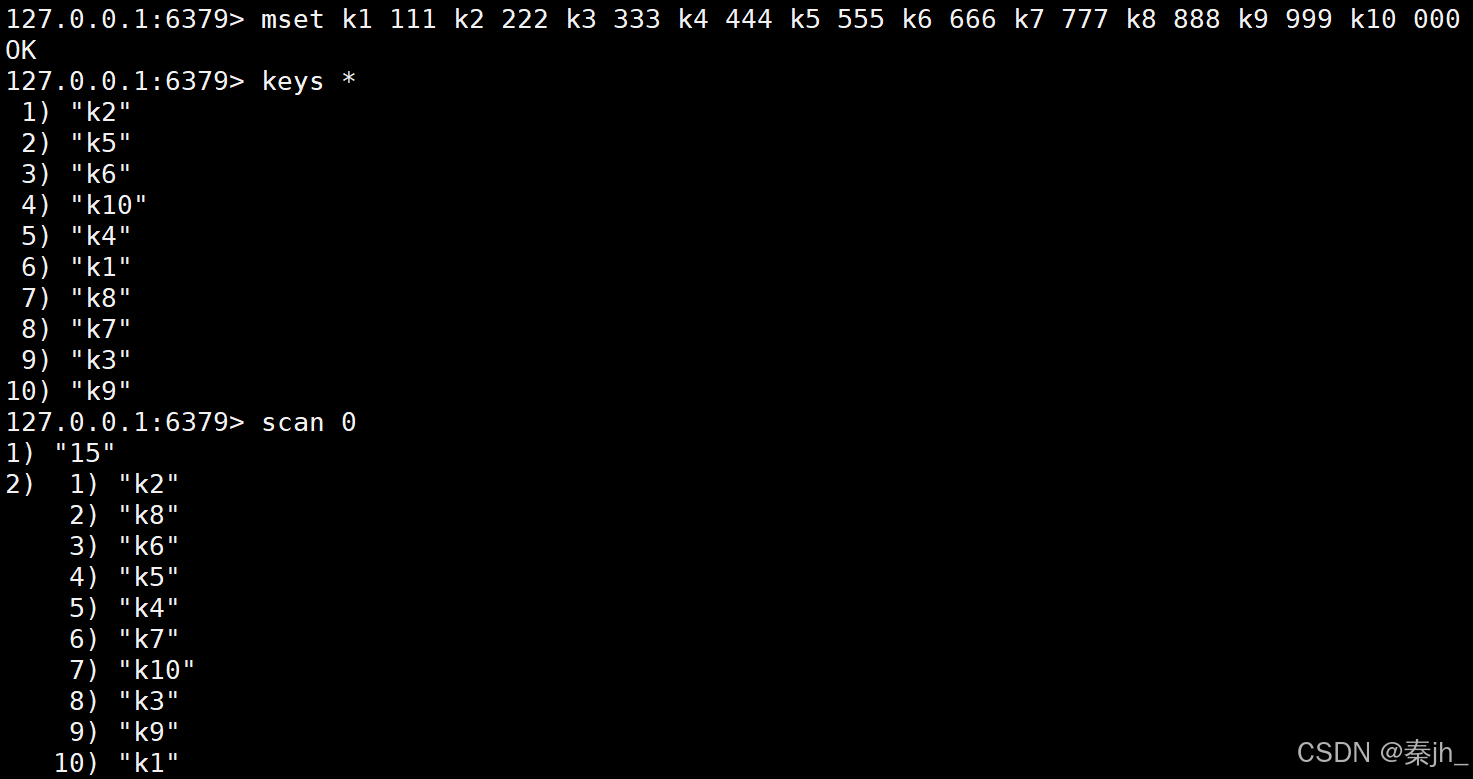
当需要遍历大量键时,使用KEYS *命令可能会阻塞Redis服务。Redis提供了SCAN系列命令进行渐进式、非阻塞的遍历。
- SCAN cursor [MATCH pattern] [COUNT count]:遍历所有键。
- SSCAN/HSCAN/ZSCAN:分别用于遍历Set、Hash和Zset的元素。
每次SCAN返回一个游标和部分结果,直到游标返回0表示遍历结束。这在清理缓存或数据迁移时非常有用。
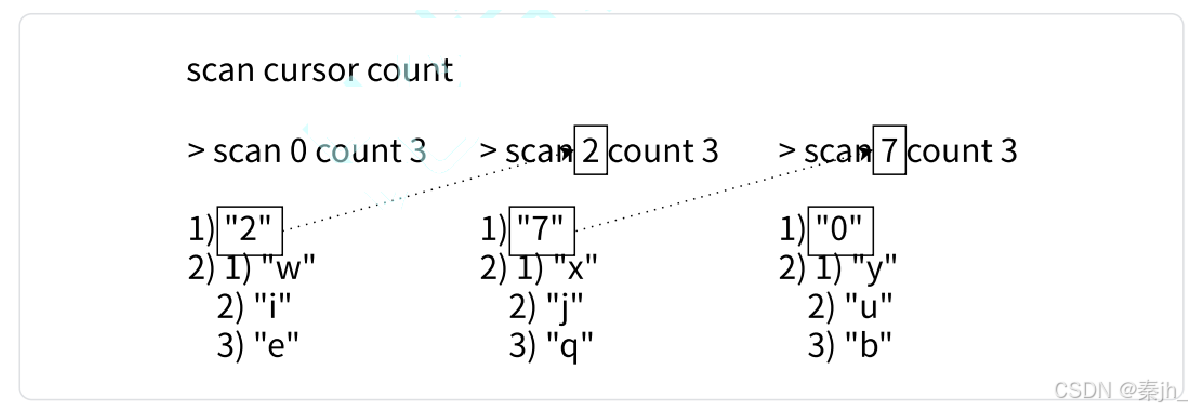
SCAN cursor [MATCH pattern] [COUNT count] [TYPE type]
COUNt:后面接数字,表示建议返回几个值,不一定就是指定的个数,但也不会差太多。
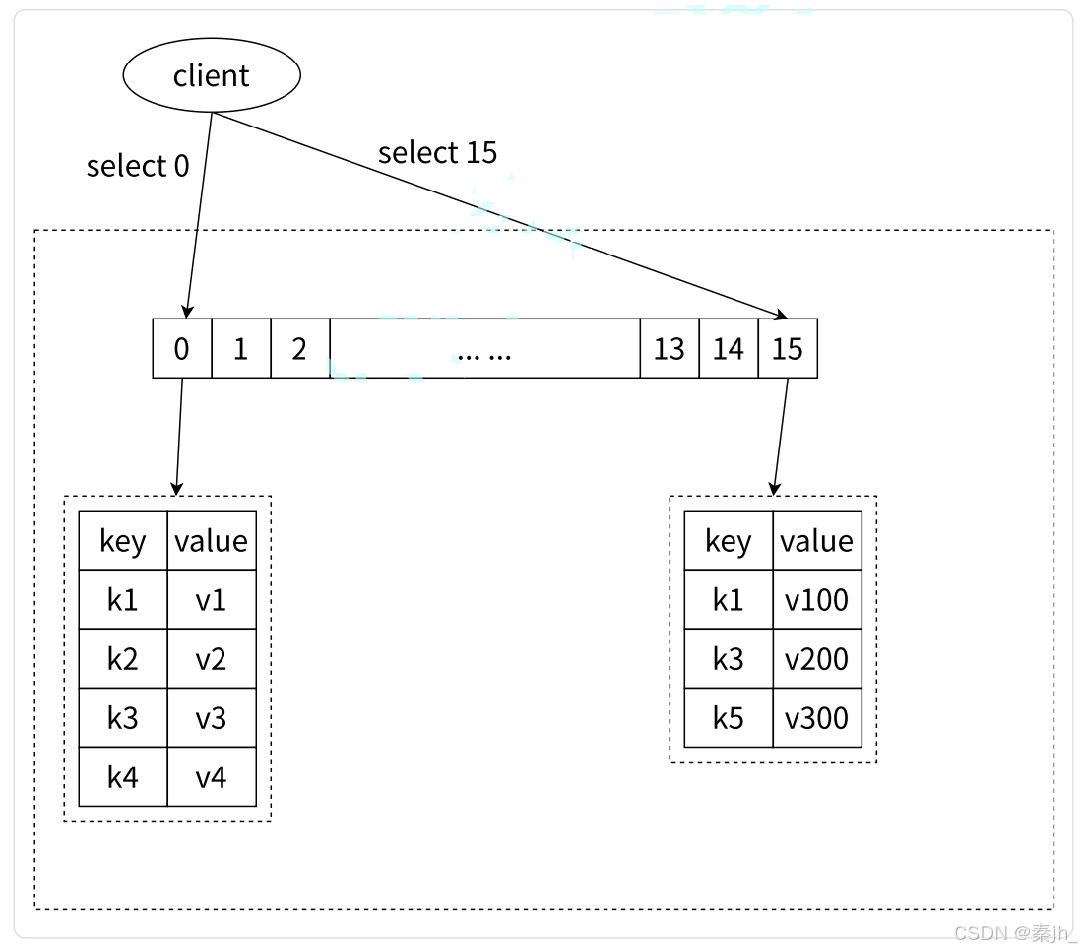
Redis支持多个逻辑数据库(默认16个),使用SELECT index切换。但生产环境中,多数据库的使用并不常见,更推荐使用不同的Key前缀进行隔离。FLUSHDB和FLUSHALL命令分别用于清空当前数据库和所有数据库,使用时需极其谨慎。
 [AFFILIATE_SLOT_2]
六、总结与最佳实践
Set和Zset是Redis中极具特色的数据结构。Set以其高效的唯一性判断和集合运算,在标签、去重和社交关系场景中不可替代。Zset则凭借其有序性和灵活的分数机制,成为排行榜、延迟任务和优先级队列的标配。
在实际开发中(无论是使用TypeScript构建Node.js服务,还是用Java开发微服务),选择合适的数据结构是关键:
- 需要快速判断存在性或进行集合运算 → 选择 Set。
- 需要按权重排序或进行范围查询 → 选择 Zset。
- 合理利用内部编码的转换阈值,针对数据特点进行优化。
- 对于大规模数据遍历,务必使用SCAN替代KEYS。
掌握Set和Zset,你就能利用Redis解决更多复杂的业务问题,构建出更高性能、更易维护的应用系统。


 浙公网安备 33010602011771号