在人工智能的广阔领域中,机器学习作为实现AI的核心手段,其算法体系犹如一座精密的宫殿。其中,决策树算法不仅是入门者理解有监督学习的经典范例,更是通往更高级模型——如随机森林、GBDT、XGBoost等强大集成学习算法——不可或缺的基石。本文将深入浅出地解析决策树的核心概念、构建逻辑、经典算法以及关键的优化技巧,并通过一个实战项目,帮助你从理论到实践,全面掌握这一在机器学习和深度学习中广泛应用的基础模型。
一、决策树:直观的“决策流程图”
决策树是一种经典的有监督学习算法,它能够同时胜任分类与回归任务。其核心逻辑在于模仿人类的决策过程:通过一系列精心设计的“是/否”问题,对数据进行层层筛选,最终得出一个明确的结论。这个过程就像一份自动生成的决策流程图。
什么是有监督学习?简单来说,就是模型在学习时,既有“题目”(特征X),也有“标准答案”(标签Y)。模型通过比较自己的“解题结果”(预测值)与“标准答案”(真实值)之间的差距(误差),不断调整内部参数,以期在未来面对新“题目”时能给出更准确的答案。这就像一位学生对照参考答案来修正自己的解题思路,从而真正掌握知识。
决策树的结构由三类节点清晰构成:
- 根节点:决策的起点,代表整个数据集中最具区分能力的特征。
- 非叶子节点(中间节点):代表后续的判断条件,每个节点都是一次基于某个特征的分支选择。
- 叶子节点:决策的终点,不再进行分裂,直接给出样本的最终预测类别或数值。
例如,在一个贷款审批模型中,决策树可能首先根据“是否有房产”进行判断,这是一个典型的根节点决策。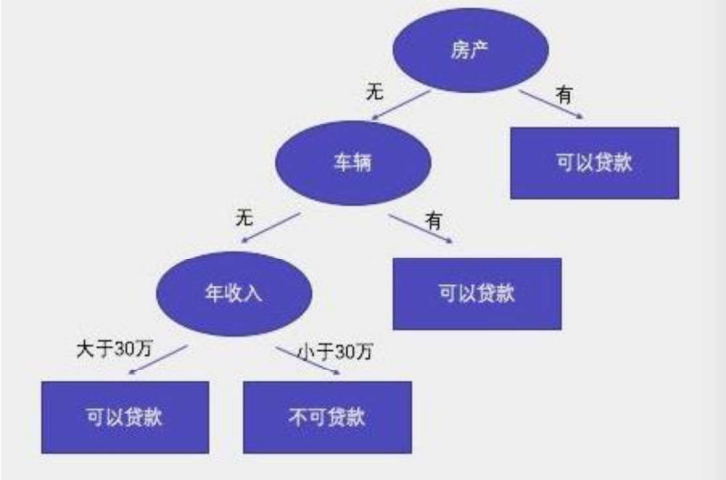 这张图直观展示了决策树如何像流程图一样工作。
二、决策树构建的核心:如何选择最佳分裂点?
构建一棵有效的决策树,关键在于解决一个核心问题:在每个节点上,应该依据哪个特征、以何种阈值进行分裂,才能最有效地“净化”数据? 这里的“净化”是指让同一个分支下的数据尽可能属于同一类别(分类任务)或具有相似的数值(回归任务)。
为了量化这种“净化”能力,机器学习领域发展出了不同的衡量标准,并由此诞生了三大经典决策树算法:ID3、C4.5和CART。它们的主要区别就在于所使用的“纯度”衡量指标不同。
三、三大经典算法:从信息论到实践优选
1. ID3算法:信息增益的开拓者
ID3算法使用信息增益作为分裂标准,其思想源于信息论中的“熵”。熵度量了系统的不确定性或混乱程度。信息增益则表示使用某个特征进行划分后,系统不确定性减少的量。ID3总是选择信息增益最大的特征进行分裂,因为它能最大程度地降低不确定性。熵的计算公式为: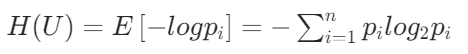 其中,
为样本集合,
为类别数,
为第
类样本在集合
中的占比。
2. C4.5算法:对ID3的优化
ID3算法有一个明显缺陷:它倾向于选择取值种类多的特征(如“用户ID”),这类特征信息增益高但无实际泛化意义。C4.5算法引入了信息增益率来解决这个问题。信息增益率是信息增益与特征本身固有值的比值,它惩罚了取值多的特征,使得选择更加公平合理。
3. CART算法:当前的主流与基石
CART(分类与回归树)是目前应用最广泛的决策树算法,也是许多集成学习模型(如随机森林、XGBoost)的默认基学习器。它使用基尼系数作为分类任务的纯度衡量标准。基尼系数反映了从数据集中随机抽取两个样本,其类别不一致的概率。基尼系数越小,数据纯度越高。其计算公式为: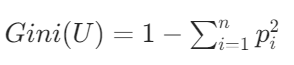 其中,
为样本集合,
为类别数,
为第
类样本在集合
中的占比。
此外,CART树强制生成二叉树(每次分裂只产生两个分支),结构更简单,计算效率更高,并且天然支持回归任务(使用方差最小化作为分裂标准)。[AFFILIATE_SLOT_1]
四、避免过拟合:决策树的剪枝艺术
决策树有一个天生的倾向:如果任其自由生长,它会不断分裂,直到每一个叶子节点都完美“记住”了训练样本,甚至包括噪声和异常值。这会导致严重的过拟合——在训练集上表现完美,在未知数据上表现糟糕。为了解决这个问题,我们需要“剪枝”。
1. 预剪枝(事前剪枝):在树构建过程中就提前停止。常用策略包括:
- 限制树的最大深度。
- 设置叶子节点所需的最小样本数(样本太少则停止分裂)。
- 设定分裂所需的最小纯度提升阈值(如基尼系数下降不足则停止)。
2. 后剪枝(事后剪枝):先让树充分生长,然后自底向上,考察每个非叶子节点。若将其替换为叶子节点能提升模型在验证集上的整体性能,则进行剪枝。后剪枝通常能得到泛化能力更强的树,但计算成本更高。
五、项目实战:客户流失预测
理论需要实践来巩固。下面我们使用一个客户流失数据集来构建一个决策树分类模型。数据集预览如下: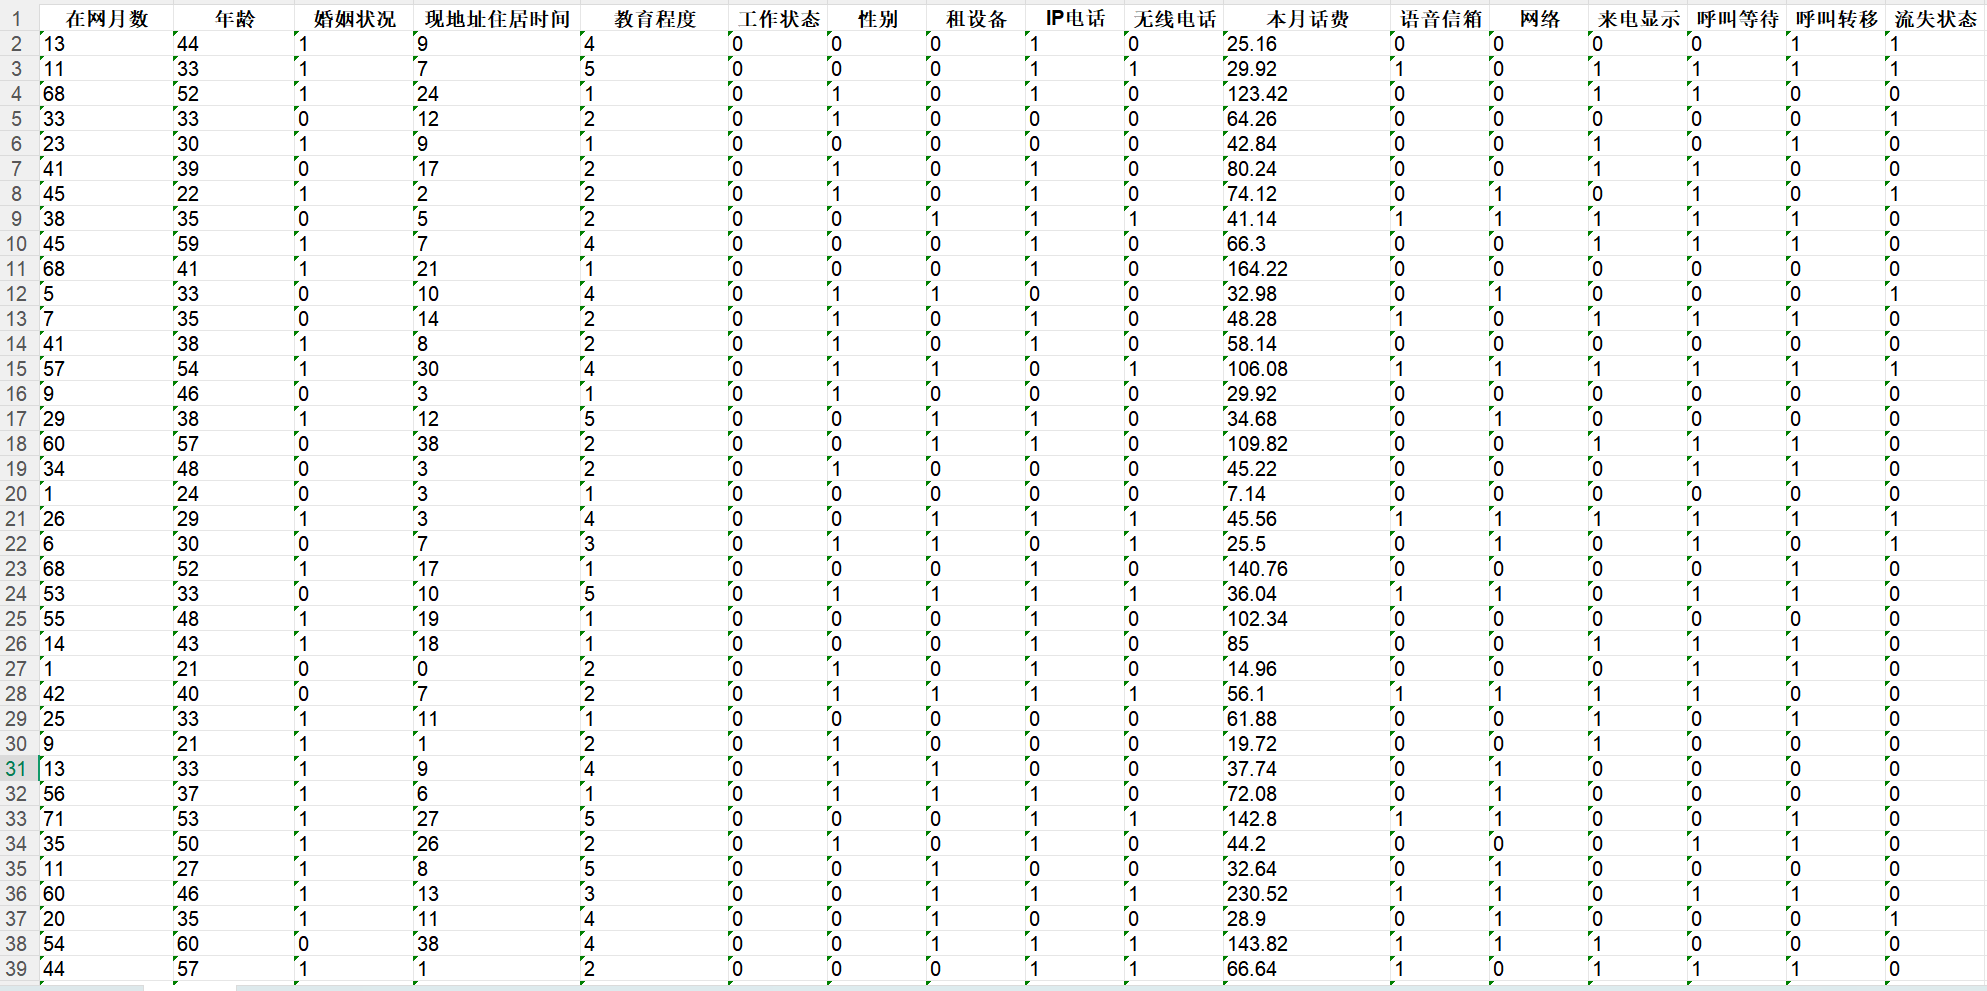
我们的目标是预测客户是否会流失(‘Churn’)。完整的实战代码如下,它涵盖了数据预处理、处理类别不平衡、模型训练与超参数调优的全过程:
import numpy as np
import pandas as pd
from sklearn.tree import DecisionTreeClassifier, plot_tree, export_text
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.metrics import accuracy_score, recall_score, precision_score, classification_report
from imblearn.over_sampling import SMOTE

import warnings
warnings.filterwarnings('ignore')

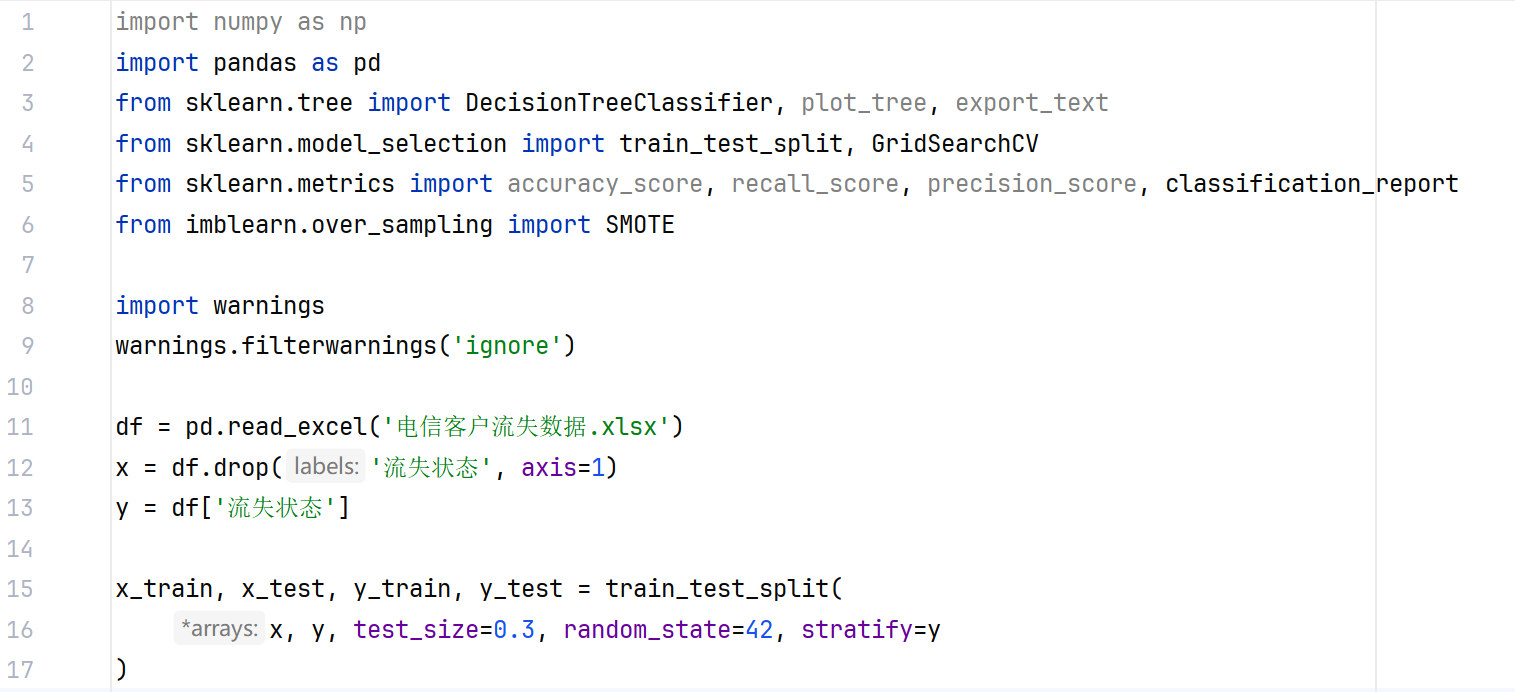
df = pd.read_excel('电信客户流失数据.xlsx')
x = df.drop('流失状态', axis=1)
y = df['流失状态']

x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.3, random_state=42, stratify=y
)

smote = SMOTE(random_state=42)
x_train_smote, y_train_smote = smote.fit_resample(x_train, y_train)

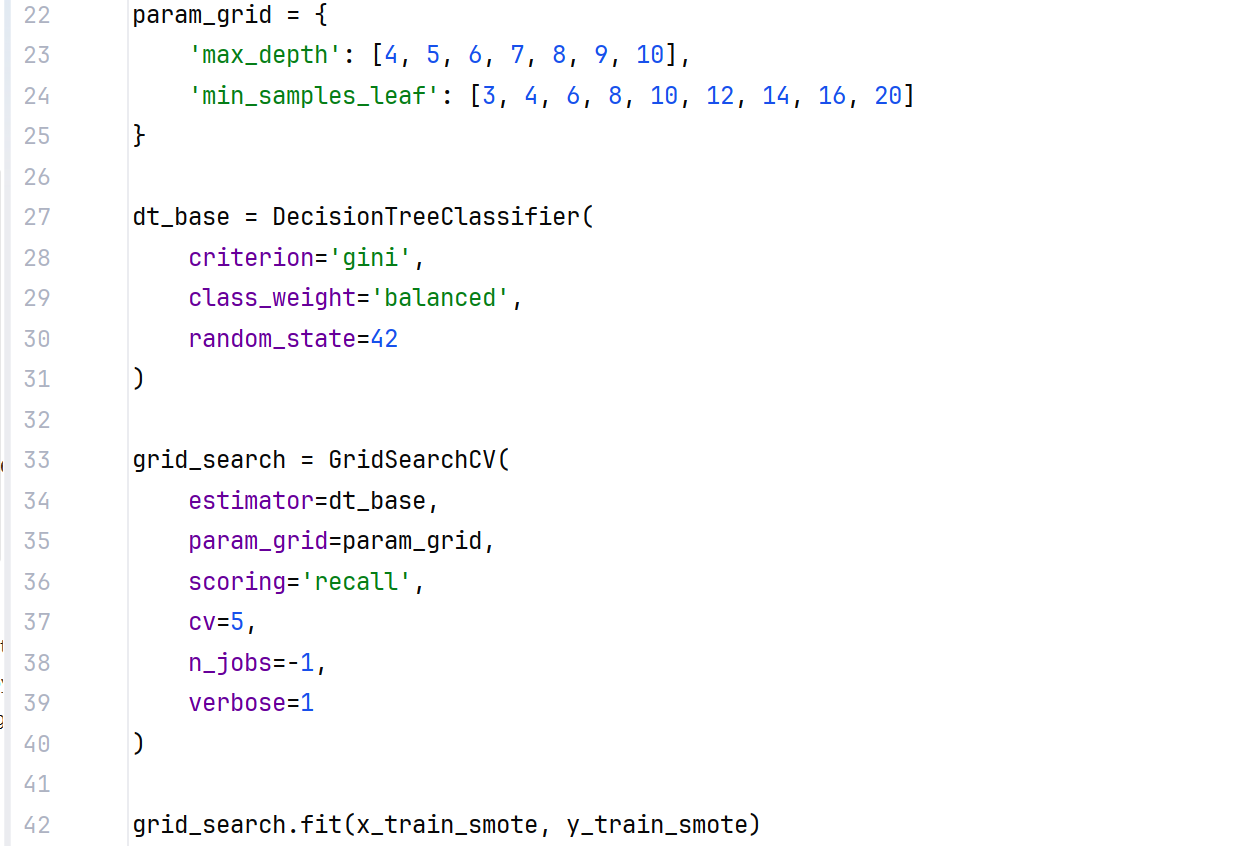
param_grid = {
    'max_depth': [4, 5, 6, 7, 8, 9, 10],
    'min_samples_leaf': [3, 4, 6, 8, 10, 12, 14, 16, 20]
}

dt_base = DecisionTreeClassifier(
    criterion='gini',
    class_weight='balanced',
    random_state=42
)

grid_search = GridSearchCV(
    estimator=dt_base,
    param_grid=param_grid,
    scoring='recall',
    cv=5,
    n_jobs=-1,
    verbose=1
)

grid_search.fit(x_train_smote, y_train_smote)

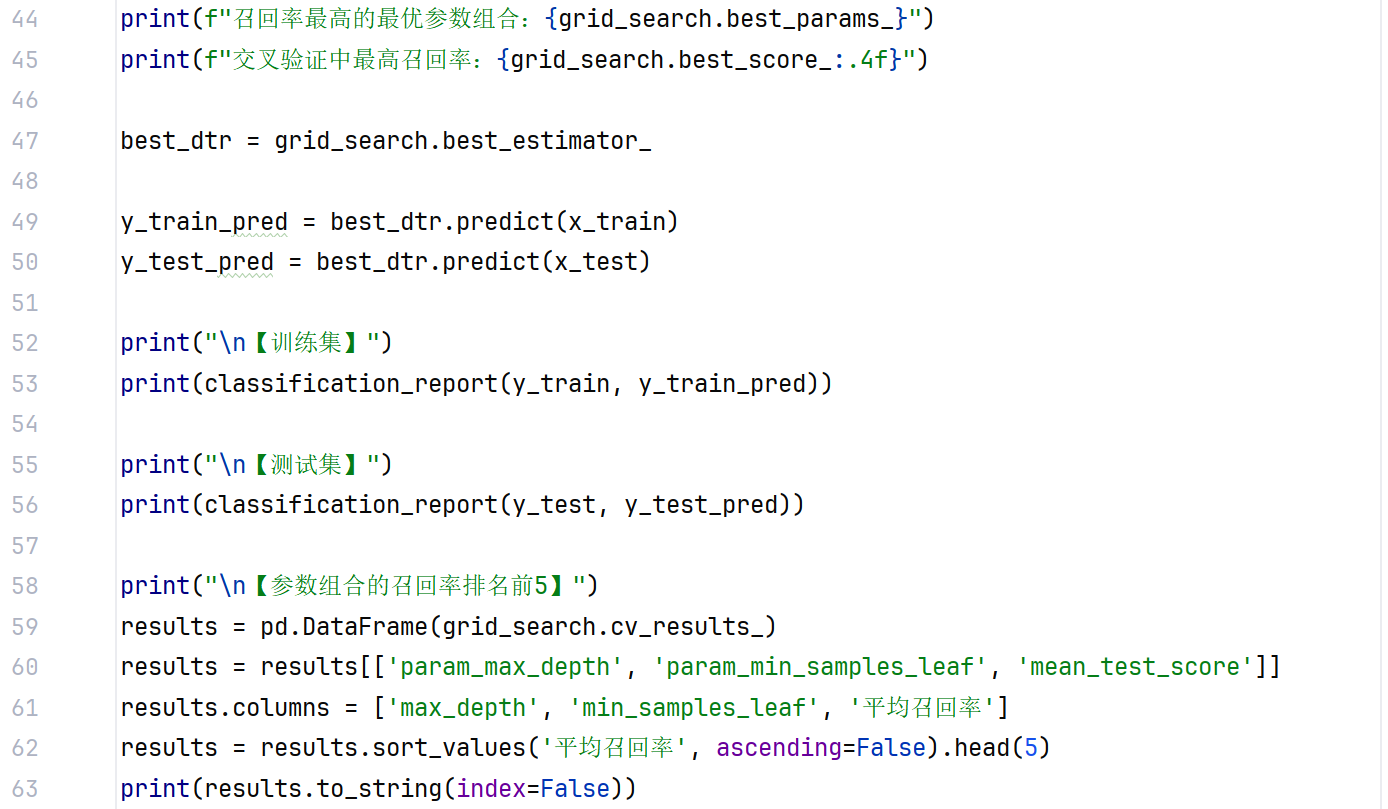
print(f"召回率最高的最优参数组合:{grid_search.best_params_}")
print(f"交叉验证中最高召回率:{grid_search.best_score_:.4f}")

best_dtr = grid_search.best_estimator_

y_train_pred = best_dtr.predict(x_train)
y_test_pred = best_dtr.predict(x_test)

print("\n【训练集】")
print(classification_report(y_train, y_train_pred))

print("\n【测试集】")
print(classification_report(y_test, y_test_pred))

print("\n【参数组合的召回率排名前5】")
results = pd.DataFrame(grid_search.cv_results_)
results = results[['param_max_depth', 'param_min_samples_leaf', 'mean_test_score']]
results.columns = ['max_depth', 'min_samples_leaf', '平均召回率']
results = results.sort_values('平均召回率', ascending=False).head(5)
print(results.to_string(index=False))

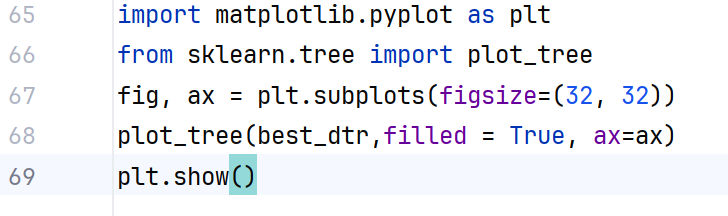
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree
fig, ax = plt.subplots(figsize=(32, 32))
plot_tree(best_dtr,filled = True, ax=ax)
plt.show()
代码执行后,我们会得到模型的评估结果(如准确率、召回率等):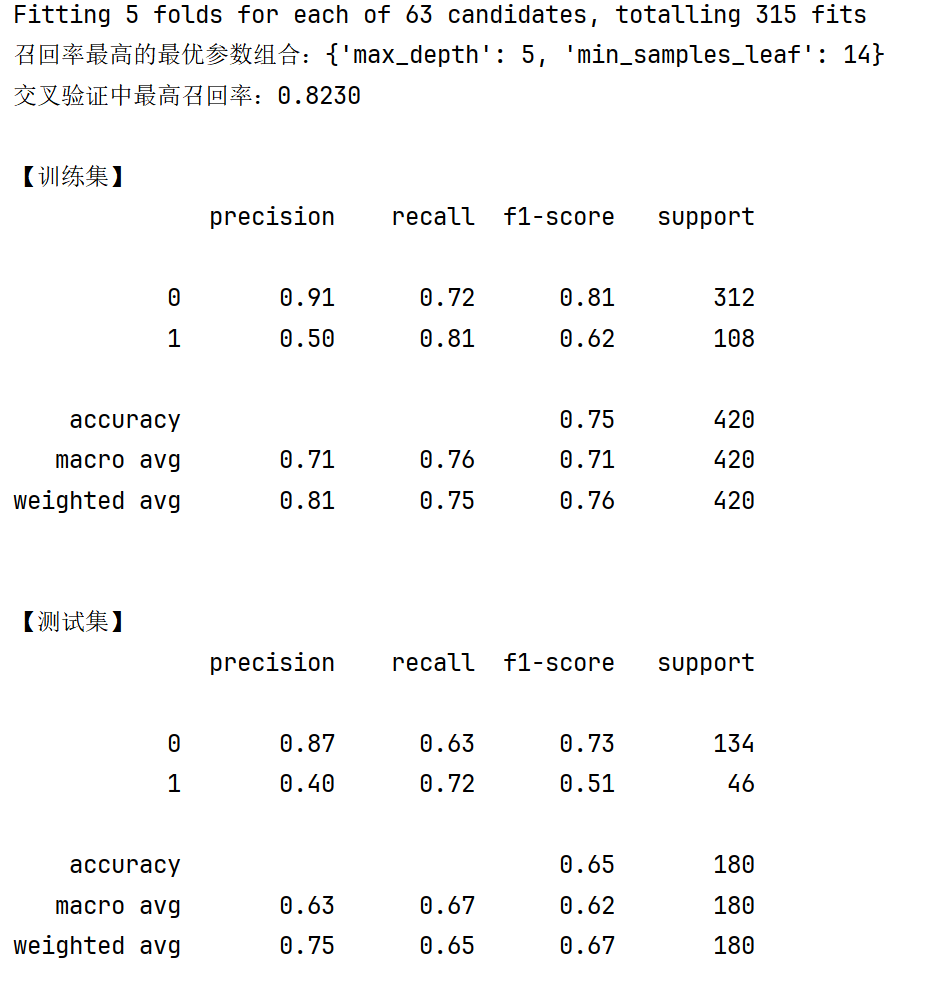
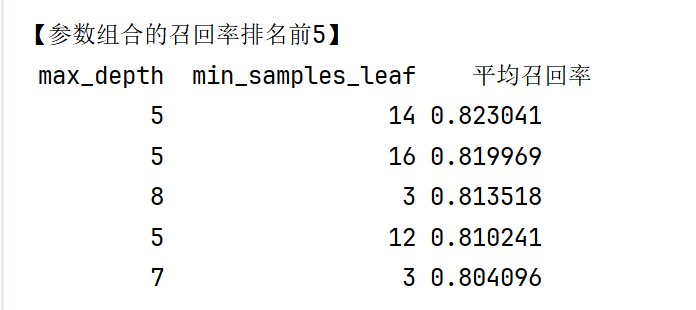
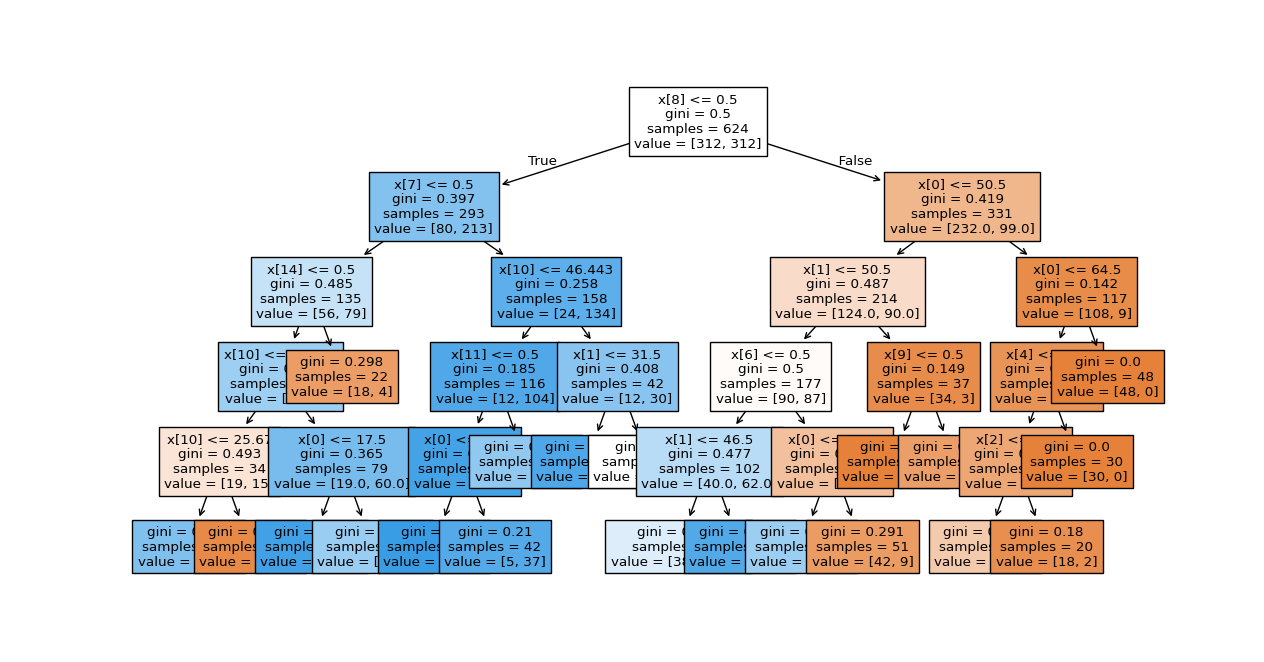
代码详解:
- 环境准备与数据加载:首先导入必要的库(如scikit-learn、pandas),并读入数据集。我们将‘Churn’列作为预测目标(y),其余特征作为输入(X),并按比例划分训练集和测试集。
- 处理数据不平衡:在分类问题中,如果正负样本比例悬殊,模型会偏向多数类。我们使用SMOTE过采样技术来生成少数类样本,平衡数据集。

- 超参数网格搜索:决策树的性能很大程度上依赖于超参数(如最大深度、最小叶子样本数)。我们使用GridSearchCV,以召回率为优化目标,自动寻找最佳参数组合。
- 模型训练与评估:用搜索到的最优参数重新训练决策树模型,并在测试集上评估其性能。
- 可视化决策树:最后,我们可以将训练好的决策树结构可视化出来,直观理解模型的决策路径。
通过这个实战,你不仅能学会如何使用Scikit-learn构建决策树,更能理解数据预处理、模型调优等机器学习全流程的关键环节。[AFFILIATE_SLOT_2]
六、总结与展望
决策树以其模型直观、解释性强、无需复杂数据预处理等优点,在机器学习中占据着独特而重要的地位。它不仅是初学者理解分类与回归逻辑的绝佳起点,更是构建当今最强大的集成学习模型(如梯度提升树、随机森林)和复杂神经网络结构的基础组件。
然而,单棵决策树容易过拟合、稳定性较差。这正是集成学习大放异彩的地方:通过组合多棵决策树(如Bagging之于随机森林,Boosting之于XGBoost),能够显著提升模型的泛化能力和预测精度。理解好决策树这“一木”,是未来领略机器学习“森林”之美的重要前提。


 浙公网安备 33010602011771号