在人工智能浪潮席卷全球的今天,深度学习已成为推动技术革新的核心引擎。作为深度学习的基石,人工神经网络(ANN)通过模拟人脑神经元的连接与计算方式,赋予了机器强大的感知与认知能力。无论是图像识别、自然语言处理,还是复杂的决策系统,其背后都离不开神经网络的支撑。本文旨在为你提供一份全面、深入的ANN技术总结,从基础概念到核心组件,再到优化实践,助你系统性地掌握这一强大的机器学习模型。
一、神经网络:从生物灵感走向计算模型
人工神经网络的构想源于对人类大脑的仿生学研究。大脑由数以亿计的神经元通过突触相互连接,形成复杂的网络来处理信息。ANN正是借鉴了这一思想,构建了一种由大量简单计算单元(人工神经元)互联而成的深度学习计算模型。
一个基本的人工神经元接收来自其他神经元或外部输入的信号,对这些信号进行加权求和(引入线性因素),然后通过一个激活函数(引入非线性因素)产生输出。这个过程可以用以下公式表示:
z = wx + b
其中,\(w_i\) 是权重,\(x_i\) 是输入,\(b\) 是偏置。正是这种简单的计算单元,通过层层堆叠,构成了强大的学习能力。下图直观展示了一个典型的三层神经网络结构:
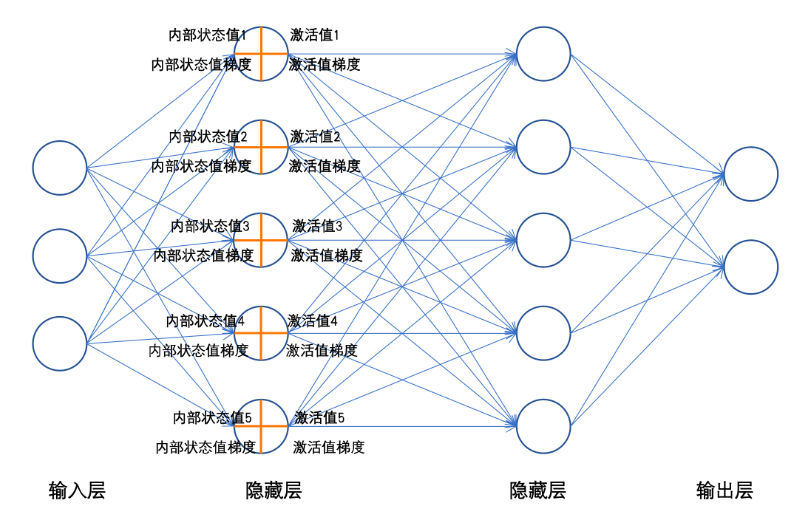
网络通常包含输入层、一个或多个隐藏层以及输出层。每一层的神经元与相邻层的神经元全连接,信息从输入层流向输出层,这个方向称为“前向传播”。层与层之间的连接关系可以通过下表来理解:
| 层级 | 作用 | 特点 |
|---|---|---|
| 输入层 | 输入样本初始特征值x | 仅一层 |
| 隐藏层 | 提取复杂的特征值 | 可多层,每层神经元数量决定提取特征的复杂度 |
| 输出层 | 输出模型预测结果 | 根据任务类型设计 |

二、激活函数:为模型注入非线性灵魂
如果神经网络只有线性变换(加权求和),那么无论堆叠多少层,其整体表达能力仍然等价于一个单层线性模型,无法学习复杂模式。激活函数的核心作用就是引入非线性,使神经网络能够逼近任意复杂的函数,从而胜任分类、回归等各种AI任务。
以下是几种经典激活函数的代码定义:
"""
案例:
    绘制激活函数ReLU的 函数图像 和 导数图像.
Sigmoid激活函数介绍:
    激活函数的目的:
        给模型增加非线性功能, 让模型(神经元)既可以做分类, 还可以做回归问题.
    激活函数的分类:
        Sigmoid:
        ReLU:
        Tanh:
        Softmax:
    Sigmoid激活函数:
        主要应用于 二分类的输出层, 且适用于 浅层神经网络(不超过5层).
        数据在 [-6, 6]之间有效果, 在[-3, 3]之间效果明显, 会将数据值映射到: [0, 1]
        求导后范围在 [0, 0.25]
    Tanh:
        主要应用于 隐藏层, 且适用于 浅层神经网络(不超过5层).
        数据在 [-3, 3]之间有效果, 在[-1, 1]之间效果明显, 会将数据值映射到: [-1, 1]
        求导后范围在 [0, 1], 较之于Sigmoid, 收敛速度快.
    ReLU:
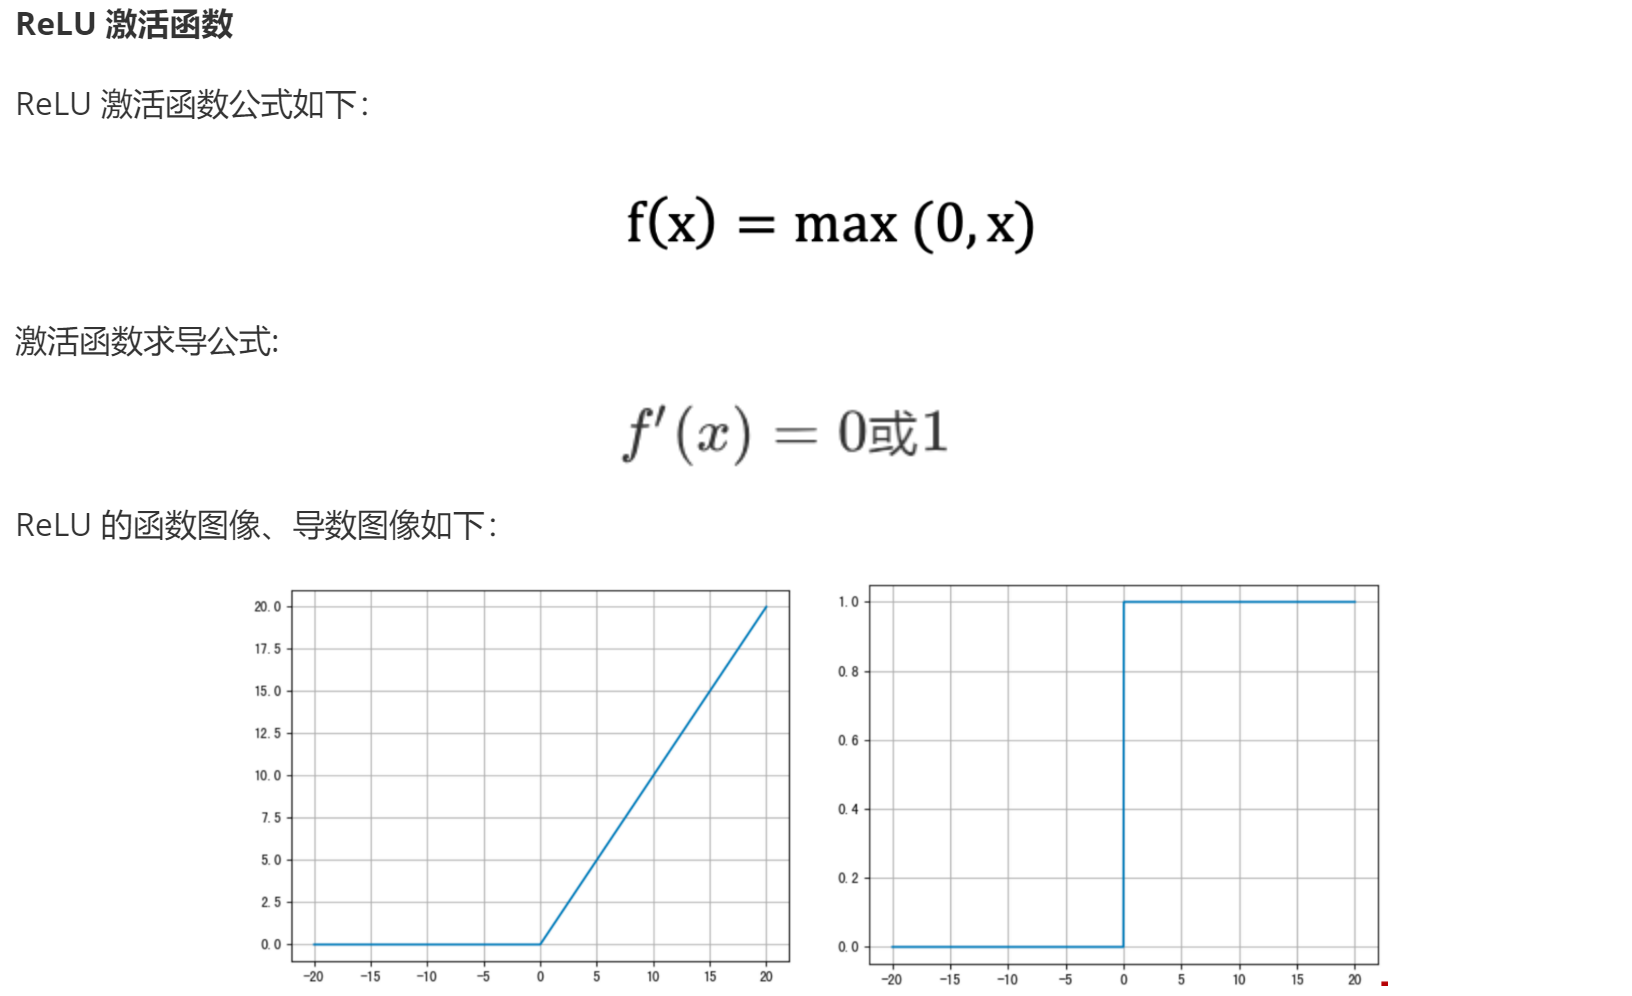
        计算公式为: max(0, x), 计算量相对较小, 训练成本低. 多应用于 隐藏层, 且适合 深层神经网络.
        求导后, 值要么是0, 要么是1, 较之于Tanh, 收敛速度更快.
        默认情况下ReLU只考虑 正样本, 可以使用LeakyReLU, PReLU 来考虑 正负样本.
    Softmax:
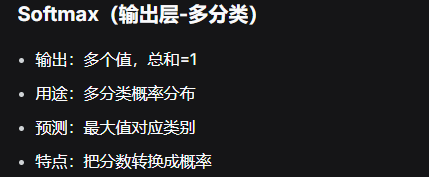
        将多分类的结果以概率的形式展示, 且概率和相加为1, 最终选取概率值最大的分类 作为最终结果.
    记忆: 如何选择激活函数
    隐藏层:
        ReLU > Leaky ReLU > PReLU > Tanh > Sigmoid
    输出层:
        二分类: Sigmoid
        多分类: Softmax
        回归问题: identity
"""
# 导包
import torch
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['SimHei']  # 用来正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False  # 用来正常显示负号
# 1. 创建画布和坐标轴, 1行2列.
fig, axes = plt.subplots(1, 2)
# 2. 生成 -20 ~ 20之间的 1000个数据点.
x = torch.linspace(-20, 20, 1000)
# print(f'x: {x}')
# 3. 计算上述1000个点, ReLU激活函数处理后的值.
# y = torch.sigmoid(x) # 激活函数处理后的值.
# y = torch.tanh(x)
y = torch.relu(x)
# print(f'y: {y}')
# 4. 在第1个子图中绘制ReLU激活函数的图像.
axes[0].plot(x, y)
axes[0].set_title('ReLU激活函数图像')
axes[0].grid()
# 5. 在第2个图上, 绘制ReLU激活函数的导数图像.
# 5.1 重新生成 -20 ~ 20之间的 1000个数据点.
# 参1: 起始值, 参2: 结束值, 参3: 元素的个数, 参4: 是否需要求导.
x = torch.linspace(-20, 20, 1000, requires_grad=True)
# 5.2 具体的计算上述1000个点, ReLU激活函数导数后的值.
# torch.sigmoid(x).sum().backward()
# torch.tanh(x).sum().backward()
torch.relu(x).sum().backward()
# 5.3 绘制图像.
axes[1].plot(x.detach(), x.grad)
axes[1].set_title('ReLU激活函数导数图像')
axes[1].grid()
plt.show()
# 绘制激活函数Softmax的 函数图像 和 导数图像
# 1. 定义张量, 记录: 分类数据.
scores = torch.tensor([[0.2, 0.35, 0.1, 0.46], [0.1, 0.13, 0.05, 2.79]])
# 2. dim = 0, 按行计算
probabilities = torch.softmax(scores, dim=1)
print(probabilities)
如何选择合适的激活函数?
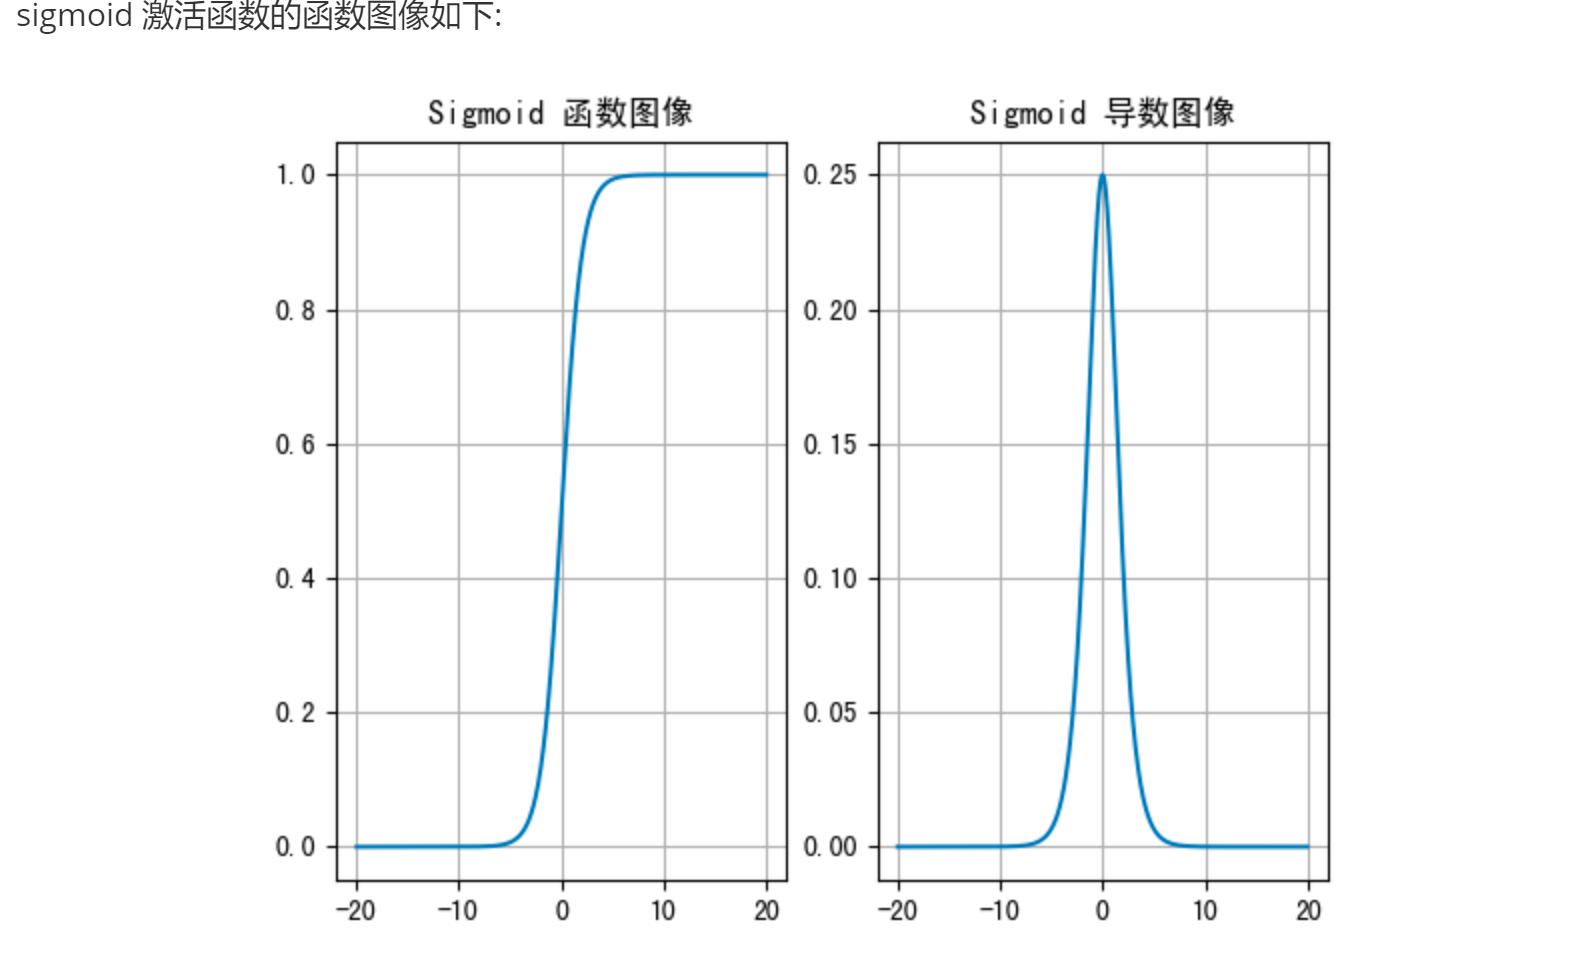
- Sigmoid:将输入压缩到(0,1)区间,传统上用于二分类输出层。但其导数最大仅为0.25,在深层网络中易导致“梯度消失”。其函数图像与导数图像如下:
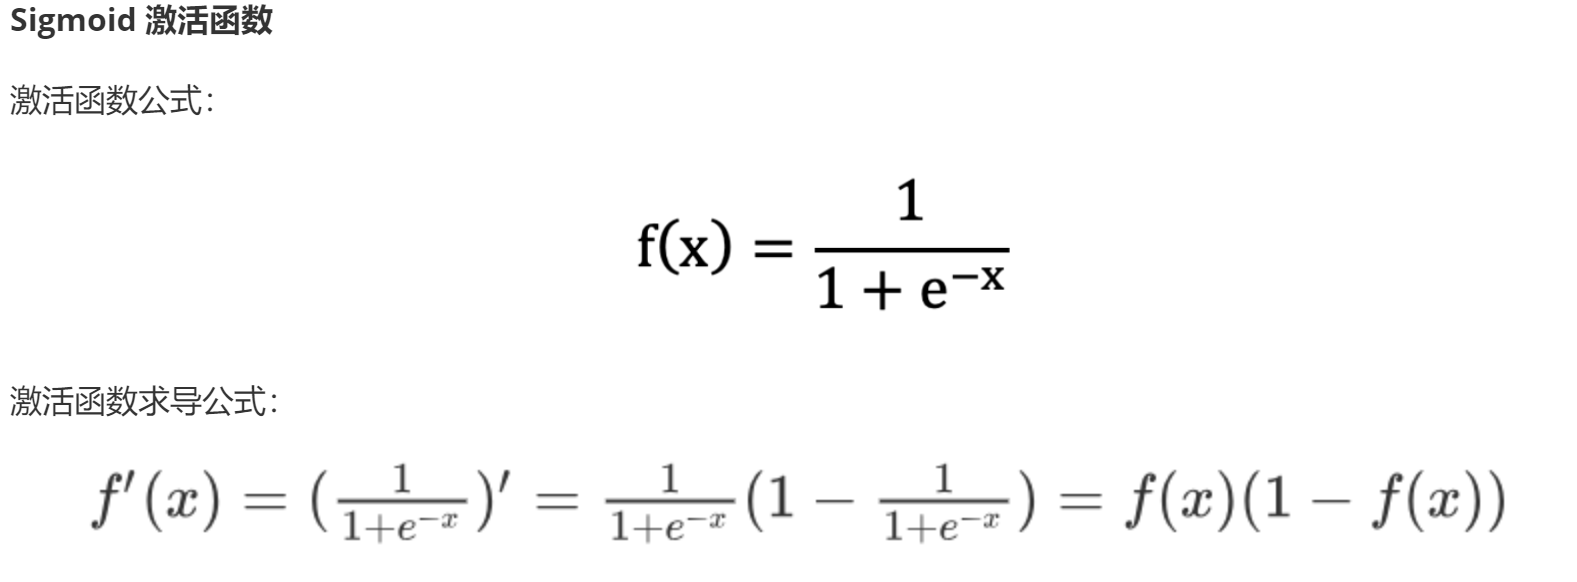
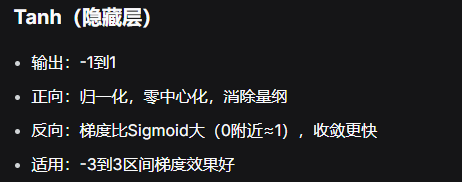
- Tanh:输出范围(-1,1),以0为中心,收敛速度通常快于Sigmoid,常用于早期的隐藏层。
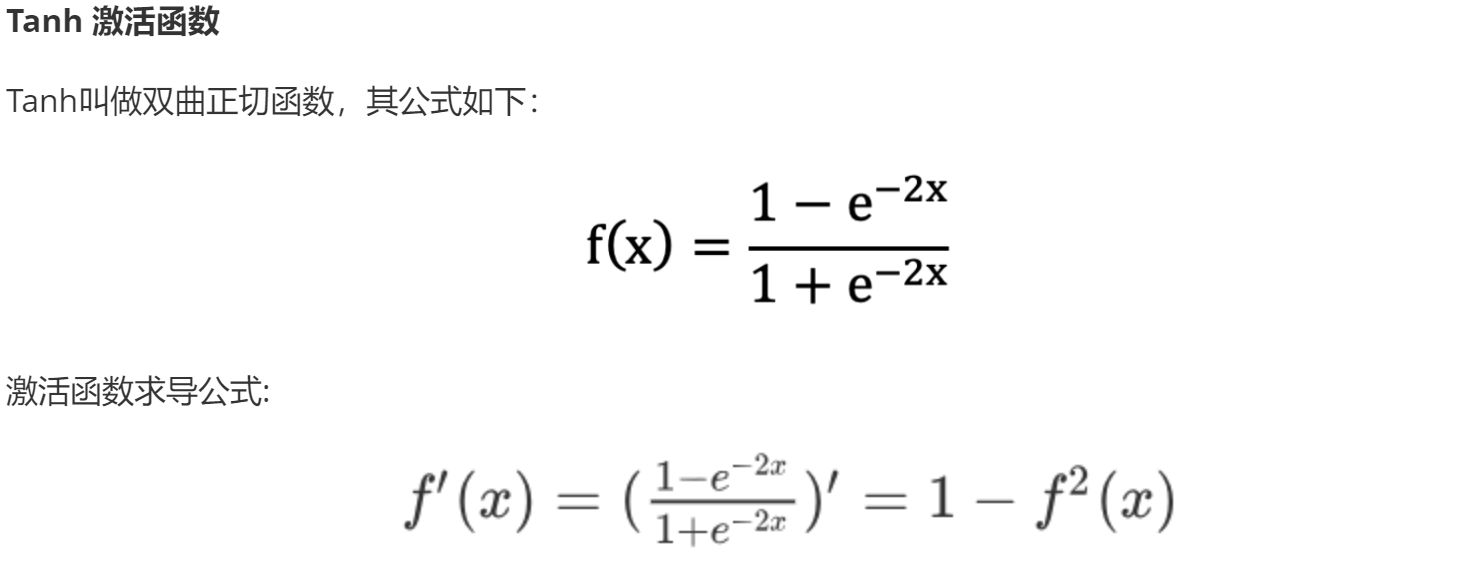
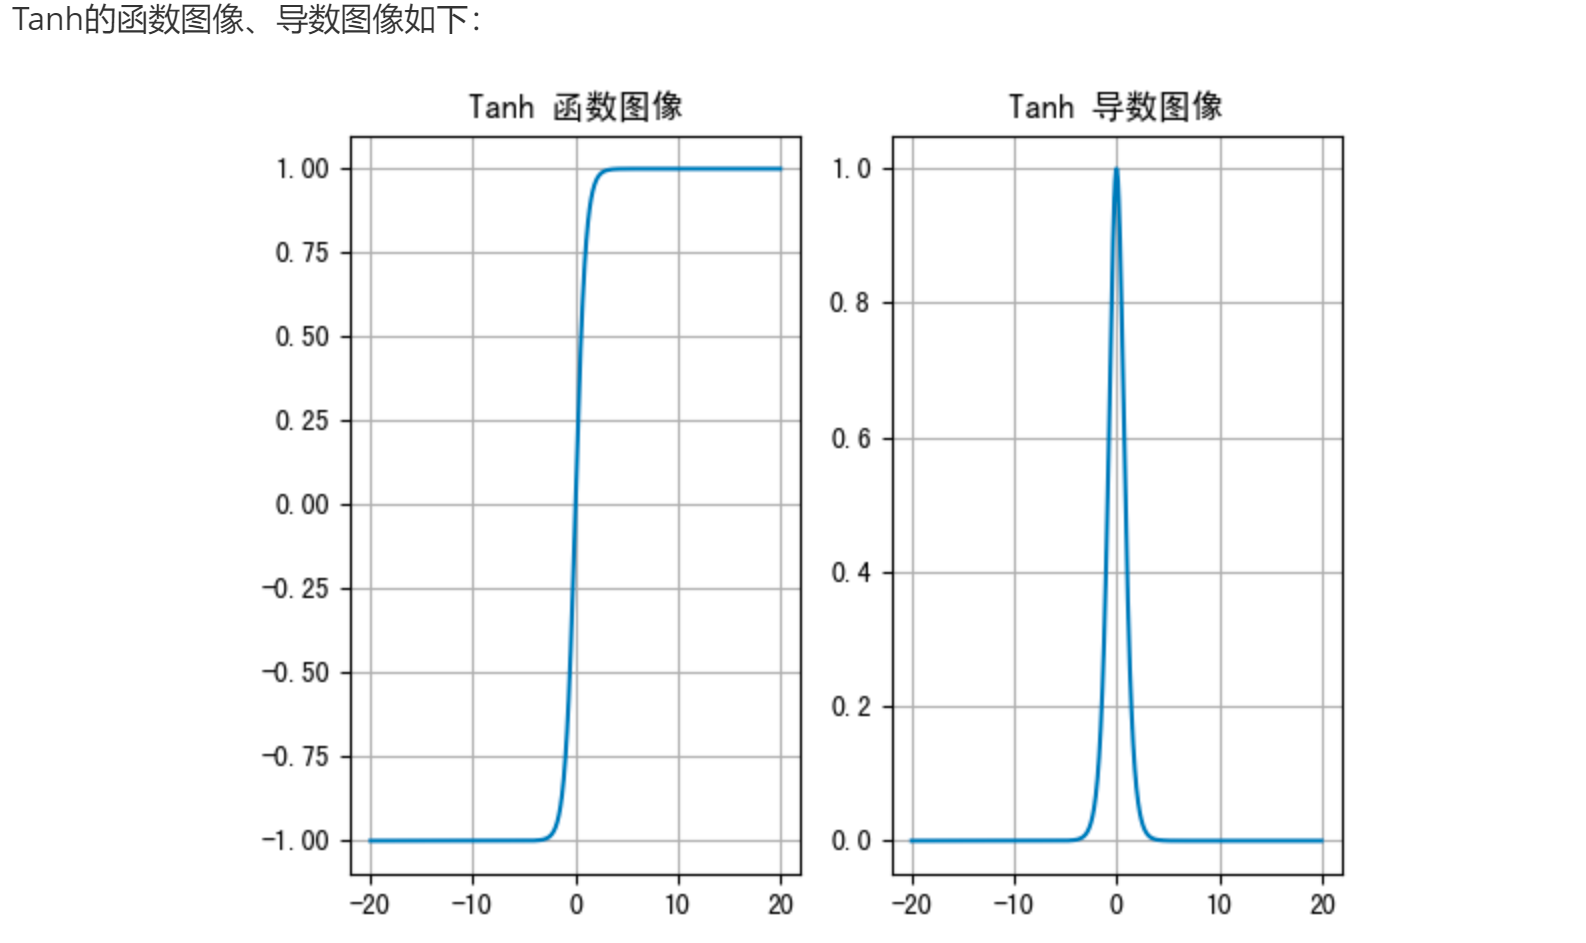
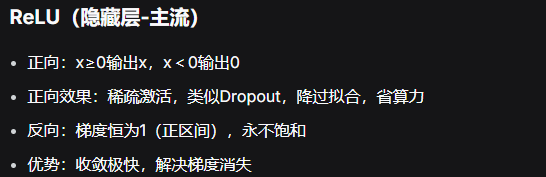
- ReLU及其变体:当前最主流的隐藏层激活函数。ReLU计算简单(\(f(x)=max(0, x)\)),能有效缓解梯度消失,加速训练。但需注意“神经元死亡”问题。Leaky ReLU和PReLU是其改进版本。
- Softmax:专为多分类输出层设计,将网络输出转换为概率分布,所有类别概率之和为1。计算公式为:
softmax(dim=1)
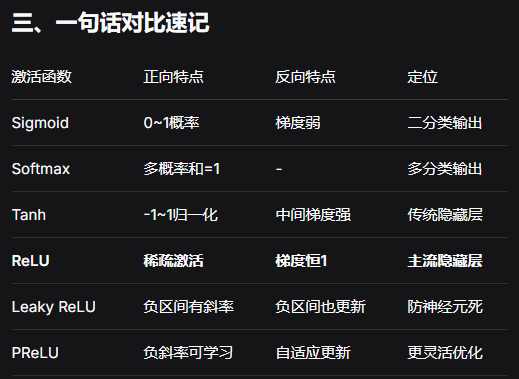
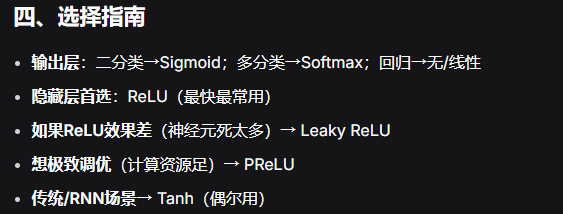
实践建议:隐藏层优先使用ReLU;二分类输出层用Sigmoid;多分类输出层用Softmax;回归问题输出层可不使用激活函数或使用恒等函数。各类激活函数的对比总结见下图: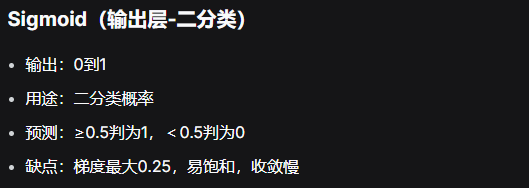
三、模型构建基石:参数初始化与网络搭建
训练开始前,神经网络的权重和偏置需要被赋予初始值。糟糕的初始化可能导致训练失败(如梯度消失/爆炸),或使所有神经元学习到相同的特征(对称性破坏失败)。
初始化方法:常见的有Xavier初始化(适用于Tanh、Sigmoid)和Kaiming初始化(适用于ReLU及其变体)。它们根据激活函数的特性来调整权重初始分布的方差,确保信号在前向和反向传播中保持稳定。下表对比了两种方法:
| 初始化方法 | 分布类型 | 参数范围 | 适用场景 |
|---|---|---|---|
| 随机初始化 | 均匀分布 | 默认(0,1),推荐(-1/√d, 1/√d) d是dim | 通用 |
| 正态分布 | 均值0,标准差1 N(0,1) | 通用 | |
| 全0/1/指定值 | - | 指定值 | 仅测试环境,训练易导致对称性 |
| Kaiming初始化 | 均匀分布 | (-√(6/n_in), √(6/n_in)) | ReLU系列 |
| 正态分布 | N(0, √(2/n_in)) | ReLU系列 | |
| Xavier初始化 | 均匀分布 | (-√(6/(n_in+n_out)), √(6/(n_in+n_out))) | Sigmoid/Tanh |
| 正态分布 | N(0, √(2/(n_in+n_out))) | Sigmoid/Tanh |

以下是Kaiming初始化的一个PyTorch示例:
"""
参数初始化的目的:
    1. 防止梯度消失 或者 梯度爆炸.
    2. 提高收敛速度.
    3. 打破对称性.
参数初始化的方式:
    无法打破对称性的:
        全0, 全1, 固定值
    可以打破对称性的:
        随机初始化, 正态分布初始化, kaiming初始化, xavier初始化
总结:
    1. 记忆 kaiming初始化, xavier初始化, 全0初始化.
    2. 关于初始化的选择上:
        激活函数ReLU及其系列: 优先用 kaiming
        激活函数非ReLU: 优先用 xavier
        如果是浅层网络: 可以考虑使用 随机初始化
"""
# 导包
import torch.nn as nn       # neural network: 神经网络
import torch.nn as nn
# 1. 均匀分布随机初始化
def dm01():
    # 1. 创建1个线性层, 输入维度5, 输出维度3
    linear = nn.Linear(5, 3)
    # 2. 对权重(w)进行随机初始化, 从0-1均匀分布产生参数
    nn.init.uniform_(linear.weight)
    # 3. 对偏置(b)进行随机初始化, 从0-1均匀分布产生参数
    nn.init.uniform_(linear.bias)
    # 4. 打印生成结果.
    print(linear.weight.data)
    print(linear.bias.data)
# 2. 固定初始化
def dm02():
    # 1. 创建1个线性层, 输入维度5, 输出维度3
    linear = nn.Linear(5, 3)
    # 2. 对权重(w)进行初始化, 设置固定值为: 3
    nn.init.constant_(linear.weight, 3)
    # 3. 对偏置(b)进行初始化, 设置固定值为: 3
    nn.init.constant_(linear.bias, 3)
    # 4. 打印生成结果.
    print(linear.weight.data)
    print(linear.bias.data)
# 3. 全0初始化
def dm03():
    # 1. 创建1个线性层, 输入维度5, 输出维度3
    linear = nn.Linear(5, 3)
    # 2. 对权重(w)进行初始化, 全0初始化
    nn.init.zeros_(linear.weight)
    # 3. 对偏置(b)进行初始化, 全0初始化
    nn.init.zeros_(linear.bias)
    # 4. 打印生成结果.
    print(linear.weight.data)
    print(linear.bias.data)
# 4. 全1初始化
def dm04():
    # 1. 创建1个线性层, 输入维度5, 输出维度3
    linear = nn.Linear(5, 3)
    # 2. 对权重(w)进行初始化, 全1初始化
    nn.init.ones_(linear.weight)
    # 3. 打印生成结果.
    print(linear.weight.data)
# 5. 正态分布随机初始化
def dm05():
    # 1. 创建1个线性层, 输入维度5, 输出维度3
    linear = nn.Linear(5, 3)
    # 2. 对权重(w)进行初始化, 正态分布初始化(均值为0, 标准差为1)
    nn.init.normal_(linear.weight)
    # 3. 打印生成结果.
    print(linear.weight.data)
# 6. kaiming 初始化
def dm06():
    # 1. 创建1个线性层, 输入维度5, 输出维度3
    linear = nn.Linear(5, 3)
    # 2. 对权重(w)进行初始化, 正态分布初始化(均值为0, 标准差为1)
    # kaiming 正态分布初始化
    # nn.init.kaiming_normal_(linear.weight)
    # kaiming 均匀分布初始化
    nn.init.kaiming_uniform_(linear.weight)
    # 3. 打印生成结果.
    print(linear.weight.data)
# 7. xavier 初始化
def dm07():
    # 1. 创建1个线性层, 输入维度5, 输出维度3
    linear = nn.Linear(5, 3)
    # 2. 对权重(w)进行初始化, 正态分布初始化(均值为0, 标准差为1)
    # xavier 正态分布初始化
    # nn.init.xavier_normal_(linear.weight)
    # xavier 均匀分布初始化
    nn.init.xavier_uniform_(linear.weight)
    # 3. 打印生成结果.
    print(linear.weight.data)
# 测试
if __name__ == '__main__':
    # dm01()        # 均匀分布随机初始化
    # dm02()        # 固定初始化
    # dm03()        # 全0初始化
    # dm04()        # 全1初始化
    # dm05()        # 正态分布
    # dm06()        # kaiming初始化
dm07() # xavier初始化一个完整的深度学习项目通常遵循以下步骤:准备数据 → 搭建网络 → 训练模型 → 测试评估。在PyTorch中搭建网络模型,需要定义一个继承自nn.Module的类,在__init__中定义网络层,在forward方法中定义前向传播逻辑:
"""
案例:
    演示神经网络搭建流程.
深度学习案例的4个步骤:
    1. 准备数据.
    2. 搭建神经网络
    3. 模型训练
    4. 模型测试
神经网络搭建流程:
    1. 定义一个类, 继承: nn.Module
    2. 在__init__()方法中, 搭建神经网络.
    3. 在 forward()方法中,完成: 前向传播.
"""
# 导包
import torch
import torch.nn as nn
from torchsummary import summary  # 计算模型参数,查看模型结构, pip install torchsummary -i https://mirrors.aliyun.com/pypi/simple/
# todo: 1.搭建神经网络, 即: 自定义继承 nn.Module
class ModelDemo(nn.Module):
    # todo: 1.1 在init魔法方法中, 完成初始化: 父类成员, 及 神经网络搭建.
    def __init__(self):
        # 1.1 初始化父类成员.
        super().__init__()
        # 1.2 搭建神经网络 -> 隐藏层 + 输出层
        # 隐藏层1: 输入特征数 3, 输出特征数 3
        self.linear1 = nn.Linear(3, 3)
        # 隐藏层2: 输入特征数 3, 输出特征数 2
        self.linear2 = nn.Linear(3, 2)
        # 输出层: 输入特征数 2, 输出特征数 2
        self.output = nn.Linear(2, 2)
        # 1.3 对隐藏层进行参数初始化.
        # 隐藏层1
        nn.init.xavier_normal_(self.linear1.weight)
        nn.init.zeros_(self.linear1.bias)
        # 隐藏层2
        nn.init.kaiming_normal_(self.linear2.weight)
        nn.init.zeros_(self.linear2.bias)
    # todo: 1.2 前向传播: 输入层 -> 隐藏层 -> 输出层
    def forward(self, x):
        # 1.1 第1层 隐藏层计算: 加权求和 + 激活函数(Sigmoid)
        # 分解版写法.
        # x = self.linear1(x)     # 加权求和
        # x = torch.sigmoid(x)    # 激活函数
        # 合并版写法.
        x = torch.sigmoid(self.linear1(x))
        # 1.2 第2层 隐藏层计算: 加权求和 + 激活函数(ReLu)
        x = torch.relu(self.linear2(x))
        # 1.3 第3层 输出层计算: 加权求和 + 激活函数(Softmax)
        # dim=-1, 表示按行计算, 一条样本一条样本的处理.
        x = torch.softmax(self.output(x), dim=-1)
        # 1.4 返回预测值.
        return x
# todo: 2.模型训练.
def train():
    # 1. 创建模型对象.
    my_model = ModelDemo()
    # print(f'my_model: {my_model}')
    # 2. 创建数据集样本, 随机生成.
    data = torch.randn(size=(5, 3))
    print(f'data: {data}')
    print(f'data.shape: {data.shape}')                  # (5行, 3列)
    print(f'data.requires_grad: {data.requires_grad}')  # False
    # 3. 调用神经网络模型 -> 进行模型训练.
    output = my_model(data)     # 底层自动调用了 forward()方法, 进行 前向传播.
    print(f'output: {output}')
    print(f'output.shape: {output.shape}')                  # (5行, 2列)
    print(f'output.requires_grad: {output.requires_grad}')  # True
    print('-' * 30)
    # 4. 计算 和 查看模型参数.
    print('=================== 计算模型参数 ===================')
    # 参1: (神经网络)模型对象, 参2: 输入数据维度(5行3列)
    summary(my_model, input_size=(5, 3))
    print('=================== 查看模型参数 ===================')
    for name, param in my_model.named_parameters():
        print(f'name: {name}')
        print(f'param: {param} \n')
# todo: 3.测试
if __name__ == '__main__':
train()四、损失函数与优化器:指引模型学习的方向
损失函数(或称代价函数)是衡量模型预测值与真实值差距的标尺,是驱动模型学习的“指挥棒”。通过计算损失,并结合反向传播算法,模型才能知道如何调整参数以减小误差。
常见损失函数:
1. 分类任务:交叉熵损失最为常用。对于多分类,常与Softmax结合,称为Softmax损失。它衡量的是预测概率分布与真实标签分布的差异。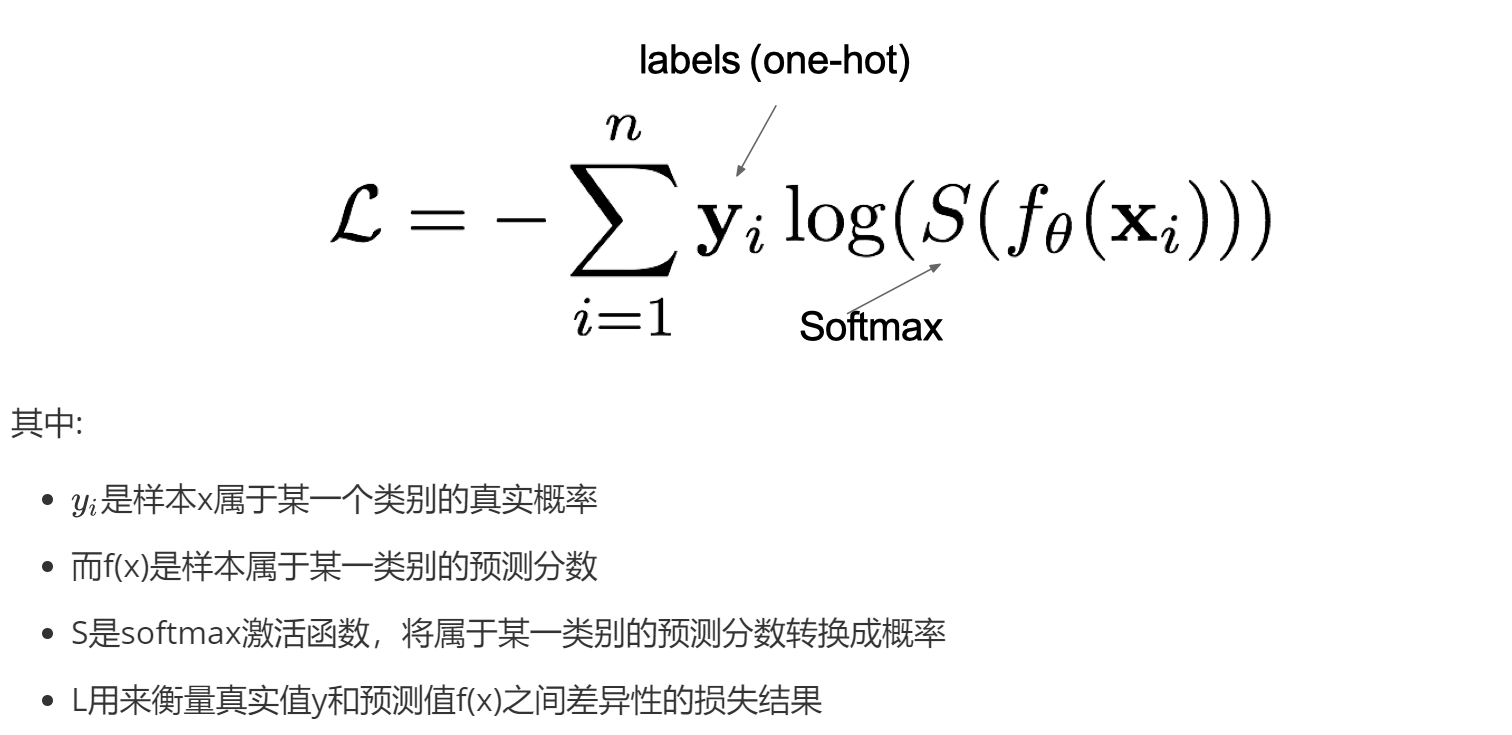
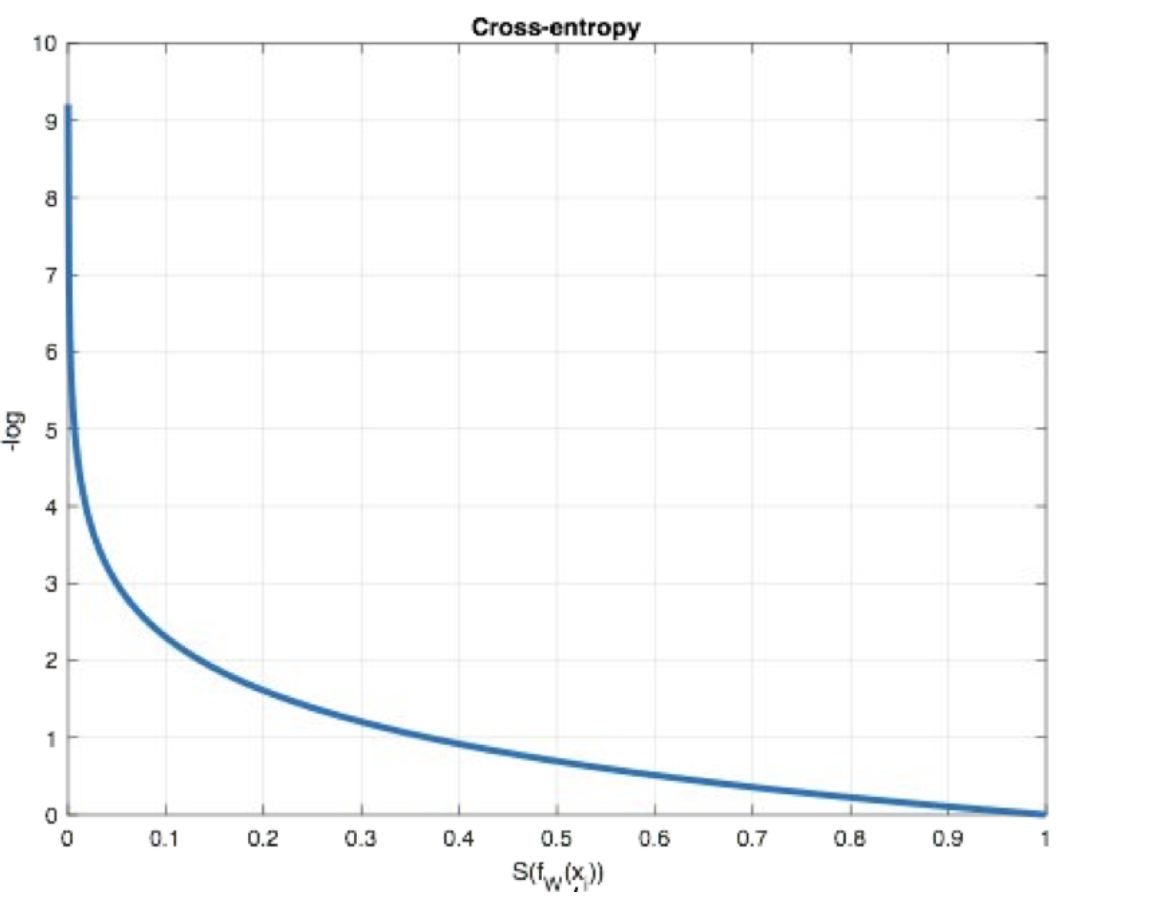
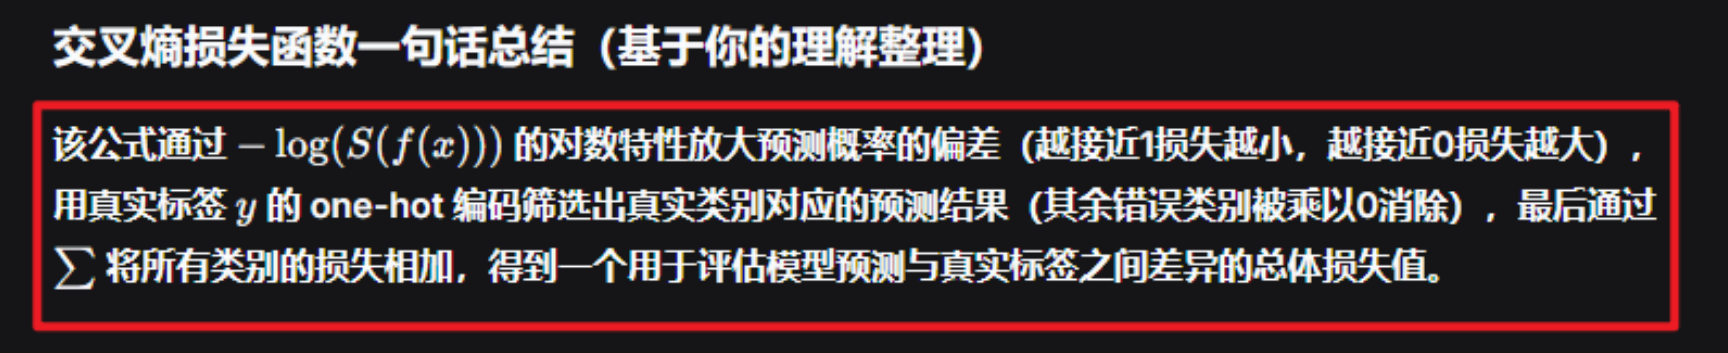
不同分类损失函数的对比如下:
| 类型 | 损失函数 | 特点 |
|---|---|---|
| 多分类交叉熵损失 | 实现softmax+损失计算 | |
| 二分类交叉熵损失 | 二分类任务 |
PyTorch实现示例:
"""
案例:
    演示 多分类任务的交叉熵损失函数.
损失函数介绍:
    概述:
        损失函数也叫成本函数, 目标函数, 代价函数, 误差函数, 就是用来衡量 模型好坏(模型拟合情况)的.
    分类:
        分类问题:
            多分类交叉熵损失: CrossEntropyLoss
            二分类交叉熵损失: BCELoss
        回归问题:
            MAE: Mean Absolute Error, 平均绝对误差.
            MSE: Mean Squared Error, 均方误差.
            Smooth L1: 结合上述两个的特点做的升级, 优化.
多分类交叉熵损失: CrossEntropyLoss
    设计思路:
        Loss = - Σylog(S(f(x)))
    简单记忆:
        x:          样本
        f(x):       加权求和
        S(f(x)):    处理后的概率
        y:          样本x属于某一个类别的 真实概率.
    大白话解释:
        损失函数结果 = 最小化 正确类别所对应的 预测概率的对数的 负值(损失值最小)...
    细节:
        CrossEntropyLoss = Softmax() + 损失计算, 后续如果用这个损失函数, 则: 输出层就不用额外调用 softmax()激活函数了.
"""
# 导包
import torch
import torch.nn as nn
# 1. 定义函数, 演示: 多分类交叉熵损失.
def dm01():
    # 1. 手动创建样本的真实值 -> 就是上述公式中的 y
    y_true = torch.tensor([[0, 1, 0], [1, 0, 0]], dtype=torch.float)
    # y_true = torch.tensor([1, 2])
    # 2. 手动创建样本的预测值 -> 就是上述公式中的 f(x)
    y_pred = torch.tensor([[0.1, 0.8, 0.1], [0.7, 0.2, 0.1]], requires_grad=True, dtype=torch.float)
    # 3. 创建多分类交叉熵损失函数.
    criterion = nn.CrossEntropyLoss()       # 平均损失, 来源于参数: reduction: str = "mean",
    # 4. 计算损失值.
    loss = criterion(y_pred, y_true)
    print(f'损失值: {loss}')
# 2. 测试
if __name__ == '__main__':
    dm01()
"""
案例:
演示二分类任务的损失函数.
二分类任务的损失函数(BCELoss):
公式:
Loss = -ylog(预测值) - (1 - y)log(1 - 预测值)
细节:
因为公式中没有包含Sigmoid激活函数, 所以使用BCELoss的时候, 还需要手动指定 Sigmoid.
"""
# 导包
import torch
import torch.nn as nn
# 1. 定义函数, 演示: 二分类任务的损失函数.
def dm01():
# 1. 设置真实值.
y_true = torch.tensor([0, 1, 0], dtype=torch.float)
# 2. 设置预测值(概率)
y_pred = torch.tensor([0.6901, 0.5423, 0.2639])
# 3. 创建二分类交叉熵损失函数.
criterion = nn.BCELoss() # reduction: str = "mean" -> 均值
# 4. 计算损失值.
loss = criterion(y_pred, y_true)
print(f'损失值: {loss}')
# 2. 测试
if __name__ == '__main__':
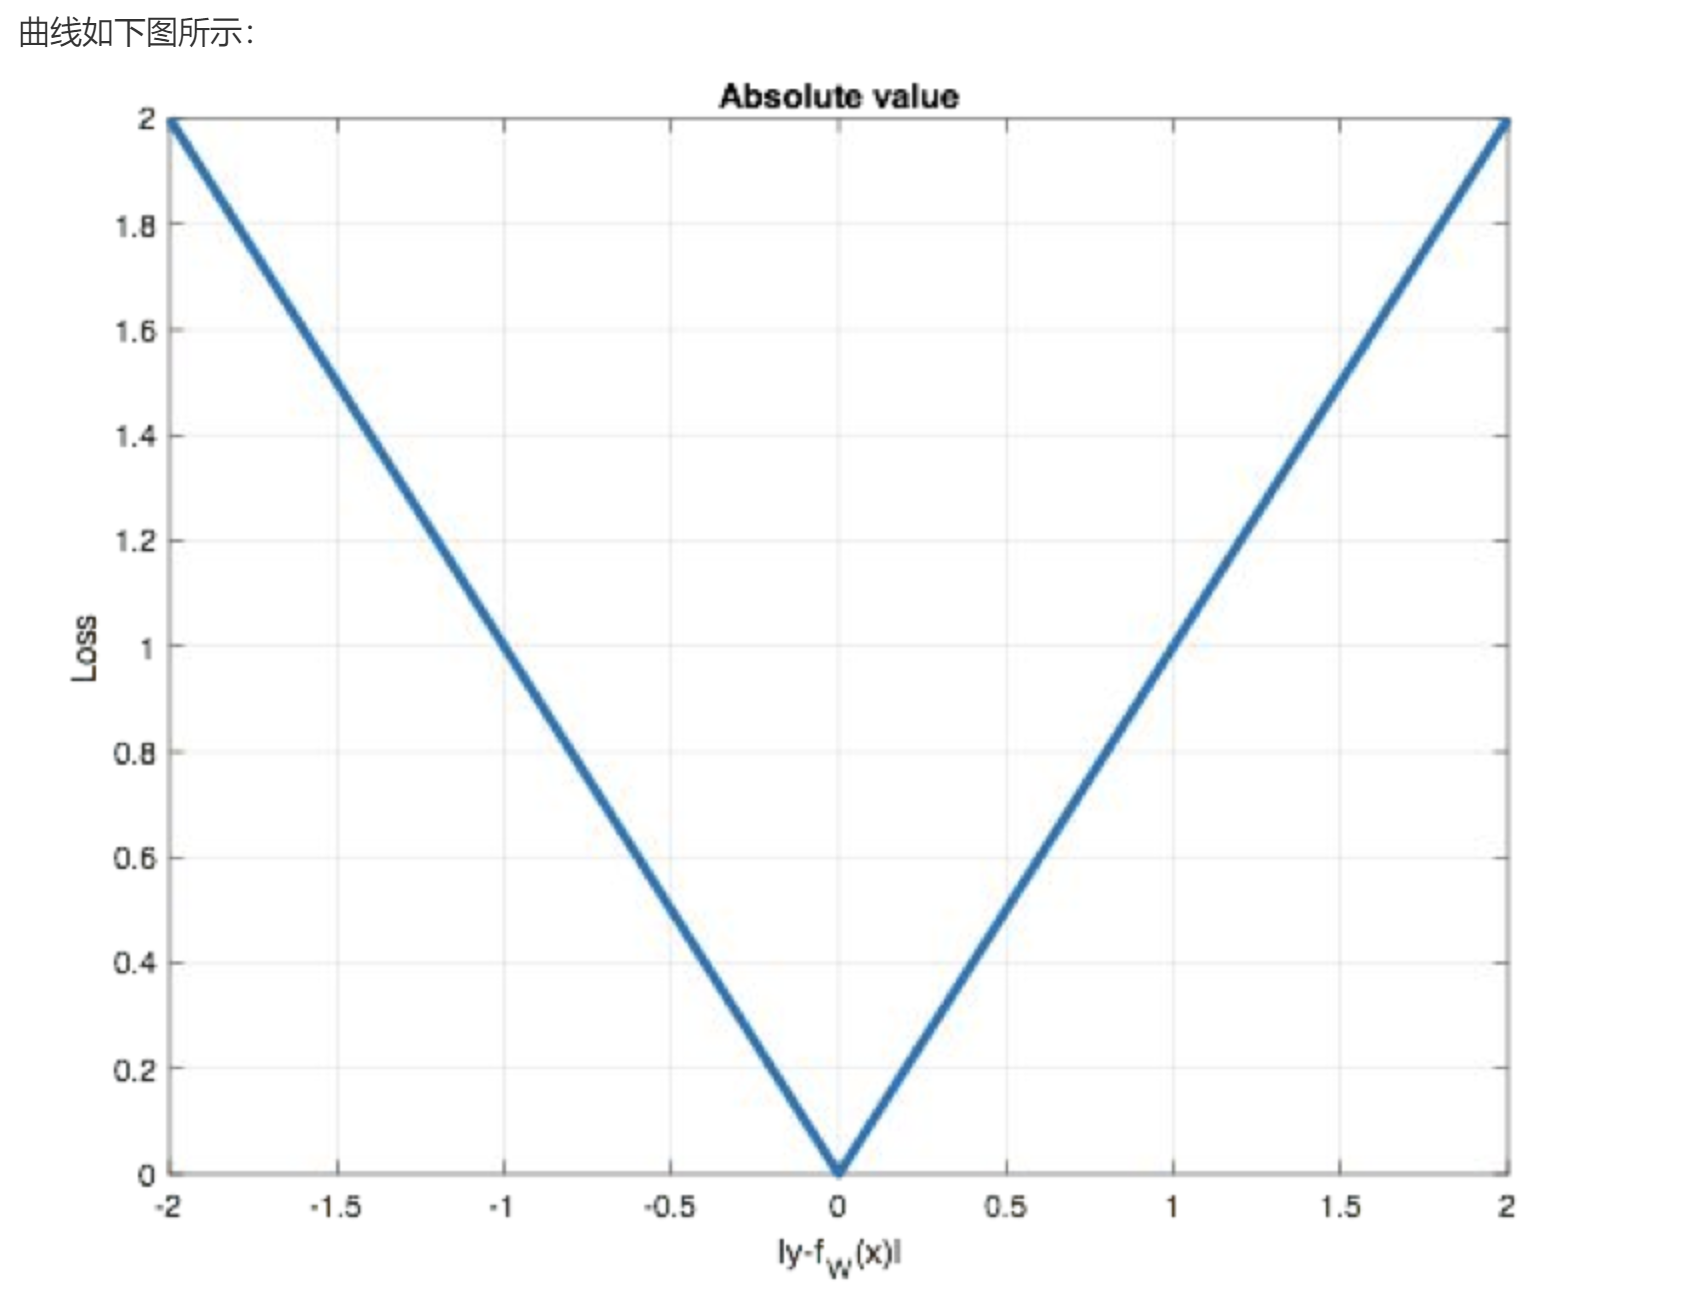
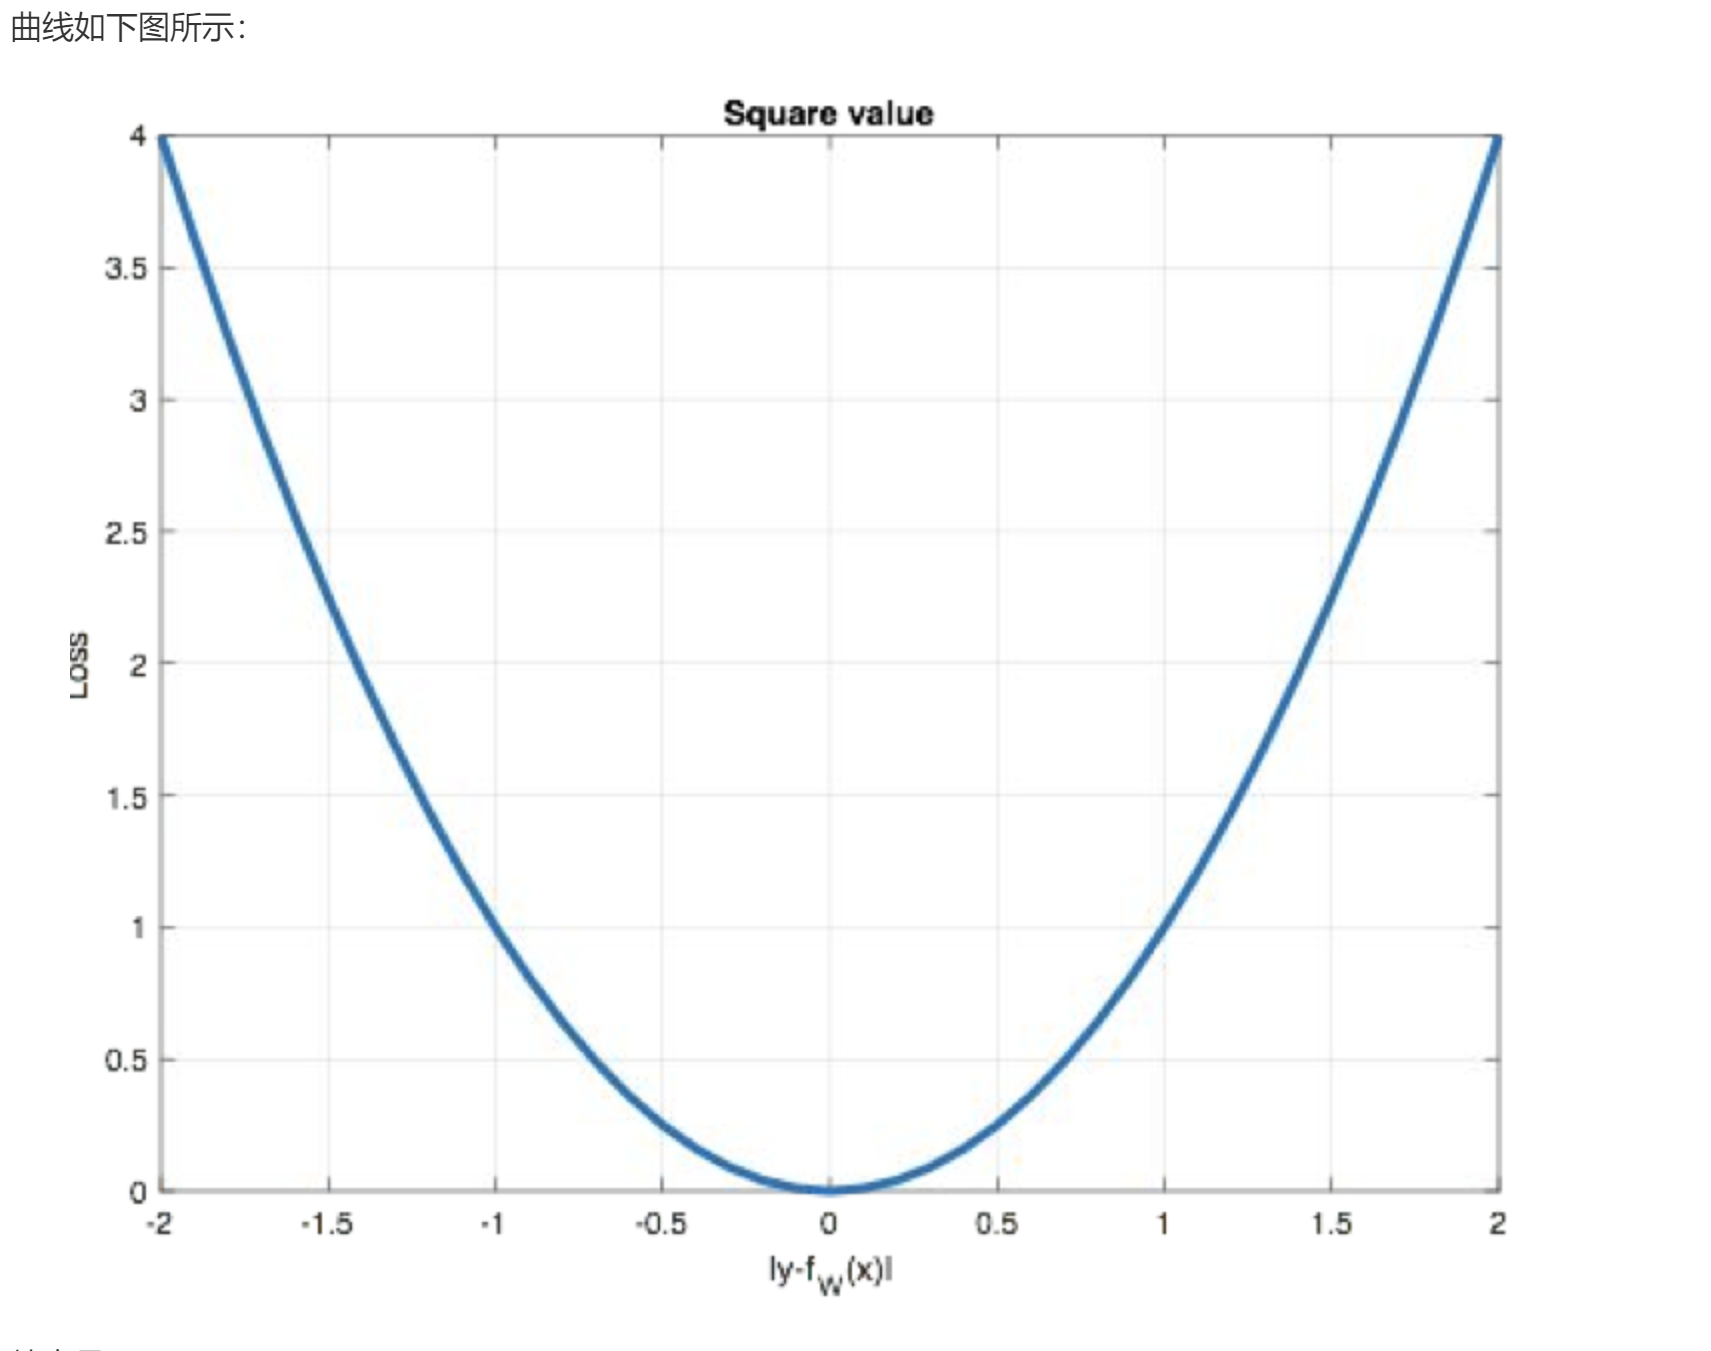
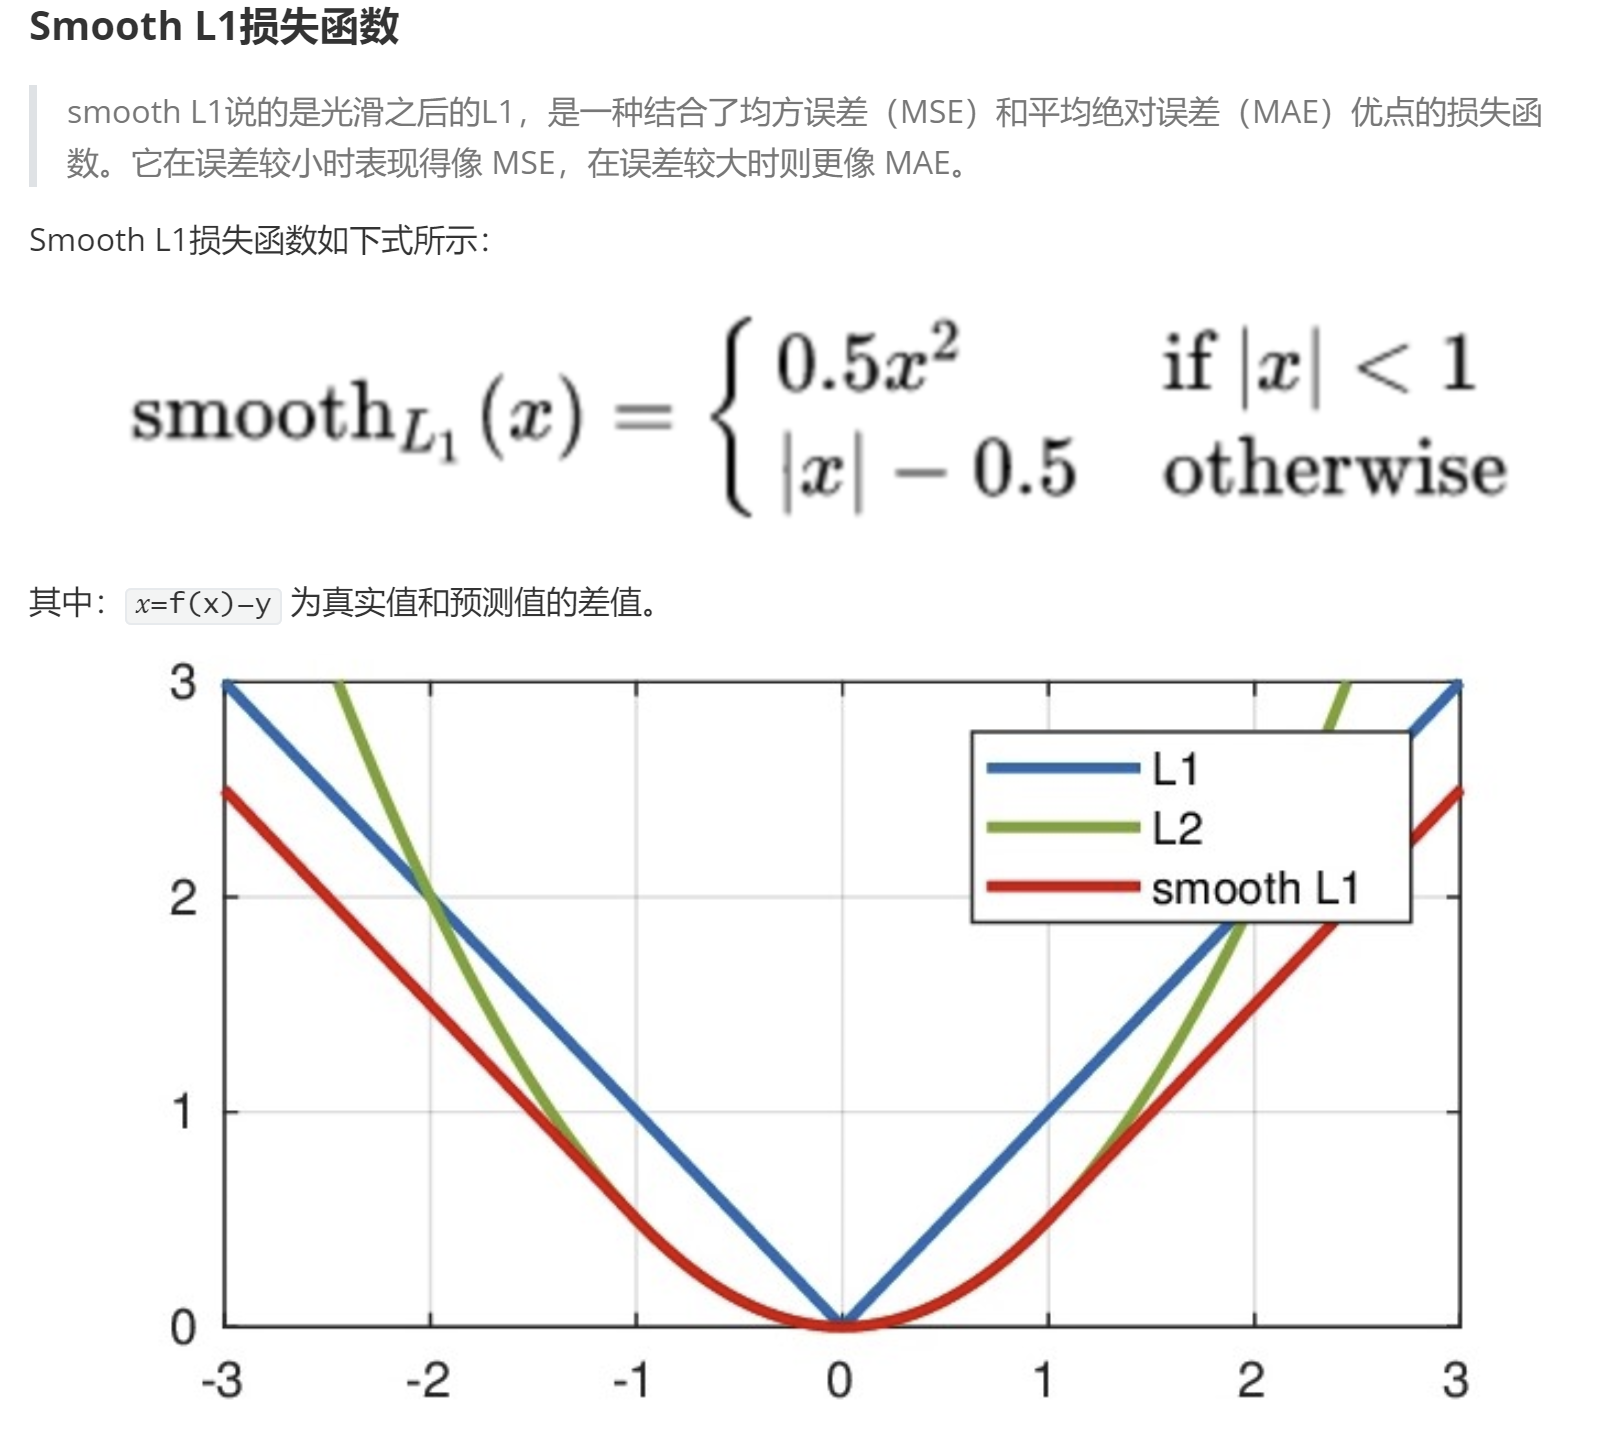
dm01()2. 回归任务:常用均方误差损失(MSE/L2)和平均绝对误差损失(MAE/L1)。MSE对异常值更敏感,L1更稳健。Smooth L1 Loss则结合了二者优点。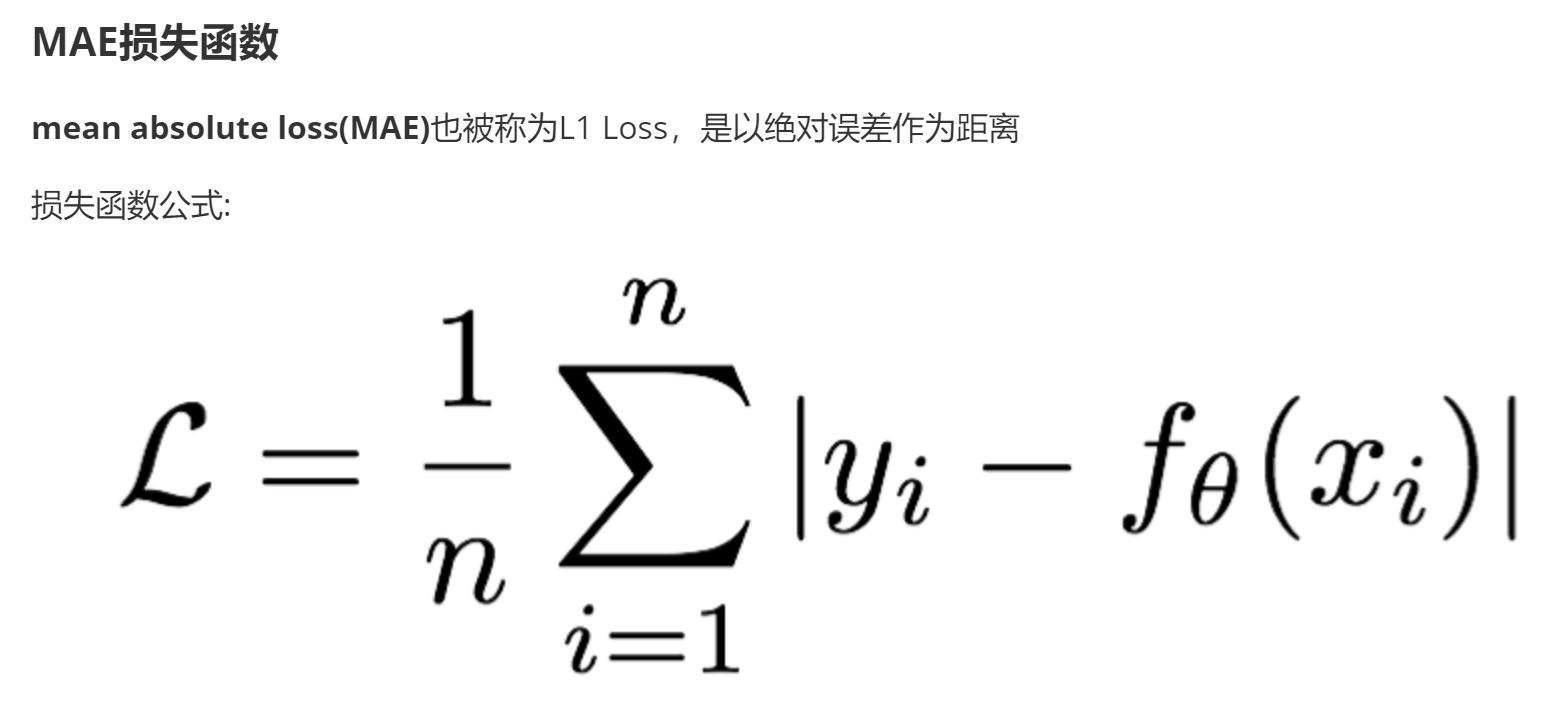
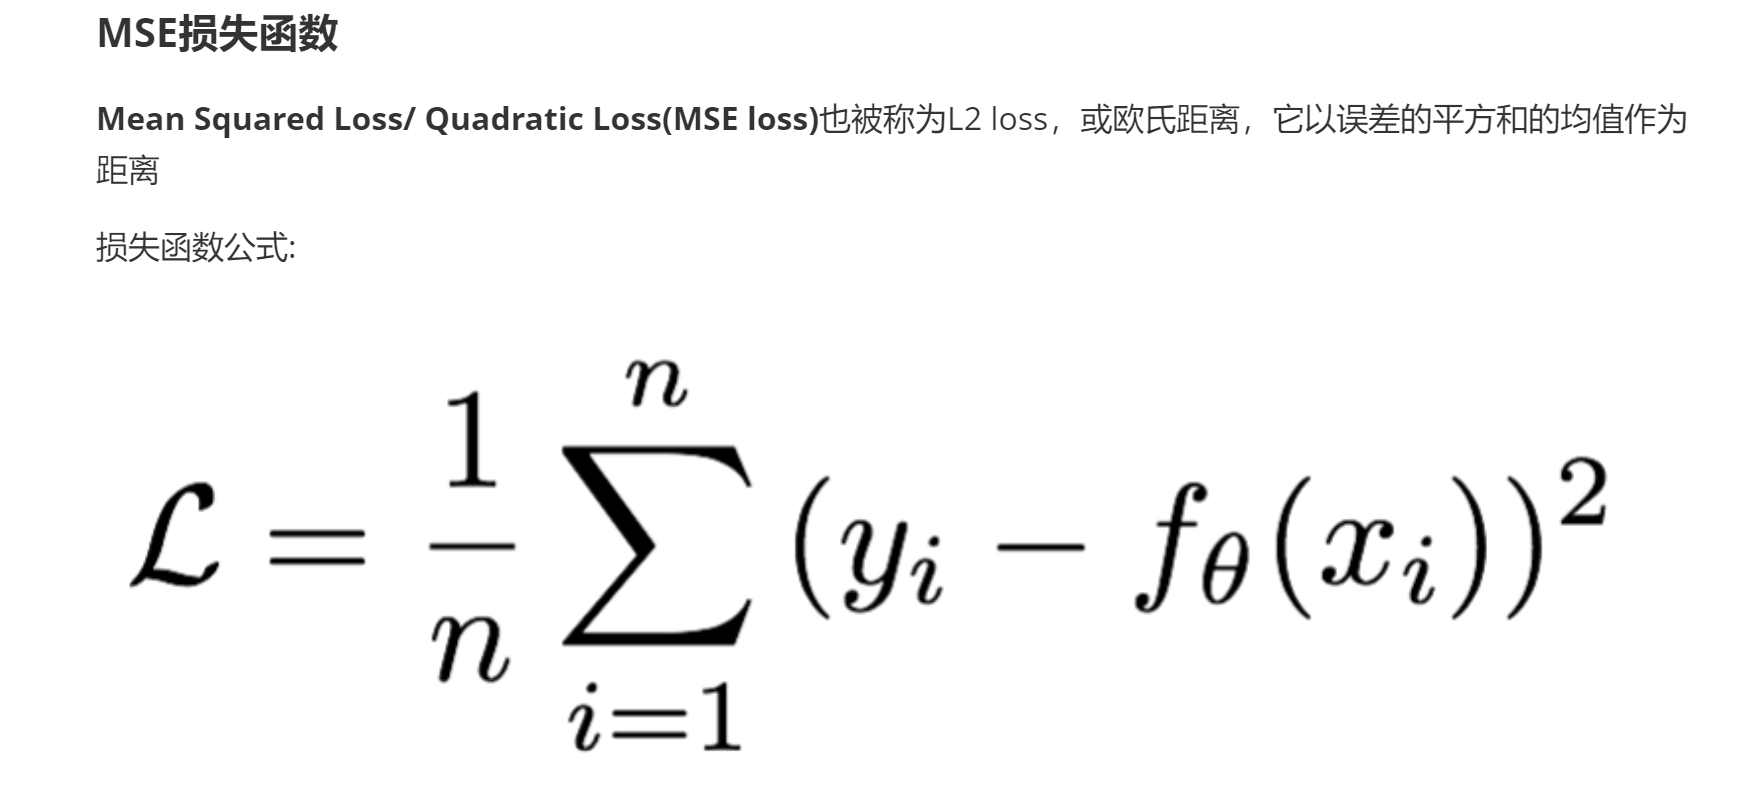
回归损失函数对比:
| 损失函数 | 特点 | 优点 | 缺点 | PyTorch实现 |
|---|---|---|---|---|
| MAE损失 | 平均绝对误差 | 对异常样本效果好,不会放大异常样本误差 L1正则化:特征筛选 | 0点不可导 | |
| MSE损失 | 均方误差 | 任意位置可导,loss越大导数越大 | 放大异常样本误差 L2正则化:权重接近0 | |
| Smooth L1损失 | MAE+MSE结合 | 任意位置可导 对异常样本效果好 无梯度爆炸,不易跳过最低点 | - |
实现示例:
"""
案例:
    演示 回归任务的损失函数介绍.
回归任务常用损失函数如下:
    MAE:   Mean Absolute Error, 平均绝对误差.
        公式:
            误差绝对值之和 / 样本总数
        类似于L1正则化, 权重可以降为0, 数据会变得稀疏.
        弊端:
            在0点不平滑(不可导), 可能错过最小值.
    MSE:   Mean Squared Error, 均方误差.
        公式:
            误差平方之和 / 样本总数
        弊端:
            如果差值过大, 可能存在梯度爆炸的情况.
    Smooth L1:
        就是基于MAE 和 MSE做的综合, 在 [-1, 1]是 L2(MSE), 其它段时L1.
        这样即解决了L1不平滑的问题(0点不可导, 可能错过最小值)
        又解决了L2(MSE)的 梯度爆炸的问题.
"""
# 导包
import torch
import torch.nn as nn
# 1. 定义函数, 演示: MAE 损失函数.
def dm01():
    # 1. 定义变量, 记录: 真实值.
    y_true = torch.tensor([2.0, 2.0, 2.0], dtype=torch.float)
    # 2. 定义变量, 记录: 预测值.
    y_pred = torch.tensor([1.0, 1.0, 1.9], requires_grad=True)
    # 3. 创建MAE损失函数对象.
    criterion = nn.L1Loss()
    # 4. 计算损失.
    loss = criterion(y_pred, y_true)
    # 5. 输出损失.
    print(f'MAE: {loss}')
# 2. 定义函数, 演示: MSE 损失函数.
def dm02():
    # 1. 定义变量, 记录: 真实值.
    y_true = torch.tensor([2.0, 2.0, 2.0], dtype=torch.float)
    # 2. 定义变量, 记录: 预测值.
    y_pred = torch.tensor([1.0, 1.0, 1.9], requires_grad=True)
    # 3. 创建MSE损失函数对象.
    criterion = nn.MSELoss()
    # 4. 计算损失.
    loss = criterion(y_pred, y_true)
    # 5. 输出损失.
    print(f'MSE: {loss}')
# 3. 定义函数, 演示: Smooth L1 损失函数.
def dm03():
    # 1. 定义变量, 记录: 真实值.
    y_true = torch.tensor([2.0, 2.0, 2.0], dtype=torch.float)
    # 2. 定义变量, 记录: 预测值.
    y_pred = torch.tensor([1.0, 1.0, 1.9], requires_grad=True)
    # 3. 创建Smooth L1损失函数对象.
    criterion = nn.SmoothL1Loss()
    # 4. 计算损失.
    loss = criterion(y_pred, y_true)
    # 5. 输出损失.
    print(f'Smooth L1: {loss}')
# 4. 测试
if __name__ == '__main__':
    # dm01()    # 0.699999988079071
    # dm02()    # 0.6700000166893005
dm03() # 0.33500000834465027定义了损失之后,我们需要优化器来执行参数更新。最基础的是梯度下降法:w₁ = w₀ - lr × grad
其中,\(\theta\)是参数,\(\eta\)是学习率,\(\nabla J(\theta)\)是梯度。根据使用数据量的不同,分为批量梯度下降、随机梯度下降和小批量梯度下降。
| 术语 | 含义 |
|---|---|
| epoch | 训练次数 |
| iteration | 每次训练需要迭代的次数 = 样本数/batch_size(向上取整) |
| batch_size | 每次迭代需要的样本数 |
现代深度学习更常使用自适应优化器,如Adam,它综合了动量法和自适应学习率的优点。各种优化器的对比如下:
| 优化方法 | 原理 | 特点 | 适用场景 |
|---|---|---|---|
| Momentum | St = β * St-1 + (1 - β) * Gt | 即使当前梯度为0,仍能参考历史梯度继续更新 | 通用 |
| Adagrad | St = St-1 + Gt * Gt 学习率 = 学习率 / (sqrt(St) + 小常数) | 自动调整学习率:前期大,后期小,可能导致学习率过早衰减 | 高维稀疏数据、文本数据 |
| RMSprop | St = β * St-1 + (1 - β) * Gt * Gt 学习率 = 学习率 / (sqrt(St) + 小常数) | 避免Adagrad学习率下降过快 | 高维稀疏数据、文本数据 |
| Adam | Momentum + RMSprop | 综合两者优点,优先选择 | 通用 |
优化器初始化示例:
"""
案例:
    演示 梯度下降优化方法.
梯度下降相关介绍:
    概述:
        梯度下降是结合 本次损失函数的导数(作为梯度) 基于学习率 来更新权重的.
    公式:
        W新 = W旧 - 学习率 * (本次的)梯度
    存在的问题:
        1. 遇到平缓区域, 梯度下降(权重更新)可能会慢.
        2. 可能会遇到 鞍点(梯度为0)
        3. 可能会遇到 局部最小值.
    解决思路:
        从上述的 学习率 或者 梯度入手, 进行优化, 于是有了: 动量法Momentum, 自适应学习率AdaGrad, RMSProp, 综合衡量: Adam
    动量法Momentum:
        动量法公式:
            St = β * St-1 + (1 - β) * Gt
        解释:
            St:     本次的指数移动加权平均结果.
            β:      调节权重系数, 越大, 数据越平缓, 历史指数移动加权平均 比重越大, 本次梯度权重越小.
            St-1:   历史的指数移动加权平均结果.
            Gt:     本次计算出的梯度(不考虑历史梯度).
        加入动量法后的 梯度更新公式:
            W新 = W旧 - 学习率 * St
    自适应学习率: AdaGrad(Adaptive Gradient Estimation)
        公式:
            累计平方梯度:
                St = St-1 + Gt * Gt
                解释:
                    St:     累计平方梯度
                    St-1:   历史累计平方梯度.
                    Gt:     本次的梯度.
            学习率:
                学习率 = 学习率 / (sqrt(St) + 小常数)
                解释:
                    小常数: 1e-10, 目的: 防止分母变为0
            梯度下降公式:
                W新 = W旧 - 调整后的学习率 * Gt
        缺点:
            可能会导致学习率过早, 过量的降低, 导致模型后期学习率太小, 较难找到最优解.
    自适应学习率: RMSProp(Root Mean Square Propagation) -> 可以看做是 对AdaGrad做的优化, 加入 调和权重系数.
        公式:
            指数加权平均 累计历史平方梯度:
                St = β * St-1 +  (1 - β) * Gt * Gt
                解释:
                    St:     累计平方梯度
                    St-1:   历史累计平方梯度.
                    Gt:     本次的梯度.
                    β:      调和权重系数.
            学习率:
                学习率 = 学习率 / (sqrt(St) + 小常数)
                解释:
                    小常数: 1e-10, 目的: 防止分母变为0
            梯度下降公式:
                W新 = W旧 - 调整后的学习率 * Gt
        优点:
           RMSProp通过引入 衰减系数β, 控制历史梯度 对 历史梯度信息获取的多少.
    自适应矩估计: Adam(Adaptive Moment Estimation)
        思路:
            即优化学习率, 又优化梯度.
        公式:
            一阶矩: 算均值.
                Mt = β1 * Mt-1 + (1 - β1) * Gt          充当: 梯度
                St = β2 * St-1 + (1 - β2) * Gt * Gt     充当: 学习率
            二阶矩: 梯度的方差.
                Mt^ = Mt / (1 - β1 ^ t)
                St^ = St / (1 - β2 ^ t)
            权重更新公式:
                W新 = W旧 - 学习率 / (sqrt(St^) + 小常数)  *  Mt^
        大白话翻译:
            Adam = RMSProp + Momentum
总结: 如何选择梯度下降优化方法
    简单任务和较小的模型:
        SGD, 动量法
    复杂任务或者有大量数据:
        Adam
    需要处理稀疏数据或者文本数据:
        AdaGrad, RMSProp
"""
# 导包
import torch
import torch.nn as nn
import torch.optim as optim
# 1. 定义函数, 演示: 梯度下降优化方法 -> 动量法(Momentum)
def dm01_momentum():
    # 1. 初始化权重参数.
    w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32)
    # 2. 定义损失函数
    criterion = ((w ** 2) / 2.0)
    # 3. 创建优化器(函数对象) -> 基于SGD(随机梯度下降), 加入参数 momentum, 就是 动量法.
    # 参1: (待优化的)参数列表, 参2: 学习率, 参3: 动量参数.
    optimizer = optim.SGD(params=[w], lr=0.01, momentum=0.9)  # 细节: momentum=0(默认), 只考虑: 本次梯度.
    # 4. 计算梯度值: 梯度清零 + 反向传播 + 参数更新
    optimizer.zero_grad()
    criterion.sum().backward()
    optimizer.step()
    print(f'w: {w}, w.grad: {w.grad}')
    # 5.重复上述的步骤, 第2次 更新权重参数.
    # 5.1 定义损失函数.
    criterion = ((w ** 2) / 2.0)
    # 5.2 计算梯度值: 梯度清零 + 反向传播 + 参数更新
    optimizer.zero_grad()
    criterion.sum().backward()
    optimizer.step()
    # 5.3 打印结果.
    print(f'w: {w}, w.grad: {w.grad}')
# 2. 定义函数, 演示: 梯度下降优化方法 -> 自适应学习率(AdaGrad)
def dm02_adagrad():
    # 1. 初始化权重参数.
    w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32)
    # 2. 定义损失函数
    criterion = ((w ** 2) / 2.0)
    # 3. 创建优化器(函数对象)
    # 思路1: 基于SGD(随机梯度下降), 加入参数 momentum, 就是 动量法.
    # 参1: (待优化的)参数列表, 参2: 学习率, 参3: 动量参数.
    # optimizer = optim.SGD(params=[w], lr=0.01, momentum=0.9)  # 细节: momentum=0(默认), 只考虑: 本次梯度.
    # 思路2: 基于AdaGrad(自适应学习率).
    optimizer = optim.Adagrad(params=[w], lr=0.01)
    # 4. 计算梯度值: 梯度清零 + 反向传播 + 参数更新
    optimizer.zero_grad()
    criterion.sum().backward()
    optimizer.step()
    print(f'w: {w}, w.grad: {w.grad}')
    # 5.重复上述的步骤, 第2次 更新权重参数.
    # 5.1 定义损失函数.
    criterion = ((w ** 2) / 2.0)
    # 5.2 计算梯度值: 梯度清零 + 反向传播 + 参数更新
    optimizer.zero_grad()
    criterion.sum().backward()
    optimizer.step()
    # 5.3 打印结果.
    print(f'w: {w}, w.grad: {w.grad}')
# 3. 定义函数, 演示: 梯度下降优化方法 -> 自适应学习率(RMSProp)
def dm03_rmsprop():
    # 1. 初始化权重参数.
    w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32)
    # 2. 定义损失函数
    criterion = ((w ** 2) / 2.0)
    # 3. 创建优化器(函数对象)
    # 思路1: 基于SGD(随机梯度下降), 加入参数 momentum, 就是 动量法.
    # 参1: (待优化的)参数列表, 参2: 学习率, 参3: 动量参数.
    # optimizer = optim.SGD(params=[w], lr=0.01, momentum=0.9)  # 细节: momentum=0(默认), 只考虑: 本次梯度.
    # 思路2: 基于AdaGrad(自适应学习率).
    # optimizer = optim.Adagrad(params=[w], lr=0.01)
    # 思路3: 基于RMSProp(自适应学习率).
    optimizer = optim.RMSprop(params=[w], lr=0.01, alpha=0.99)
    # 4. 计算梯度值: 梯度清零 + 反向传播 + 参数更新
    optimizer.zero_grad()
    criterion.sum().backward()
    optimizer.step()
    print(f'w: {w}, w.grad: {w.grad}')
    # 5.重复上述的步骤, 第2次 更新权重参数.
    # 5.1 定义损失函数.
    criterion = ((w ** 2) / 2.0)
    # 5.2 计算梯度值: 梯度清零 + 反向传播 + 参数更新
    optimizer.zero_grad()
    criterion.sum().backward()
    optimizer.step()
    # 5.3 打印结果.
    print(f'w: {w}, w.grad: {w.grad}')
# 4. 定义函数, 演示: 梯度下降优化方法 -> 自适应矩估计(Adam)
def dm04_adam():
    # 1. 初始化权重参数.
    w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32)
    # 2. 定义损失函数
    criterion = ((w ** 2) / 2.0)
    # 3. 创建优化器(函数对象)
    # 思路1: 基于SGD(随机梯度下降), 加入参数 momentum, 就是 动量法.
    # 参1: (待优化的)参数列表, 参2: 学习率, 参3: 动量参数.
    # optimizer = optim.SGD(params=[w], lr=0.01, momentum=0.9)  # 细节: momentum=0(默认), 只考虑: 本次梯度.
    # 思路2: 基于AdaGrad(自适应学习率).
    # optimizer = optim.Adagrad(params=[w], lr=0.01)
    # 思路3: 基于RMSProp(自适应学习率).
    # optimizer = optim.RMSprop(params=[w], lr=0.01, alpha=0.99)
    # 思路4: 基于Adam(自适应矩估计).
    optimizer = optim.Adam(params=[w], lr=0.01, betas=(0.9, 0.999)) # betas=(梯度用的 衰减系数, 学习率用的 衰减系数)
    # 4. 计算梯度值: 梯度清零 + 反向传播 + 参数更新
    optimizer.zero_grad()
    criterion.sum().backward()
    optimizer.step()
    print(f'w: {w}, w.grad: {w.grad}')
    # 5.重复上述的步骤, 第2次 更新权重参数.
    # 5.1 定义损失函数.
    criterion = ((w ** 2) / 2.0)
    # 5.2 计算梯度值: 梯度清零 + 反向传播 + 参数更新
    optimizer.zero_grad()
    criterion.sum().backward()
    optimizer.step()
    # 5.3 打印结果.
    print(f'w: {w}, w.grad: {w.grad}')
# 5. 测试
if __name__ == '__main__':
    dm01_momentum()
    # dm02_adagrad()
    # dm03_rmsprop()
    # dm04_adam()
⚙️ 反向传播(BP)与学习率:反向传播是计算损失函数对每一层参数梯度的核心算法,本质是链式法则的反复应用。学习率是训练中最关键的超参数之一,过大导致震荡,过小则收敛缓慢。采用学习率衰减策略(如StepLR、CosineAnnealingLR)能提升训练效果。
∂loss/∂w = (loss对a) × (a对z) × (z对w)
         = (损失对激活值) × (激活函数斜率) × (输入x)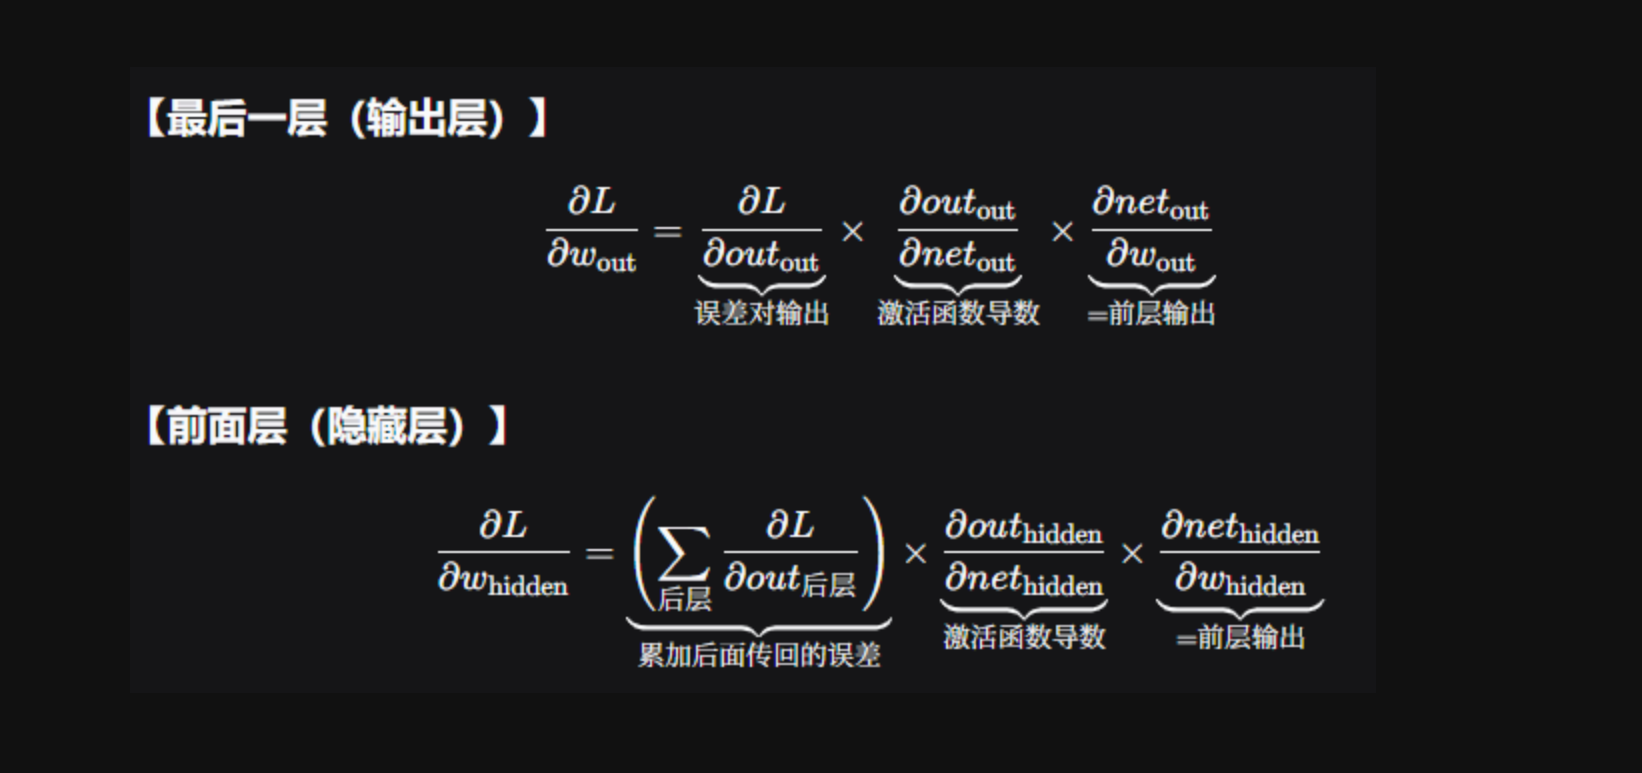
反向传播中的梯度计算流程:
| 层位置 | 核心公式 | 难点 |
|---|---|---|
| 输出层 | 梯度 = (输出误差) × (激活导数) × (前层输出) | 直接算,简单 |
| 隐藏层 | 梯度 = [累加后面所有路径的误差] × (激活导数) × (前层输出) | 需要逐层反向累加 |
学习率调度器示例:
学习率越小, 梯度下降越慢.
学习率越大, 梯度下降越快, 可能会越过最小值, 造成震荡, 甚至不收敛(梯度爆炸)
常见学习率衰减策略:
| 策略 | 公式 | 特点 | PyTorch实现 |
|---|---|---|---|
| 等间隔衰减 | 步长相等,学习率随训练次数减小 | ||
| 指定间隔衰减 | 自定义训练次数步长 | ||
| 指数衰减 | 前期减小快,后期减小慢 |
"""
案例:
    演示学习率衰减策略.
学习率衰减策略介绍:
    目的:
        较之于AdaGrad, RMSProp, Adam方式, 我们可以通过 等间隔, 指定间隔, 指数等方式, 来手动控制学习率的调整.
    分类:
        等间隔学习率衰减
        指定间隔学习率衰减
        指数学习率衰减
等间隔学习率衰减:
    step_size: 间隔的轮数, 即: 多少轮调整一次学习率.
    gamma:     学习率衰减系数, 即: lr新 = lr旧 * gamma
指定间隔学习率衰减:
    milestones = [50, 125, 160]     里边定义的是要调整学习率的 轮数.
    gamma:     学习率衰减系数, 即: lr新 = lr旧 * gamma
指数间隔学习率衰减:
    前期学习率衰减快, 中期慢, 后期更慢, 更符合梯度下降规律.
    公式:
        lr新 = lr旧 * gamma ** epoch
总结:
    等间隔学习率衰减:
        优点:
            直观, 易于调试, 适用于 大批量数据.
        缺点:
            学习率变化较大, 可能跳过最优解.
        应用场景:
            大型数据集, 较为简单的任务.
    指定间隔学习率衰减:
        优点:
            易于调试, 稳定训练过程.
        缺点:
            在某些情况下可能衰减过快, 导致优化提前停滞.
        应用场景:
            对应训练平稳性要求较高的任务.
   指数学习率衰减:
        优点:
            平滑, 且考虑历史更新, 收敛稳定性较强.
        缺点:
            超参调节较为复杂, 可能需要更多的资源.
        应用场景:
            高精度训练, 避免过快收敛.
"""
# 导包
import torch
from torch import optim
import matplotlib.pyplot as plt
# 1. 定义变量, 记录初始的 学习率, 训练的轮数, 每轮训练的批次数.
lr, epochs, iteration = 0.1, 200, 10
# 2. 创建数据集.  y_true, x, w
# 真实值.
y_true = torch.tensor([0])
# 输入特征
x = torch.tensor([1.0], dtype=torch.float32)
# 权重参数w, 需要自动微分(求导)
w = torch.tensor([1.0], requires_grad=True, dtype=torch.float32)
# 3. 创建优化器对象, 动量法 -> 加速模型的收敛, 减少震荡.
# 参1: 待优化的参数, 参2: 学习率, 参3: 动量系数
optimizer = optim.SGD([w], lr=lr, momentum=0.9)
# 4. 创建学习率衰减对象.
# 思路1: 创建等间隔学习率衰减对象.
# 参1: 优化器对象, 参2: 间隔的轮数(多少轮调整一次学习率), 参3: 学习率衰减系数.
# scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=50, gamma=0.5)   # [0.1, 0.1, 0.1... 0.05...]
# 定义变量, 记录要修改学习率的轮数.
# 思路1: 创建等间隔学习率衰减对象.
# scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=50, gamma=0.5)   # [0.1, 0.1, 0.1... 0.05...]
# 思路2: 创建指定间隔学习率衰减对象.
# milestones = [50, 125, 160]
# scheduler = optim.lr_scheduler.MultiStepLR(optimizer, milestones=milestones, gamma=0.5)
# 思路3: 创建指数衰减学习率对象.
scheduler = optim.lr_scheduler.ExponentialLR(optimizer, gamma=0.95)
# 5. 创建两个列表, 分别表示: 训练轮数, 每轮训练用的学习率
# epoch_list = [0, 1, 2, 3.... 50, 51, 52...100, 101, 101... 150, 151...199]
# lr_list =    [0.1, 0.1, 0.1, 0.05........,0.025.........,  0.0125...]
lr_list, epoch_list = [], []
# 6. 循环遍历训练轮数, 进行具体的训练.
for epoch in range(epochs):  # epoch: 0 ~ 199
    # 7. 获取当前轮数 和 学习率, 并保存到列表中.
    epoch_list.append(epoch)
    lr_list.append(scheduler.get_last_lr())  # 获取最后的lr(learning rate, 学习率)
    # 8. 循环遍历, 每轮每批次进行训练.
    for batch in range(iteration):
        # 9. 先计算预测值, 然后基于损失函数计算损失.
        y_pred = w * x
        # 10. 计算损失, 最小二乘法.
        loss = (y_pred - y_true) ** 2
        # 11. 梯度清零 + 反向传播 + 优化器更新参数.
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    # 12. 更新学习率.
    scheduler.step()
# 13. 打印结果:
print(f'lr_list: {lr_list}')  # [0.1, 0.1, 0.1..., 0.05........,0.025.........,  0.0125...]
# 14. 可视化.
# x轴: 训练的轮数, y轴: 每轮训练用的学习率
plt.plot(epoch_list, lr_list)
plt.xlabel('Epoch')
plt.ylabel('Learning Rate')
plt.show()
五、正则化技术:对抗过拟合的利器
当模型在训练集上表现优异,在未见过的测试集上却性能大跌时,就发生了过拟合。正则化技术是防止过拟合、提升模型泛化能力的关键。
✅ Dropout:在训练过程中,以一定概率\(p\)随机将隐藏层的神经元输出置零(“失活”)。这迫使网络不依赖于任何单个神经元,从而学习到更鲁棒的特征。测试时,所有神经元都参与预测,但输出要乘以\(1-p\)以保持期望值一致。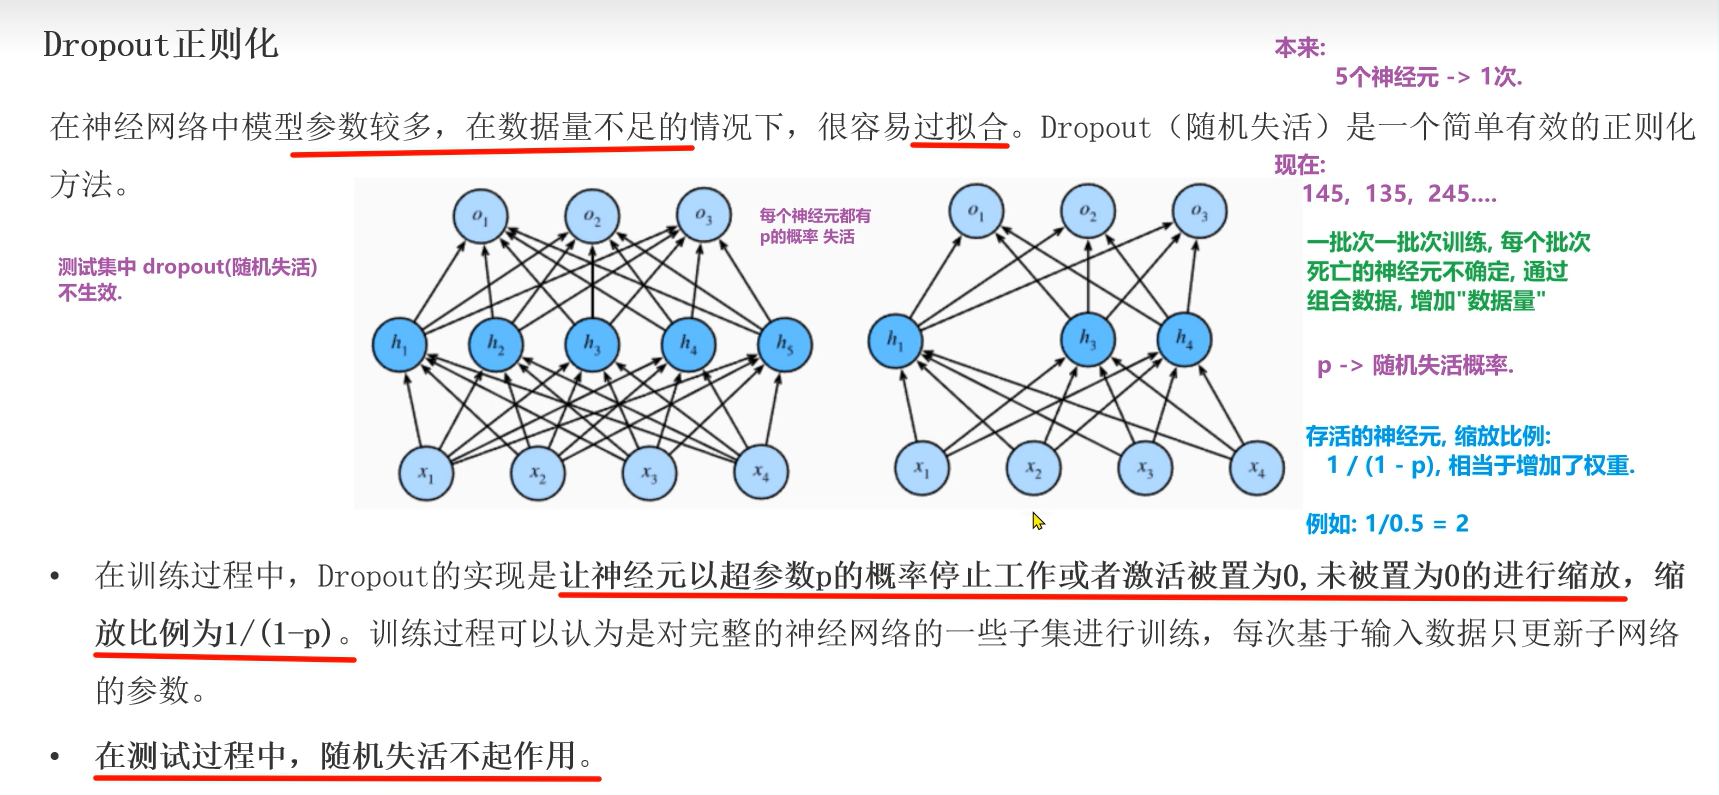
代码实现:
"""
案例:
    代码演示 随机失活.
正则化的作用:
    缓解模型的过拟合情况.
正则化的方式:
    L1正则化: 权重可以变为0, 相当于: 降维.
    L2正则化: 权重可以无限接近0
    DropOut: 随机失活, 每批次样本训练时, 随机让一部分神经元死亡, 防止一些特征对结果的影响较大(防止过拟合)
    BN(批量归一化): ...
"""
# 导包
import torch
import torch.nn as nn
# 1. 定义函数, 演示: 随机失活(DropOut)
def dm01():
    # 1. 创建隐藏层输出结果.
    t1 = torch.randint(0, 10, size=(3, 4)).float()
    print(f't1: {t1}')      # t1: tensor([[0., 5., 6., 3.]])
    # 2. 进行下一层 加权求和 和 激活函数计算.
    # 2.1 创建全连接层(充当线性层)
    # 参1: 输入特征维度, 参2: 输出特征维度.
    linear1 = nn.Linear(4, 5)
    # 2.2 加权求和.
    l1 = linear1(t1)
    print(f'l1: {l1}')
    # 2.3 激活函数.
    output = torch.relu(l1)
    print(f'output: {output}')
    # 3. 对激活值进行随机失活dropout处理 -> 只有训练阶段有, 测试阶段没有.
    dropout = nn.Dropout(p=0.5) # 每个神经元都有50%的概率被 kill.
    # 具体的 随机失活动作.
    d1 = dropout(output)
    print(f'd1(随机失活后的数据): {d1}')        # 未被失活的进行缩放, 缩放比例为: 1 / (1 - p) = 2
# 2. 测试
if __name__ == '__main__':
    dm01()
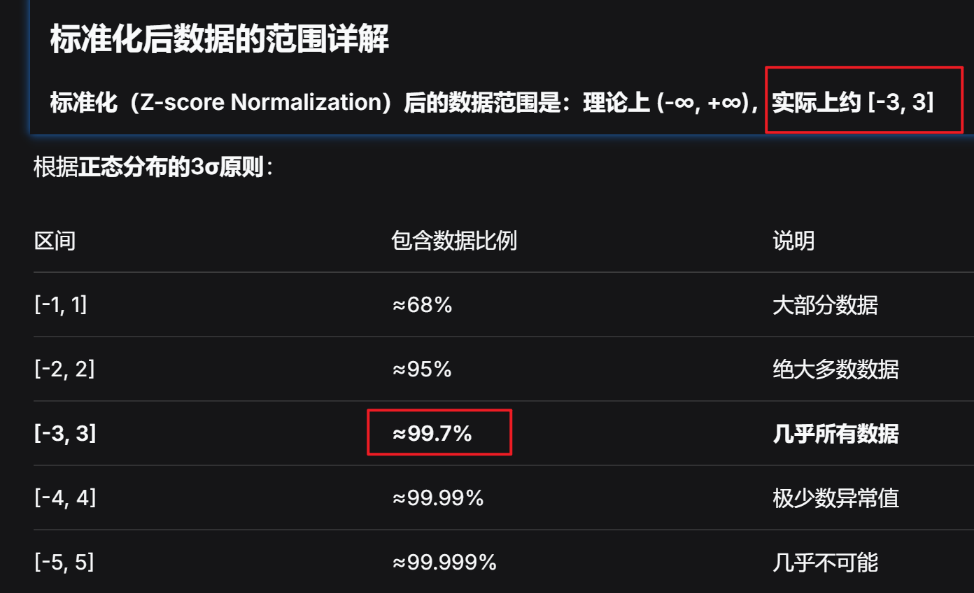
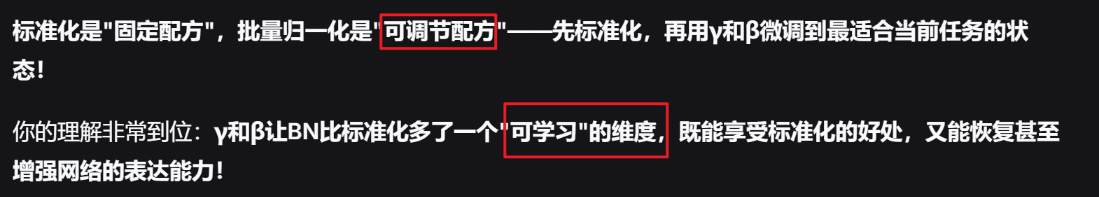
✅ 批量归一化(Batch Normalization, BN):BN通过对每一小批(batch)数据进行标准化(减均值、除标准差),并将结果进行缩放和平移重构,解决了“内部协变量偏移”问题。它允许使用更高的学习率,加速收敛,同时也有轻微的正则化效果。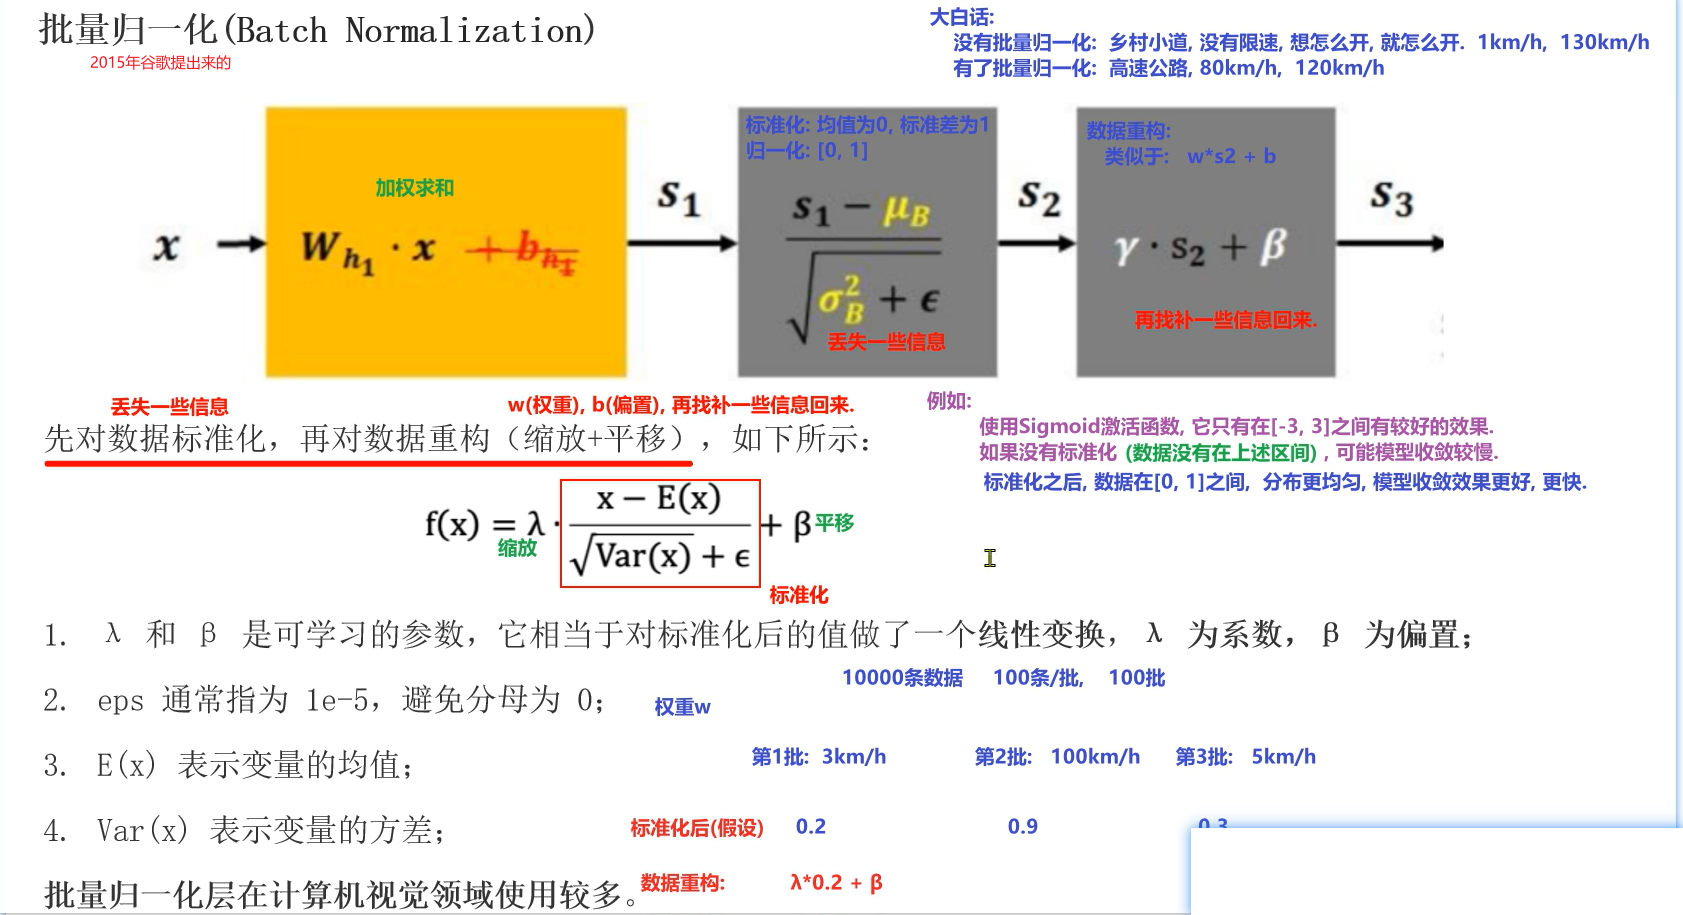
BN的计算过程:首先对数据进行标准化,然后进行重构。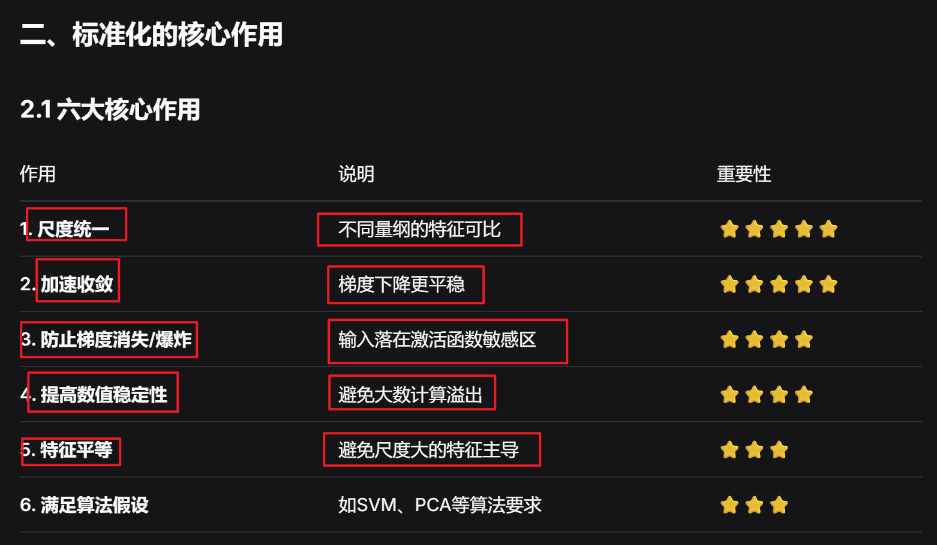
代码实现:
"""
案例:
    代码演示批量归一化,  它(批量归一化)也属于正则化的一种, 也是用于 缓解模型的 过拟合情况的.
批量归一化:
    思路:
        先对数据做标准化(会丢失一些信息), 然后再对数据做 缩放(λ, 理解为: w权重) 和 平移(β, 理解为: b偏置), 再找补回一些信息.
    应用场景:
        批量归一化在计算机视觉领域使用较多.
        BatchNorm1d:主要应用于全连接层或处理一维数据的网络,例如文本处理。它接收形状为 (N, num_features) 的张量作为输入。
        BatchNorm2d:主要应用于卷积神经网络,处理二维图像数据或特征图。它接收形状为 (N, C, H, W) 的张量作为输入。
        BatchNorm3d:主要用于三维卷积神经网络 (3D CNN),处理三维数据,例如视频或医学图像。它接收形状为 (N, C, D, H, W) 的张量作为输入。
"""
# 导包
import torch
import torch.nn as nn
# 1. 定义函数, 处理 二维数据.
def dm01():
    # 1. 创建图像样本数据.
    # 1张图片, 2个通道, 3行4列(像素点)
    input_2d = torch.randn(size=(1, 2, 3, 4))
    print(f'input_2d: {input_2d}')
    # 2. 创建批量归一化层(BN层)
    # 参1: 输入特征数 = 图片的通道数.
    # 参2: 噪声值(小常数), 默认为1e-5.
    # 参3: 动量值, 用于计算移动平均统计量的  动量值.
    # 参4: 表示使用可学习的变换参数(λ, β) 对归一化(标准化)后的数据进行 缩放和平移.
    bn2d = nn.BatchNorm2d(num_features=2, eps=1e-5, momentum=0.1, affine=True)
    # 3. 对数据进行 批量归一化处理.
    output_2d = bn2d(input_2d)
    print(f'output_2d: {output_2d}')
# 2. 定义函数, 处理: 一维数据.
def dm02():
    # 1. 创建样本数据.
    # 2行2列, 2条样本, 每个样本有2个特征
    input_1d = torch.randn(size=(2, 2))
    print(f'input_1d: {input_1d}')
    # 2. 创建线性层.
    linear1 = nn.Linear(2, 4)
    # 3. 对数据进行 线性变换.
    l1 = linear1(input_1d)
    print(f'l1: {l1}')
    # 4. 创建批量归一化层.
    bn1d = nn.BatchNorm1d(num_features=4)
    # 5. 对线性处理结果l1 进行 批量归一化处理.
    output_1d = bn1d(l1)
    print(f'output_1d: {output_1d}')
# 3. 测试
if __name__ == '__main__':
    # dm01()
dm02()六、总结与实战要点
掌握人工神经网络,需要理解其核心工作流程:前向传播计算预测值,损失函数评估误差,反向传播计算梯度,优化器更新参数。以下是关键要点与常见问题解决方案:
- 核心概念:神经元(线性+非线性)、网络层级结构、激活函数(隐藏层ReLU优先)、参数初始化(依激活函数选择)、优化器(Adam常用)。
- 常见问题:
- 梯度消失:使用ReLU、残差连接、合理的初始化。
- 梯度爆炸:梯度裁剪、合理的初始化、使用Smooth L1损失。
- 神经元死亡:使用Leaky ReLU,降低学习率。
- 过拟合:应用Dropout、BN、L2正则化、数据增强。
最后,让我们通过一个完整的ANN多分类实战案例,将上述所有知识点串联起来:
"""
案例:
    ANN(人工神经网络)案例: 手机价格分类案例.
背景:
    基于手机的20列特征 -> 预测手机的价格区间(4个区间), 可以用机器学习做, 也可以用 深度学习做(推荐)
ANN案例的实现步骤:
    1. 构建数据集.
    2. 搭建神经网络.
    3. 模型训练.
    4. 模型测试.
优化思路:
    1. 优化方法从 SGD -> Adam
    2. 学习率从 0.001 -> 0.0001
    3. 对数据进行标准化.
    4. 增加网络的深度, 每层的神经元数量
    5. 调整训练的轮数
    6. ......
"""
import torch
import torch.nn as nn
import pandas as pd
from sklearn.model_selection import train_test_split
from torch.utils.data import TensorDataset
from torch.utils.data import DataLoader
import torch.optim as optim
import numpy as np
import time
from sklearn.preprocessing import StandardScaler
# 构建数据集
def create_dataset():
	# 使用pandas读取数据
	data = pd.read_csv('./data/手机价格预测.csv')
	# 特征值和目标值
	x, y = data.iloc[:, :-1], data.iloc[:, -1]
	# 类型转换:特征值,目标值
	x = x.astype(np.float32)
	y = y.astype(np.int64)
	# 数据集划分
	x_train, x_valid, y_train, y_valid = train_test_split(x, y, train_size=0.8, random_state=88, stratify=y)
	# 优化①:数据标准化
	transfer = StandardScaler()
	x_train = transfer.fit_transform(x_train)
	x_valid = transfer.transform(x_valid)
	# 构建数据集,转换为pytorch的形式
	train_dataset = TensorDataset(torch.from_numpy(x_train), torch.tensor(y_train.values))
	valid_dataset = TensorDataset(torch.from_numpy(x_valid), torch.tensor(y_valid.values))
	# 返回结果
	return train_dataset, valid_dataset, x_train.shape[1], len(np.unique(y))
# 构建网络模型
class PhonePriceModel(nn.Module):
	def __init__(self, input_dim, output_dim):
		super(PhonePriceModel, self).__init__()
		# 优化②:增加网络深度
		# 1. 第一层: 输入为维度为 20, 输出维度为: 128
		self.linear1 = nn.Linear(input_dim, 128)
		# 2. 第二层: 输入为维度为 128, 输出维度为: 256
		self.linear2 = nn.Linear(128, 256)
		# 3. 第三层: 输入为维度为 256, 输出维度为: 512
		self.linear3 = nn.Linear(256, 512)
		# 4. 第四层: 输入为维度为 512, 输出维度为: 128
		self.linear4 = nn.Linear(512, 128)
		# 5. 输出层: 输入为维度为 128, 输出维度为: 4
		self.linear5 = nn.Linear(128, output_dim)
	def forward(self, x):
		# 前向传播过程
		x = torch.relu(self.linear1(x))
		x = torch.relu(self.linear2(x))
		x = torch.relu(self.linear3(x))
		x = torch.relu(self.linear4(x))
		# 后续CrossEntropyLoss损失函数中包含softmax过程, 所以当前步骤不进行softmax操作
		output = self.linear5(x)
		# 获取数据结果
		return output
# 编写训练函数
def train(train_dataset, input_dim, class_num):
	# 固定随机数种子
	torch.manual_seed(0)
	# 初始化数据加载器
	dataloader = DataLoader(train_dataset, shuffle=True, batch_size=8)
	# 初始化模型
	model = PhonePriceModel(input_dim, class_num)
	# 损失函数 CrossEntropyLoss = softmax + 损失计算
	criterion = nn.CrossEntropyLoss()
	# 优化③:使用Adam优化方法, 优化④:学习率变为1e-4
	optimizer = optim.Adam(model.parameters(), lr=1e-4)
	# 遍历每个轮次的数据
	num_epoch = 50
	for epoch_idx in range(num_epoch):
		# 训练时间
		start = time.time()
		# 计算损失
		total_loss = 0.0
		total_num = 0
		# 遍历每个batch数据进行处理
		for x, y in dataloader:
			model.train()
			output = model(x)
			# 计算损失
			loss = criterion(output, y)
			# 梯度清零
			optimizer.zero_grad()
			# 反向传播
			loss.backward()
			# 参数更新
			optimizer.step()
			# 损失计算
			total_num += len(y)
			total_loss += loss.item() * len(y)
		# 打印损失变换结果
		print('epoch: %4s loss: %.2f, time: %.2fs' %
			  (epoch_idx + 1, total_loss / total_num, time.time() - start))
	# 模型保存
	torch.save(model.state_dict(), './model/phone-price-model2.pth')
def evaluate(valid_dataset, input_dim, class_num):
	# 加载模型和训练好的网络参数
	model = PhonePriceModel(input_dim, class_num)
	# load_state_dict:将加载的参数字典应用到模型上
	# load:加载用来保存模型参数的文件
	model.load_state_dict(torch.load('./model/phone-price-model2.pth'))
	# 构建加载器
	dataloader = DataLoader(valid_dataset, batch_size=8, shuffle=False)
	# 评估测试集
	correct = 0
	# 遍历测试集中的数据
	for x, y in dataloader:
		# 将其送入网络中
		# model.eval()
		output = model(x)
		# 获取预测类别结果
		y_pred = torch.argmax(output, dim=1)
		# 获取预测正确的个数
		correct += (y_pred == y).sum()
	# 求预测精度
	print('Acc: %.5f' % (correct / len(valid_dataset)))
if __name__ == '__main__':
    # 创建数据集
	train_dataset, valid_dataset, input_dim, class_num = create_dataset()
    # 创建神经网络模型
    # model = PhonePriceModel(input_dim, output_dim)
    # summary(model, input_size=(16, input_dim))
    # model训练
	train(train_dataset, input_dim, class_num)
    # 模型测试
evaluate(valid_dataset, input_dim, class_num)人工神经网络是通往更复杂AI模型(如CNN、RNN、Transformer)的必经之路。理解其基本原理和组件间的相互作用,是你在深度学习和机器学习领域深入探索的坚实第一步。持续实践,不断调优,你就能驾驭这一强大工具,解决真实的业务与科研难题。
nn.CrossEntropyLoss(reduction='mean')nn.BCELoss(reduction='mean')nn.L1Loss()nn.MSELoss()nn.SmoothL1Loss()lr = lr × gammaStepLR(optimizer, step_size=50, gamma=0.5)lr = lr × gammaMultiStepLR(optimizer, milestones=[50,100,160], gamma=0.5)lr = lr × gamma^epochExponentialLR(optimizer, gamma=0.9)


 浙公网安备 33010602011771号