在工业物联网与后端架构中,时序数据处理常面临数据孤岛与处理链冗长的挑战。Apache IoTDB的SELECT INTO语句,通过将查询结果直接写入新序列,实现了数据库内部的轻量级ETL与物化视图功能,极大地简化了数据处理流程,提升了微服务数据层的自治能力。
一、SELECT INTO:时序数据的“查询即存储”引擎
传统数据处理流程中,原始数据往往需要经过外部ETL工具清洗、转换后才能存入分析库,链路长且复杂。Apache IoTDB的INTO子句创新性地将这一过程内化。其核心价值在于:在数据库内部完成“查询-转换-存储”的闭环,无需数据导出,降低了系统复杂度与网络开销。这对于构建高性能、自治的后端数据服务至关重要,尤其适用于实时监控、设备管理等场景。
主要应用场景包括:
- 内部ETL:对原始时序数据进行过滤、计算、聚合后,将结果持久化到新序列。
- 查询结果物化:将复杂或高频查询的结果固化存储,起到类似物化视图的作用,加速后续查询。
- 序列结构转换:将非对齐序列的数据迁移到对齐序列中,优化存储与查询性能。
上图直观展示了SELECT INTO在数据处理链路中的核心作用。
二、语法精讲:从基础到对齐模式
SELECT INTO语句的基本语法结构如下,其核心在于INTO子句与查询结果集的映射关系:
selectIntoStatement
: SELECT
resultColumn [, resultColumn] ...
INTO intoItem [, intoItem] ...
FROM prefixPath [, prefixPath] ...
[WHERE whereCondition]
[GROUP BY groupByTimeClause, groupByLevelClause]
[FILL {PREVIOUS | LINEAR | constant}]
[LIMIT rowLimit OFFSET rowOffset]
[ALIGN BY DEVICE]
;
intoItem
: [ALIGNED] intoDevicePath '(' intoMeasurementName [',' intoMeasurementName]* ')'
;INTO子句由多个intoItem构成,每个intoItem指定一个目标设备及其下的多个物理量(测点)。关键在于,目标序列必须与查询结果集的列一一对应。根据查询是否使用ALIGN BY DEVICE,对应规则分为两种模式:
1. 按时间对齐(默认模式)
此模式下,查询结果按时间戳横向排列。所有intoItem中定义的目标序列总数,必须等于查询结果的列数(排除时间列),并按从左到右的顺序严格对应。
示例:将原始数据库root.sg中四个序列的数据,写入到备份库root.sg_copy的指定序列中。
IoTDB> select s1, s2 into root.sg_copy.d1(t1), root.sg_copy.d2(t1, t2), root.sg_copy.d1(t2) from root.sg.d1, root.sg.d2;
+--------------+-------------------+--------+
| source column|  target timeseries| written|
+--------------+-------------------+--------+
| root.sg.d1.s1| root.sg_copy.d1.t1|    8000|
+--------------+-------------------+--------+
| root.sg.d2.s1| root.sg_copy.d2.t1|   10000|
+--------------+-------------------+--------+
| root.sg.d1.s2| root.sg_copy.d2.t2|   12000|
+--------------+-------------------+--------+
| root.sg.d2.s2| root.sg_copy.d1.t2|   10000|
+--------------+-------------------+--------+
Total line number = 4
It costs 0.725s
source column 列表示查询结果的列名
target timeseries 表示对应列写入的目标序列
written 表示预期写入的数据量
聚合查询的结果同样可以写回,这为构建预聚合指标层提供了便利:
IoTDB> select count(s1 + s2), last_value(s2) into root.agg.count(s1_add_s2), root.agg.last_value(s2) from root.sg.d1 group by ([0, 100), 10ms);
+--------------------------------------+-------------------------+--------+
|                         source column|        target timeseries| written|
+--------------------------------------+-------------------------+--------+
|  count(root.sg.d1.s1 + root.sg.d1.s2)| root.agg.count.s1_add_s2|      10|
+--------------------------------------+-------------------------+--------+
|             last_value(root.sg.d1.s2)|   root.agg.last_value.s2|      10|
+--------------------------------------+-------------------------+--------+
Total line number = 2
It costs 0.375s
2. 按设备对齐(ALIGN BY DEVICE)
当查询使用ALIGN BY DEVICE时,结果集会按设备纵向组织。此时,intoItem的数量必须与查询匹配的设备数一致,每个设备对应一个intoItem,且每个intoItem内的目标物理量数需与结果列数(排除时间、设备列)对应。
示例:按设备进行数据备份。
IoTDB> select s1, s2 into root.sg_copy.d1(t1, t2), root.sg_copy.d2(t1, t2) from root.sg.d1, root.sg.d2 align by device;
+--------------+--------------+-------------------+--------+
| source device| source column|  target timeseries| written|
+--------------+--------------+-------------------+--------+
|    root.sg.d1|            s1| root.sg_copy.d1.t1|    8000|
+--------------+--------------+-------------------+--------+
|    root.sg.d1|            s2| root.sg_copy.d1.t2|   11000|
+--------------+--------------+-------------------+--------+
|    root.sg.d2|            s1| root.sg_copy.d2.t1|   12000|
+--------------+--------------+-------------------+--------+
|    root.sg.d2|            s2| root.sg_copy.d2.t2|    9000|
+--------------+--------------+-------------------+--------+
Total line number = 4
It costs 0.625s
对于包含表达式计算的查询,按设备对齐的写回同样适用:
IoTDB> select s1 + s2 into root.expr.add(d1s1_d1s2), root.expr.add(d2s1_d2s2) from root.sg.d1, root.sg.d2 align by device;
+--------------+--------------+------------------------+--------+
| source device| source column|       target timeseries| written|
+--------------+--------------+------------------------+--------+
|    root.sg.d1|       s1 + s2| root.expr.add.d1s1_d1s2|   10000|
+--------------+--------------+------------------------+--------+
|    root.sg.d2|       s1 + s2| root.expr.add.d2s1_d2s2|   10000|
+--------------+--------------+------------------------+--------+
Total line number = 2
It costs 0.532s
三、变量占位符:大幅简化批量操作
当需要处理大量序列时,手动编写每个目标路径极其繁琐。IoTDB提供了变量占位符功能,能根据源序列路径动态生成目标路径,极大提升了语句的简洁性与可维护性。
- 后缀复制符
:::复制查询设备或物理量的后缀。例如,root.backup::表示目标设备从root.backup开始,后续层级与源设备相同。 - 单层节点匹配符
${i}:表示目标路径当前层节点名与查询序列路径的第i层节点名相同。例如,对于路径root.sg.d1.s1,${2}代表d1。
⚠️ 注意:占位符的使用模式(目标设备/物理量是否使用)与查询是否包含聚合、表达式计算紧密相关,需遵循特定规则以避免歧义。
按时间对齐下的占位符用例
用例1:目标设备固定,物理量名根据源物理量动态生成。
select s1, s2
into root.sg_copy.d1(::), root.sg_copy.d2(s1), root.sg_copy.d1(${3}), root.sg_copy.d2(::)
from root.sg.d1, root.sg.d2;
上述语句等价于:
select s1, s2
into root.sg_copy.d1(s1), root.sg_copy.d2(s1), root.sg_copy.d1(s2), root.sg_copy.d2(s2)
from root.sg.d1, root.sg.d2;用例2:目标设备根据占位符动态生成,物理量名固定指定。
select d1.s1, d1.s2, d2.s3, d3.s4
into ::(s1_1, s2_2), root.sg.d2_2(s3_3), root.${2}_copy.::(s4)
from root.sg;用例3:设备与物理量均使用占位符,实现完整路径的复制与迁移。
select * into root.sg_bk.::(::) from root.sg.**;按设备对齐下的占位符用例
在按设备对齐模式下,占位符的使用规则略有不同,需特别注意。
用例:为每个源设备下的物理量备份,并在物理量名前增加前缀。
select * into ::(backup_${4}) from root.sg.** align by device;四、高级特性与实战应用场景
1. 指定对齐写入
可以通过ALIGNED关键词,精确控制目标设备的写入方式(对齐或非对齐),这对于优化存储和查询性能至关重要。
select s1, s2 into root.sg_copy.d1(t1, t2), aligned root.sg_copy.d2(t1, t2) from root.sg.d1, root.sg.d2 align by device;2. 实现数据库内部ETL
结合IoTDB的内置函数或用户自定义函数(UDF),可以在写回过程中完成复杂的数据清洗与转换,实现真正的库内ETL。[AFFILIATE_SLOT_1]
IOTDB > SELECT preprocess_udf(s1, s2) INTO ::(preprocessed_s1, preprocessed_s2) FROM root.sg.* ALIGN BY DEIVCE;
+--------------+-------------------+---------------------------+--------+
| source device|      source column|          target timeseries| written|
+--------------+-------------------+---------------------------+--------+
|    root.sg.d1| preprocess_udf(s1)| root.sg.d1.preprocessed_s1|    8000|
+--------------+-------------------+---------------------------+--------+
|    root.sg.d1| preprocess_udf(s2)| root.sg.d1.preprocessed_s2|   10000|
+--------------+-------------------+---------------------------+--------+
|    root.sg.d2| preprocess_udf(s1)| root.sg.d2.preprocessed_s1|   11000|
+--------------+-------------------+---------------------------+--------+
|    root.sg.d2| preprocess_udf(s2)| root.sg.d2.preprocessed_s2|    9000|
+--------------+-------------------+---------------------------+--------+
3. 构建物化视图
将耗时较长的聚合查询(如按小时、天聚合)结果持久化存储,后续查询可直接读取结果,极大提升报表和分析性能。
IOTDB > SELECT count(s1), last_value(s1) INTO root.sg.agg_${2}(count_s1, last_value_s1) FROM root.sg1.d1 GROUP BY ([0, 10000), 10ms);
+--------------------------+-----------------------------+--------+
|             source column|            target timeseries| written|
+--------------------------+-----------------------------+--------+
|      count(root.sg.d1.s1)|      root.sg.agg_d1.count_s1|    1000|
+--------------------------+-----------------------------+--------+
| last_value(root.sg.d1.s2)| root.sg.agg_d1.last_value_s2|    1000|
+--------------------------+-----------------------------+--------+
Total line number = 2
It costs 0.115s
4. 非对齐序列转对齐序列
这是数据模型优化的关键步骤。将历史非对齐数据迁移到对齐序列,可以充分利用对齐序列的存储和查询优势。⚠️ 注意:对于大数据量迁移,建议使用WHERE时间过滤或LIMIT/OFFSET进行分批操作。
IOTDB > SELECT s1, s2 INTO ALIGNED root.sg1.aligned_d(s1, s2) FROM root.sg1.non_aligned_d WHERE time >= 0 and time < 10000;
+--------------------------+----------------------+--------+
|             source column|     target timeseries| written|
+--------------------------+----------------------+--------+
| root.sg1.non_aligned_d.s1| root.sg1.aligned_d.s1|   10000|
+--------------------------+----------------------+--------+
| root.sg1.non_aligned_d.s2| root.sg1.aligned_d.s2|   10000|
+--------------------------+----------------------+--------+
Total line number = 2
It costs 0.375s
对于一般的聚合查询,时间戳是无意义的,约定使用 0 来存储
当目标序列存在时,需要保证源序列和目标时间序列的数据类型兼容
当目标序列不存在时,系统将自动创建目标序列(包括 database)
当查询的序列不存在或查询的序列不存在数据,则不会自动创建目标序列
五、权限、配置与性能考量
执行SELECT INTO语句的用户需要具备相应的权限:
所有 SELECT 子句中源序列的 WRITE_SCHEMA 权限
所有 INTO 子句中目标序列 WRITE_DATA 权限
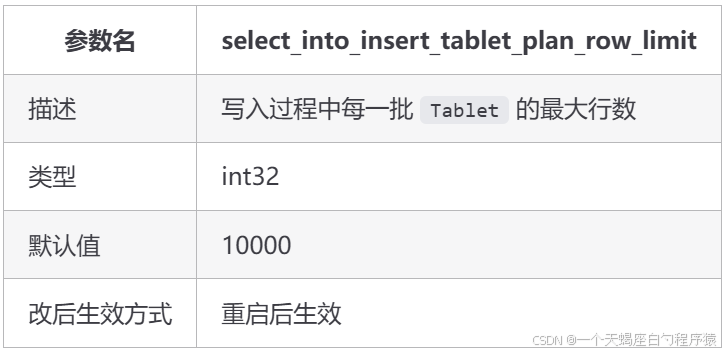
此外,关键的配置参数select_into_insert_tablet_plan_row_limit控制着单次写入的数据块大小,合理调整此参数有助于平衡内存使用与写入性能。
总结
Apache IoTDB的SELECT INTO子句是一项强大而灵活的特性,它将数据处理逻辑从应用层下沉到数据库层。通过“查询即存储”的模式,它不仅简化了后端架构中数据管道的复杂度,还通过物化视图、内部ETL等能力,显著提升了数据服务的响应速度与自治性。掌握其语法细节、占位符技巧以及应用场景,对于构建高效、可靠的物联网后端微服务与数据中间件具有重要意义。[AFFILIATE_SLOT_2]


 浙公网安备 33010602011771号