当软件从执行确定性的指令,转向理解并生成不确定性的内容,传统的工程方法便遭遇了前所未有的挑战。本文旨在探讨大模型时代下,软件工程如何从追求“确定性交付”的CI/CD范式,演进为应对“概率性智能”的CC/CD(持续校准/持续开发)新范式,为构建可靠、可信的AI应用提供清晰的路线图。
确定性假设的崩塌:传统工程范式的四大盲区
传统的软件工程,无论是瀑布模型还是敏捷DevOps,都建立在一个核心假设之上:系统行为是确定的。然而,当大语言模型(LLM)这类概率性、涌现性的智能体成为系统核心时,这一基石便动摇了。直接将CI/CD套用于AI应用开发,会暴露出四个根本性盲区:
- 非确定性输入:自然语言交互带来了近乎无限的表达方式,无法穷举所有可能的用户输入进行测试。
- 非确定性输出:模型输出对提示词极其敏感,且内部推理过程是黑箱,无法保证相同输入产生相同输出。
- 代理权与控制权的权衡:赋予AI自主决策权意味着让渡人类控制权,这需要渐进式地建立信任,而非一步到位。
- 评估的语义扩散:“评估”一词的含义变得模糊,从模型基准测试到应用行为验证,我们需要重新定义AI应用的质量保障体系。
Air Canada客服智能体“幻觉”出不存在政策的案例,正是这种范式失效的典型体现。它警示我们,必须放弃“全自动驾驶”的幻想,转而寻求一种渐进、可控的演进路径。[AFFILIATE_SLOT_1]
范式革命:CC/CD(持续校准/持续开发)的核心框架
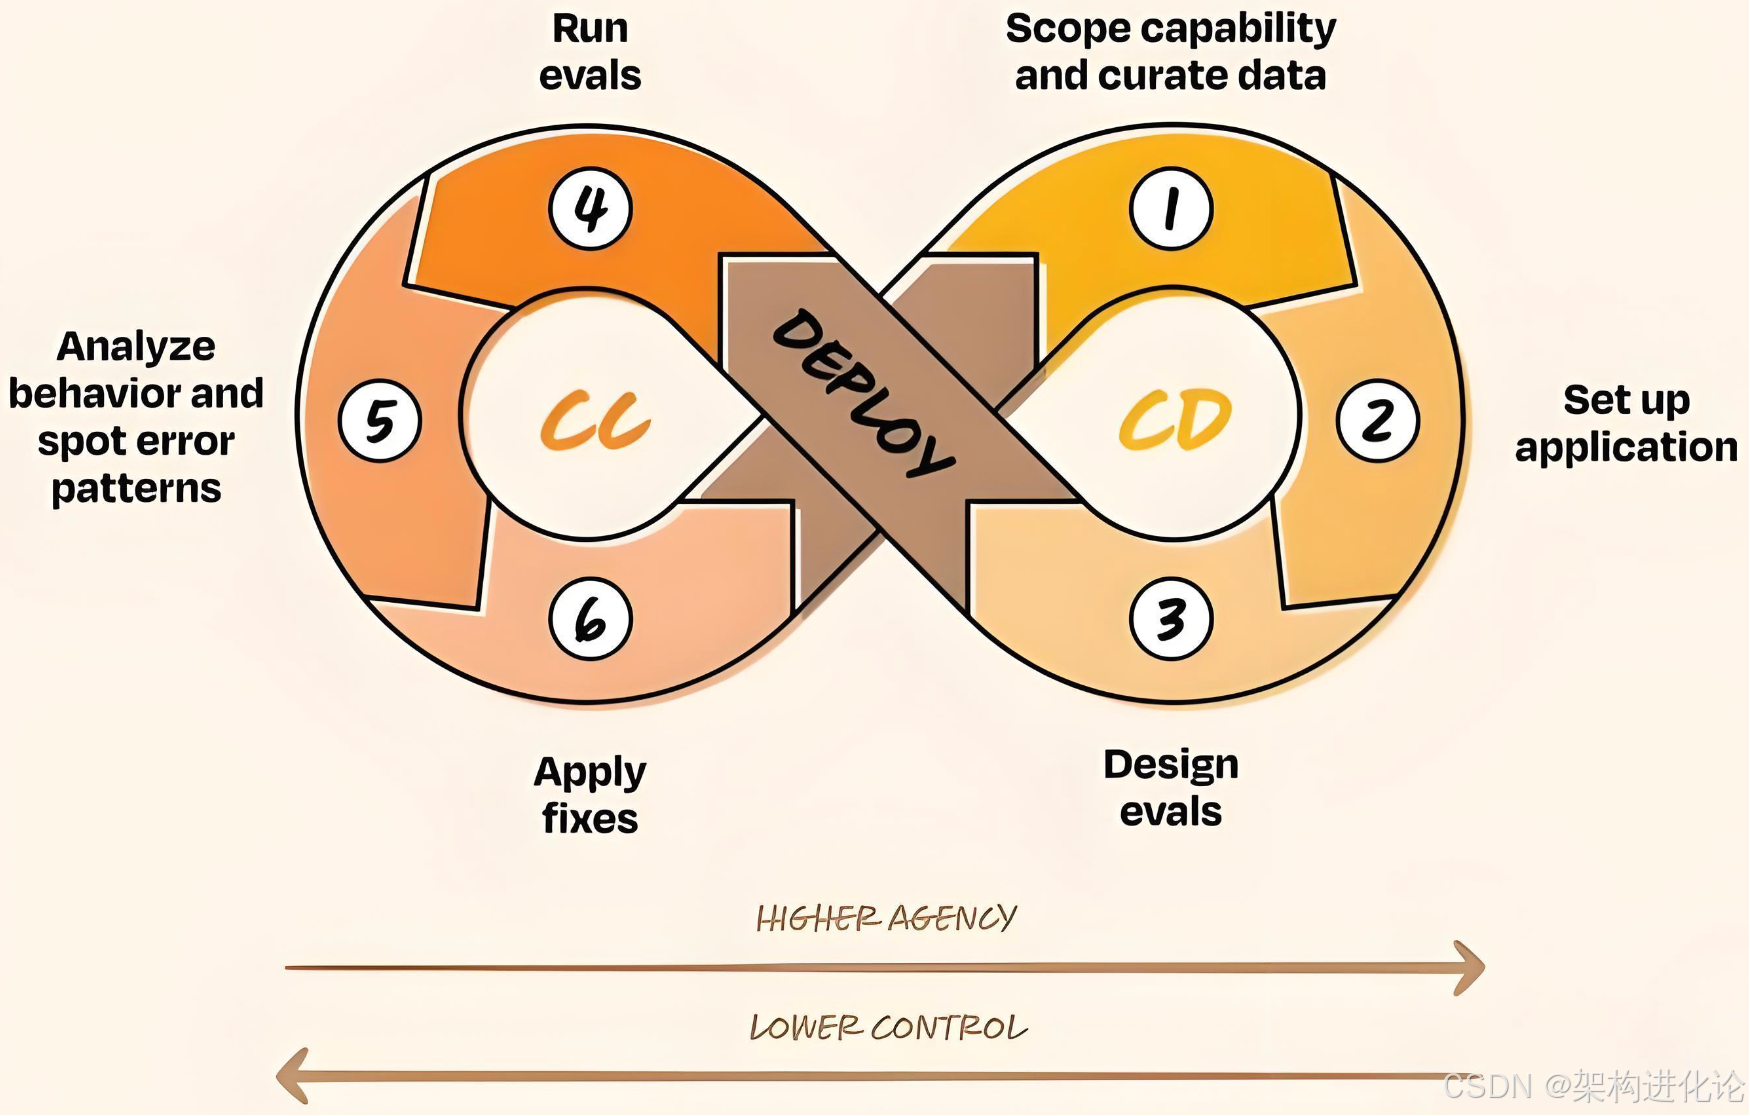
为应对上述挑战,一种新的工程范式应运而生:Continuous Calibration/Continuous Development(CC/CD)。它并非替代CI/CD,而是其在概率系统时代的必要延伸与重构。
Continuous Calibration/Continuous Development是一种专为大模型驱动的软件系统设计的工程范式,它以“渐进式自主化”为核心原则,通过持续的行为校准与能力开发的循环迭代,在保障用户体验和信任的前提下,逐步提升系统的智能程度与自主决策能力。
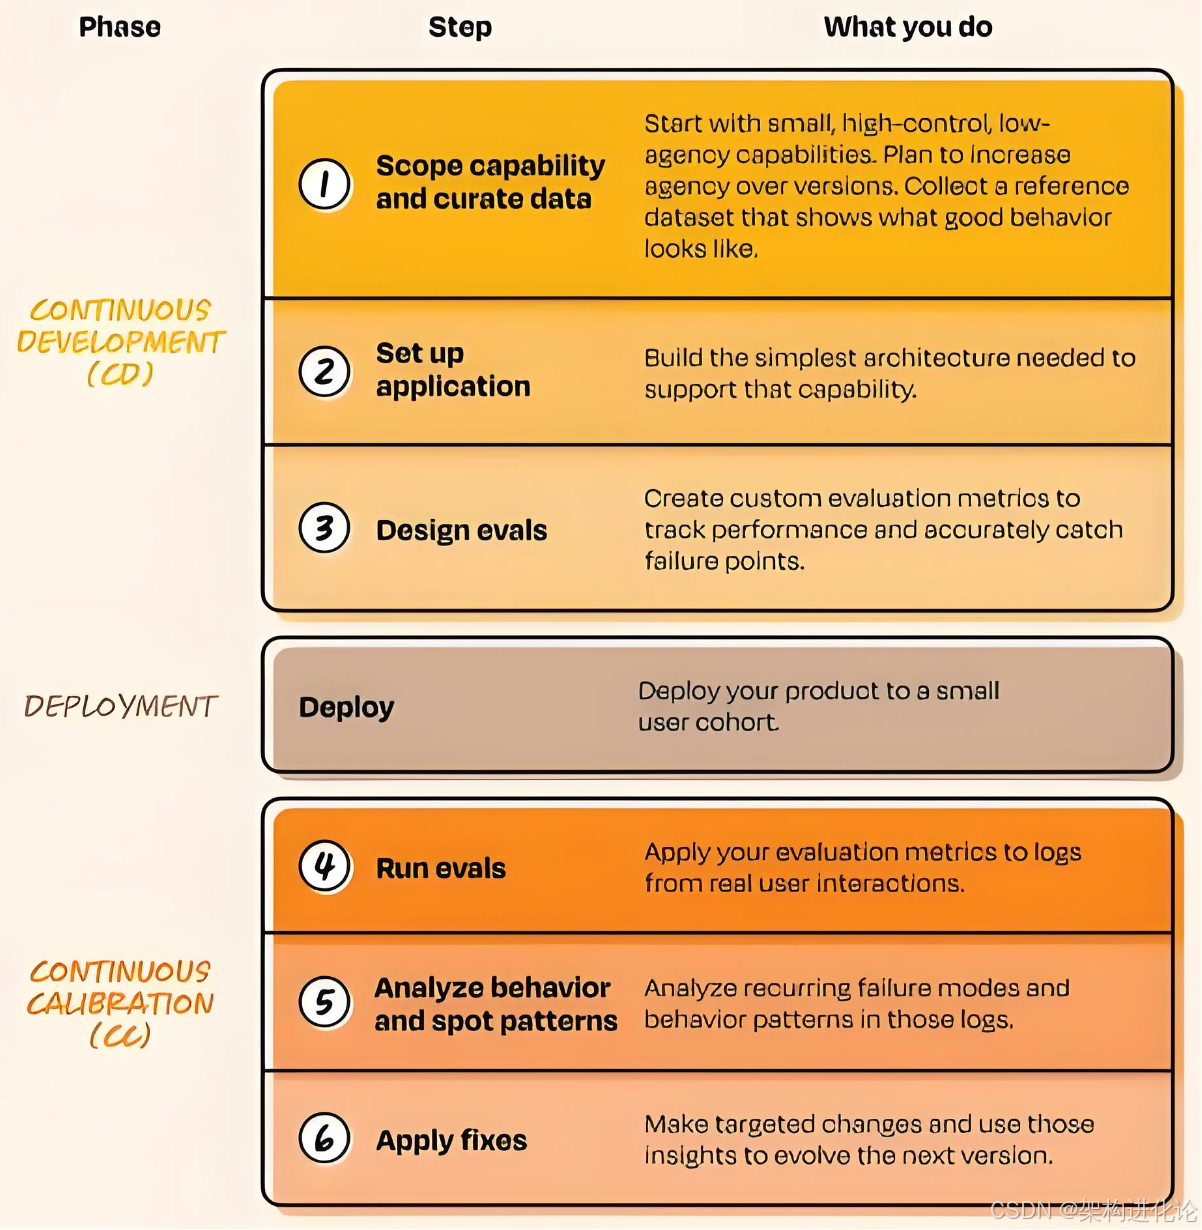
这一范式包含两个紧密耦合的核心阶段,形成一个闭环:
- 持续开发:界定能力范围,构建初始数据集与评估指标,搭建基础设施,产出的是一个受控环境下的最小可行智能系统。
- 持续校准:在生产环境中观测系统涌现行为,识别新型错误模式,基于真实反馈扩展评估指标,产出的是对系统行为边界的深入理解和驱动下一轮开发的优化信号。
渐进式自主化:从“学车”到“自动驾驶”的演进逻辑
理解CC/CD的最佳类比是自动驾驶的研发过程。传统CI/CD如同驾校考试,在标准场地通过预设项目即获认证。但真实道路充满未知。CC/CD则像渐进式自动驾驶研发:
- V1(人类完全控制):系统仅提供预警(如工单路由),人类全权负责决策。
- V2(辅助驾驶):系统可执行部分任务(如生成回复草稿),但需人类全程监控并随时接管。
- V3(有条件自主):系统在多数场景下自主运行,仅在复杂情况请求人类干预。
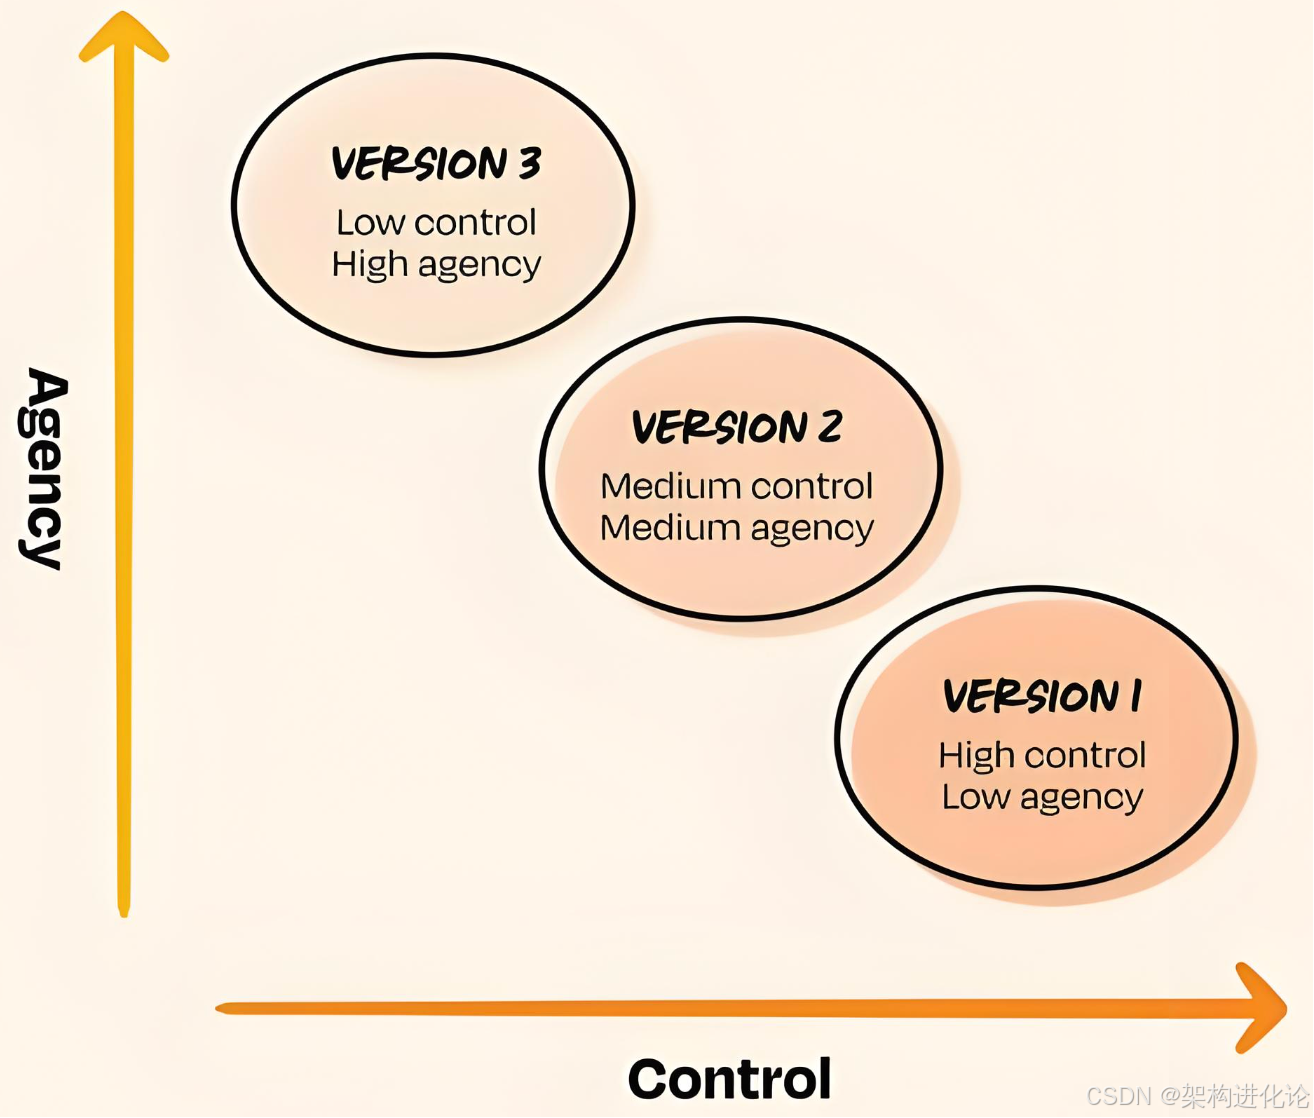
这一演进的核心逻辑是:自主权的每一次提升,都必须基于前一阶段积累的“信任证据”。系统必须在当前边界内反复证明其可靠性,才能获得更多权限。这彻底改变了产品演进路径——从功能堆叠变为信任建立。
双C协同:从评估到监测的反馈飞轮
CC/CD框架的精妙之处在于“持续开发”与“持续校准”之间形成的反馈闭环。其核心洞见在于:评估(Evals)只能捕捉已知的错误,而生产监测(Monitoring)才能发现未知的失败模式。
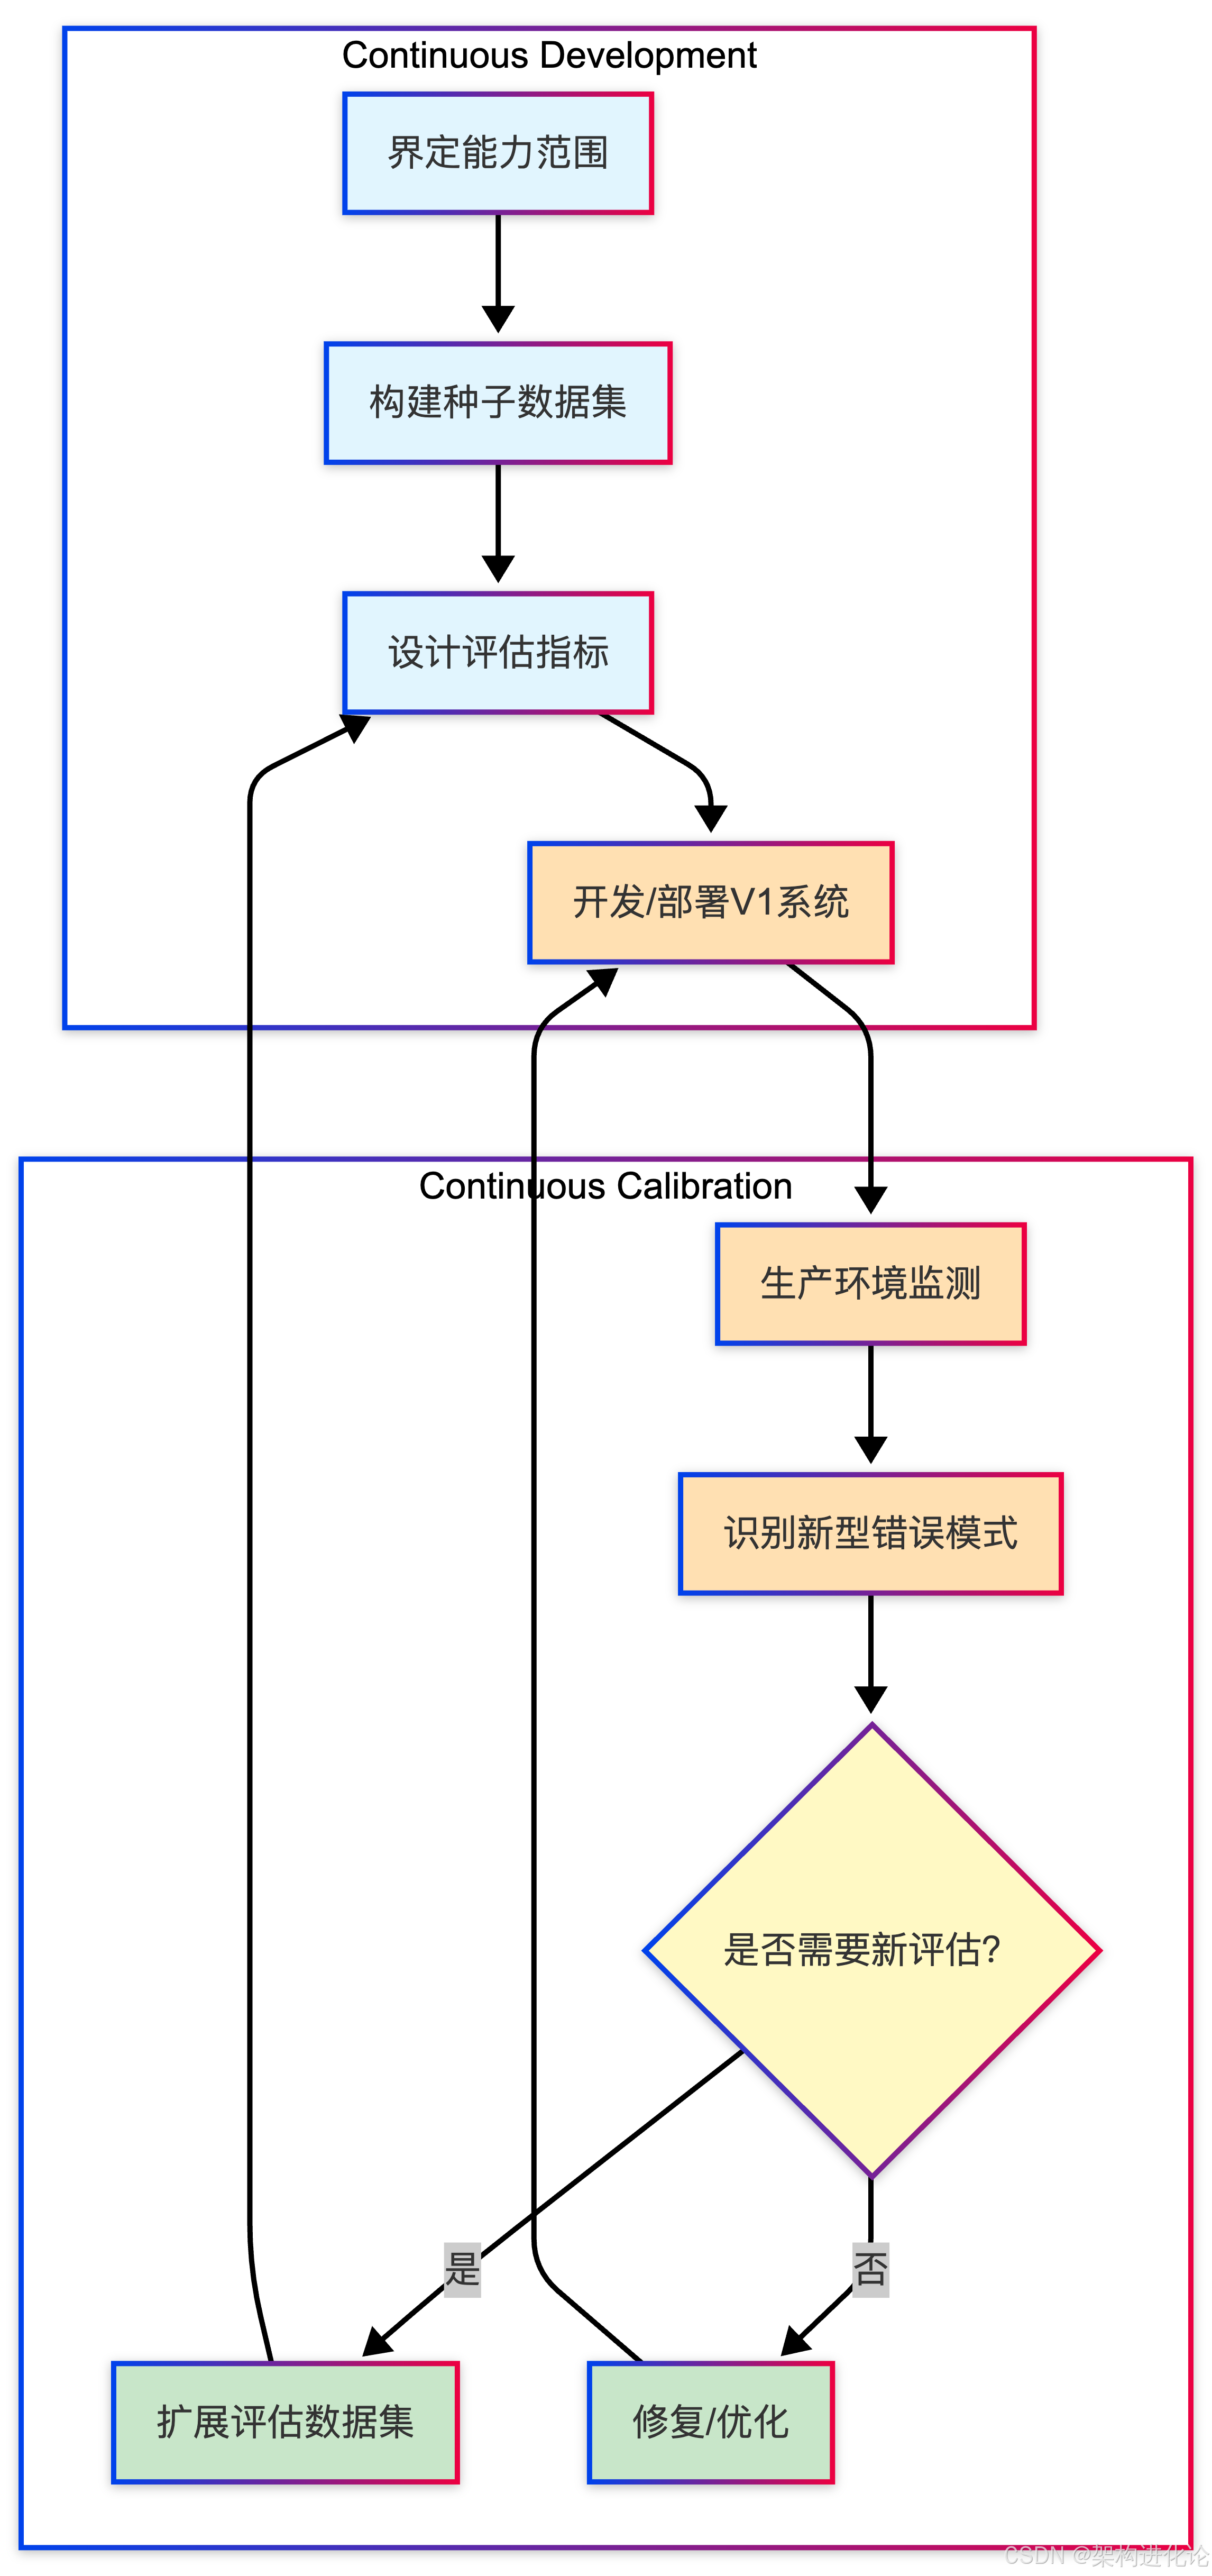
评估集编码了团队对系统的“已知期望”,是产品知识的固化。生产监测则捕获真实用户行为,包括显式反馈(点赞/点踩)和隐式信号(要求重新生成)。当监测发现新的系统性失败模式时,该模式就会被纳入评估集,防止未来回归。这个“生产发现 → 评估扩展 → 开发优化”的循环,构成了系统持续进化的动力源泉。
技术深潜:CC/CD落地的核心能力建设
将理念转化为实践,需要构建一系列新型技术能力,核心围绕评估、监测与知识管理。
1. 评估数据集的演化管理
在CC/CD中,评估数据集是“活资产”,需要持续演化。其管理策略如下:
# eval_dataset_evolution.py
"""
评估数据集演化管理 - 展示评估集如何基于生产发现持续扩展
"""
import json
import hashlib
from datetime import datetime
from typing import List, Dict, Optional
from dataclasses import dataclass, field
@dataclass
class TestCase:
    """测试用例 - 评估数据集的基本单元"""
    id: str
    input: str
    expected_output: str
    task_type: str
    added_at: datetime
    added_reason: str  # 为什么添加这个用例(初始设计/生产发现/回归预防)
    tags: List[str] = field(default_factory=list)
    def __post_init__(self):
        if not self.id:
            content = f"{self.input}{self.expected_output}{self.added_at}"
            self.id = hashlib.md5(content.encode()).hexdigest()[:8]
class EvaluationDataset:
    """评估数据集 - 支持版本化和演化追踪"""
    def __init__(self, name: str, version: str = "1.0.0"):
        self.name = name
        self.version = version
        self.test_cases: Dict[str, TestCase] = {}
        self.version_history: List[Dict] = []
        self._record_version("initial_creation")
    def add_test_case(self, test_case: TestCase):
        """添加新的测试用例"""
        self.test_cases[test_case.id] = test_case
        print(f"[数据集演化] 添加测试用例: {test_case.id}")
        print(f"  输入: {test_case.input[:50]}...")
        print(f"  原因: {test_case.added_reason}")
    def add_from_production_failure(self,
                                   user_input: str,
                                   failure_description: str,
                                   corrected_output: str,
                                   task_type: str):
        """基于生产失败案例添加测试用例"""
        test_case = TestCase(
            id="",
            input=user_input,
            expected_output=corrected_output,
            task_type=task_type,
            added_at=datetime.now(),
            added_reason=f"生产发现: {failure_description}",
            tags=["from_production", "regression_prevention"]
        )
        self.add_test_case(test_case)
    def _record_version(self, reason: str):
        """记录数据集版本变更"""
        self.version_history.append({
            "version": self.version,
            "timestamp": datetime.now().isoformat(),
            "reason": reason,
            "test_case_count": len(self.test_cases)
        })
    def save_version(self, reason: str):
        """保存当前版本(模拟版本控制)"""
        # 实际实现中,这里会将数据集保存到存储,并更新版本号
        new_version = self._bump_version()
        self._record_version(reason)
        print(f"\n[数据集演化] 新版本已保存: {new_version}")
        print(f"  原因: {reason}")
        print(f"  测试用例数: {len(self.test_cases)}")
    def _bump_version(self) -> str:
        """递增版本号(简化实现)"""
        major, minor, patch = self.version.split(".")
        new_patch = int(patch) + 1
        self.version = f"{major}.{minor}.{new_patch}"
        return self.version
    def analyze_coverage(self) -> Dict:
        """分析数据集覆盖情况"""
        task_types = {}
        added_reasons = {}
        for case in self.test_cases.values():
            # 按任务类型统计
            task_types[case.task_type] = task_types.get(case.task_type, 0) + 1
            # 按添加原因统计
            added_reasons[case.added_reason] = added_reasons.get(case.added_reason, 0) + 1
        return {
            "total_cases": len(self.test_cases),
            "by_task_type": task_types,
            "by_reason": added_reasons,
            "version": self.version
        }
# 使用示例
def eval_dataset_demo():
    # 创建初始评估集
    dataset = EvaluationDataset("客服意图识别", "1.0.0")
    # 初始设计阶段添加的用例
    dataset.add_test_case(TestCase(
        id="",
        input="我的订单什么时候到?",
        expected_output="查询订单",
        task_type="intent_classification",
        added_at=datetime.now(),
        added_reason="初始设计-常见用户问题"
    ))
    dataset.add_test_case(TestCase(
        id="",
        input="我要退货,衣服尺码不对",
        expected_output="申请售后",
        task_type="intent_classification",
        added_at=datetime.now(),
        added_reason="初始设计-常见用户问题"
    ))
    # 保存初始版本
    dataset.save_version("初始设计完成")
    # 模拟生产环境发现的失败案例
    production_failures = [
        {
            "input": "你们客服电话多少",
            "failure": "模型回复'客服电话可在官网查询',用户非常不满",
            "corrected": "咨询联系方式",
            "task": "intent_classification"
        },
        {
            "input": "我上周买的那双鞋能换颜色吗",
            "failure": "模型意图识别为'查询订单',实际应为'申请售后'",
            "corrected": "申请售后",
            "task": "intent_classification"
        }
    ]
    for failure in production_failures:
        dataset.add_from_production_failure(
            user_input=failure["input"],
            failure_description=failure["failure"],
            corrected_output=failure["corrected"],
            task_type=failure["task"]
        )
    # 保存新版本
    dataset.save_version("基于生产失败案例扩展")
    # 分析覆盖情况
    coverage = dataset.analyze_coverage()
    print("\n[数据集覆盖分析]")
    print(f"总用例数: {coverage['total_cases']}")
    print("按任务类型:", coverage['by_task_type'])
    print("按添加原因:", coverage['by_reason'])
# 运行示例
eval_dataset_demo()
2. 生产监测与错误模式识别
生产监测系统需像敏锐的传感器,不仅能收集数据,更要能自动识别新型错误模式:
# production_monitoring.py
"""
生产监测系统 - 识别新型错误模式并触发校准
"""
from datetime import datetime, timedelta
from typing import List, Dict, Optional
from dataclasses import dataclass
import random
from collections import Counter
@dataclass
class InteractionLog:
    """用户交互日志"""
    timestamp: datetime
    user_input: str
    model_output: str
    user_feedback: Optional[int]  # 1-5分,None表示无反馈
    regenerated: bool  # 用户是否要求重新生成
    task_type: str
    latency_ms: int
    session_id: str
class ErrorPatternDetector:
    """错误模式检测器 - 从日志中发现新型错误"""
    def __init__(self, lookback_hours: int = 24):
        self.lookback = timedelta(hours=lookback_hours)
        self.logs: List[InteractionLog] = []
        self.known_patterns: Dict[str, Dict] = {}  # 已识别的模式
        self.alert_threshold = 5  # 同一模式出现5次触发告警
    def add_log(self, log: InteractionLog):
        """添加新的交互日志"""
        self.logs.append(log)
    def analyze_recent(self) -> List[Dict]:
        """分析近期日志,识别错误模式"""
        cutoff = datetime.now() - self.lookback
        recent = [log for log in self.logs if log.timestamp >= cutoff]
        # 识别负面信号
        negative_logs = [
            log for log in recent
            if (log.user_feedback and log.user_feedback <= 2) or log.regenerated
        ]
        if len(negative_logs) < self.alert_threshold:
            return []
        # 聚类分析(简化版:按输入模式聚类)
        patterns = self._cluster_by_input_pattern(negative_logs)
        # 过滤掉已知模式
        new_patterns = []
        for pattern in patterns:
            pattern_id = self._generate_pattern_id(pattern)
            if pattern_id not in self.known_patterns:
                pattern["id"] = pattern_id
                pattern["first_seen"] = datetime.now()
                pattern["occurrence_count"] = pattern["logs_count"]
                new_patterns.append(pattern)
                self.known_patterns[pattern_id] = pattern
        return new_patterns
    def _cluster_by_input_pattern(self, logs: List[InteractionLog]) -> List[Dict]:
        """按输入模式聚类(简化实现)"""
        # 实际应用中,这里会使用文本聚类算法
        # 这里模拟返回两个聚类结果
        clusters = [
            {
                "pattern_description": "用户询问联系方式",
                "keywords": ["电话", "客服", "联系", "人工"],
                "logs_count": 3,
                "sample_input": "你们客服电话多少",
                "typical_output": "客服电话可在官网查询",
                "error_type": "信息缺失"
            },
            {
                "pattern_description": "用户表达不满时回复生硬",
                "keywords": ["投诉", "差评", "生气", "不满"],
                "logs_count": 4,
                "sample_input": "你们服务太差了,我要投诉",
                "typical_output": "已记录您的投诉,将转交相关部门",
                "error_type": "情感不匹配"
            }
        ]
        return clusters
    def _generate_pattern_id(self, pattern: Dict) -> str:
        """生成模式唯一ID"""
        content = f"{pattern['pattern_description']}{pattern['error_type']}"
        import hashlib
        return hashlib.md5(content.encode()).hexdigest()[:8]
class CalibrationTrigger:
    """校准触发器 - 基于错误模式触发校准流程"""
    def __init__(self, detector: ErrorPatternDetector):
        self.detector = detector
        self.calibration_events = []
    def run_periodic_check(self):
        """周期性检查并触发校准"""
        print(f"\n[校准检查] {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
        new_patterns = self.detector.analyze_recent()
        if not new_patterns:
            print("  未发现新型错误模式")
            return
        print(f"  发现 {len(new_patterns)} 个新型错误模式")
        for pattern in new_patterns:
            self._trigger_calibration(pattern)
    def _trigger_calibration(self, pattern: Dict):
        """触发校准流程"""
        event = {
            "timestamp": datetime.now(),
            "pattern_id": pattern["id"],
            "pattern_description": pattern["pattern_description"],
            "occurrence_count": pattern["occurrence_count"],
            "status": "pending"
        }
        self.calibration_events.append(event)
        print(f"\n [校准触发] 新型错误模式")
        print(f"  模式ID: {pattern['id']}")
        print(f"  描述: {pattern['pattern_description']}")
        print(f"  出现次数: {pattern['occurrence_count']}")
        print(f"  示例输入: {pattern['sample_input']}")
        print(f"  错误类型: {pattern['error_type']}")
        print(f"  建议操作: 评估是否需要纳入评估集")
# 使用示例
def monitoring_demo():
    # 创建检测器和触发器
    detector = ErrorPatternDetector(lookback_hours=24)
    trigger = CalibrationTrigger(detector)
    # 模拟添加一些日志
    now = datetime.now()
    # 正常日志
    for i in range(50):
        detector.add_log(InteractionLog(
            timestamp=now - timedelta(hours=random.randint(1, 23)),
            user_input=f"查询订单{i}",
            model_output="订单状态正常",
            user_feedback=5,
            regenerated=False,
            task_type="order_query",
            latency_ms=random.randint(500, 1500),
            session_id=f"session_{i}"
        ))
    # 负面日志 - 联系方式类
    for i in range(3):
        detector.add_log(InteractionLog(
            timestamp=now - timedelta(hours=random.randint(1, 23)),
            user_input="客服电话多少",
            model_output="客服电话可在官网查询",
            user_feedback=1,
            regenerated=True,
            task_type="general_inquiry",
            latency_ms=800,
            session_id=f"session_bad_{i}"
        ))
    # 负面日志 - 投诉类
    for i in range(4):
        detector.add_log(InteractionLog(
            timestamp=now - timedelta(hours=random.randint(1, 23)),
            user_input="你们服务太差了,我要投诉",
            model_output="已记录您的投诉,将转交相关部门",
            user_feedback=2,
            regenerated=True,
            task_type="complaint",
            latency_ms=950,
            session_id=f"session_bad2_{i}"
        ))
    # 运行检查
    trigger.run_periodic_check()
# 运行示例
monitoring_demo()
3. 知识校准:微调之外的优化路径
“校准”在技术上还有更深含义。近期研究提出的“知识校准”概念,为模型优化提供了新思路。例如,Calico系统通过诊断模型在代码任务中的“知识缺口”,自动重构代码以融入缺失信息,从而提升性能,避免了高昂的微调成本。
代码示例展示了基于知识校准的缺陷诊断思路:
# knowledge_calibration.py
"""
知识校准示例 - 展示如何通过知识注入修复模型缺陷
"""
from typing import Dict, List, Optional
import ast
class CodeKnowledgeCalibrator:
    """代码知识校准器 - 识别并注入被忽视的知识"""
    def __init__(self, model):
        self.model = model  # 实际应用中这里是大模型
        self.knowledge_base = self._init_knowledge_base()
    def _init_knowledge_base(self) -> Dict:
        """初始化知识库"""
        return {
            "python_patterns": {
                "list_comprehension": "列表推导式比for循环更高效,但复杂逻辑应保留for循环以提高可读性",
                "context_manager": "使用with语句确保资源正确释放",
                "type_hints": "类型提示有助于代码可读性和静态检查"
            },
            "common_pitfalls": {
                "mutable_default": "不要使用可变对象作为函数默认参数",
                "exception_hiding": "避免捕获所有异常却不处理",
                "race_condition": "多线程环境下注意共享资源的同步访问"
            }
        }
    def analyze_code(self, code: str) -> Dict:
        """分析代码,识别潜在的知识缺口"""
        try:
            tree = ast.parse(code)
        except SyntaxError:
            return {"error": "代码语法错误"}
        findings = []
        # 遍历AST,检查常见模式
        for node in ast.walk(tree):
            # 检查函数定义中的可变默认参数
            if isinstance(node, ast.FunctionDef):
                for arg, default in zip(node.args.args[-len(node.args.defaults):], node.args.defaults):
                    if isinstance(default, (ast.List, ast.Dict, ast.Set)):
                        findings.append({
                            "type": "mutable_default",
                            "location": node.lineno,
                            "knowledge": self.knowledge_base["common_pitfalls"]["mutable_default"],
                            "severity": "high"
                        })
            # 检查裸的except
            if isinstance(node, ast.ExceptHandler):
                if node.type is None:
                    findings.append({
                        "type": "exception_hiding",
                        "location": node.lineno,
                        "knowledge": self.knowledge_base["common_pitfalls"]["exception_hiding"],
                        "severity": "medium"
                    })
        return {
            "code": code,
            "findings": findings,
            "has_issues": len(findings) > 0
        }
    def calibrate_code(self, code: str) -> Dict:
        """校准代码 - 基于知识注入优化代码"""
        analysis = self.analyze_code(code)
        if not analysis["has_issues"]:
            return {"status": "no_calibration_needed", "code": code}
        # 生成校准建议
        suggestions = []
        for finding in analysis["findings"]:
            suggestions.append({
                "issue": finding["type"],
                "location": finding["location"],
                "knowledge": finding["knowledge"],
                "suggestion": self._generate_suggestion(finding)
            })
        # 实际应用中,这里会基于建议重新生成代码
        calibrated_code = self._apply_suggestions(code, suggestions)
        return {
            "status": "calibrated",
            "original_code": code,
            "calibrated_code": calibrated_code,
            "suggestions": suggestions,
            "finding_count": len(analysis["findings"])
        }
    def _generate_suggestion(self, finding: Dict) -> str:
        """生成具体的修改建议"""
        if finding["type"] == "mutable_default":
            return "将可变默认参数改为None,在函数体内初始化"
        elif finding["type"] == "exception_hiding":
            return "指定具体的异常类型,或至少记录异常信息"
        else:
            return "参考知识库进行调整"
    def _apply_suggestions(self, code: str, suggestions: List) -> str:
        """应用建议生成校准后代码(简化实现)"""
        # 实际应用中,这里会调用大模型进行代码重构
        lines = code.split("\n")
        # 模拟修改:添加注释说明问题
        for suggestion in suggestions:
            if suggestion["issue"] == "mutable_default":
                lines.insert(
                    suggestion["location"],
                    f"# TODO: {suggestion['knowledge']} - {suggestion['suggestion']}"
                )
        return "\n".join(lines)
# 使用示例
def knowledge_calibration_demo():
    calibrator = CodeKnowledgeCalibrator(model=None)
    # 有问题的代码
    problematic_code = '''
def add_item(item, items=[]):
    items.append(item)
    return items
def process_data(data):
    try:
        result = data.process()
        return result
    except:
        return None
'''
    print("原始代码:")
    print(problematic_code)
    result = calibrator.calibrate_code(problematic_code)
    print("\n" + "="*50)
    print("校准结果:")
    print(f"状态: {result['status']}")
    print(f"发现的问题数: {result['finding_count']}")
    for suggestion in result.get('suggestions', []):
        print(f"\n问题类型: {suggestion['issue']}")
        print(f"知识: {suggestion['knowledge']}")
        print(f"建议: {suggestion['suggestion']}")
    if 'calibrated_code' in result:
        print("\n校准后代码:")
        print(result['calibrated_code'])
# 运行示例
knowledge_calibration_demo()
这启示我们,校准行为不一定需要重新训练模型,通过优化输入(提示工程、知识注入等)往往是更高效、可持续的策略。[AFFILIATE_SLOT_2]
融合与实施:CC/CD与传统DevOps的双轨协同
CC/CD不是要推翻现有体系,而是与之融合,形成协同工作的双轨系统。
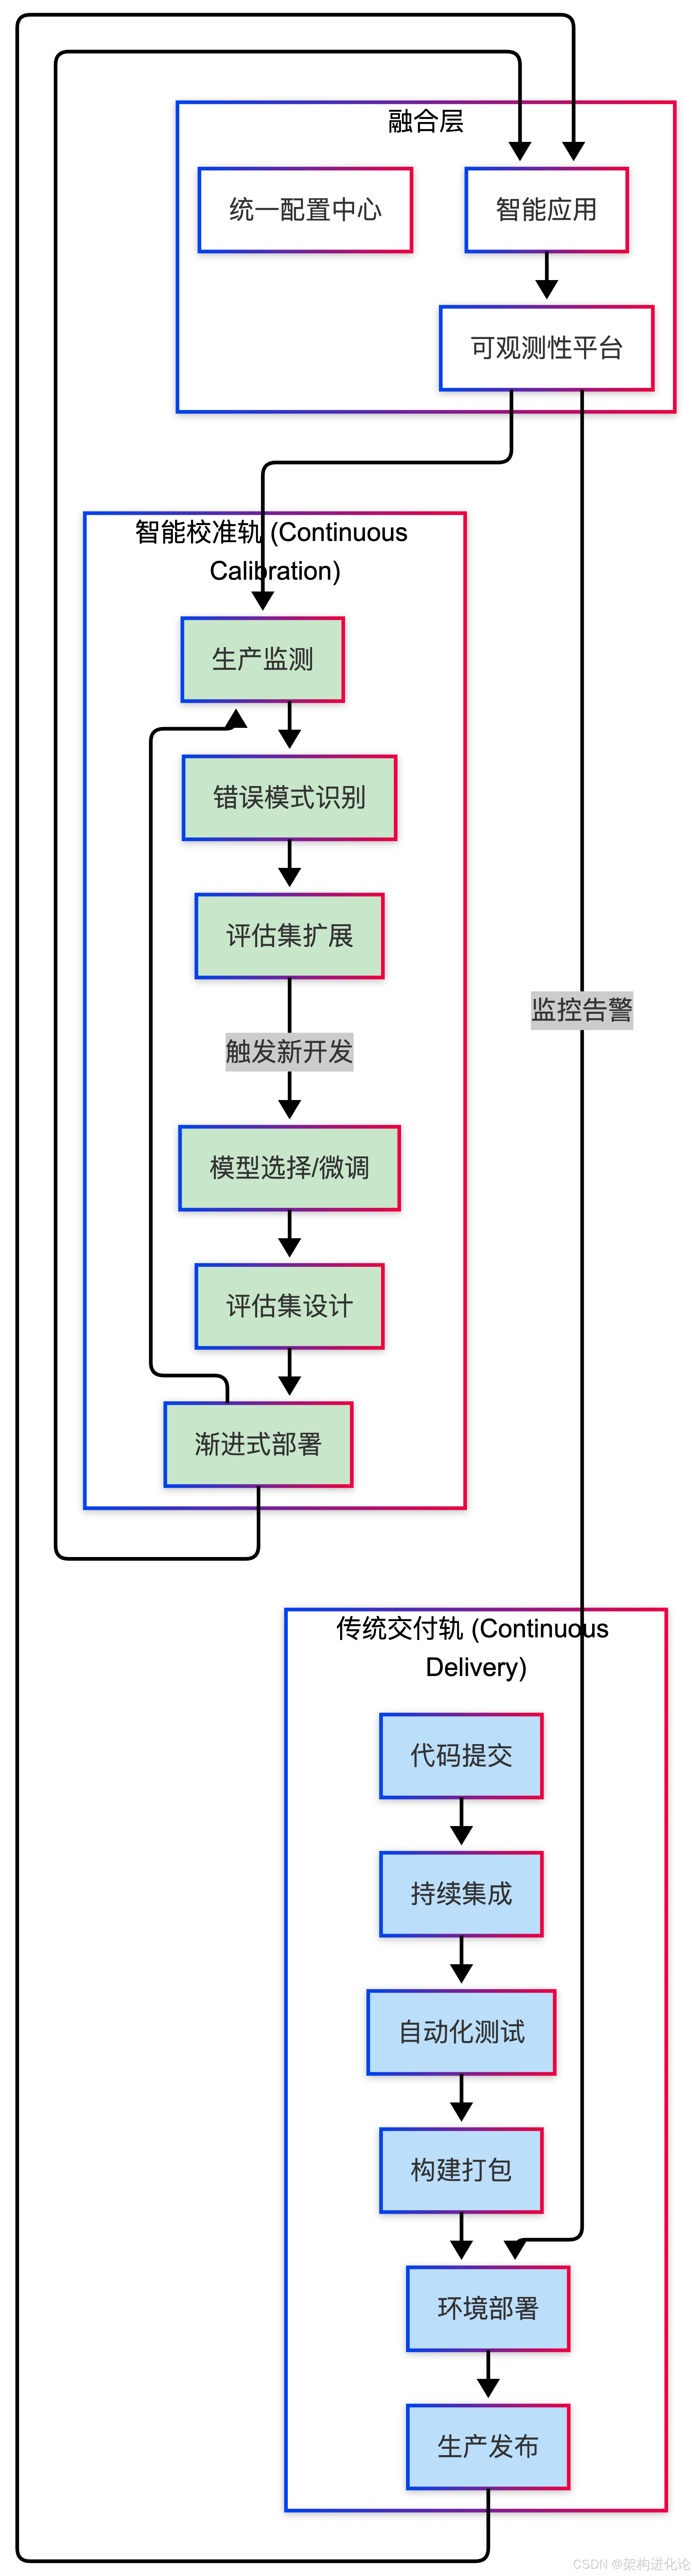
融合架构
传统DevOps轨道继续负责基础设施、确定性代码的CI/CD;CC/CD校准轨道则负责模型版本、提示模板、RAG知识库等智能组件的持续校准与部署。
实施路线图
团队可以遵循一个清晰的四阶段路线图来落地CC/CD:
- 诊断与规划(1-2个月):识别场景,绘制工作流,设计V1方案,构建种子评估集。
- V1构建与部署(2-3个月):实现高控制、低自主的V1功能,建立生产监测基线。
- 校准循环(持续):分析监测数据,识别错误模式,扩展评估集,优化系统行为。
- 渐进式升级(按需):当系统证明可靠性后,设计并实施下一自主权阶段。
成功的标志是“最小化意外”。当日常校准会议不再发现新的数据分布或错误模式时,就表明系统已准备好进入下一阶段。
总结:从交付到校准的认知跃迁
大模型时代的软件工程范式革命,本质是一场从“交付确定性”到“校准概率性”的认知跃迁。
传统CI/CD的隐喻是流水线,追求标准化输入与稳定产出。而CC/CD的隐喻是驯鹰——你无法“构建”一只鹰,但可以通过持续的训练、反馈与校准,让它学会在可控范围内自主狩猎,同时确保在需要时能随时召回。
这要求从业者同时拥抱工程师的严谨与园丁的耐心。未来,随着校准自动化、个性化校准等趋势的发展,CC/CD范式将日益成熟,成为构建下一代可靠AI应用的基石。在这场变革中,我们不再是事无巨细的指令发出者,而是把握方向的引导者,每一次校准都是信任的积累,每一次演进都是能力的共同提升。


 浙公网安备 33010602011771号