目录
4.DocumentReader(Extract - 提取)
5.DocumentTransformer(Transform - 转换)
1.前言
SpringAI的学习我是基于鱼皮的那个AI超级智能体项目和Spring的官方文档来进行学习的,下面的图片会引用一些鱼皮和官方的图片来进行讲解。
2.RAG工作流程
在讲解ETL之前,先简单的了解一下RAG工作流程是什么,我这里简单过一下,大家想详细了解的可以去参照SpringAI的官网,官网的文档写得很好Retrieval Augmented Generation :: Spring AI Reference https://docs.spring.io/spring-ai/reference/api/retrieval-augmented-generation.html
其实RAG 的本质就是:先通过“向量+过滤”精准找到与问题相关的文档片段,再用这些片段“喂”大模型,让生成的答案既依托权威文档,又发挥大模型的理解/生成能力,解决大模型“幻觉”、知识 cutoff 等问题。
工作流程图如下:
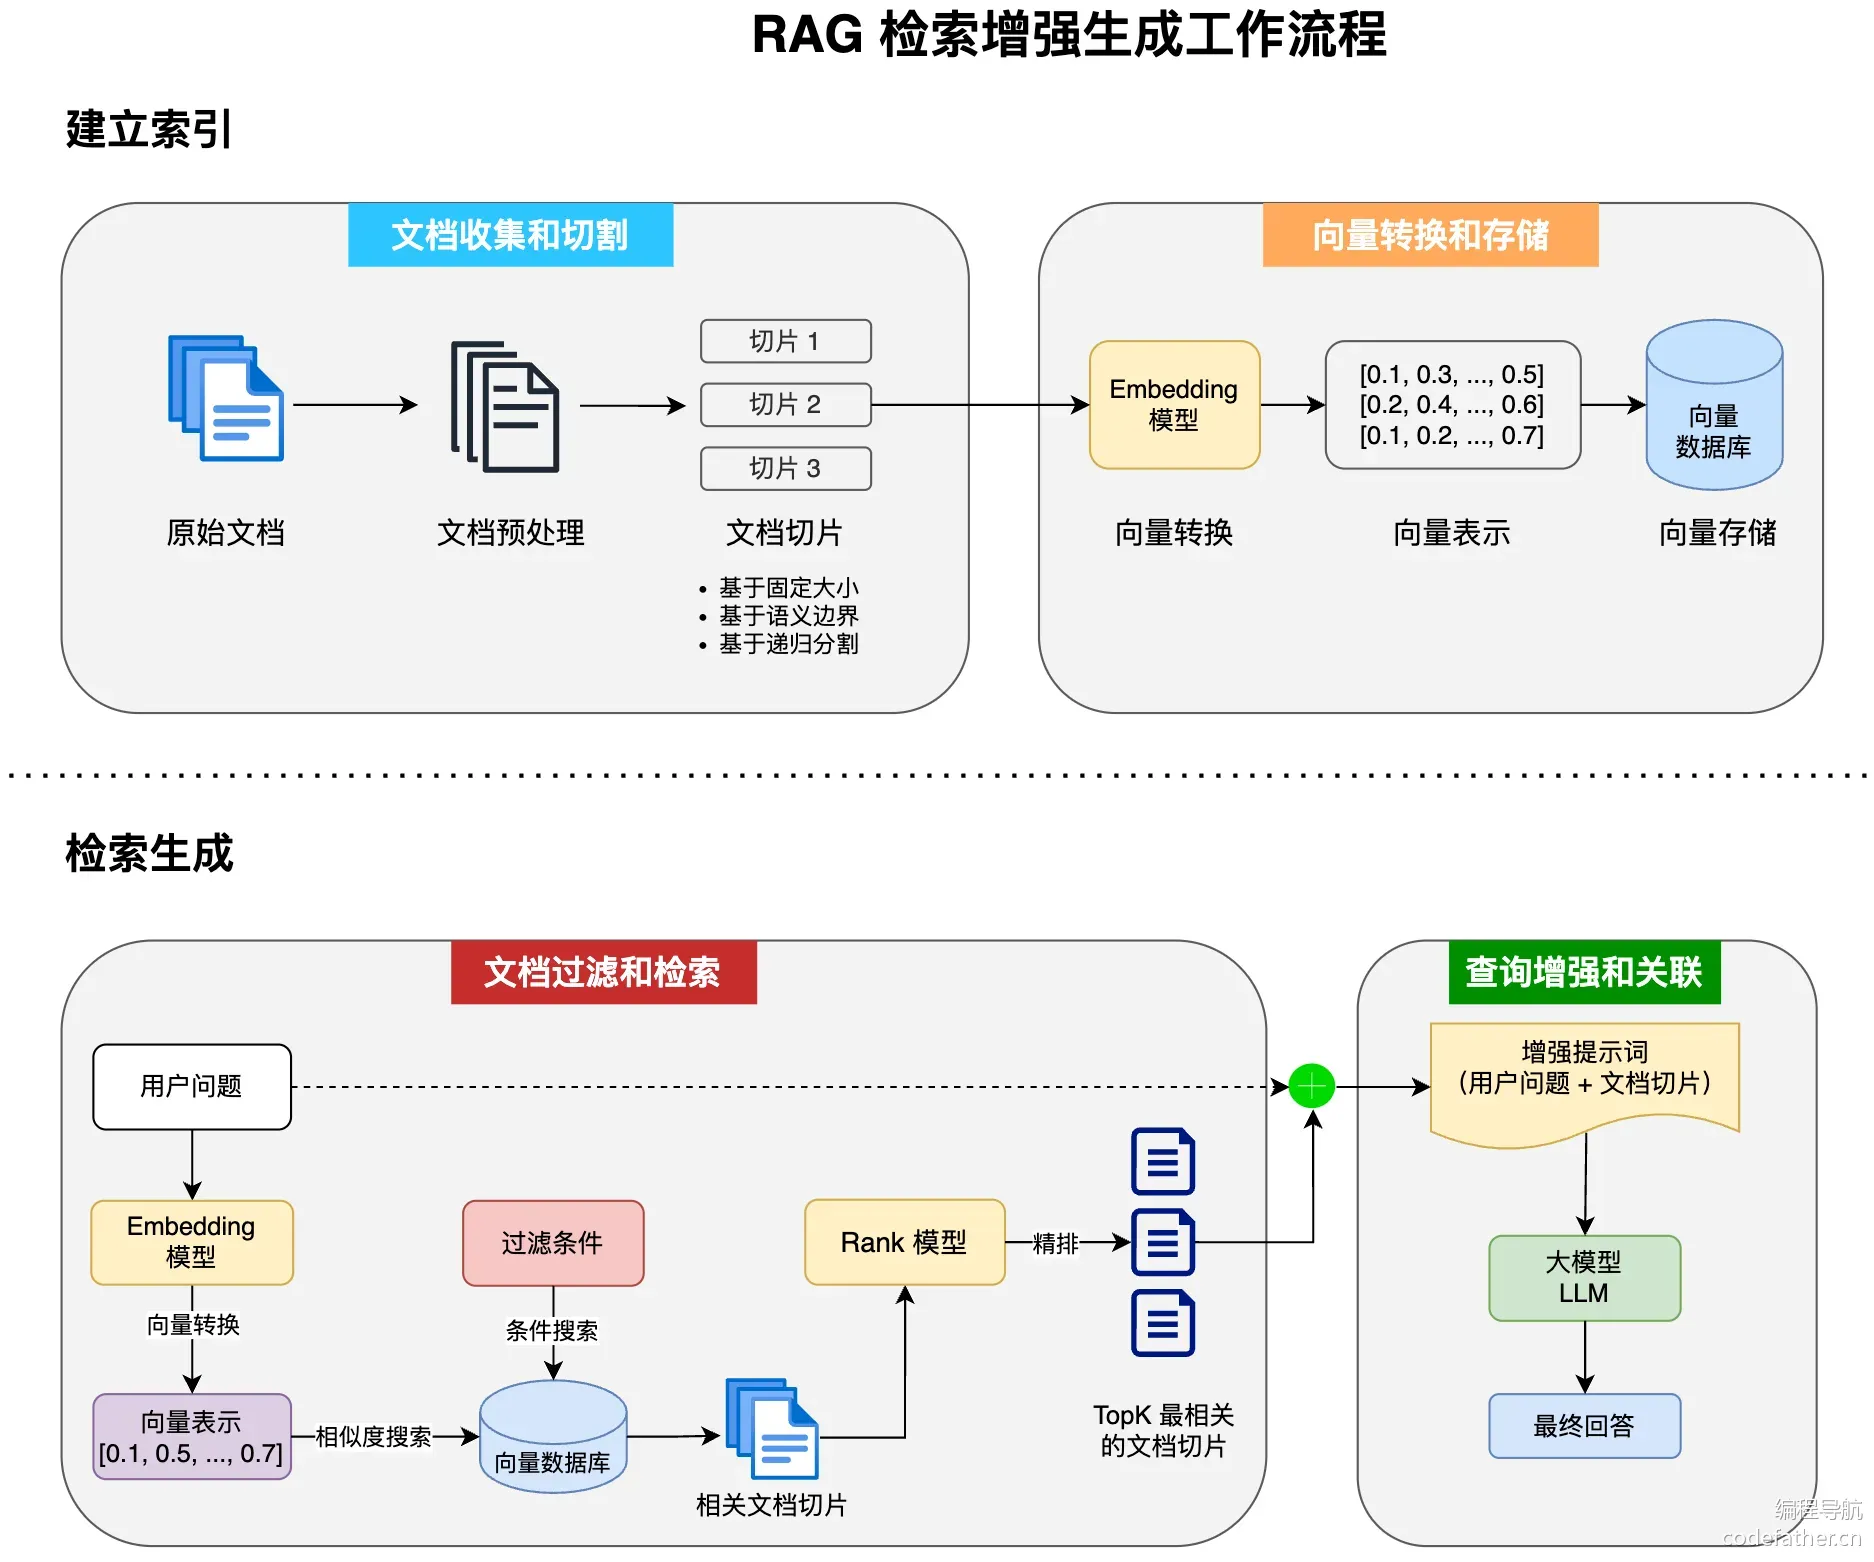
上半部分:建立索引(离线准备)
将知识库转换成可检索的向量形式:
文档收集和切割:原始文档经过预处理后,按照固定大小、语义边界或递归分割策略切成多个文本片段(切片1、2、3...)
向量转换和存储:这些切片通过 Embedding 模型转换成数字向量(如
[0.1, 0.3, ...]),存入向量数据库
下半部分:检索生成(在线回答)
处理用户提问并生成回答:
文档检索:用户问题也被转成向量 → 在向量库中相似度搜索 → 可结合过滤条件筛选 → 通过 Rank 模型精排选出最相关的 TopK 个切片
查询增强:将用户问题 + 检索到的文档切片组合成增强提示词,输入大模型(LLM)生成最终回答
简单来说就是:
先"离线切文档存向量",再"在线搜相似给 AI",让大模型基于检索到的知识而非猜测来回答。
而我们本文要讲解的就是RAG的四个大流程中的第一个:文档收集和切割
- 文档收集和切割
- 向量转换和存储
- 文档过滤和检索
- 查询增强和关联
3.ETL概念
Spring AI 的 ETL(Extract-Transform-Load) 是构建 RAG 知识库的数据处理管道,负责将原始文档(PDF、Markdown、HTML 等)加工成 AI 可检索的向量格式。
ETL 包含三大核心组件,分别对应三个阶段:抽取、转换、加载,Spring AI 官网也进行了详细的讲解
ETL Pipeline :: Spring AI Referencehttps://docs.spring.io/spring-ai/reference/api/etl-pipeline.html
3.1文档是什么
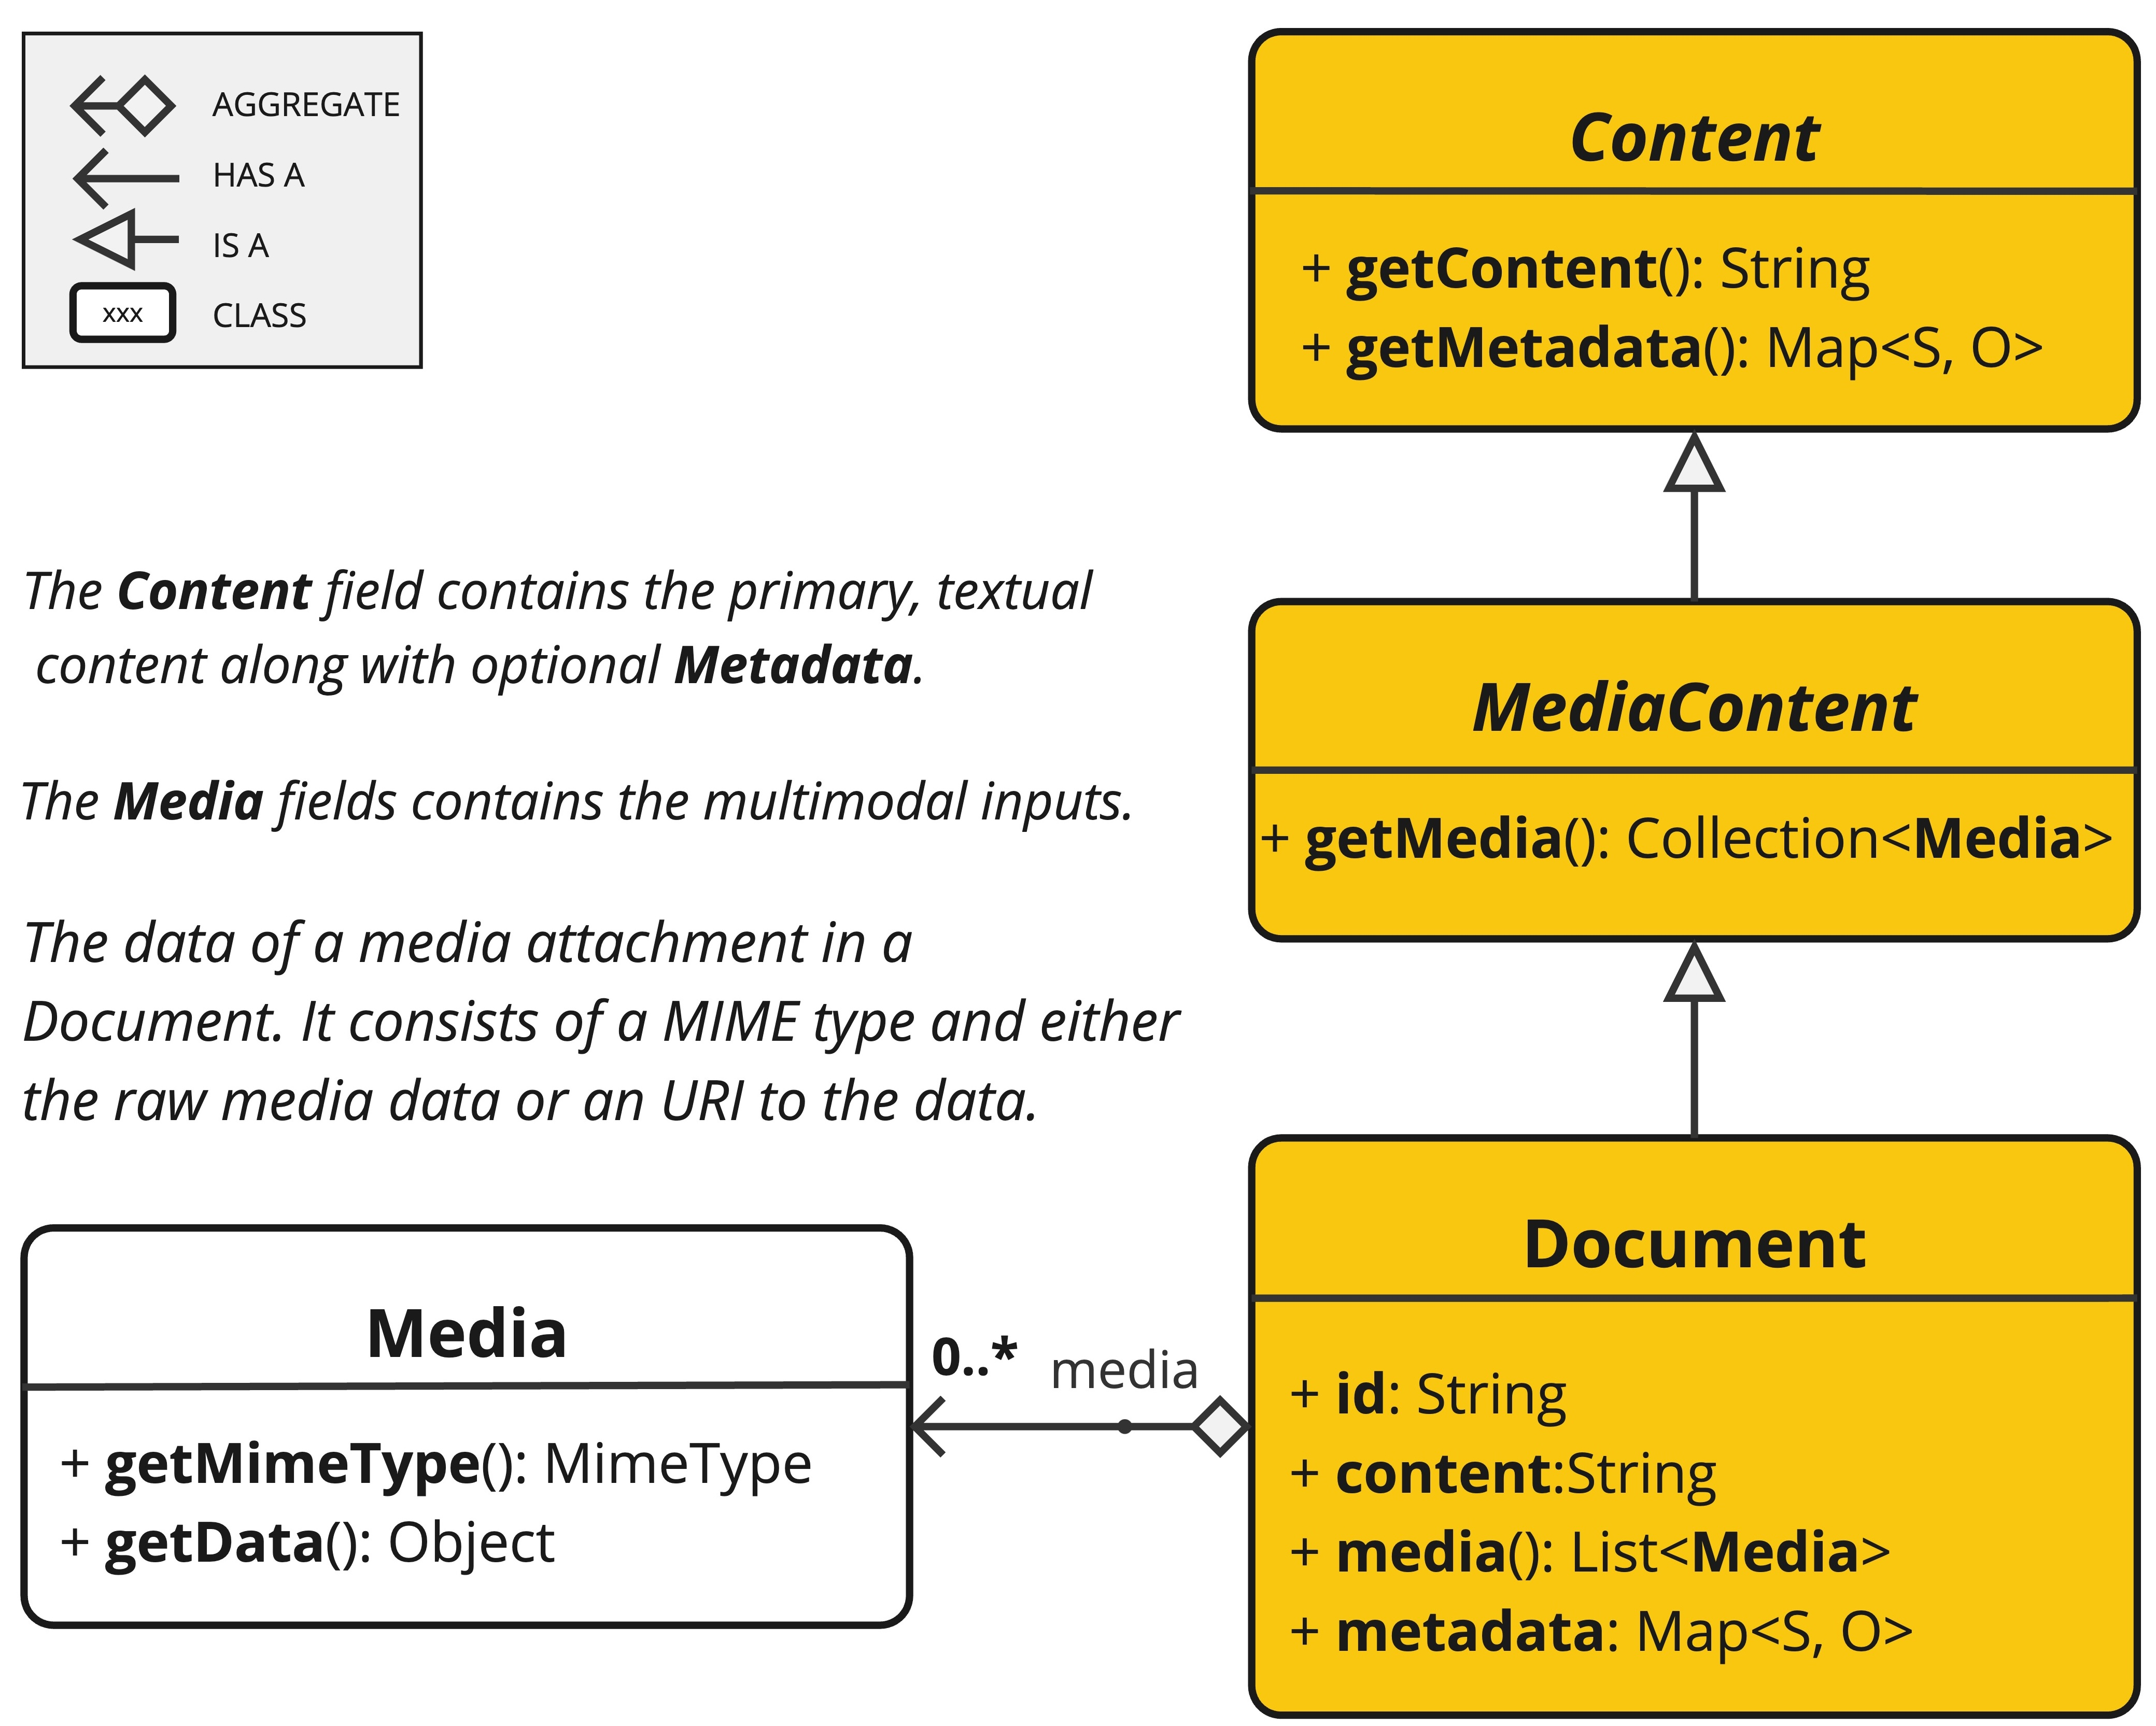
Spring AI 中的文档范围比我们生活中的更为广泛,不仅仅包含文本,还可以包含一系列元信息和多媒体附件(文档类包含文本、元数据以及可选的额外媒体类型,如图片、音频和视频。)
ETL
在 Spring AI 中,对 Document 的处理通常遵循以下流程:
- 读取文档:使用 DocumentReader 组件从数据源(如本地文件、网络资源、数据库等)加载文档。
- 转换文档:根据需求将文档转换为适合后续处理的格式,比如去除冗余信息、分词、词性标注等,可以使用 DocumentTransformer 组件实现。
- 写入文档:使用 DocumentWriter 将文档以特定格式保存到存储中,比如将文档以嵌入向量的形式写入到向量数据库,或者以键值对字符串的形式保存到 Redis 等 KV 存储中。
流程如图:
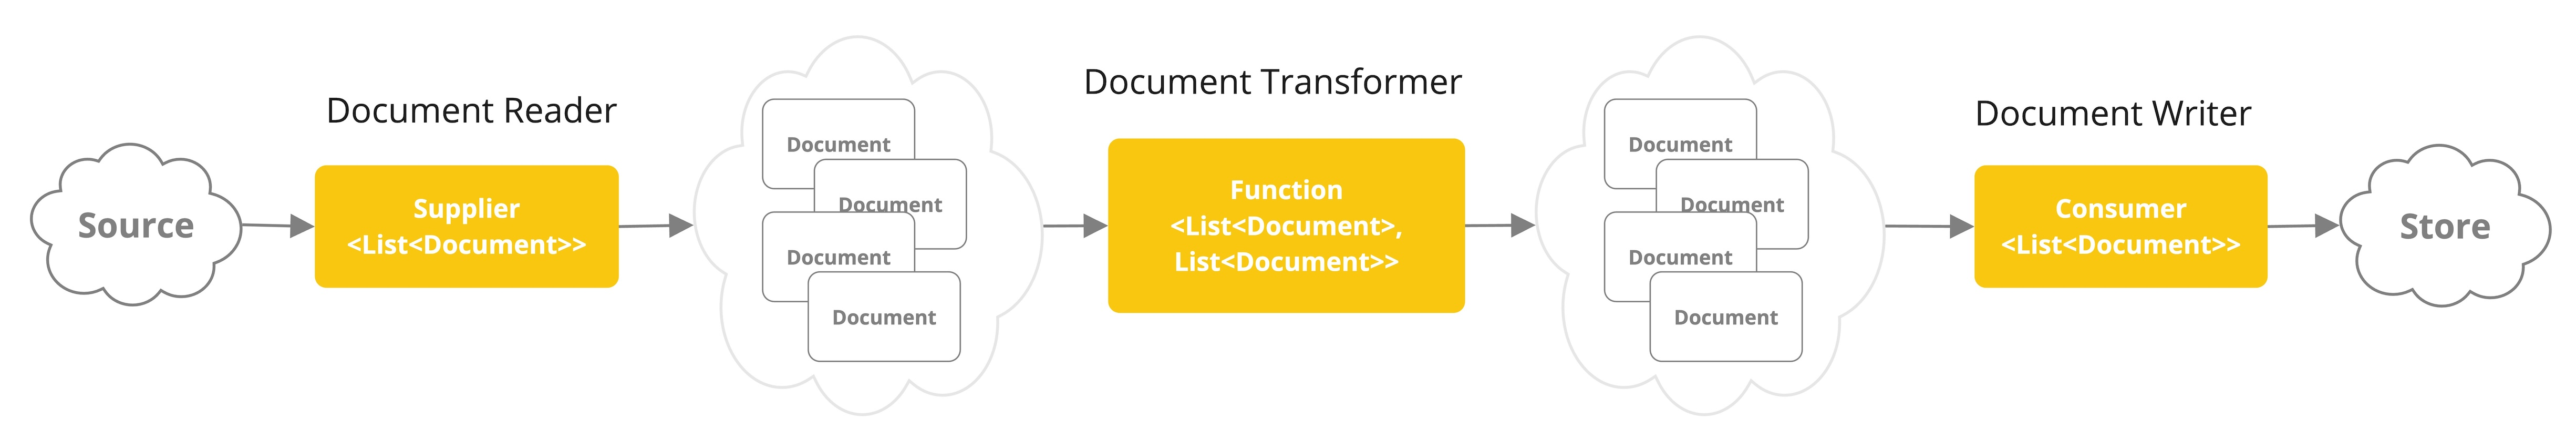
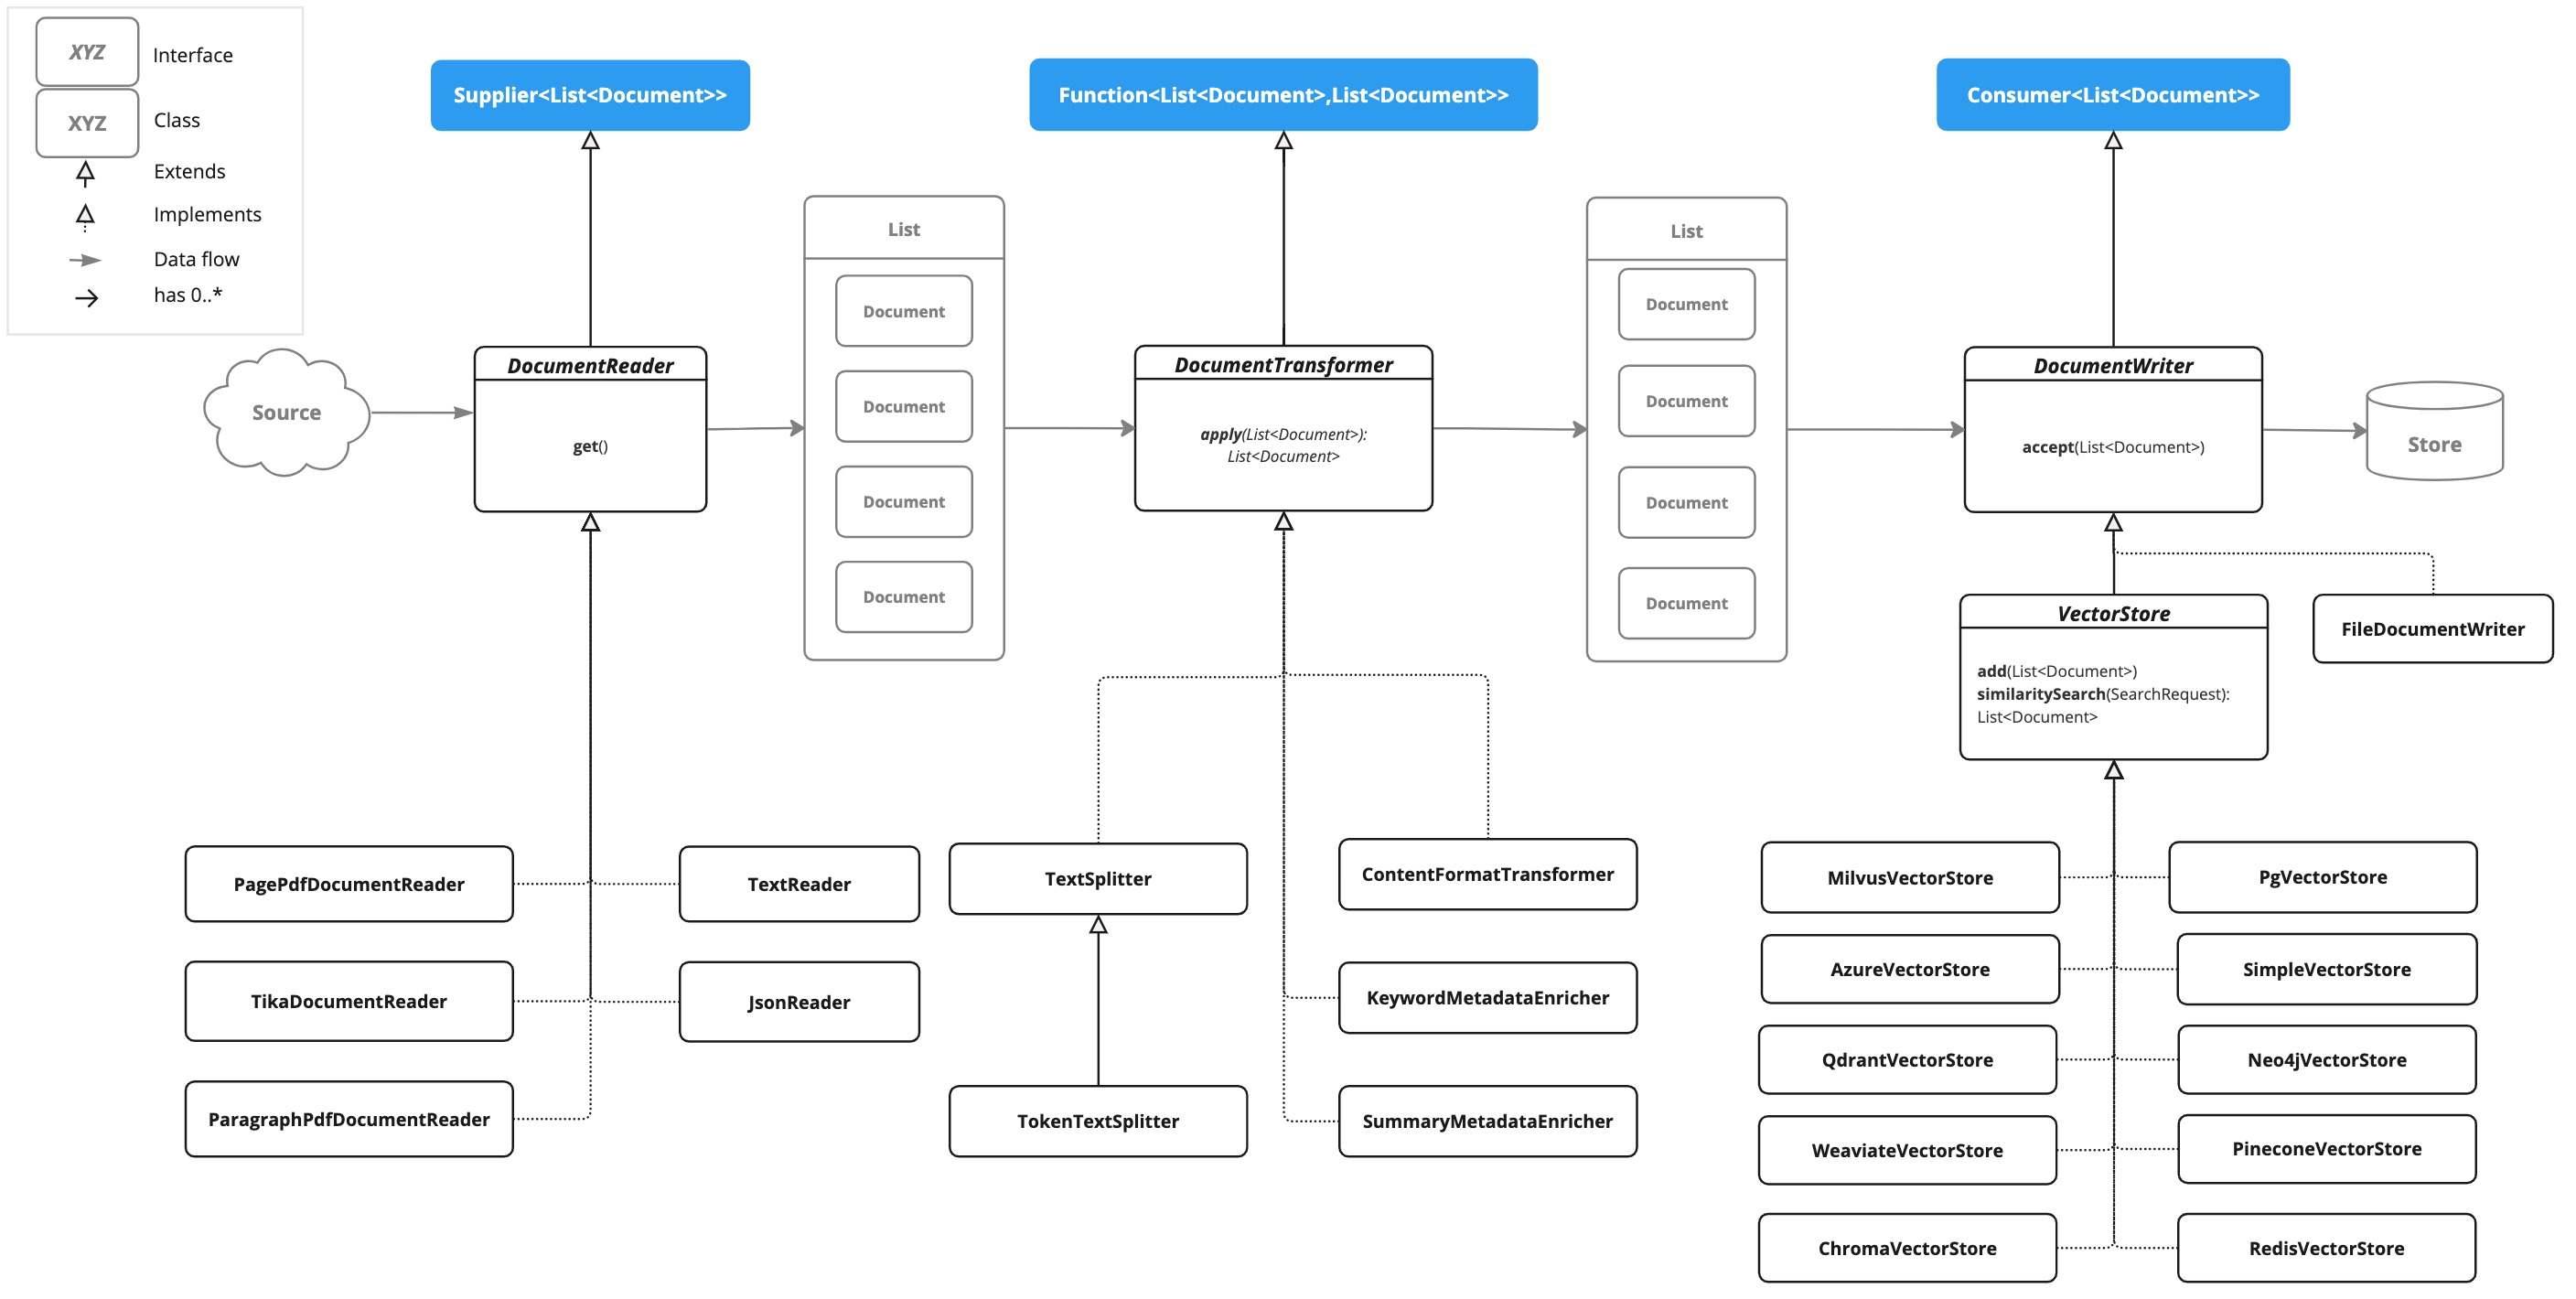
利用 Spring AI 实现 ETL,核心就是要学习 DocumentReader、DocumentTransformer、DocumentWriter 三大组件。
下面是三个组件的类图示例图(了解即可)
4.DocumentReader(Extract - 提取)
4.1职责
从各种数据源(本地文件、网页、数据库等)读取原始内容,并将其封装为 Spring AI 的 Document(文档)对象。
4.2提取类别
官网提供了如下这些实现类进行文档的读取以及读取的方式:
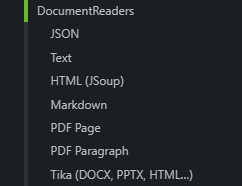
这里我给出表格简单说一下各个的作用:
| 实现类 | 适用场景 | 特点 |
|---|---|---|
TextReader | 纯文本文件(.txt) | 简单文本读取,支持自定义元数据 |
PagePdfDocumentReader | PDF 文件 | 按页读取 PDF,保留页码元数据 |
MarkdownDocumentReader | Markdown 文件 | 解析 Markdown 结构,保留标题层级 |
JsoupDocumentReader | HTML 网页 | 使用 JSoup 爬取并解析网页内容 |
TikaDocumentReader | 多格式文件 | 基于 Apache Tika,自动识别多种格式(Word、Excel、PPT 等) |
JsonReader | JSON 数据 | 从 JSON 提取指定字段作为文档内容 |
实际情况,大家根据自己的知识库选择不同的读取方式,如果都不能满足,则可以实现DocumentReader进行自定义实现,下面是接口:
package org.springframework.ai.document;
import java.util.List;
import java.util.function.Supplier;
public interface DocumentReader extends Supplier> {
	default List read() {
		return get();
	}
}
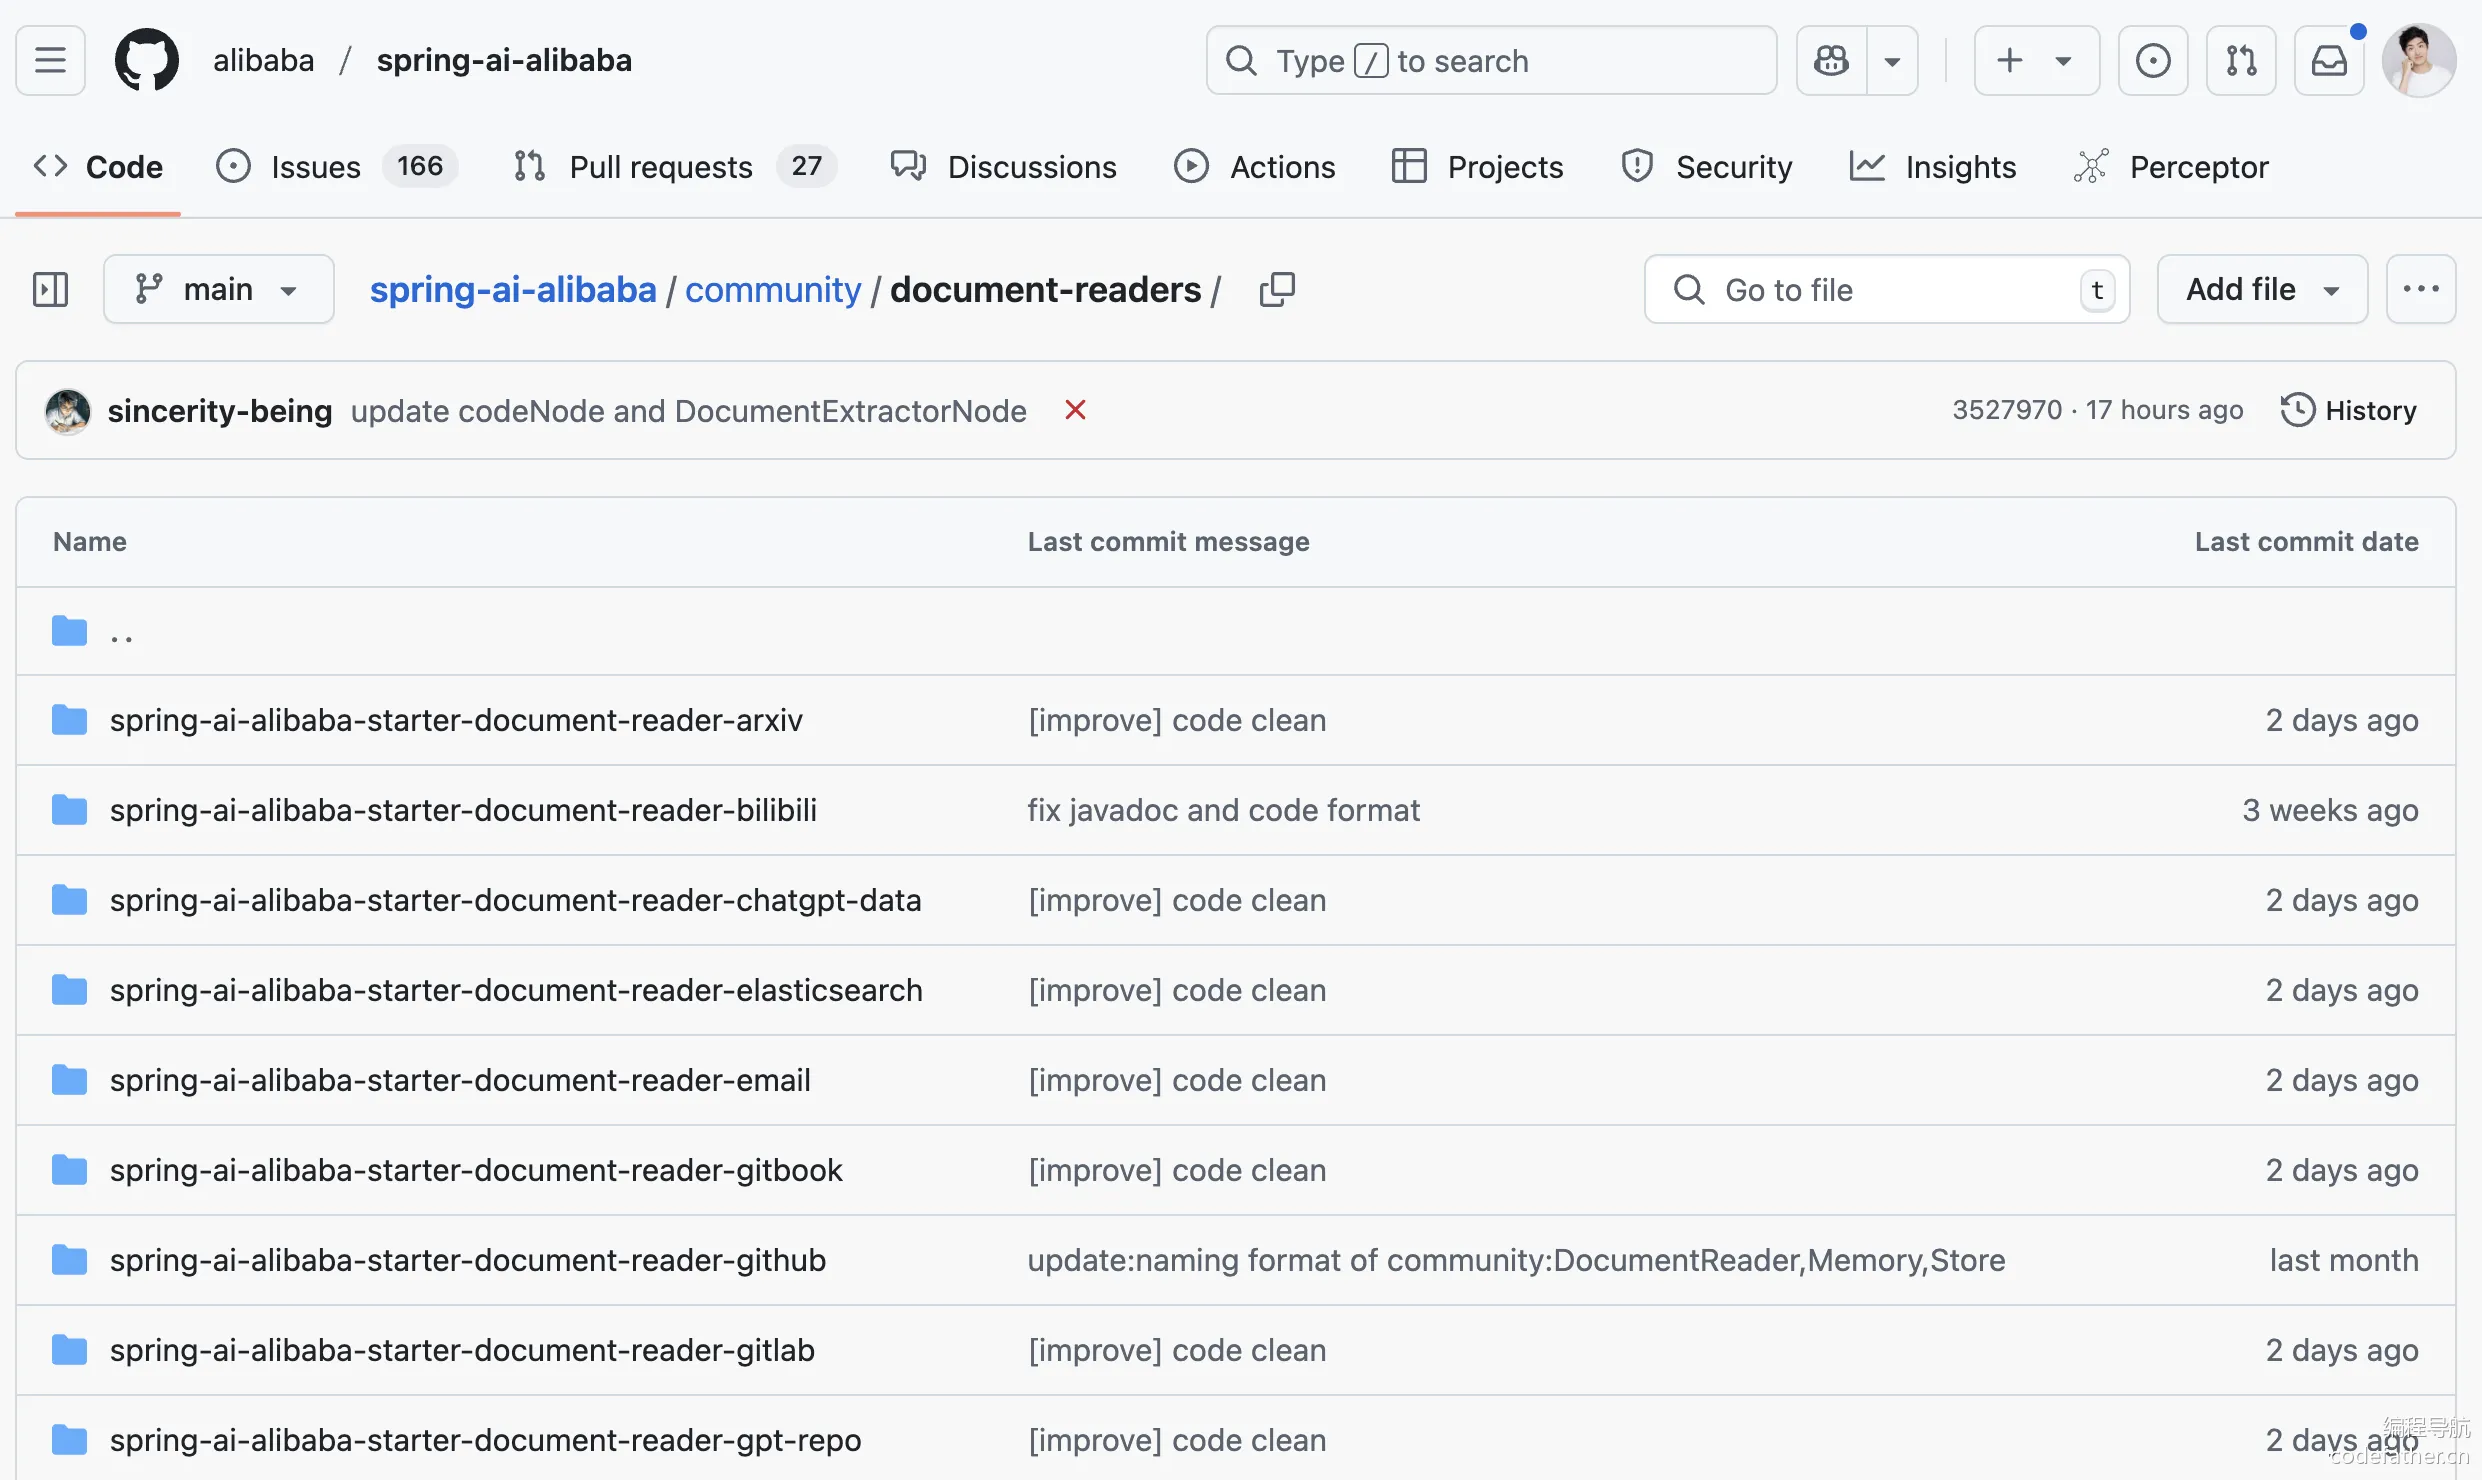
此外,Spring AI Alibaba 官方社区提供了 更多的文档读取器,比如加载飞书文档、提取 B 站视频信息和字幕、加载邮件、加载 GitHub 官方文档、加载数据库等等。
4.3代码演示
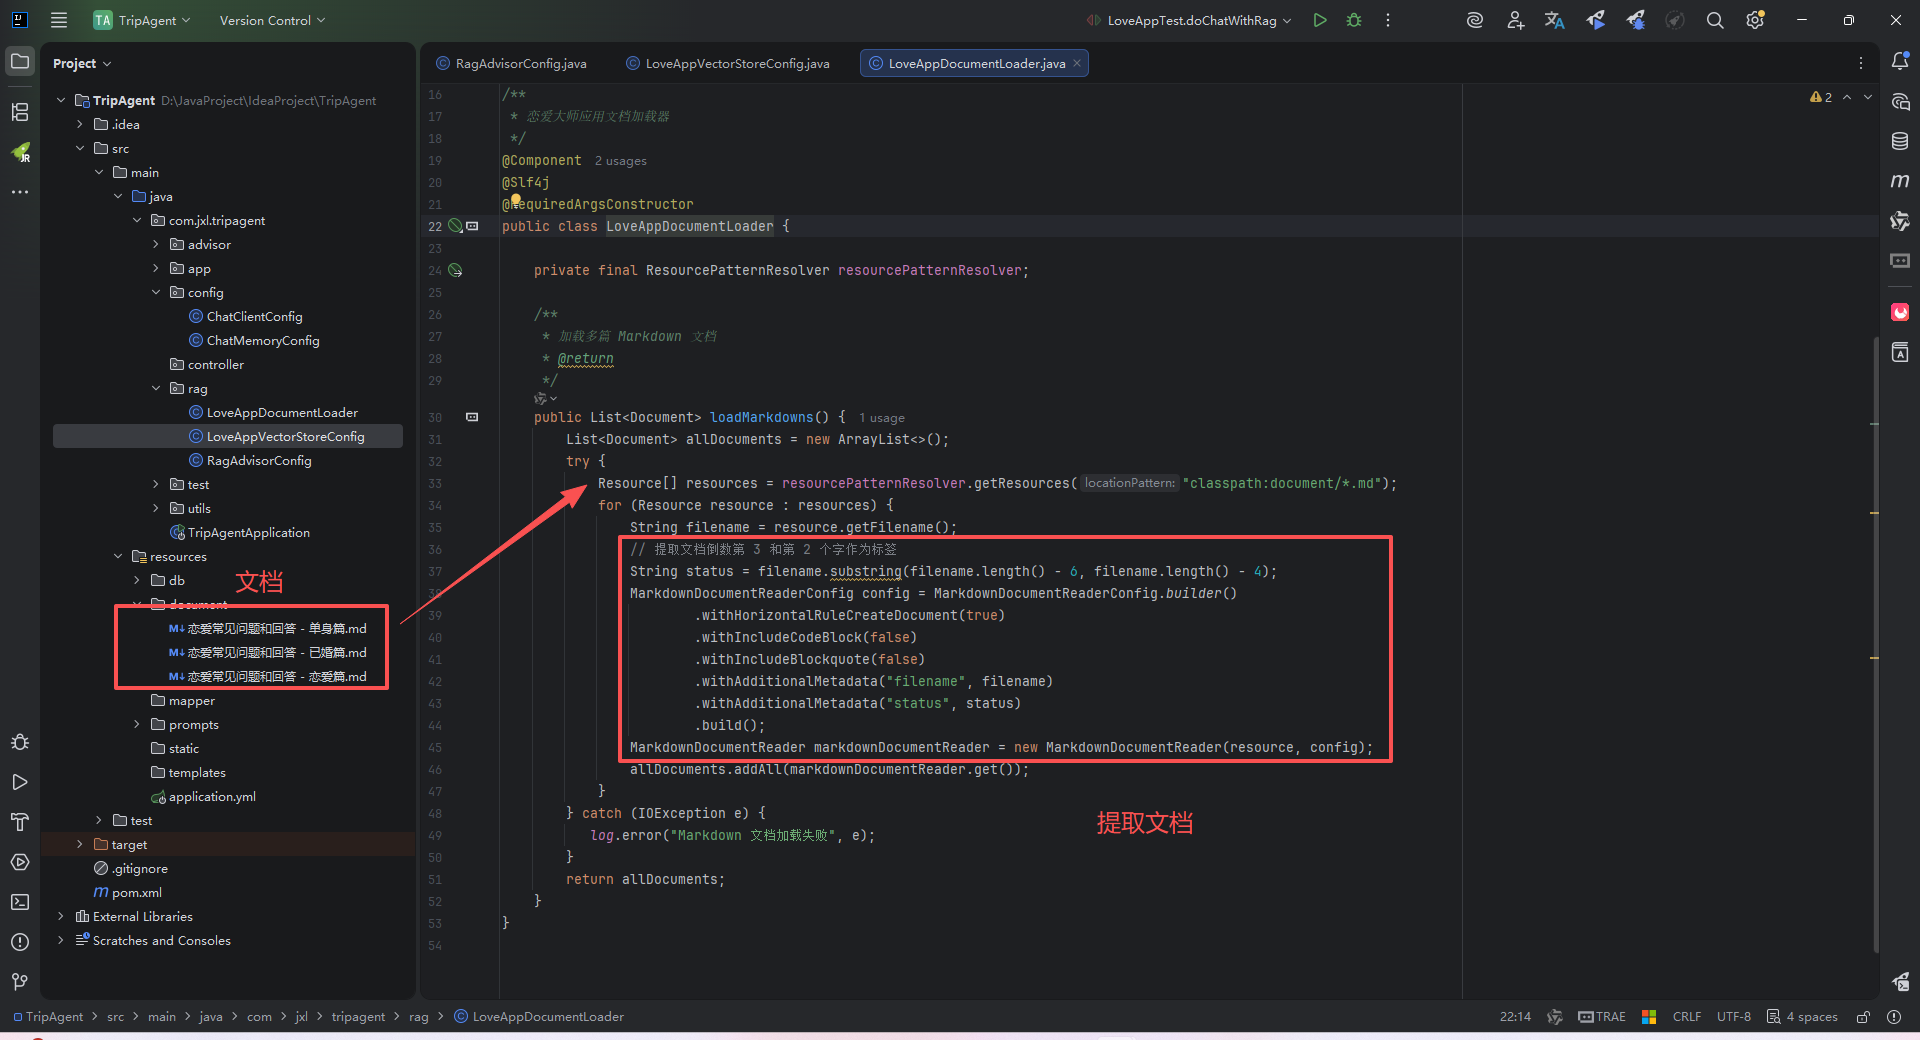
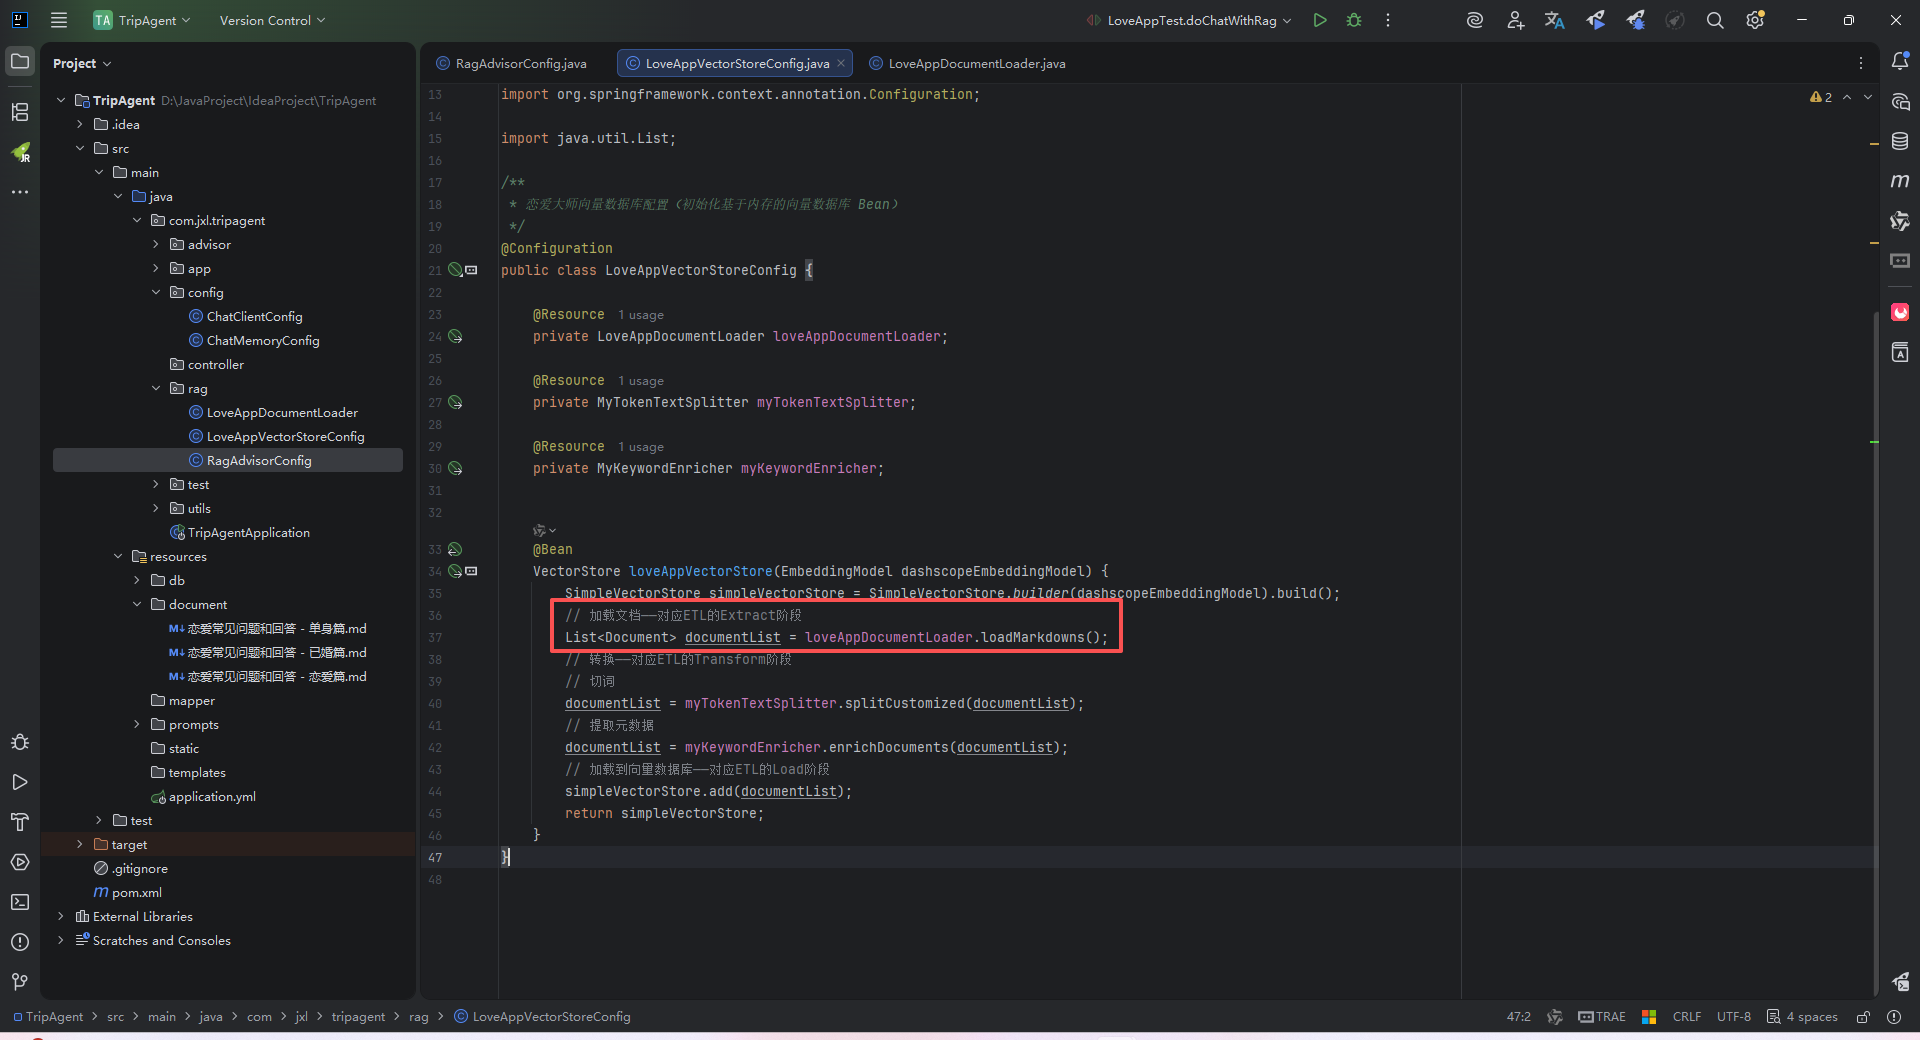
这里基于我自己实现的恋爱大师项目进行演示:
我使用的是MD的文档提取器
单元测试并DEBUG一下上面的代码:
@Test
void doChatWithRag() {
    String chatId = UUID.randomUUID().toString();
    String message = "我已经结婚了,但是婚后关系不太亲密,怎么办?";
    String answer = loveApp.doChatWithRag(message, chatId);
    Assertions.assertNotNull(answer);
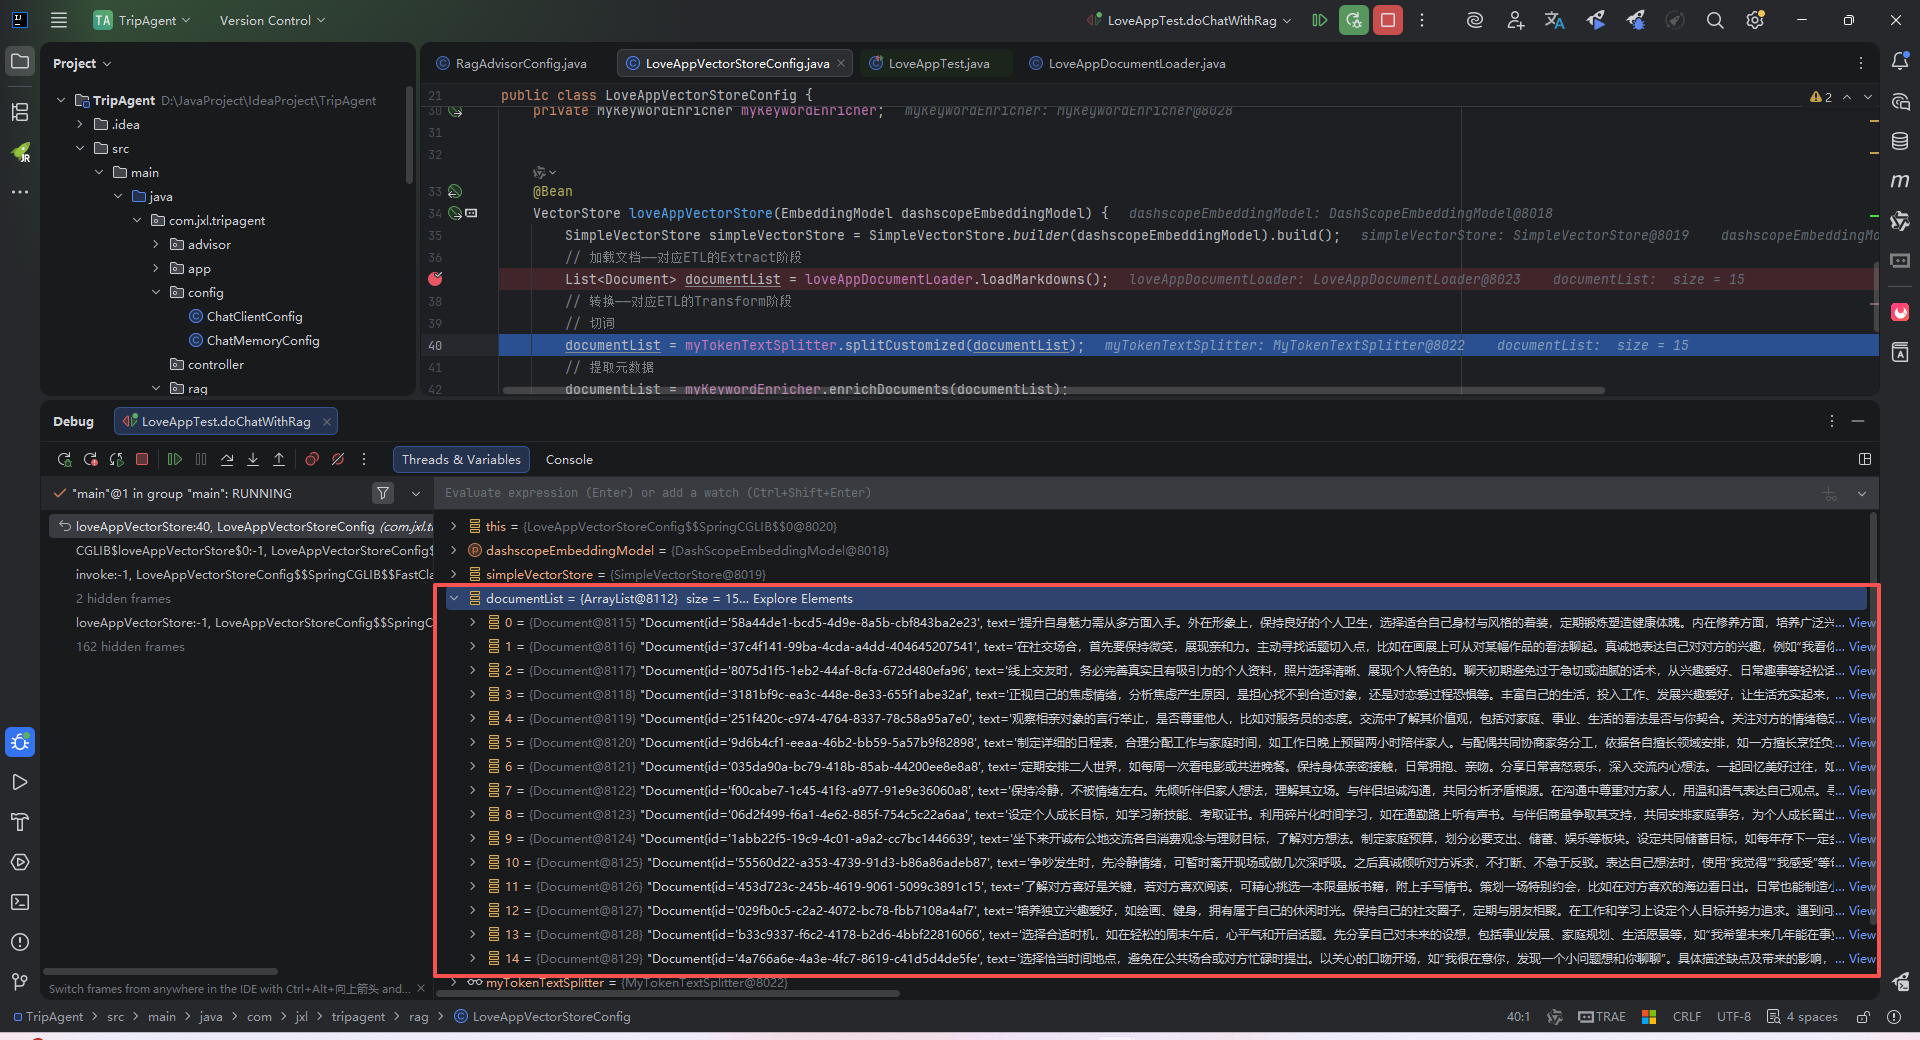
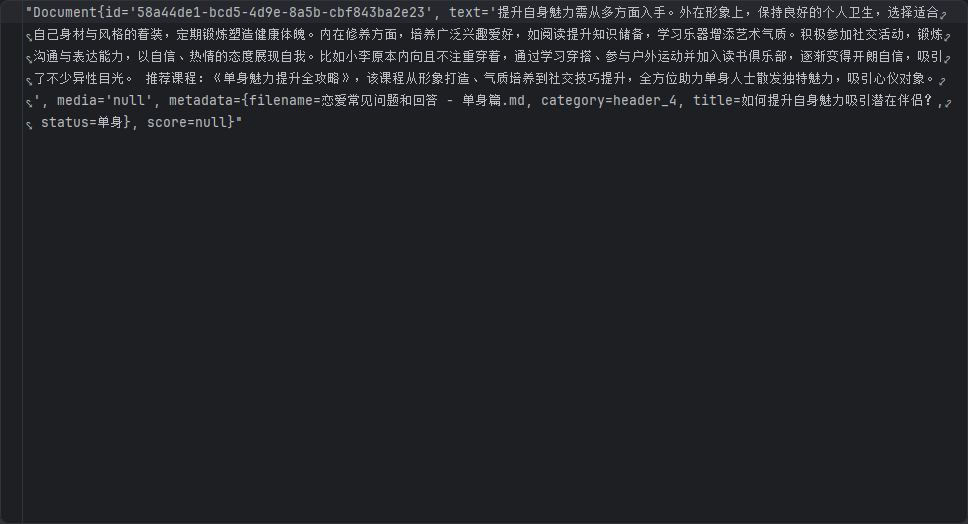
}这里可以看到知识库文件被正常提取成为15个文件
5.DocumentTransformer(Transform - 转换)
5.1职责
对 Document 进行清洗、分割、元数据增强,使其适合向量化存储。这是最重要的环节
Spring AI 通过 DocumentTransformer 组件实现文档转换。看下源码,DocumentTransformer 接口实现了 Function<List<Document>, List<Document>> 接口,负责将一组文档转换为另一组文档。
public interface DocumentTransformer extends Function, List> {
    default List transform(List documents) {
        return apply(documents);
    }
}
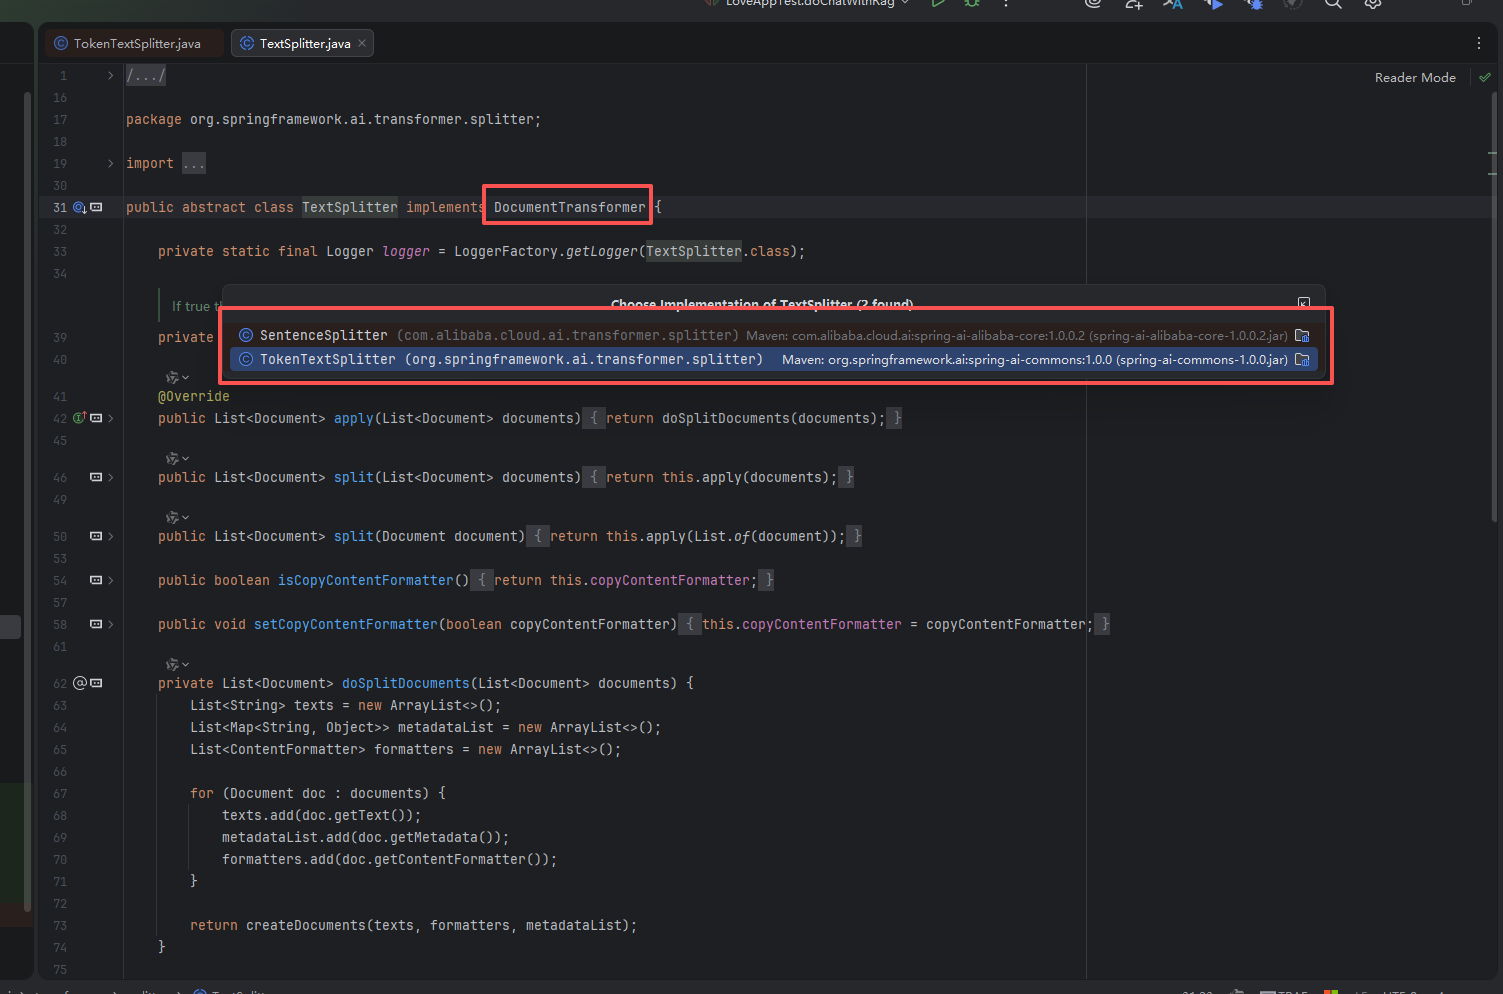
文档转换是保证 RAG 效果的核心步骤,也就是如何将大文档合理拆分为便于检索的知识碎片,Spring AI 提供了多种 DocumentTransformer 实现类,可以简单分为 3 类。
5.2文本分割器(Text Splitters)
用于解决大模型上下文长度限制,将长文本切分小块:
| 实现类 | 策略 | 特点 |
|---|---|---|
TokenTextSplitter | 基于 Token 数量 | 最常用,默认 800 token/块,保留语义边界(句子/段落) |
ParagraphTextSplitter | 基于段落 | 按空行分割,保持段落完整性 |
TokenTextSplitter 参数说明:
TokenTextSplitter splitter = new TokenTextSplitter(
    800,    // defaultChunkSize: 目标块大小(token数)
    350,    // minChunkSizeChars: 最小字符数
    5,      // minChunkLengthToEmbed: 最小嵌入长度
    10000,  // maxNumChunks: 最大块数
    true    // keepSeparator: 是否保留分隔符(如换行符)
);
这里给出表格说明,一般开发时就查文档和问AI就行了
| 参数 | 值 | 含义 | 作用说明 |
|---|---|---|---|
defaultChunkSize | 800 | 目标块大小(token 数) | 每个文本块理想包含的 token 数量。实际分割时会尽量接近这个值,但受语义边界影响可能有所偏差 |
minChunkSizeChars | 350 | 最小字符数 | 如果一个文本块的字符数低于此值,会被合并到相邻块中,避免产生过短的碎片 |
minChunkLengthToEmbed | 5 | 最小嵌入长度 | 过滤掉过短的 token 序列(如单个标点、语气词),只有超过 5 个 token 的内容才会被保留为独立块 |
maxNumChunks | 10000 | 最大块数 | 单篇文档最多分割成多少块。防止超大文档产生爆炸性数量的切片,控制内存和存储开销 |
keepSeparator | true | 保留分隔符 | 分割后是否保留换行符、段落标记等分隔符。设为 true 可保持原始格式和段落结构 |
这里大家肯定有疑惑了,为啥上面提取文档拆分了一次,三个文件拆分成了15个document,这里为啥还要拆分?
原始文件(1 个大 Markdown 文件)
    ↓
【Extract 阶段 - Reader】
- MarkdownDocumentReader 读取文件
- 按水平线 --- 分割(可选)
    ↓
产生:2-3 个较大的 Document(每个可能包含多个段落)
    ↓
【Transform 阶段 - Transformer】
- TokenTextSplitter 进一步处理
- 按 token 数量(如 800)+ 段落边界再次分割
    ↓
产生:10-20 个较小的 Document Chunk(适合向量化)
    ↓
【Load 阶段】存入向量库提取文档的拆分只是一次粒度很粗的拆分,而Transform 是在 Reader 输出的 Document 基础上进行"再加工"
Reader 的拆分 vs Transform 的拆分
| 维度 | Reader 的拆分(初步) | Transform 的拆分(精细) |
|---|---|---|
| 目的 | 文件级的粗分 | 语义级的细分,适配模型上下文 |
| 粒度 | 大段(可能几千字) | 小块(几百个 token,约 200-800 字) |
| 依据 | 文件格式特征(如 --- 水平线、分页符) | 语义边界(段落、句子)+ Token 限制 |
| 是否保留元数据 | 是 | 是(且可以添加新元数据) |
| 类比 | 把一本书分成"章节" | 把章节切成适合阅读理解的"段落" |
5.3文本分割器案例演示
这里我们定义一下分词器,便于待会直接注入使用
package com.jxl.tripagent.utils;
import org.springframework.ai.document.Document;
import org.springframework.ai.transformer.splitter.TokenTextSplitter;
import org.springframework.stereotype.Component;
import java.util.List;
/**
 * 自定义基于 Token 的切词器
 */
@Component
public class MyTokenTextSplitter {
    public List splitDocuments(List documents) {
        TokenTextSplitter splitter = new TokenTextSplitter();
        return splitter.apply(documents);
    }
    public List splitCustomized(List documents) {
        TokenTextSplitter splitter = new TokenTextSplitter(200, 100, 10, 5000, true);
        return splitter.apply(documents);
    }
}
注入使用
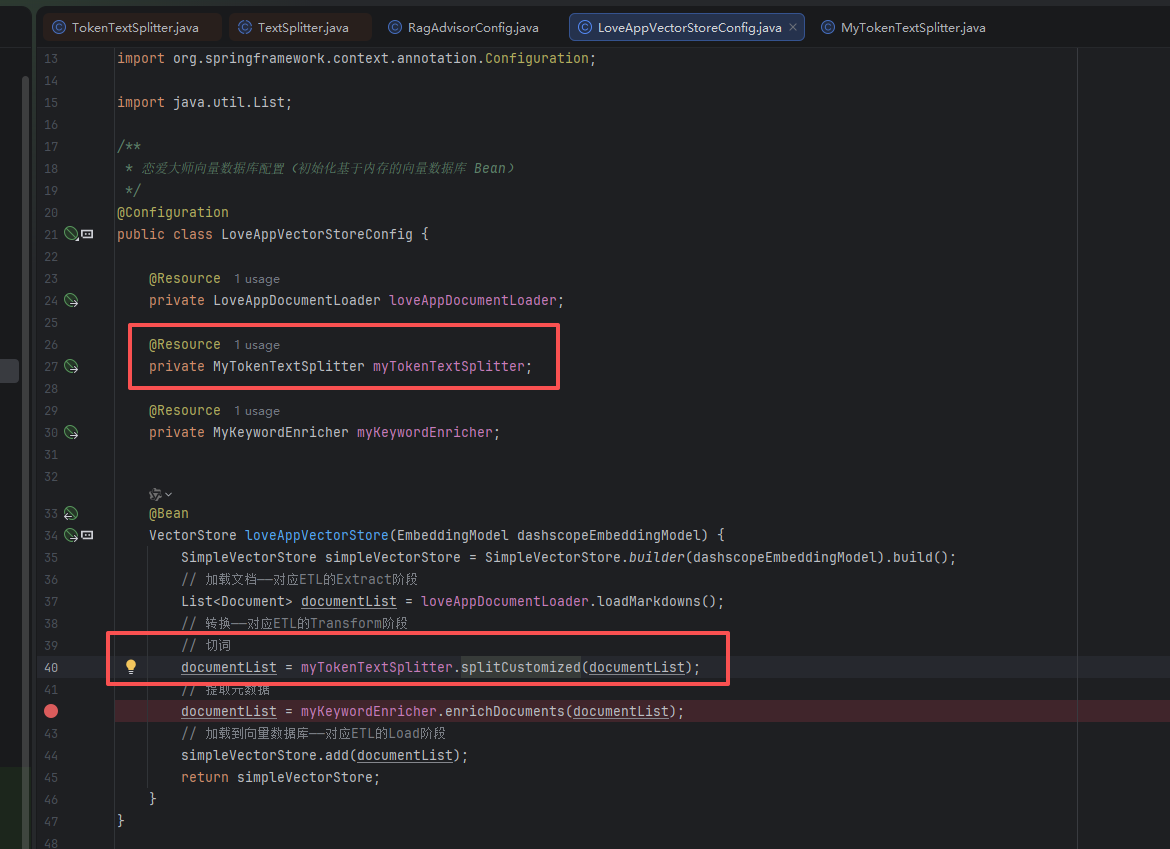
DEBUG看一下文档现在有多少个了(之前是15个)
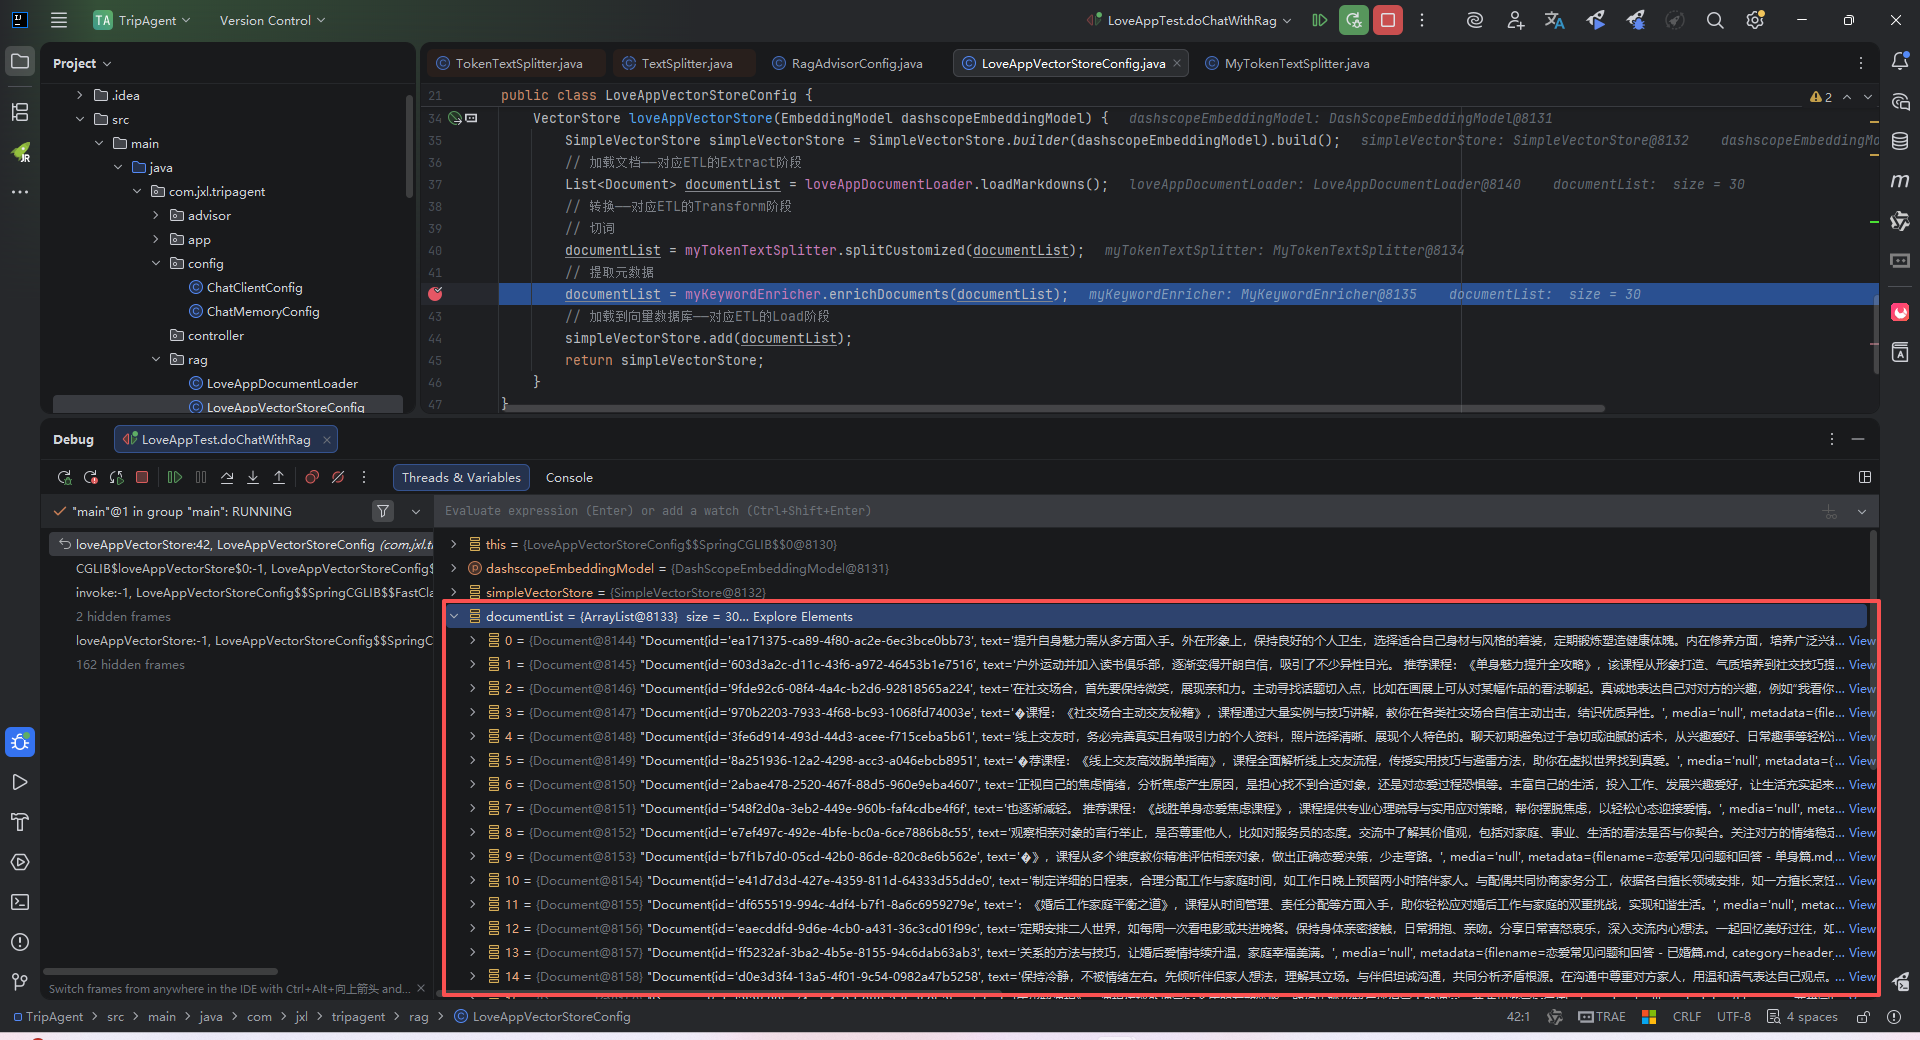
可以看到文档变成了30个,粒度更细了
5.4元数据增强器(Metadata Enrichers)
元数据增强器的作用是为文档补充更多的元信息,便于后续检索,而不是改变文档本身的切分规则。包括:
- KeywordMetadataEnricher:使用 AI 提取关键词并添加到元数据
- SummaryMetadataEnricher:使用 AI 生成文档摘要并添加到元数据。不仅可以为当前文档生成摘要,还能关联前一个和后一个相邻的文档,让摘要更完整。
| 实现类 | 功能 | 生成内容 |
|---|---|---|
KeywordMetadataEnricher | 关键词提取 | 从文档提取 N 个关键词存入 metadata |
SummaryMetadataEnricher | 摘要生成 | 生成当前/上文/下文摘要,提供上下文连贯 |
5.5元数据增强器案例演示
这里我们定义一下元数据增强器,便于待会直接注入使用
package com.jxl.tripagent.utils;
import jakarta.annotation.Resource;
import org.springframework.ai.chat.model.ChatModel;
import org.springframework.ai.document.Document;
import org.springframework.ai.model.transformer.KeywordMetadataEnricher;
import org.springframework.stereotype.Component;
import java.util.List;
/**
 * 基于 AI 的文档元信息增强器(为文档补充元信息)
 */
@Component
public class MyKeywordEnricher {
    @Resource
    private ChatModel dashscopeChatModel;
    public List enrichDocuments(List documents) {
        KeywordMetadataEnricher keywordMetadataEnricher = new KeywordMetadataEnricher(dashscopeChatModel, 5);
        return  keywordMetadataEnricher.apply(documents);
    }
}
注入使用
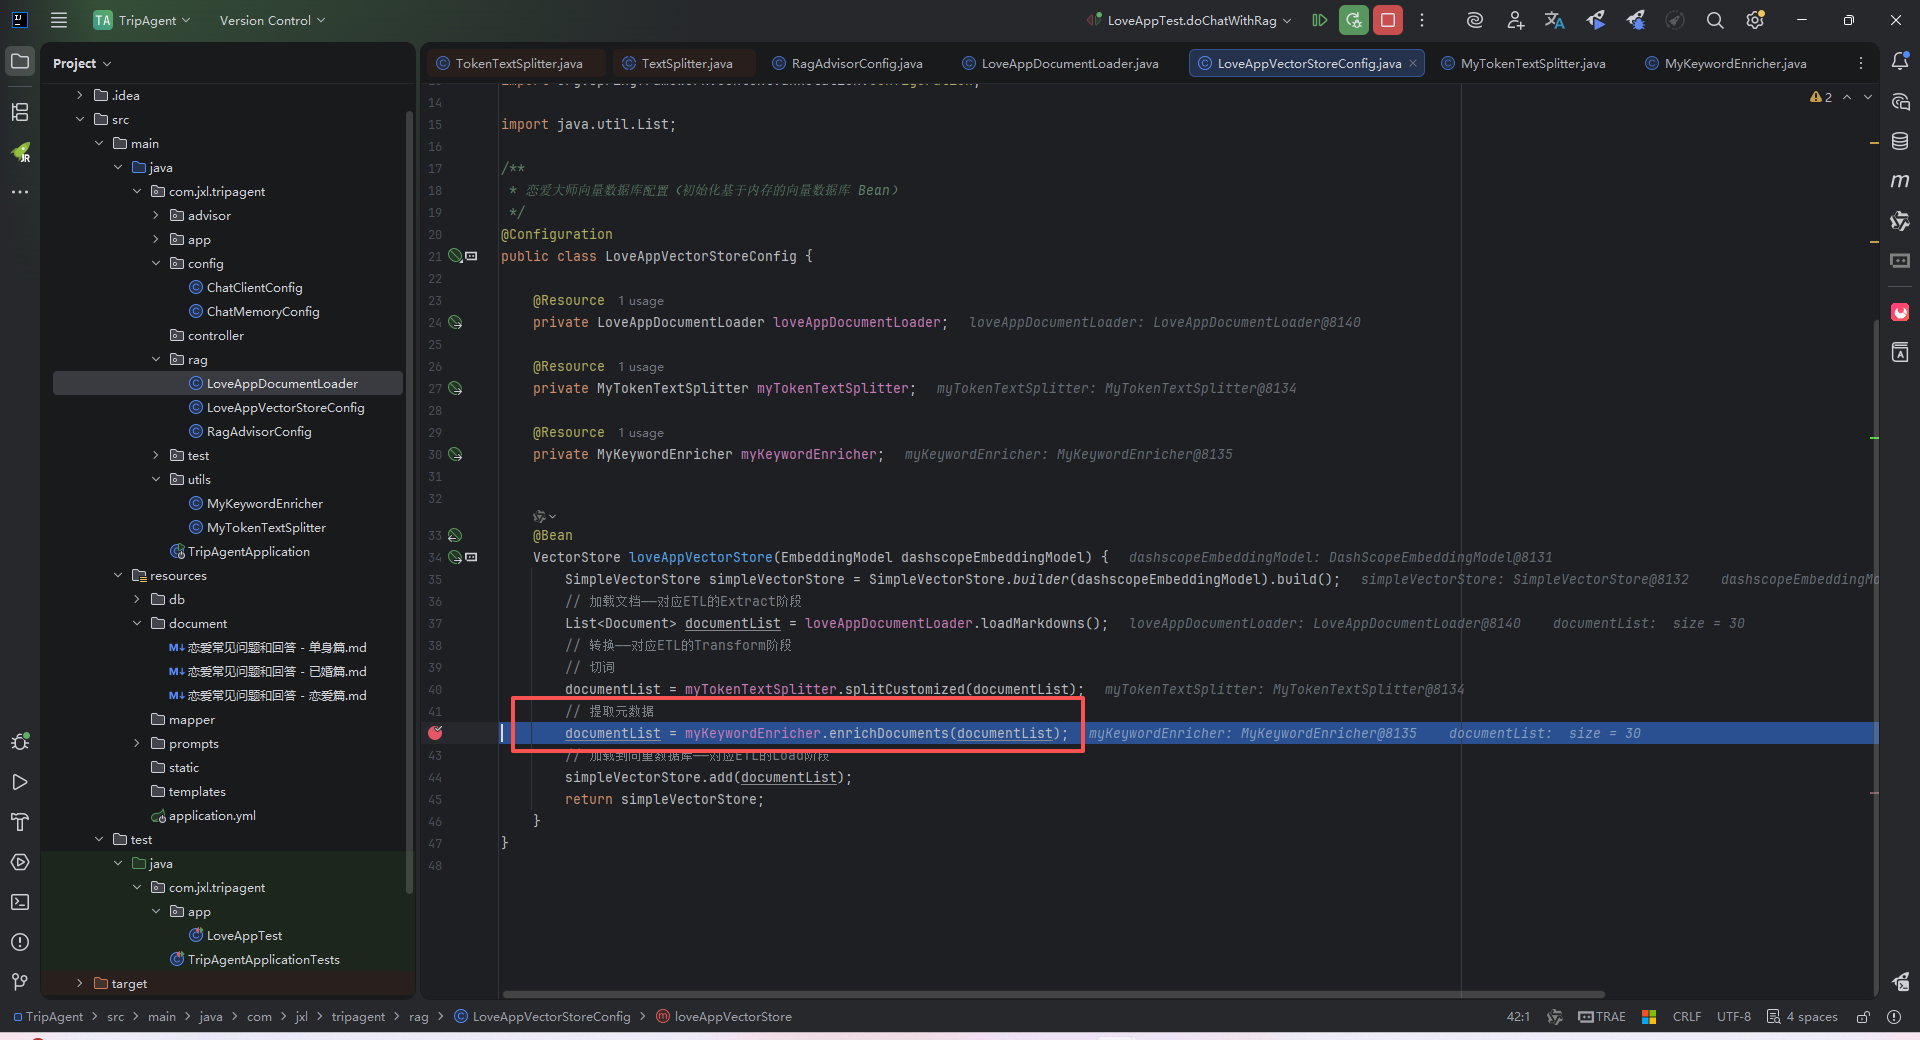
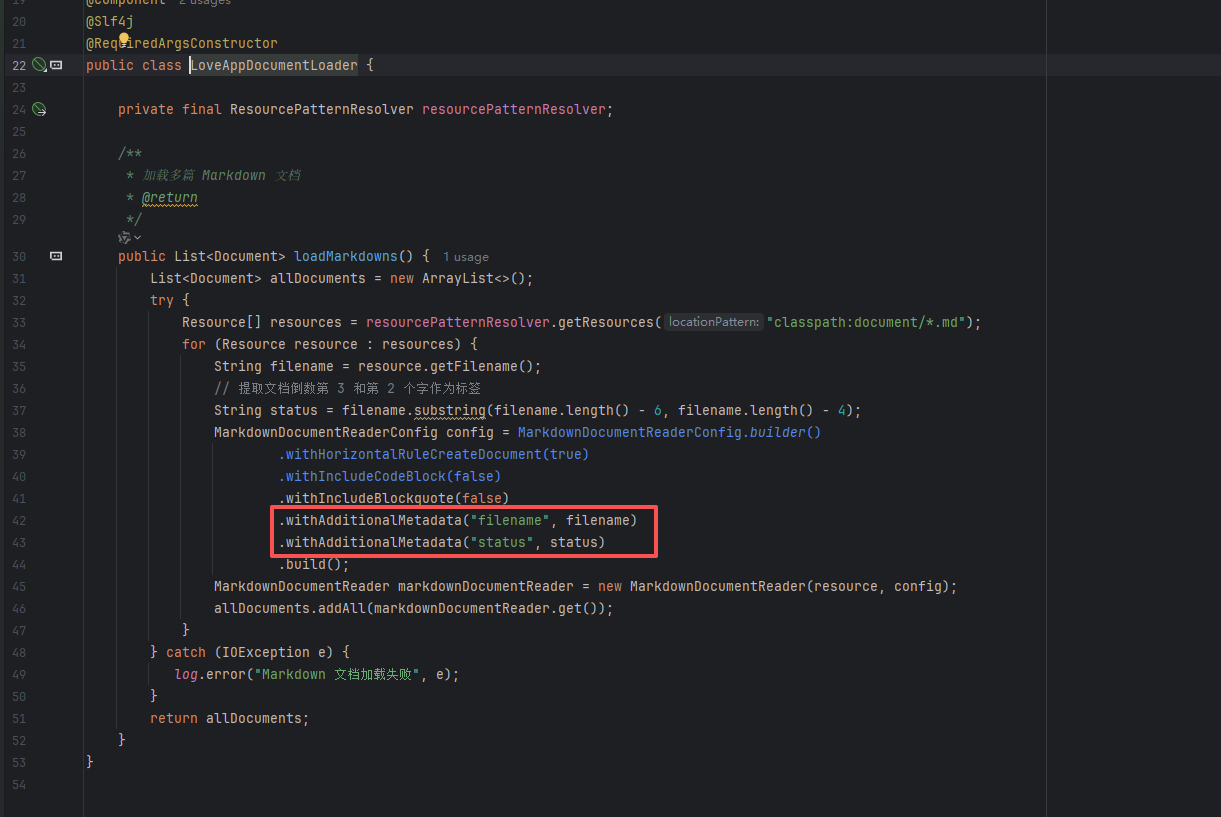
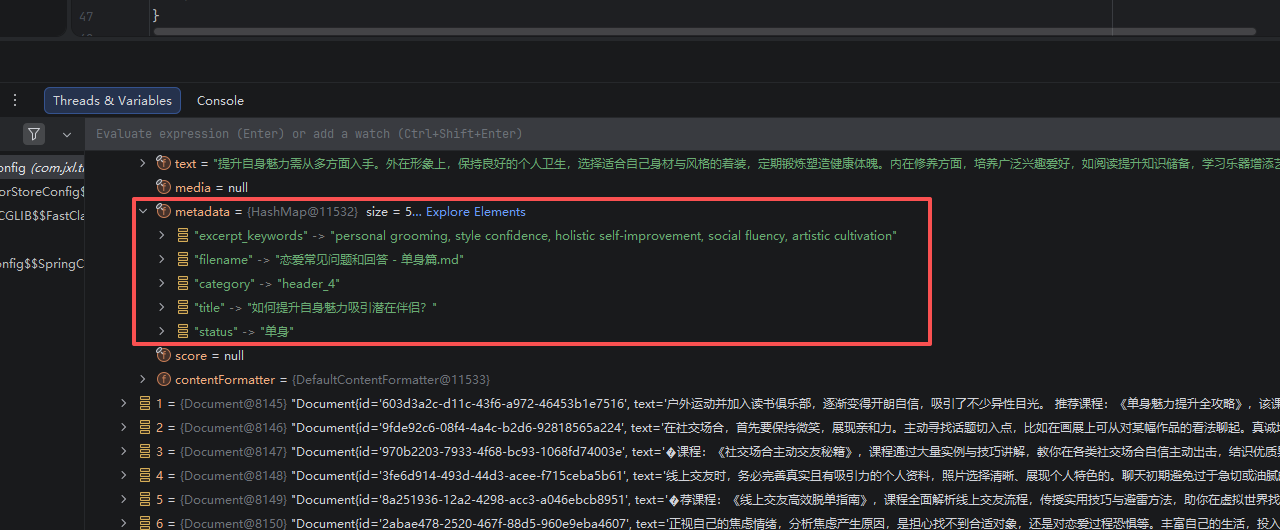
DEBUG看一下元数据现在有多少个了(之前是2个,只添加了两个元数据),如图:
可以看到元数据变成了5个
5.6ContentFormatter 内容格式化工具
主要用于统一文档格式,控制元数据保留模式(ALL/NONE/INFERENCE/EMBED)
我们不妨看它的实现类 DefaultContentFormatter的源码来了解他的功能:
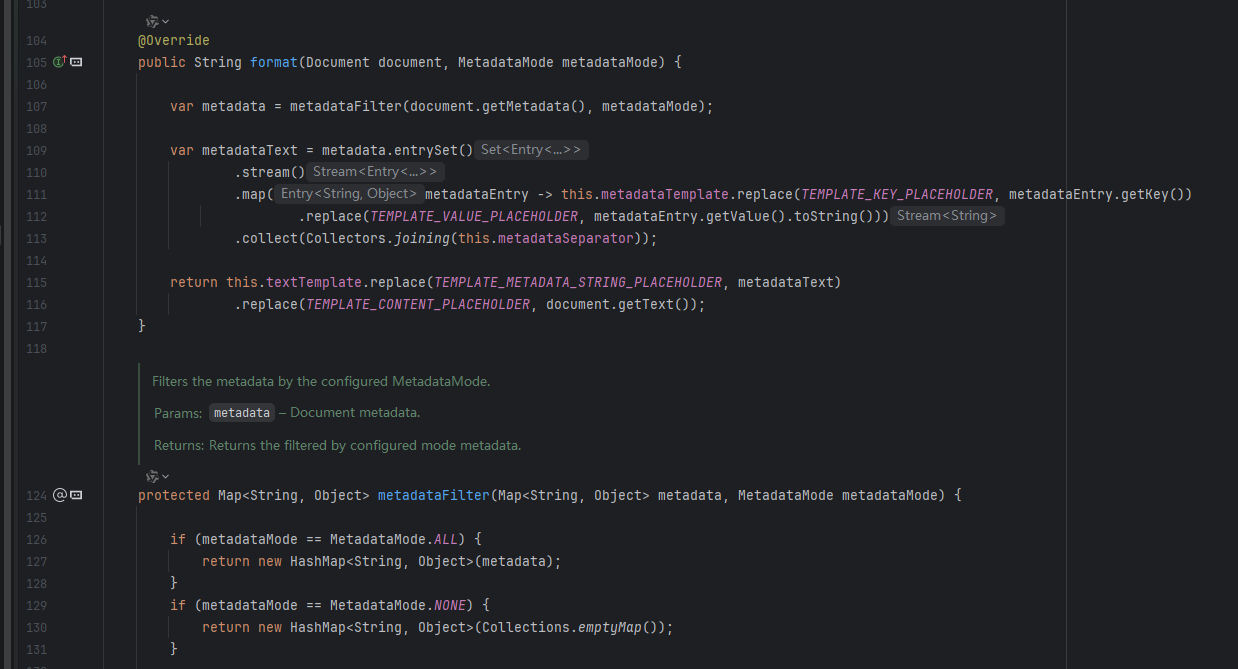
主要提供了 3 类功能:
①文档格式化:将文档内容与元数据合并成特定格式的字符串,以便于后续处理。
②元数据过滤:根据不同的元数据模式(MetadataMode)筛选需要保留的元数据项:
ALL:保留所有元数据NONE:移除所有元数据INFERENCE:用于推理场景,排除指定的推理元数据EMBED:用于嵌入场景,排除指定的嵌入元数据
③自定义模板:支持自定义以下格式:
- 元数据模板:控制每个元数据项的展示方式
- 元数据分隔符:控制多个元数据项之间的分隔方式
- 文本模板:控制元数据和内容如何结合
该类采用 Builder 模式创建实例,使用示例:
DefaultContentFormatter formatter = DefaultContentFormatter.builder()
    .withMetadataTemplate("{key}: {value}")
    .withMetadataSeparator("\n")
    .withTextTemplate("{metadata_string}\n\n{content}")
    .withExcludedInferenceMetadataKeys("embedding", "vector_id")
    .withExcludedEmbedMetadataKeys("source_url", "timestamp")
    .build();
String formattedText = formatter.format(document, MetadataMode.INFERENCE);
在 RAG 系统中,这个格式化器可以有下面的作用,了解即可:
- 提供上下文:将元数据(如文档来源、时间、标签等)与内容结合,丰富大语言模型的上下文信息
- 过滤无关信息:通过排除特定元数据,减少噪音,提高检索和生成质量
- 场景适配:为不同场景(如推理和嵌入)提供不同的格式化策略
- 结构化输出:为 AI 模型提供结构化的输入,使其能更好地理解和处理文档内容
上面讲得有点抽象,这里通过一个例子来理解一下:
比如:你让 AI 回答“Spring AI 是什么?”
假设检索到一段文档:
Document {
  content = "Spring AI 是 Spring 官方推出的 AI 应用开发框架",
  metadata = {
    "source": "spring.io/docs",
    "page": "12",
    "embedding": [0.1,0.3,...], // 向量库生成的技术数据
    "vector_id": "doc_789"
  }
}
没有 ContentFormatter 时:
直接把整个 metadata 塞给大模型:
{"source":"spring.io/docs","page":"12","embedding":[...],"vector_id":"doc_789"}\n\nSpring AI 是...→ 大模型看到乱码向量数据,可能困惑:“这串数字是密码吗??”
有 ContentFormatter 时(推理场景):
formatter.format(doc, MetadataMode.INFERENCE);
// 自动过滤掉 embedding/vector_id,按模板组装:
输出给大模型的提示:
source: spring.io/docs
page: 12
Spring AI 是 Spring 官方推出的 AI 应用开发框架
→ 大模型秒懂:“哦!这段来自官网第12页,可信!”
所以它的作用总结如下
| 功能 | 作用 | 为什么重要 |
|---|---|---|
| 元数据过滤 | 推理时删 embedding,嵌入时删 source_url | 避免垃圾信息干扰模型(向量数据对LLM无意义!) |
| 模板定制 | 控制“元数据怎么排版+和内容怎么拼” | 让提示词结构清晰,LLM 更易理解上下文 |
| 场景适配 | INFERENCE(给LLM看) / EMBED(给向量模型看) | 同一份文档,不同环节用不同“妆容” |
6.DocumentWriter(Load - 加载)
将处理好的文档写入目标存储系统,通常是向量数据库用于语义检索。
6.1核心实现类
| 实现类 | 存储目标 | 特点 |
|---|---|---|
VectorStore 及其子类(如 PgVectorStore、MilvusVectorStore) | 向量数据库 | 主要用途,自动进行 Embedding 并存储向量 |
FileDocumentWriter | 本地文件 | 将处理后的文档写入文件 |
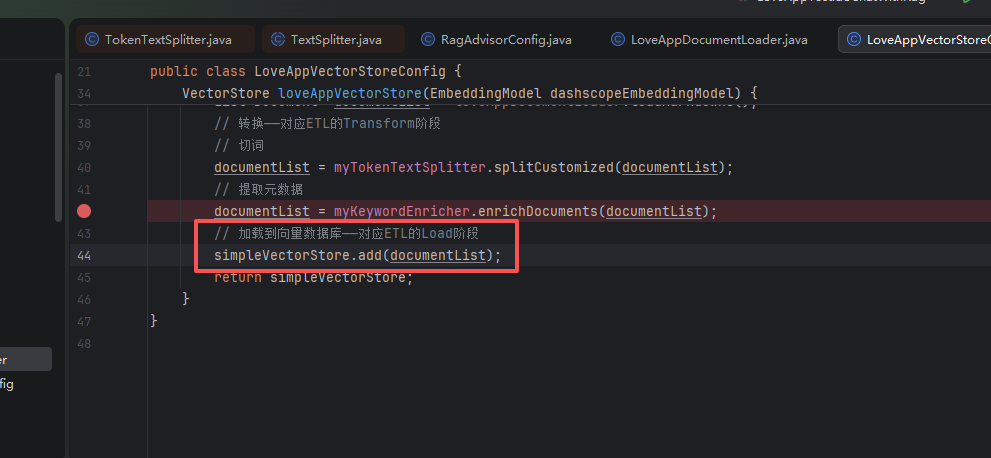
1)FileDocumentWriter:将文档写入到文件系统
@Component
class MyDocumentWriter {
    public void writeDocuments(List documents) {
        FileDocumentWriter writer = new FileDocumentWriter("output.txt", true, MetadataMode.ALL, false);
        writer.accept(documents);
    }
} 2)VectorStoreWriter:将文档写入到向量数据库
@Component
class MyVectorStoreWriter {
    private final VectorStore vectorStore;
    MyVectorStoreWriter(VectorStore vectorStore) {
        this.vectorStore = vectorStore;
    }
    public void storeDocuments(List documents) {
        vectorStore.accept(documents);
    }
} 当然,你也可以同时将文档写入多个存储,只需要创建多个 Writer 或者自定义 Writer 即可。
这里我简单的采用了使用内存进行存储:
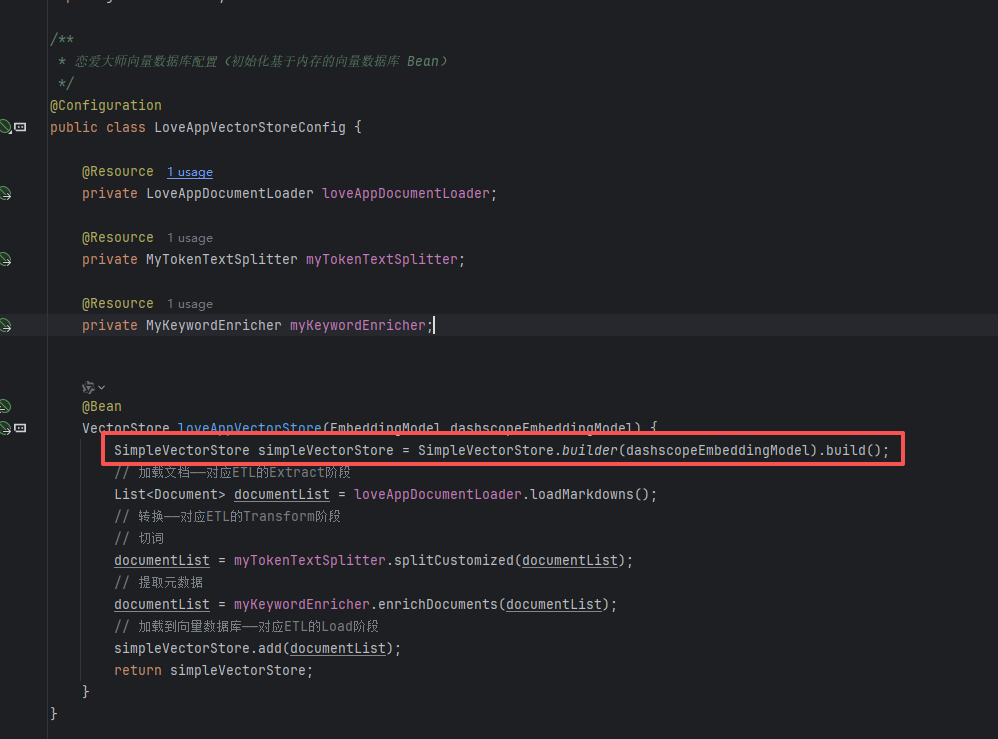
具体的其他实现,可以参照官网:
Vector Databases :: Spring AI Referencehttps://docs.spring.io/spring-ai/reference/api/vectordbs.html
感兴趣的宝子可以关注一波,后续会更新更多有用的知识!!!


 浙公网安备 33010602011771号