在机器学习的世界里,分类问题无处不在——从垃圾邮件过滤到金融风控,从医疗诊断到广告点击预测。当我们需要一个不仅能够做出分类决策,还能给出概率解释的模型时,逻辑回归(Logistic Regression)往往是第一个被想到的经典算法。它虽然名字中带有“回归”,实则是解决二分类问题的利器,以其良好的可解释性、高效的计算性能和坚实的概率论基础,成为数据科学家和算法工程师工具箱中的必备武器。本文将深入剖析逻辑回归的核心原理,完成从模型定义到参数更新的完整推导,并探讨其在现代开发栈(如Python、Java等)中的实践要点。
1. 模型核心:Sigmoid函数与概率映射
逻辑回归的核心思想,是解决线性回归直接用于分类时的根本缺陷。线性回归的输出是连续值,而分类需要离散的类别标签(通常是0或1)。如果简单地对线性回归的结果设置一个阈值(如0.5)进行硬截断,会带来两个严重问题:首先,输出值没有概率意义,我们无法知道模型对这次预测的“确信程度”;其次,模型对异常值非常敏感,一个极端的样本就可能大幅扭曲整个决策边界。
逻辑回归的巧妙之处在于引入了Sigmoid函数(也称Logistic函数),将线性组合 $z = w^Tx + b$ 的输出映射到(0,1)区间,并将其解释为样本属于正类的概率。Sigmoid函数的数学形式为 $\sigma(z) = \frac{1}{1+e^{-z}}$,它具有完美的S型曲线,将整个实数域平滑地压缩到(0,1)之间。
下图直观展示了Sigmoid函数如何将线性输出转化为概率:
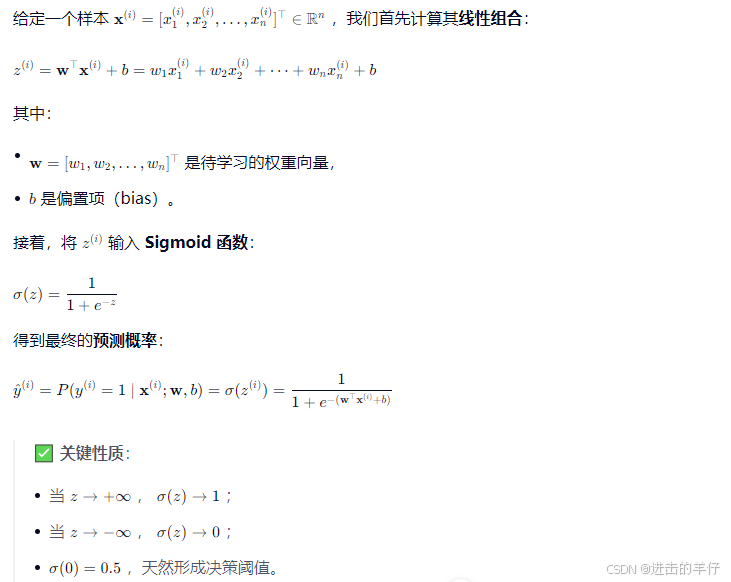
因此,逻辑回归的决策规则可以形式化地定义为:当预测概率 $P(y=1|x) \geq 0.5$ 时,我们预测为正类(1),否则为负类(0)。由于Sigmoid函数在z=0时取值为0.5,这等价于判断线性部分 $z = w^Tx + b$ 是否大于等于0。
决策规则的示意图如下:

在实际工程中,无论是使用Python的Scikit-learn库、Java的Weka、还是Go或TypeScript/JavaScript环境下的机器学习实现,理解这一概率映射过程都是正确应用和调试模型的基础。[AFFILIATE_SLOT_1]
2. 损失函数:交叉熵损失的最大似然解释
定义了模型如何输出概率后,下一个关键问题是:如何衡量模型预测的好坏?我们需要一个损失函数来量化预测概率与真实标签之间的差距。对于分类问题,最自然且理论完备的选择是交叉熵损失(Cross-Entropy Loss),它源于概率论中的最大似然估计(Maximum Likelihood Estimation, MLE)原理。
首先,我们可以将逻辑回归对一个样本的预测写成一个统一的概率表达式:
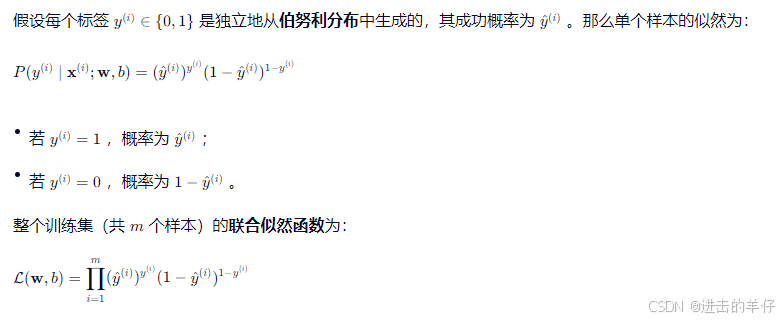
这个式子巧妙地利用了指数项,使得当y=1时,后半部分为1,概率等于 $\hat{y}$;当y=0时,前半部分为1,概率等于 $1-\hat{y}$。对于包含m个样本的整个训练集,我们假设所有样本独立同分布,那么模型产生当前观测到的这组标签的似然函数(Likelihood)就是每个样本概率的连乘:
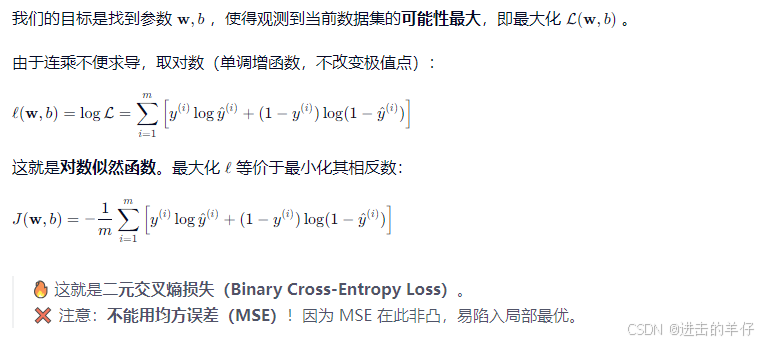
我们的目标是找到一组参数(w, b),使得这个似然函数的值最大,即“当前观测到的数据最有可能发生”。为了计算方便,通常对似然函数取对数,将连乘转化为连加,得到对数似然函数。最大化对数似然等价于最小化其负值,而这个负对数似然正是我们熟悉的二元交叉熵损失函数:
- 为什么不用均方误差(MSE)? 对于分类问题,MSE作为损失函数是非凸的,存在许多局部最优点,不利于优化。而交叉熵损失是凸函数,能保证梯度下降找到全局最优解。
- 信息论视角: 交叉熵衡量的是真实分布与预测分布之间的“距离”。最小化交叉熵就是让模型的预测分布尽可能接近真实的数据分布。
在TensorFlow(Python)、Spark MLlib(Java/Scala)或各种深度学习框架中,交叉熵损失都是分类任务的标准配置。理解其最大似然根源,有助于在遇到类别不平衡等复杂场景时,能够灵活调整或自定义损失函数。
3. 梯度推导:链式法则下的参数更新公式
定义了凸的损失函数后,我们就可以使用梯度下降(Gradient Descent)及其变种(如随机梯度下降SGD、Adam等)来优化模型参数。关键在于计算出损失函数关于每个参数(权重w和偏置b)的梯度。推导过程是应用链式法则的经典范例。
我们首先回顾一下计算图和各部分符号。对于单个样本,前向传播过程为:

我们的目标是从损失 $\mathcal{L}$ 开始,反向传播误差,计算梯度 $\frac{\partial \mathcal{L}}{\partial w_j}$ 和 $\frac{\partial \mathcal{L}}{\partial b}$。根据链式法则,我们需要先计算损失对Sigmoid输出 $\hat{y}$ 的导数,再计算 $\hat{y}$ 对线性输出 $z$ 的导数,最后计算 $z$ 对参数 $w_j$ 和 $b$ 的导数。
链式法则的路径示意如下:
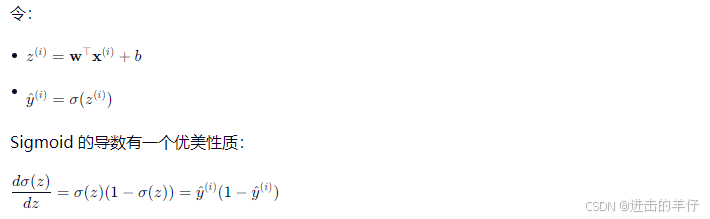
第一步,计算损失 $\mathcal{L}$ 对预测值 $\hat{y}$ 的导数。根据交叉熵损失公式 $\mathcal{L} = -[y \log(\hat{y}) + (1-y)\log(1-\hat{y})]$,求导可得:
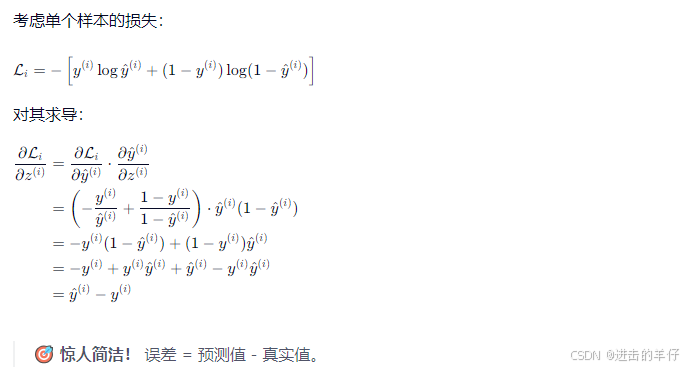
这个结果非常简洁且直观:误差 $(\hat{y} - y)$ 直接体现了预测值与真实值的差距。第二步,计算 $\hat{y}$ 对 $z$ 的导数,即Sigmoid函数的导数。Sigmoid函数有一个很好的性质:$\sigma'(z) = \sigma(z)(1-\sigma(z)) = \hat{y}(1-\hat{y})$。最后,线性部分 $z = w^Tx + b$ 对参数的导数很简单:$\frac{\partial z}{\partial w_j} = x_j$,$\frac{\partial z}{\partial b} = 1$。
将这三步结合起来,就得到了损失函数关于权重和偏置的最终梯度:
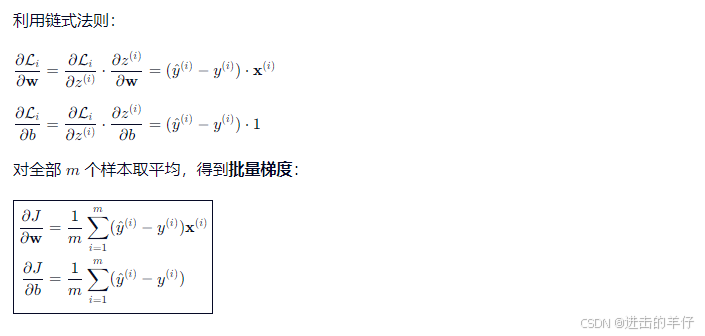
这个结果异常优美且具有启发性:参数w_j的梯度等于特征值x_j乘以预测误差 $(\hat{y} - y)$。误差越大,梯度越大,参数更新幅度也越大;同时,梯度方向与特征值相关。偏置b的梯度就是误差本身。这种简洁的形式是逻辑回归及其扩展(如神经网络)能够高效训练的关键。
4. 实践要点:从理论到代码的跨越
理解了理论推导后,将其转化为实际可运行的代码是最后一步。无论是用Python的NumPy进行手写实现以加深理解,还是在生产环境中调用高度优化的库,都需要注意以下关键点:
- 参数初始化: 通常将权重w初始化为小的随机数(如从均值为0、标准差为0.01的正态分布中采样),偏置b初始化为0。在Python中,可以使用
np.random.randn() * 0.01。 - 学习率选择: 学习率 $\alpha$ 是梯度下降最重要的超参数之一。太大可能导致震荡甚至发散,太小则收敛缓慢。通常需要根据经验或使用学习率衰减策略、自适应优化器(如Adam)来调整。
- 特征缩放: 逻辑回归虽然不像基于距离的模型(如KNN、SVM)那样严格要求特征尺度一致,但进行归一化(如缩放到[0,1])或标准化(均值为0,方差为1)可以显著加快梯度下降的收敛速度。
- 正则化: 为了防止过拟合,几乎总是在损失函数中加入正则化项。L1正则化(Lasso)可以产生稀疏解,用于特征选择;L2正则化(Ridge)则使权重平滑衰减,更为常用。Scikit-learn中的逻辑回归默认使用L2正则化。
- 多分类扩展: 逻辑回归本质是二分类器。对于多分类问题(K类),常用Softmax回归(多项逻辑回归)或“一对多”(One-vs-Rest)策略。Softmax可以看作是Sigmoid函数在多分类上的自然推广。
一个简化的批量梯度下降更新步骤伪代码如下:for epoch in range(num_epochs):
z = X.dot(w) + b # 线性部分
y_hat = sigmoid(z) # 激活函数
error = y_hat - y # 计算误差
dw = (1/m) * X.T.dot(error) # 权重梯度
db = (1/m) * np.sum(error) # 偏置梯度
w = w - learning_rate * dw # 更新权重
b = b - learning_rate * db # 更新偏置
[AFFILIATE_SLOT_2]
总结与展望
逻辑回归以其清晰的概率解释、高效的优化过程和优秀的基线性能,在机器学习领域经久不衰。本文完整地走过了逻辑回归的旅程:从Sigmoid函数解决概率映射问题,到基于最大似然估计推导出交叉熵损失,再到通过链式法则得到简洁优雅的梯度公式,最后探讨了工程实践中的关键要点。尽管深度学习模型如今大放异彩,但逻辑回归仍然是构建可解释性强、部署简单的分类系统的首选,也是理解更复杂模型(如神经网络)的基石。掌握其背后的数学原理,将使你无论使用Python、Java、Go还是TypeScript进行开发,都能更加自信和高效地解决实际的分类问题。


 浙公网安备 33010602011771号