在人工智能领域,文档理解一直是一个兼具实用性与挑战性的课题。近日,DeepSeek团队开源了其第二代OCR模型——DeepSeek-OCR 2,它不仅再次刷新了多项性能基准,更在核心架构上做出了一次颠覆性的革新:让语言模型来“看”图。这标志着文档处理正从传统的“光学字符识别”迈向更智能的“内容结构理解”。
一、架构革命:当语言模型成为“视觉编码器”
传统OCR模型通常遵循一个清晰的视觉-文本处理流水线:先用视觉模型(如CLIP、ViT)提取图像特征,再将特征转换为文本。然而,DeepSeek-OCR 2打破了这一范式,它做出了一个大胆的结构性改变:用语言模型架构替换了传统的视觉编码器。
这意味着什么?简单来说,模型不再仅仅是“看到”图像,而是开始尝试“理解”图像。就像人类阅读文档时,我们会自然地关注标题、段落、图表等结构性元素,并按照逻辑顺序浏览。OCR 2通过引入语言模型的因果注意力机制,让AI也具备了这种“选择性关注”和“顺序理解”的能力。
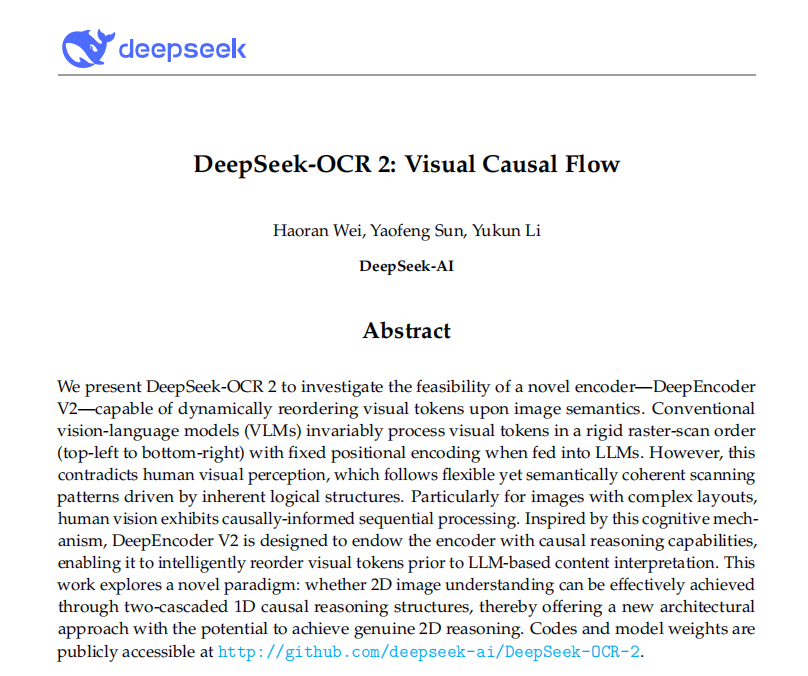
上图直观展示了OCR 2带来的视觉冲击。其核心在于引入了“因果流查询(Causal Flow Query)”机制。模型在“阅读”图像时,不再是机械地、无差别地扫描每一个像素块(Patch),而是像人类一样,看完一个区域后,动态决定下一个应该关注哪里。这种从“并行处理”到“序列化理解”的转变,是本次升级的灵魂。
二、技术核心:动态Token压缩与自适应感知
一张高分辨率图像(如1280×1280)被分割成16×16的小块后,会产生多达6400个视觉Token。这对于后续的语言模型来说是难以承受的计算负担。OCR 2的解决方案是一套精巧的动态Token压缩流程。
其流程可以概括为以下几步:
- 初步感知:使用ViTDet编码器对整张图像进行编码,生成完整的视觉Token图谱。
- 智能压缩:通过一个由CNN和Channel Mixer组成的Token Merging模块,将Token数量压缩至原始的1/16。
- 信息保留:加入位置编码和层归一化,形成紧凑且富含关键信息的Token序列。
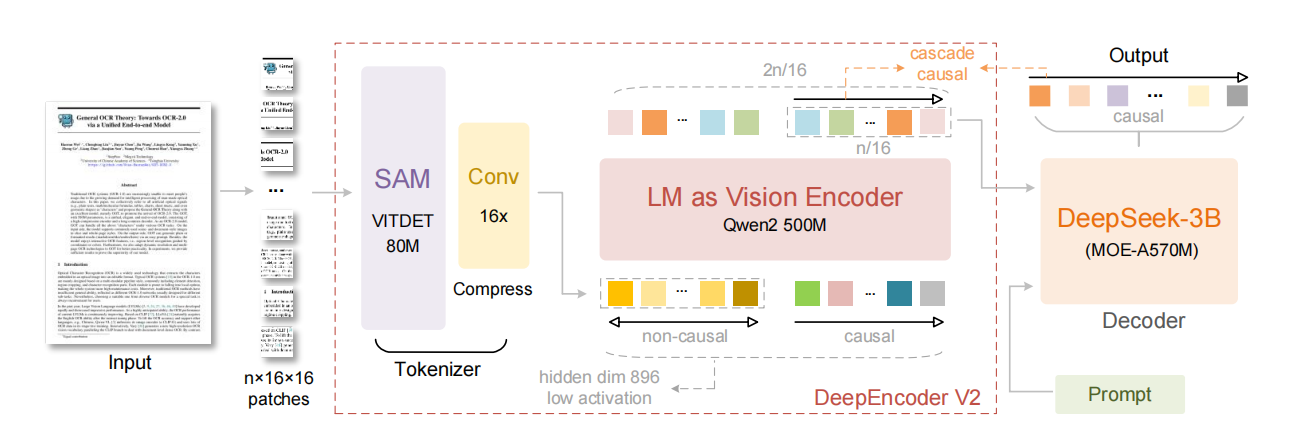
最终,每张图像最多只输出512个视觉Token。相比OCR 1的1156个和Gemini的1120个,这不仅大大减少了计算量,而且通过自适应机制,模型能智能判断哪些区域信息密集(如正文、表格),哪些相对次要(如纯色背景),从而在压缩过程中保留最重要的信息。这种“取其精华”的能力,是高效理解的前提。[AFFILIATE_SLOT_1]
三、范式对比:OCR 2与主流模型的本质差异
为了更清晰地理解OCR 2的创新之处,我们可以将其与主流文档理解模型进行对比:
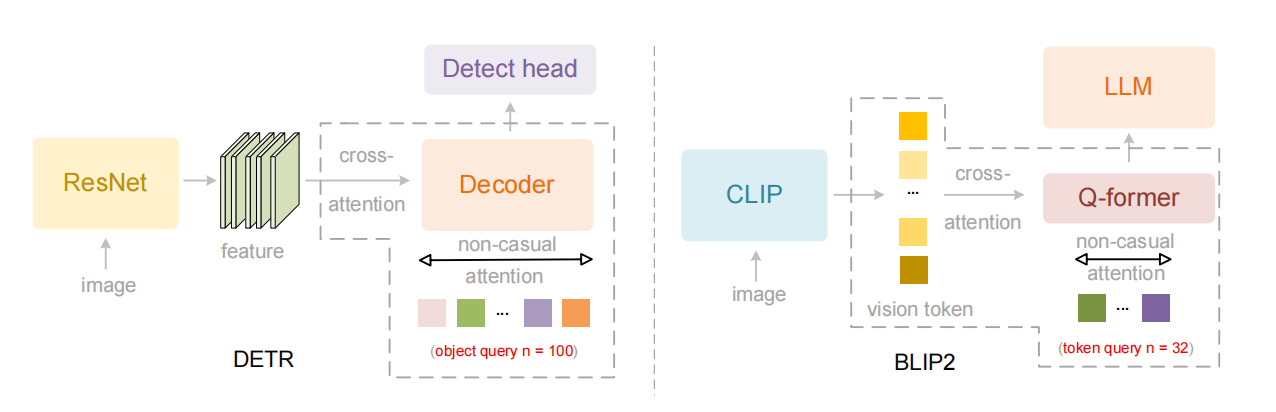
- 传统DETR架构:依赖固定数量的查询向量(如100个)去“抓取”图中的物体或文本区域,它不关心阅读顺序,是一种并行的、目标驱动的检测范式。
- BLIP-2等VLM架构:使用Q-Former作为桥梁,从海量图像Token中筛选出有代表性的子集,再馈送给语言模型。它做了信息过滤,但过滤过程本身并非序列化或因果的。
- DeepSeek-OCR 2:直接让语言模型(Qwen2)担任“第一理解者”。它生成动态的阅读查询,引导视觉编码器按顺序、有重点地“观看”图像,最后由一个较小的生成模型(如DeepSeek-3B)输出结构化结果。
项目地址:https://github.com/deepseek-ai/DeepSeek-OCR-2
模型地址:
https://huggingface.co/deepseek-ai/DeepSeek-OCR-2
论文地址:https://github.com/deepseek-ai/DeepSeek-OCR-2/blob/main/DeepSeek_OCR2_paper.pdf
这种“LM as Vision Encoder”的设计,使得模型在处理复杂版式(如双栏、图文混排、表格)时,能更好地模拟人类的阅读路径,从根本上减少顺序错乱导致的语义错误。
四、性能飞跃:数据背后的实力证明
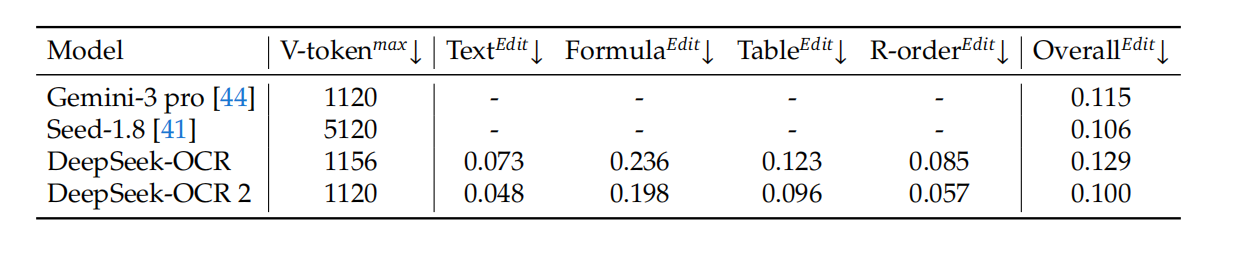
任何架构创新都需要硬核的性能指标来验证。在权威的OmniDocBench v1.5基准测试中,DeepSeek-OCR 2交出了一份令人瞩目的答卷。
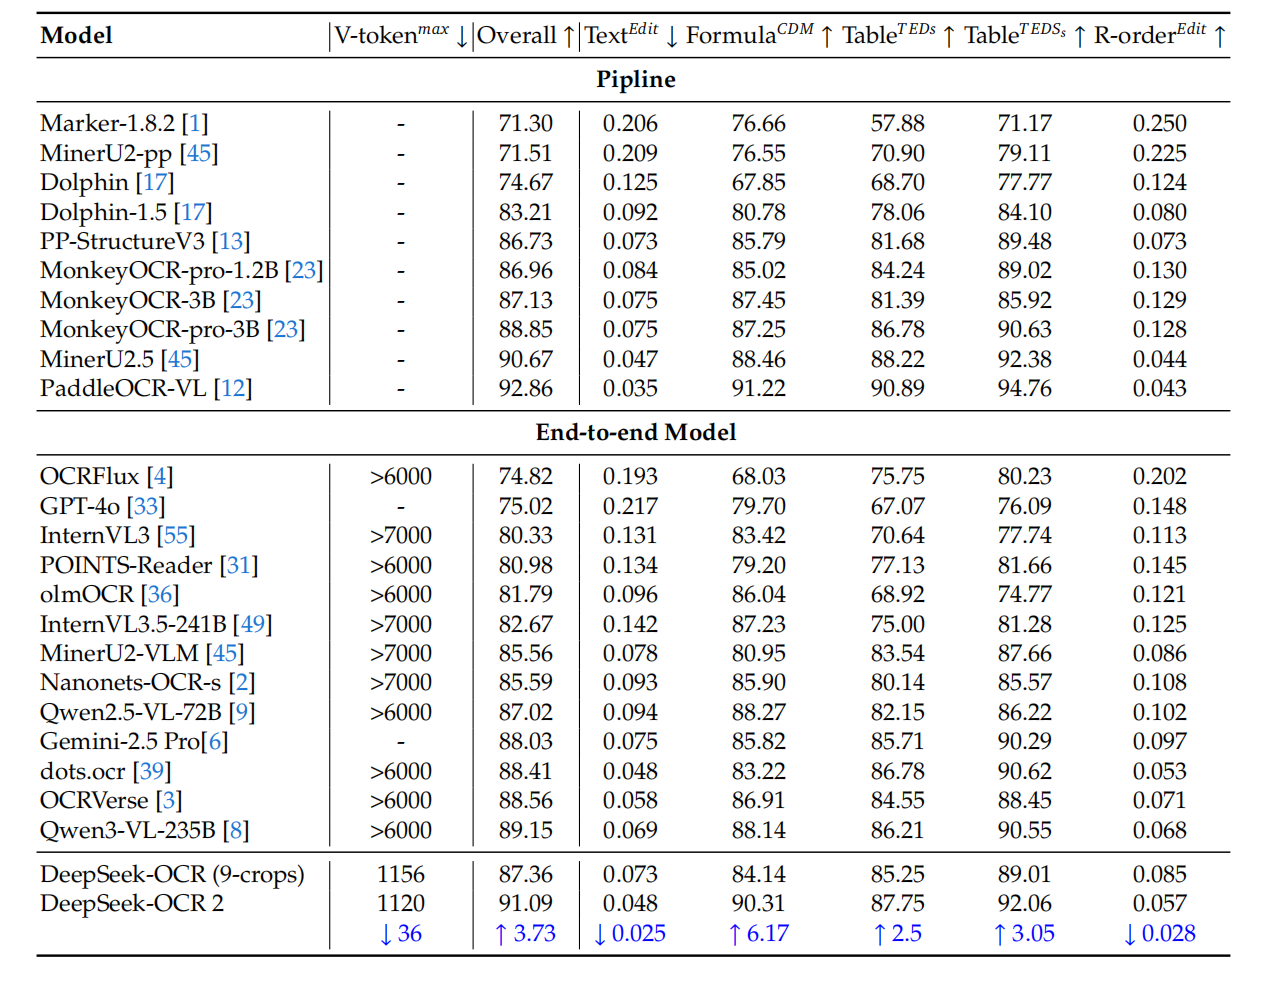
如图所示,OCR 2是唯一一个在视觉Token数不超过1120的限制下,全面超越所有使用更多Token的“大模型”的选手。与上一代相比,其整体准确率提升了3.73%,这是一个在SOTA水平上显著的进步。
更值得关注的是其在“阅读顺序识别”这一核心任务上的表现。衡量顺序错误的R-order Edit分数从0.085大幅降至0.057,误差率下降了约33%。这对于实际应用至关重要,因为顺序错误比单纯的字符错误更难发现,且对下游的信息抽取、知识库构建等任务破坏性更大。
五、从“字符”到“内容”:重新定义OCR的价值边界
DeepSeek-OCR 2的推出,促使我们重新思考OCR技术的终极目标。传统OCR的使命是“把图像中的文字准确地提取出来”,其终点是文本字符串。然而,在真实的办公、研究和出版场景中,文档的价值远不止于字符本身。
一份文档是标题、段落、列表、引用、图表、脚注、页眉页脚等元素构成的有机整体。这些元素的层级关系和空间布局,共同决定了文档的语义和阅读逻辑。传统OCR输出一串“正确但无序”的文本后,用户往往还需要进行繁琐的后期编辑和重组。
OCR 2所代表的下一代技术,其目标是“把图像变成可直接使用的内容”。它输出的不仅仅是文字,更是附带结构、顺序和关系的信息。这使得处理结果能够无缝接入后续的检索系统、知识图谱或内容管理系统,极大提升了自动化流程的效率和可靠性。[AFFILIATE_SLOT_2]
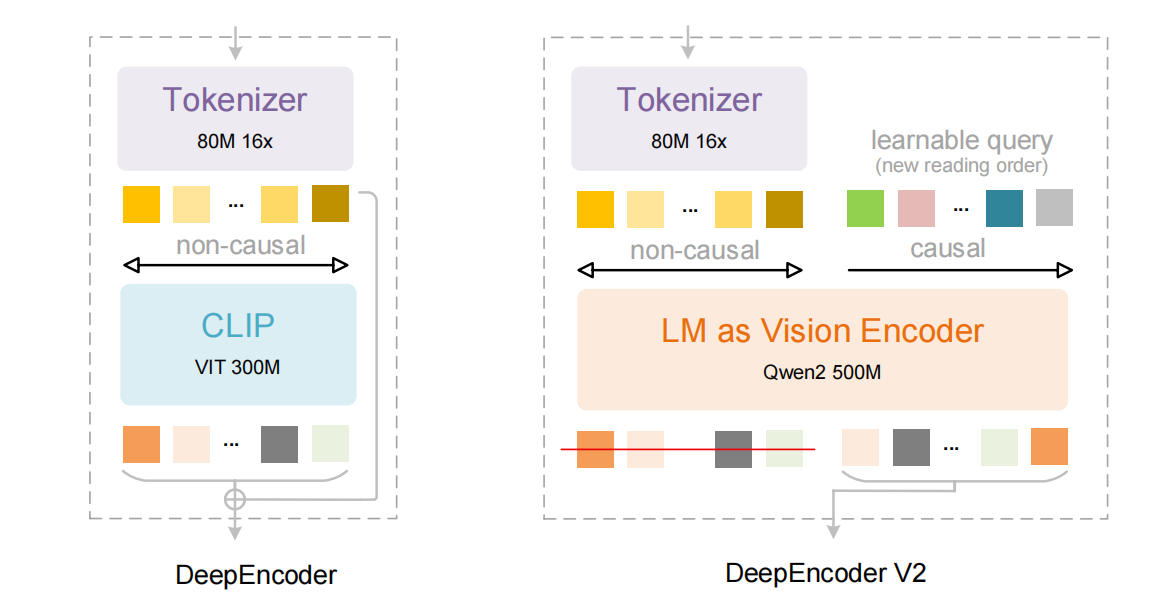
上图左右架构的对比,正是这种理念转变的缩影:从专注于“还原像素”的扫描仪,进化为能够“理解版面”的智能助手。
六、开源与未来:对开发者生态的影响
DeepSeek再次坚持开源路线,将OCR 2的代码、模型权重及相关工具链向社区开放。这对于广大开发者和研究者而言是一个重大利好:
- 降低门槛:企业和个人开发者可以免费获取顶尖的文档理解能力,集成到自己的产品中。
- 促进创新:开放的架构允许社区在其基础上进行微调、改进或应用于新的垂直领域(如古籍识别、医疗报告分析、财务报表解析)。
- 推动标准:一个强大的开源基准模型,有助于推动整个文档AI领域评估标准和任务定义的发展。
展望未来,文档理解AI的发展方向将更加侧重于多模态深度理解、逻辑推理和知识关联。OCR 2在“阅读顺序”上的突破只是一个开始。我们期待看到模型不仅能读懂版面,还能理解表格中的数值关系、图表中的趋势含义,以及跨页的引用逻辑,真正实现像专家一样“阅读”文档。
总结
DeepSeek-OCR 2通过一场架构革命,将文档理解提升到了新的高度。它用语言模型替代传统视觉编码器,赋予了AI“顺序阅读”的类人能力;通过动态Token压缩技术,在效率与精度间取得了卓越平衡。其性能在多项基准测试中达到SOTA,尤其大幅降低了顺序识别错误。这标志着OCR技术正从单纯的“字符识别”迈向真正的“内容与结构理解”,为自动化办公、数字图书馆和知识管理等领域打开了新的想象空间。开源的策略将进一步加速这一技术的普及与创新。


 浙公网安备 33010602011771号