DeepSeek发布了OCR模型,正好公司最近有新的需求,要在PDF中识别固定的内容,所以就要试试,主要看速度,之前一直在使用MonkeyOCR,也是个3B的模型,速度速度平均1秒1页,也很快。

下载模型
刚看到消息的时候,就在modelscope中下载了模型,模型自行下载吧:https://www.modelscope.cn/models/deepseek-ai/DeepSeek-OCR
运行模型
- 模型的README文件中写了部署的方式,我选择了使用vllm的形式跑,参考网址:
https://github.com/deepseek-ai/DeepSeek-OCR - 按照原文的步骤,开始执行,先创建conda虚拟环境,这步骤正常操作

# 下载运行的项目 git clone https://github.com/deepseek-ai/DeepSeek-OCR.git # 创建conda虚拟环境 conda create -n deepseek-ocr python=3.12.9 -y conda activate deepseek-ocr - 下一步是安装包,这里面有点坑。我本地的环境跟官网的例子不一样,管网CUDA版本是:cuda11.8,我本地的版本是:cuda12.4。
- 于是我就按照管网的流程,下载我自己对应版本的包文件
- 下载 vllm-0.8.5:
https://github.com/vllm-project/vllm/releases/download/v0.8.5/vllm-0.8.5+cu121-cp38-abi3-manylinux1_x86_64.whl - 运行相关脚本
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu124 pip install vllm-0.8.5+cu121-cp38-abi3-manylinux1_x86_64.whl pip install -r requirements.txt pip install flash-attn==2.7.3 --no-build-isolation - 安装
flash-attn我遇到了问题,在清华源中下载的都是组件的源码,需要本地编译,但我本地一直编译不过去,页面卡住不动,于是就直接在网上下载编译好的文件,直接安装的,网址:https://github.com/Dao-AILab/flash-attention/releases,我用的是最新版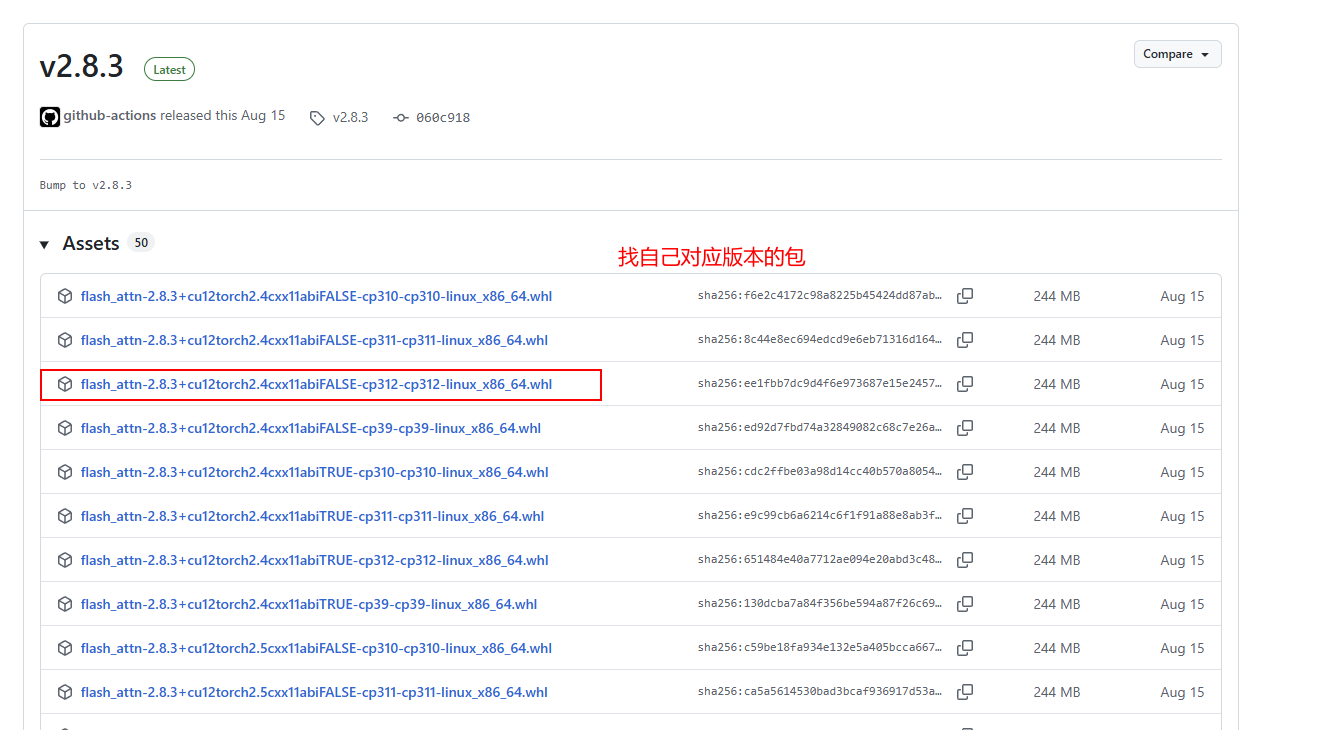
- 下载好了以后,直接安装即可,
pip install flash_attn-2.8.3+cu12torch2.4cxx11abiFALSE-cp312-cp312-linux_x86_64.whl - 全部安装好了以后,就按照官网的流程继续
# 进入到vllm的脚本文件包中 cd DeepSeek-OCR-master/DeepSeek-OCR-vllm # 修改配置文件 ## 主要修改 MODEL_PATH 、INPUT_PATH 、 OUTPUT_PATH 这三个参数 vi config.py - 前面说了,管网的环境是cuda11.8,我本地环境是cuda12.4,所以在执行的脚本中,需要修改cuda的地址:
vi run_dpsk_ocr_pdf.py
替换成本地CUDA的安装路径if torch.version.cuda == '12.4': os.environ["TRITON_PTXAS_PATH"] = "/usr/local/cuda-12.4/bin/ptxas" - 然后就可以正常执行转换脚本了:
python run_dpsk_ocr_pdf.py
测试效果
实测,本地L20显卡,识别1893页的PDF文件,需要17分钟。识别效果还不错。


 浙公网安备 33010602011771号