
树链剖分
熟 练 抛 粪
引入
树链剖分用于将树分割成若干条链的形式,以维护树上路径的信息。
树链剖分(树剖/链剖)有多种形式,如重链剖分,长链剖分和用于 Link/cut Tree 的剖分(有时被称作「实链剖分」)。大多数情况下(没有特别说明时),「树链剖分」都指「重链剖分」。
以上来自 OI wiki,对于这部分内容,需要你有扎实的前置知识,请先去学习 线段树 & 树状数组 相关内容。
简单的说,树链剖分就是通过将树分解成许多条链状结构,这样就从二维转到一维,方便进行处理。
重链剖分
定义
我们先来学习最基础的重链剖分。
这里先给出一些定义(来自 OI wiki):
定义 重子结点 表示其子结点中子树最大的子结点。如果有多个子树最大的子结点,取其一。如果没有子结点,就无重子结点。
定义 轻子结点 表示剩余的所有子结点。
从这个结点到重子结点的边为 重边。
到其他轻子结点的边为 轻边。
若干条首尾衔接的重边构成 重链。
把落单的结点也当作重链,那么整棵树就被剖分成若干条重链。
这些定义我们没必要完全记住,我们只需要记住,一条重链就是由一个头节点,连接了许多个重儿子组成的就好了。
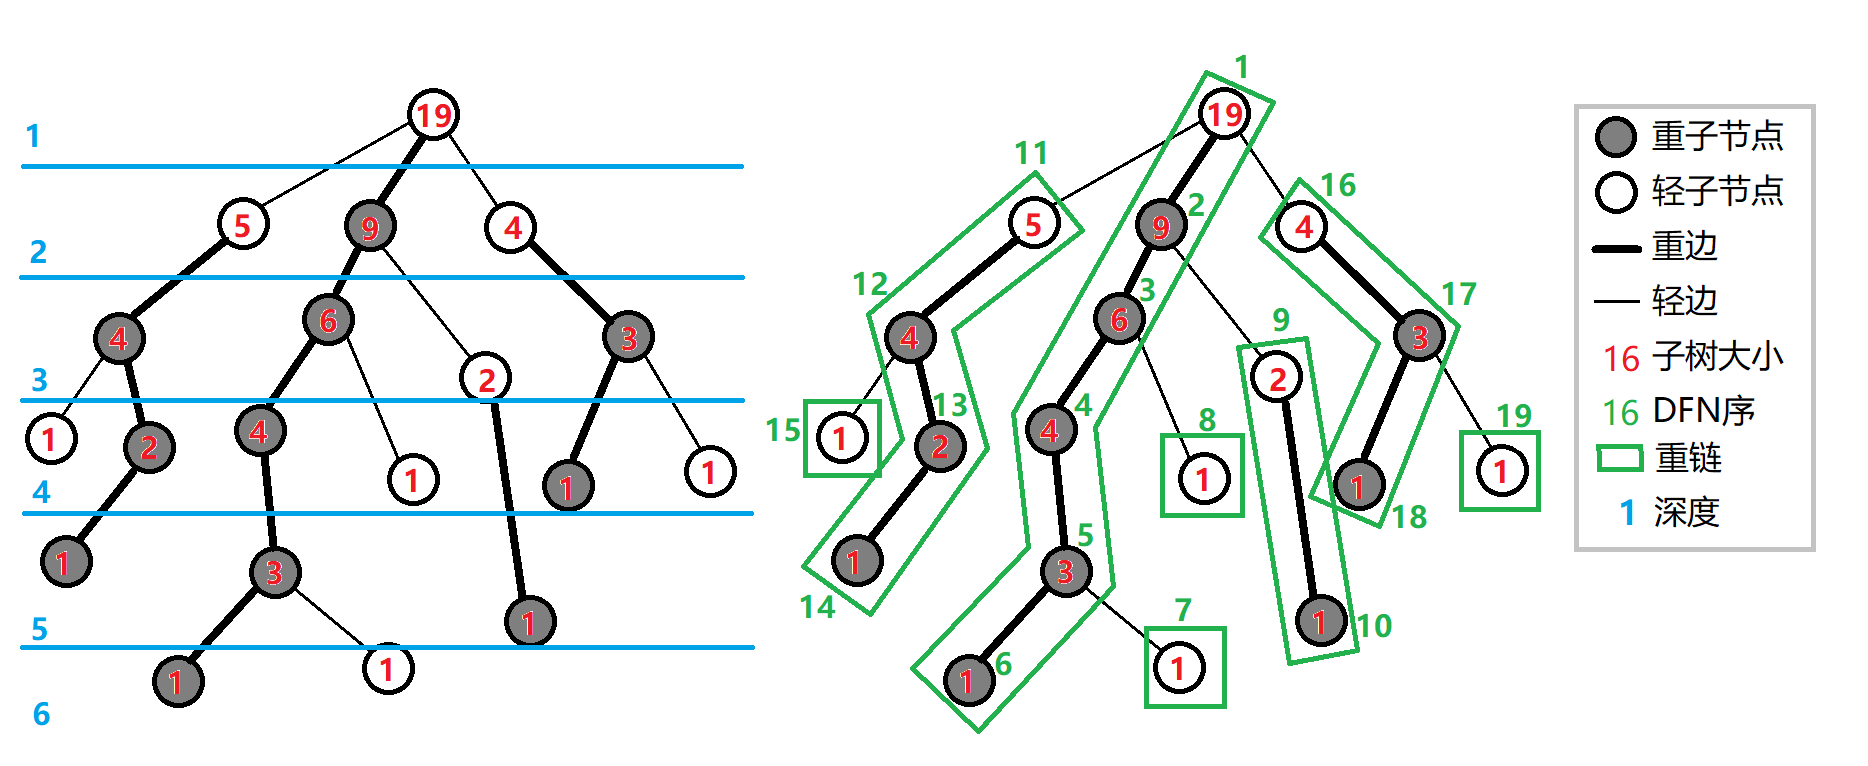
如图所示,这个图讲的非常清楚。
我们剖析一下重链的性质。
首先,我们的重链剖分是基于 DFS 实现的,因此节点会有一个 DFN 序编号,这个编号会遵循 DFN 序编号的所有性质,就例如说同一颗子树下,根节点编号最小,其他节点的编号一定是连续的,最后一个编号一定是子树根节点编号加子树大小减一。
然后就是重链剖分的精妙之处了,由于我们进行 DFS 的时候优先进行重链的遍历,这就导致了同一条重链上,节点编号也是连续的。
也就是说,如果我们对一条重链上的点进行区间操作的话,那不就异常简单了?举个例子来说,如上图,我想在节点 \(19\) 到节点 \(3\) 的路径上点权加 \(1\),经观察可发现他们路径之间的点由于都属于同一条重链,因此我们就可以让 \(dfn_{19} \sim dfn_{3}\) 加 \(1\),也就是 \(1 \sim 5\) 加 \(1\),这一操作如果我们再结合线段树,那不就是 \(O(\log n)\) 的复杂度?十分快了。
思路详解
我们知道了重链剖分是基于 DFS 的,那我们进行一次 DFS 要去维护那些信息?又要进行几次 DFS 呢?
我们回顾一下我们如果要对重链上的点进行区间操作,我们需要哪些信息?
- \(dfn\):DFN 序编号,这是很重要的,自然不必多说。
- \(depth\):表示节点的深度,我们要对节点的深度进行比较,这样就能得到 \(dfn\) 和其他信息的相对关系。
- \(hson\):重子节点,我们的重链剖分中最重要的思想。
- \(size\):表示当前节点为根节点的子树大小,很显然我们要去维护重儿子,跟子树大小是息息相关的。
- \(fa\):当前节点的父亲节点,进行 DFS 的时候不能忽视节点父子关系,有这个数组会方便很多。
- \(top\):当前节点所处重链的头节点。
- (\(rnk\)):表示 DFS 序所对应的结点编号,这个不是很重要,但是如果你要和线段树结合的话,建树会用到。
很显然这么多数据一次 DFS 是不足以全部处理完的,经过先人实践,我们需要进行两次 DFS,第一次处理重儿子及相关内容,第二次进行 DFN 序相关编号。
代码实现
对于第一次 DFS 我们处理重儿子及相关内容。
inline void dfs1(ll u, ll f) {
	depth[u] = depth[f] + 1;
	fa[u] = f;
	size[u] = 1;
	for (ll i = first[u]; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (f == v) continue;
		dfs1(v, u);
		size[u] += size[v];
		if (size[hson[u]] < size[v]) hson[u] = v;
	}
}
第二次我们进行编号,注意遍历节点的时候我们要优先遍历重儿子,这样才会自然的形成一条重链。
inline void dfs2(ll u, ll ftop) {
	dfn[u] = ++tot;
	rnk[tot] = u;
	top[u] = ftop;
	if (hson[u]) dfs2(hson[u], ftop);
	for (ll i = first[u]; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (v != fa[u] && v != hson[u]) dfs2(v, v);
	}
}
这就是其代码了,很短是不是?其实并不是,因为单独的树剖并不能解决任何问题需要和其他知识结合使用(就比如建图你得写一个链式前向星吧?),因此代码每道题都不会很短。
应用
在讲解相关应用之前,我们讲解一个小技巧,那就是 std::min 其实是可以传入比较函数的,因此在比较两个节点 \(u\) 和 \(v\) 深度的时候我们可以这么写:
inline bool cmp(ll a, ll b) {
	if (depth[a] == depth[b]) return a < b;
	return depth[a] < depth[b];
}
ll k = min(u , v , cmp);
最近公共祖先
相较于 DFS 序 + RMQ 求 LCA 树剖在时间复杂度和常数方面均不占优势,但其胜在代码简洁,思路易懂。是一种在考场上写的不二选择。
其实非常简单,就是对于两个点来说,如果属于同一条重链,说明他们就是父子,那么 LCA 就是深度较浅的那一个。
如果不再同一条链上呢?我们就循环让深度较浅的那个点向上跳,然后再次判断是否在一条链上(判断的标准就是 \(top_u = top_v\),也就是所处重链的头节点相等)。
inline ll check(ll u, ll v) {
	while (top[u] != top[v]) {
		if (depth[top[u]] > depth[top[v]]) u = fa[top[u]];
		else v = fa[top[v]]; // 选择更深的节点向上跳
	}
	return min(u, v, cmp);
}
路径相关操作
如果题目让你在从 \(u\) 到 \(v\) 的路径上将途径点点权都加一个值 \(val\),应该怎么做呢?
我们还是效仿 LCA 的思想进行向上跳,在途径链上进行操作,因为同一条链上的序号是连续的,我们可以使用线段树进行区间操作。
区间修改:
inline void add_path(ll u, ll v, ll val) {
	while (top[u] != top[v]) {
		if (depth[top[u]] < depth[top[v]]) swap(u, v);
		add(1, 1, n, dfn[top[u]], dfn[u], val);
		u = fa[top[u]];
	}
	add(1, 1, n, dfn[min(u, v, cmp)], dfn[max(u, v, cmp)], val);
}
区间查询:
inline ll check_path(ll u, ll v) {
	ll res = 0;
	while (top[u] != top[v]) {
		if (depth[top[u]] < depth[top[v]]) swap(u, v);
		res = res + check(1, 1, n, dfn[top[u]], dfn[u]);
		u = fa[top[u]];
	}
	res = res + check(1, 1, n, dfn[min(u, v, cmp)], dfn[max(u, v, cmp)]);
	return res % mod;
}
需要注意的是,网上还有一种写法就是不需要管操作范围的 \(l\) 和 \(r\) 的大小关系,最后的跳到同一条链上的 \(u\) 和 \(v\) 进行查询的时候直接写成:add(1, 1, n, dfn[u], dfn[v], val),然后在线段树相关操作的部分写一句:if (l > r) swap(l, r)。这样确实可以通过大部分板题的,但是在实际应用中,这样写的安全性是很低的,如果题目中本就包含不合法操作,那么这个语句就会强行将本不应该被统计的不合法操作修改为合法操作,造成很大程度挂分。
这里声明,由于博主初学时觉得上述写法编码难度较低,于是部分题还是写了上述写法,如果在后续例题中出现请注意甄别,如有误导深表歉意。
子树操作
这里我们就要用到 DFN 序的相关性质了,同一颗子树下节点的 DFN 编号本就是连续的,直接进行相关操作就好了。
子树修改:
inline void add_tree(ll u, ll val) {
	ll l = dfn[u], r = dfn[u] + size[u] - 1;
	add(1, 1, n, l, r, val);
}
子树查询:
inline ll check_tree(ll u) {
	ll l = dfn[u], r = dfn[u] + size[u] - 1;
	ll res = check(1, 1, n, l, r);
	return res % mod;
}
化边权为点权
由于我们 DFS 的时候只处理了节点相关信息,和边的关系不大,因此如果题目中让你对边权进行相关处理,我们就无从下手了。
可以考虑将边权化为点权,也就是说找到一种对应方法,使每一条连接 \(u\) 和 \(v\) 的双向边都对应唯一的节点。
很好想到这个时候应该让边权对应到深度更深的那个点上,否则肯定会冲突。
然后如果进行路径操作的时候,我们会把路径起止点的 LCA 统计两次(很好想吧?),需要去掉一次。
具体代码我们直接看例题部分就好。
例题
P3379 【模板】最近公共祖先(LCA)
先来看最近公共祖先,这个不需要结合线段树,是树剖入门好题。
#include<bits/stdc++.h>
using namespace std;
#define endl '\n'
#define ll long long
#define const constexpr
#define dbug(x) (void)(cerr << #x << " = " << x << endl)

const int N = 5e5 + 86;
ll n, m, s;
struct node {
	ll next, to, w;
} edge[N * 2];

ll cnt, first[N];
inline void add(ll u, ll v) {
	cnt++;
	edge[cnt].next = first[u];
	edge[cnt].to = v;
	first[u] = cnt;
}

// 重链剖分
ll fa[N], hson[N], size[N], top[N], depth[N];     //父节点,重儿子,子树大小,头节点,深度
ll tot, dfn[N], rnk[N];   // dfs序号和dfs序号所对应的节点。

// 第一个 dfs 预处理父节点,重儿子,子树大小,深度
inline void dfs1(ll u, ll f) {
	fa[u] = f;
	size[u] = 1;
	depth[u] = depth[f] + 1;

	for (ll i = first[u]; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (f == v) continue; // 回边跳过
		dfs1(v, u);
		size[u] += size[v];
		if (size[v] > size[hson[u]]) hson[u] = v;
	}
}

// 第二个dfs进行树剖,处理dfs序号和dfs序号所对应的节点,头节点。
inline void dfs2(ll u, ll ftop) {
	top[u] = ftop;
	dfn[u] = ++tot;
	rnk[tot] = u;
	if (hson[u]) dfs2(hson[u], top[u]); // 进入自己的重儿子
	for (ll i = first[u]; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (v != hson[u] && v != fa[u]) dfs2(v, v); // 这意味着一条新重链出现
	}
}

inline bool cmp(ll x, ll y) {
	return depth[x] < depth[y];
}

inline ll check(ll u, ll v) {
	while (top[u] != top[v]) {
		if (depth[top[u]] > depth[top[v]]) {
			u = fa[top[u]]; // 选择更深的节点向上跳
		} else {
			v = fa[top[v]];
		}
	}
	return min(u, v, cmp);
}

int main() {
	ios::sync_with_stdio(0);
	cin.tie(0), cout.tie(0);

	cin >> n >> m >> s;
	// build graph
	for (ll i = 1; i < n; i++) {
		ll u, v;
		cin >> u >> v;
		add(u, v);
		add(v, u);
	}
	dfs1(s, s);
	dfs2(s, s);
	while (m--) {
		ll x, y;
		cin >> x >> y;
		cout << check(x, y) << endl;
	}

	return ~~ (0 ^ 0);
}
P3384 【模板】重链剖分/树链剖分
树剖模板,相关操作刚才都讲过,刷完板题后你会发现你可以直接复制粘贴稍微修改 AC 掉很多道蓝题,但很不建议这么干,因为码量很多代表着如果你不多练习的话很容易会出错。
!!!码量预警!!!
#include<bits/stdc++.h>
using namespace std;
#define endl '\n'
#define ll long long
#define const constexpr
#define dbug(x) (void)(cerr << #x << " = " << x << endl)

const int N = 1e5 + 86;

ll a[N];
ll n, m, r, mod;

// build graph
struct node {
	ll next, to;
} edge[N << 1];

ll first[N], cnt;
inline void add(ll u, ll v) {
	cnt++;
	edge[cnt].to = v;
	edge[cnt].next = first[u];
	first[u] = cnt;
}

// 重链剖分
ll fa[N], size[N], hson[N], top[N], depth[N];
ll dfn[N], rnk[N], tot;

inline void dfs1(ll u, ll f) {
	fa[u] = f;
	size[u] = 1;
	depth[u] = depth[f] + 1;
	for (ll i = first[u] ; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (v == f) continue;
		dfs1(v, u);
		size[u] += size[v];
		if (size[hson[u]] < size[v]) hson[u] = v;
	}
}

inline void dfs2(ll u, ll ftop) {
	top[u] = ftop;
	dfn[u] = ++tot;
	rnk[tot] = u;
	if (hson[u]) dfs2(hson[u], top[u]);
	for (ll i = first[u]; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (v != fa[u] && v != hson[u]) dfs2(v, v);
	}
}

// segment-tree
ll tree[N << 2], tag[N << 2];
inline ll ls(ll x) {
	return x << 1;
}
inline ll rs(ll x) {
	return x << 1 | 1;
}
inline void push_up(ll x) {
	tree[x] = tree[ls(x)] + tree[rs(x)];
}


// 建树时按照dfn序的节点编号进行建树
inline void build(ll x, ll l, ll r) {
	if (l == r) {
		tree[x] = a[rnk[l]] % mod;
		return ;
	}
	ll mid = l + r >> 1;
	build(ls(x), l, mid);
	build(rs(x), mid + 1, r);
	push_up(x);
}
inline void add_tag(ll x, ll l, ll r, ll val) {
	tag[x] += val;
	tree[x] += (r - l + 1) * val % mod;
}
inline void down_tag(ll x, ll l, ll r) {
	ll mid = l + r >> 1;
	add_tag(ls(x), l, mid, tag[x] % mod);
	add_tag(rs(x), mid + 1, r, tag[x] % mod);
	tag[x] = 0;
}

inline void add(ll x, ll tl, ll tr, ll l, ll r, ll val) {
	if (tl >= l && tr <= r) {
		add_tag(x, tl, tr, val);
		return ;
	}
	if (tag[x]) down_tag(x, tl, tr);
	ll mid = tl + tr >> 1;
	if (l <= mid) add(ls(x), tl, mid, l, r, val);
	if (r > mid ) add(rs(x), mid + 1, tr, l, r, val);
	push_up(x);
}
inline bool cmp(ll a, ll b) {
	if (depth[a] == depth[b]) return a < b;
	return depth[a] < depth[b];
}

inline ll check(ll x, ll tl, ll tr, ll l, ll r) {
	if (tl >= l && tr <= r) return tree[x];
	if (tag[x]) down_tag(x, tl, tr);
	ll mid = tl + tr >> 1, res = 0;
	if (l <= mid) res += check(ls(x), tl, mid, l, r);
	if (r > mid ) res += check(rs(x), mid + 1, tr, l, r);
	return res % mod;
}

// 进行路径上操作
inline void add_path(ll u, ll v, ll val) {
	while (top[u] != top[v]) {
		if (depth[top[u]] < depth[top[v]]) swap(u, v);
		add(1, 1, n, dfn[top[u]], dfn[u], val);
		u = fa[top[u]];
	}
	add(1, 1, n, dfn[min(u, v, cmp)], dfn[max(u, v, cmp)], val);
}
inline ll check_path(ll u, ll v) {
	ll res = 0;
	while (top[u] != top[v]) {
		if (depth[top[u]] < depth[top[v]]) swap(u, v);
		res = res + check(1, 1, n, dfn[top[u]], dfn[u]);
		u = fa[top[u]];
	}
	res = res + check(1, 1, n, dfn[min(u, v, cmp)], dfn[max(u, v, cmp)]);
	return res % mod;
}

// 进行子树操作
inline void add_tree(ll u, ll val) {
	ll l = dfn[u], r = dfn[u] + size[u] - 1;
	add(1, 1, n, l, r, val);
}
inline ll check_tree(ll u) {
	ll l = dfn[u], r = dfn[u] + size[u] - 1;
	ll res = check(1, 1, n, l, r);
	return res % mod;
}

int main() {
	ios::sync_with_stdio(0);
	cin.tie(0), cout.tie(0);
	cin >> n >> m >> r >> mod;
	for (ll i = 1; i <= n; i++) cin >> a[i];
	for (ll i = 1; i < n; i++) {
		ll u, v;
		cin >> u >> v;
		add(u, v);
		add(v, u);
	}
	dfs1(r, r);
	dfs2(r, r);
	build(1, 1, n);

	while (m--) {
		ll opt;
		cin >> opt;
		if (opt == 1) {
			ll u, v, val;
			cin >> u >> v >> val;
			add_path(u, v, val);
		} else if (opt == 2) {
			ll u, v;
			cin >> u >> v;
			cout << check_path(u, v) << endl;
		} else if (opt == 3) {
			ll u, val;
			cin >> u >> val;
			add_tree(u, val);
		} else if (opt == 4) {
			ll u;
			cin >> u;
			cout << check_tree(u) << endl;
		}
	}

	return ~~ (0 ^ 0);
}
P3950 部落冲突
点权化为边权。然后照常进行操作就好。
#include<bits/stdc++.h>
using namespace std;
#define endl '\n'
#define ll long long
#define const constexpr
#define dbug(x) (void)(cerr << #x << " = " << x << endl)

const int N = 3e5 + 86;
ll n, m;
ll L[N], R[N];

struct node {
	ll next, to;
} edge[N << 1];

ll first[N], cnt;
inline void add(ll u, ll v) {
	cnt++;
	edge[cnt].to = v;
	edge[cnt].next = first[u];
	first[u] = cnt;
}

ll fa[N], top[N], hson[N], size[N], depth[N];
ll dfn[N], tot;

inline void dfs1(ll u, ll f) {
	fa[u] = f;
	size[u] = 1;
	depth[u] = depth[f] + 1;
	for (ll i = first[u]; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (v == f) continue;
		dfs1(v, u);
		size[u] += size[v];
		if (size[hson[u]] < size[v]) hson[u] = v;
	}
}

inline void dfs2(ll u, ll ftop) {
	top[u] = ftop;
	dfn[u] = ++tot;
	if (hson[u]) dfs2(hson[u], top[u]);
	for (ll i = first[u] ; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (v != fa[u] && v != hson[u]) dfs2(v, v);
	}
}

ll tree[N << 2], tag[N << 2];

inline ll ls(ll x) {
	return x << 1;
}
inline ll rs(ll x) {
	return x << 1 | 1;
}
inline void push_up(ll x) {
	tree[x] = tree[ls(x)] + tree[rs(x)];
}

inline void add_tag(ll x, ll l, ll r, ll val) {
	tag[x] += val;
	tree[x] += (r - l + 1) * val;
}

inline void down_tag(ll x, ll l, ll r) {
	ll mid = l + r >> 1;
	add_tag(ls(x), l, mid, tag[x]);
	add_tag(rs(x), mid + 1, r, tag[x]);
	tag[x] = 0;
}
inline bool cmp(ll a, ll b) {
	if (depth[a] == depth[b]) return a < b;
	return depth[a] < depth[b];
}

inline void update(ll x, ll tl, ll tr, ll l, ll r, ll val) {
	if (l > r) swap(l, r);
	if (tl >= l && tr <= r) {
		add_tag(x, tl, tr, val);
		return ;
	}
	if (tag[x]) down_tag(x, tl, tr);
	ll mid = tl + tr >> 1;
	if (l <= mid) update(ls(x), tl, mid, l, r, val);
	if (r > mid ) update(rs(x), mid  + 1, tr, l, r, val);
	push_up(x);
}

inline ll check(ll x, ll tl, ll tr, ll l, ll r ) {
	if (l > r) swap(l, r);
	if (tl >= l && tr <= r) {
		return tree[x];
	}
	if (tag[x])down_tag(x, tl, tr);
	ll mid = tl + tr >> 1;
	ll res = 0;
	if (l <= mid) res += check(ls(x), tl, mid, l, r);
	if (r > mid ) res += check(rs(x), mid + 1, tr, l, r);
	return res;
}

inline bool check_path(ll u, ll v) {
	ll res = 0;
	while (top[u] != top[v]) {
		if (depth[top[u]] < depth[top[v]]) swap(u, v);
		res += check(1, 1, n, dfn[u], dfn[top[u]]);
		u = fa[top[u]];
	}
	res += check(1, 1, n, dfn[u], dfn[v]);
	ll lca = min(u, v, cmp);
	res -= check(1, 1, n, dfn[lca], dfn[lca]);
	if (res > 0) return 0;
	else return 1;
}

int main() {
	ios::sync_with_stdio(0);
	cin.tie(0), cout.tie(0);
	cin >> n >> m;
	for (ll i = 1; i < n; i++) {
		ll u, v;
		cin >> u >> v;
		add(u, v);
		add(v, u);
	}
	dfs1(1, 1);
	dfs2(1, 1);


	ll war = 0;
	while (m--) {
		char opt ;
		cin >> opt;
		if (opt == 'Q') {
			ll u, v;
			cin >> u >> v;
			if (check_path(u, v)) cout << "Yes";
			else cout << "No";
			cout << endl;
		}
		if (opt == 'C') {
			cin >> L[++war] >> R[war];
			ll k = max(L[war], R[war], cmp);
			update(1, 1, n, dfn[k], dfn[k], 1);
		}
		if (opt == 'U') {
			ll x;
			cin >> x;
			ll k = max(L[x], R[x], cmp);
			update(1, 1, n, dfn[k], dfn[k], -1);
		}
	}

	return ~~ (0 ^ 0);
}
P4114 Qtree1
这个涉及到了最大值,不能去除 LCA 的影响了,所以我们选择根本不去处理 LCA,也就是在最后一步在同一链上的时候将深度较浅的那个节点的 DFN 不去处理。
构建线段树的时候记得处理原始边权。
#include<bits/stdc++.h>
using namespace std;
#define endl '\n'
#define ll long long
#define const constexpr
#define dbug(x) (void)(cerr << #x << " = " << x << endl)

const int N = 3e5 + 86;
struct node {
	ll next, to, w;
} edge[N << 1];

ll first[N], cnt;
inline void add(ll u, ll v, ll w) {
	cnt++;
	edge[cnt].to = v;
	edge[cnt].next = first[u];
	edge[cnt].w = w;
	first[u] = cnt;
}

ll n, a[N];
ll top[N], depth[N], hson[N], size[N], fa[N];
ll dfn[N], rnk[N], tot;

inline bool cmp(ll a, ll b) {
	if (depth[a] == depth[b]) return a < b;
	return depth[a] < depth[b];
}

inline void dfs1(ll u, ll f) {
	depth[u] = depth[f] + 1;
	fa[u] = f;
	size[u] = 1;
	for (ll i = first[u]; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (f == v) continue;
		dfs1(v, u);
		size[u] += size[v];
		if (size[hson[u]] < size[v]) hson[u] = v;
	}
}

inline void dfs2(ll u, ll ftop) {
	dfn[u] = ++tot;
	rnk[tot] = u;
	top[u] = ftop;
	if (hson[u]) dfs2(hson[u], ftop);
	for (ll i = first[u]; i; i = edge[i].next) {
		ll v = edge[i].to;
		if (v != fa[u] && v != hson[u]) dfs2(v, v);
	}
}

ll tree[N << 2];

inline ll ls(ll x) {
	return x << 1;
}
inline ll rs(ll x) {
	return x << 1 | 1;
}

inline void push_up(ll x) {
	tree[x] = max(tree[ls(x)], tree[rs(x)]);
}

inline void build(ll x, ll l, ll r) {
	if (l == r) {
		tree[x] = a[l];
		return ;
	}
	ll mid = l + r >> 1;
	build(ls(x), l, mid);
	build(rs(x), mid + 1, r);
	push_up(x);
}

inline void update(ll x, ll tl, ll tr, ll pos, ll val) {
	if (tl == tr) {
		tree[x] = val;
		return ;
	}
	ll mid = tl + tr >> 1;
	if (pos <= mid) update(ls(x), tl, mid, pos, val);
	if (pos > mid ) update(rs(x), mid + 1, tr, pos, val);
	push_up(x);
}

inline ll check(ll x, ll tl, ll tr, ll l, ll r) {
	if (l > r) swap(l, r);
	if (tl >= l && tr <= r) {
		return tree[x];
	}
	ll mid = tl + tr >> 1, res = 0;
	if (l <= mid) res = max (check(ls(x), tl, mid, l, r), res);
	if (r > mid ) res = max (check(rs(x), mid + 1, tr, l, r), res);
	return res;
}

inline ll check_path(ll u, ll v) {
	ll res = 0;
	while (top[u] != top[v]) {
		if (depth[top[u]] < depth[top[v]]) swap(u, v);
		res = max(check(1, 1, n, dfn[top[u]], dfn[u]), res);
		u = fa[top[u]];
	}
	res = max(check(1, 1, n, dfn[min(u, v, cmp)] + 1, dfn[max(u, v, cmp)]), res);
	return res;
}

int main() {
	ios::sync_with_stdio(0);
	cin.tie(0), cout.tie(0);
	cin >> n;
	for (ll i = 1; i < n; i++) {
		ll u, v, w;
		cin >> u >> v >> w;
		add(u, v, w);
		add(v, u, w);
	}
	dfs1(1, 1);
	dfs2(1, 1);
	for (ll u = 1; u <= n; u++) {
		for (ll i = first[u]; i; i = edge[i].next) {
			ll v = edge[i].to, w = edge[i].w;
			a[dfn[max(u, v, cmp)]] = w;
		}
	}


	build(1, 1, n);
	string opt;
	while (cin >> opt) {
		if (opt == "DONE") return 0;
		if (opt == "CHANGE") {
			ll x, val;
			cin >> x >> val;
			ll u = edge[x * 2].to;
			ll v = edge[x * 2 - 1].to;
			update(1, 1, n, dfn[max(u, v, cmp)], val);
		}
		if (opt == "QUERY") {
			ll u, v;
			cin >> u >> v;
			cout << check_path(u, v) << endl;
		}
	}
	return ~~ (0 ^ 0);
}

 浙公网安备 33010602011771号