
猫树
所谓「猫树」就是一种不支持修改,仅仅支持快速区间询问的一种静态线段树。
2025-10-31 upt:更新了板码(其他例题代码暂未更新),防止了
__lg(0)的 UB。
引入
今天我本来想学习 RMQ(Range Maximum/Minimum Query,即区间最大(最小)值)问题的,顺便复习 ST 表,结果在机缘巧合之下发现了一种颇为冷门的数据结构——猫树。
我们都知道,线段树可以用于查询区间信息,查询一次的复杂度是 \(O(\log{n})\) ,同时他还支持高速的区间修改,可以称得上是很实用的数据结构了。但他在处理 RMQ 问题上,弊端就展现出来了,相较于 \(O(1)\) 复杂度查询的 ST 表,他在大数据上的表现颇为吃力,而线段树的长处也就是区间修改,在 RMQ 问题上也无法展露拳脚。
难道我们就真的需要放弃这个数据结构,转而去学 ST 表了吗?这里就有一种思路了,我们既然都不用区间修改了,那我们为什么不直接抛弃掉这个功能,转而优化区间查询操作呢?
这当然是可以的,而这种优化过的线段树,就是我们今天要介绍的猫树。
先来看看其与 ST 表的对比:
| 对比维度 | ST 表(Sparse Table) | 猫树(Cat Tree) |
|---|---|---|
| 核心原理 | 基于倍增思想 | 基于二叉树分治 |
| 预处理时间复杂度 | \(O(n \log n)\) | \(O(n \log n)\) |
| 单次查询时间复杂度 | \(O(1)\) | \(O(1)\) |
| 空间复杂度 | \(O(n \log n)\) | \(O(n \log n)\) |
| 常数因子 | 较小,查询时仅需两次数组访问和一次 \(\log\) 计算。 | 较大,查询时需计算异或和 \(\log\) 函数(实际并无差异) |
由于这个数据结构过于冷门,所以网络上并没有对其复杂度和常数方面的详细说明(甚至询问 AI 无果)
实际使用上,尽管猫树常数略大(实际上约等于相同,且 ST 表板题经实测猫树较 ST 表更快),但他的可拓展性是 ST 表不可比拟的。
实现流程
我们假设现在要查询 \(l \sim r\) 的区间信息,如果是线段树,需要每次递归查询,无形之中创造了复杂度。
那我们考虑常用优化技巧——空间换时间,如果我们提前已经预处理好了这个区间的信息,或者较于线段树预处理多个区间维护一个查询区间,我们将其改为仅处理极少量区间就可得到查询区间信息,那复杂度不就降至 \(O(1)\) 了吗?
在猫树中,我们只采用两个预处理区间一步获得查询区间信息。
建树
具体实现步骤(这个非常重要):
-
首先按照线段树分治思想预处理,我们还是把一个区间分为两份 \(l \sim mid\) 和 \(mid + 1 \sim r\)。
-
对于这两个区间,我们从其中间点 \(mid\) 和 \(mid + 1\) 出发,用 \(O(n)\) 的时间暴力遍历两边的每个元素。
我们以区间和(依题目不同而变化)为例:
- 对于左侧区间,逆序遍历:\(cat_i = cat_{i+1} + a_i\);
- 对于右侧区间,顺序遍历:\(cat_i = cat_{i-1} + a_i\)。
-
处理完这个区间,就按线段树建树思想继续递归,直至 \(l = r\)。
以上就是猫树的建树流程,也就是待会要讲的 build() 函数的实现。
相较于线段树线性复杂度,猫树的建树时间复杂度略差,但这都是为我们的 \(O(1)\) 查询铺路。
但是这里还有一个问题:如何保证每个区间都能被分成两份预处理过的区间?
其实我们由上面的预处理流程就可以知道:
某个预处理过的区间可以将任意一个左右端点都在该区间内,且经过该区间中点的区间分成两份,而这两份区间已经处理过了,那么就可以 \(O(1)\) 合并求解了
你可以感性理解一下,实在不理解,这篇博客讲的很清楚。
查询
也就是说,对于一个要查询的节点,我们需要找到一个他经过的区间中点,这样我们就可以将这段区间分成两段处理了。
有人会问了,那我们找到这个分割点的过程,不会导致复杂度变高吗?
其实这就是猫树的一个巧妙之处,我们其实可以 \(O(1)\) 找到这个分割点。
不难看出,如果从查询区间两个端点(叶子节点)开始,往深度更浅的地方走,也就是同时往上走直至相遇,这个相遇点就是我们要找的分割点了。
那这个分割点不就是这两个叶子节点的 \(\operatorname{LCA}\) 吗?那我们可以用倍增或欧拉序(DFS 序)求 \(\operatorname{LCA}\),就可以将复杂度稍微降一点,已经比线段树更优了,但还远远不够。
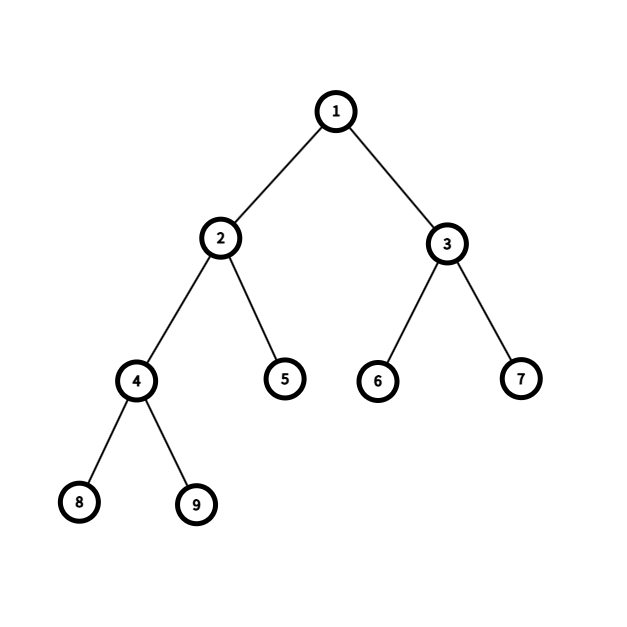
这就涉及到,如何在一棵猫树上求 \(\operatorname{LCA}\) 了,我们可以考虑一下线段树(完全二叉树)的编号性质:
-
根节点编号为 \(1\)。
-
对于任意节点 \(x\),左子节点编号为 \(2x\),右子节点编号为\(2x + 1\)。
这种编号方式使得节点的二进制表示与它在树中的深度直接相关:
举个例子:
- 根节点(编号 \(1\),二进制 \(1\))在第 \(1\) 层。
- 第 \(2\) 层节点编号为 \(2\)(\(10\))、\(3\)(\(11\))。
- 第 \(3\) 层节点编号为 \(4\)(\(100\))、\(5\)(\(101\))、\(6\)(\(110\))、\(7\)(\(111\))。
- ...
- 第 \(k\) 层的节点编号的二进制长度为 \(k\)(最高位为 \(1\),后面跟 \(k-1\) 位)。
因此,节点编号的最高位所在的位置(即 \(\log(x)\) 的结果)直接对应节点的深度,一般地,节点 \(x\) 的深度为 \(\lfloor {\log(x)} \rfloor + 1\)(0 - based)。
注意,其他网上的代码都会预处理对数数组,但实际上我们可以直接使用 std::__lg() 函数,直接返回对数向下取整的形式,而且查询复杂度是 \(O(1)\),还不用预处理。
这是对于每个节点的深度,我们想一下,\(\operatorname{LCA}(x,y)\) 的深度就等于 \(x\) 的深度减去 \(x\) 与 \(y\) 从 \(\operatorname{LCA}(x,y)\) 到各自节点的 “分叉深度”。
那我们如何取得分叉深度呢?
我们观察一下上面那个图,发现 \(4(100)_2\) 和 \(5(101)_2\) 的 \(\operatorname{LCA}\) 就是 \(2(10)_2\)。
我们观察一下就可以发现两个结点的 \(\operatorname{LCA}\) 的节点编号其实就是他们编号的最长公共前缀(二进制下)。
这不又把 LCA 问题转化为了 LCP 问题了吗?我们直接学习KMP算法与Z函数。
其实没有那么麻烦,二进制下的 LCP 问题,我们首先给他按位异或一下,可以发现他们的公共前缀不见了(相同为 \(0\)),所以异或结果的最高位,对应着两个节点编号的二进制表示中,第一个不相同的位的位置。
综上所述:公共前缀的长度 = 总位数 - 最高异或位的位置 - 1(0 - based)
了解了这些之后,我们就可以推导猫树中 \(\operatorname{LCA}\) (的层数)的公式了:
设(其中 \(pos\) 用于存储树上的对应下标, \(\log\) 均向下取整,\(\oplus\) 代表按位异或):
- \(x = pos_l\),\(y = pos_r\)。
- \(k = \log(x) + 1\):\(x\) 的最高位位置(0-based),即 \(x\) 所在深度为 \(k + 1\)。
- \(m = \log(x \oplus y) + 1\):\(x\) 和 \(y\) 异或结果的最高位位置(0-based)。
所以 \(\operatorname{LCA}(x,y) = k - m = \log(x) - \log(x \oplus y)\) (可看作 1-based)。
就这样,我们得到了对应最近公共祖先的层数(有层数就足够了,不用求出其节点编号,因为一层一共就两个节点,而我们又是用两段区间得到查询结果,所以直接该层两段在区间范围内的全用就可以)。
代码实现
我们进入到代码编写部分(和线段树类似)。
定义变量
这里的 \(len\) 变量用于将原数组长度调整为大于等于 \(n\) 的最小的 \(2\) 的整数次幂,因为我们求最近公共祖先,是基于满二叉树的编号规则,如果不补齐长度,会造成下标编号混乱,因此在猫树中,这一步是必须的。
const ll N = 1e5 + 86;  // 数据规模上限,注意此处数组应该开到2倍大小
ll a[N << 1];                // 原数组
ll pos[N << 1];              // 记录每个位置在二叉树中的节点编号
ll cat[22][N << 1];          // 猫树核心数组:cat[d][i]表示第d层中i位置的预处理最大值
ll n, len, m;           // n:原数组长度;len:调整后的长度(2的幂);m:查询次数
构建猫树(核心)
build() 函数递归构建二叉树,在每一层 \(d\) 预处理区间最大值,供后续查询使用,具体实现刚才讲的很清楚了,可以返回去看看。
inline ll ls(ll x) { return x << 1; }   // 左子节点:x*2
inline ll rs(ll x) { return x << 1 | 1; } // 右子节点:x*2+1
inline void build(ll x, ll l, ll r, ll d) {
    if (l == r) {  // 叶子节点:对应原数组单个元素
        pos[l] = x;  // 记录该位置在二叉树中的节点编号
        return;
    }
    ll mid = l + r >> 1;  // 取区间中点

    // 左半区间预处理:从mid向左延伸,记录[mid, l]方向的最大值(前缀最大值数组)
    cat[d][mid] = a[mid];
    for (ll i = mid - 1; i >= l; i--) {
        cat[d][i] = max(a[i], cat[d][i + 1]);
    }

    // 右半区间预处理:从mid+1向右延伸,记录[mid+1, r]方向的最大值
    cat[d][mid + 1] = a[mid + 1];
    for (ll i = mid + 2; i <= r; i++) {
        cat[d][i] = max(a[i], cat[d][i - 1]);
    }

    // 递归构建左右子树(深度+1)
    build(ls(x), l, mid, d + 1);
    build(rs(x), mid + 1, r, d + 1);
}
查询区间
可以看出 check() 函数较之前线段树已经不变的异常简洁了,因为没涉及到任何函数递归调用和多重循环,可以保证其复杂度就是 \(O(1)\) 的。
#define lg(x) ((x) == 0 ? (0) : (__lg(x)))
inline ll check(ll l, ll r) {
    if (l == r) return a[l];  // 单点查询直接返回
    // 计算深度d:两位置对应节点的公共祖先所在层数
    ll d = __lg(pos[l]) - __lg(pos[l] ^ pos[r]);
    // 区间最大值 = 左半预处理最大值 和 右半预处理最大值 的较大者
    return max(cat[d][l], cat[d][r]);
}
例题
求最值 RMQ 问题
ST 表的例题,当然也就是猫树的例题啦。
#include<bits/stdc++.h>
using namespace std;
#define endl '\n'
#define ll long long
#define dbug(x) (void)(cerr << #x << " = " << x << endl)

const ll N = 2e5 + 86;
ll a[N];
ll pos[N];
ll cat[22][N];
ll n, len, m;

inline ll ls(ll x) {
	return x << 1;
}
inline ll rs(ll x) {
	return x << 1 | 1;
}

inline void build(ll x, ll l, ll r, ll d) {
	if (l == r) {
		pos[l] = x;
		return;
	}
	ll mid = l + r >> 1;

	cat[d][mid] = a[mid];
	for (ll i = mid - 1; i >= l; i--) {
		cat[d][i] = max(a[i], cat[d][i + 1]);
	}

	cat[d][mid + 1] = a[mid + 1];
	for (ll i = mid + 2; i <= r; i++) {
		cat[d][i] = max(a[i], cat[d][i - 1]);
	}

	build(ls(x), l, mid, d + 1);
	build(rs(x), mid + 1, r, d + 1);
}
#define lg(x) ((x) == 0 ? (0) : (__lg(x)))
inline ll check(ll l, ll r) {
	if (l == r) return a[l];
	// 通过求二进制下LCP就可以获得对应层数
	ll d = __lg(pos[l]) - __lg(pos[l] ^ pos[r]);
	return max(cat[d][l], cat[d][r]);
}

int main() {
	ios::sync_with_stdio(0);
	cin.tie(0), cout.tie(0);

	cin >> n >> m;
	len = 1;
	while (len < n) len <<= 1;

	for (ll i = 1; i <= n; ++i) {
		cin >> a[i];
	}

	build(1, 1, len, 1);

	while (m--) {
		ll l, r;
		cin >> l >> r;
		cout << check(l, r) << endl;
	}

	return ~~(0 ^ 0);
}
唯一的区别就是,这道题是区间最小值,将上述代码中的 std::max() 换成 std::min() 就可以了。
#include<bits/stdc++.h>
using namespace std;
#define endl '\n'
#define ll long long
#define dbug(x) (void)(cerr << #x << " = " << x << endl)

const int N = 1e5+86;
ll a[N << 1], cat[23][N << 1], pos[N << 1];
ll n, m, len = 1;


inline ll ls(ll x) {
	return x << 1;
}
inline ll rs(ll x) {
	return x << 1 | 1;
}

inline void build(ll x, ll l, ll r, ll d) {
	if (l == r) {
		pos[l] = x;
		return ;
	}
	ll mid = l + r >> 1;

	cat[d][mid] = a[mid];
	for (ll i = mid - 1; i >= l; i--) {
		cat[d][i] = min(cat[d][i + 1], a[i]);
	}

	cat[d][mid + 1] = a[mid + 1];
	for (ll i = mid + 2; i <= r; i++) {
		cat[d][i] = min(cat[d][i - 1], a[i]);
	}

	build(ls(x), l, mid, d + 1);
	build(rs(x), mid + 1, r, d + 1);
}

inline ll check(ll l, ll r) {
	if (l == r) return a[l];
	ll d = __lg(pos[l]) - __lg(pos[l] ^ pos[r]);
	return min(cat[d][l], cat[d][r]);
}

int main() {

	ios::sync_with_stdio(0);
	cin.tie(0), cout.tie(0);

	cin >> n >> m;
	while (len < n) len <<= 1;
	for (ll i = 1; i <= n; i++) {
		cin >> a[i];
	}
	build(1, 1, len, 1);

	while (m--) {
		ll l, r;
		cin >> l >> r;
		cout << check(l, r) << " ";
	}

	return ~~ (0 ^ 0);
}

 浙公网安备 33010602011771号