
ConcurrentHashMap面试题
一、能具体说一下ConcurrentHashmap的实现吗 ?
ConcurrentHashmap线程安全在jdk1.7版本是基于分段锁 实现,在jdk1.8是基于CAS+synchronized 实现。
1.7分段锁
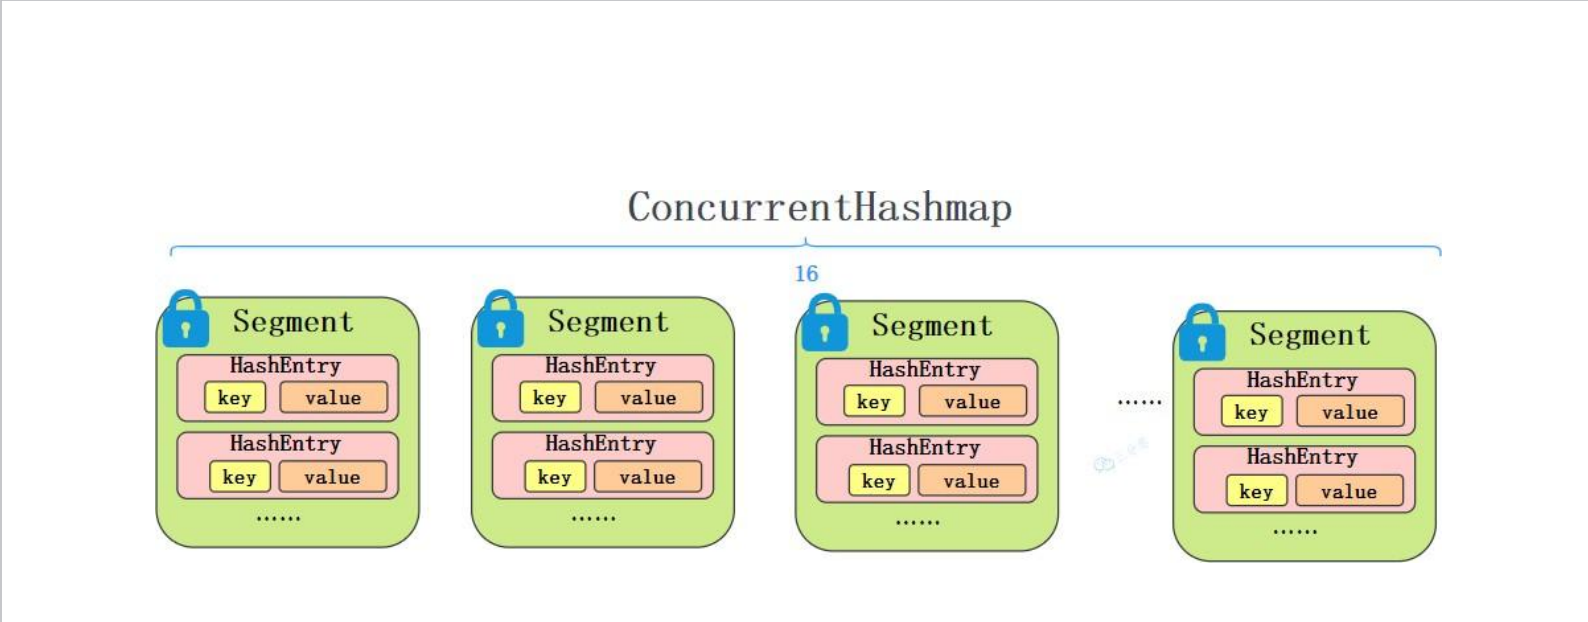
从结构上说,1.7版本的ConcurrentHashMap采用分段锁机制,里面包含一个Segment数组,Segment继承于ReentrantLock,Segment则包含HashEntry的数组,HashEntry本身就是一个链表的结构,具有保存key、value的能力能指向下一个节点的指针。
实际上就是相当于每个Segment都是一个HashMap,默认的Segment长度是16,也就是支持16个线程的并发写,Segment之间相互不会受到影响。
put流程
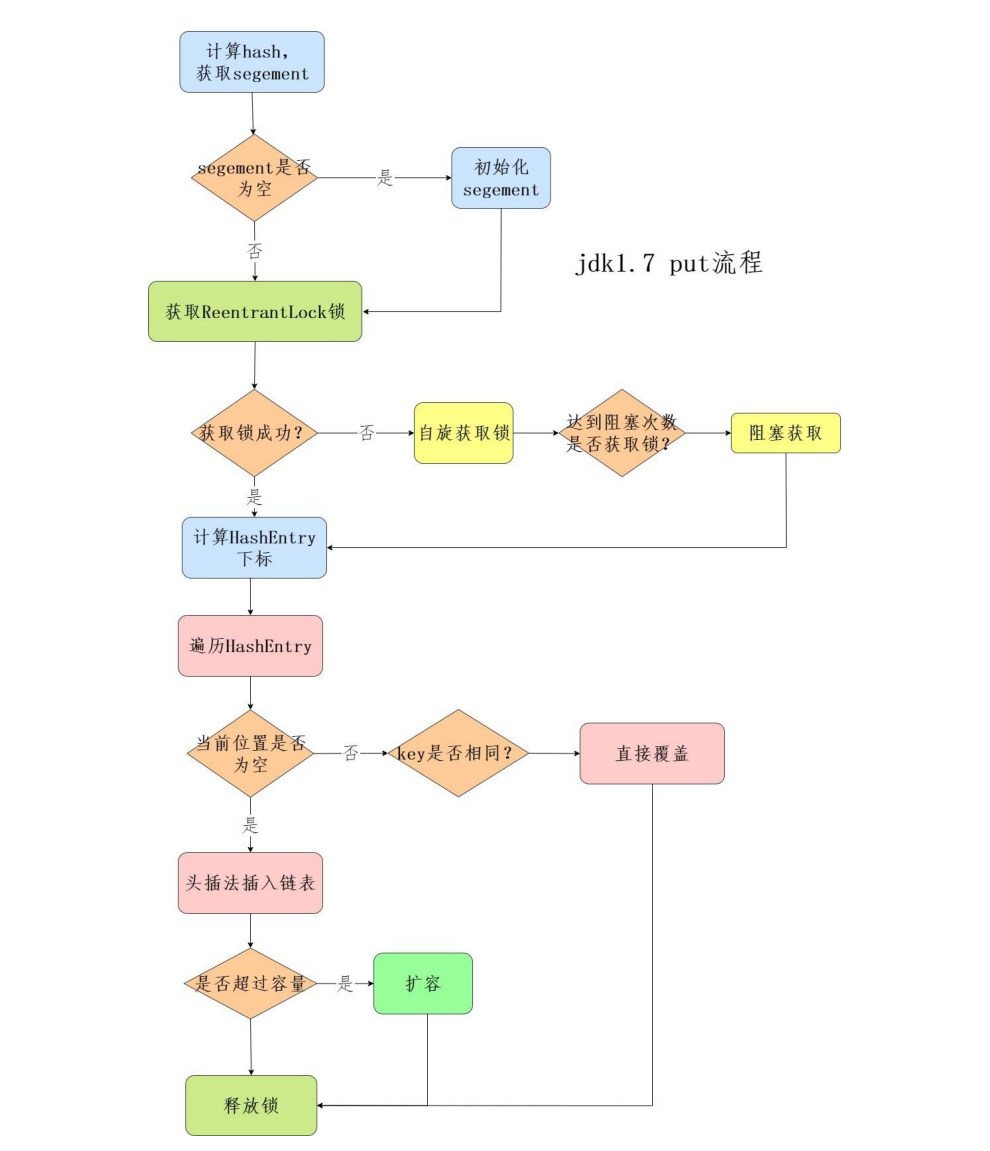
整个流程和HashMap非常类似,只不过是先定位到具体的Segment,然后通过ReentrantLock去操作而已,后面的流程,就和HashMap基本上是一样的。
-
计算hash,定位到segment,segment如果是空就先初始化
-
使用ReentrantLock加锁,如果获取锁失败则尝试自旋,自旋超过次数就阻塞获取,保证一定获取锁成功
-
遍历HashEntry,就是和HashMap一样,数组中key和hash一样就直接替换,不存在就再插入链表,链表同样操作
get流程
get也很简单,key通过hash定位到segment,再遍历链表定位到具体的元素上,需要注意的是value是volatile的,所以get是不需要加锁的。
1.8、CAS + Synchronized
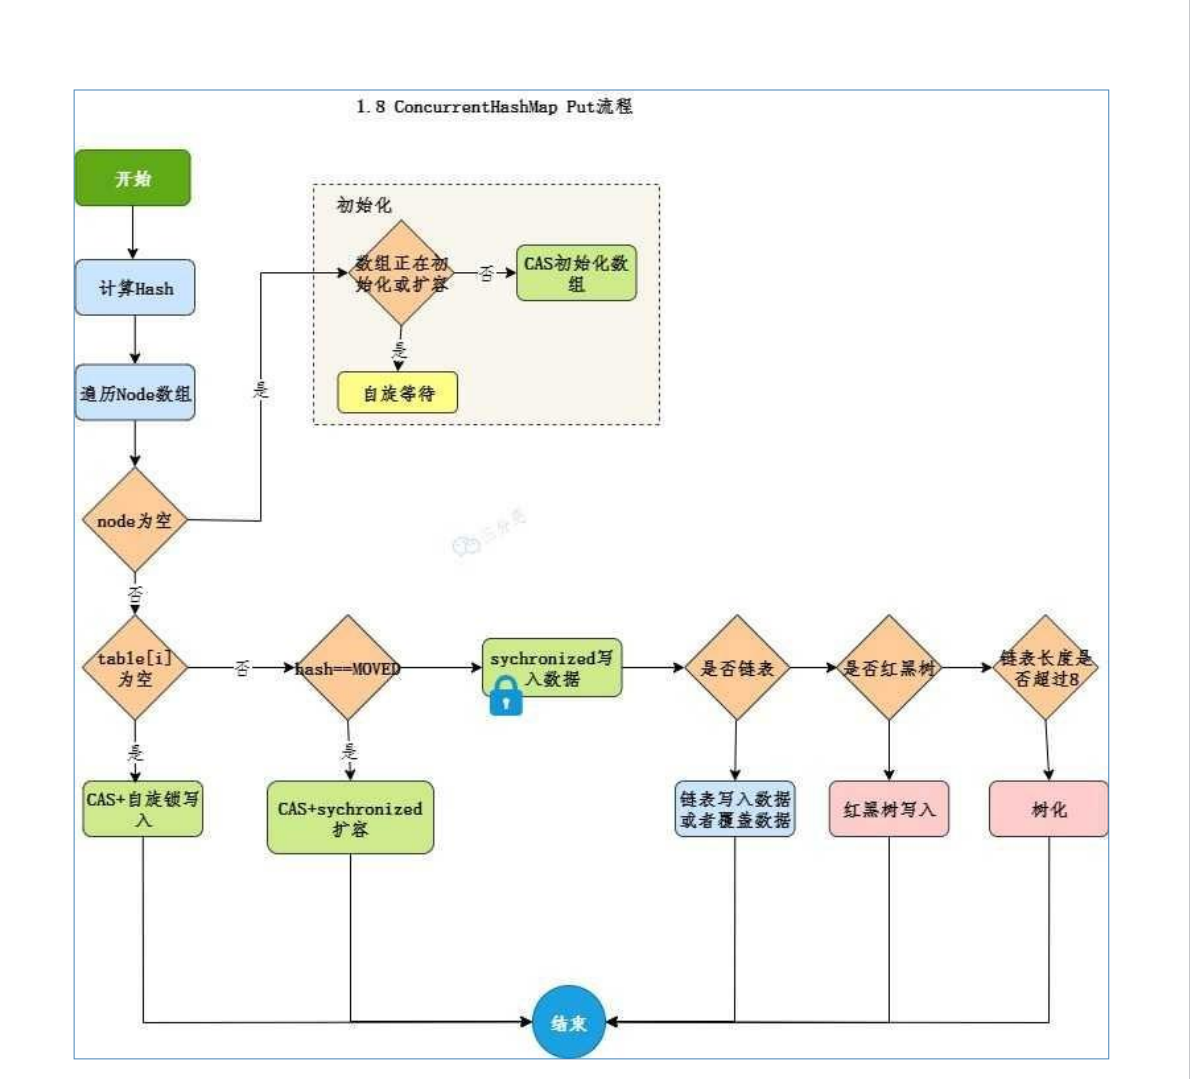
jdk1.8实现线程安全不是在数据结构上下功夫,它的数据结构和HashMap是一样的,数组+链表+红黑树。它实现线程安全的关键点在于put流程。
put的流程图
put的代码
        public V put(K key, V value) {
            // 第三个参数 onlyIfAbsent 为 false 表示哈希表中存在相同的 key 时【用当前数据覆盖旧数据】
            return putVal(key, value, false);
        }

        final V putVal(K key, V value, boolean onlyIfAbsent) {
            // 【ConcurrentHashMap 不能存放 null 值】
            if (key == null || value == null) throw new NullPointerException();
            // 扰动运算,高低位都参与寻址运算
            int hash = spread(key.hashCode());
            // 表示当前 k-v 封装成 node 后插入到指定桶位后,在桶位中的所属链表的下标位置
            int binCount = 0;
            // tab 引用当前 map 的数组 table,开始自旋
            for (Node<K,V>[] tab = table;;) {
                // f 表示桶位的头节点,n 表示哈希表数组的长度
                // i 表示 key 通过寻址计算后得到的桶位下标,fh 表示桶位头结点的 hash 值
                Node<K,V> f; int n, i, fh;

                // 【CASE1】:表示当前 map 中的 table 尚未初始化
                if (tab == null || (n = tab.length) == 0)
                    //【延迟初始化】
                    tab = initTable();

                // 【CASE2】:i 表示 key 使用【寻址算法】得到 key 对应数组的下标位置,tabAt 获取指定桶位的头结点f
                else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
                    // 对应的数组为 null 说明没有哈希冲突,直接新建节点添加到表中
                    if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null)))
                        break;
                }
                // 【CASE3】:逻辑说明数组已经被初始化,并且当前 key 对应的位置不为 null
                // 条件成立表示当前桶位的头结点为 FWD 结点,表示目前 map 正处于扩容过程中
                else if ((fh = f.hash) == MOVED)
                    // 当前线程【需要去帮助哈希表完成扩容】
                    tab = helpTransfer(tab, f);

                // 【CASE4】:哈希表没有在扩容,当前桶位可能是链表也可能是红黑树
                else {
                    // 当插入 key 存在时,会将旧值赋值给 oldVal 返回
                    V oldVal = null;
                    // 【锁住当前 key 寻址的桶位的头节点】
                    synchronized (f) {
                        // 这里重新获取一下桶的头节点有没有被修改,因为可能被其他线程修改过,这里是线程安全的获取
                        if (tabAt(tab, i) == f) {
                            // 【头节点的哈希值大于 0 说明当前桶位是普通的链表节点】
                            if (fh >= 0) {
                                // 当前的插入操作没出现重复的 key,追加到链表的末尾,binCount表示链表长度 -1
                                // 插入的key与链表中的某个元素的 key 一致,变成替换操作,binCount 表示第几个节点冲突
                                binCount = 1;
                                // 迭代循环当前桶位的链表,e 是每次循环处理节点,e 初始是头节点
                                for (Node<K,V> e = f;; ++binCount) {
                                    // 当前循环节点 key
                                    K ek;
                                    // key 的哈希值与当前节点的哈希一致,并且 key 的值也相同
                                    if (e.hash == hash &&
                                        ((ek = e.key) == key ||
                                         (ek != null && key.equals(ek)))) {
                                        // 把当前节点的 value 赋值给 oldVal
                                        oldVal = e.val;
                                        // 允许覆盖
                                        if (!onlyIfAbsent)
                                            // 新数据覆盖旧数据
                                            e.val = value;
                                        // 跳出循环
                                        break;
                                    }
                                    Node<K,V> pred = e;
                                    // 如果下一个节点为空,把数据封装成节点插入链表尾部,【binCount 代表长度 - 1】
                                    if ((e = e.next) == null) {
                                        pred.next = new Node<K,V>(hash, key,
                                                                  value, null);
                                        break;
                                    }
                                }
                            }
                            // 当前桶位头节点是红黑树
                            else if (f instanceof TreeBin) {
                                Node<K,V> p;
                                binCount = 2;
                                if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key,
                                                                      value)) != null) {
                                    oldVal = p.val;
                                    if (!onlyIfAbsent)
                                        p.val = value;
                                }
                            }
                        }
                    }

                    // 条件成立说明当前是链表或者红黑树
                    if (binCount != 0) {
                        // 如果 binCount >= 8 表示处理的桶位一定是链表,说明长度是 9
                        if (binCount >= TREEIFY_THRESHOLD)
                            // 树化
                            treeifyBin(tab, i);
                        if (oldVal != null)
                            return oldVal;
                        break;
                    }
                }
            }
            // 统计当前 table 一共有多少数据,判断是否达到扩容阈值标准,触发扩容
            // binCount = 0 表示当前桶位为 null,node 可以直接放入,2 表示当前桶位已经是红黑树
            addCount(1L, binCount);
            return null;
        }
put()的源码虽然很长,但是逻辑很清晰,主要步骤如下:
1、先计算key的哈希值
2、然后使用死循环遍历数组,保证put操作必须成功
3、判断数组是否为空,如果为空,就通过CAS+自旋的方式执行初始化操作
4、如果数组不为空,通过(n - 1) & hash来计算当前key在table数组中对应的下标位置,如果该位置还没有任何值,则把当前的key/value封装成Node,直接通过CAS自旋写入数据
5、判断如果当前节点哈希值等于MOVED(-1,表示正在扩容),就帮忙扩容
6、如果下标位置不为空,就使用 synchronized写入数据,写入数据同样判断链表、红黑树,链表写入和HashMap的方式一样,key hash一样就覆盖,反之就尾插法,链表长度超过8就转换成红黑树

 浙公网安备 33010602011771号