
树链剖分
树链剖分
- 类型:轻重链剖分
- 例题:https://www.luogu.com.cn/problem/P3384
- 前置知识:图论,线段树,LCA
- 思想:将树剖分为链用线段树来维护
一、树剖分为链
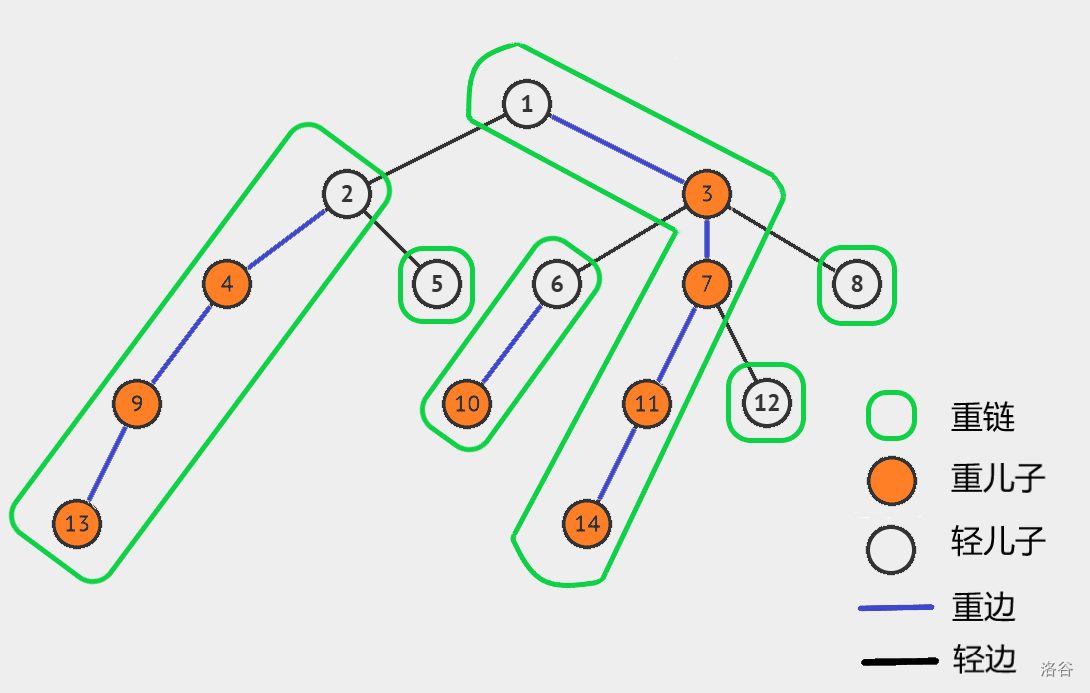
定义
- 重儿子:一个子结点中子树最大的结点。
- 轻儿子:非重儿子的结点。
- 重边:结点到重儿子的边
- 轻边:结点到轻儿子的边
- 重链:若干条首尾衔接的重边
那么:把落单的结点也当作重链,那么整棵树就被剖分成若干条重链。
如图,举个例子:
实现
用两个 dfs 实现。
一个求出结点的父结点(fa),结点的深度(dep),结点子树大小(size),重儿子编号(son)。
另一个求出重链的顶点(top),dfs 序(dfn),即在线段树中的编号,dfs 序所对应的节点编号(rev)。
会发现:rev[dfn[x]]=x。
代码展示
void dfs1(int p, int f) {
	size[p] = 1; dep[p] = dep[f] + 1; fa[p] = f;
	for (int i = h[p]; i; i = e[i].next) {
		int v = e[i].to;
		if (v == f) continue;
		dfs1(v, p);
		size[p] += size[v];
		if (size[v] > size[son[p]])
			son[p] = v;
	}
}

void dfs2(int p, int t) {
	top[p] = t;
	dfn[p] = ++cnt;
	rev[cnt] = p;
	if (!son[p]) return ;
	dfs2(son[p], t); // 优先对重儿子进行 DFS,可以保证同一条重链上的点 DFS 序连续
	for (int i = h[p]; i; i = e[i].next) {
		int v = e[i].to;
		if (v != son[p] && v != fa[p])
			dfs2(v, v);
	}
}
二、线段树
代码展示
void build(int p, int l, int r) {
	a[p].l = l; a[p].r = r;
	if (l == r) {
		a[p].dat = d[rev[l]]; // 与维护序列的线段树唯一不同,d[rev[l]] 表示树上编号为 l 的结点
		return ;
	}
	int mid = l + r >> 1;
	build(p << 1, l, mid);
	build(p << 1 | 1, mid + 1, r);
	a[p].dat = (a[p << 1].dat + a[p << 1 | 1].dat) % Mod;
}

void spread(int p) {
	if (a[p].lazy) {
		(a[p << 1].dat += (a[p << 1].r - a[p << 1].l + 1) * a[p].lazy) %= Mod;
		(a[p << 1].lazy += a[p].lazy) %= Mod;
		(a[p << 1 | 1].dat += (a[p << 1 | 1].r - a[p << 1 | 1].l + 1) * a[p].lazy) %= Mod;
		(a[p << 1 | 1].lazy += a[p].lazy) %= Mod;
		a[p].lazy = 0;
	}
}

int query(int p, int l, int r) {
	if (a[p].l >= l && a[p].r <= r) return a[p].dat;
	spread(p);
	int mid = a[p].l + a[p].r >> 1, sum = 0;
	if (l <= mid) sum = (sum + query(p << 1, l, r)) % Mod;
	if (r > mid) sum = (sum + query(p << 1 | 1, l, r)) % Mod;
	return sum;
}

void update(int p, int l, int r, int x) {
	if (a[p].l >= l && a[p].r <= r) {
		(a[p].dat += (a[p].r - a[p].l + 1) * x) %= Mod;
		(a[p].lazy += x) %= Mod; return ;
	}
	spread(p);
	int mid = a[p].l + a[p].r >> 1;
	if (l <= mid) update(p << 1, l, r, x);
	if (r > mid) update(p << 1 | 1, l, r, x);
	a[p].dat = (a[p << 1].dat + a[p << 1 | 1].dat) % Mod;
}
三、维护
1.子树修改
子树中结点的 dfs 序是连续的。
假若修改 \(p\) 的子树,则修改对象为 \(dfn[p]\sim dfn[p]+size[p]-1\)。
void update_subtree(int p, int v) {
	update(1, dfn[p], dfn[p] + size[p] - 1, v);
}
2.子树询问
同上,不做解释。
int query_subtree(int p) {
	return query(1, dfn[p], dfn[p] + size[p] - 1);
}
3.链的修改
步骤是这样的:
- 较深的结点往上跳,沿路修改
- 不在同一条重链上,回到 1
- 在同一条重链上,直接修改(因为同一条重链结点编号是连续的)
void update_chain(int x, int y, int v) {
	while (top[x] != top[y]) {
		if (dep[top[x]] < dep[top[y]]) swap(x, y);
		update(1, dfn[top[x]], dfn[x], v);
		x = fa[top[x]];
	}
	if (dep[x] > dep[y]) swap(x, y);
	update(1, dfn[x], dfn[y], v);
}
4.链的查询
同上,不做解释。
int query_chain(int x, int y) {
	int ans = 0;
	while (top[x] != top[y]) {
		if (dep[top[x]] < dep[top[y]]) swap(x, y);
		(ans += query(1, dfn[top[x]], dfn[x])) %= Mod;
		x = fa[top[x]];
	}
	if (dep[x] > dep[y]) swap(x, y);
	(ans += query(1, dfn[x], dfn[y])) %= Mod;
	return ans;
}
四、全部代码展示
#include <bits/stdc++.h>

#define int long long

using namespace std;

int read() {
    int x = 0, k = 1;
    char c = getchar();
    while (c < '0' || c > '9') {
        if (c == '-') k = -1;
        c = getchar();
    }
    while (c >= '0' && c <= '9') {
        x = x * 10 + c - '0';
        c = getchar();
    }
    return x * k;
}

#define N 100005

struct edge {
	int to, next;
} e[N << 1];

struct segt {
	int l, r, dat, lazy;
} a[N << 2];

int n, m, root, Mod;
int tot, h[N];
int fa[N], dep[N], size[N], son[N];
int cnt, top[N], dfn[N], rev[N];
int d[N];

void add_edge(int u, int v) {
	e[++tot].to = v;
	e[tot].next = h[u];
	h[u] = tot;
}

void dfs1(int p, int f) {
	size[p] = 1; dep[p] = dep[f] + 1; fa[p] = f;
	for (int i = h[p]; i; i = e[i].next) {
		int v = e[i].to;
		if (v == f) continue;
		dfs1(v, p);
		size[p] += size[v];
		if (size[v] > size[son[p]])
			son[p] = v;
	}
}

void dfs2(int p, int t) {
	top[p] = t;
	dfn[p] = ++cnt;
	rev[cnt] = p;
	if (!son[p]) return ;
	dfs2(son[p], t);
	for (int i = h[p]; i; i = e[i].next) {
		int v = e[i].to;
		if (v != son[p] && v != fa[p])
			dfs2(v, v);
	}
}

void build(int p, int l, int r) {
	a[p].l = l; a[p].r = r;
	if (l == r) {
		a[p].dat = d[rev[l]];
		return ;
	}
	int mid = l + r >> 1;
	build(p << 1, l, mid);
	build(p << 1 | 1, mid + 1, r);
	a[p].dat = (a[p << 1].dat + a[p << 1 | 1].dat) % Mod;
}

void spread(int p) {
	if (a[p].lazy) {
		(a[p << 1].dat += (a[p << 1].r - a[p << 1].l + 1) * a[p].lazy) %= Mod;
		(a[p << 1].lazy += a[p].lazy) %= Mod;
		(a[p << 1 | 1].dat += (a[p << 1 | 1].r - a[p << 1 | 1].l + 1) * a[p].lazy) %= Mod;
		(a[p << 1 | 1].lazy += a[p].lazy) %= Mod;
		a[p].lazy = 0;
	}
}

int query(int p, int l, int r) {
	if (a[p].l >= l && a[p].r <= r) return a[p].dat;
	spread(p);
	int mid = a[p].l + a[p].r >> 1, sum = 0;
	if (l <= mid) sum = (sum + query(p << 1, l, r)) % Mod;
	if (r > mid) sum = (sum + query(p << 1 | 1, l, r)) % Mod;
	return sum;
}

void update(int p, int l, int r, int x) {
	if (a[p].l >= l && a[p].r <= r) {
		(a[p].dat += (a[p].r - a[p].l + 1) * x) %= Mod;
		(a[p].lazy += x) %= Mod; return ;
	}
	spread(p);
	int mid = a[p].l + a[p].r >> 1;
	if (l <= mid) update(p << 1, l, r, x);
	if (r > mid) update(p << 1 | 1, l, r, x);
	a[p].dat = (a[p << 1].dat + a[p << 1 | 1].dat) % Mod;
}

void update_chain(int x, int y, int v) {
	while (top[x] != top[y]) {
		if (dep[top[x]] < dep[top[y]]) swap(x, y);
		update(1, dfn[top[x]], dfn[x], v);
		x = fa[top[x]];
	}
	if (dep[x] > dep[y]) swap(x, y);
	update(1, dfn[x], dfn[y], v);
}

int query_chain(int x, int y) {
	int ans = 0;
	while (top[x] != top[y]) {
		if (dep[top[x]] < dep[top[y]]) swap(x, y);
		(ans += query(1, dfn[top[x]], dfn[x])) %= Mod;
		x = fa[top[x]];
	}
	if (dep[x] > dep[y]) swap(x, y);
	(ans += query(1, dfn[x], dfn[y])) %= Mod;
	return ans;
}

void update_subtree(int p, int v) {
	update(1, dfn[p], dfn[p] + size[p] - 1, v);
}

int query_subtree(int p) {
	return query(1, dfn[p], dfn[p] + size[p] - 1);
}

signed main() {
	n = read(), m = read(), root = read(), Mod = read();
	for (int i = 1; i <= n; i++)
		d[i] = read();
	for (int i = 1; i < n; i++) {
		int u = read(), v = read();
		add_edge(u, v); add_edge(v, u);
	}
	dfs1(root, 0);
	dfs2(root, root);
	build(1, 1, n);
	while (m--) {
		int op = read();
		if (op == 1) {
			int x = read(), y = read(), v = read();
			update_chain(x, y, v);
		}
		if (op == 2) {
			int x = read(), y = read();
			printf("%lld\n", query_chain(x, y));
		}
		if (op == 3) {
			int x = read(), v = read();
			update_subtree(x, v);
		}
		if (op == 4) {
			int x = read();
			printf("%lld\n", query_subtree(x));
		}
	}
}
五、后续:
1.时间复杂度
树的重链数量小于 \(\log n\),线段树的操作时间复杂度为 \(O(\log n)\),所以在修改和询问链的时间复杂度为 \(O(\log^2 n)\) 。
所以总时间复杂度为 \(O(n \log n + q \log^2 n)\) 。完全二叉树会超时,但随机数据下不用担心。
2.边权转点权
树的边上有权值的问题。例如:https://www.luogu.com.cn/problem/P4315
只需将指向子结点的边权设为子结点的点权,查询是特殊处理一下即可。

 浙公网安备 33010602011771号