
2026年知网AIGC困惑度检测是什么原理?免费5步把AI率从70%压到12%操作教程
2026年知网AIGC困惑度检测是什么原理?免费5步把AI率从70%压到12%操作教程
知网AIGC检测有一个关键指标叫“困惑度“(Perplexity),很多同学在检测报告里见过这个词,但不知道它是什么意思,也不知道怎么影响最终的AI率。
搞清楚这个原理,降AI率的方向就对了。
主要工具用嘎嘎降AI(www.aigcleaner.com),下面把5步操作流程和原理一起说清楚。
困惑度检测是什么原理
困惑度(Perplexity)是衡量语言模型对文本“意外程度“的指标。简单理解:
- 困惑度低 = 这段文字太规律,模型能轻易预测下一个词 → 像AI写的
- 困惑度高 = 这段文字比较“意外“,模型不容易预测 → 像人写的
AI生成的文字之所以困惑度低,是因为大语言模型生成内容时会选择“最高概率“的下一个词,导致文本在统计上非常规律、可预测。
知网AIGC检测通过分析文本的困惑度分布来判断是否是AI生成的。困惑度均匀且偏低的段落,被标记为AI内容的概率很高。
所以,提高文本困惑度是降低AI率的核心思路:用更不可预测、更个性化的表达方式,让检测算法觉得这是人写的。
为什么换词没用
很多同学用的方法是把AI率高的句子里的关键词换掉,比如把“显著“换成“明显“,把“提升“换成“改善“。
这种方法基本没用,因为困惑度检测分析的是句子层面的统计特征,不是具体词汇。换词不改变句子结构,困惑度不变,AI率也不变。
真正有效的方法是从句子结构层面做改变,这正是嘎嘎降AI双引擎(语义同位素分析+风格迁移网络)做的事情。
5步操作流程
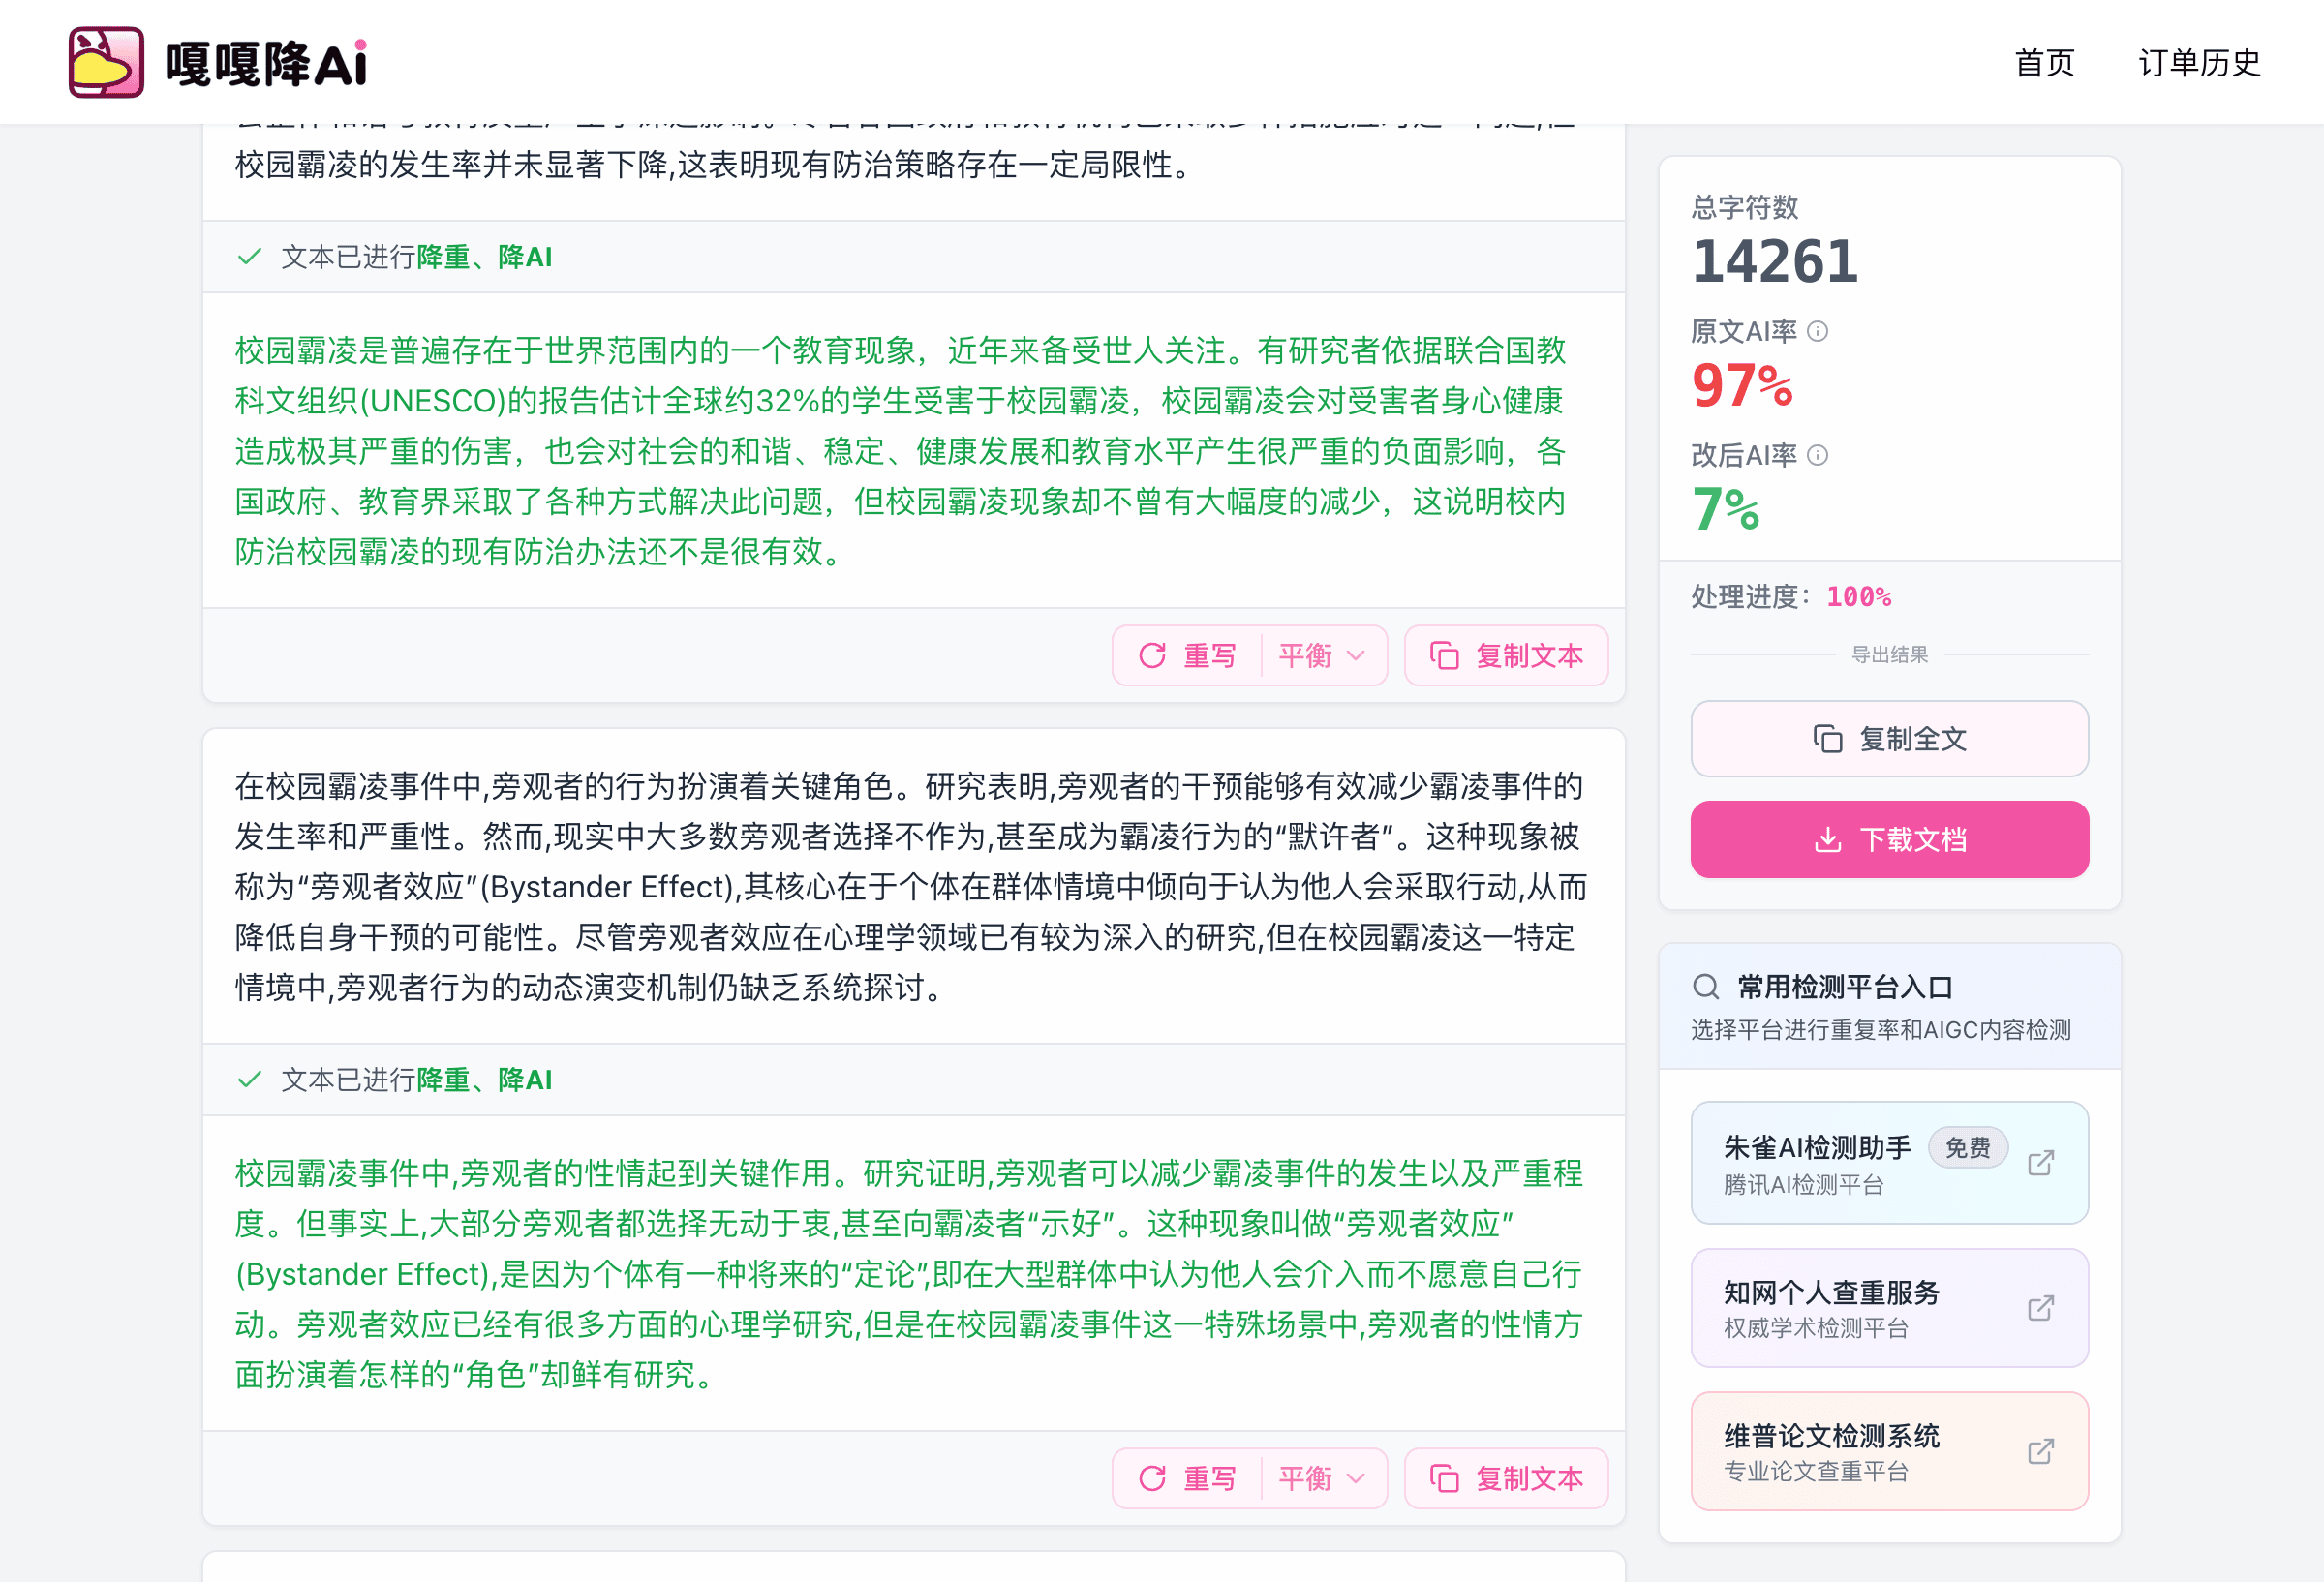
第一步:上传全文检测,看困惑度分布
登录嘎嘎降AI(www.aigcleaner.com),上传全文检测,查看各章节的AI率分布。通常引言和文献综述困惑度最低(AI味最重),结果和讨论部分因为有数据支撑,困惑度相对高一些。
整篇都要测,不能只看标红部分。
第二步:人工提高重灾区的困惑度(先做这一步)
在上工具之前,先对AI率最高的段落做人工调整:
- 在段落里加入一两个具体的研究细节或数字
- 加入研究者的个人判断(“值得注意的是……“)
- 把超过30字的长句拆成两句
这一步是免费的,而且处理之后工具的降AI效果会更好。
第三步:整篇上传嘎嘎降AI深度改写
做完人工润色,把全文整篇上传嘎嘎降AI,选深度改写模式。
这一步有个关键点:建议把全文上传进去降,不要只降某些段落,否则处理过和没处理过的部分困惑度分布不一致,知网检测会识别出来,降AI效果大打折扣。
嘎嘎降AI的双引擎会从句子结构层面提高文本困惑度,而不是简单替换词汇,处理完的文章在统计分布上更接近人写的内容。
第四步:通读检查内容完整性
工具处理完之后通读一遍,确认专业术语没有被改错,论文的核心论点表述没有变形。深度改写模式会改变句子结构,但内容层面的信息应该完整保留。
第五步:复测,不达标再处理一次
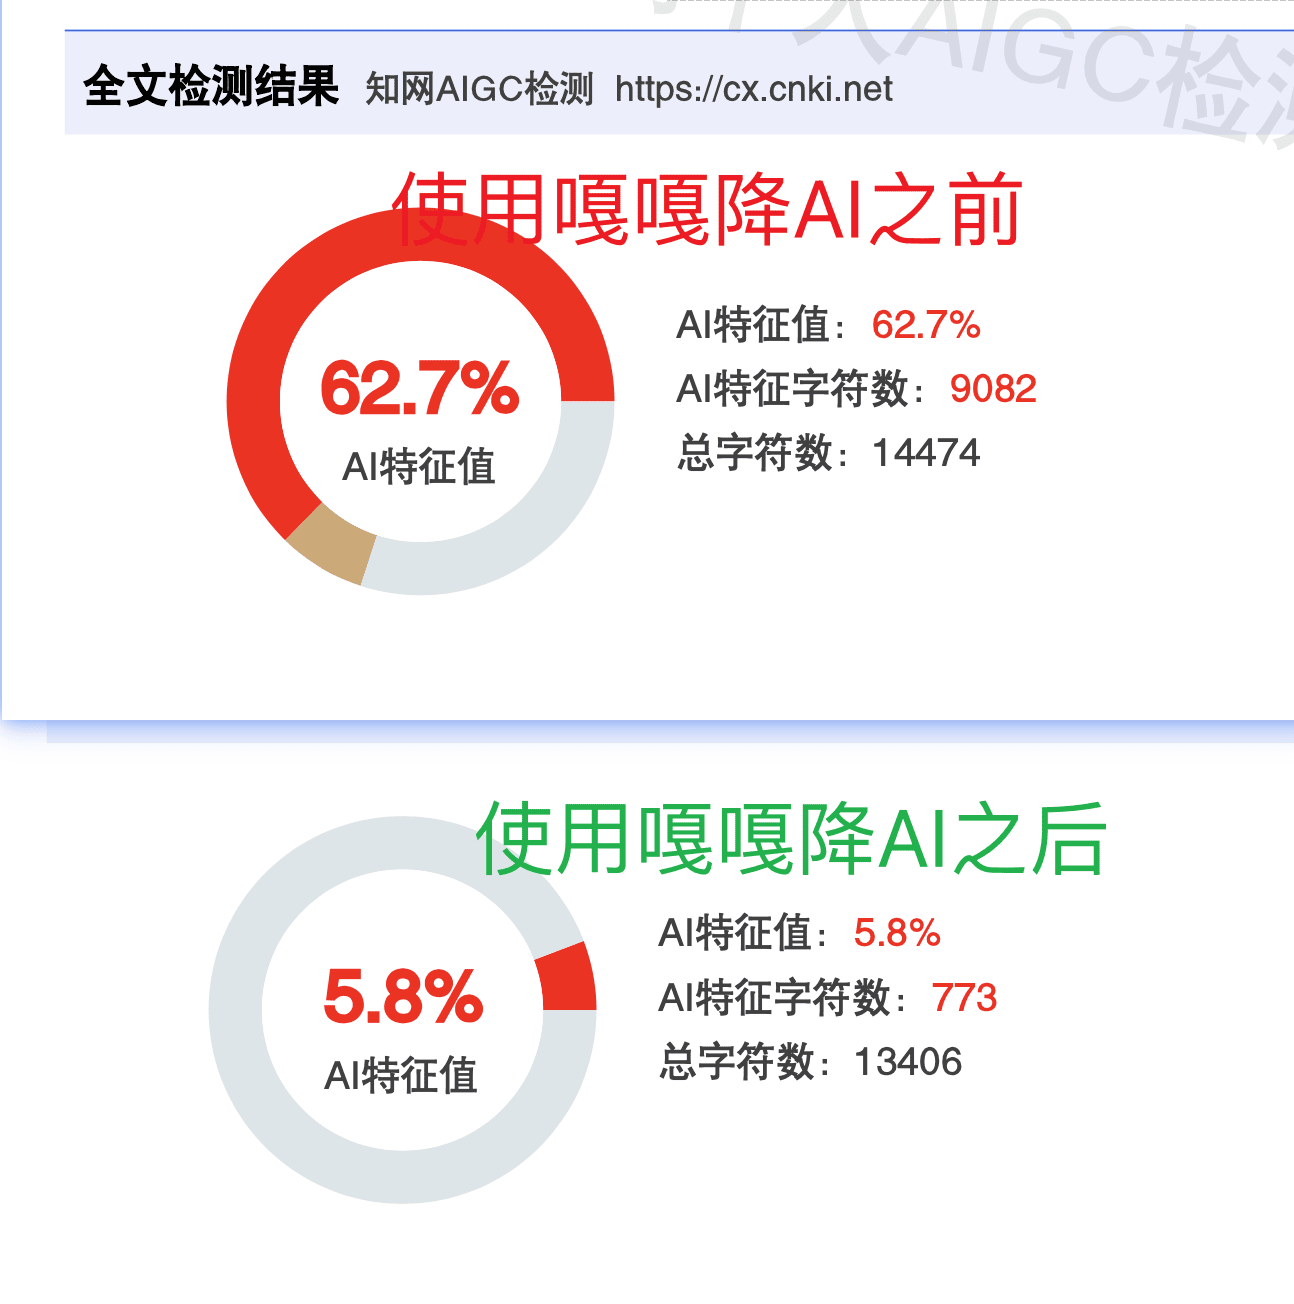
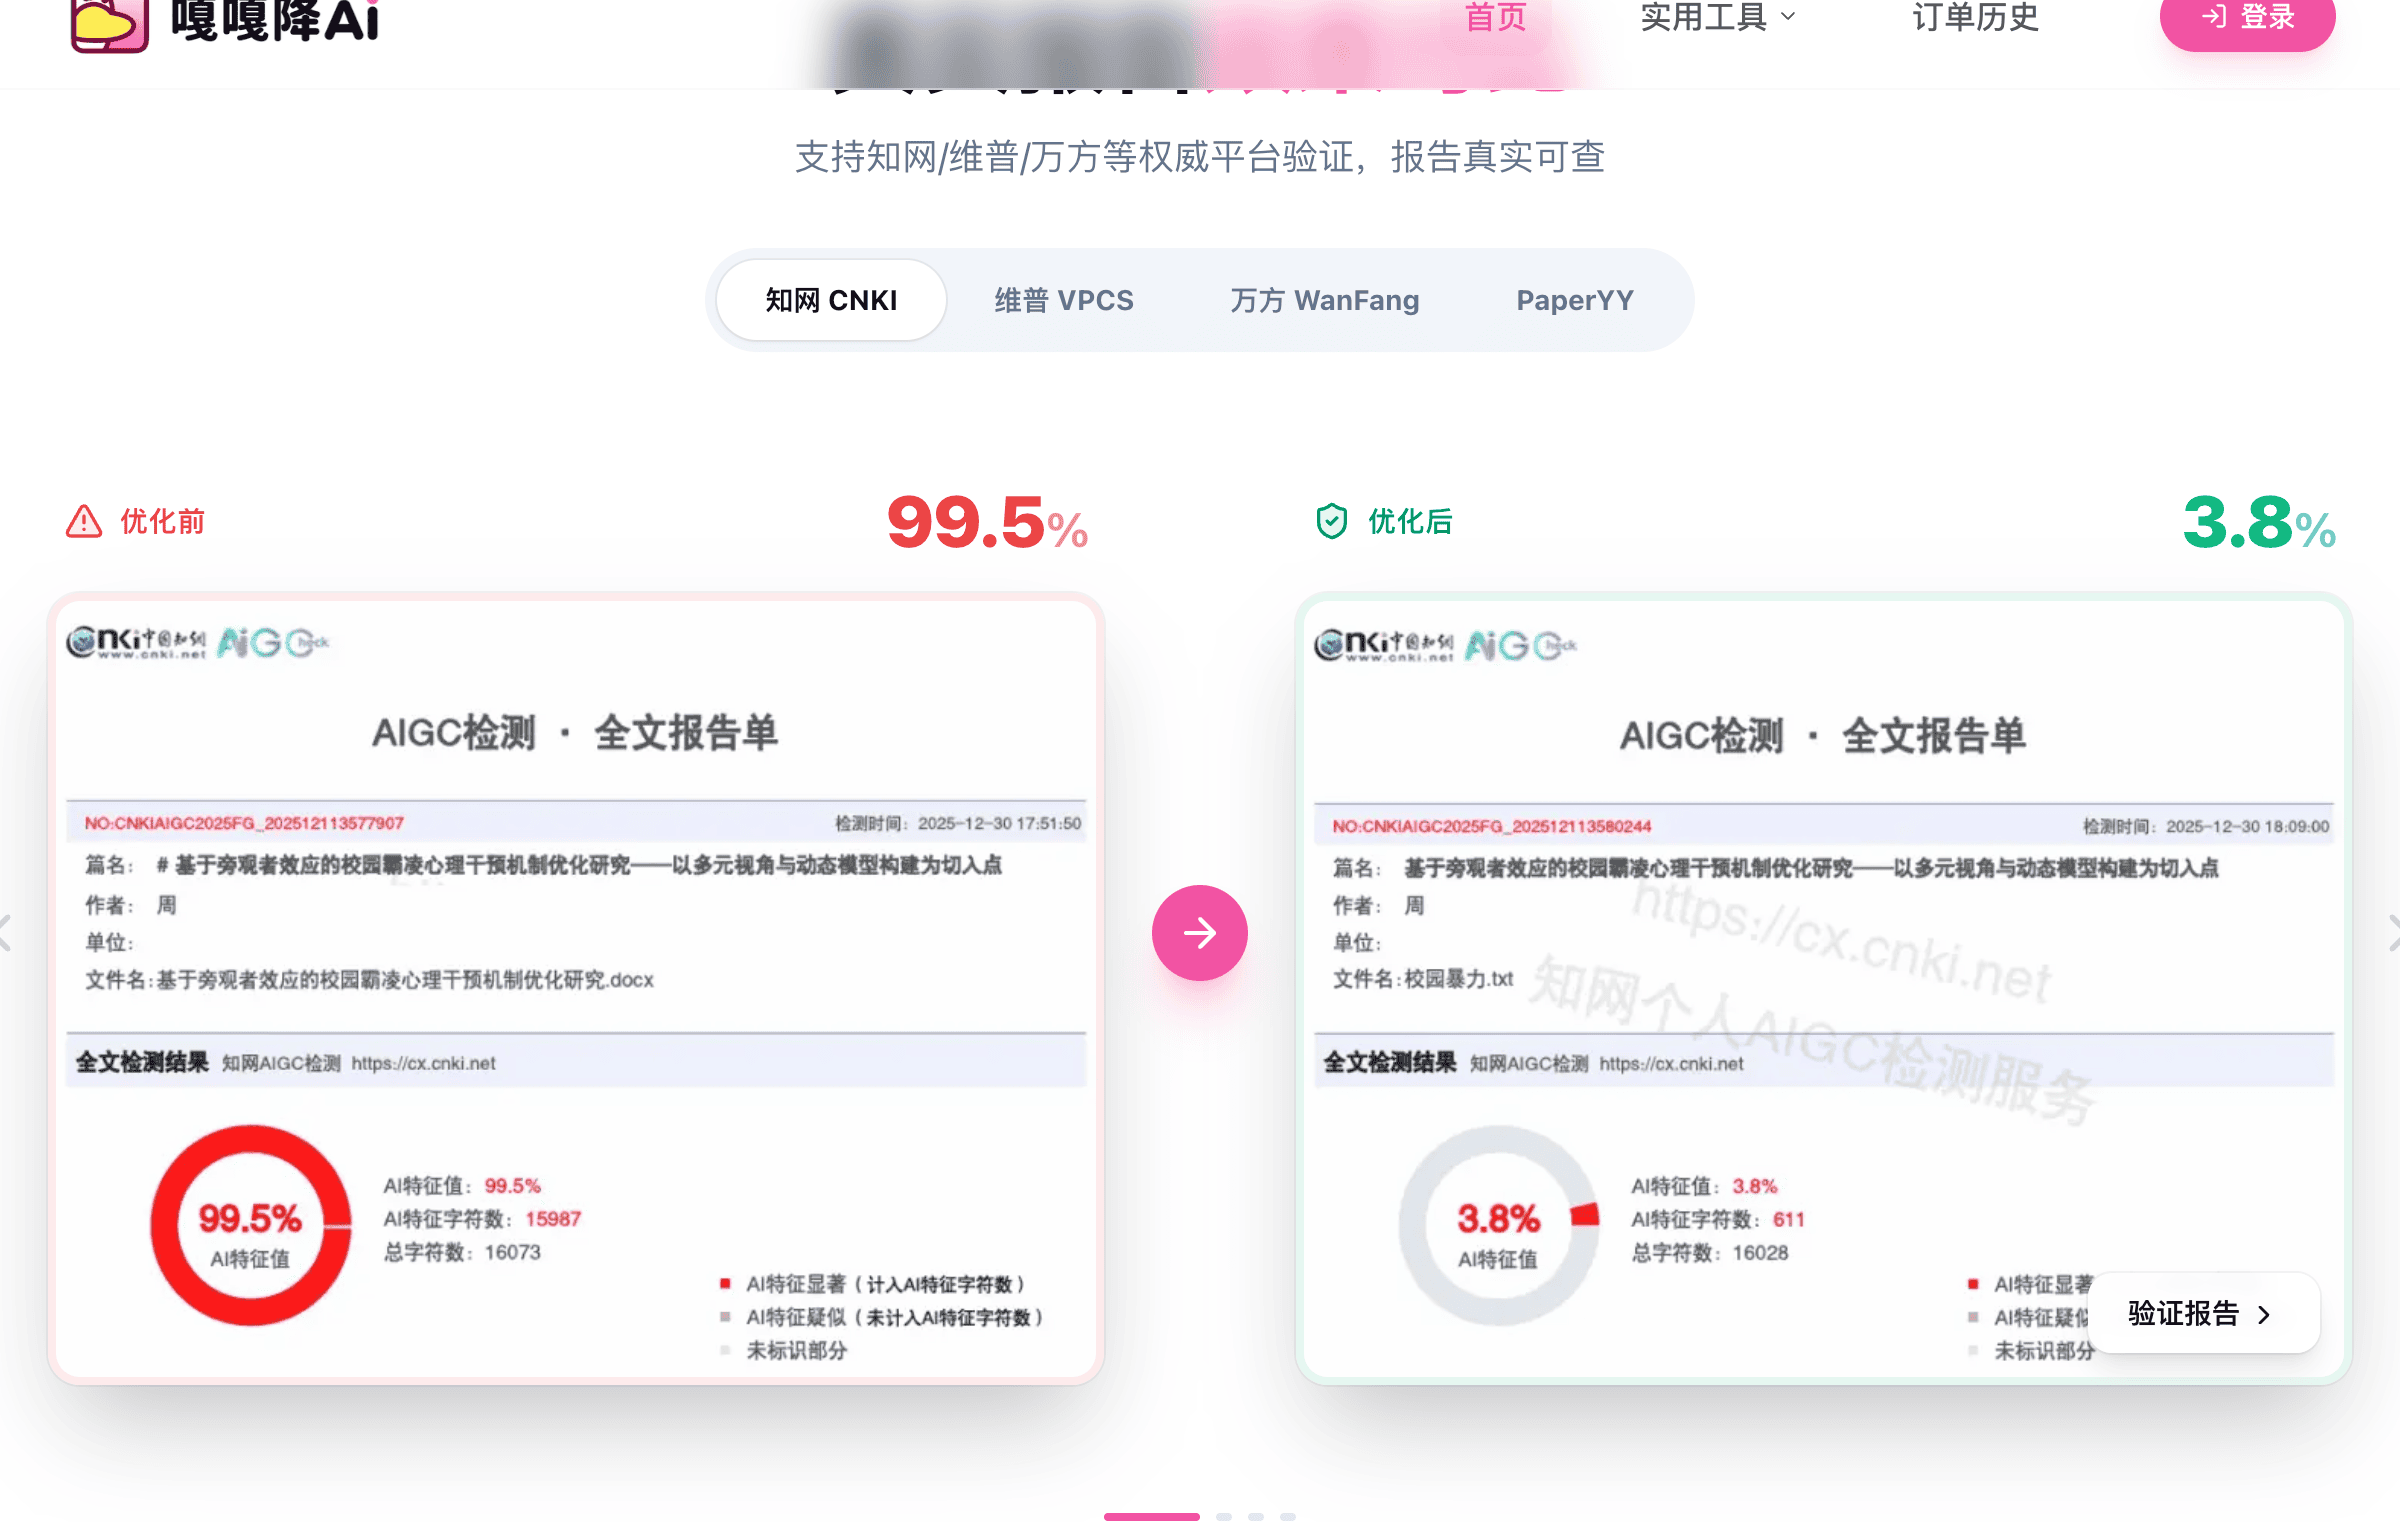
AI率70%的论文,按这个流程走,通常一次处理能降到15%-20%,加上人工润色可以到12%左右。如果还不够,把剩余的高AI率段落再单独处理一次。
嘎嘎降AI有不达标退款保障,处理完如果还是超过20%,可以申请退款或重新处理。
工具对比
| 工具 | 价格 | 困惑度优化 | 知网适配 | 退款 | 官网 |
|---|---|---|---|---|---|
| 嘎嘎降AI | 4.8元/千字 | 双引擎深度优化 | 9大平台 | 未达标可退款 | www.aigcleaner.com |
| 比话 | 8元/千字 | Pallas引擎 | 知网专项 | 全额退款 | www.bihuapass.com |
| 率零 | 优惠价 | 深度语义重构 | 多平台 | - | www.0ailv.com |
常见问题
困惑度和重复率有什么区别?
重复率(查重)检测的是文字和其他文献的相似度;困惑度检测的是文字的AI特征。两个是独立的检测维度,降重复率的方法(改写、同义替换)对困惑度没有帮助,需要分开处理。
手动提高困惑度有没有具体的方法?
有效的方法:加入具体数字(“实验组n=53“而不是“实验组人数较多“)、用主动句代替被动句、加入研究者的主观判断、拆分长句、改变段落开头方式(不要全用主语+谓语开头)。
为什么处理完之后第二天测AI率又高了?
检测结果不会因为时间而变化,如果重测数值变高,可能是你在工具处理后又做了修改,修改的部分没有被处理。再次上传处理之前,确认修改的段落也在上传的文件里。
本文提到的工具官网:
- 嘎嘎降AI:www.aigcleaner.com
- 比话:www.bihuapass.com
- 率零:www.0ailv.com
 浙公网安备 33010602011771号