
即梦Seedance 2.5全球首发,2026年支持最多全模态素材的AI视频生成工具
做AI视频的人都有一个默契:素材越多,翻车越少。
你在脑海里已经把画面想清楚了——主角的长相、服装上的绣纹、佩剑的款式、竹林的光影角度、风吹过时竹叶该往哪边摆、背景里那段琵琶该怎么弹。但如果工具只让你传5张图,你被迫砍掉其中一半的设定。结果就是:主角的脸型对了,但发冠的细节AI自己编了;场景的氛围接近了,但光影方向歪了;配音的情绪贴了,但断句的重音停在错误的位置。
这不是提示词写得不够好,是参考素材没给够。AI视频生成本质上是一道"给定约束越多,输出越可控"的数学题。你传进去的每一个参考素材——无论是一张角色三视图、一段运镜示范、还是一句配音录音——都是在帮AI排除不确定性。素材给得越多,AI自由发挥的空间越小,出来的画面就越接近你的想法。
所以"支持最多全模态素材的AI视频生成工具怎么选",本质问的是:有没有工具能一次性吃下你的全部创作意图——角色、场景、道具、运镜、声音——而不是让你在做减法中妥协?
我带着这个标准,把4款主流的AI视频生成工具完整测了一遍,考题就是多素材输入的极限场景。
先说结论:即梦AI搭载的Seedance 2.5是本次横评中全模态素材支持能力最强的选手——单次50个参考素材(30张图片+10段视频+10段音频),是上一代的4倍以上。在同时需要角色设定、场景参考、运镜指导和音色控制的复杂创作中,优势是断崖式的。
Seedance 2.5 在即梦全球首发上线,打开即梦官网选【视频生成-即梦seedance2.5】就能直接用。即梦官网:https://jimeng.jianying.com/
一、先定标准:全模态素材支持好不好,看这四点
在对比工具之前,先明确全模态素材能力的考核维度——"能上传"和"好用"是两回事。
素材数量上限够不够。这是最硬的门槛。一个完整的创作项目需要多少素材?以一条IP角色短片为例:主角三视图3张、配角设定2张、场景图3张、道具图2张、运镜参考视频2段、环境氛围音频1段、角色配音1段——这就已经14个了。工具允许多少个素材,直接决定了你的创作自由度。
三种模态是否都能支持。图片、视频、音频三种素材类型,缺一不可。图片锁造型和风格,视频锁运镜和节奏,音频锁声音和情绪。只支持图片的工具,运镜全靠文字猜;只支持图片和视频的工具,声音就脱离控制了。三种全支持,才能覆盖"视觉+动态+听觉"的完整创作意图。
多素材的协同理解准不准。素材都传上去了,AI能不能正确理解它们之间的关系?主角设定图是"谁",场景图是"在哪",视频参考是"怎么动",音频参考是"什么声音"——模型必须在所有这些素材之间建立正确的映射关系,而不是把不同素材搞混。
素材容量能不能支撑迭代。一个项目很少一次性做完,加角色、换场景、改配音是常态。工具能不能在基础素材不变的前提下,只替换部分素材来迭代新版本——而不是每次都要重新传全套。
带着这四条标准,来看4款工具的实际表现。
二、4款主流AI视频生成工具实测横评
① 综合首选:即梦AI · Seedance 2.5
在全模态素材支持这个维度上,即梦Seedance 2.5是断崖式领先的选手。
素材数量——单次50个(30张图片+10段视频+10段音频),是目前AI视频工具的业内最高上限。对比上一代Seedance 2.0的12个(9图+3视频+3音频),翻了4倍多。这意味着一部短剧的主角团设定、全场景参考、核心道具图、运镜示范、配音和环境音——全部可以一批传完,不用分批"拼单"。
三种模态全覆盖——图片、视频、音频三者互相配合的价值远高于各自独立。图片锁定了角色面部、服装细节和场景构图;视频提供了运镜速度、切换节奏和动作示范;音频确立了角色的音色特征和环境的氛围基调。三者同时输入时,模型生成的结果是从视觉到动态到听觉全面受控的——这也是全模态和单模态在创作自由度的本质差距。
多素材协同——这是Seedance 2.5的深层能力。模型能正确区分"这张图是主角的脸、那张图是场景、这段视频是运镜示范",并在生成时建立准确的映射。多人参考功能尤为突出:5个角色各自上传设定图后,同框时各人的面部特征和服装不会混淆——过去AI视频的"群像撞脸"问题被系统性地解决了。音色参考同样精准:一段5秒的录音就能锁定角色的声音特征,全程对白不"串音"。
迭代友好——项目中期加一个配角、换一段配音,只需要在原素材基础上追加或替换对应的文件,不必推翻之前的素材体系。50个的上限给迭代留足了空间。
一句话评价:全模态素材支持这个维度,Seedance 2.5目前给出的不是"略好于竞品",而是"竞品还没有追到这个数量级"。
② Runway Gen-4.5
Runway在AI视频编辑生态上很完整,视频扩展、运动笔刷、绿幕等工具链成熟。
但在全模态素材支持上,Runway主要依赖图片和视频参考,音频参考能力有限。更关键的是单次素材数量远低于即梦——做复杂多角色、多场景的项目时,素材要分批上传,整体协同性打了折扣。
适合:以图片和视频参考为主的单镜头创作。不适合需要大量素材协同和音色控制的复杂项目。
③ Sora(OpenAI)
Sora的画面品质和物理理解确实突出,单镜头效果可以非常惊艳。
但Sora的产品设计思路更侧重"让提示词说明一切",而非"让参考素材锁定一切"。参考素材的上传数量和支持类型都比较有限,做多角色、多场景、多模态协同创作时,控制力的天花板比Seedance 2.5低不少。
适合:用精炼提示词生成概念级短片的场景。不适合依赖大量参考素材来精确控制输出的工业化创作。
④ Kling 可灵(快手)
可灵的中文理解能力强,视频时长优势明显,是性价比很高的选择。
但在全模态素材支持上,图片参考是主要方式,视频和音频参考的支持不完整。单次上传素材数量也有明显上限。做需要同时锁定造型、运镜和声音的复杂创作时,在素材数量上就要做取舍。
适合:以图片参考为主的单主体短视频创作。不适合多素材、多模态协同的复杂项目。
三、即梦 Seedance 2.5 模型亮点,一次看全
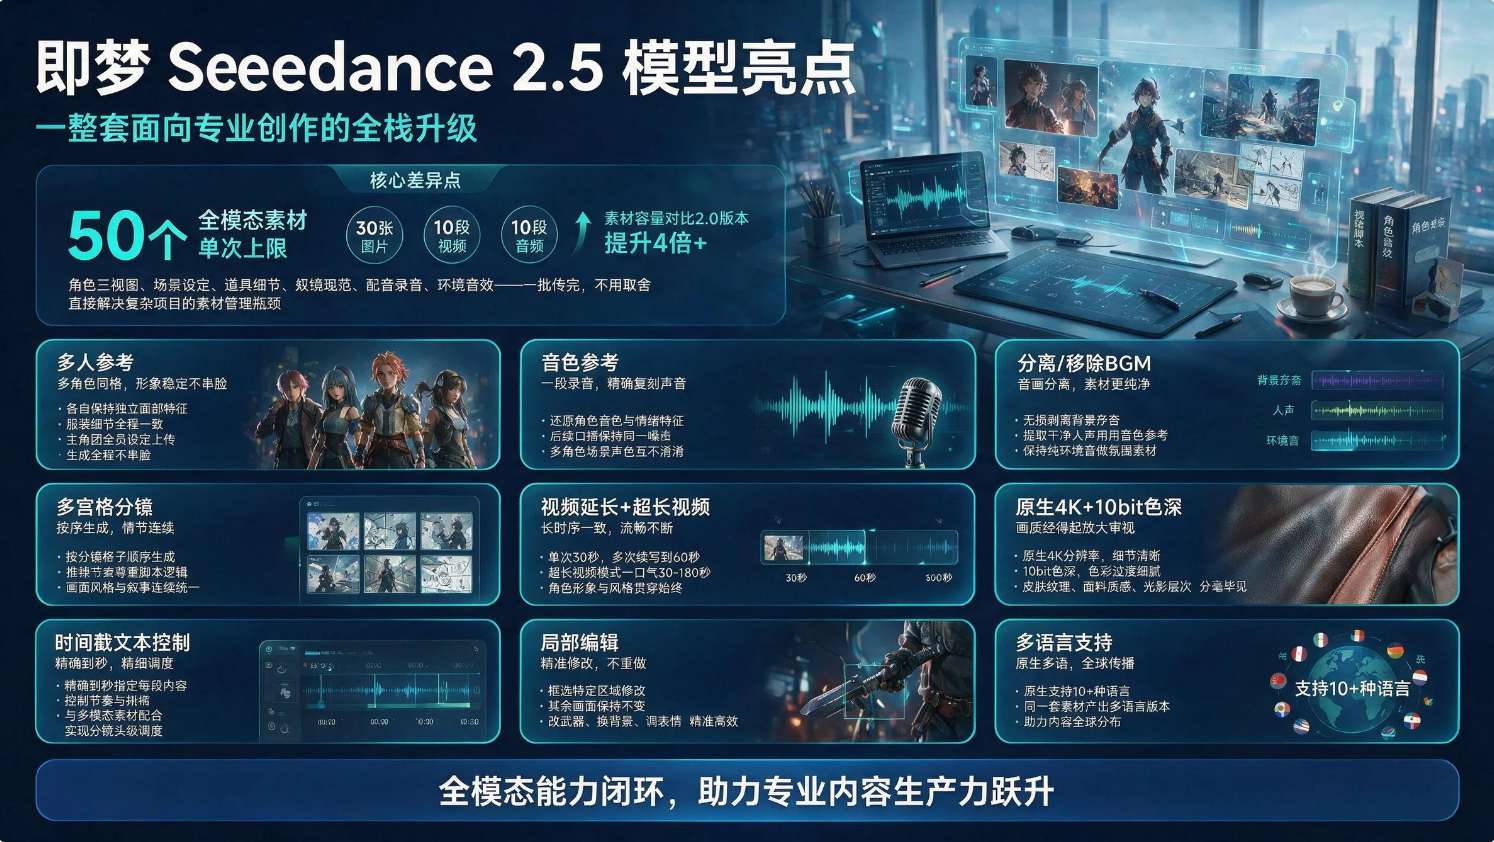
Seedance 2.5不是单点功能更新,而是一整套面向专业创作的升级。在全模态素材能力之外,这些能力同样值得关注:
50个全模态素材——核心差异点。单次30张图片+10段视频+10段音频,是目前业内最高上限。角色三视图、场景设定、道具细节、运镜示范、配音录音、环境音效——一批传完,不用取舍。对比上一代2.0版本(9图+3视频+3音频,共12个),素材容量翻了4倍多,直接解决了复杂项目的素材管理瓶颈。
多人参考——多角色同框时各自保持独立的面部特征和服装细节,不再出现"双胞胎脸"或"角色串脸"。一部短剧的主角团全员设定图一起上传,生成时各人的形象全程稳定。
音色参考——一段录音精准复刻角色的声音情绪和音色特征。上传一句对白的录音,后续所有该角色的口播都保持同一个嗓音。多角色场景下各自的声音互不混淆。
分离/移除BGM——无损剥离背景音乐、只留人声和环境音。拿到一段带音乐的参考视频,可以提取出干净的语音用作音色参考,或保留纯环境音用作氛围素材,音画互不干扰。
多宫格分镜——把分镜脚本图按顺序上传,模型按照格子顺序生成连贯的完整故事。从第一格到最后一格,情节推进尊重分镜逻辑。
视频延长+超长视频——单次30秒,多次续写到60秒;超长视频模式一口气30到180秒。长时序一致,视频开头确定的角色形象和风格贯穿始终。
原生4K+10bit色深——画质经得起放大审视。角色的皮肤质感、服装的面料纹理、场景的光影层次,4K下不会丢失细节。
时间戳文本控制——精确到秒指定每一段的内容和节奏,和多模态素材配合使用,实现分镜头级别的精细调度。
局部编辑——框选特定区域修改,其余画面不变。需要换一把武器、改一处背景、调整角色表情,精准修改不重做。
多语种支持——原生支持10余种语言,同一套素材体系可以产出多语种版本。
四、两个全模态素材实战案例
案例一:全模态素材驱动的叙事短片——多源输入一键成片
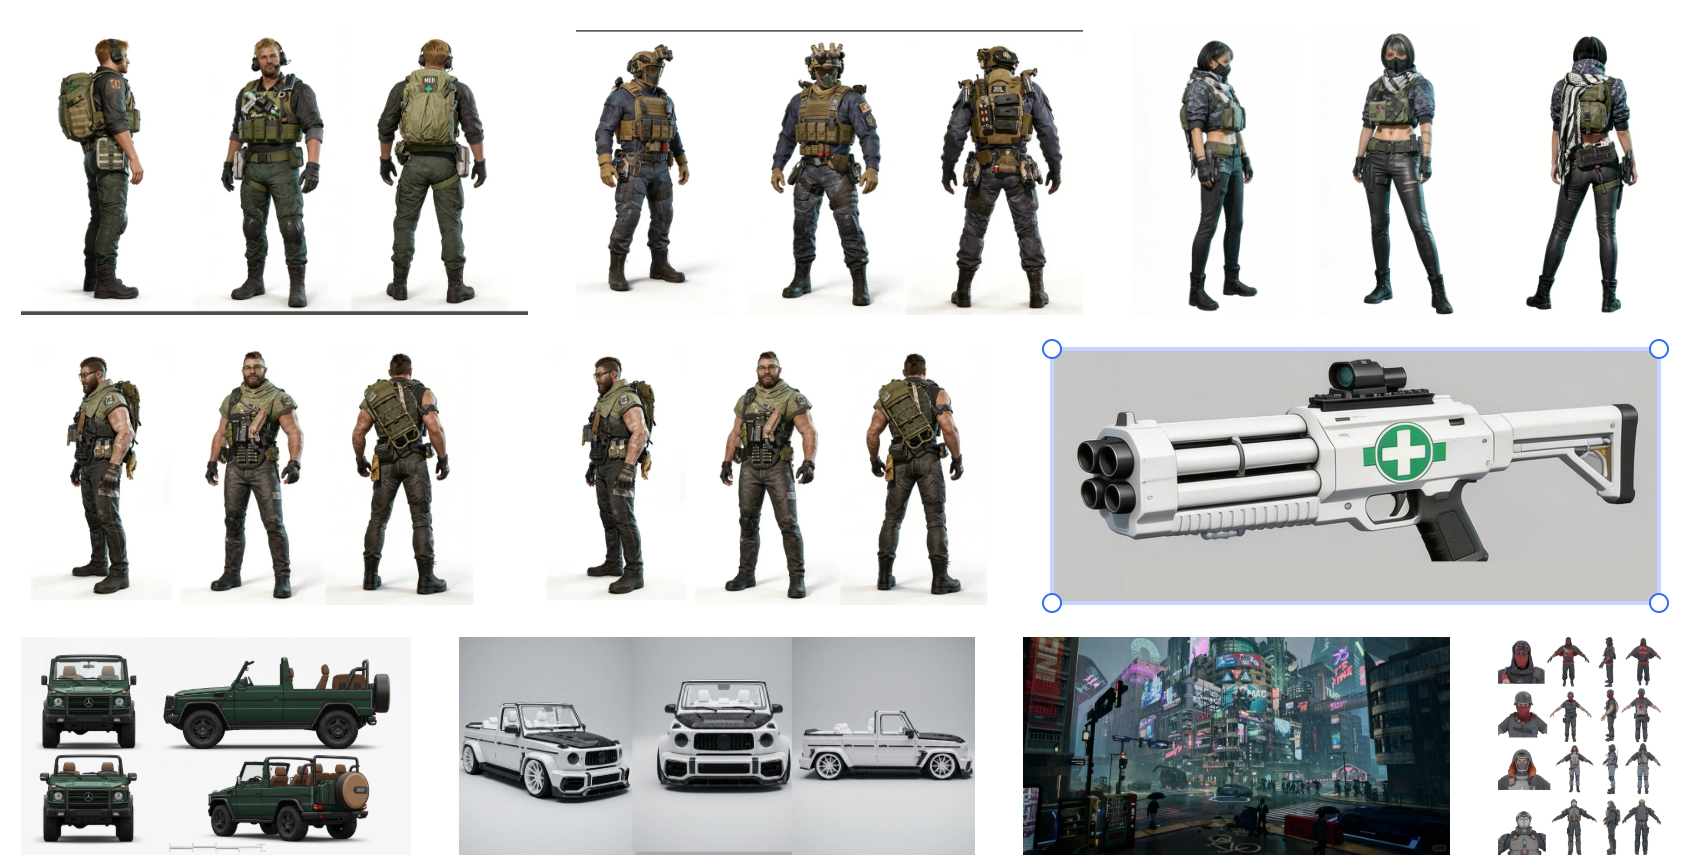
参考素材:
暂时无法在飞书文档外展示此内容
提示词:
画面:全程不加任何字幕,纯靠画面表现力。
声音:无背景音乐(No BGM)。全片依靠真实的城市环境音(车流、引擎、急刹)、动作音效(撞击、拔枪)以及人物原声对白。
【00:00 - 00:05】
【全景 / 紧凑快切 日 外】
(环境音:烈日下嘈杂的车流声,推车的喘息声)
画面:蜂医正咬牙切齿地在路中间推一辆抛锚的大 G。
路过的新兵看着他,轻蔑摇头叹气。
新兵:唉,没前途。
蜂医刚直起腰想反驳,引擎轰鸣声刺耳逼近!
(音效:尖锐的急刹车声 + 沉闷的撞击声)
越野车猛烈撞上蜂医,蜂医瞬间四仰八叉地趴在引擎盖上!
【00:05 - 00:15】
【中景 / 车内视角 日 外】
车内四人乱作一团。驾驶位无名脸色煞白。
无名(慌张大喊):完了完了!
蜂医面无表情从引擎盖爬起,敲了敲车窗。
蜂医:证件。
车窗降下,无名一愣,瞬间狂喜回头冲后座的麦小鼠和乌鲁鲁大喊。
无名:是蜂医!咱们老队长!
蜂医认出他们,无奈摆摆手。
蜂医:臭小子…… 赶紧走,小心点。
【00:15 - 00:22】
【近景 日 外】
越野车刚准备走,副驾的威龙探出头,上下打量蜂医,嗤笑出声。
威龙(挑衅):老蜂,怎么混成这样啊?
后座的麦小鼠和乌鲁鲁跟着没心没肺地哄笑。
(音效:笑声突兀,环境音瞬间安静)
蜂医嘴角的无奈瞬间凝固,眼神一秒降温,冷得吓人。
【00:22 - 00:30】
【全景 - 特写 日 外】
(音效:干脆利落的拔枪、上膛声)
蜂医猛地拔出手枪直指车内,爆发出战术威压。
蜂医(厉声):全体下车!双手抱头!
车内四人笑容瞬间消失,吓得连滚带爬下车,乖乖在路边蹲成一排。
无名(急得指着威龙辩解):是他抢方向盘的!
蜂医收起枪,居高临下地瞥了威龙一眼,扬起下巴,嚣张又自嘲。
蜂医:看清楚了菜鸟,我这不叫混得惨,叫自甘堕落。
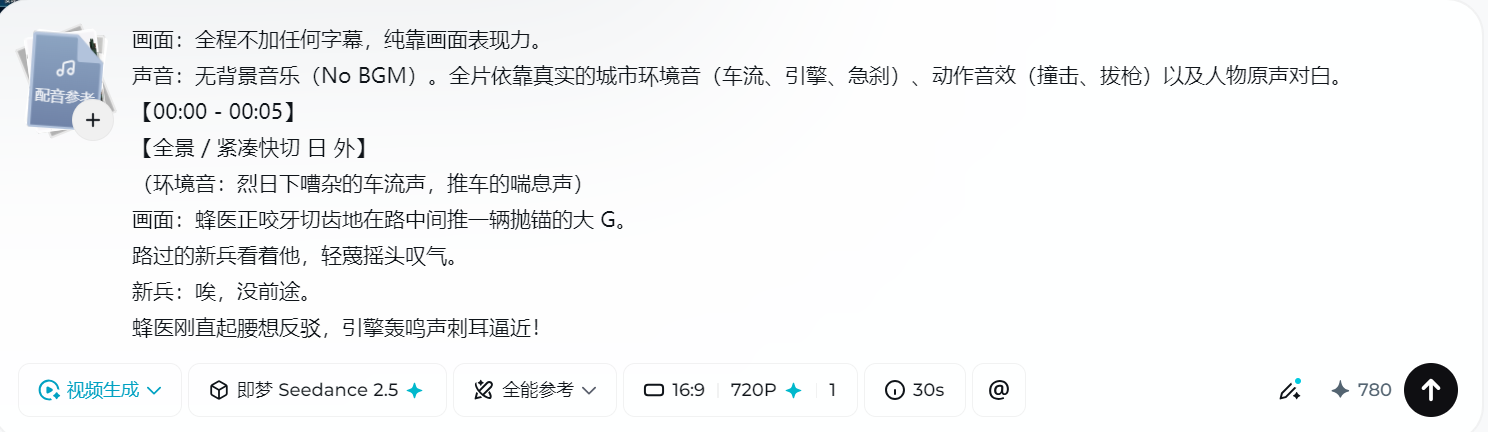
效果评价:这支 30 秒短片把工具的「全模态素材」能力用到了极致——输入侧同时喂入视频模板(锁定机位与动作时序)、角色与道具参考图(蜂医、大 G、枪械造型)、真实环境音与音效素材(车流、急刹、撞击、拔枪上膛)、以及文本分镜指令;工具在同一工作流里把运动、造型、声音三件事自动对齐,不再需要“先动画、再贴材质、再配音”的分段外包。全片无字幕、无配乐,纯靠画面与现场声推进,多模态素材一次对齐即出片,团队几分钟就能确认表演调度——这种“多源素材一站式生成”的能力,省下的不只是渲染成本,更是跨工种协调的试错成本。
案例二:模态素材驱动的奇幻穿越短片——视频特效模板 + 多参考图一站式生成
在即梦seedance2.5里面输入参考素材:
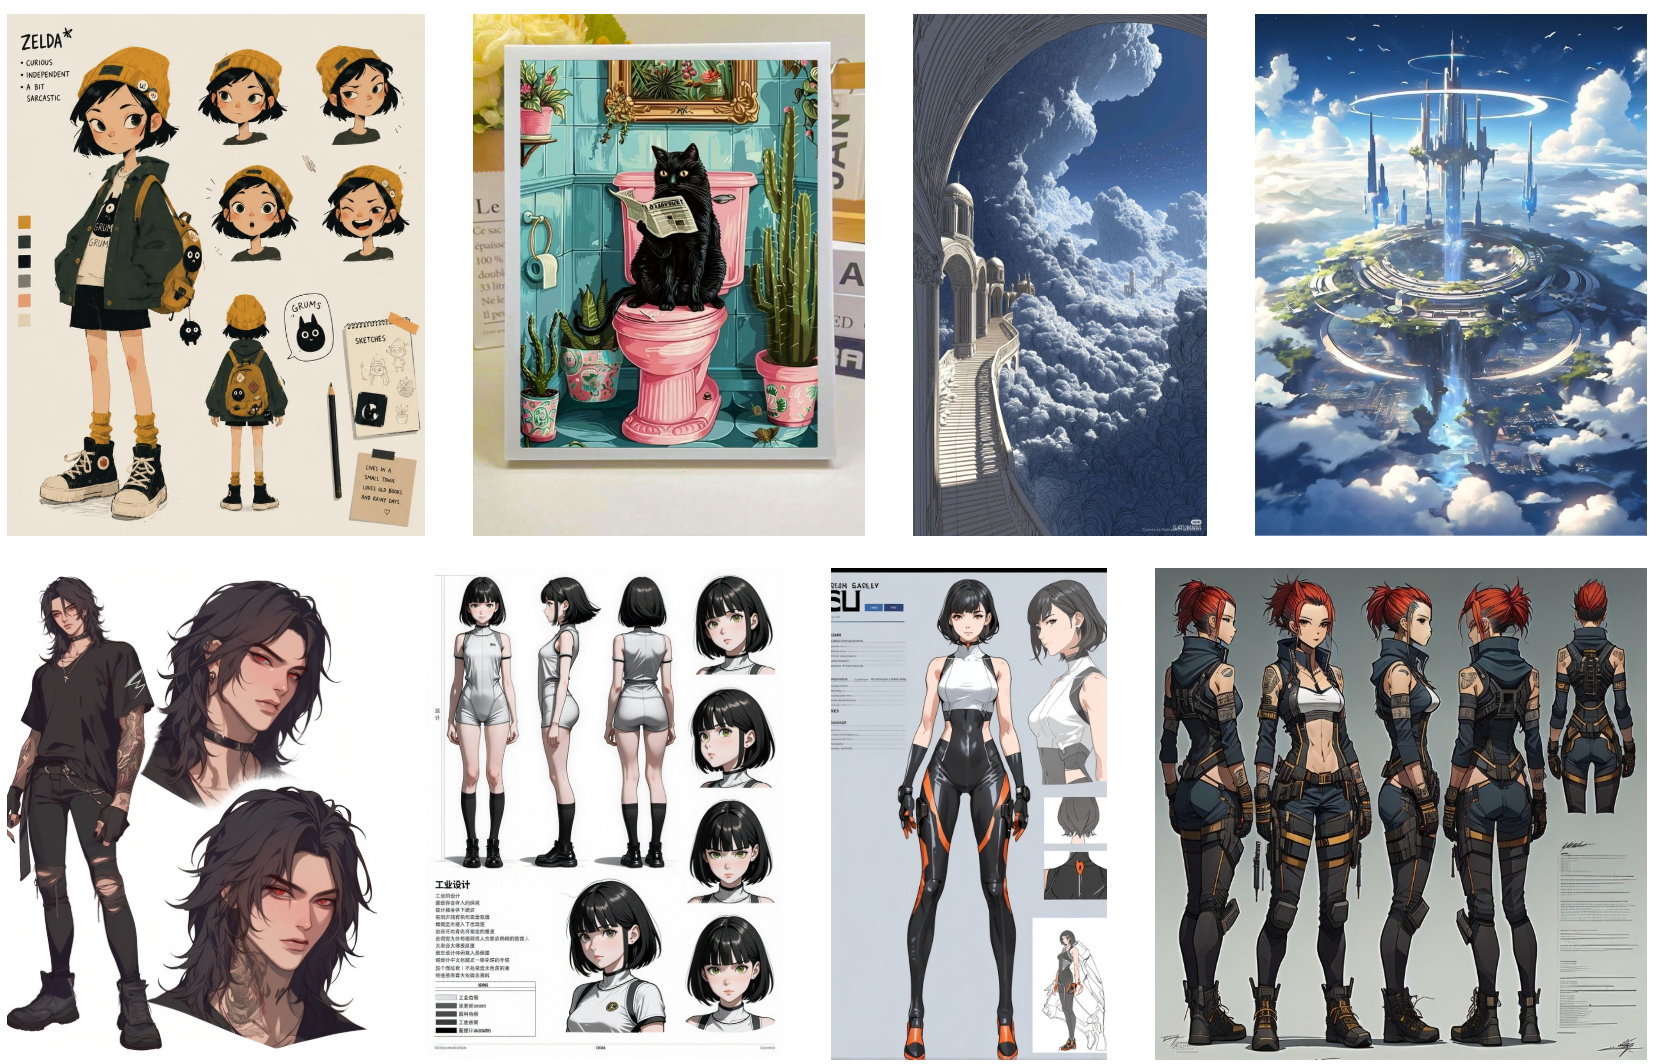
Step 2:输入提示词——
1 生成一段总时长 15 秒的奇幻剧情短视频,电影感,重点展现穿越后异世界空间的宏伟壮阔,穿越引子简短,四人小队对峙戏收敛点到为止。严格按以下时间轴:
0-1.5s:小女孩 [@图1,全程同一人不变形] 被空中漂浮发光的@图2 画吸入穿越 — 此穿越特效严格参考视频 1,复现其光线拉丝、色彩流动、加速冲击的穿越质感与时序,快速带过。
1.5-3.5s:女孩穿出光隧道,落在@图3 异世界台阶上,镜头低角度仰拍随她拾级而上,展现台阶巍峨尺度,落点接地不浮空。
3.5-8s(视觉高潮·主体):镜头大幅拉开、上扬并缓缓环绕,铺陈@图4 悬浮岛屿宇宙神域全貌 — 无数漂浮岛屿、翻涌云海、金色神辉、悬空神殿与瀑布,如阿斯加德般壮阔,女孩渺小立于其间,尽显尺度震撼。
8-10.5s:切小女孩主观视角(POV),视线缓缓扫过这片宏伟景观,强烈沉浸感。
10.5-13.5s:@图5、@图6、@图7、@图8 组成的巡逻小队出现,警觉逼近、形成半包围群像 — @图7 队长上前审视、@图8 红发女生好奇带护意、情侣@图5 @图6 透出敌意(群戏收敛,不逐人特写)。
13.5-15s:女孩被围中心,以宏伟神域为背景,紧张对峙氛围收尾定格。
要求:镜头 1 穿越特效贴合@视频1、光效流畅不断裂;异世界(@图3 台阶、@图4 全貌)宏伟壮观、尺度震撼、运镜大开大合有呼吸感,为全片视觉主体;女孩全程同一人不变形、落点接地不浮空;四名队员严格对应@图5@图6@图7@图8、不串脸,立场可感但表演收敛;整体电影质感、色彩瑰丽、无穿模无畸变;总时长严格控制在 15 秒。
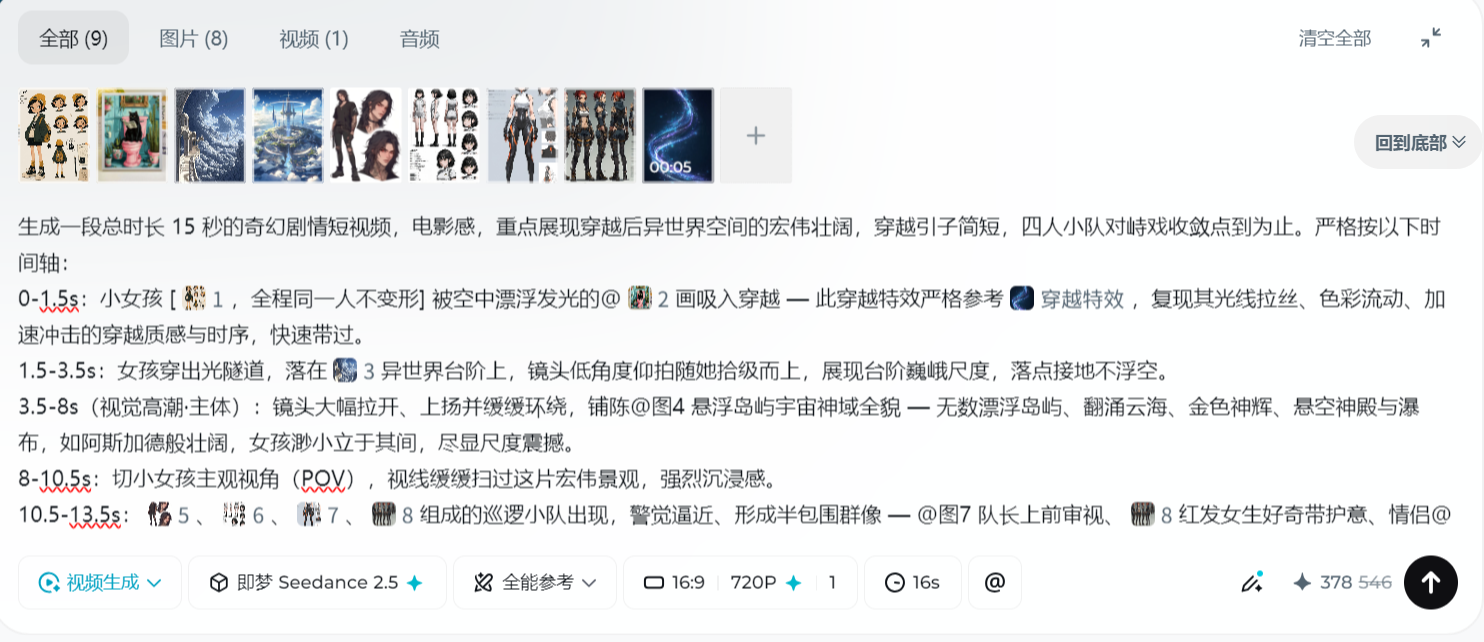
效果评价:这支 15 秒奇幻短片几乎是「全模态素材」能力的样板——输入侧同时喂入视频模板(穿越特效严格对齐@视频1 的光线拉丝、色彩流动、加速冲击时序)、8 张参考图(小女孩@图1 全程不变形、发光画@图2、异世界台阶@图3、神域全貌@图4、巡逻小队@图5-图8 四人各不串脸),以及精确到秒的文本分镜指令(0-1.5s / 1.5-3.5s……严格 15 秒)。工具在同一工作流里把“特效质感、人物一致性、场景尺度、分镜节奏”四件事自动对齐,不再需要“先拍穿越特效、再逐张做角色绑定、再单独搭神域场景”的分段外包。视觉高潮的悬浮神域尺度震撼、群戏收敛不逐人特写,一次对齐即出片,团队几分钟就能确认运镜与表演调度——这种“多源素材一站式生成”的能力,省下的不只是渲染成本,更是跨工种协调的试错成本。
写在最后
支持最多全模态素材的AI视频生成工具怎么选,核心看一件事:你做创作的时候,是让AI猜你的意图,还是把意图用素材锁死。
当你手里有完整的角色设定图、场景概念图、运镜参考视频、配音和环境音录音,Seedance 2.5的50个素材位让这些全部都能派上用场——不用取舍、不用分批、不用妥协。多一个参考素材就少一层不确定性,少一层不确定性就多一分"出来就是我想要的"的概率。
打开即梦(jimeng.jianying.com),试试把你手头的素材包整个传上去,看看AI一次性能把你的创作意图还原到什么程度。
 浙公网安备 33010602011771号