
JeecgBoot AI专题研究 | 从规划、画面、动作、声音到逐帧渲染,看懂大模型“写”出视频的底层原理
一个容易被误读的现象
2026 年 9 月 22 日 Claude Opus 5.5 发布后,社交平台上很快出现了大量“一句话出片”的作品:十几秒的动效作品集、带旁白的科普短片、配着钢琴曲的动态设计,甚至还有一支两分半钟的完整 MV。
于是不少人得出了两个结论:要么是 Claude 偷偷上线了视频模型,要么是 AI 随手写几行代码视频就“自己长出来了”。这两种理解其实都偏了。
先把事实摆清楚:Opus 5.5 的输入可以是文字、图片和文件,但它看不了视频,输出也只有文字。Anthropic 的官方发布文章同样没有提到任何视频能力,重点放在写代码、操作电脑和知识工作上。
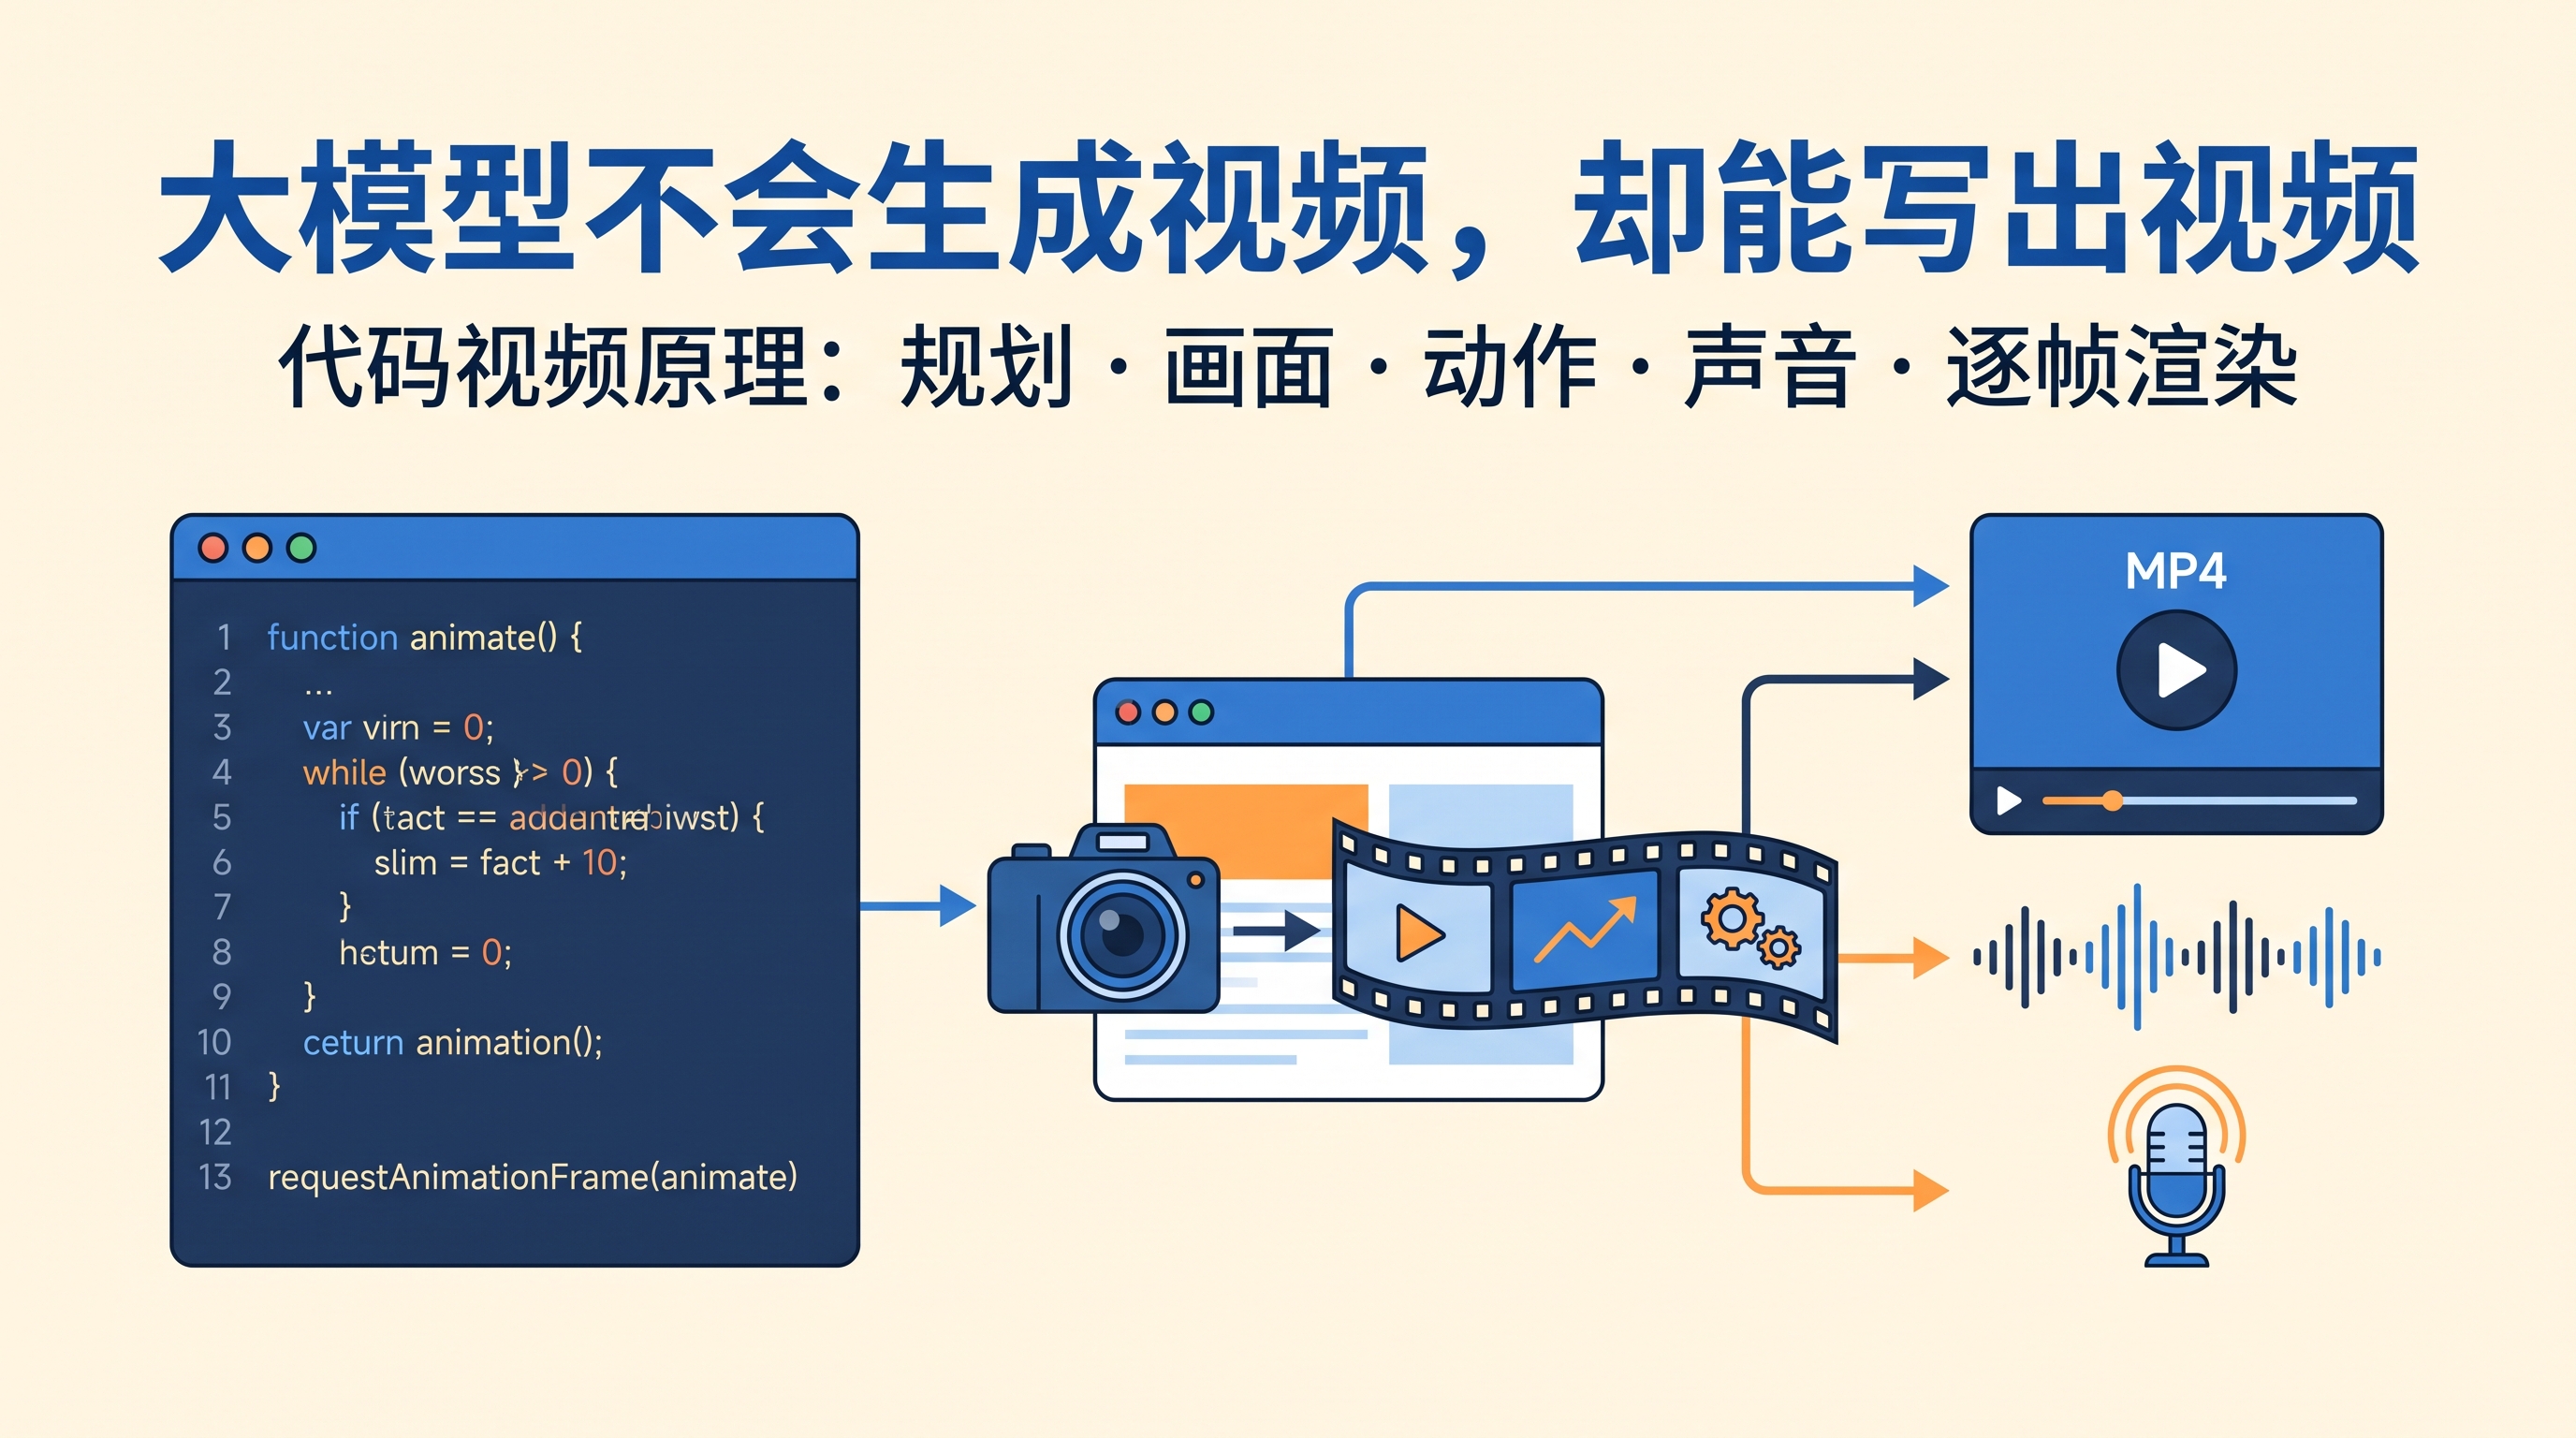
那这些视频是怎么来的?答案是——程序画出来的。模型写出一段描述“每一帧长什么样”的程序,浏览器或渲染软件按照程序把几千帧逐一画好,最后拼接成 MP4。换句话说,在这类作品里,Opus 5.5 同时扮演了导演和程序员两个角色,而真正“出图”的是浏览器和渲染工具。
理解了这一点,你就能明白:这件事的天花板不在于模型会不会“画”,而在于它能不能把一个创意拆解成可执行的工程。
从一条真实的提示词说起
先看一个用来制作教学视频的提示词样例,它很能说明代码视频的思路:
帮我做一个教学视频,素材(Markdown 文件)和 Gemini API Key(.env 文件)见附件。使用 JS + Canvas 绘制,手绘卡通风格,有动效,配音使用 Gemini 3.8 Flash TTS。要通俗易懂,开头要吸引人,看完有收获。
拆开看,这短短几句话把五件事都交代到了:
- 素材:内容来源是 Markdown 文件
- 绘制方式:JS + Canvas,即“画面由程序绘制”的代码视频路线
- 视觉风格:手绘卡通,有动效
- 配音工具:交给 TTS 语音服务
- 验收标准:开头抓人、讲得明白、看完有收获
在实际使用中我们发现,提示词里技术路线和验收标准写得越具体,成片越稳定;只说“做个酷炫视频”,模型往往会回落到它最熟悉的默认风格。
底层原理:视频就是“第 N 帧长什么样”
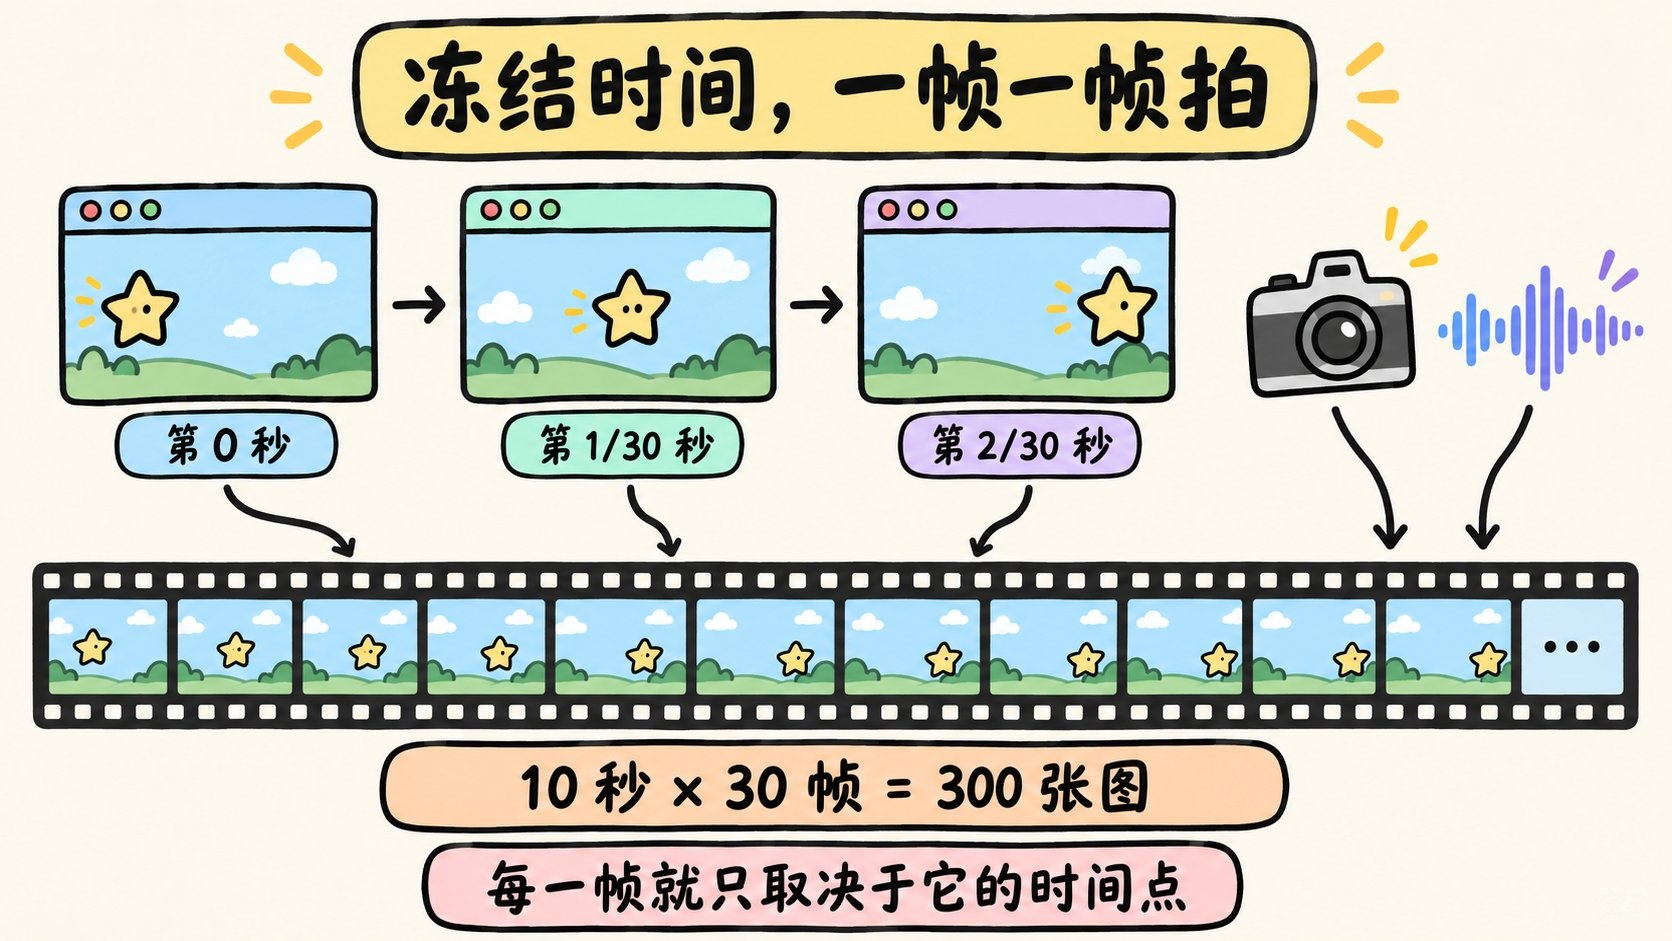
视频本质上是一串连续播放的静态图片。常见帧率是每秒 30 帧,一段 10 秒的视频就是 300 张图,播放够快,人眼就会把它们看成连贯的运动。
所以,做视频这件事可以被归约成一个问题:给定任意时间点,画面应该长什么样? Opus 5.5 的工作,就是写出一个能回答这个问题的程序——你随便问它“第 2.5 秒是什么画面”,程序都能立即画出那一刻的完整帧。
整条流水线可以拆成五个环节:规划、画面、动作、声音、拍摄与合成。
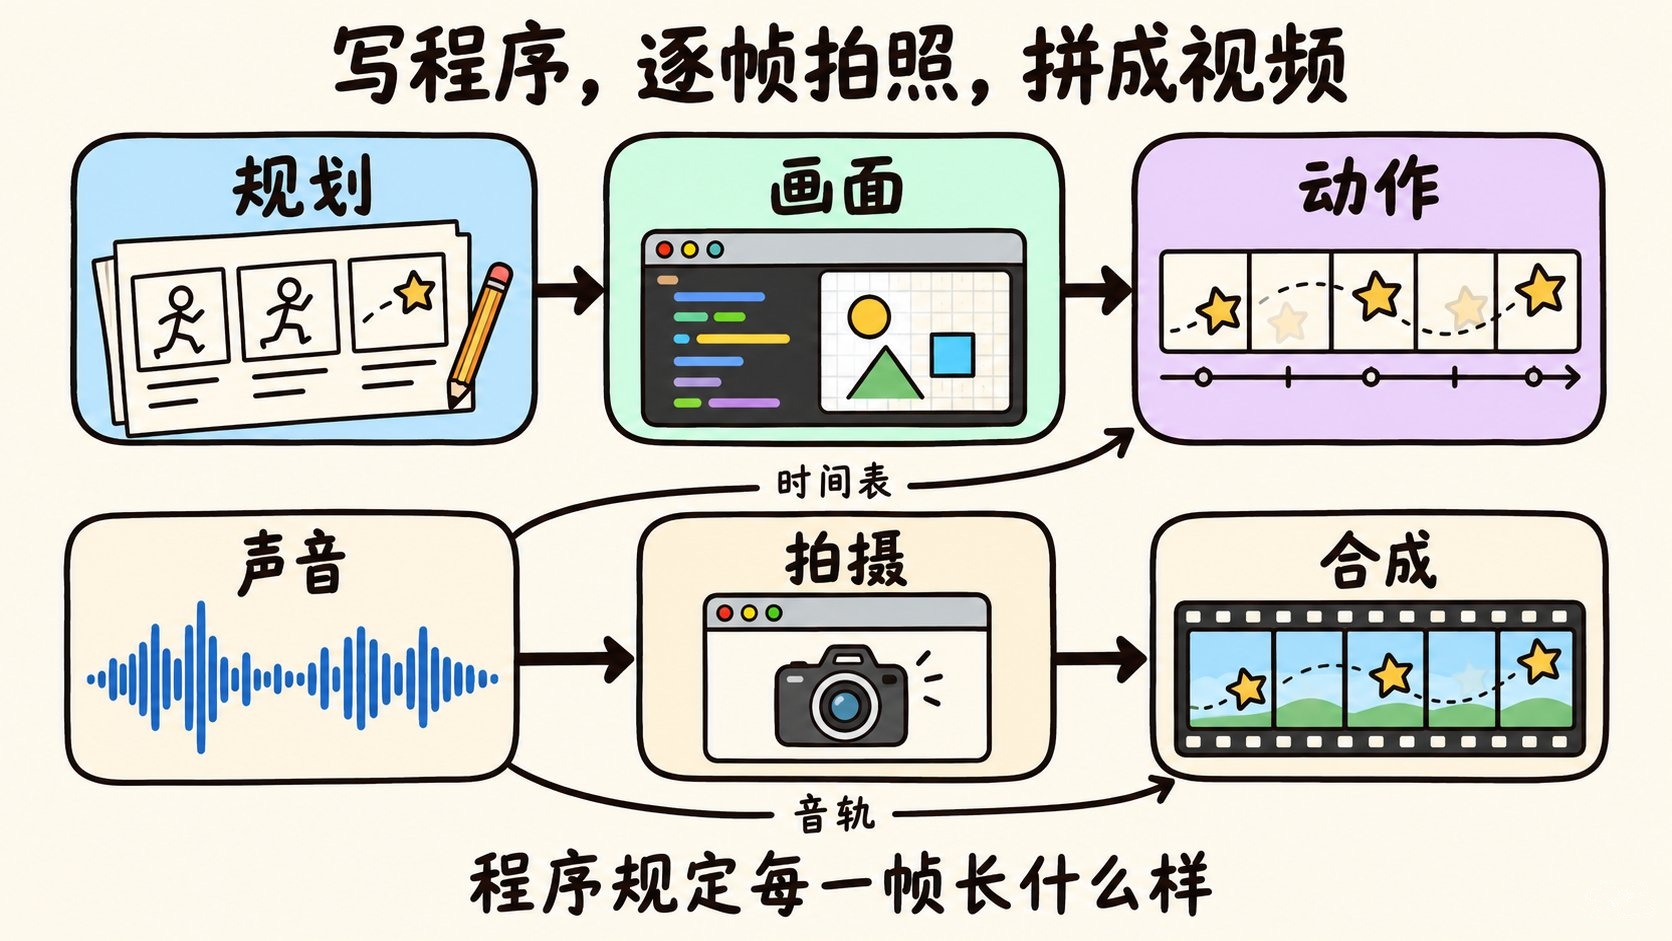
其中“规划、画面、动作”三步是模型写出来的代码,其余环节依赖外部工具。配音在这里有两个去向:一方面为动作提供时间表,另一方面作为音轨交给 FFmpeg 合成。下面逐一展开。
第一步:规划——先有脚本和分镜,再动手
接到“帮我做个视频”的需求后,模型并不会立刻写渲染代码,而是先写脚本,再把脚本拆成一个个镜头(分镜)。每个镜头都要回答三个问题:画什么、持续多久、配什么话。
一个公开了全部源码的例子是 MV《I'm Upping My P(doom)》,项目名 PDoomVideo,时长 156.6 秒,源码托管在 GitHub 上。据项目说明,作者只指定了一个角色形象,并要求每句歌词都配上有趣的画面和转场,没有给任何具体场景,其余全部由模型完成。
模型在第一轮产出后,自己写了一份分镜规范 STORYBOARD.md,约束了整片的一致性:
- 角色设计固定,全片不变
- 配色从暖奶油色过渡到太空紫,再到警报红,最后回归
- 每个镜头里都必须有东西在动,画面不放文字
- 角色表情渐变,不允许突然跳变
- 每次切镜都由动作带出,比如一口咬下去黑屏、一次坠落、镜头穿过一只眼睛
随后,模型按章节分工,并行派出多个子智能体(subagent),每个子智能体负责时间轴上的一段,各写一个 JavaScript 文件。
值得注意的是,这支视频前后其实生成了两轮。所谓“一句话一次成型”,指的是用户侧只发了一句话,规划、分工、返工都是模型在内部完成的。这恰恰是 Opus 5.5 的强项:在长时间、多文件的任务里保持方向不跑偏——官方发布文章中提到,有测试者让它无人值守连续工作了 18 个多小时。
第二步:画面——一切形状都由代码描述
代码视频不需要现成的图片素材,画面里的形状、颜色、角色都由代码描述出来。
最常见的载体是网页:文字和色块用 HTML、CSS 排版,图标和角色用 SVG 绘制。SVG 用坐标和数学公式描述图形,放大不会模糊,非常适合程序生成。比如下面这段 SVG 画了一个青色圆形、一颗金色五角星和一个方块身体:
<svg width="400" height="200">
 <circle cx="60" cy="100" r="40" fill="teal" />
 <polygon points="200,60 212,95 250,95 219,117 231,152 200,130 169,152 181,117 150,95 188,95" fill="gold" />
 <rect x="300" y="80" width="60" height="50" rx="6" fill="#d97757" />
</svg>
不同风格对应不同的工具选择:
- 3D 场景:常用网页 3D 库 three.js,整个场景往往就是一个 HTML 文件
- 手绘质感:前面那支 MV 用的是 p5.js(面向艺术创作的绘图库)加一个水彩笔刷库
- 数学/编程讲解:Manim,一个专做数学动画的 Python 库,不经过网页
- 三维建模:有开发者把 Blender 当成 Python 库使用,让模型直接写脚本建模、贴图
- 照片级素材:先用图像模型生成图片,再放进网页里作为元素使用
选型上的经验是:信息密度高、文字多的内容优先选 HTML/SVG,因为排版可控、字体清晰;追求质感和氛围时再考虑 Canvas、WebGL 或 three.js。
第三步:动作——把每个动作钉在时间轴上
画面之所以会动,是因为代码里有一张时间表:第几秒、哪个元素、怎么动。主流写法有两种。
第一种是 GSAP,一个老牌网页动画库。下面两行的意思是“第 2 秒星星从无到有弹出,第 3 秒角色向右移动 400 像素”:
tl.from(star, { scale: 0 }, 2)
tl.to(character, { x: 400 }, 3)
GSAP 时间轴的关键能力是可以暂停,也可以直接跳到任意时间点——后面“逐帧拍照”环节正是依赖这一点。开源工具 HyperFrames 默认使用的就是 GSAP。
第二种是 Remotion 的写法。Remotion 是一个用 React 写视频的框架,每一帧都是“帧号的函数”:代码拿到当前帧号,计算出这一帧里每个元素的位置、透明度和颜色。
两种写法殊途同归:给定一个时间点,画面就被唯一确定。这个性质直接决定了后续能否稳定、可重复地出片。
第四步:声音——配音就是全片的时钟
带旁白的视频,通常是先做配音,再让画面去对齐配音。
流程大致是:模型写好旁白稿,交给文字转语音服务(常见如 ElevenLabs)朗读。关键在于拿到每个字说出口的精确时刻——ElevenLabs 提供带时间戳的接口,返回音频的同时给出每个字符的起止时间;如果手里是现成录音,则可以用 Whisper 等语音识别工具反推每个词的时间。
有了这份时间表,画面就能“卡着话走”:旁白说到“星星”的那一刻,星星恰好弹出。整条配音成为全片的时钟,所有动作都以它为基准排布。
音效和音乐也挂在同一个时钟上:元素弹出配一声“啵”,转场配一声“嗖”,背景音乐垫底,有人说话时自动压低音量。声音来源大致有三类:
- 音效库中的现成素材
- AI 音效/音乐模型:例如让模型按品牌规范写提示词,交给 Suno 生成一段 150 BPM 的配乐和 10 个音效
- 纯代码合成:有人让模型做 90 秒的动态设计演示,连钢琴配乐都是模型自己写代码合成的
MV 则恰好反过来:歌曲本身就是时钟,画面跟着歌词和节拍走,不需要 TTS。
第五步:拍摄与合成——冻结时间,一帧一帧地拍
写好的网页还不是视频。要变成 MP4,需要一台“摄像机”把它逐帧拍下来,再与声音合成。
这台摄像机就是无头浏览器(headless browser,没有界面、在后台运行的浏览器),通常是 Chrome,由 Puppeteer 这类自动化工具驱动。
关键在于:它从不按播放键。以 HeyGen 开源的 HyperFrames 为例,渲染器先把画面跳到第 0 秒截一张图,再跳到第 1/30 秒截第二张……一段 10 秒、30 帧的视频就这样截 300 张。帧率可以自定义,前面那支 MV 用的是每秒 24 帧,156.6 秒共约 3760 帧。
为什么不能直接录屏?
浏览器为了流畅,大量工作是异步进行的:字体慢慢加载、图片慢慢解码、动画跟随屏幕刷新率走。机器一卡就会掉帧,同一份代码在两台电脑上录出来的结果也可能不同。
HeyGen 的工程团队记录过这类问题:截图太快,会截到字体还没显示、SVG 还没上色的画面。他们的解法是在 Linux 上使用特制版 Chrome,让排版、绘制、截图在一次调用中全部完成,截完这一帧才进入下一帧。
如果画面中嵌入了视频素材,也不交给浏览器播放,而是渲染前先用 FFmpeg 把素材拆成图片序列,拍到哪一帧就换上对应的那一张。
代码必须遵守的三条禁令
为了保证每次渲染结果一致,代码需要守住三条规矩:
- 不读取当前系统时间
- 不使用没有固定种子的随机数
- 渲染过程中不联网
守住这三条,每一帧就只取决于它的时间点,同一份代码每次都会渲染出完全相同的视频。由此还带来一个工程红利:几千帧可以分发给多个浏览器进程并行渲染,最后再按顺序拼接,大幅缩短出片时间。
最后的合成
收尾交给开源音视频工具 FFmpeg:把几千张截图按顺序编码成视频流,再混入配音、音效和音乐,输出最终的 MP4 文件。
不必自己造轮子:HyperFrames 与 Remotion
第五步的“摄像机”不需要从零实现,目前有两个主流开源工具,都可以配合 Claude Code 使用。
HyperFrames 由数字人视频公司 HeyGen 开源:视频就写成普通 HTML,动画默认用 GSAP,渲染依靠 Puppeteer + FFmpeg。它为 Claude Code、Cursor、Codex 等编程智能体提供了技能包(skill),把流程固化为:规划 → 写 HTML → 接入可跳转的动画 → 加素材 → 代码检查 → 预览 → 渲染。
npx skills add heygen-com/hyperframes   # 给智能体装上技能包
npx hyperframes render                   # 渲染出 MP4
Remotion 出现得更早,用 React 组件写视频,同样提供官方技能包,在项目目录中运行 npx remotion skills add 即可安装。
两者如何取舍?HeyGen 分享过一个经验:他们早期尝试过 Remotion,发现框架约束加得越多,智能体的产出越保守、越雷同,换回纯 HTML 后创意才回来。这是一家之言,但很有参考价值。我们的建议是:
- 追求创意多样性、团队前端基础弱:优先 HyperFrames,门槛低,模型写 HTML/CSS 最熟练
- 追求帧级精确控制、已有 React 技术栈:选择 Remotion,组件化便于复用和维护
- 数学公式、算法讲解:直接考虑 Manim
模型如何检查自己的作品
既然 Opus 5.5 看不了视频,它怎么做质检?答案是看截图:渲染出若干张静态关键帧,逐张检查排版、重叠、可读性,发现问题就回去改代码,再重新渲染。
这也提示我们一个实用技巧:在提示词里明确要求“每完成一个镜头先渲染 3~4 张静帧自检”,能显著减少返工。
在 claude.ai 中,Claude Design 同样可以制作动画,产出的也是在浏览器中运行的网页代码;如果要拿到 MP4 文件,目前多借助第三方工具逐帧渲染。
代码视频 vs 视频生成模型:互补而非替代
Seedance(字节)、可灵 Kling(快手)这类视频模型直接生成像素,而 Opus 5.5 生成的是代码。两条路线的能力边界几乎完全互补:
| 对比维度 | 代码视频(模型写程序) | 视频模型(Seedance、可灵等) |
|---|---|---|
| 画面怎么来 | 程序计算每一帧 | 模型直接生成像素 |
| 画面里的文字 | 每个字都准确 | 容易错字、乱码 |
| 修改一处细节 | 改一行代码,别处不动 | 通常要整段重新生成 |
| 与旁白对齐 | 精确到帧 | 很难精确控制 |
| 写实画面、人脸、动物 | 弱,近看是粗糙几何形状 | 强 |
| 同样输入重复渲染 | 结果完全一致 | 每次都不同 |
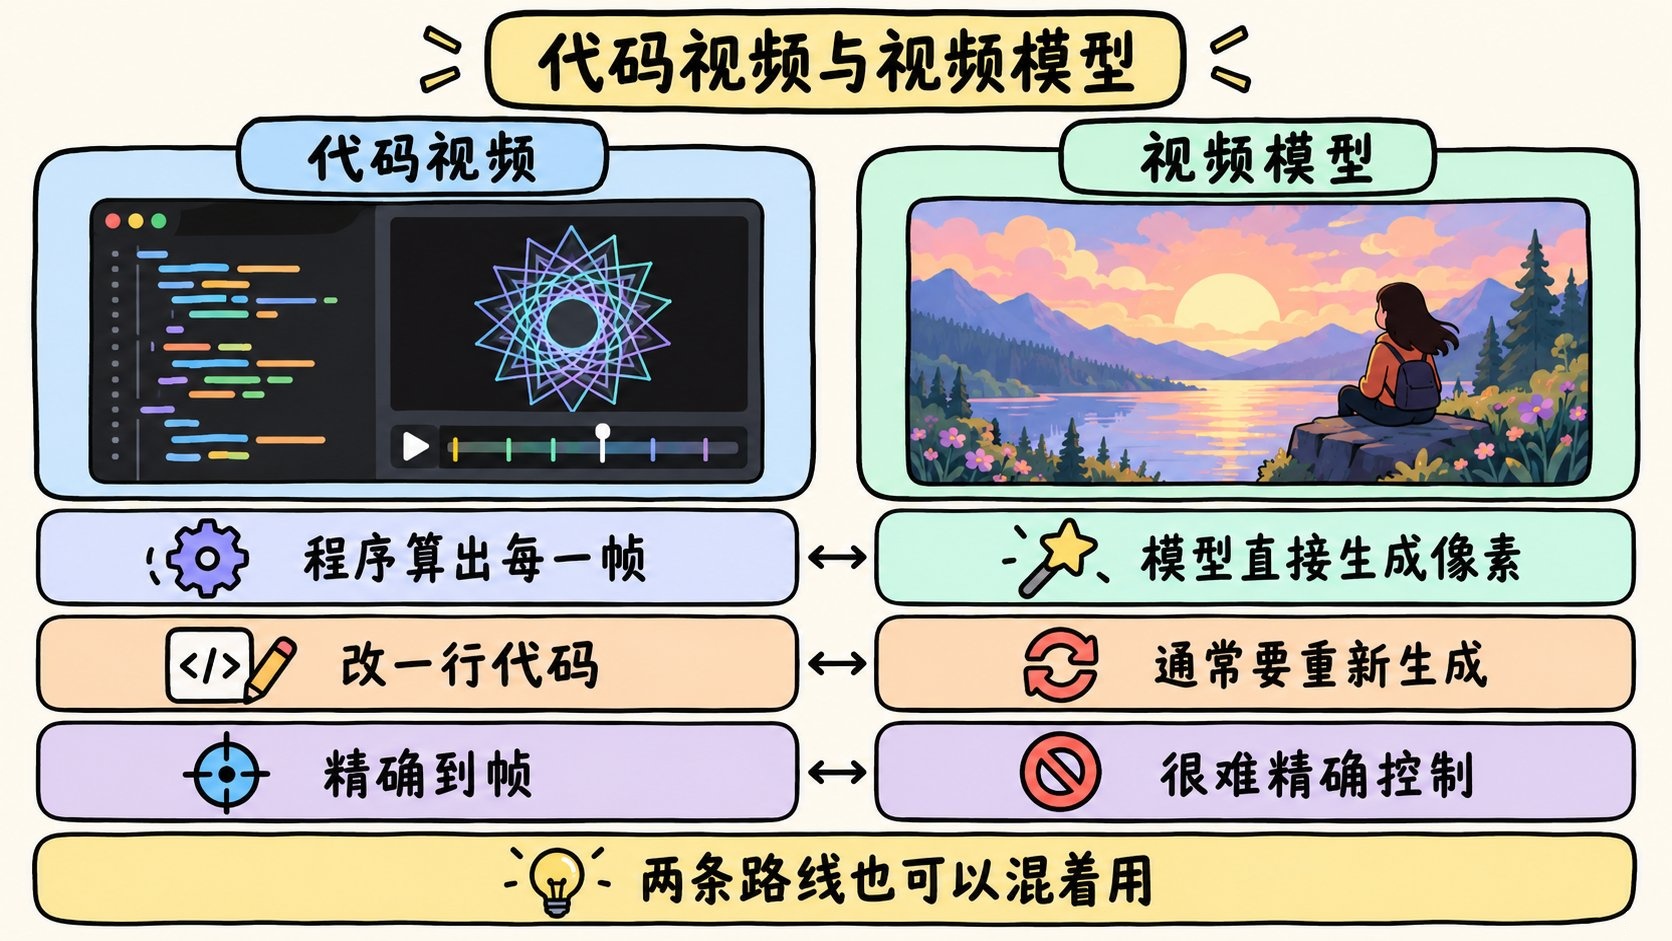
两条路线也完全可以混用。Claude 可以充当编排器(orchestrator),通过 MCP(Model Context Protocol,让 AI 调用外部工具的标准协议)调用视频模型,拿回生成好的片段,再剪进自己的时间轴。已经有人用几张自拍加一段语音备忘录,通过 MCP 连接的工具做出数字人口播视频;也有人先用代码渲染出镜头,再交给 Runway 的 Aleph 模型转成写实风格。
对于企业场景来说,这种“代码打底 + 模型补短板”的组合尤其有价值:产品演示、数据可视化、功能讲解这类强调准确性的内容交给代码;需要真人、实景氛围的镜头再交给视频模型。
局限与成本:上手前需要知道的事
代码视频擅长动效、图表和讲解类内容,但在写实画面和大制作上仍有明显短板:
- 活物画不好:动物和人脸近看只是粗糙的几何形状,这类镜头还得靠视频模型或实拍
- 容易过曝:太空等场景常常亮得发白,需要在提示词里专门要求真实色彩
- 额度消耗大:有创作者制作一支 3 分钟带旁白的短片,用掉了每周 Claude 额度的约 7%;部分单条提示词的 3D 项目写到一半就撞上了单次输出长度上限。按 API 计费,Opus 5.5 为每百万输入 Token 4 美元、每百万输出 Token 20 美元
- 审美仍需人把关:开发者 Wes Bos 的评价很中肯——这些动效本身未必出色,出色的是它“能做出来”;决定展示什么、把风格做到位依然是难点,提供素材库和风格指引会好很多
- 有环境门槛:需要能执行代码的环境(一般是 Claude Code),并装好 Node.js、Chrome 和 FFmpeg
补充两条实践中的避坑经验:
- 长片务必分段渲染。先按镜头渲染、确认,再整片合成,避免一次性长任务中途失败导致全部重来。
- 把视频规范写进项目文件。将帧率、配色、字体、禁用风格等规则沉淀成项目级说明文件,可以让每一次生成都自动遵守,减少提示词重复。
总结
Opus 5.5 做视频的分工其实很清晰:模型负责规划、写代码、调度其他工具,浏览器和 FFmpeg 负责把代码变成画面和文件。
它在视频上的表现,本质上来自两项最强能力的叠加——长时间规划和高质量写代码。因此这类视频的优势是文字准、时间准、改得动;当需要写实画面时,再把视频生成模型接进来补位。
对开发者而言,这意味着视频正在变成一种“可编程资产”:可以版本管理、可以参数化复用、可以批量生成。这条路线未来的想象空间,或许比“一句话出片”本身更值得关注。
参考资料
- Introducing Claude Opus 5.5:Anthropic 官方发布文章
- HTML to Video Was Not Easy: Here's How We Solved It:HeyGen 讲解 HyperFrames 渲染原理的工程文章
- Claude Opus 5.5 One-Shot a Music Video:OrcaRouter 对 PDoomVideo 项目的拆解
- Claude Opus 5.5 for video:daily.dev 相关文章摘要
- Claude Opus 5.5 generates motion design and visual scenes entirely in code:daily.dev 整理的社区案例
- Create speech with timestamps:ElevenLabs 带时间戳的语音合成接口文档
本文为 JeecgBoot AI 专题研究系列文章。

 浙公网安备 33010602011771号