
在Zephyr中保存并离线分析Coredump崩溃现场
设备在客户现场崩溃,串口日志早就丢了,这是嵌入式开发最头疼的场景之一。Zephyr 自带的 Coredump 子系统可以在崩溃瞬间把寄存器和栈内容保存下来,如果再把 dump 写进 Flash 分区,设备重启后就能把完整的崩溃现场读出来,离线还原出寄存器值和带行号的完整调用栈。
本文基于 NCS v3.4.0、nRF54L15 DK 实测,介绍一套完整的 Coredump 落地方案:
- 通过 Kconfig 开启 Coredump 子系统并选择 Flash 分区后端;
- 通过 Devicetree 在 RRAM 尾部划出一块 dump 存储区(NCS v3.4.0 起 Partition Manager 已弃用,分区改由 Devicetree 管理);
- 用多层嵌套函数触发 BusFault,验证调用栈回溯效果;
- 用 nrfutil 直接从 Flash 读出 dump,配合 GDB 离线还原崩溃现场。
1. Coredump 工作原理
Zephyr 的 Coredump 子系统(CONFIG_DEBUG_COREDUMP)在 CPU 进入 fatal error 处理流程时,会把当前线程的寄存器上下文和指定的内存区域打包成一段二进制数据,交给后端(backend)处理。
Zephyr 提供多种后端,常用的有两个:
| 后端 | 配置项 | 行为 |
|---|---|---|
| Logging | CONFIG_DEBUG_COREDUMP_BACKEND_LOGGING |
崩溃时直接通过日志把 dump 打印出来 |
| Flash 分区 | CONFIG_DEBUG_COREDUMP_BACKEND_FLASH_PARTITION |
崩溃时把 dump 写入指定 Flash 分区,重启后再读取 |
如果这两个后端都不满足需求(比如想写到外部 Flash、文件系统,或崩溃时直接通过某种接口上报),可以自定义后端:选择
CONFIG_DEBUG_COREDUMP_BACKEND_OTHER=y,然后在应用代码里定义一个名为coredump_backend_other的struct coredump_backend_api全局变量,实现 5 个回调即可:
start()/end():dump 开始和结束时各调用一次,用于初始化和收尾(如擦除、flush);buffer_output(buf, len):核心回调,coredump 子系统把 dump 数据流式推给它,想存哪存哪;query()/cmd():对应应用侧的coredump_query()/coredump_cmd()接口,用于重启后查询和读出 dump。接口定义见
${ZEPHYR_BASE}/include/zephyr/debug/coredump.h,最直观的参考就是 Flash 分区后端的源码:${ZEPHYR_BASE}/subsys/debug/coredump/coredump_backend_flash_partition.c。
Logging 后端的问题是:设备死在现场时,串口不一定有人接着。Flash 分区后端把现场固化在非易失存储里,重启后应用可以自己读出并通过任何通道(串口、BLE、LTE)上报,也可以事后用调试器直接读 Flash,适合现场设备。
整个流程如下:
- 崩溃发生,fatal error handler 调用 coredump 子系统;
- 后端先整区擦除目标分区,再写入 16 字节 header + dump 数据;
- 系统复位(由 NCS 的 fatal_error 库触发);
- 重启后应用查询分区,发现有有效 dump,读出并处理。
dump 数据本身的格式由 CONFIG_DEBUG_COREDUMP_MEMORY_DUMP_* 控制,最小模式(MIN)只包含异常线程的栈和寄存器,通常几百字节,对 Flash 占用很小。
2. 开启 Coredump 相关配置
在 prj.conf 中添加:
# flash 驱动
CONFIG_FLASH=y

# coredump 子系统:flash 分区后端 + 最小 dump 范围
CONFIG_DEBUG_COREDUMP=y
CONFIG_DEBUG_COREDUMP_BACKEND_FLASH_PARTITION=y
CONFIG_DEBUG_COREDUMP_MEMORY_DUMP_MIN=y

# NCS fatal_error 库:fatal error 后自动复位
CONFIG_RESET_ON_FATAL_ERROR=y

# 串口打印
# 注意:当前示例是用 PRINTK 打印上次保存的 dump,必须关掉 CONFIG,LOG_PRINTK,
# 否则 printk 会走 LOG 的 deferred 缓冲,大量 dump 打印会撑爆 LOG buffer 被丢弃(messages dropped)
CONFIG_PRINTK=y
CONFIG_LOG=y
CONFIG_LOG_PRINTK=n
说明:
-
CONFIG_FLASH=y:Flash 分区后端依赖 Zephyr 的 flash 驱动 API,nRF54L15 上对应 RRAM 控制器驱动; -
CONFIG_DEBUG_COREDUMP=y:使能 coredump 子系统,fatal error 时自动转储; -
CONFIG_DEBUG_COREDUMP_BACKEND_FLASH_PARTITION=y:选择 Flash 分区作为存储后端,编译期要求 Devicetree 中存在 label 为coredump-partition的节点(下一节配置); -
CONFIG_DEBUG_COREDUMP_MEMORY_DUMP_MIN=y:
只转储异常线程的栈和寄存器。dump 范围是一个三选一的 choice(CONFIG_DEBUG_COREDUMP_MEMORY_DUMP_*),三个选项的功能和资源占用对比如下:选项 dump 内容 dump 体积(≈ Flash 分区需求) ..._MEMORY_DUMP_MIN异常线程的 thread struct + 寄存器 + 栈顶部分(从 SP 到栈底) 最小,本文实测 795 字节,几 KB 分区就够 ..._MEMORY_DUMP_THREADS所有线程的 thread struct + 各自的栈 + 线程调试元数据(自动 select DEBUG_THREAD_INFO)约为全部线程栈使用量之和,几 KB ~ 几十 KB,取决于线程数和栈大小 ..._MEMORY_DUMP_LINKER_RAM(默认值)_image_ram_start到_image_ram_end整段 RAM,即 data/bss/noinit 等全部已用 RAM等于固件 RAM 总用量,几十 KB 起步、可到上百 KB,内部 Flash 通常划不出这么大的分区,更多配合 RAM 后端或调试用途 几点补充:
- dump 是流式输出的,三个选项本身的 RAM 开销都可以忽略。以 Flash 分区后端为例,静态缓冲只有 2 个
CONFIG_DEBUG_COREDUMP_FLASH_CHUNK_SIZE(默认 64 字节)的 buffer 加栈上 1 个,合计约 192 字节;代码本身的 Flash 占用约几 KB。真正决定分区大小的是 dump 数据量。 ..._MEMORY_DUMP_THREADS依赖!SMP且架构支持ARCH_SUPPORTS_COREDUMP_THREADS(ARM Cortex-M 支持)。- 还有两个影响 dump 体积的相关选项:
CONFIG_DEBUG_COREDUMP_THREAD_STACK_TOP(MIN/THREADS 下默认 y,只 dump 栈顶而非整个栈区域,可用CONFIG_DEBUG_COREDUMP_THREAD_STACK_TOP_LIMIT限制字节数);CONFIG_DEBUG_COREDUMP_DUMP_THREAD_PRIV_STACK(开 USERSPACE 时默认 y,额外 dump 用户线程的特权栈,不需要可以关掉省空间)。
- dump 是流式输出的,三个选项本身的 RAM 开销都可以忽略。以 Flash 分区后端为例,静态缓冲只有 2 个
-
CONFIG_RESET_ON_FATAL_ERROR=y:NCS 的 fatal_error 库,在 fatal error 处理(含 coredump 写入)完成后自动复位系统。不开这个配置,系统会停在死循环里,dump 虽然写了但设备不会自己恢复。
3. 划分 Coredump 分区
3.1 板级默认分区布局
nRF54L15 DK(cpuapp)的默认分区由 SDK 自带文件 ${NCS}/zephyr/dts/vendor/nordic/nrf54l15_cpuapp_partition.dtsi 定义:
| 分区 | 地址 | 大小 | 用途 |
|---|---|---|---|
boot_partition |
0x0 |
62KB | MCUboot |
slot0_partition |
0x10000 |
712KB | 应用主槽位 |
slot1_partition |
0xc2000 |
712KB | OTA 备用槽位 |
storage_partition |
0x174000 |
36KB | 存储(NVS/LittleFS/Settings 等) |
注意
boot_partition是 62KB 而不是 64KB,这是 nRF54L15/L10/L05 特有的硬件限制:这三款芯片的 RRAMC regionSIZE字段只有 5 bit(单位 1KB),单个 region 最多锁 31KB;2 个region 写保护的上限就是 62KB。副作用是boot_partition与slot0_partition之间会留下 2KB 的分区缝隙,这 2KB 无法利用,属于正常现象。分区若给到 64KB,
fprotect_area()会因超出上限而失败,导致 MCUboot 区域无法使用写保护功能。nRF54LM20/LV10(7 bit)和 nRF54LS05(10 bit)的
SIZE字段更宽,没有这个限制。其他系列则是另一套机制,都不存在这个上限:nRF52 用 BPROT 外设,按 Flash 页(4KB)逐页保护,block 数量覆盖整片 Flash;nRF53 和 nRF91 用 SPU,region 粒度分别为 16KB 和 32KB,region 数量同样覆盖整片 Flash。这些系列只需保证分区按各自粒度对齐即可,MCUboot 分区大小不受保护机制约束(例如 nRF52840 上典型的 MCUboot 分区是 48KB)。
3.2 增加 coredump 分区
| 分区 | 地址 | 大小 | 用途 |
|---|---|---|---|
boot_partition |
0x0 |
62KB | MCUboot |
slot0_partition |
0x10000 |
712KB | 应用主槽位 |
slot1_partition |
0xc2000 |
712KB | OTA 备用槽位 |
storage_partition |
0x174000 |
20KB | 存储(NVS/LittleFS/Settings 等) |
coredump_partition |
0x178000 |
16KB | Coredump 存储分区 |
Coredump 的 flash backend 只能存放在内部 Flash。这里为了示例,把 storage partition 压缩了一下,在尾部留出 16KB 用来存储崩溃时的寄存器和单一线程栈(崩溃线程栈)。如果你想保存所有线程的栈,记得分区要大一些。
如果你想保存到外部 Flash 或文件系统,可以考虑开发自定义 backend。
在 NCS v3.4.0 之后(对应 Zephyr 4.4),不再使用 Partition Manager 进行分区,而是使用 Zephyr 标准的设备树进行分区。
给出一个参考文件memory_map.dtsi,内容就是一段完整的 partitions 定义。考虑到大多数产品都是有 MCUboot 的,示例也有mcuboot。
/*
 * nRF54L15 DK (cpuapp) Flash 分区布局,Application 与 MCUboot 共用。
 */
partitions {
	#address-cells = <1>;
	#size-cells = <1>;

	boot_partition: partition@0 {
		compatible = "zephyr,mapped-partition";
		label = "mcuboot";
		/* 62KB:保证 FPROTECT 可默认开启 */
		reg = <0x0 DT_SIZE_K(62)>;
	};

	slot0_partition: partition@10000 {
		compatible = "zephyr,mapped-partition";
		label = "image-0";
		reg = <0x10000 DT_SIZE_K(712)>;
	};

	slot1_partition: partition@c2000 {
		compatible = "zephyr,mapped-partition";
		label = "image-1";
		reg = <0xc2000 DT_SIZE_K(712)>;
	};

	storage_partition: partition@174000 {
		compatible = "zephyr,mapped-partition";
		label = "storage";
		reg = <0x174000 DT_SIZE_K(20)>;
	};

	coredump_partition: partition@178000 {
		compatible = "zephyr,mapped-partition";
		label = "coredump-partition";
		reg = <0x178000 DT_SIZE_K(16)>;
	};
};
关键点:
- coredump 节点的 label 必须是
coredump-partition,这是后端源码里写死的名字(${NCS}/zephyr/subsys/debug/coredump/coredump_backend_flash_partition.c) - coredump 分区必须在内部 flash
- 地址要按擦除块对齐。nRF54L15 的 RRAM 擦除块 4KB、写块 16 字节,
0x178000满足对齐;最小模式 dump 只有几百字节,16KB 很宽裕; - 如果是不用 MCUboot 的单镜像工程,
boot_partition/slot1_partition可以直接删掉,只保留slot0_partition、storage_partition和coredump_partition。
如果你想深入了解 Zephyr 的设备树分区写法,包括外部 Flash 如何分区,请参考:Zephyr中的分区和存储系统 - Jayant's Blog
3.3 将分区配置添加到设备树
前面给出的分区配置,直接添加到设备树 overlay 就可以。
不过,一般工程上都是有 bootloader 的。在 sysbuild 多镜像工程中,每个镜像有自己独立的 dts,分区必须要在两个镜像的设备树中保持一致。
因此在工程上,为了保持一致性,最好只写一份分区文件(上一节的memory_map.dtsi)。同一份 dtsi 要分别在两个镜像的 overlay 里 include。Devicetree 的 #include 是文本级展开,可以直接把 dtsi 包含进 &cpuapp_rram 节点内部。
完整的工程文件结构如下:
<工程根>/
├── prj.conf
├── sysbuild.conf
├── sysbuild/
│   └── mcuboot.overlay                       # MCUboot 镜像 overlay
├── boards/
│   ├── memory_map.dtsi                       # 共享分区布局
│   └── nrf54l15dk_nrf54l15_cpuapp.overlay    # 应用 overlay
└── src/
    └── main.c
Application 镜像的设备树: boards/nrf54l15dk_nrf54l15_cpuapp.overlay
/* 应用镜像:在 cpuapp_rram 节点内引入共享分区布局 */
&cpuapp_rram {
	#include "memory_map.dtsi"
};
MCUboot 镜像的设备树: sysbuild/mcuboot.overlay
/* MCUboot 镜像:引入同一份共享分区布局,保证与应用看到的槽位地址一致 */
&cpuapp_rram {
	#include "../boards/memory_map.dtsi"
};

/ {
	chosen {
		zephyr,code-partition = &boot_partition;
	};
};
MCUboot 镜像的 chosen 节点把 zephyr,code-partition 指向 boot_partition,即 MCUboot 自身链接到 RRAM 起始位置。
mcuboot 的配置也可以写到
sysbuild/mcuboot/boards/<board_name>.overlay。相关规则,可以参考:理解Zephyr项目的配置与构建系统 - Jayant's Blog
3.4 sysbuild 配置
sysbuild.conf 只需要一行:
SB_CONFIG_BOOTLOADER_MCUBOOT=y
coredump 本身不依赖 MCUboot。本文启用 MCUboot 只是为了演示多镜像工程下如何保证分区一致。如果你的工程没有 bootloader,删掉 sysbuild.conf 和 sysbuild/mcuboot.overlay,只保留应用 overlay 即可。
3.5 Partition Manager 已弃用
背景:NCS 早期版本用自家的 Partition Manager(PM)在构建期生成 Flash 分区表,从 NCS v3.3 起 PM 被标记为 deprecated,v3.4.0 起默认关闭,分区全面切换到 Zephyr 原生的 Devicetree fixed-partitions 方式,官方计划在 2026 年底前把 PM 从代码库中移除。
对应用开发者的直接影响:
- 不再需要
pm_static.yml,也不要在sysbuild.conf里开SB_CONFIG_PARTITION_MANAGER; - 分区直接写在 Devicetree 里,板级默认布局由 SDK 自带的 dtsi 提供,应用用 overlay 增量修改;
- 使用 sysbuild 多镜像时,每个镜像(app、MCUboot)有自己独立的 Devicetree,只有用到某个分区的镜像才需要在自己的 Devicetree 里看到它。
- 如果产品已经在用 MCUboot DFU 出货,从 PM 迁移到 DTS 时新 overlay 里的分区地址和大小必须与旧
pm_static.yml完全一致,否则新老固件之间 DFU 会断。NCS 自带转换脚本${NCS}/nrf/scripts/pm_to_dts.py,可以根据现有 PM 配置生成初始 overlay。
[点击展开] NCS v3.3 及更早版本:Partition Manager 方式
v3.3 及更早版本默认使用 Partition Manager,分区地址由 PM 在构建期生成,Devicetree 只负责声明 coredump-partition 节点供后端推导写块大小。需要三个文件配合:
sysbuild.conf:
SB_CONFIG_BOOTLOADER_MCUBOOT=y
SB_CONFIG_PARTITION_MANAGER=y
pm_static.yml(静态分区表,把 coredump_partition 钉在固定地址):
mcuboot:
  address: 0x0
  region: flash_primary
  size: 0xC000
mcuboot_pad:
  address: 0xC000
  region: flash_primary
  size: 0x800
app:
  address: 0xC800
  region: flash_primary
  size: 0xA5800
mcuboot_primary:
  address: 0xC000
  region: flash_primary
  size: 0xA6000
  span: [app, mcuboot_pad]
mcuboot_primary_app:
  address: 0xC800
  region: flash_primary
  size: 0xA5800
  span: [app]
mcuboot_secondary_pad:
  address: 0xB2000
  region: flash_primary
  size: 0x800
mcuboot_secondary_app:
  address: 0xB2800
  region: flash_primary
  size: 0xA5800
mcuboot_secondary:
  address: 0xB2000
  region: flash_primary
  size: 0xA6000
  span: [mcuboot_secondary_pad, mcuboot_secondary_app]
settings_storage:
  address: 0x158000
  region: flash_primary
  size: 0x9000
coredump_partition:
  address: 0x161000
  region: flash_primary
  size: 0x4000
overlay(地址必须与 pm_static.yml 一致,两边要手动对齐):
/delete-node/ &storage_partition;

&cpuapp_rram {
	partitions {
		coredump_partition: partition@161000 {
			label = "coredump-partition";
			reg = <0x161000 DT_SIZE_K(16)>;
		};
	};
};
PM 方式的坑:
- PM 要求静态配置中恰好只有一个空隙(留给动态大小的 app),其余区域必须填满;
- 修改
pm_static.yml后必须 pristine 构建(west build -p always); - PM 和 Devicetree 两份地址要保持一致,写错不报错,dump 会写到错误位置。
这也是官方弃用 PM 的原因之一——两份真相来源太容易出问题。
4. 触发崩溃的测试代码
为了验证 dump 里的调用栈回溯效果,故意把崩溃代码套三层函数,每层都加 __noinline 防止编译器内联(内联后调用栈会丢帧):
#include <zephyr/kernel.h>
#include <zephyr/debug/coredump.h>
#include <zephyr/shell/shell.h>
#include <zephyr/sys/printk.h>
#include <zephyr/sys/util.h>

/* 多层嵌套触发崩溃,验证 dump 调用栈回溯(__noinline 防止被内联) */
static __noinline void crash_level3(void)
{
	/* 写未映射地址,触发 BusFault -> coredump -> reset */
	*(volatile uint32_t *)0x60000000 = 0;
}

static __noinline void crash_level2(void)
{
	crash_level3();
}

static __noinline void crash_level1(void)
{
	crash_level2();
}
0x60000000 在 nRF54L15 上是未映射地址,写它会触发 Precise BusFault,属于典型的 fatal error。
再注册一个 shell 命令作为触发入口。需要开启:
CONFIG_SHELL=y
static int cmd_crash(const struct shell *sh, size_t argc, char **argv)
{
	ARG_UNUSED(argc);
	ARG_UNUSED(argv);

	shell_print(sh, "crashing now ...");
	k_msleep(100); /* 等串口日志发完 */

	crash_level1();

	/* 若未触发 fault(兜底) */
	k_panic();

	return 0;
}

SHELL_CMD_REGISTER(crash, NULL, "Trigger a BusFault to generate a coredump",
		   cmd_crash);
你也可以用按钮触发,或者直接调用这个崩溃函数。
最后在 main() 里检查并打印上次保存的 dump(只读不擦除,保留给 PC 端工具直接读 Flash 验证):
/* 启动时检查并打印 flash 中保存的 coredump(只读,不擦除) */
static void print_stored_dump(void)
{
	int ret = coredump_query(COREDUMP_QUERY_HAS_STORED_DUMP, NULL);

	if (ret != 1) {
		printk("No stored coredump (query ret=%d)\n", ret);
		return;
	}

	int size = coredump_query(COREDUMP_QUERY_GET_STORED_DUMP_SIZE, NULL);

	printk("=== Stored coredump found, size=%d bytes ===\n", size);

	uint8_t buf[128];
	off_t off = 0;

	while (off < size) {
		struct coredump_cmd_copy_arg arg = {
			.offset = off,
			.buffer = buf,
			.length = MIN((off_t)sizeof(buf), size - off),
		};

		ret = coredump_cmd(COREDUMP_CMD_COPY_STORED_DUMP, &arg);
		if (ret <= 0) {
			printk("coredump copy error at off=%d: %d\n", (int)off, ret);
			return;
		}

		/* 按 16 字节一行组装后再一次性 printk,避免逐字节打印被丢弃 */
		for (int i = 0; i < ret; i += 16) {
			char line[80];
			int line_len = snprintk(line, sizeof(line), "%08x: ",
						(unsigned int)(off + i));

			for (int j = i; j < MIN(i + 16, ret); j++) {
				line_len += snprintk(line + line_len, sizeof(line) - line_len,
						     "%02x ", buf[j]);
			}
			printk("%s\n", line);
		}
		off += ret;
	}

	printk("\n=== coredump end (%d bytes) ===\n", size);
}

int main(void)
{
	printk("\n[app] boot\n");

	print_stored_dump();

	printk("[app] type 'crash' in shell to trigger BusFault\n");

	return 0;
}
这里用了 coredump 子系统提供的三个应用侧接口:
coredump_query(COREDUMP_QUERY_HAS_STORED_DUMP, NULL):查询分区里是否有有效 dump,返回 1 表示有;coredump_query(COREDUMP_QUERY_GET_STORED_DUMP_SIZE, NULL):获取 dump 数据长度;coredump_cmd(COREDUMP_CMD_COPY_STORED_DUMP, &arg):按偏移分段把 dump 拷贝到内存。
另外还有两个清理命令本文没用到:COREDUMP_CMD_ERASE_STORED_DUMP(整区擦除)和 COREDUMP_CMD_INVALIDATE_STORED_DUMP(仅作废 header)。
实际产品中,上报成功后应该调其中一个清掉之前的 coredump,避免重复上报。
5. 编译、烧录与运行
在 NCS 工具链环境中执行:
# 构建(sysbuild + MCUboot)
west build -p always -b nrf54l15dk/nrf54l15/cpuapp . --sysbuild

# 烧录:sysbuild 下 west flash 会依次烧 MCUboot 和签名后的应用镜像
west flash -d build
用 Shell 模式打开串口(nRF54L15 DK 的 VCOM1,115200 8N1),复位设备,先看到 MCUboot 拉起应用,应用报告没有已存 dump:
*** Booting MCUboot v2.3.0-dev-c1d2d128a001 ***
*** Using nRF Connect SDK v3.4.0-99553055607b ***
I: Bootloader chainload address offset: 0x10000
I: Jumping to the first image slot
*** Booting nRF Connect SDK v3.4.0-99553055607b ***

[app] boot
No stored coredump (query ret=0)
[app] type 'crash' in shell to trigger BusFault
uart:~$
看到 shell 提示符后输入 crash 回车,完整过程如下:
uart:~$ crash
crashing now ...
<err> os: ***** BUS FAULT *****
<err> os:   Precise data bus error
<err> os:   BFAR Address: 0x60000000
<err> os: Faulting instruction address (r15/pc): 0x0001bd9c
<err> os: Current thread: 0x200009d0 (shell_uart)
<err> fatal_error: Resetting system
*** Booting MCUboot v2.3.0-dev-c1d2d128a001 ***
...
[app] boot
=== Stored coredump found, size=795 bytes ===
00000000: 5a 45 02 00 03 00 05 00 19 00 00 00 41 03 00 4c
...
=== coredump end (795 bytes) ===
uart:~$
整个链路:BusFault → coredump 写入 RRAM(内部 NVM) → 自动复位 → MCUboot 启动 → 应用读出 dump 并 hex 打印。dump 只有 795 字节,这就是最小模式的好处。
再次按 Reset 键,dump 会原样再打印一遍,说明它确实固化在 Flash 里,不会被启动过程破坏。
6. 离线导出与调用栈还原
串口 hex 打印只是验证手段,真正有价值的是把 dump 拿出来离线分析。
实际产品中,应用读出 dump 后可以用 BLE、串口、蜂窝等方式上传。也可以直接用 J-Link 读出。
6.1 用 J-link 直接读 Flash
如果有 J-link,可以直接用nrfutil把分区内容读出,不依赖应用层代码:
# 读取整个分区到 Intel HEX 文件(地址对应 overlay 中的 coredump_partition)
nrfutil device read --address 0x178000 --bytes 0x4000 --to-file coredump.hex --serial-number <SN>

# 或只在终端查看头部
nrfutil device read --address 0x178000 --bytes 16 --serial-number <SN>
--serial-number <SN>是 J-Link 序号。如果你电脑上只插了一个 J-Link,也可以不用这个参数。
分区布局是 16 字节 header + dump 数据:
| 偏移 | 字段 | 说明 |
|---|---|---|
| 0 | id[2] |
魔数 'C' 'D'(0x43 0x44) |
| 2 | hdr_version |
头部版本,当前为 1 |
| 4 | size |
dump 数据长度(不含 header),小端 |
| 8 | flags |
保留 |
| 10 | checksum |
数据累加和校验 |
| 12 | error |
非 0 表示上次写入失败,dump 无效 |
| 16 | dump 数据 | 与串口 hex 打印逐字节一致 |
注意:重新烧录固件会擦除该分区,务必先读 dump 再烧录。
6.2 用 GDB 还原寄存器和调用栈
dump 是 Zephyr coredump 二进制格式,不需要人工解析 hex。Zephyr 自带一个 coredump_gdbserver.py(位于 ${ZEPHYR_BASE}/scripts/coredump/),它把 dump 伪装成一个 GDB remote target,GDB 连上后就能像调试现场一样查看寄存器和回溯栈。
分析流程可以写成一个脚本串起来。这边直接提供参考脚本:
analyze_dump.py
"""一条命令分析 Zephyr coredump:ihex -> bin -> 去掉 16 字节 header
-> 启动 coredump_gdbserver -> gdb batch 打印寄存器和调用栈"""

import os
import subprocess
import sys
import tempfile
import time

GDB = "arm-zephyr-eabi-gdb"
OBJCOPY = "arm-zephyr-eabi-objcopy"
FLASH_HDR_SIZE = 16
GDBSERVER_PORT = 1234


def main() -> int:
    if len(sys.argv) != 3:
        sys.exit(f"usage: python {os.path.basename(__file__)} <coredump.hex> <zephyr.elf>")

    hex_file, elf_file = sys.argv[1], sys.argv[2]

    zephyr_base = os.environ.get("ZEPHYR_BASE")
    if not zephyr_base:
        sys.exit("ZEPHYR_BASE is not set; run inside the NCS toolchain environment")

    gdbserver = os.path.join(zephyr_base, "scripts", "coredump", "coredump_gdbserver.py")
    for f in (hex_file, elf_file, gdbserver):
        if not os.path.isfile(f):
            sys.exit(f"file not found: {f}")

    tmpdir = tempfile.mkdtemp(prefix="coredump_")
    raw_bin = os.path.join(tmpdir, "raw.bin")
    dump_bin = os.path.join(tmpdir, "coredump.bin")

    # Intel HEX -> binary
    subprocess.run([OBJCOPY, "-I", "ihex", "-O", "binary", hex_file, raw_bin],
                   check=True)

    # 去掉 flash header(offset 4 处是小端 32 位 dump 长度)
    with open(raw_bin, "rb") as f:
        raw = f.read()
    if raw[:2] != b"CD":
        sys.exit("flash partition header magic is not 'CD'; no valid coredump")
    size = int.from_bytes(raw[4:8], "little")
    with open(dump_bin, "wb") as f:
        f.write(raw[FLASH_HDR_SIZE:FLASH_HDR_SIZE + size])
    print(f"[*] dump size = {size} bytes")

    # 启动 coredump GDB server
    server = subprocess.Popen([sys.executable, gdbserver, "--port", str(GDBSERVER_PORT),
                               elf_file, dump_bin],
                              stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)
    try:
        # 等待就绪。注意:不要用 socket 探测端口——gdbserver 会把第一个
        # TCP 连接当成 GDB 会话,探测会抢走连接,GDB 会看到 "No stack"
        for _ in range(25):
            if server.poll() is not None:
                sys.exit("coredump_gdbserver failed to start")
            time.sleep(0.2)

        # GDB batch:打印寄存器和调用栈
        out = subprocess.run(
            [GDB, "-batch",
             "-ex", f"target remote localhost:{GDBSERVER_PORT}",
             "-ex", "info registers pc lr sp",
             "-ex", "bt",
             elf_file],
            capture_output=True, text=True, errors="replace")
        # 过滤 gdbserver 噪声行
        for line in (out.stdout + out.stderr).splitlines():
            if line.strip() and "Remote " not in line:
                print(line)
    finally:
        server.terminate()

    return 0


if __name__ == "__main__":
    sys.exit(main())
在 NCS 工具链环境中执行上述脚本,传入 dump 二进制和对应工程的 elf 文件:
python analyze_dump.py coredump.hex build\<应用名>\zephyr\zephyr.elf
输出(nRF54L15 DK 实测):
[*] dump size = 795 bytes
0x0001bd9c in crash_level3 () at src/main.c:18
18		*(volatile uint32_t *)0x60000000 = 0;
pc             0x1bd9c             0x1bd9c <crash_level3+6>
lr             0x11147             69959
sp             0x20002258          0x20002258 <shell_uart_stack+1552>
#0  0x0001bd9c in crash_level3 () at src/main.c:18
#1  0x0001bda4 in crash_level2 () at src/main.c:23
#2  0x0001bda8 in crash_level1 () at src/main.c:28
#3  0x00011146 in cmd_crash (...) at src/main.c:88
#4  0x00013c58 in exec_cmd (...) at zephyr/subsys/shell/shell.c:565
...
#10 0x000118b2 in z_thread_entry (...) at zephyr/lib/os/thread_entry.c:60
#0 帧就是崩溃点,精确定位到 src/main.c:18 的那句野指针写,与崩溃时串口打印的 r15/pc: 0x0001bd9c 完全吻合。三层嵌套函数一帧不少,继续往下还能穿过 shell 子系统直到线程入口,每一帧都带源文件和行号。这就是前面坚持加 __noinline 的原因——没有它,crash_level1/2/3 会被内联成一帧,回溯就丢层了。
前提:ELF 必须与崩溃时运行的固件是同一次构建的产物,否则地址对不上。现场设备抓 dump 时,记得归档对应的
zephyr.elf。
7. 注意事项
- 重复崩溃只保留一份 dump:后端每次写入前先整区擦除,旧内容不会残留。如果写入中途断电,header 的
error字段非 0,查询时会视为无效 dump。 - 烧录工具对 dump 的影响不同:实测
west flash只写 MCUboot 和应用镜像区域,coredump 分区内容保留;而nrfutil device program属于整片擦除式烧录,会清掉 dump。无论如何,分析现场前先读分区最保险。 CONFIG_LOG_PRINTK=n不能省:dump hex 打印量大,走 LOG deferred 缓冲会被丢弃,只看到messages dropped。- 分区表要单一来源:sysbuild 多镜像各有独立 Devicetree,分区布局改一处忘了另一处,会导致 app 和 MCUboot 看到的槽位地址不一致,表现为 DFU 后无法启动。用共享 dtsi + 双 overlay include 的方式可以从根上避免。
- 栈大小影响 dump 完整性:最小模式 dump 的是异常线程的栈区域,如果线程栈很大(比如 shell 线程),dump 体积会跟着涨,分区要留够。本文 16KB 分区对 795 字节的 dump 非常宽裕。
- 生产版本建议关掉 shell 触发入口:
crash命令只用于验证,量产固件应移除,避免被误触发。
8. 延伸阅读:用 Memfault 云端做规模化故障检测
本文的方案是"设备存 Flash + 人工读出来本地 GDB 分析",适合调试阶段和小批量场景。如果设备已经批量铺到客户现场,一台台接 J-Link 读 dump 显然不现实,这时可以考虑 Nordic 旗下的 Memfault 云端设备可观测性平台。
NCS 已经集成了 Memfault SDK(modules/lib/memfault-firmware-sdk),它底层同样基于 Zephyr 的 Coredump 子系统,但把本文第 6 步的"人工导出分析"换成了全自动链路:
- 设备端自动采集:崩溃时自动保存 coredump,同时持续收集重启原因、metrics(如 LTE 连接耗时、栈剩余量)、trace events 等;
- 自动上报:设备联网后通过 HTTPS 把数据上传到 Memfault 云端(支持 LTE、Wi-Fi 等链路);
- 云端自动分析:上传 ELF 符号文件后,云端自动把 coredump 还原成带行号的调用栈,并把相同崩溃聚合成 Issue,统计影响版本和设备数量,无需人工逐个分析;
- Fleet 级监控:在 Web 控制台查看整个设备群的健康度、崩溃率趋势,还支持 OTA 升级闭环。
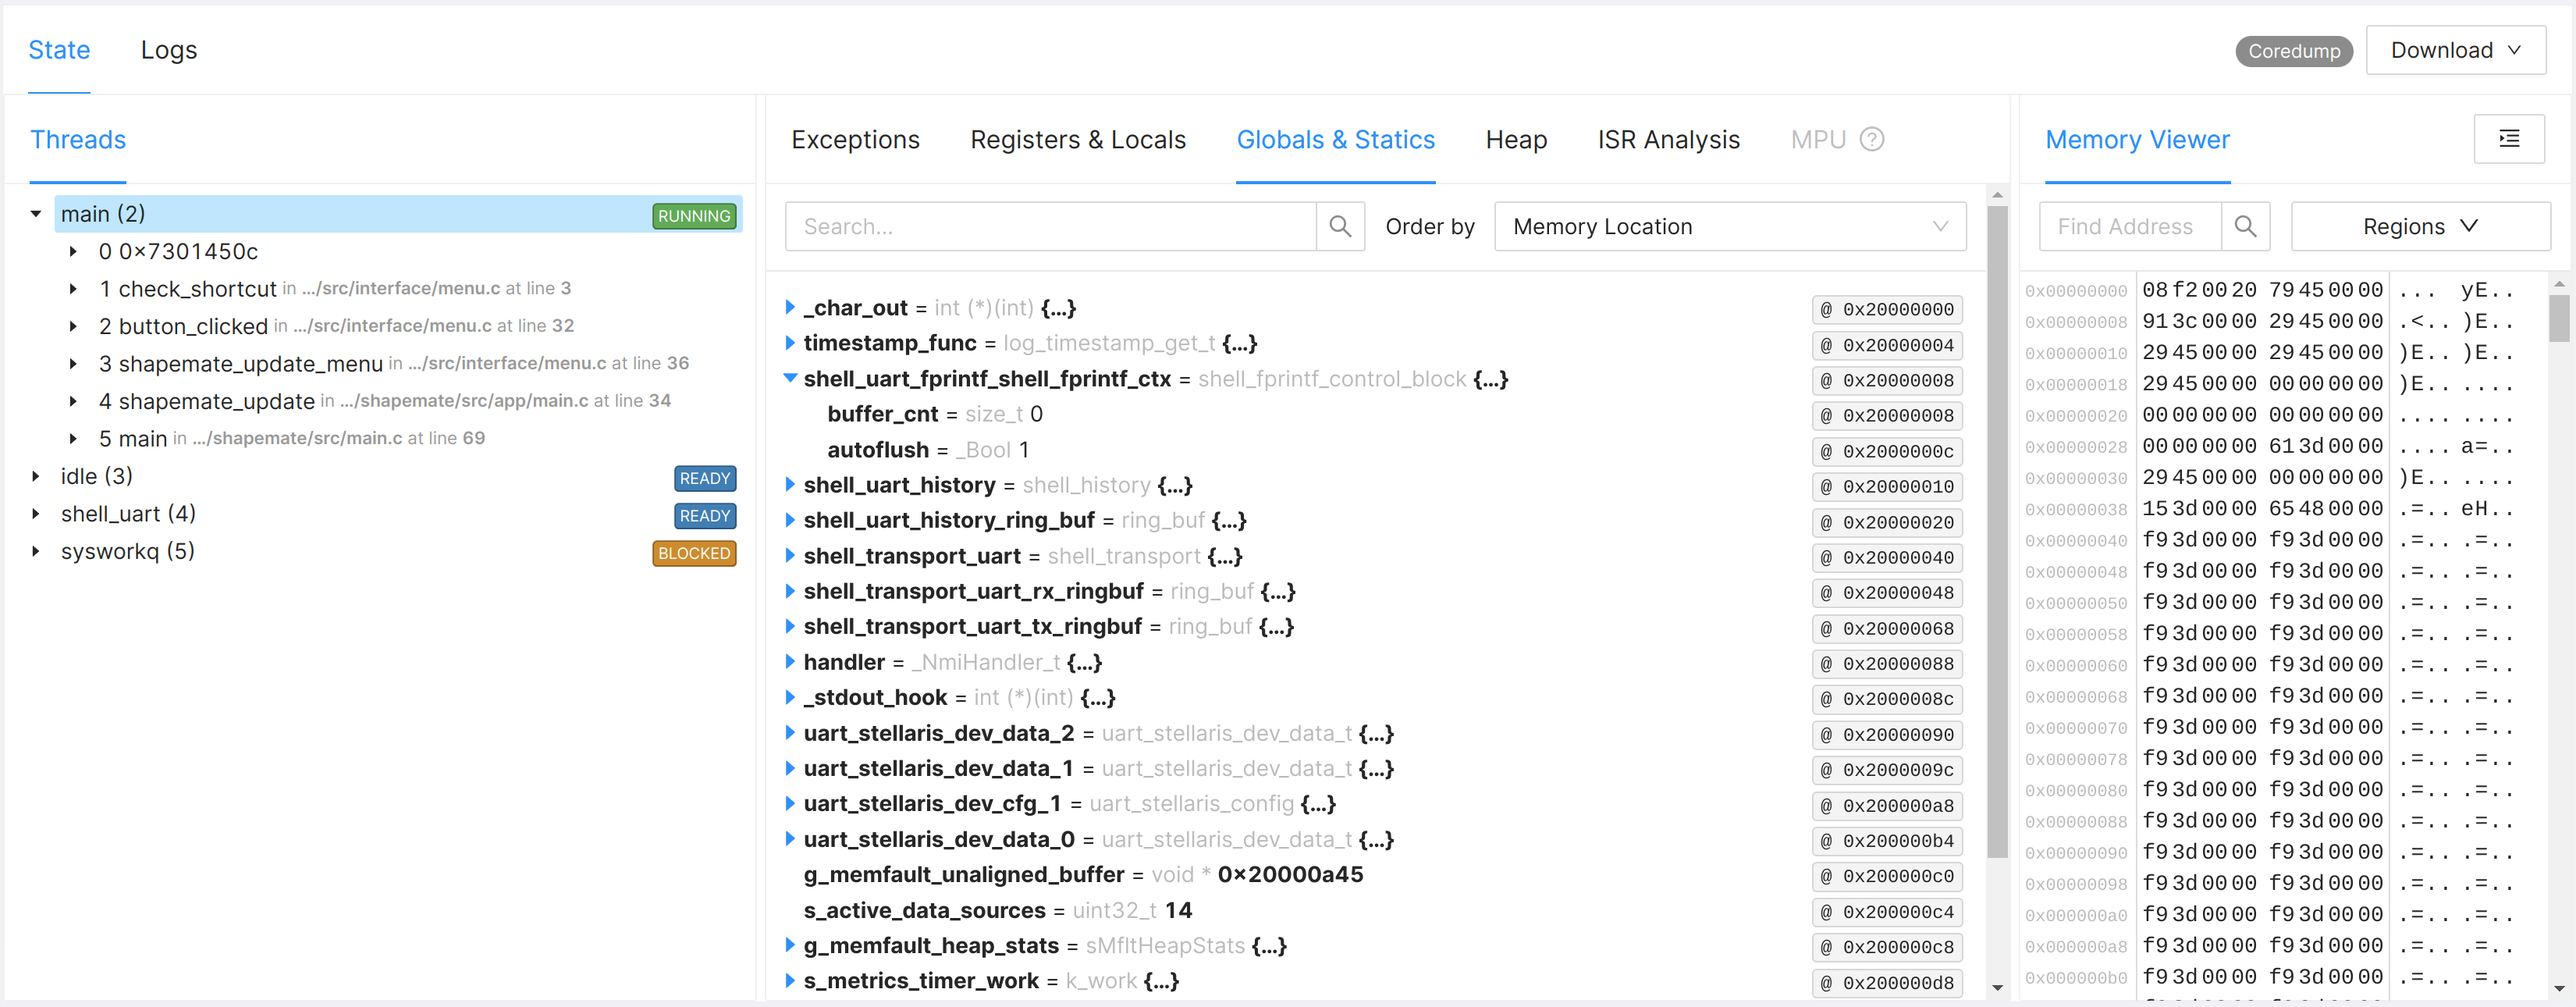
下面是 Memfault 官方文档中 MCU(Zephyr)项目的云端分析界面效果。Issue 详情页一览:左侧是崩溃时的线程列表,右侧可以直接看寄存器、Heap/ISR/MPU 分析:
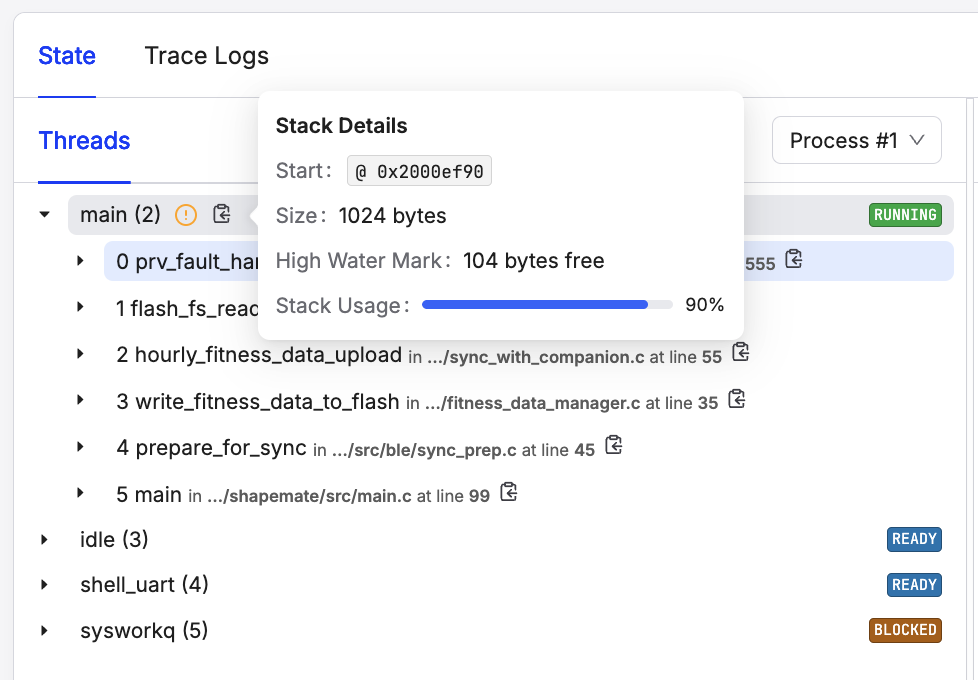
每个线程的 backtrace 可以逐帧展开,显示源文件路径、行号、PC 地址,与本文用 GDB 还原出的调用栈等价:
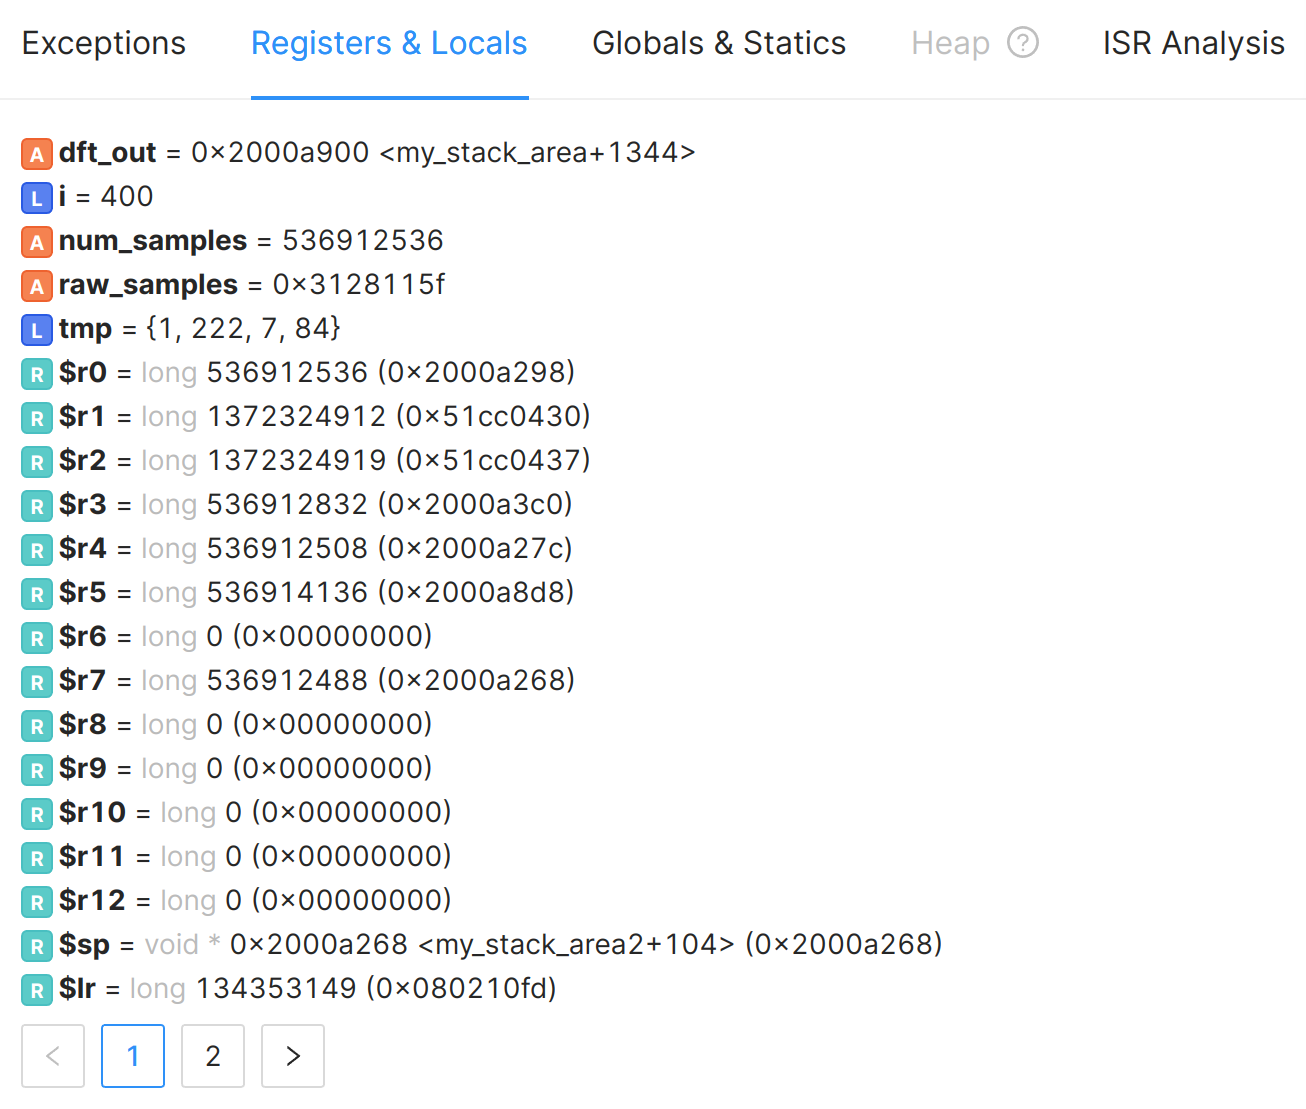
点击某一帧,还能查看该帧的寄存器值和局部变量:
Memfault 的崩溃分析是事后快照,不是实时调试:云端展示的寄存器、调用栈、变量全部来自设备崩溃瞬间保存的 coredump,不能在云端单步、下断点或查看设备当前状态。
但它比本地方案强在两点:一是每台设备的每次崩溃都会上报并按 Issue 聚合,保留期内可回溯任意历史现场,还能统计影响面;二是 metrics 通过 heartbeat 周期性上报,可以看整个设备群的运行趋势,接近准实时监控。换句话说,Memfault 替代的是本文第 6 章的"读 dump + GDB 离线分析"并把它规模化器。
批量监控方面,Overview Dashboard 可以一眼看到整个设备群的活跃设备数、软件版本分布和各项 metrics 趋势:
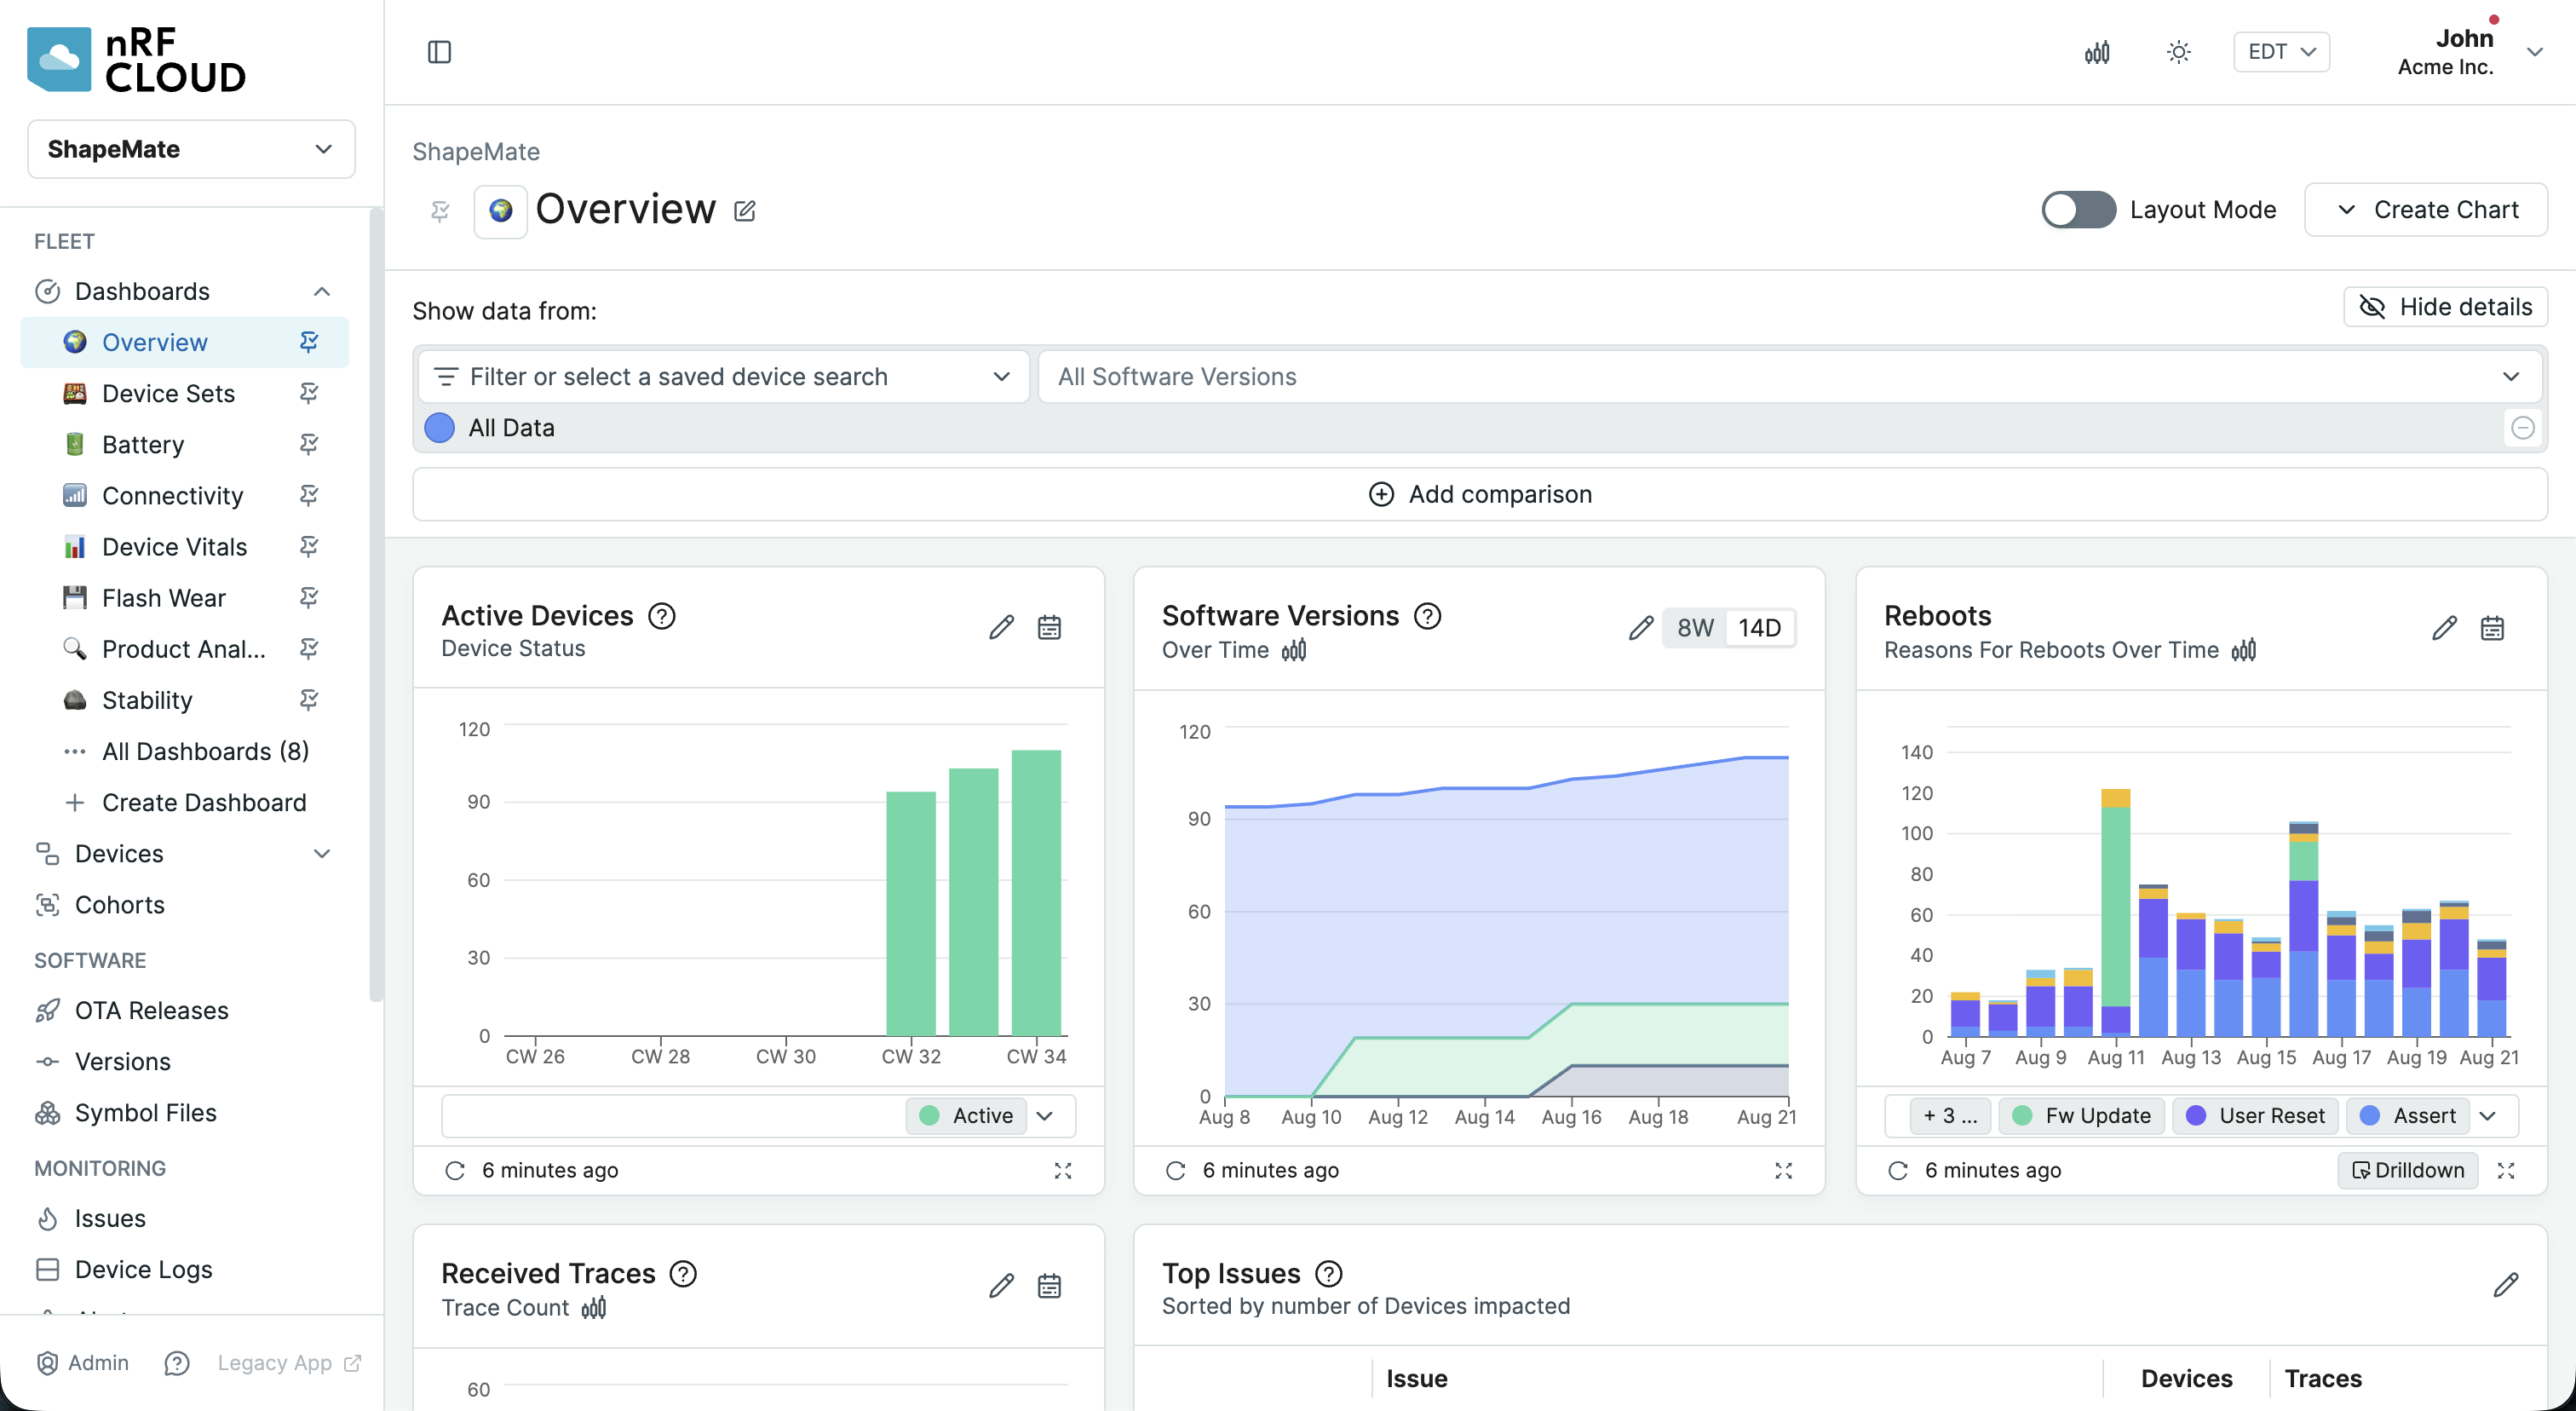
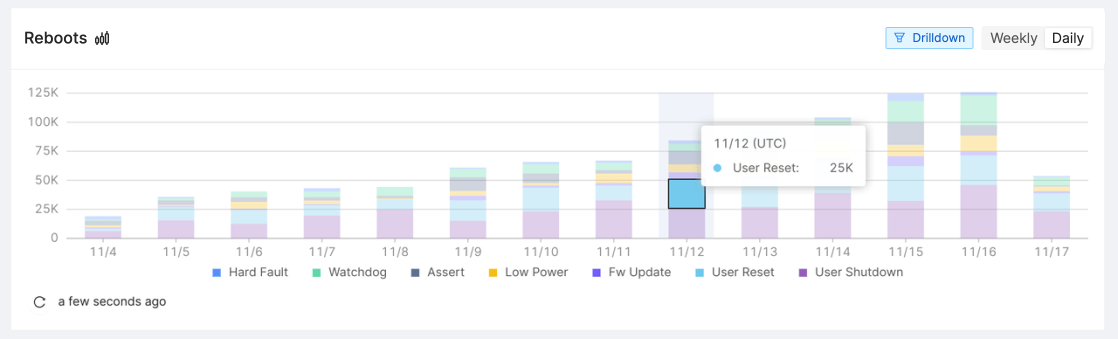
以 Reboots 图表为例,它按重启原因(低电量、用户复位、看门狗等)分解每天的重启次数,点击某一段还能下钻到对应的具体设备列表,从"发现趋势异常"到"定位受影响设备"一步到位:
NCS 自带参考例程 nrf/samples/debug/memfault(支持 nRF91 系列 LTE 和 nRF7002 Wi-Fi),注册 Memfault 账号拿到 project key 填入 CONFIG_MEMFAULT_NCS_PROJECT_KEY 即可跑通。详细集成方式见 NCS 文档的 Memfault 章节。

 浙公网安备 33010602011771号