
从轮询到等待——PostgreSQL WAIT FOR LSN 特性深度解析
本文整理于 HOW 2026 演讲内容,演讲者:周煦能,数据系统工程师,专注 PostgreSQL 内核开发、性能优化与核心子系统补丁迭代,拥有大量生产级内核优化经验。
前言
在异步复制的 PostgreSQL 集群中,读写一致性是一个长期存在的痛点。主库写入成功后,备库可能还未完成 WAL 的重放,此时在备库上查询,可能查不到刚刚写入的数据。为了解决这个问题,社区此前普遍采用的方案是轮询(Polling) :在备库上不断查询pg_last_wal_replay_lsn(),直到其追上主库的目标 LSN。
然而,轮询方案存在明显的效率问题:反复查询带来了大量的 CPU 消耗、缓存污染和上下文切换。在 PG 19 中,社区引入了一个全新的特性——WAIT FOR LSN,通过事件驱动的等待机制,彻底替代了低效的轮询。
本文基于 HOW 2026 开源生态大会暨 PostgreSQL 高峰论坛的主题分享,系统解析 WAIT FOR LSN 特性的设计背景、实现原理与接口设计。
一、异步场景下的读写一致性挑战
1.1 同步复制 vs 异步复制
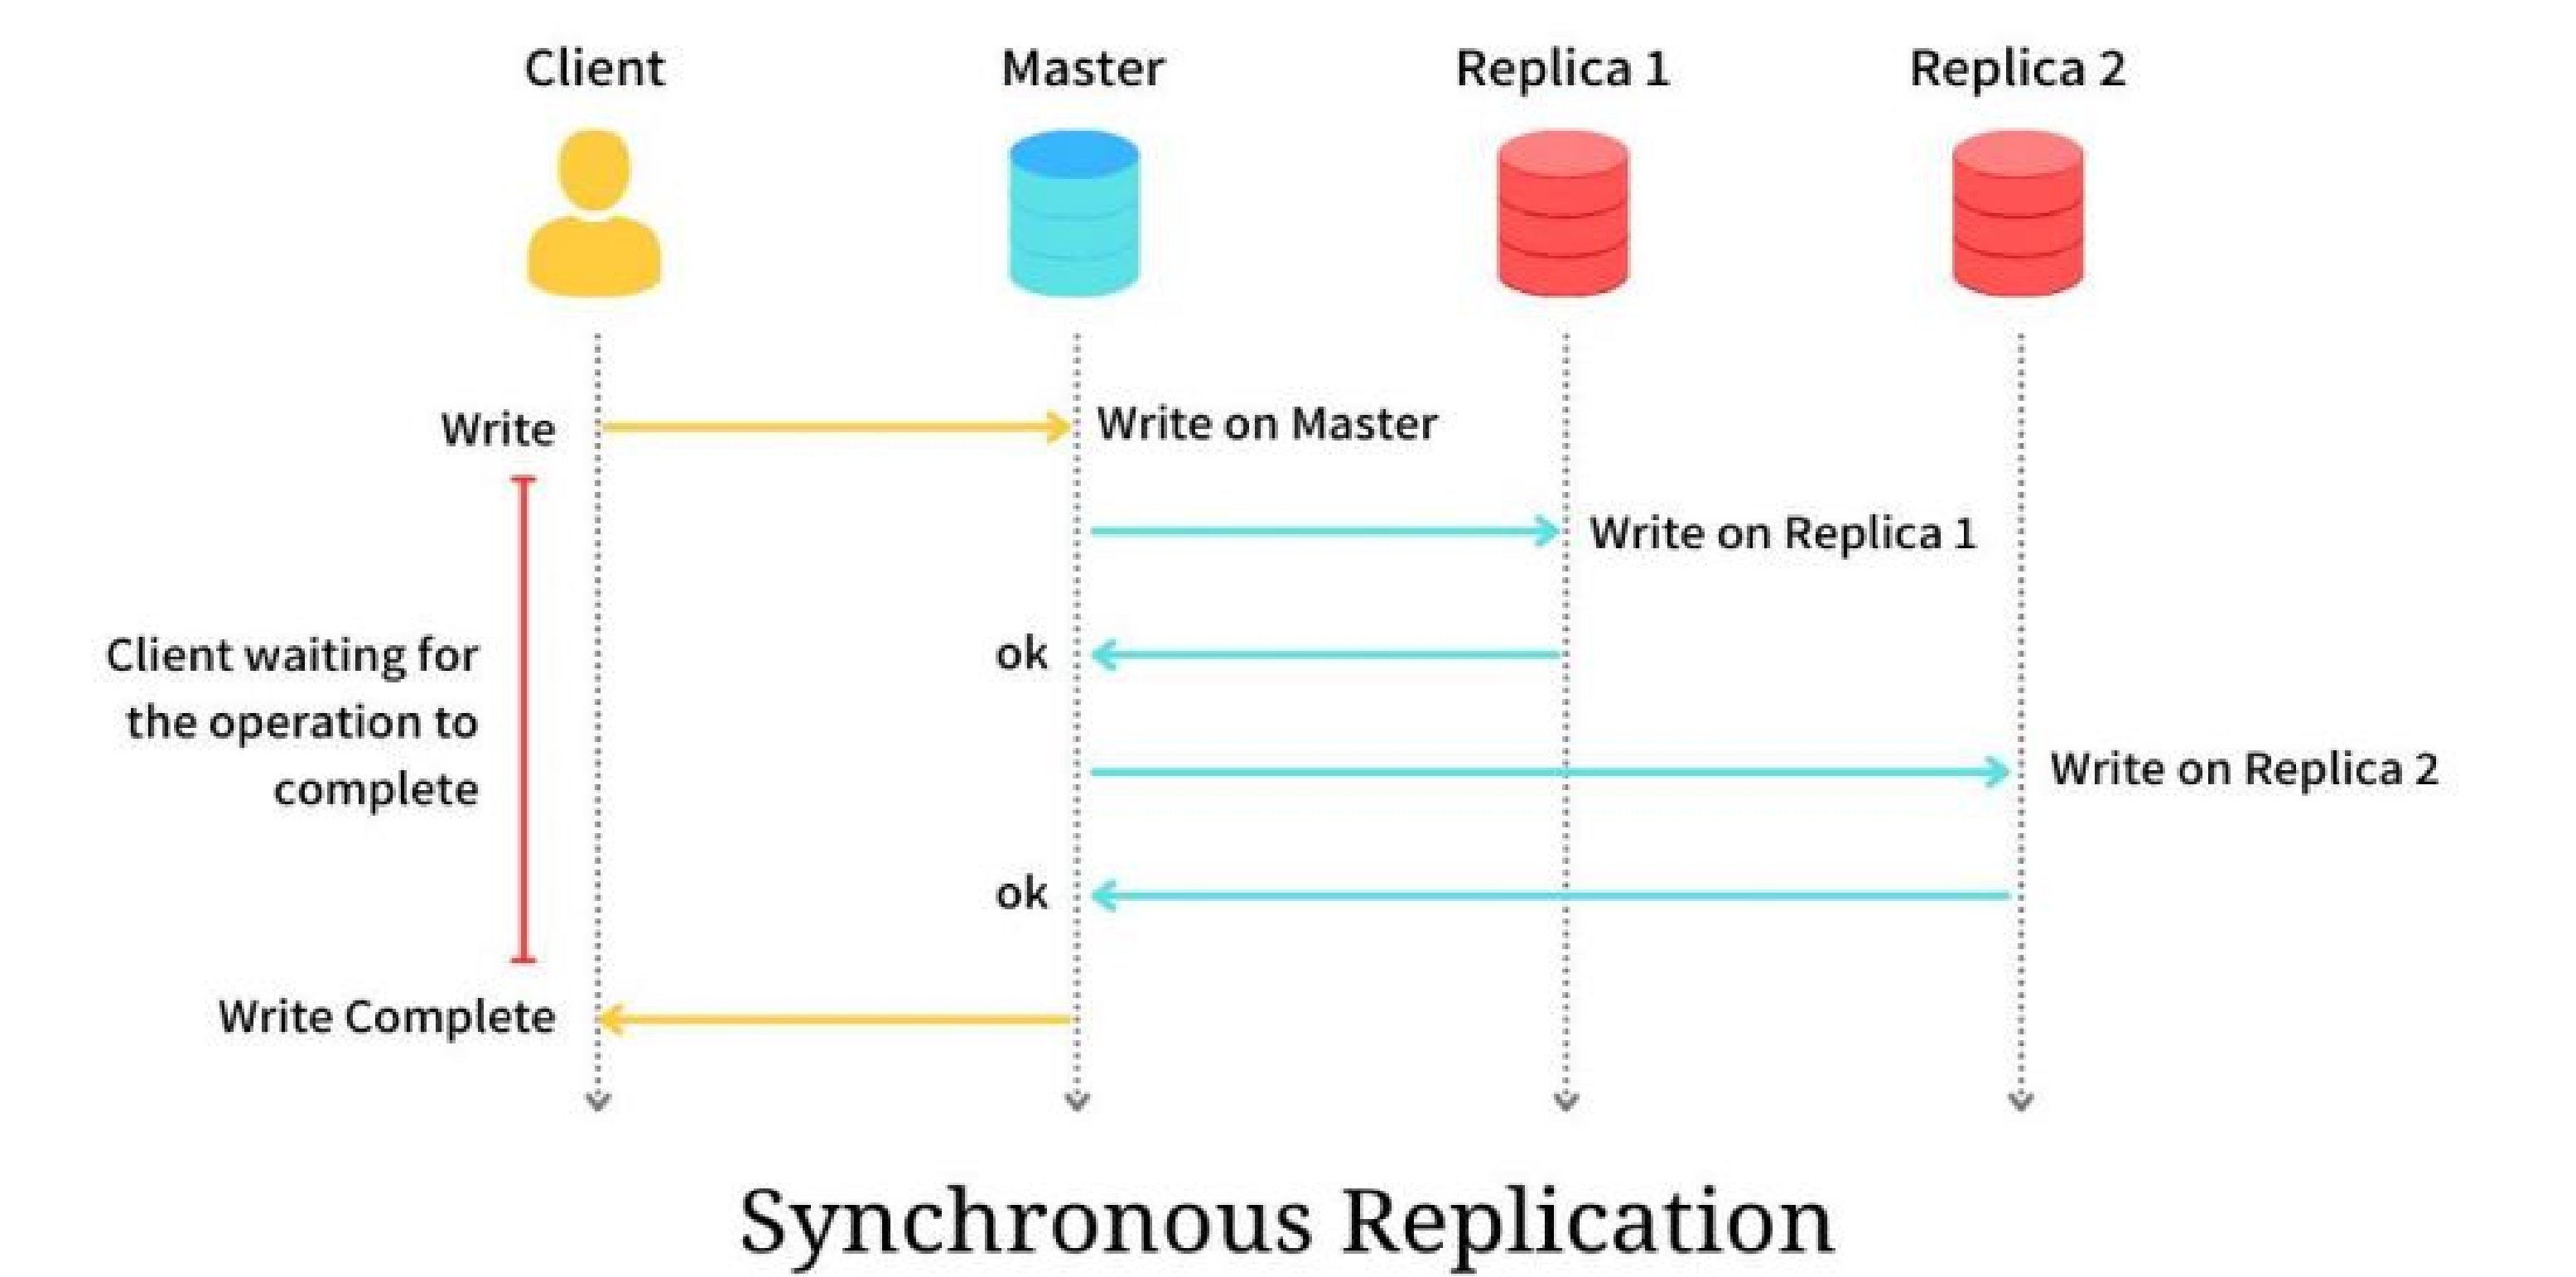
在同步复制模式下,客户端发起写请求后,主库在本地完成写入,并将变更同步复制到所有同步备库。只有在主库和所有同步备库均确认写入成功后,主库才向客户端返回成功。因此,客户端在备库上查询时,能够确保数据已同步。
而在异步复制模式下,情况则完全不同:
- 客户端向主库发起写入请求
- 主库本地 WAL 持久化后,立即向客户端返回成功(无论备库是否已接收到 WAL)
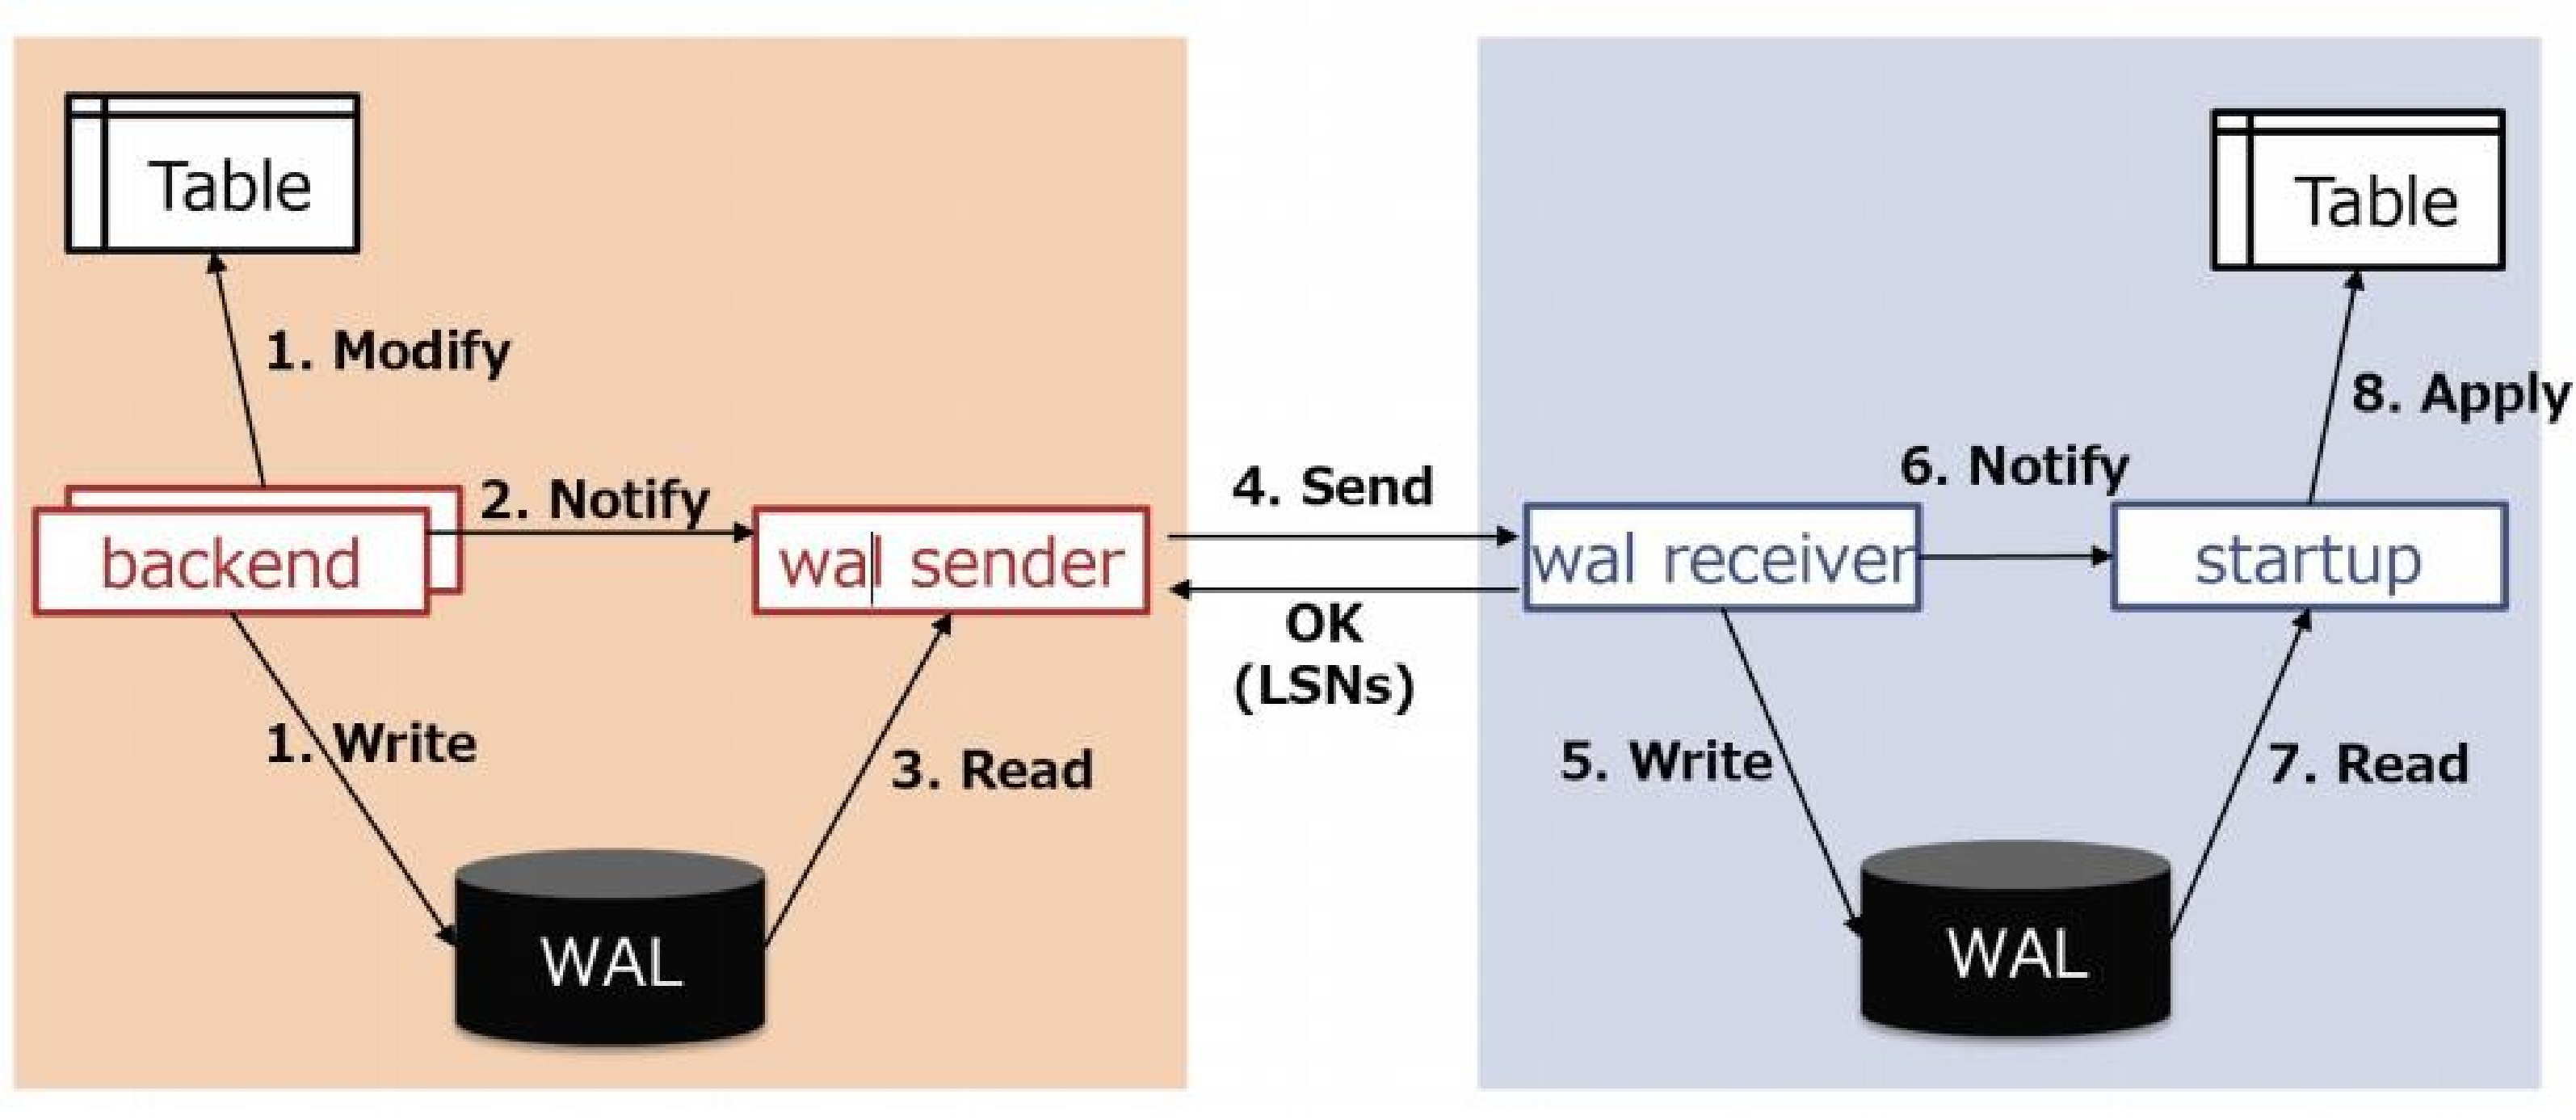
- WAL 通过 walsender 异步发送给备库的 walreceiver
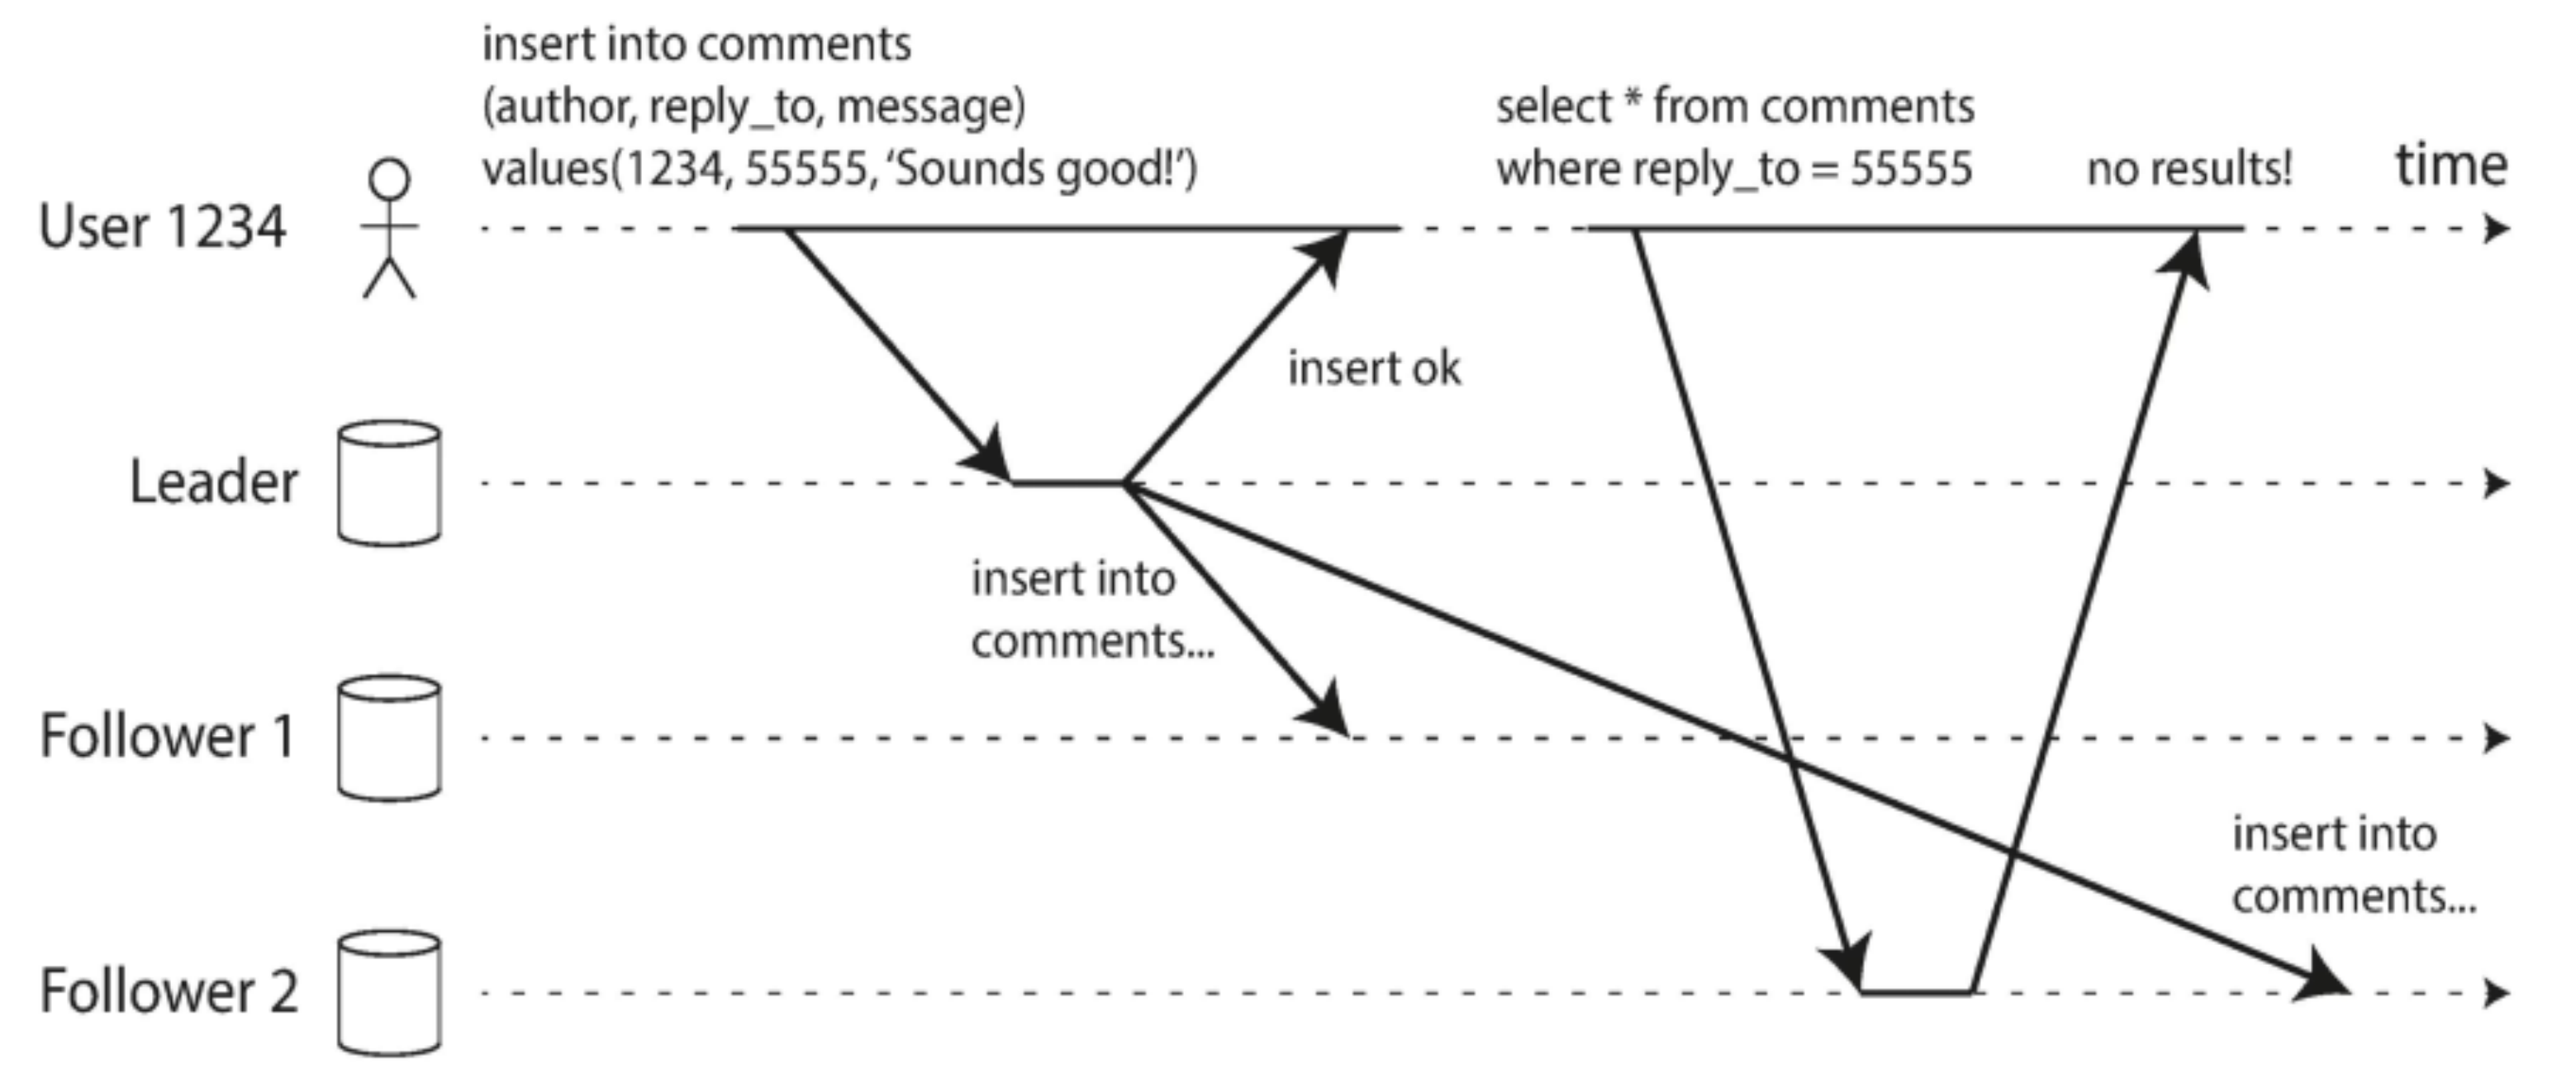
- 备库接收并重放 WAL——此过程存在延迟(replication lag)
- 客户端立即在备库上查询——可能查不到刚刚写入的数据
一致性问题的根本原因在于:主库提交与备库回放是解耦的。主库的提交操作与 walsender 发送 WAL、备库接收和回放 WAL 之间,没有任何同步保证。
1.2 一致性问题的典型场景
读写分离架构中,为了分摊主库的查询压力,应用程序通常会将读请求路由到备库。然而,在异步复制场景下,如果写入操作刚完成就立即查询备库,查询结果可能为空——数据尚未同步完成。
这在很多业务场景中是不可接受的。一个典型例子是“写后读”模式:用户提交表单后立即刷新页面查看结果,如果查询被路由到尚未完成同步的备库,用户将看到不一致的状态。
二、基于轮询的现有方案及其开销
2.1 轮询方案的实现逻辑
社区此前提供的轮询方案,核心逻辑如下:
-- 在主库获取当前WAL插入位置
SELECT pg_current_wal_insert_lsn(); -- 例如 0/306EE20

-- 在备库不断轮询,直到重放位置追上目标LSN
function wait_for_replay(target_lsn, timeout):
    deadline = now() + timeout
    while now() < deadline:
        replay_lsn = query("SELECT pg_last_wal_replay_lsn()")
        if replay_lsn is NULL:
            continue   -- 备库尚未就绪
        if lsn_cmp(replay_lsn, target_lsn) >= 0:
            return "success"
        sleep(200ms)
    return "timeout"
2.2 轮询方案的核心缺陷
| 问题 | 说明 |
|---|---|
| 额外开销 | 反复发起查询并比较 LSN,带来 SQL 执行、连接和网络开销 |
| 延迟与负载的权衡 | 轮询间隔越短,响应越及时但系统开销越大;间隔越长,系统开销小但检测延迟越大 |
| 非事件驱动 | 条件满足后,仍需等到下一次轮询才能观察到状态变化 |
| 应用逻辑复杂 | 需要自行处理超时、重试、异常状态以及边界情况 |
2.3 轮询开销的微观分析
为了直观观察轮询的实际代价,可以构造一个实验:
- 在主库创建长时间运行的阻塞条件:开启一个后台事务(如
BEGIN; INSERT; pg_sleep(60); COMMIT;),使该事务长时间持有资源 - 在备库触发被阻塞的操作:执行
pg_create_logical_replication_slot(),该操作会进入等待状态 - 收集性能指标:通过 perf 工具采集等待进程的硬件指标
实验结果显示,在 60 秒的等待过程中:
| 指标 | 数值 |
|---|---|
| CPU 周期数 | 2,930,606,156(约 29 亿) |
| 指令数 | 1,003,179,713(约 10 亿) |
| 缓存未命中 | 144,808,110(约 1.45 亿) |
| 上下文切换 | 77,278(约 7.7 万次) |
一个仅仅在等待的后端进程,就消耗了数十亿的 CPU 周期,并发生了数万次上下文切换。
2.4 代价为何如此之高?
轮询的开销主要来自以下几个方面:
(1)上下文切换(Context Switch)
进程在休眠与唤醒之间反复切换,涉及用户态与内核态的转换,每次切换都有显著的成本:TLB(Translation Lookaside Buffer,页表缓存)刷新失效;CPU 流水线被冲刷(pipeline flush),无法并行执行;L1/L2/L3 的指令缓存和数据缓存被污染。
(2)调度器开销
Linux 的调度器使用红黑树(Red-Black Tree,一种自平衡二叉搜索树)管理可运行进程。每次将进程从红黑树取下再放回,都需要进行树的平衡操作(rebalance)。
(3)性能计数器开销
进程切换时,内核需要记录进程在 CPU 上运行的时间等统计信息,这些记账操作本身也消耗 CPU。
社区资深成员 Andres Freund 曾在邮件列表中表示:PostgreSQL 代码中应尽量避免引入长时间的轮询——因为轮询会隐藏 bug、容易出错、耗能且低效。
三、WAIT FOR LSN 基础设施
3.1 设计目标
WAIT FOR LSN 的核心设计思路是:用事件驱动的等待机制替代轮询。当条件满足时,进程被主动唤醒,而不是反复自行检查。
3.2 核心 IPC 机制
PG 内部提供了两种主要的进程间通信(IPC)原语:
(1)Latch
基于布尔标志的唤醒原语,通过SetLatch/ResetLatch/WaitLatch进行操作。进程在“有工作到来之前”进入休眠,避免轮询。
(2)条件变量(Condition Variable)
基于自旋锁保护的等待队列(由一组 PGPROC 组成),通过Signal/Broadcast唤醒等待者。本质上是给对应进程设置其 latch,从而触发唤醒。
3.3 消除“虚假唤醒”
如果采用简单的条件变量方案,每次 WAL 推进时广播唤醒所有等待进程,会导致大量不必要的唤醒——因为很多进程等待的目标 LSN 可能尚未达到。
要实现精确唤醒,需要引入按 LSN 索引的等待队列,仅唤醒那些条件已经满足的进程:
- 为每个 backend 分配独立的 latch
- 维护一个等待队列,记录每个进程的等待类型和目标 LSN
- 只有当目标 LSN 达成时,才唤醒相应的进程
数据结构设计:
引入ProcessInfos结构保存当前所有等待进程的信息。使用配对堆(Pairing Heap) 按等待 LSN 排序,以便快速获取当前等待的最小 LSN。引入无锁的缓存标记(lock-free cache mark) ,记录当前所有等待类型中最小等待 LSN 的值——每次 WAL 推进时,只需比较推进的 LSN 与缓存的最小等待 LSN,如果连最小的等待 LSN 都没有达到,则无需遍历堆。
3.4 WAIT FOR LSN Infra 核心接口
新增的核心接口:
WaitLSNWakeup:用于唤醒等待 LSN 的进程WaitForLSN:用于进程进入等待状态
支持的等待类型:
standby_replay:等待备库回放(默认)standby_write:等待备库写入standby_flush:等待备库持久化primary_flush:等待主库持久化
3.5 效果验证
将原有轮询逻辑:
pg_usleep(1000L); // 轮询等待
替换为事件驱动机制:
WaitForLSN(WAIT_LSN_TYPE_PRIMARY_FLUSH, loc, -1);
WaitForLSN(WAIT_LSN_TYPE_STANDBY_REPLAY, loc, -1);
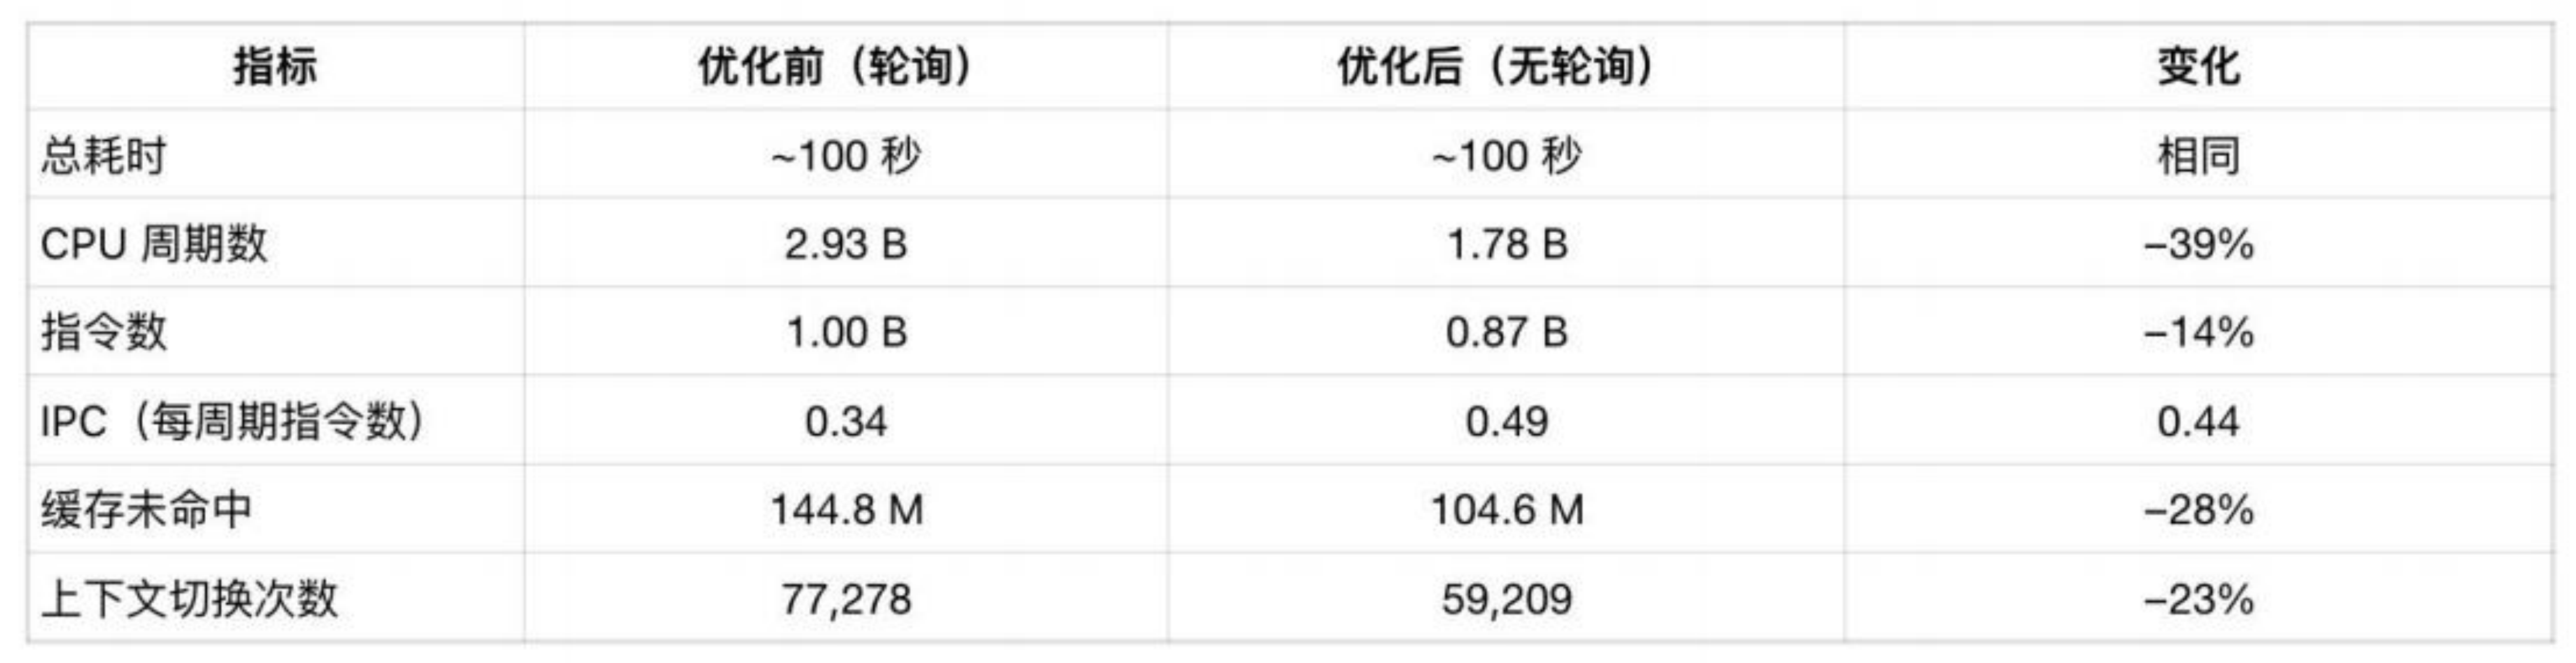
在同样的 60 秒等待测试中,硬件指标显著改善:
| 指标 | 轮询方案 | WAIT FOR LSN | 提升 |
|---|---|---|---|
| CPU 周期数 | ~29 亿 | ~17.8 亿 | 约 39% |
| 指令数 | ~10 亿 | ~8.7 亿 | 约 14% |
| 缓存未命中 | ~1.45 亿 | ~1.06 亿 | 约 27% |
| 上下文切换 | ~77,278 | ~60,000 | 约 22% |
值得注意的是,每周期指令数(IPC) 有所提升,说明 CPU 利用率更高——流水线没有被缓存未命中或代码冲刷频繁阻塞。
四、WAIT FOR LSN 命令接口
4.1 为什么不能用 Function 或 Procedure?
在设计用户接口时,看似有多种选择:Function、Procedure 或 Command。最终选择Command而非更常见的 Function/Procedure,背后有深刻的技术原因。
关键约束:等待期间必须释放所有 Snapshot
如果在等待期间持有 Snapshot(快照),会持有MyProc->xmin,从而阻止备库的 WAL 回放。具体来说:
- startup process 回放时,需要判断某些元组(tuple)或索引项对哪些进程可见
- 如果某个 backend 持有 snapshot,startup process 可能需要等待该 backend 结束才能推进回放
- 而该 backend 可能在等待 WAL 回放——形成死锁(Self Deadlock)
各方案的对比:
| 方案 | 问题 | 结论 |
|---|---|---|
| Function | ExecutorRun 期间必须持有 query 快照;函数只是表达式求值,不能安全释放外层 ActiveSnapshot → 持有 xmin → 可能阻塞备机回放 | ❌ |
| Procedure | CALL 本身嵌在 portal/result 处理流程中,snapshot 可能由外层框架创建,不属于 procedure 本身,无法安全释放 | ❌ |
| Command | 顶层 utility command,不需要 snapshot;等待前清理 active/catalog snapshot,并验证无 registered snapshot → MyProc->xmin 为 Invalid,可安全等待 replay | ✅ |
只有 Command 能够满足安全等待的要求。
4.2 命令语法与使用示例
基本用法:
-- 主库执行写入操作
UPDATE movie SET genre = 'Dramatic' WHERE genre = 'Drama';
-- UPDATE 100

-- 获取当前WAL插入位置
SELECT pg_current_wal_insert_
();
-- pg_current_wal_insert_lsn
-- ---------------------------
-- 0/306EE20
-- (1 row)

-- 在备库执行等待
WAIT FOR LSN '0/306EE20';
-- status
-- ---------
-- success
-- (1 row)

-- 此时备库已同步,可以查到写入的数据
SELECT * FROM movie WHERE genre = 'Drama';
-- genre
-- -------
-- (0 rows)
带选项的用法:
WAIT FOR LSN '<lsn>' [WITH (MODE '<mode>')]
支持的 MODE 选项:
standby_replay(默认):等待备库回放完成standby_write:等待备库写入完成standby_flush:等待备库持久化完成primary_flush:等待主库持久化完成
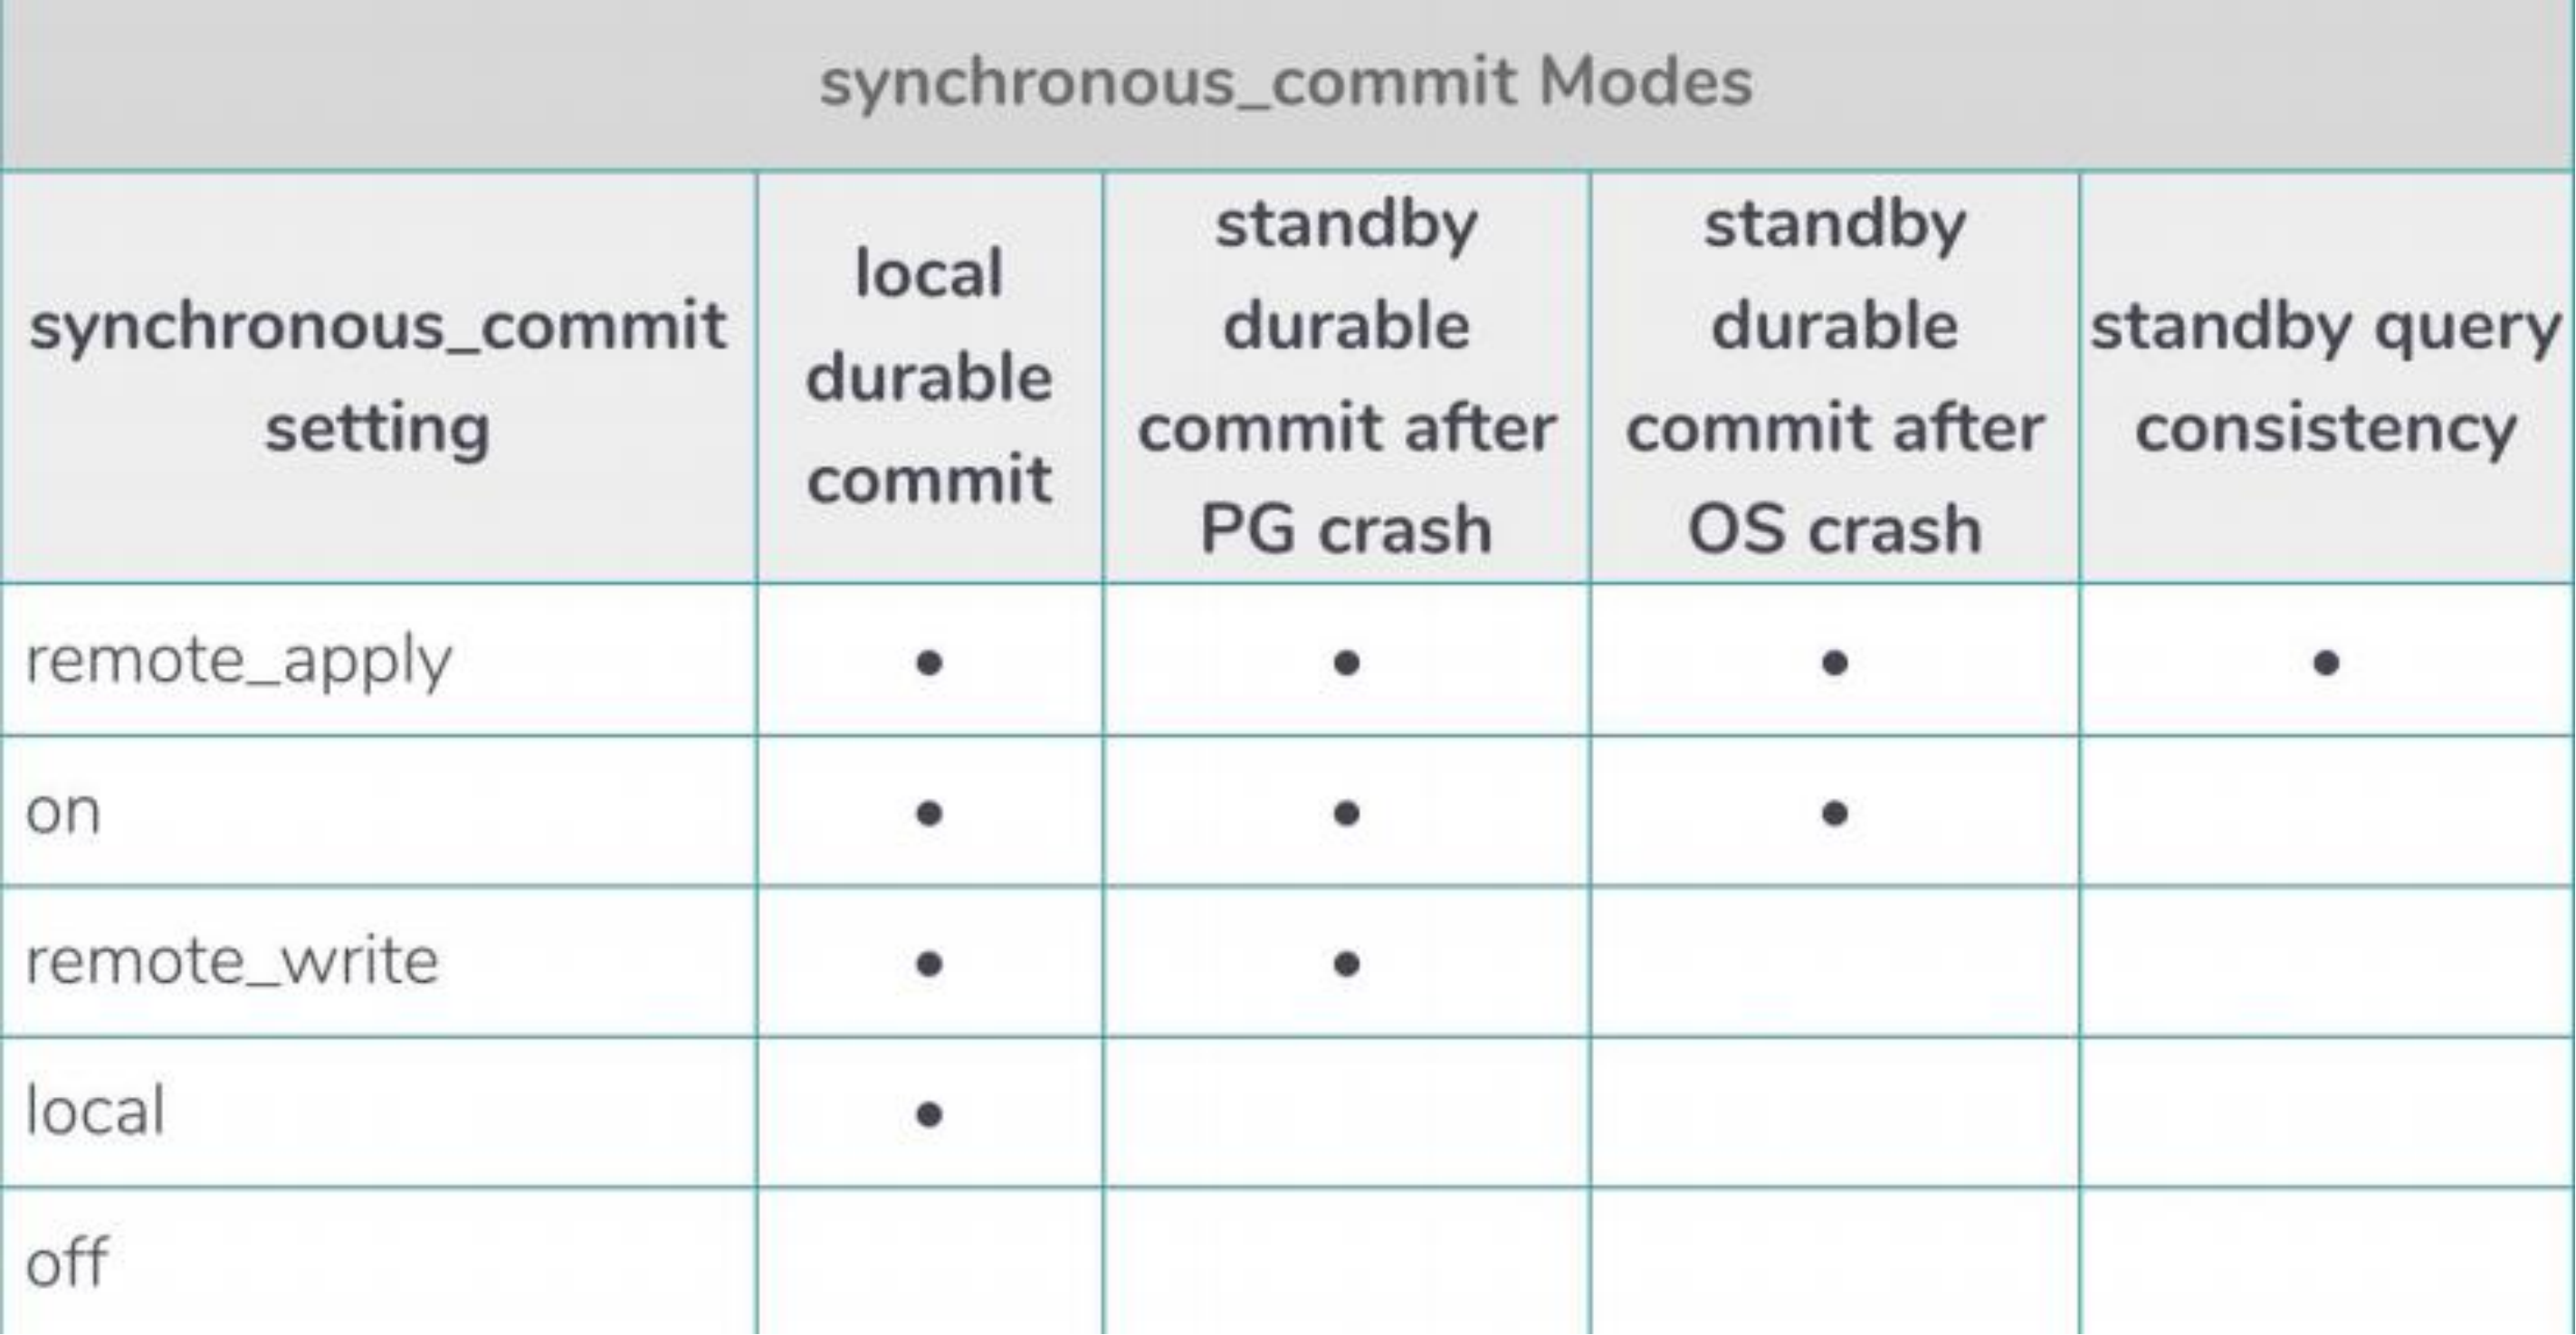
不同 MODE 对应不同的等待级别,用户可以根据业务一致性需求灵活选择。
结语
WAIT FOR LSN 是 PostgreSQL 19 中一个重要的特性增强。它通过以下方式从根本上解决了异步复制场景下的读写一致性问题:
- 事件驱动替代轮询:彻底消除了轮询带来的 CPU 周期消耗、缓存污染和上下文切换开销
- 精准定向唤醒:通过 LSN 索引的等待队列,只唤醒条件满足的进程,避免“虚假唤醒”
- 安全的接口设计:通过 Command 而非 Function/Procedure 实现,确保等待期间能够释放所有 Snapshot,避免死锁
这一特性不仅提升了异步复制场景下的系统效率,也为用户提供了一种简洁、可控的读写一致性保障手段。

 浙公网安备 33010602011771号