
Java 常见集合类
😉 本文共3247字,阅读时间约10min
底层数据结构
List
ArrayList:Object[]数组Vector:Object[]数组LinkedList: 双向链表
Set
HashSet(无序,唯一): 基于 HashMap 实现的,底层采用 HashMap 来保存元素
TreeSet(有序,唯一): 红黑树(自平衡的排序二叉树)。TreeSet 用于支持对元素自定义排序规则的场景。
LinkedHashSet: LinkedHashSet 是 HashSet 的子类,并且其内部是通过 LinkedHashMap 来实现的。有点类似于我们之前说的 LinkedHashMap 其内部是基于 HashMap 实现一样,不过还是有一点点区别的
Queue
PriorityQueue:Object[]数组来实现二叉堆ArrayQueue:Object[]数组 + 双指针
Map
HashMap:数组 + 链表 + 红黑树
TreeMap: 红黑树(自平衡的排序二叉树)
Hashtable: 数组+链表
LinkedHashMap: LinkedHashMap 继承自 HashMap,所以它的底层仍然是基于拉链式散列结构即由数组和链表或红黑树组成。另外,LinkedHashMap 在上面结构的基础上,增加了一条双向链表,使得上面的结构可以保持键值对的插入顺序。同时通过对链表进行相应的操作,实现了访问顺序相关逻辑。
区别
ArrayList 和 Vector 的区别?
是否线程安全
ArrayList 与 LinkedList 区别?
ArrayList 底层使用的是 Object 数组;LinkedList 底层使用的是 双向链表 数据结构
我们在项目中一般是不会使用到
LinkedList的,需要用到LinkedList的场景几乎都可以使用ArrayList来代替,并且,性能通常会更好!不要下意识地认为
LinkedList作为链表就最适合元素增删的场景。我在上面也说了,LinkedList仅仅在头尾插入或者删除元素的时候时间复杂度近似 O(1),其他情况增删元素的时间复杂度都是 O(n) 。
HashMap 和 Hashtable 的区别
-
线程安全:因为
Hashtable内部的方法基本都经过synchronized修饰。(如果你要保证线程安全的话就使用ConcurrentHashMap吧!); -
效率: 因为线程安全的问题,
HashMap要比Hashtable效率高一点。另外,Hashtable基本被淘汰,不要在代码中使用它; -
对 Null key 和 Null value 的支持:
HashMap可以存储 null 的 key 和 value,但 null 作为键只能有一个,null 作为值可以有多个;Hashtable 不允许有 null 键和 null 值,否则会抛出NullPointerException。 -
底层数据结构:hashmap有优化成红黑树的机制,hashtable就是单纯的数组+链表。
ArrayList源码&扩容机制分析
数据结构
Object[] elementData; // 保存ArrayList数据的数组
扩容机制
构造方法
public ArrayList() {
    this.elementData = DEFAULTCAPACITY_EMPTY_ELEMENTDATA;
}
- 懒加载节省内存,未初始化elementData
add方法
public boolean add(E e) {
    // 确认elementData容量是否足够
    ensureCapacityInternal(size + 1);  // 第一次调用add()方法时,size=0
    elementData[size++] = e;
    return true;
}
先调用ensureCapacityInternal(int minCapacity) 方法,对数组容量进行检查,不够时则进行扩容。
private void ensureCapacityInternal(int minCapacity) {
    // 如果elementData为"{}"即第一次调用add(E e),重新定义minCapacity的值,赋值为DEFAULT_CAPACITY=10
    // 即第一次调用add(E e)方法时,定义底层数组elementData的长度为10
    if (elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA) {
        minCapacity = Math.max(DEFAULT_CAPACITY, minCapacity);
    }
    // 判断是否需要扩容
    ensureExplicitCapacity(minCapacity);
}
private void ensureExplicitCapacity(int minCapacity) {
    modCount++;

    // 第一次进入时,minCapacity=10,elementData.length=0,对数组进行扩容
    // 之后再进入时,minCapacity=size+1,elementData.length=10(每次扩容后会改变),
    // 需要minCapacity>elementData.length成立,才能扩容
    if (minCapacity - elementData.length > 0)
        grow(minCapacity);
}
grow(minCapacity) 对数组进行扩容,这是扩容的核心方法。
private void grow(int minCapacity) {
    // 将数组长度赋值给oldCapacity
    int oldCapacity = elementData.length;
    // 将oldCapacity右移一位再加上oldCapacity,即相当于newCapacity=1.5oldCapacity(不考虑精度损失)
    int newCapacity = oldCapacity + (oldCapacity >> 1);
    // 如果newCapacity还是小于minCapacity,直接将minCapacity赋值给newCapacity
    if (newCapacity - minCapacity < 0)
        newCapacity = minCapacity;
    // 特殊情况:newCapacity的值过大,直接将整型最大值赋给newCapacity,
    // 即newCapacity=Integer.MAX_VALUE
    if (newCapacity - MAX_ARRAY_SIZE > 0)
        newCapacity = hugeCapacity(minCapacity);
    // 将elementData的数据拷贝到扩容后的数组
    elementData = Arrays.copyOf(elementData, newCapacity);
}
结论
使用ArrayList()创建ArrayList对象时,不会定义底层数组的长度,当第一次调用add(E e) 方法时,初始化定义底层数组的长度为10,之后调用add(E e)时,如果需要扩容,则调用grow(int minCapacity) 进行扩容,长度为原来的1.5倍。
ConcurrentHashMap
线程安全的HashMap
-
1.8:Node 数组 + 链表 / 红黑树,锁粒度为Node数组索引头Node
-
1.7 :Segment 数组 + HashEntry 数组 + 链表,锁粒度为Segment
ConcurrentHashMap 1.8
存储结构
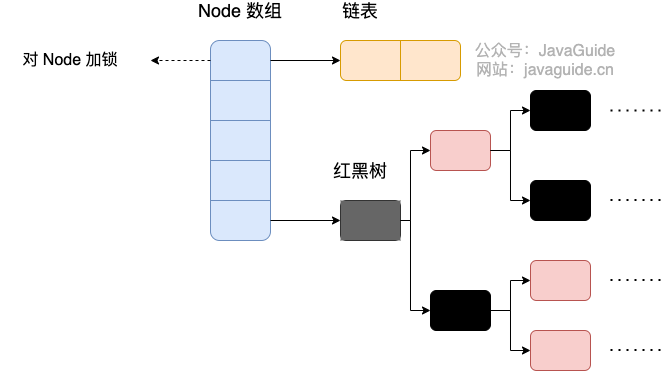
Node数组 + 链表 + 红黑树
初始化 initTable
/**
 * Initializes table, using the size recorded in sizeCtl.
 */
private final Node<K,V>[] initTable() {
    Node<K,V>[] tab; int sc;
    while ((tab = table) == null || tab.length == 0) {
        // 如果 sizeCtl < 0 ,说明另外的线程执行CAS 成功,正在进行初始化。
        if ((sc = sizeCtl) < 0)
            // 让出 CPU 使用权
            Thread.yield(); // lost initialization race; just spin
        else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) {
            try {
                if ((tab = table) == null || tab.length == 0) {
                    int n = (sc > 0) ? sc : DEFAULT_CAPACITY;
                    @SuppressWarnings("unchecked")
                    Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n];
                    table = tab = nt;
                    sc = n - (n >>> 2);
                }
            } finally {
                sizeCtl = sc;
            }
            break;
        }
    }
    return tab;
}
ConcurrentHashMap 的初始化是通过自旋和 CAS 操作完成的。里面需要注意的是变量 sizeCtl ,它的值决定着当前的初始化状态。
- -1 说明正在初始化
- -N 说明有N-1个线程正在进行扩容
- 表示 table 初始化大小,如果 table 没有初始化
- 表示 table 容量,如果 table 已经初始化。
put方法
-
根据 key 计算出 hashcode 。
-
判断是否需要进行初始化。
-
即为当前 key 定位出的 Node,如果为空表示当前位置可以写入数据,利用 CAS 尝试写入,失败则自旋保证成功。
-
如果当前位置的
hashcode == MOVED == -1,则需要进行扩容。 -
如果都不满足,则利用 synchronized 锁写入数据。
-
如果数量大于
TREEIFY_THRESHOLD则要执行树化方法,在treeifyBin中会首先判断当前数组长度≥64时才会将链表转换为红黑树。
public V put(K key, V value) {
    return putVal(key, value, false);
}

/** Implementation for put and putIfAbsent */
final V putVal(K key, V value, boolean onlyIfAbsent) {
    // key 和 value 不能为空
    if (key == null || value == null) throw new NullPointerException();
    int hash = spread(key.hashCode());
    int binCount = 0;
    for (Node<K,V>[] tab = table;;) {
        // f = 目标位置元素
        Node<K,V> f; int n, i, fh;// fh 后面存放目标位置的元素 hash 值
        if (tab == null || (n = tab.length) == 0)
            // 数组桶为空,初始化数组桶(自旋+CAS)
            tab = initTable();
        else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
            // 桶内为空,CAS 放入,不加锁,成功了就直接 break 跳出
            if (casTabAt(tab, i, null,new Node<K,V>(hash, key, value, null)))
                break;  // no lock when adding to empty bin
        }
        else if ((fh = f.hash) == MOVED)
            tab = helpTransfer(tab, f);
        else {
            V oldVal = null;
            // 使用 synchronized 加锁加入节点
            synchronized (f) {
                if (tabAt(tab, i) == f) {
                    // 说明是链表
                    if (fh >= 0) {
                        binCount = 1;
                        // 循环加入新的或者覆盖节点
                        for (Node<K,V> e = f;; ++binCount) {
                            K ek;
                            if (e.hash == hash &&
                                ((ek = e.key) == key ||
                                 (ek != null && key.equals(ek)))) {
                                oldVal = e.val;
                                if (!onlyIfAbsent)
                                    e.val = value;
                                break;
                            }
                            Node<K,V> pred = e;
                            if ((e = e.next) == null) {
                                pred.next = new Node<K,V>(hash, key,
                                                          value, null);
                                break;
                            }
                        }
                    }
                    else if (f instanceof TreeBin) {
                        // 红黑树
                        Node<K,V> p;
                        binCount = 2;
                        if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key,
                                                       value)) != null) {
                            oldVal = p.val;
                            if (!onlyIfAbsent)
                                p.val = value;
                        }
                    }
                }
            }
            if (binCount != 0) {
                if (binCount >= TREEIFY_THRESHOLD)
                    treeifyBin(tab, i);
                if (oldVal != null)
                    return oldVal;
                break;
            }
        }
    }
    addCount(1L, binCount);
    return null;
}
get方法
- 根据 hash 值计算位置。
- 查找到指定位置,如果头节点就是要找的,直接返回它的 value.
- 如果头节点 hash 值小于 0 ,说明正在扩容或者是红黑树,查找之。
- 如果是链表,遍历查找之。
ConcurrentHashMap 1.7
ConcurrentHashMap可以做到读取数据不加锁,并且内部的结构可以让其在进行写操作的时候能够将锁的粒度保持地尽量小,不用对整个ConcurrentHashMap加锁。
存储结构
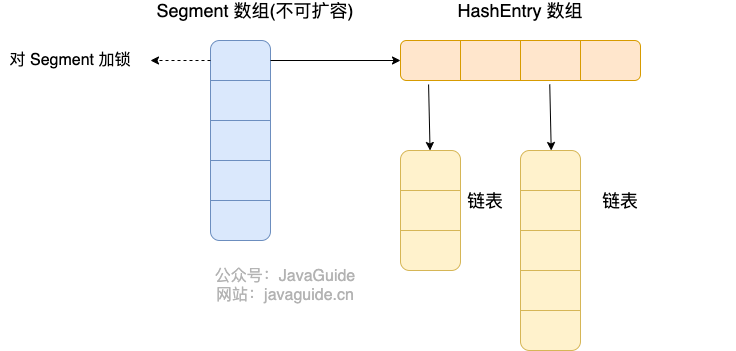
ConcurrnetHashMap 由很多个 Segment 组合,而每一个 Segment 是一个类似于 HashMap 的结构,所以每一个 HashMap 的内部可以进行扩容。但是 Segment 的个数一旦初始化就不能改变,默认 Segment 的个数是 16 个,你也可以认为 ConcurrentHashMap 默认支持最多 16 个线程并发。
put方法
每当对HashEntry数组的数据进行修改时,必须首先获得它对应的Segment锁.。
-
在put方法中,首先要加锁,如果获取锁失败就会通过自旋的方式阻塞保证能拿到锁.通过key的hash值来确定具体的链表头。
-
如果指定位置的
Segment为空,则CAS初始化这个Segment。 -
Segment.put插入 key,value 值。
final V put(K key, int hash, V value, boolean onlyIfAbsent) {
    // 获取 ReentrantLock 独占锁,获取不到,scanAndLockForPut 获取。
    HashEntry<K,V> node = tryLock() ? null : scanAndLockForPut(key, hash, value);
    V oldValue;
    try {
        HashEntry<K,V>[] tab = table;
        // 计算要put的数据位置
        int index = (tab.length - 1) & hash;
        // CAS 获取 index 坐标的值
        HashEntry<K,V> first = entryAt(tab, index);
        for (HashEntry<K,V> e = first;;) {
            if (e != null) {
                // 检查是否 key 已经存在,如果存在,则遍历链表寻找位置,找到后替换 value
                K k;
                if ((k = e.key) == key ||
                    (e.hash == hash && key.equals(k))) {
                    oldValue = e.value;
                    if (!onlyIfAbsent) {
                        e.value = value;
                        ++modCount;
                    }
                    break;
                }
                e = e.next;
            }
            else {
                // first 有值没说明 index 位置已经有值了,有冲突,链表头插法。
                if (node != null)
                    node.setNext(first);
                else
                    node = new HashEntry<K,V>(hash, key, value, first);
                int c = count + 1;
                // 容量大于扩容阀值,小于最大容量,进行扩容
                if (c > threshold && tab.length < MAXIMUM_CAPACITY)
                    rehash(node);
                else
                    // index 位置赋值 node,node 可能是一个元素,也可能是一个链表的表头
                    setEntryAt(tab, index, node);
                ++modCount;
                count = c;
                oldValue = null;
                break;
            }
        }
    } finally {
        unlock();
    }
    return oldValue;
}
由于 Segment 继承了 ReentrantLock,所以 Segment 内部可以很方便的获取锁,put 流程就用到了这个功能。
-
tryLock()获取锁,获取不到使用scanAndLockForPut方法继续获取。 -
计算 put 的数据要放入的 index 位置,然后获取这个位置上的
HashEntry。 -
遍历 put 新元素,为什么要遍历?因为这里获取的
HashEntry可能是一个空元素,也可能是链表已存在,所以要区别对待。(下面这个其实就是正常的put流程)如果这个位置上的
HashEntry不存在:- 如果当前容量大于扩容阀值,小于最大容量,进行扩容。
- 直接头插法插入。
如果这个位置上的
HashEntry存在:- 判断链表当前元素 key 和 hash 值是否和要 put 的 key 和 hash 值一致。一致则替换值
- 不一致,获取链表下一个节点,直到发现相同进行值替换,或者链表表里完毕没有相同的。
- 如果当前容量大于扩容阀值,小于最大容量,进行扩容。
- 直接链表头插法插入。
-
如果要插入的位置之前已经存在,替换后返回旧值,否则返回 null.
这里面的第一步中的 scanAndLockForPut 操作这里没有介绍,这个方法做的操作就是不断的自旋 tryLock() 获取锁。当自旋次数大于指定次数时,使用 lock() 阻塞获取锁。在自旋时顺表获取下 hash 位置的 HashEntry。
get方法
- 计算得到 key 的存放位置。
- 遍历指定位置查找相同 key 的 value 值。
public V get(Object key) {
    Segment<K,V> s; // manually integrate access methods to reduce overhead
    HashEntry<K,V>[] tab;
    int h = hash(key);
    long u = (((h >>> segmentShift) & segmentMask) << SSHIFT) + SBASE;
    // 计算得到 key 的存放位置
    if ((s = (Segment<K,V>)UNSAFE.getObjectVolatile(segments, u)) != null &&
        (tab = s.table) != null) {
        for (HashEntry<K,V> e = (HashEntry<K,V>) UNSAFE.getObjectVolatile
                 (tab, ((long)(((tab.length - 1) & h)) << TSHIFT) + TBASE);
             e != null; e = e.next) {
            // 如果是链表,遍历查找到相同 key 的 value。
            K k;
            if ((k = e.key) == key || (e.hash == h && key.equals(k)))
                return e.value;
        }
    }
    return null;
}
总结
Java7 中 ConcurrentHashMap 使用的分段锁,也就是每一个 Segment 上同时只有一个线程可以操作,每一个 Segment 都是一个类似 HashMap 数组的结构,它可以扩容,它的冲突会转化为链表。但是 Segment 的个数一但初始化就不能改变。ReentrantLock。
Java8 中的 ConcurrentHashMap 使用的 Synchronized 锁加 CAS 的机制。结构也由 Java7 中的 Segment 数组 + HashEntry 数组 + 链表 进化成了 Node 数组 + 链表 / 红黑树,Node 是类似于一个 HashEntry 的结构。它的冲突再达到一定大小时会转化成红黑树,在冲突小于一定数量时又退回链表。
有些同学可能对 Synchronized 的性能存在疑问,其实 Synchronized 锁自从引入锁升级策略后,性能不再是问题,有兴趣的同学可以自己了解下 Synchronized 的锁升级。
参考自Java集合

 浙公网安备 33010602011771号