
第一次个人编程作业
Github 仓库:https://github.com/irving-code/irving-code/tree/main/3124004096
第一次个人编程作业
一、作业信息
| 项目 | 内容 |
|---|---|
| 作业名称 | 论文查重程序 |
| 项目类型 | 个人编程作业 |
| 开发语言 | Python 3.10+ |
| 开发环境 | Windows + Python |
| 课程链接 | https://edu.cnblogs.com/campus/gdgy/Class56-Grade2024-CS |
| 作业链接 | https://edu.cnblogs.com/campus/gdgy/Class56-Grade2024-CS/homework/15693 |
| 作业目标 | 实现一个简单的论文查重系统 |
| 项目仓库 | https://github.com/irving-code/irving-code/tree/main/3124004096 |
| 学号目录 | 3124004096/ |
| 核心算法 | 基于词频向量的余弦相似度 |
| 第三方依赖 | 无 |
项目文件结构如下:
3124004096/
├── main.py
├── test_main.py
├── requirements.txt
├── performance_analysis.py
├── reports/
└── data/
    ├── original.txt
    └── plagiarized.txt
二、PSP 表格
开发开始前记录预估耗时,项目完成后在文末附录记录实际耗时,时间单位统一为分钟。
| PSP2.1 Personal Software Process Stages | 预估耗时(分钟) |
|---|---|
| Planning / 计划 | |
| · Estimate / 估计这个任务需要多少时间 | 30 |
| Development / 开发 | |
| · Analysis / 需求分析(包括学习新技术) | 60 |
| · Design Spec / 生成设计文档 | 45 |
| · Design Review / 设计复审 | 15 |
| · Coding Standard / 代码规范 | 15 |
| · Design / 具体设计 | 45 |
| · Coding / 具体编码 | 180 |
| · Code Review / 代码复审 | 30 |
| · Test / 测试(自我测试、修改代码、提交修改) | 90 |
| Reporting / 报告 | |
| · Test Report / 测试报告 | 30 |
| · Size Measurement / 计算工作量 | 30 |
| · Postmortem & Process Improvement Plan / 事后总结并提出过程改进计划 | 60 |
| · 合计 | 630 |
三、需求分析
本项目需要实现一个命令行论文查重程序。程序接收三项参数:
原文文件 抄袭文件 结果文件
程序读取原文和待检测文本,计算两份文本的相似度,并将结果写入指定文件,结果保留两位小数。
基本功能要求:
- 能够读取文本文件。
- 能够处理中文、英文和数字。
- 能够计算两份文本的相似度。
- 能够将结果写入文件。
- 能够处理参数错误、文件不存在、编码错误和输出覆盖输入等异常。
- 能够通过至少 10 个单元测试,并提供分支覆盖率报告。
- 能够使用代码质量工具检查且无警告。
- 能够进行性能分析并完成一次计算模块优化。
四、总体设计
程序主要分为四个部分:
命令行参数
      ↓
文件读取
      ↓
文本清洗与词元提取
      ↓
词频统计与余弦相似度计算
      ↓
结果写入文件
对应的函数如下:
| 函数 | 功能 |
|---|---|
read_text |
读取文本文件 |
tokenize |
提取中文、英文和数字 |
similarity |
计算两个文本的相似度 |
compare_files |
完成文件级别的查重 |
main |
处理命令行参数和异常 |
本项目没有使用第三方库,主要原因是该需求使用 Python 标准库即可完成。这样可以减少环境配置问题,也方便项目在其他电脑上运行。
五、算法设计
5.1 文本预处理
程序使用正则表达式提取有效内容:
re.findall(r"[\u4e00-\u9fff]|[A-Za-z0-9]+", text.lower())
处理规则如下:
- 中文按单个汉字提取;
- 英文连续字符作为一个词;
- 数字连续字符作为一个词;
- 标点符号和空白字符被忽略;
- 英文统一转换为小写。
中文按单字处理,是为了避免中文分词依赖第三方库。计算时使用相邻词元二元组,使局部顺序和增删改能够影响结果,避免只统计单字频次导致顺序完全打乱仍被判为高度相似。
5.2 词频向量
使用 Counter 统计相邻词元二元组的出现次数。例如:
文本:Python 编程 Python
二元组:Python-编程、编程-Python
两个文本会分别转换为二元组词频向量;只有单字符短文本退化为一元词频。
5.3 余弦相似度
余弦相似度公式为:
similarity = A·B / (|A| × |B|)
其中:
A和B是两个文本的词频向量;A·B是两个向量的点积;|A|和|B|是向量的模长。
余弦相似度的取值范围为 0 到 1:
1.00表示两个文本完全相同;0.00表示两个文本没有共同词元;- 越接近
1,说明文本越相似。
如果任意一个文本为空,程序直接返回 0.0,避免出现除零错误。
六、核心代码
6.1 文本读取
def read_text(path: str | Path) -> str:
    """Read a text file, accepting the common UTF-8/GB18030 encodings."""
    file_path = Path(path)
    for encoding in ("utf-8-sig", "gb18030"):
        try:
            return file_path.read_text(encoding=encoding)
        except UnicodeDecodeError:
            continue
    raise UnicodeError(f"无法解析文件编码: {file_path}")
程序优先使用 UTF-8 读取。如果读取失败,则尝试使用 GB18030,增强了对中文文本文件的兼容性。
6.2 文本处理
def tokenize(text: str) -> list[str]:
    """Keep Chinese characters and English/numeric words."""
    return TOKEN_PATTERN.findall(text.lower())

def feature_counts(text: str) -> Counter[str | tuple[str, str]]:
    tokens = tokenize(text)
    if len(tokens) < 2:
        return Counter(tokens)
    return Counter(zip(tokens, tokens[1:]))
6.3 相似度计算
def similarity(text_a: str, text_b: str) -> float:
    vector_a = feature_counts(text_a)
    vector_b = feature_counts(text_b)
    if not vector_a or not vector_b:
        return 0.0

    if len(vector_a) > len(vector_b):
        vector_a, vector_b = vector_b, vector_a
    dot = sum(count * vector_b.get(token, 0) for token, count in vector_a.items())
    norm_a = math.sqrt(sum(value * value for value in vector_a.values()))
    norm_b = math.sqrt(sum(value * value for value in vector_b.values()))
    return dot / (norm_a * norm_b)
程序遍历较小词频表计算点积,避免创建额外的共同特征集合。
6.4 命令行入口
def main(argv: list[str] | None = None) -> int:
    args = sys.argv[1:] if argv is None else argv
    if len(args) != 3:
        print("用法: python main.py 原文文件 抄袭文件 结果文件", file=sys.stderr)
        return 2

    try:
        compare_files(*args)
    except (OSError, UnicodeError) as error:
        print(f"错误: {error}", file=sys.stderr)
        return 1
    return 0
参数数量错误时返回 2;文件读取、编码或写入失败时返回 1,正常运行返回 0。
七、程序运行
进入学号目录后,使用三个绝对路径运行:
python main.py E:\软件工程\irving-code\3124004096\data\original.txt E:\软件工程\irving-code\3124004096\data\plagiarized.txt E:\软件工程\irving-code\3124004096\answer.txt
示例原文:
人工智能正在改变软件开发方式,程序员需要持续学习新的工具和方法。
示例待检测文本:
软件开发方式正在被人工智能改变,程序员也需要不断学习新的工具和方法。
运行后生成的 answer.txt 内容为:
0.70
这个结果说明两段文字包含较多相同的局部二元组,同时语序调整也降低了相似度。
八、单元测试
8.1 测试方法与数据设计
测试采用 Python 内置 unittest 自动运行,并使用白盒方法覆盖主要判断分支:空向量、短文本退化、向量交换、参数数量错误、读取失败、写入失败以及答案覆盖输入保护。同时结合等价类和边界值,构造相同文本、无关文本、增删改文本、乱序文本、空文本、单字符、英文大小写、标点、UTF-8 BOM、GB18030 和非法编码等数据。
部分测试代码:
def test_modified_assignment_sample_is_partial_match(self):
    score = similarity(
        "今天是星期天,天气晴,今天晚上我要去看电影。",
        "今天是周天,天气晴朗,我晚上要去看电影。",
    )
    self.assertGreater(score, 0.5)
    self.assertLess(score, 1.0)

def test_output_cannot_overwrite_input(self):
    self.assertEqual(main([str(original), str(candidate), str(original)]), 1)
    self.assertEqual(original.read_text(encoding="utf-8"), "原文")
8.2 测试结果
python -m unittest -v
实际结果:
Ran 19 tests in 0.101s

OK
19 个用例覆盖 read_text、tokenize、feature_counts、similarity、compare_files 和 main。完整输出保存在 reports/unit-tests.txt。
8.3 分支覆盖率
执行命令:
$env:COVERAGE_FILE = Join-Path $env:TEMP '3124004096.coverage'
python -m coverage run --branch --source=main -m unittest -v
python -m coverage report -m
python -m coverage html
最终总覆盖率为 97%,其中语句覆盖率 98%,分支覆盖率 94%。
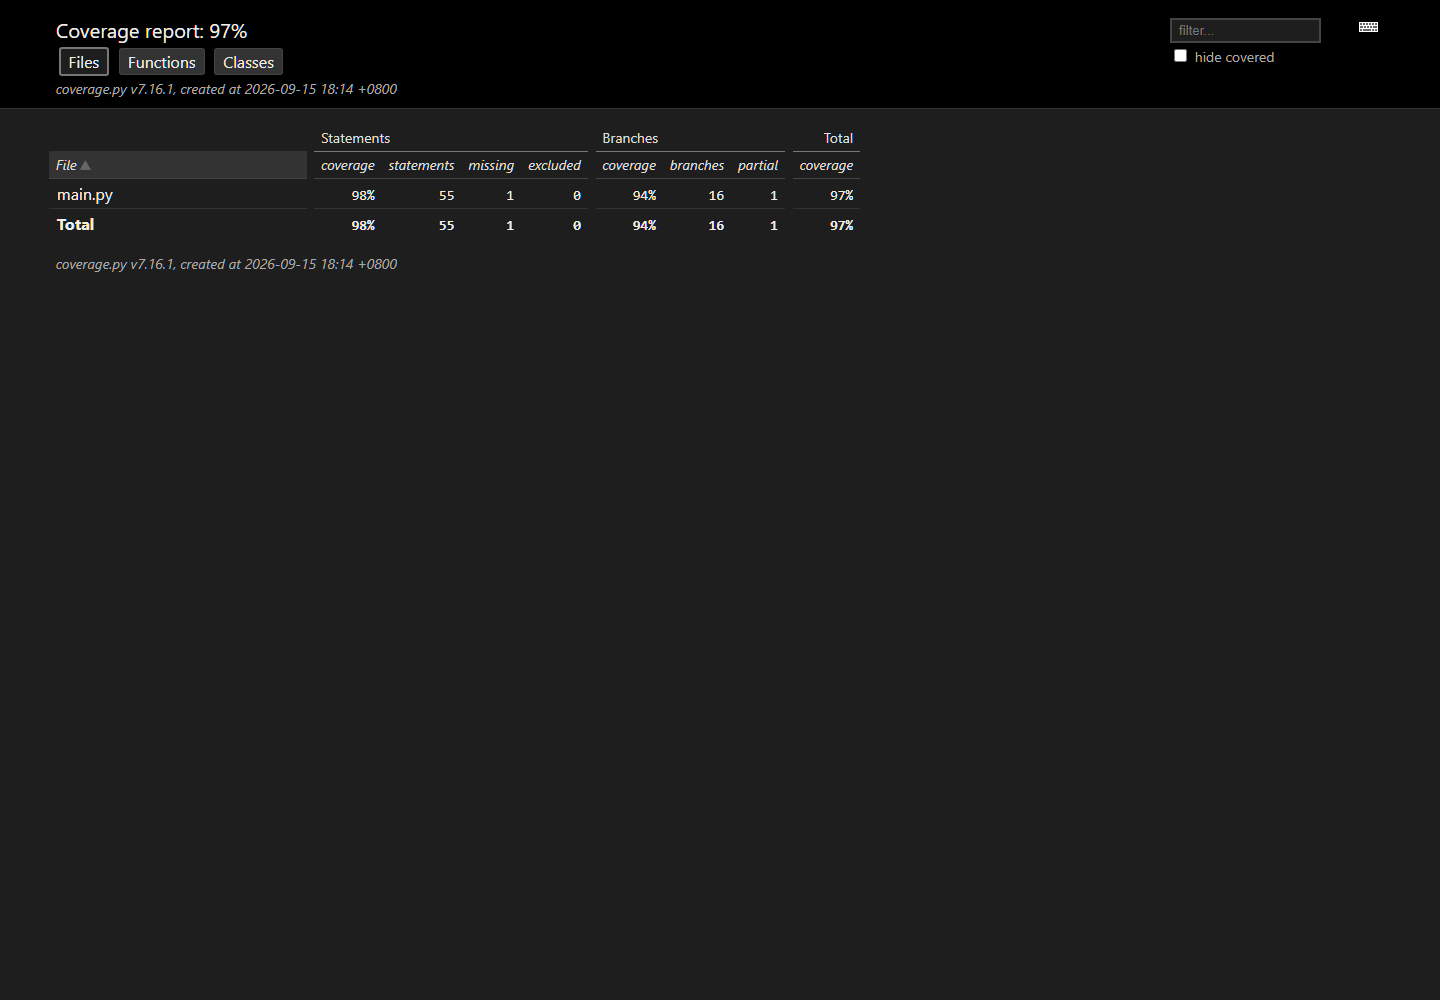
测试覆盖了全部核心计算和主要异常路径,足以作为当前版本的自动回归测试。未覆盖的一行是脚本入口的 raise SystemExit(main()),其内部 main 已被直接测试。
九、异常处理
程序把参数错误与输入输出错误统一转换为明确的标准错误信息和非零退出码,避免出现未处理异常。各异常类别、目标、场景和测试如下:
| 异常类别 | 设计目标 | 错误场景 | 对应测试 |
|---|---|---|---|
| 参数数量错误 | 在访问参数前终止并输出用法,返回 2 |
少传或多传路径 | test_main_rejects_wrong_argument_count |
OSError 读取错误 |
文件不存在或不可读时返回 1 |
路径拼写错误 | test_main_reports_missing_input |
UnicodeError |
两种编码都无法解析时拒绝错误内容 | 输入为非法字节 | test_read_text_rejects_unknown_encoding |
OSError 写入错误 |
目标为目录或不可写时返回 1 |
把目录作为答案文件 | test_directory_cannot_be_used_as_output_file |
| 输出覆盖保护 | 写入前阻止答案路径指向输入 | 答案和原文使用同一路径 | test_output_cannot_overwrite_input |
异常测试示例:
def test_read_text_rejects_unknown_encoding(self):
    path.write_bytes(b"\x81\x30\x81")
    with self.assertRaises(UnicodeError):
        read_text(path)

def test_main_reports_missing_input(self):
    self.assertEqual(main(["missing.txt", "also-missing.txt", "answer.txt"]), 1)
十、性能分析
10.1 性能瓶颈
使用 Python 内置 cProfile 采集性能数据,用 SnakeViz 展示调用关系。为避免短样例的模块加载时间干扰,基准生成两份各 5 万词元的文本并重复运行 20 次:
python -m cProfile -o reports/performance.prof performance_analysis.py --profile
python -m snakeviz reports/performance.prof
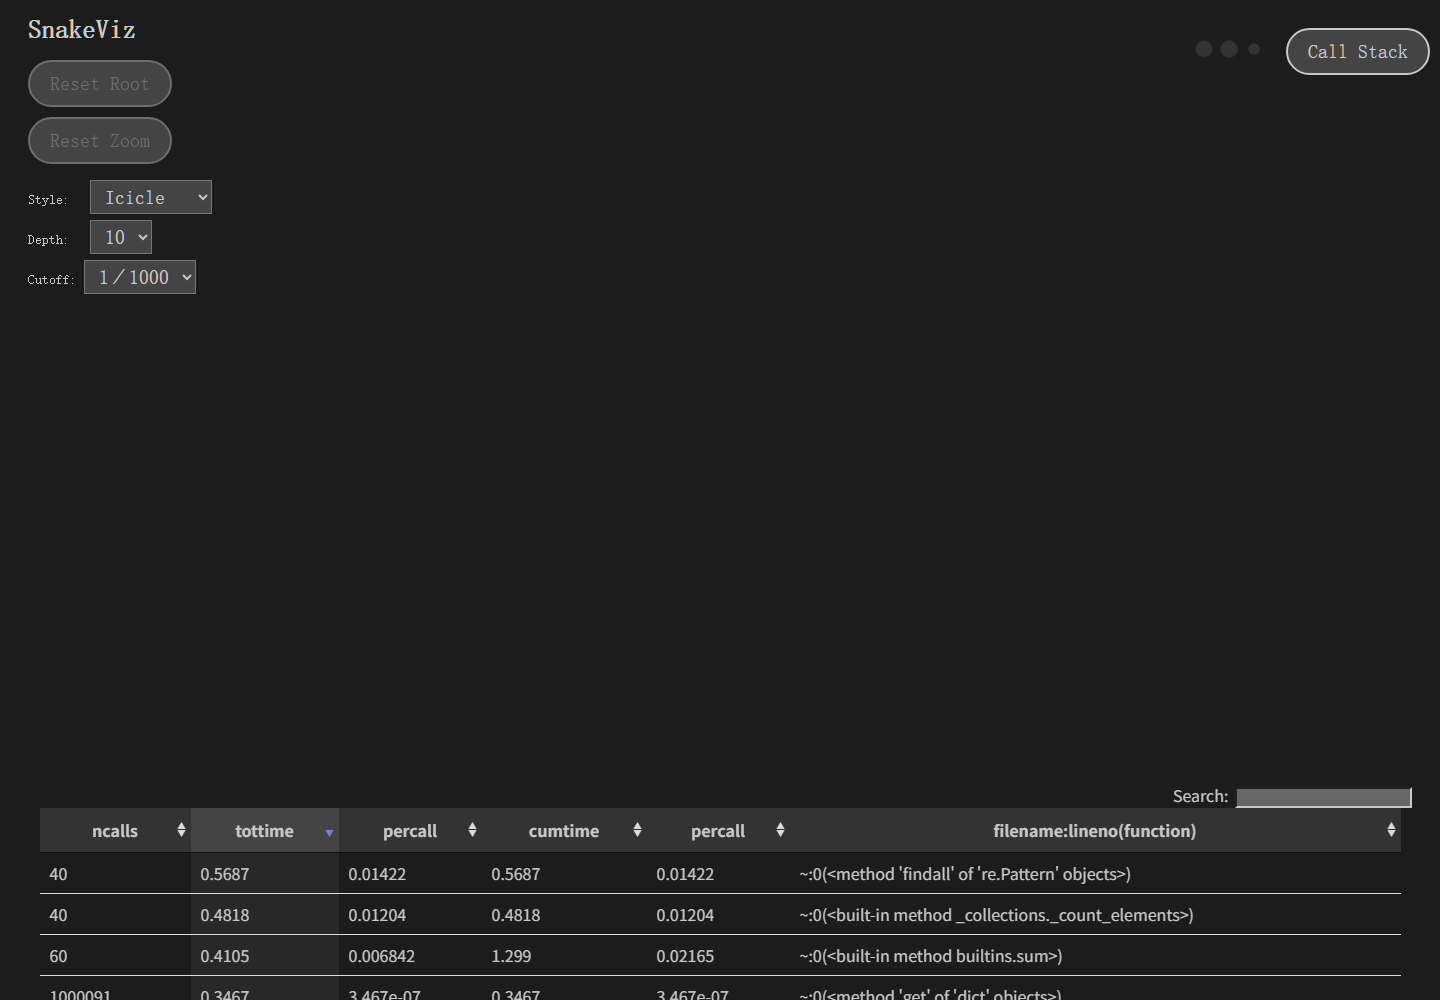
分析得到计算模块 similarity 的累计耗时为 2.501s;业务函数中 feature_counts 累计耗时 1.195s。具体底层热点是正则 findall,自身耗时 0.569s,其次是 Counter 使用的 _count_elements,自身耗时 0.482s。完整排序保存在 reports/performance-top.txt。
10.2 改进思路与结果
初版先构造 set(vector_a) & set(vector_b),产生一个额外的共同特征集合。改进后交换两个词频表,直接遍历较小表并用 dict.get 查询另一表,省去共同集合的分配,也减少不必要遍历。
运行 python performance_analysis.py,对同一数据各运行 10 次:
before: 1.374s
after:  0.777s
improvement: 43.4%
本次性能分析和改进共花费约 30 分钟。基准会受机器状态影响,但两个实现使用同一数据、同一进程和相同重复次数,适合比较本次局部优化。
算法复杂度仍为线性:
- 文本读取:
O(n + m) - 正则提取:
O(n + m) - 词频统计:
O(n + m) - 点积与模长计算:平均情况下接近
O(k)
其中 n、m 是两份文本长度,k 是词汇表大小。因此整体时间复杂度约为:
O(n + m)
空间复杂度主要来自两个二元组词频字典,约为:
O(n + m)
十一、代码质量分析
使用 Ruff 对 Python 源码进行静态分析:
ruff check --no-cache .
最终结果:
All checks passed!
检查过程中曾发现 performance_analysis.py 有一个未使用的 Counter 导入,删除后再次检查为零警告。结果保存在 reports/code-quality.txt。
十二、Git 使用记录
项目按照功能阶段进行提交,实际提交记录如下:
decc4da chore: initialize plagiarism checker project
6edded2 feat: add text reading and tokenization
b80e45f feat: calculate cosine similarity
ebaf117 feat: add CLI and input error handling
710d84f test: cover similarity and file output
d9f39cb docs: add project README and development blog
ff35b48 docs: revise PSP 2.1 time table
182bbe8 feat: organize assignment under student ID
当前提交:docs: complete assignment reports and blog(哈希以 git log 为准)
这样的提交方式能够反映项目从需求分析到功能实现、再到测试完善的过程,也方便后续定位问题。
十三、项目总结
本项目完成了一个基础的论文查重程序,实现了文本读取、文本预处理、词频统计、余弦相似度计算、结果写入、异常处理和单元测试。
项目的优点:
- 结构简单,容易理解和运行;
- 不依赖第三方库;
- 对中文文本有基本处理能力;
- 对常见输入错误进行了处理;
- 使用单元测试验证了核心功能;
- 具有线性的基本时间复杂度。
项目的不足:
- 中文按单字处理,语义理解能力有限;
- 没有识别同义词和近义表达;
- 没有删除停用词;
- 对大规模论文集合的批量查重支持不足;
- 余弦相似度只能反映词汇重合,不能完全代表语义相似。
后续可以从以下方向改进:
- 使用专业中文分词工具;
- 增加停用词表;
- 引入 TF-IDF 权重;
- 使用 SimHash 进行大规模文本指纹比较;
- 使用词向量或句向量进行语义相似度计算;
- 增加批量文件检测和图形化界面。
通过这次作业,我进一步熟悉了 Python 文件处理、正则表达式、字典统计、向量计算、单元测试、性能分析和 Git 项目管理流程。相比只完成一个能运行的程序,测试和文档让我更清楚地认识到,一个完整项目还需要考虑输入边界、可维护性和可复现性。
附录:PSP 表格(完成后)
| PSP2.1 Personal Software Process Stages | 实际耗时(分钟) |
|---|---|
| Planning / 计划 | |
| · Estimate / 估计这个任务需要多少时间 | 20 |
| Development / 开发 | |
| · Analysis / 需求分析(包括学习新技术) | 30 |
| · Design Spec / 生成设计文档 | 30 |
| · Design Review / 设计复审 | 10 |
| · Coding Standard / 代码规范 | 10 |
| · Design / 具体设计 | 30 |
| · Coding / 具体编码 | 120 |
| · Code Review / 代码复审 | 20 |
| · Test / 测试(自我测试、修改代码、提交修改) | 60 |
| Reporting / 报告 | |
| · Test Report / 测试报告 | 20 |
| · Size Measurement / 计算工作量 | 15 |
| · Postmortem & Process Improvement Plan / 事后总结并提出过程改进计划 | 55 |
| · 合计 | 420 |

 浙公网安备 33010602011771号