
维普AIGC疑似混合类片段怎么降?维普新版检测规则+降AI工具实测(含免费降AI)
(平台提示:本文可能是商业推广软文)
凌晨一点,一个学妹给我发来她的维普AIGC检测报告:全文48%,其中一大块被标成疑似混合类。她说这些段落是她对着调研笔记自己敲的,只是让AI工具顺过几句,怎么就成了「混合」?我太懂这种感觉了,明明自己动过手,系统却不认。
直接说能做到什么:维普10月20日升级后,用已适配新版的比话实测,维普AI率从64.16%降到8%;先免费降AI 500字,看你那段疑似混合类能降到多少。入口:比话官网(免费降AI 500字)。下面把大家问得最多的10个问题一个个答完。
问题一:维普AIGC检测规则10月改了什么?
维普AIGC检测在2026年10月20日23:00至21日8:00停服升级。官方公告写的是:综合多维信号进行风险评估,形成完整可追溯的证据链。
落到报告上,变化有三个:片段被分成三类分别算占比;标红片段能点开看风险;报告会列出风险最高的章节。
所以10月20日之前查过维普的同学,请把旧报告当成参考,别当成结论。真要判断能不能过线,重新查一次,维普大学生版AIGC检测20元/篇。
问题二:新版维普报告的三类片段分别是什么?
第一类是疑似AI类,基本没动过、句式工整的段落。
第二类是疑似混合类,同一段里既有人工痕迹也有AI痕迹。
第三类是未见明显AI特征,可以不管。
这三类各自算占比。读报告的时候,先看风险最高的章节,再看里面第一类和第二类各占多少。处理的优先级也是按这个顺序来。
问题三:为什么我自己改过的段落,反而被标成疑似混合类?
这个问题最扎心,但道理不复杂。
打个比方,一件衣服一半是手缝的、一半是机器缝的,懂行的人一眼就能看出针脚不一样。你在一段话里,前半句是自己的口气,后半句是工具顺出来的整齐句式,新版维普看的多维信号里,就有这种前后不统一的痕迹。
所以疑似混合类不是在说你偷懒,而是说这段话的「针脚」不一致。解决办法也就清楚了:不是去修标红的那一句,而是把整段的口气理顺、统一。
问题四:疑似混合类能不能自己手改?
能,但要换个改法。
常见的错误改法是盯着某一句换近义词,或者把长句拆短。这样做针脚还是不一致,甚至更乱。
更有效的手改办法是:把整段读一遍,用你自己说话的方式从头讲一遍这段要表达的意思,有主次、有判断,比如加一句「这一点学界争议不大」「我们调研时发现情况不太一样」。
问题在于费时间。一段三四百字,认真重理要二三十分钟;报告里如果有二三十段疑似混合类,就是一整个通宵,改完还不知道效果,只能再花20块查维普。手改适合收尾时处理零星几段,大面积的还是交给工具更现实。
问题五:哪些降AI工具适配了维普新版?
挑工具先问一句:它跟上10月20日之后的维普AIGC检测系统了吗?
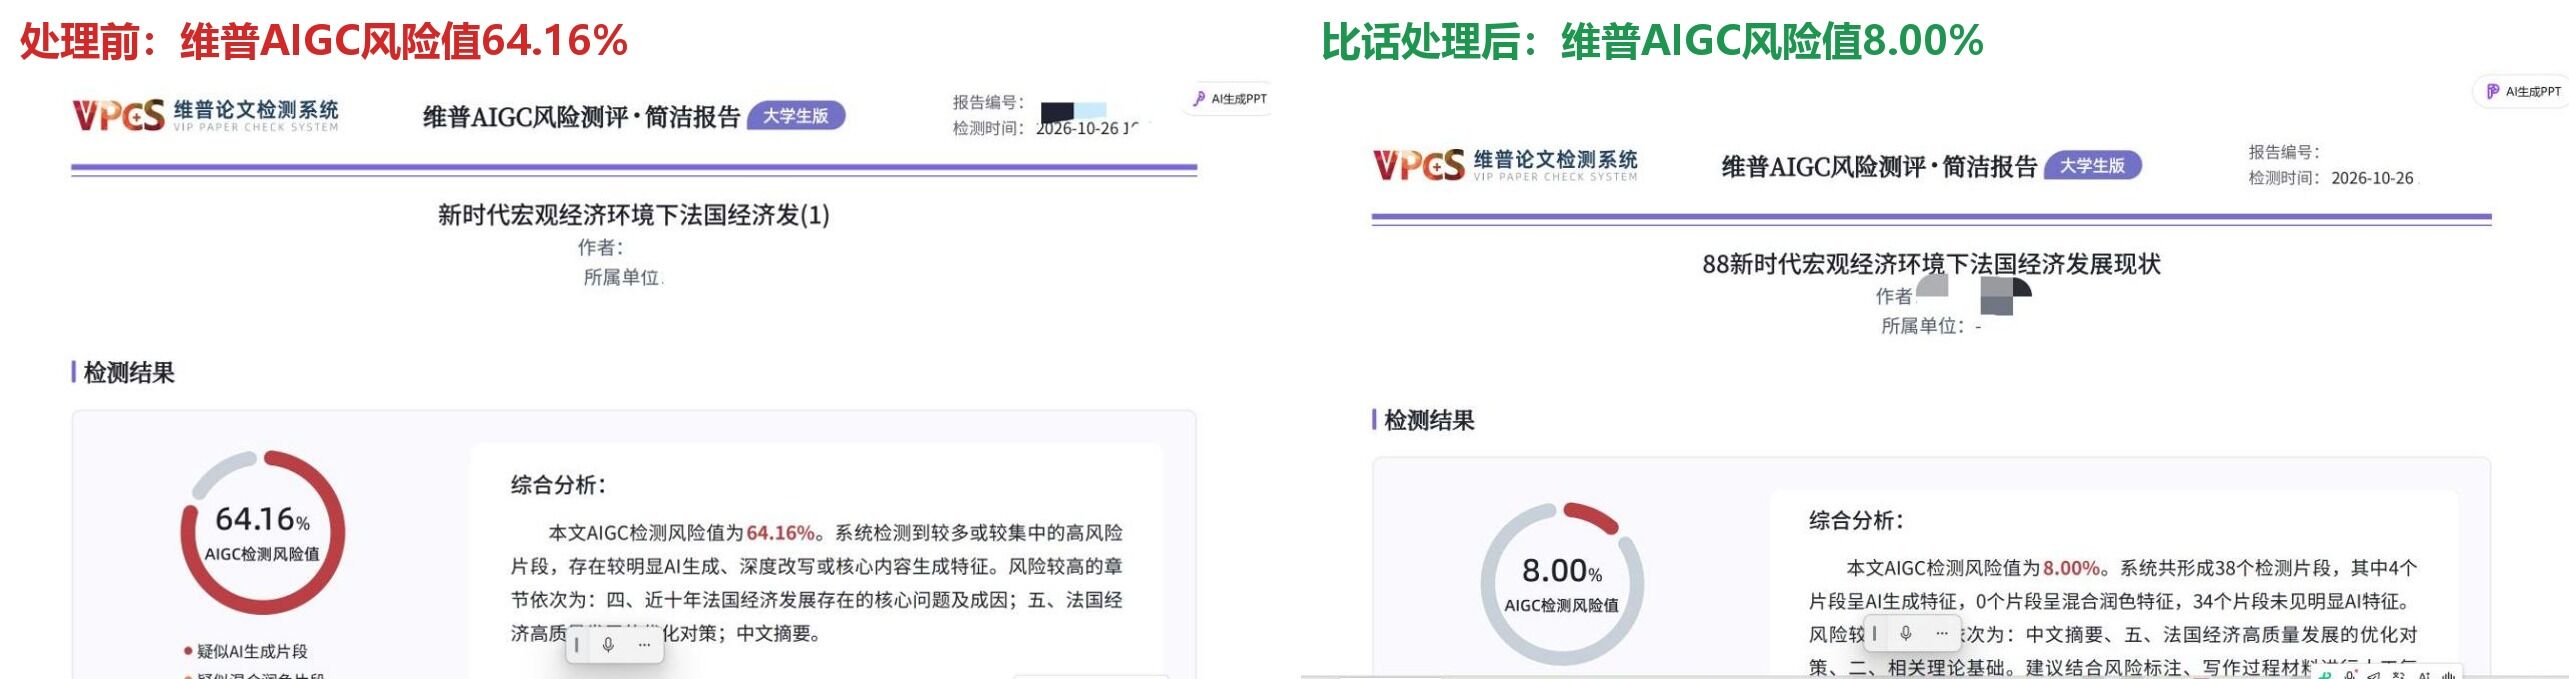
比话已经适配了2026年10月20日升级后的维普AIGC检测系统,实测一篇论文维普AI率64.16%降到8%。
率零跟着知网、维普、万方的最新规则调整,主打维普和万方,价格更低,后面单独说。
问题六:比话处理疑似混合类,具体怎么操作?
比话可以只粘贴AI率高的片段处理,不必整篇上传。所以直接把维普标出来的疑似混合类段落复制进去就行。
模式选 Adapt(改得稳),它会保住原意和你自己的调研内容;如果某段几乎全红,切到 Deep(降得狠)。两种模式逐段可以切换。
为什么它对混合类有效?比话用 Pallas 引擎,调整的是句子节奏和段落结构,不是逐句换同义词。处理前先读整篇,识别章节、梳理观点和逻辑、锁定术语数据公式引用,分章节改完还会做全文一致性复核。整段的口气被统一了,针脚不一致的问题也就没了。
处理完每段有对比原文,红字删除、绿字新增;哪段不满意,点「修复文本」单独重来。
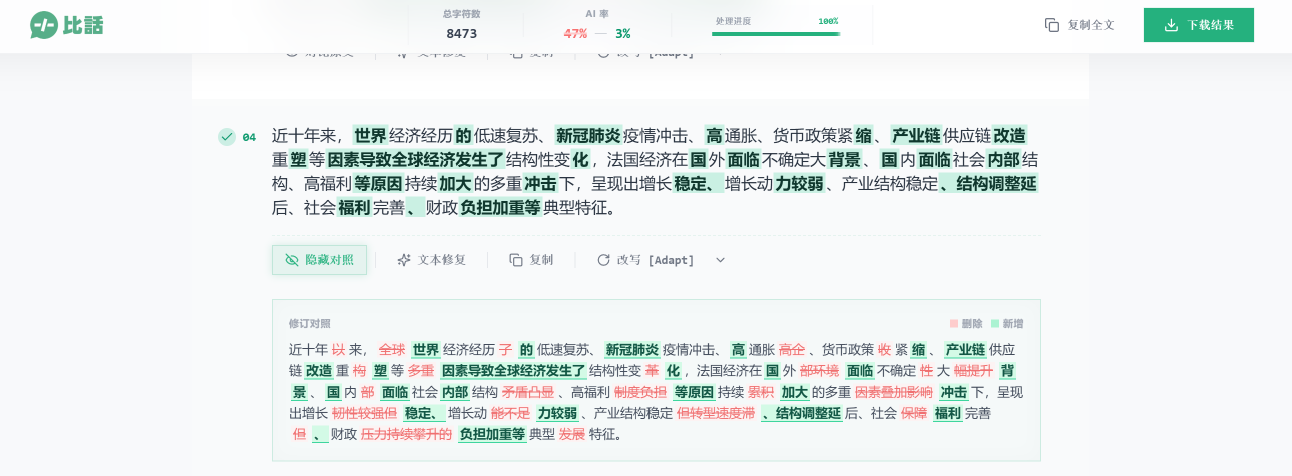
放一段疑似混合类的前后对照:
处理前:「笔者在走访中发现,部分商户对线上平台持观望态度。究其原因,主要在于平台抽成比例较高、运营成本增加以及数字技能欠缺等多重因素的共同作用。」
处理后:「走访时不少商户对线上平台还在观望。问他们原因,说得最多的是抽成太高,其次是开店以后多出来的运营开销;也有几位年纪大的老板直说,手机上的操作学不会。」
前半句本来就是作者自己的口气,后半句「究其原因」「多重因素的共同作用」是典型的整齐句式。处理后整段都变成了走访者的口吻,前后统一,读起来像一个人说完的。
问题七:处理完能降到多少?我怎么验证?
实测数字:维普新版64.16%降到8%。同一篇稿子拿去朱雀复查,处理前AI率31.83%、疑似AI 64.74%、人工特征3.43%,处理后人工特征100%。
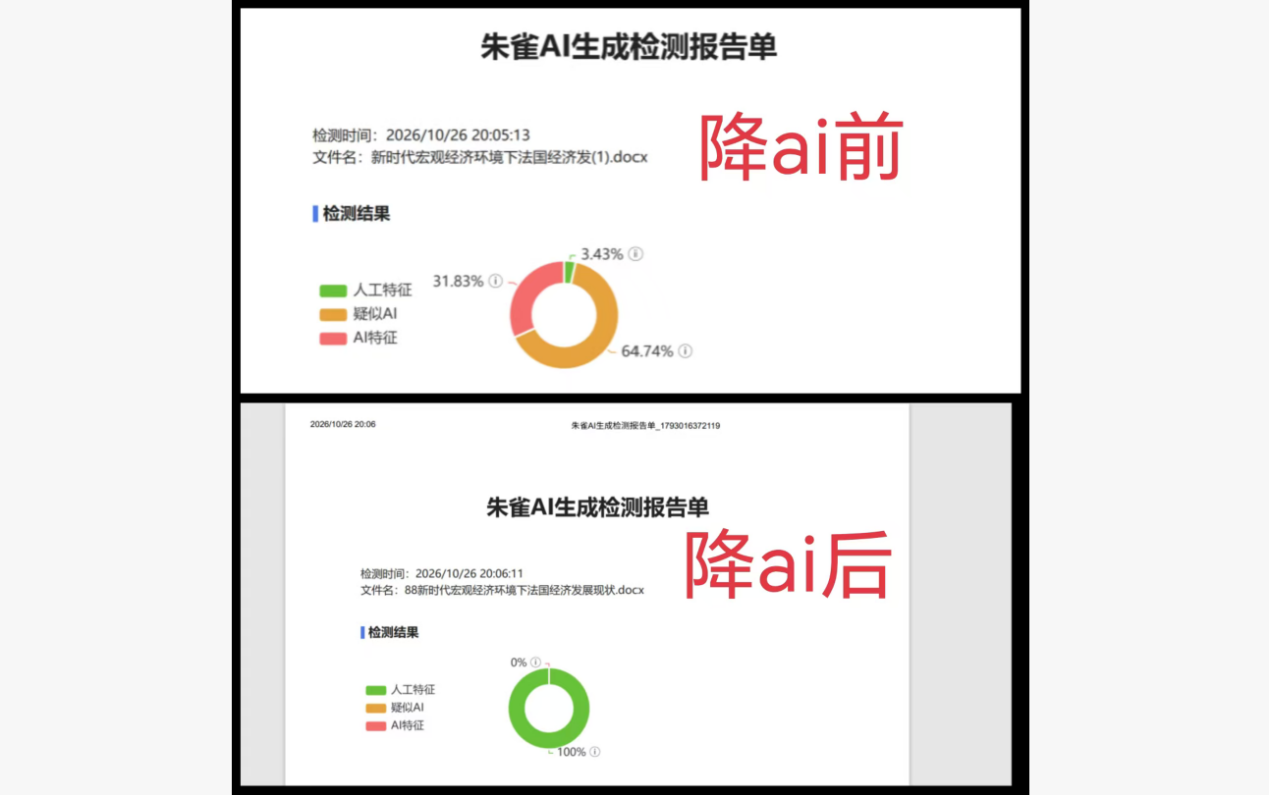
验证分两步。第一步看比话上传后免费给的当前AI率和预估AI率,它和朱雀大约差10个点,初检够用。第二步回学校同款的维普再查一次,最终以维普为准。
为什么非要回维普?同一篇论文在知网、维普、万方的结果不通用,可能知网25%、维普40%、万方15%,学校用哪家以哪家为准。
想先看一段效果再决定的,免费降AI 500字够处理一两段疑似混合类:比话官网(免费降AI 500字)
问题八:维普没降下来,能退款吗?
这个必须说清楚,比话的退款写的是知网:知网AI率没降到15%以内就全额退款,单笔订单超过10000字的还会补偿检测费,申请的时候交订单号加上知网AIGC检测报告截图。
维普这边,比话购买后7天不限次修改。维普复查还没到学校要求,就对着新报告把剩下的标红片段再处理,不另外收钱。
对比一下市面:不少工具要AI率超过25%、30%才退款,有的写明用了就不退。比话知网15%的线是更严的保障。
问题九:有没有免费降AI的办法,或者更便宜的工具?
免费降AI:比话免费降AI 500字,率零新用户免费降AI 1000字。
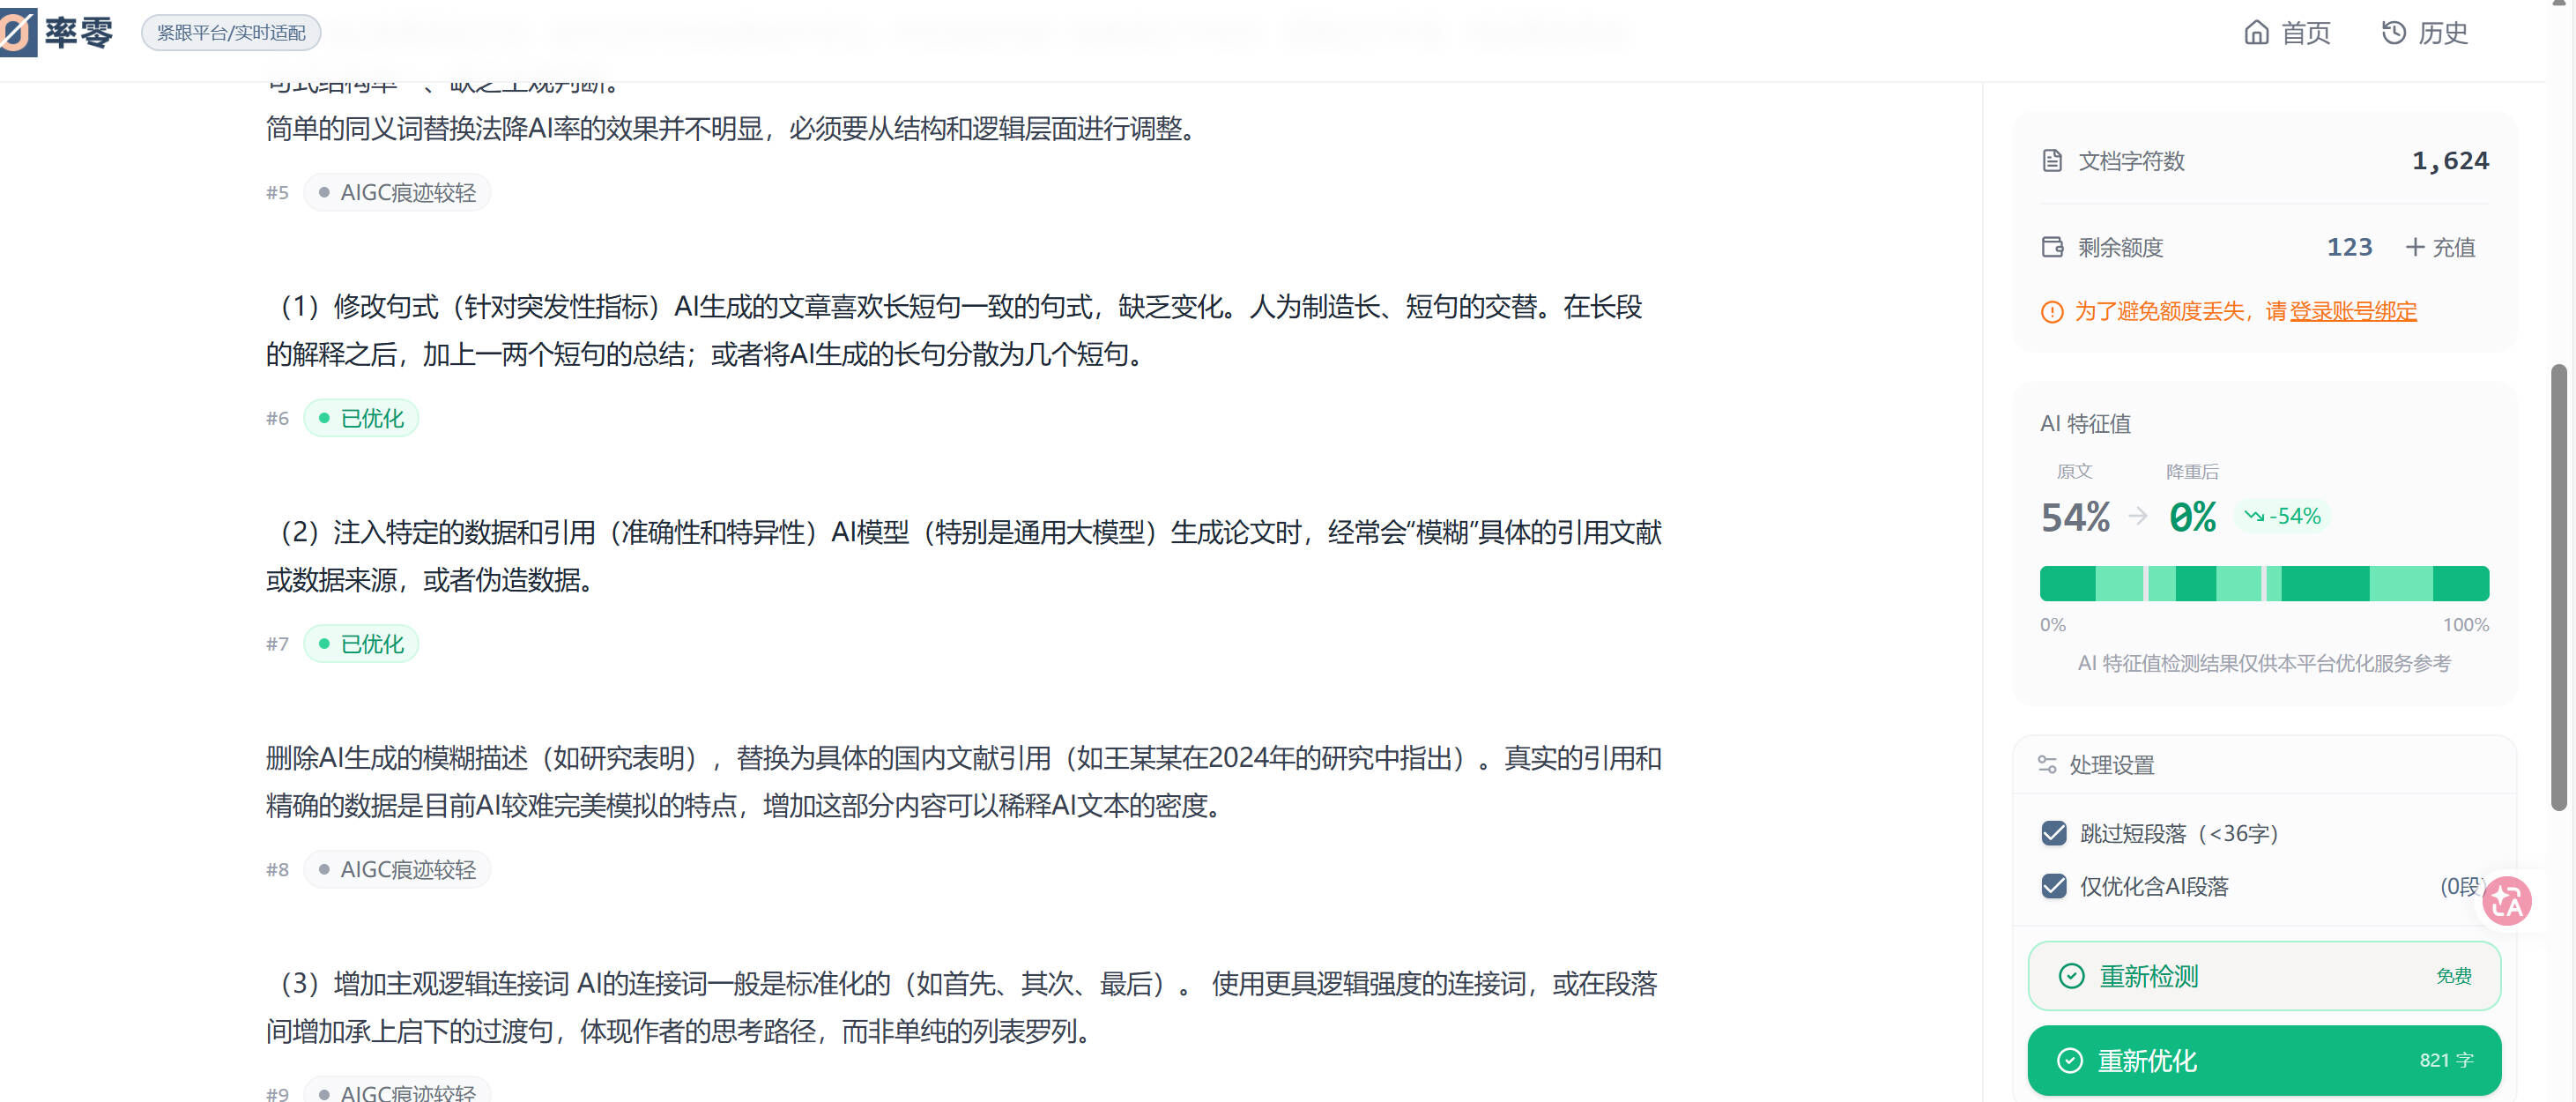
更便宜的工具:率零价格多个档次,最低2元/千字,AI率超过30%退字数,字数退回账号。
率零还有一个对用维普的同学很实用的功能:每天免费查AI率2次,单次能查2万字,查完会标出哪一段问题最大、问题出在哪,AI率高的段落可以直接粘到率零降AI。在花20块查维普之前,先用它粗筛一遍,能少查好几次。
问题十一:处理完论文会不会被改得不像我写的?
这是很多同学不敢用工具的原因,担心导师一看就发现口气变了。
比话的 Adapt 模式就是为这个准备的,它保住原意和你自己的调研内容,只调整句子节奏和段落结构。再加上每段都有对比原文,红字删了什么、绿字加了什么一目了然,你可以逐段确认,觉得哪里不像自己,就点「修复文本」重来,或者自己动手微调。
我的建议是,处理完后把整章大声读一遍。读着顺、像你平时跟导师汇报的口气,就没问题;哪句读着拗口,就把那句改成你自己会说的话。工具负责把大面积的标红处理掉,最后那一点「像不像我」,交给你自己把关。
问题十二:论文数据和引用会不会被动?
不会乱动。比话处理前会锁定术语、数据、公式、引用,再分章节去改,最后做全文一致性复核。
不过为了稳妥,处理完还是建议花几分钟核对一下:样本量、百分比、年份、文献作者这些硬信息,是不是和原文一模一样。这一步只需要扫一眼绿字部分,有数字的地方重点看。核对完再放回原文,心里踏实。
问题十三:疑似混合类和疑似AI类,先处理哪个?
先处理疑似AI类。它是红得最实的部分,处理一段降一段,效果最直观。
疑似混合类放第二步。原因是这类段落里有你自己的东西,处理时要更小心,用 Adapt 模式保住原意,处理完还要逐段确认口气。
如果时间实在紧,就按报告列出的风险最高章节来,那一章里两类片段一起处理掉,其余章节等复查后看情况再说。
问题十:学校维普AI率要求多少?超了会怎样?
没有全国统一标准,各校甚至各学院自定。本科最常见的是40%,其次30%,也有50%、20%;硕博从15%到40%都有。高校通知里指定的AIGC检测系统,维普最多。
超线的后果写得很硬:海南科技职业大学超过35%取消答辩资格;汉口学院AIGC超过20%视情节不予答辩或取消论文合格成绩;海南医科大学超过50%直接认定为学术不端。
所以今天就做三件事:重新查一次维普拿到新报告;把疑似AI类和疑似混合类片段挑出来;先免费处理一段看效果,再决定整篇怎么弄。以你们学校的通知为准。
最后放一次入口:比话官网(免费降AI 500字)
 浙公网安备 33010602011771号