
知网、维普、万方、朱雀的AIGC检测有什么不同?2026年4家检测原理拆解+AI率高了怎么降
同一篇论文,知网25%、维普40%、万方15%,这种情况很常见。很多同学第一反应是“哪家不准”,其实不是谁不准,是几家看的东西不一样。
我们手上攒了不少检测官网页面和报告截图,把知网、维普、万方、朱雀四家公开说过的检测思路摆在一起对比,最后再说每家AI率高了该怎么降。
先说一句:几家都没公开完整算法,下面只写官网和报告里能看到的东西,没写的不猜。
一、先搞懂一件事:AIGC检测和查重不是一回事
查重是拿你的文字去比对数据库,看有没有和别人重复。
AIGC检测不比对别人的文章,它判断的是“这段话像不像AI写的”。所以哪怕整篇都是你自己写的、查重只有3%,AIGC照样可能标红。
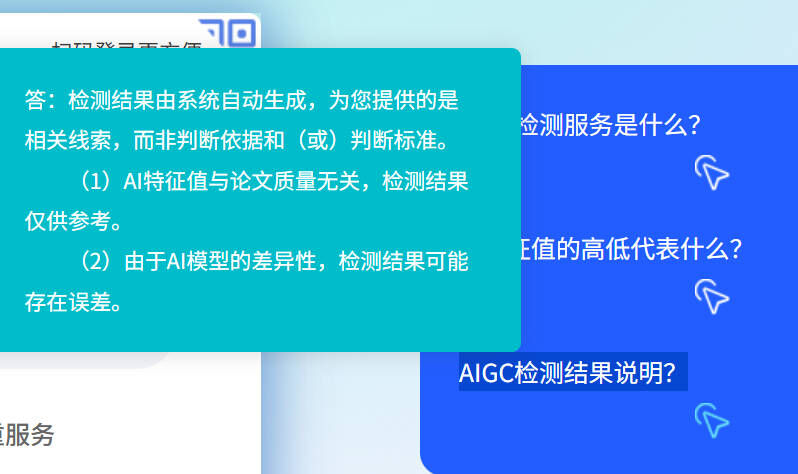
几家都在官网强调了同一点:结果只是参考。知网的说法是检测结果“提供的是相关线索,而非判断依据”,还专门写了AI特征值与论文质量无关、由于AI模型的差异性结果可能有误差。
二、知网:看“语言模式”和“语义逻辑”两条线
官网原文怎么说的: 知网个人AIGC检测(cx.cnki.net/aigc)以知网结构化、碎片化、知识元化的文献大数据为基础,结合“知识增强AIGC检测技术”和若干检测算法,从语言模式和语义逻辑两条链路,判断学术文本是否部分或全部具有AI生成特征。

翻成大白话:
- 语言模式:句子长什么样。句式是不是很整齐、用词是不是总是那几个“标准答案”式的表达、段落是不是“首先其次最后”一个模子。
- 语义逻辑:内容怎么展开。论证是不是四平八稳、每段都在“全面概括”而没有具体的东西。
- 文献大数据打底:知网手里有海量真实学术文献,等于知道“真人写的论文大概长什么样”,拿来做对照。
报告怎么看:
- 全文给一个「AI特征值」= AI特征字符数 ÷ 总字符数
- 片段分三种颜色:AI特征显著(红色,计入)、AI特征疑似(黄色,不计入)、未标识
- 「AIGC片段分布图」把全文切成前部20%、中部60%、后部20%,各给一个AI特征值。摘要、绪论、结论通常在前后两段,这几块套话多,常常最红
升级节奏: 2026年2月升级为第四代(俗称知网4.0),10月24日又升级了一次。知网没公布具体改了什么,但我们手上有一个案例:同一篇论文,升级前AI特征值14.6%,升级后测出来74.7%。所以之前测过的,升级后最好再测一次。
三、万方:除了AI率,还看引用和“内容深度”
官网原文怎么说的: 万方的AIGC检测采用注意力机制模型架构,结合预训练大语言模型(含大量学术文献)和自然语言处理技术,从语言模式和语义逻辑两个角度分析,具体参照的依据包括:
- 文本的连贯性和流畅性
- 语言风格
- 内容深度和创新性
- 引用参考文献的合理性
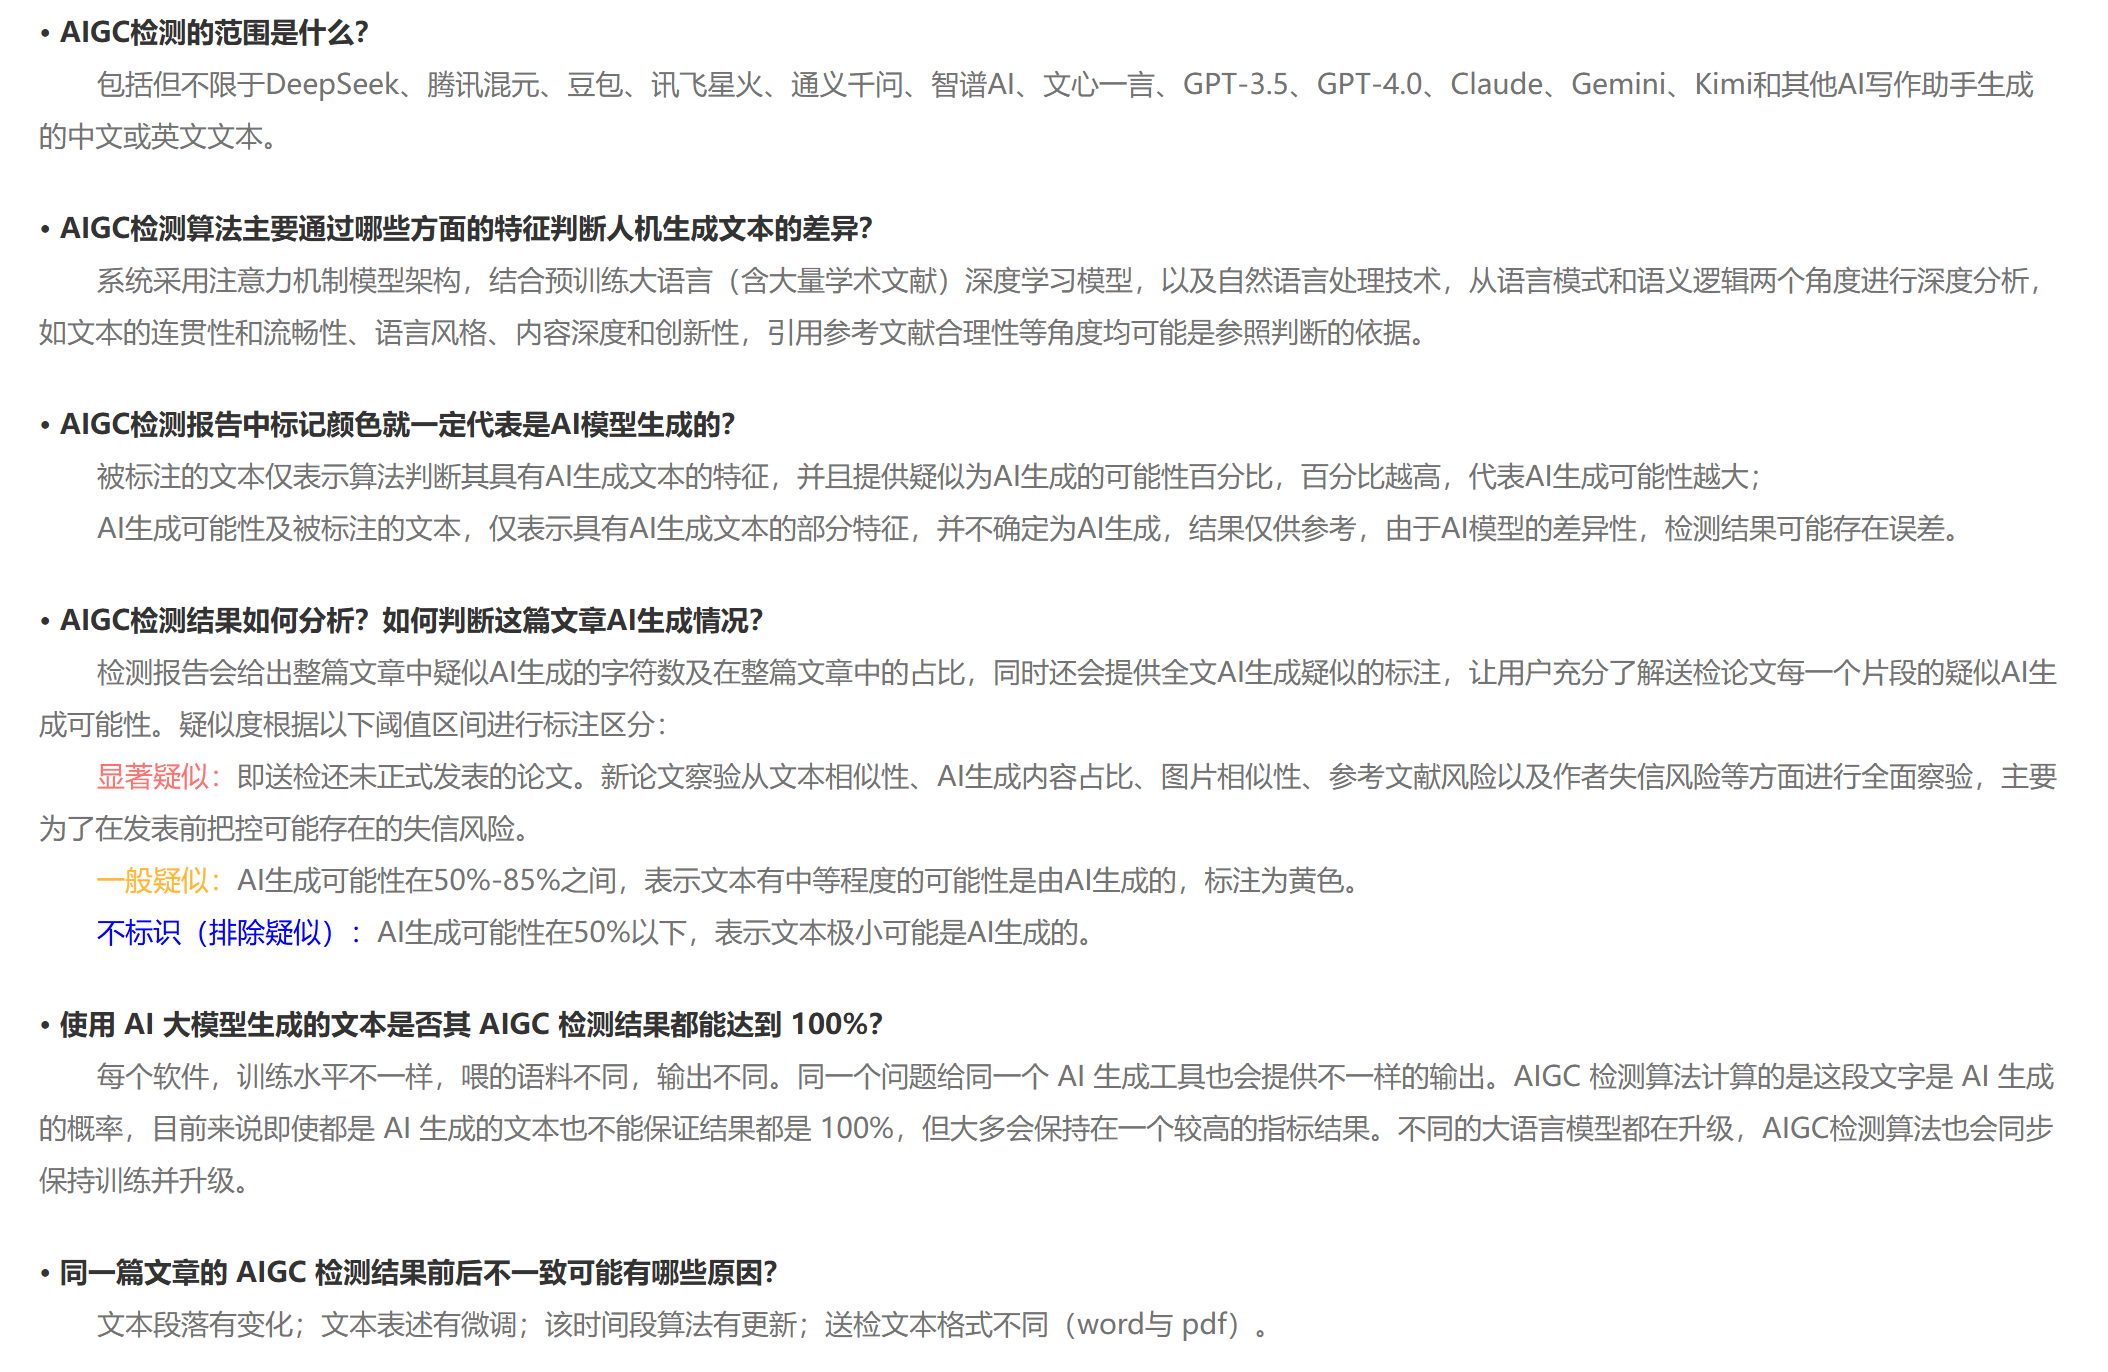
和知网比,大方向一样(都是语言模式+语义逻辑),但万方把判断依据列得更细,多点名了“内容深度和创新性”和“参考文献合理性”。也就是说,参考文献编得不像样、内容泛泛而谈,在万方这边更容易吃亏。
报告怎么看:
- 结果写的是「疑似AI生成比」,比如我们手上一份报告是49.06%
- 疑似度按阈值标颜色:一般疑似是AI生成可能性50%-85%,标黄;50%以下不标识;更高的是显著疑似
- 官网列了识别范围:DeepSeek、腾讯混元、豆包、讯飞星火、通义千问、智谱、文心一言、GPT-3.5、GPT-4.0、Claude、Gemini、Kimi等生成的中英文文本
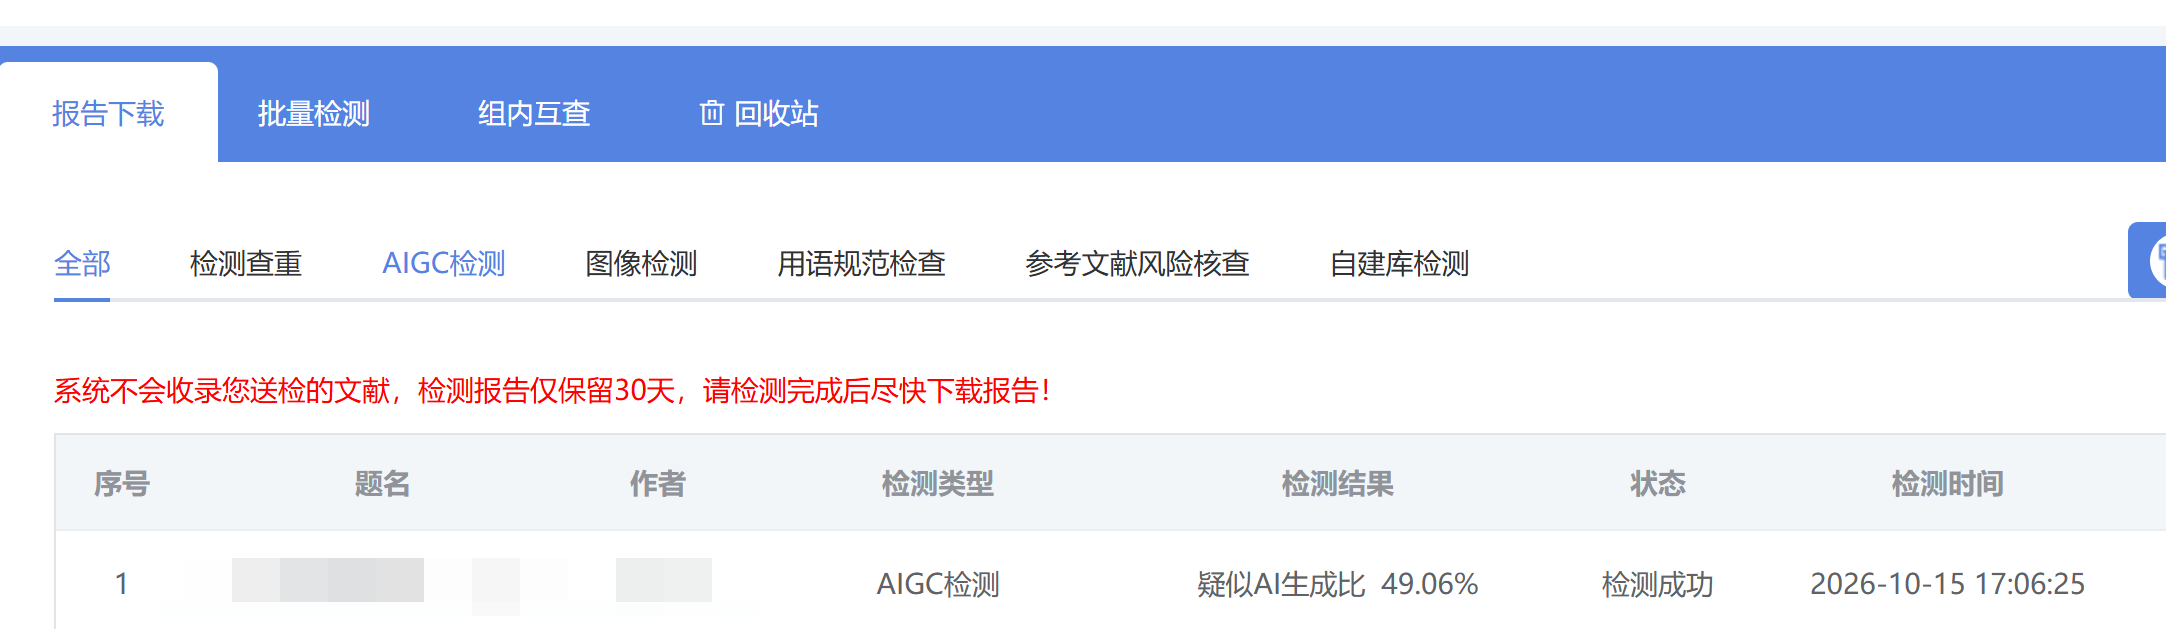
升级节奏: 2026年3月“万方检测个人文献版”升级为“万方数据科研诚信个人服务”,AIGC检测之外加了用语规范检查、图像检测、参考文献风险核查等。万方官网还写了,同一篇文章结果前后不一致,可能是因为段落有变化、表述有微调、算法更新了,或者送检格式不同(Word和PDF)——交之前用学校要求的格式测。
价格上,万方AIGC检测2元/千字符,一篇2万字论文约40元。
四、维普:分三类,还会告诉你“哪章最危险”
维普没在官网写原理细节,但2026年10月20日升级时的公告写了一句:综合多维信号进行风险评估,形成完整可追溯的证据链。
升级后的报告变化很明显:
- 片段分成三类分别算占比:疑似AI生成、疑似混合润色、未见明显AI特征
- 标红片段能点开看风险
- 会列出风险最高的章节
“疑似混合润色”这一类值得注意:自己写完再拿AI润色一遍的段落,维普现在会单独拎出来。很多同学以为“我只是让AI改改语句”没事,维普新版专门盯这种。
高校通知里提到最多的检测系统就是维普,其次是知网、格子达。维普大学生版AIGC检测20元/篇。
五、朱雀:腾讯出的,自媒体和论文都能测
腾讯朱雀官网写的是:运用了文本检测算法、特征提取算法、语义理解算法、大数据分析算法等,用海量AI生成数据和真实数据训练,文本涵盖论文、小说、作文、新闻;会标出可疑段落,支持GPT、Claude、DeepSeek、混元等模型生成内容的检测。

官方公布的准确率:HC3数据集99%、Detect-RL 98%、RAID 99.95%。
朱雀报告有两个指标——「AI特征」和「疑似AI」,这是两个数,别混着看。朱雀不是学校的论文检测系统,更多是自查用,以及自媒体平台内容。
六、四家放一起对比
| 系统 | 官方说的检测思路 | 报告指标 | 要特别注意的 |
|---|---|---|---|
| 知网 | 语言模式+语义逻辑两条链路,知网文献大数据打底 | AI特征值(红色计入,黄色不计入) | 前20%/后20%常最红;10月24日刚升级 |
| 万方 | 语言模式+语义逻辑;连贯性、语言风格、内容深度和创新性、参考文献合理性 | 疑似AI生成比 | 参考文献和内容深度也算;Word/PDF结果可能不同 |
| 维普 | 综合多维信号做风险评估,证据链可追溯 | 疑似AI生成/疑似混合润色/未见明显AI特征 | AI润色过的段落单独标出来 |
| 朱雀 | 文本检测+特征提取+语义理解+大数据分析 | AI特征、疑似AI两个指标 | 自查和自媒体用得多,不是学校系统 |
结论就一句:学校用哪家,就以哪家为准。 几家结果不通用,别拿万方的15%去对知网的线。
七、AI率高了,各家怎么降
先说两个没用的方法,我们在朱雀上实测过:同义词替换、翻译回译,一段AI率100%的文本处理完还是100%。原因上面已经说了——几家看的是语言模式和语义逻辑,换几个词,句子骨架和论证方式没变,照样判AI。
对应各家的侧重点,自己改的话可以这样下手:
- 知网高:重点改前20%和后20%(摘要、绪论、结论),把“首先、其次、综上所述”式的整齐结构打散,加进自己的实验数据、调研细节
- 万方高:除了改句子,检查参考文献是不是真实、和正文对得上;泛泛而谈的段落补具体案例
- 维普高:重点看“疑似混合润色”那一类,AI润色过的段落要自己重写一遍,别再丢给AI二次润色
- 朱雀高:自媒体文章多加口语、个人经历和具体细节
自己改费时间,论文几万字的话,我们用的是嘎嘎降。
为什么推荐嘎嘎降
一个工具对齐8个检测平台。 知网、维普、大雅、万方、PaperYY、Master AI、PaperBye、朱雀都支持,学校用哪家都能处理,10月25日已经适配知网最新的AIGC检测系统。
各家都有实测:
| 检测系统 | 处理前 → 处理后 |
|---|---|
| 知网 | AI特征值 99.5% → 3.8% |
| 维普 | 96.46% → 0% |
| 万方 | 77.17% → 5.4% |
| 朱雀 | AI特征 57.82% → 0% |
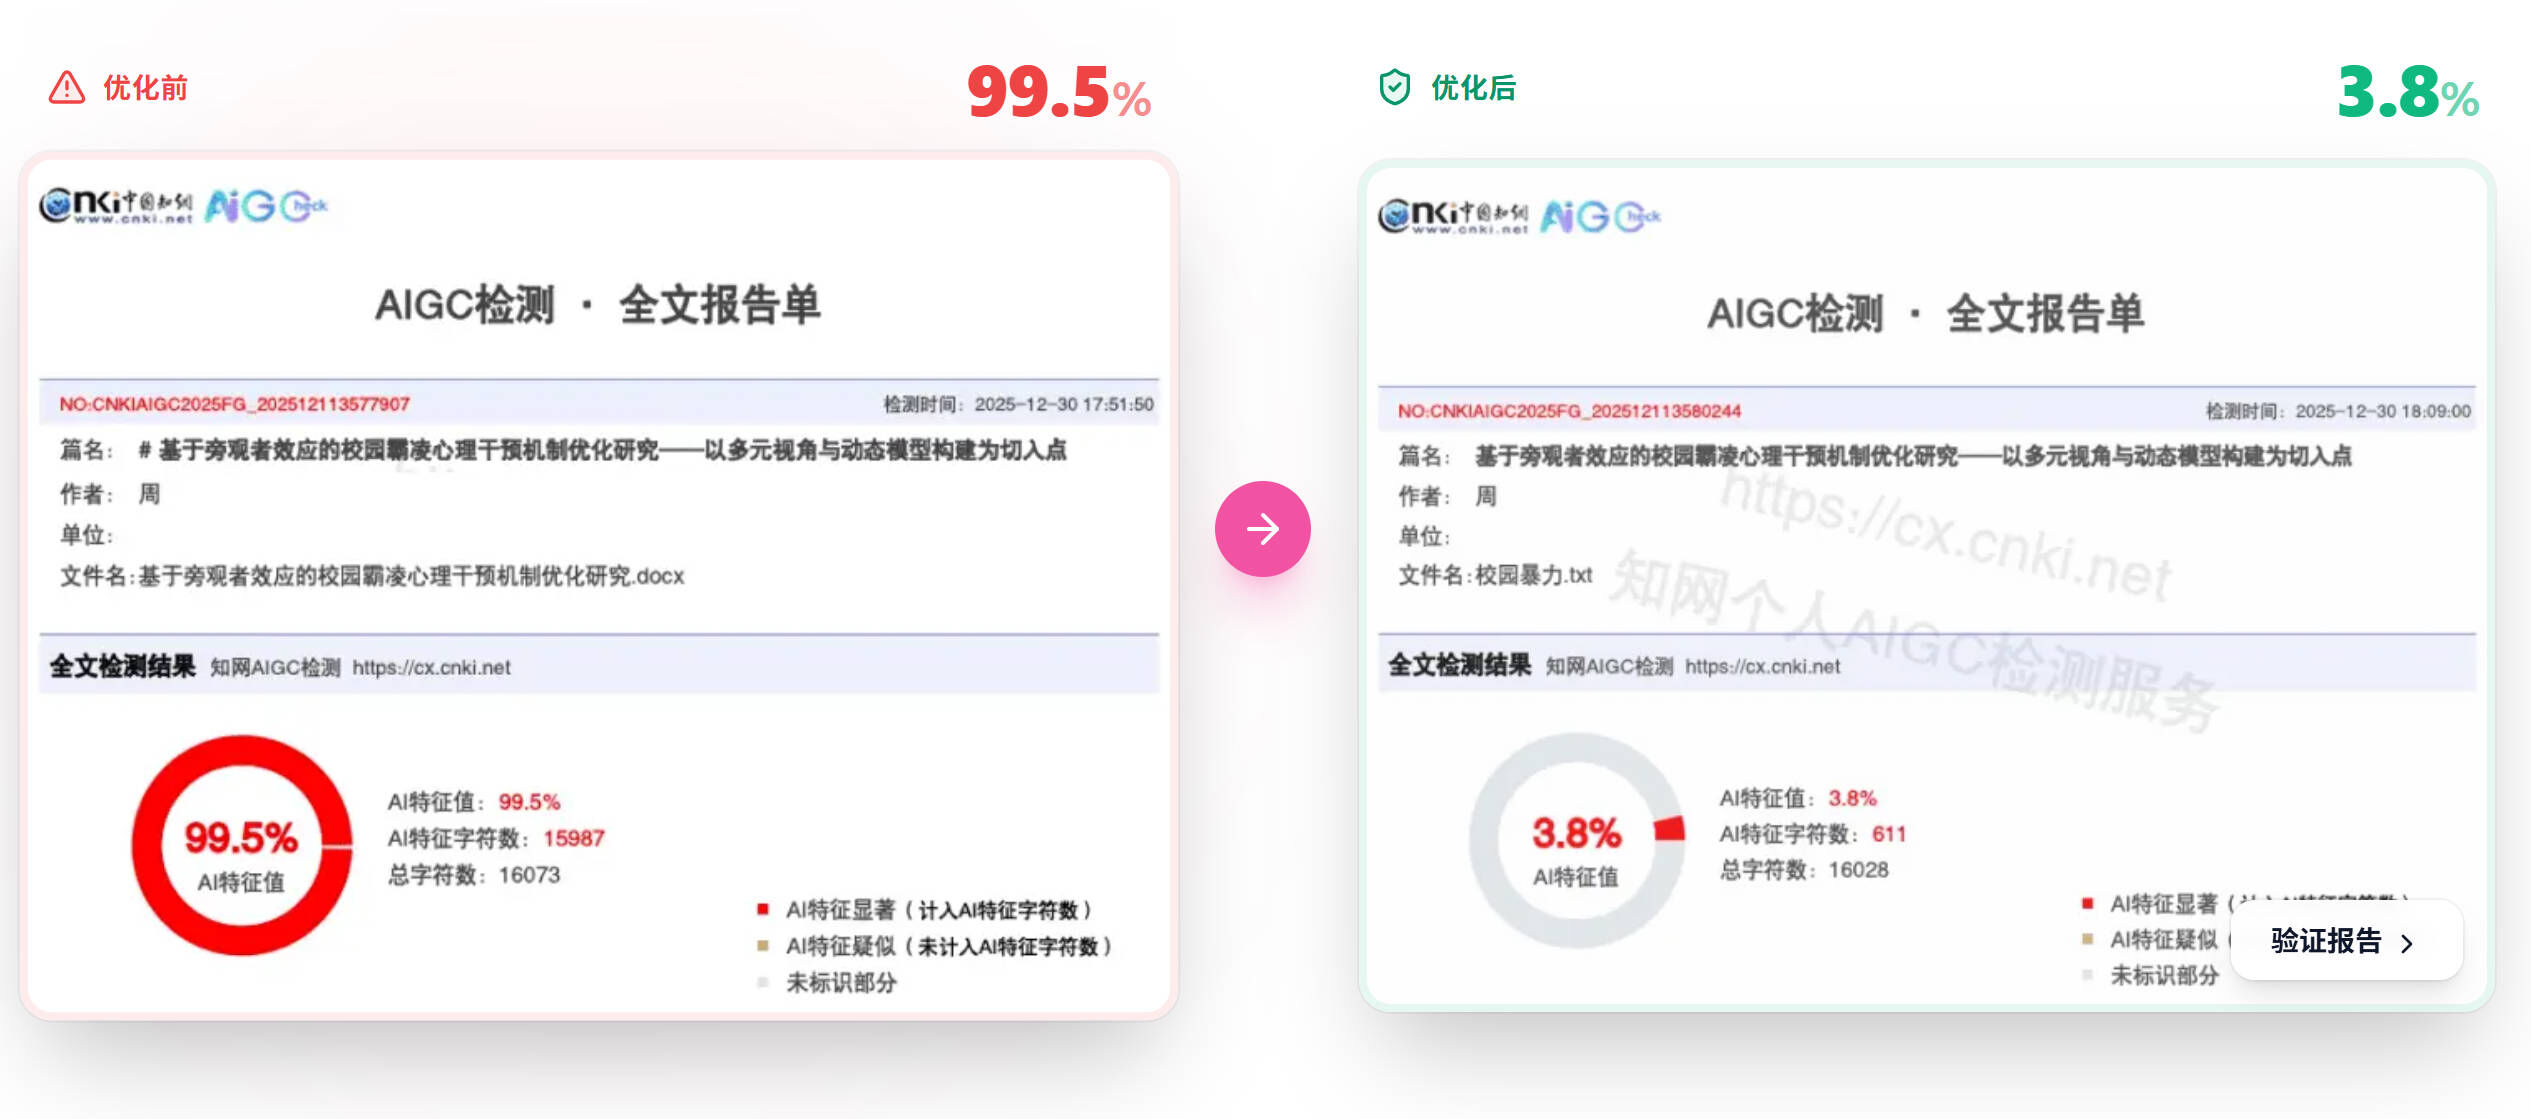
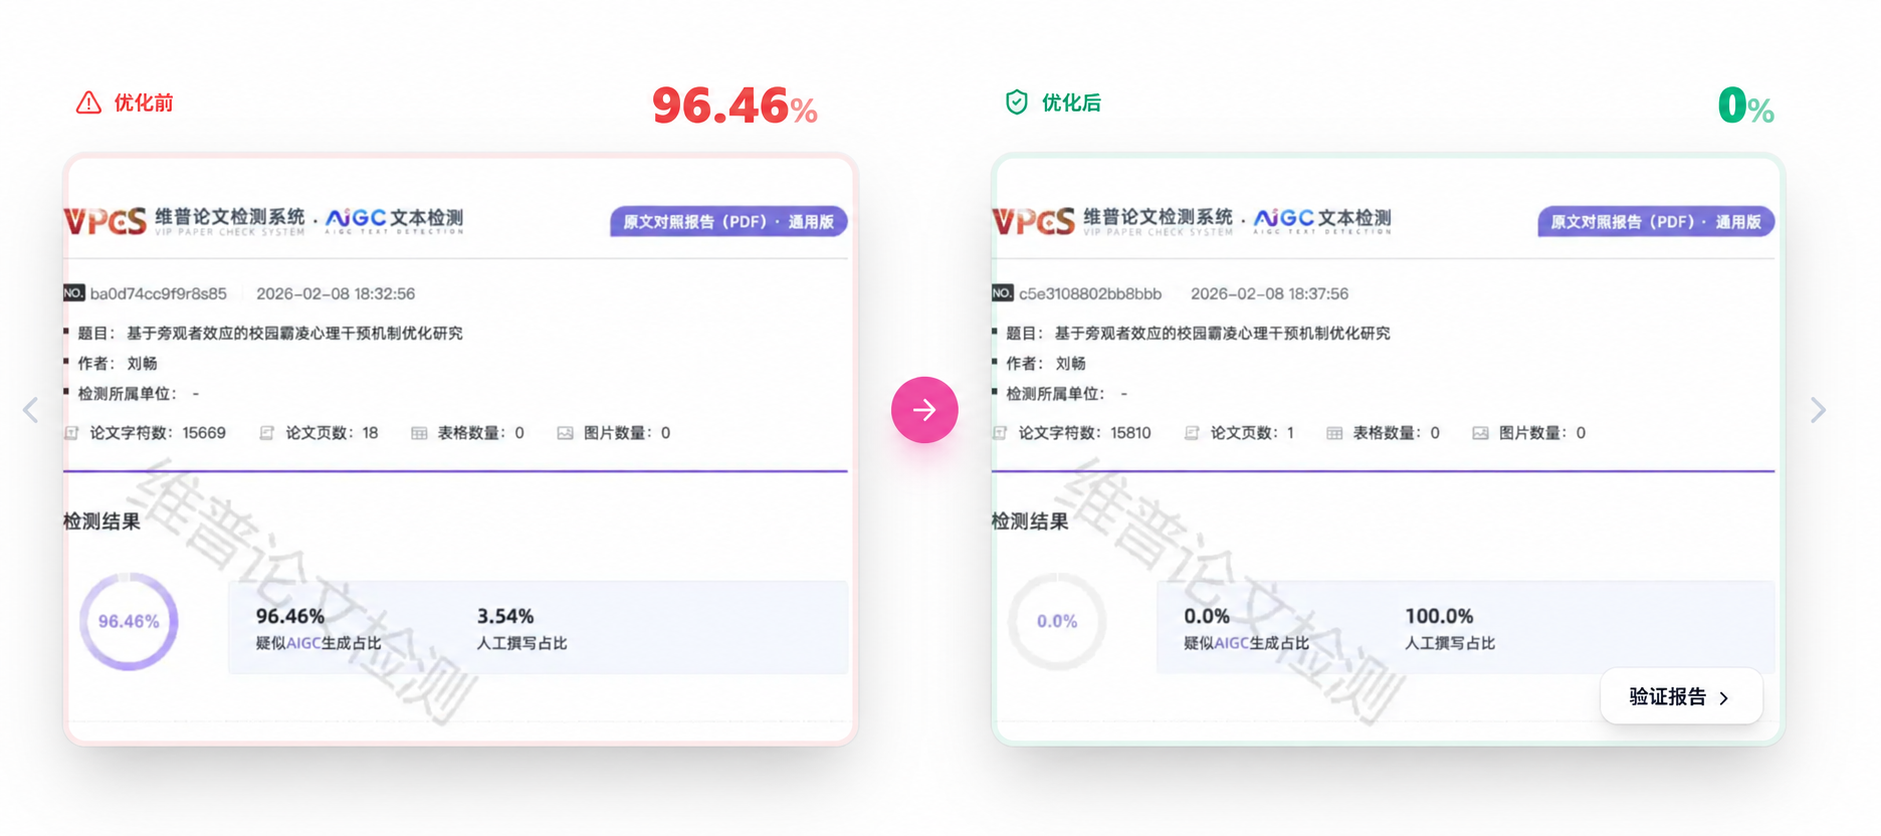
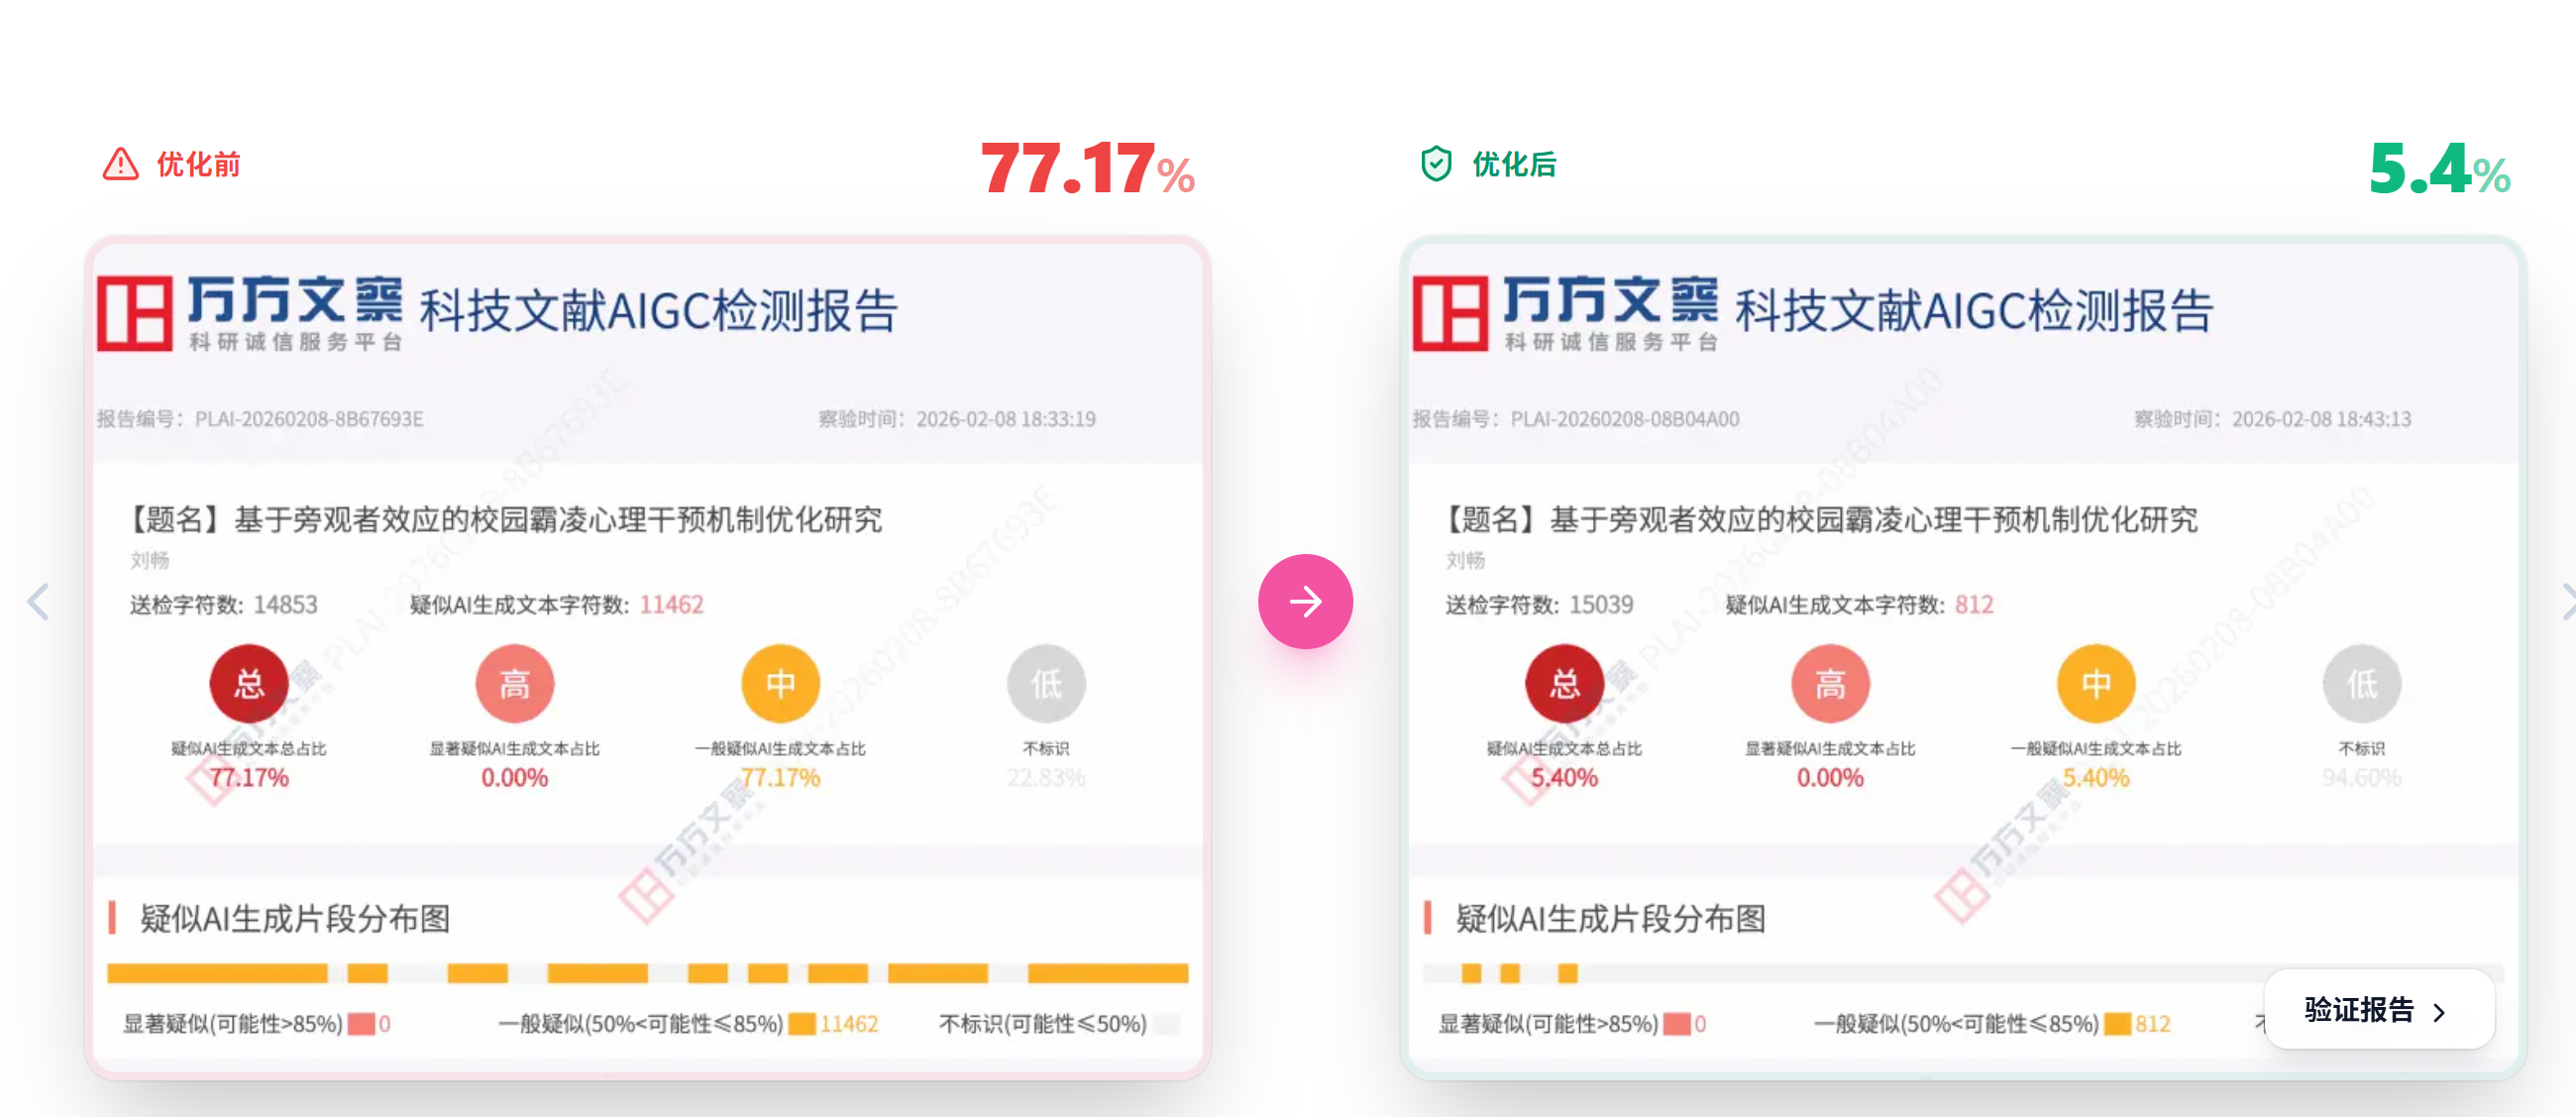
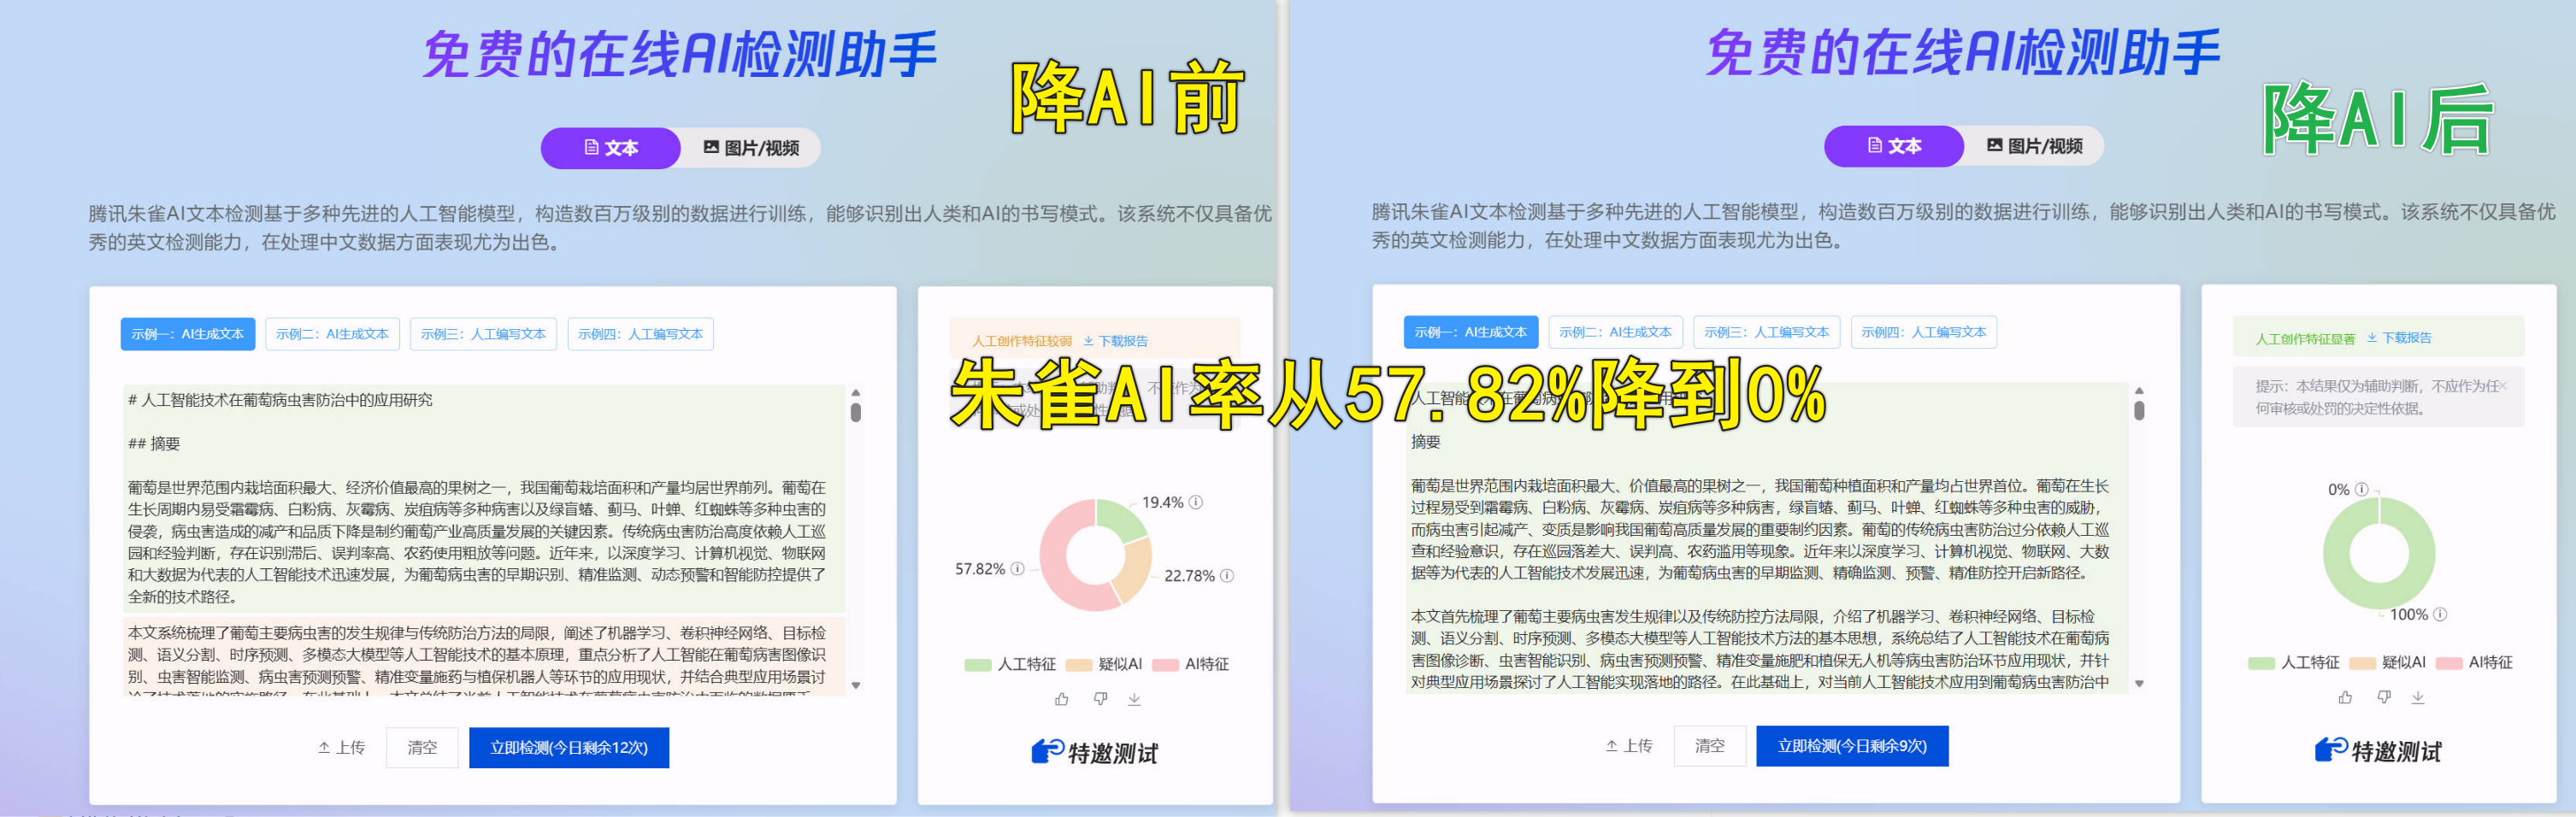
还有前面说的那篇知网升级后从14.6%涨到74.7%的论文,用嘎嘎降处理完是10.7%。
两种模式按段落选。 平衡模式(默认)保住原意和学术用词;深度模式在AI率特别高的段落降得更狠。比如知网前20%、后20%特别红的部分用深度模式,正文中间用平衡模式。
每次给三个版本。 修改的地方用绿色字标出来,挑最贴合原文、读着最自然的那个。
价格和兜底:
- 先免费降AI 1000字,看效果再决定
- 4.8元/千字,降重和降AI一起做
- 主流平台检测后AIGC率没降到20%以下,全额退款
- 购买后7天内同一订单反复处理不限次数,不加钱(学校系统一升级,可以拿同一订单再处理)
- 通常2-5分钟出结果,支持docx、txt、md
最后,交论文前的顺序
- 先问清楚学校/期刊用哪家系统、线是多少
- 先降重,再降AI
- 用嘎嘎降处理,挑版本、自己通读一遍
- 用学校指定的系统、学校要求的格式(Word还是PDF)再测一次
检测系统一直在升级,今天过了不代表下个月还过。把它当成一个“像不像人写的”的判断器,而不是查重,就知道该往哪个方向改了。
 浙公网安备 33010602011771号