
论文ai率是怎么检测的?搞懂原理再去ai味,改起来事半功倍
论文ai率是怎么检测的?搞懂原理再去ai味,改起来事半功倍
同实验室的师妹干过一件特别有代表性的事:知网AIGC检测67.4%,她闷头改了三天,把"的"换成"之",把"因此"换成"故而",把"研究"换成"探究",全文替换了几百处。复测,66.9%。三天工龄,换来0.5个点,人直接崩溃在工位上。
她的问题不是不努力,是不知道检测器在看什么。这就像考试不知道评分标准,答得越多越跑题。所以这篇不急着给你工具和技巧,先把论文ai率是怎么检测的这件事用大白话讲透。搞懂原理,你会立刻明白哪些改法是无用功,哪些改法一改一个准,同样是熬一个晚上,别人降30个点你降0.5个点,差的就是这层认知。实在火烧眉毛没时间看原理的,可以先把标红最狠的一段贴进比话官网(500字免费试用)免费测个效果,回头再补课。
论文ai率是怎么检测的?三个信号大白话拆解
先破除一个误解:检测系统不是在你的论文里搜AI的指纹,它手里没有ChatGPT的生成记录,也不存在什么隐藏水印数据库。它做的事情本质上是概率判断:拿一套模型分析你的文本特征,评估这段话像不像机器写出来的。像,就标红。
具体看什么,主要是三个信号。
信号一:下一个词好不好猜。AI生成文字的底层逻辑是预测下一个词,所以它写出来的句子,每个词都是最顺理成章的那个选择。检测器反过来利用这一点:拿模型去猜你文本的下一个词,猜得越准,说明你的行文越标准,越可能是机器写的。打个比方,AI点菜永远点销量第一的招牌套餐,一个人连续一百顿都点招牌套餐,你也会怀疑他不是人。落到你的论文上:如果通篇都是最标准的学术套话,检测器一猜一个准,AI率就下不来,哪怕真是你自己写的。而人类写作会时不时冒出意料之外但情理之中的表达,这种猜不到,恰恰是人味。
信号二:节奏匀不匀。AI写的段落,句子长度出奇地整齐,二十五字、二十八字、二十六字,段落结构也是标准的总分总循环,像匀速运转的跑步机。人写东西是逛街式的,有时候一句话拖得很长,中间还要插一个补充说明,有时候就三个字,完事。检测器统计句长分布和段落节奏,太稳的,标红。你的论文如果每段都一样长、每句都一样齐,这一项就已经在给AI率贡献分数了。
信号三:用词偏好。大模型有自己的口头禅:随着、综上所述、值得注意的是、日益凸显、不难发现,还有排比堆砌、每段结尾升华一句的习惯。这些模板痕迹检测器见得太多了,密度一高就触发警报。
三个信号合起来打一个综合分,这就是你报告上那个百分比。理解了这一点,你也就理解了两件让无数人困惑的事:为什么自己一个字一个字写的也会被标红,因为规整的学术八股腔天然踩中这三个信号,你冤,但检测器不管你冤不冤,学校只看报告数字;为什么师妹换了三天词没用,"的"换成"之",可预测性没变、节奏没变、结构没变,三个信号一个都没打中,检测器眼里这篇文章纹丝没动,三天时间等于扔进水里。
AI文本特征自查清单:你的论文中了几条?
把三个信号落成一张能对着自查的清单,通读你的论文,中三条以上的段落基本就是标红高危区:
- 句子长度高度均匀,很少有短句急停或长句展开;
- 每段都是观点、展开、小结的总分总,段段如此;
- 随着、综上所述、值得注意的是、不难发现这类衔接词高频出现;
- 大量日益显著、丰硕的成果、重要的理论基础式万能形容,删掉也不影响信息量;
- 排比句成灾,三个有利于、四个进一步连着排;
- 段落结尾习惯性升华,每段收一句正确的废话;
- 全文找不到一处只有你才写得出来的东西,没有具体样本数、没有实验中的意外、没有调研对象说过的原话;
- 转述文献的句式高度一致,清一色某某(年份)指出、认为、提出。
最后两条要特别圈出来。一手细节的缺失,是AI文本最藏不住的马脚,模型没参加你的实验,编不出因样本流失临时补发了20份问卷这种事。反过来这也是你手里最硬的牌:往标红段落里塞你的一手细节,是所有改法里性价比最高的一招。
搞懂原理之后,手动去ai味怎么改才打在点上?
原理清楚了,改法就有了准星:每一处修改,都要打中三个信号里的至少一个,打不中的都是无用功。看一组文献综述的改写前后对比。
改写前,三个信号全踩:
国内外学者对乡村旅游进行了大量研究,取得了丰硕的成果,为本研究提供了重要的理论基础。
改写后:
围绕乡村旅游,近十年国内研究集中在开发模式与社区参与两条线上。分歧出现在社区收益怎么量:王某(2021)用问卷自评,陈某(2023)坚持用分红台账,两套测法得出的参与度差了近一倍。这个分歧就是本文切入的缝隙。
拆解一下打点:原句每个词都猜得到,改后分红台账、差了近一倍是猜不到的具体信息,打中信号一;原句一句到底四平八稳,改后长短交错,中间还插了个补充说明,打中信号二;丰硕的成果、重要的理论基础这类模板话全部清除,换成有信息量的表述,打中信号三。
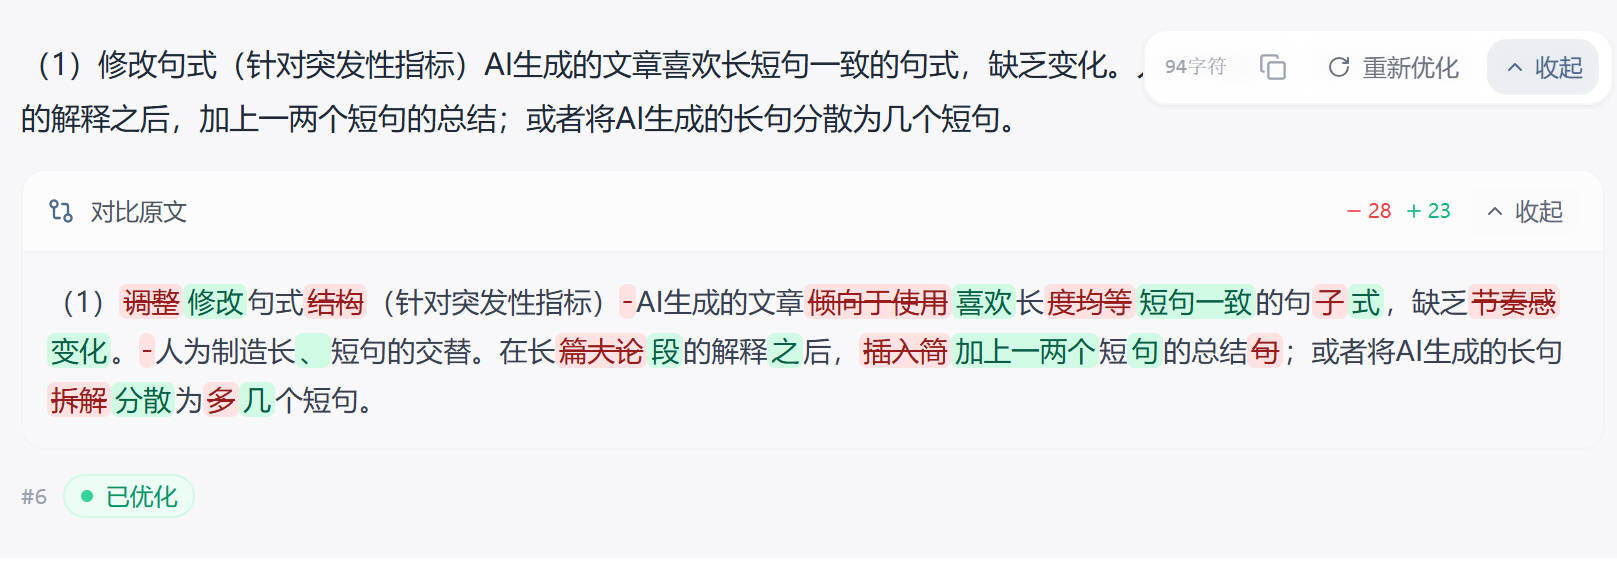
按同样的思路,其余改法各自的靶子也标清楚:
- 拆长句、造节奏,专打信号二。超40字的句子拆开,偶尔来个短句急刹;
- 模板衔接词清零、删万能形容,专打信号三。删完你会发现句子反而更有劲了;
- 塞一手细节,专打信号一。实验里的波折、调研的具体日期、访谈对象的原话,这些是模型预测不出来的;
- 打乱出牌顺序:AI习惯定义、分类、意义一路排下来,你先抛一个反常识现象再回头补定义,可预测性直接下来。
顺便解释两个流传很广的偏方为什么不灵。同义词批量替换,就是师妹那三天,打不中任何信号,前面说过了。中译英再译回来的回译法更糟:机器翻译本身就是模型生成,转一圈回来节奏更均匀、用词更标准,属于用AI味洗AI味,越洗越红,还容易把术语洗错,答辩时自己都看不懂自己的句子。
全篇手改成本太高的时候怎么办?
按上面的方法逐段改,是真有效,但也是真费时间。每一段都要重想信息增量、重排节奏,实际操作下来每千字纯改写就要半小时起步,一篇一两万字的论文改下来是以天计的工程,改完还要复检验证,不达标再来一轮。时间充裕的同学按清单慢慢磨,完全来得及;卡着截止日期的,说句实在话,这个工程量硬扛不现实,扛到最后复检没排上,延迟答辩的是你自己。
时间紧、学校又是用知网检测的,可以看看比话。它的思路和这篇文章讲的原理是同一套:Pallas引擎针对知网AIGC检测的判定信号做定向改写,等于把上面的手动打点批量自动化。
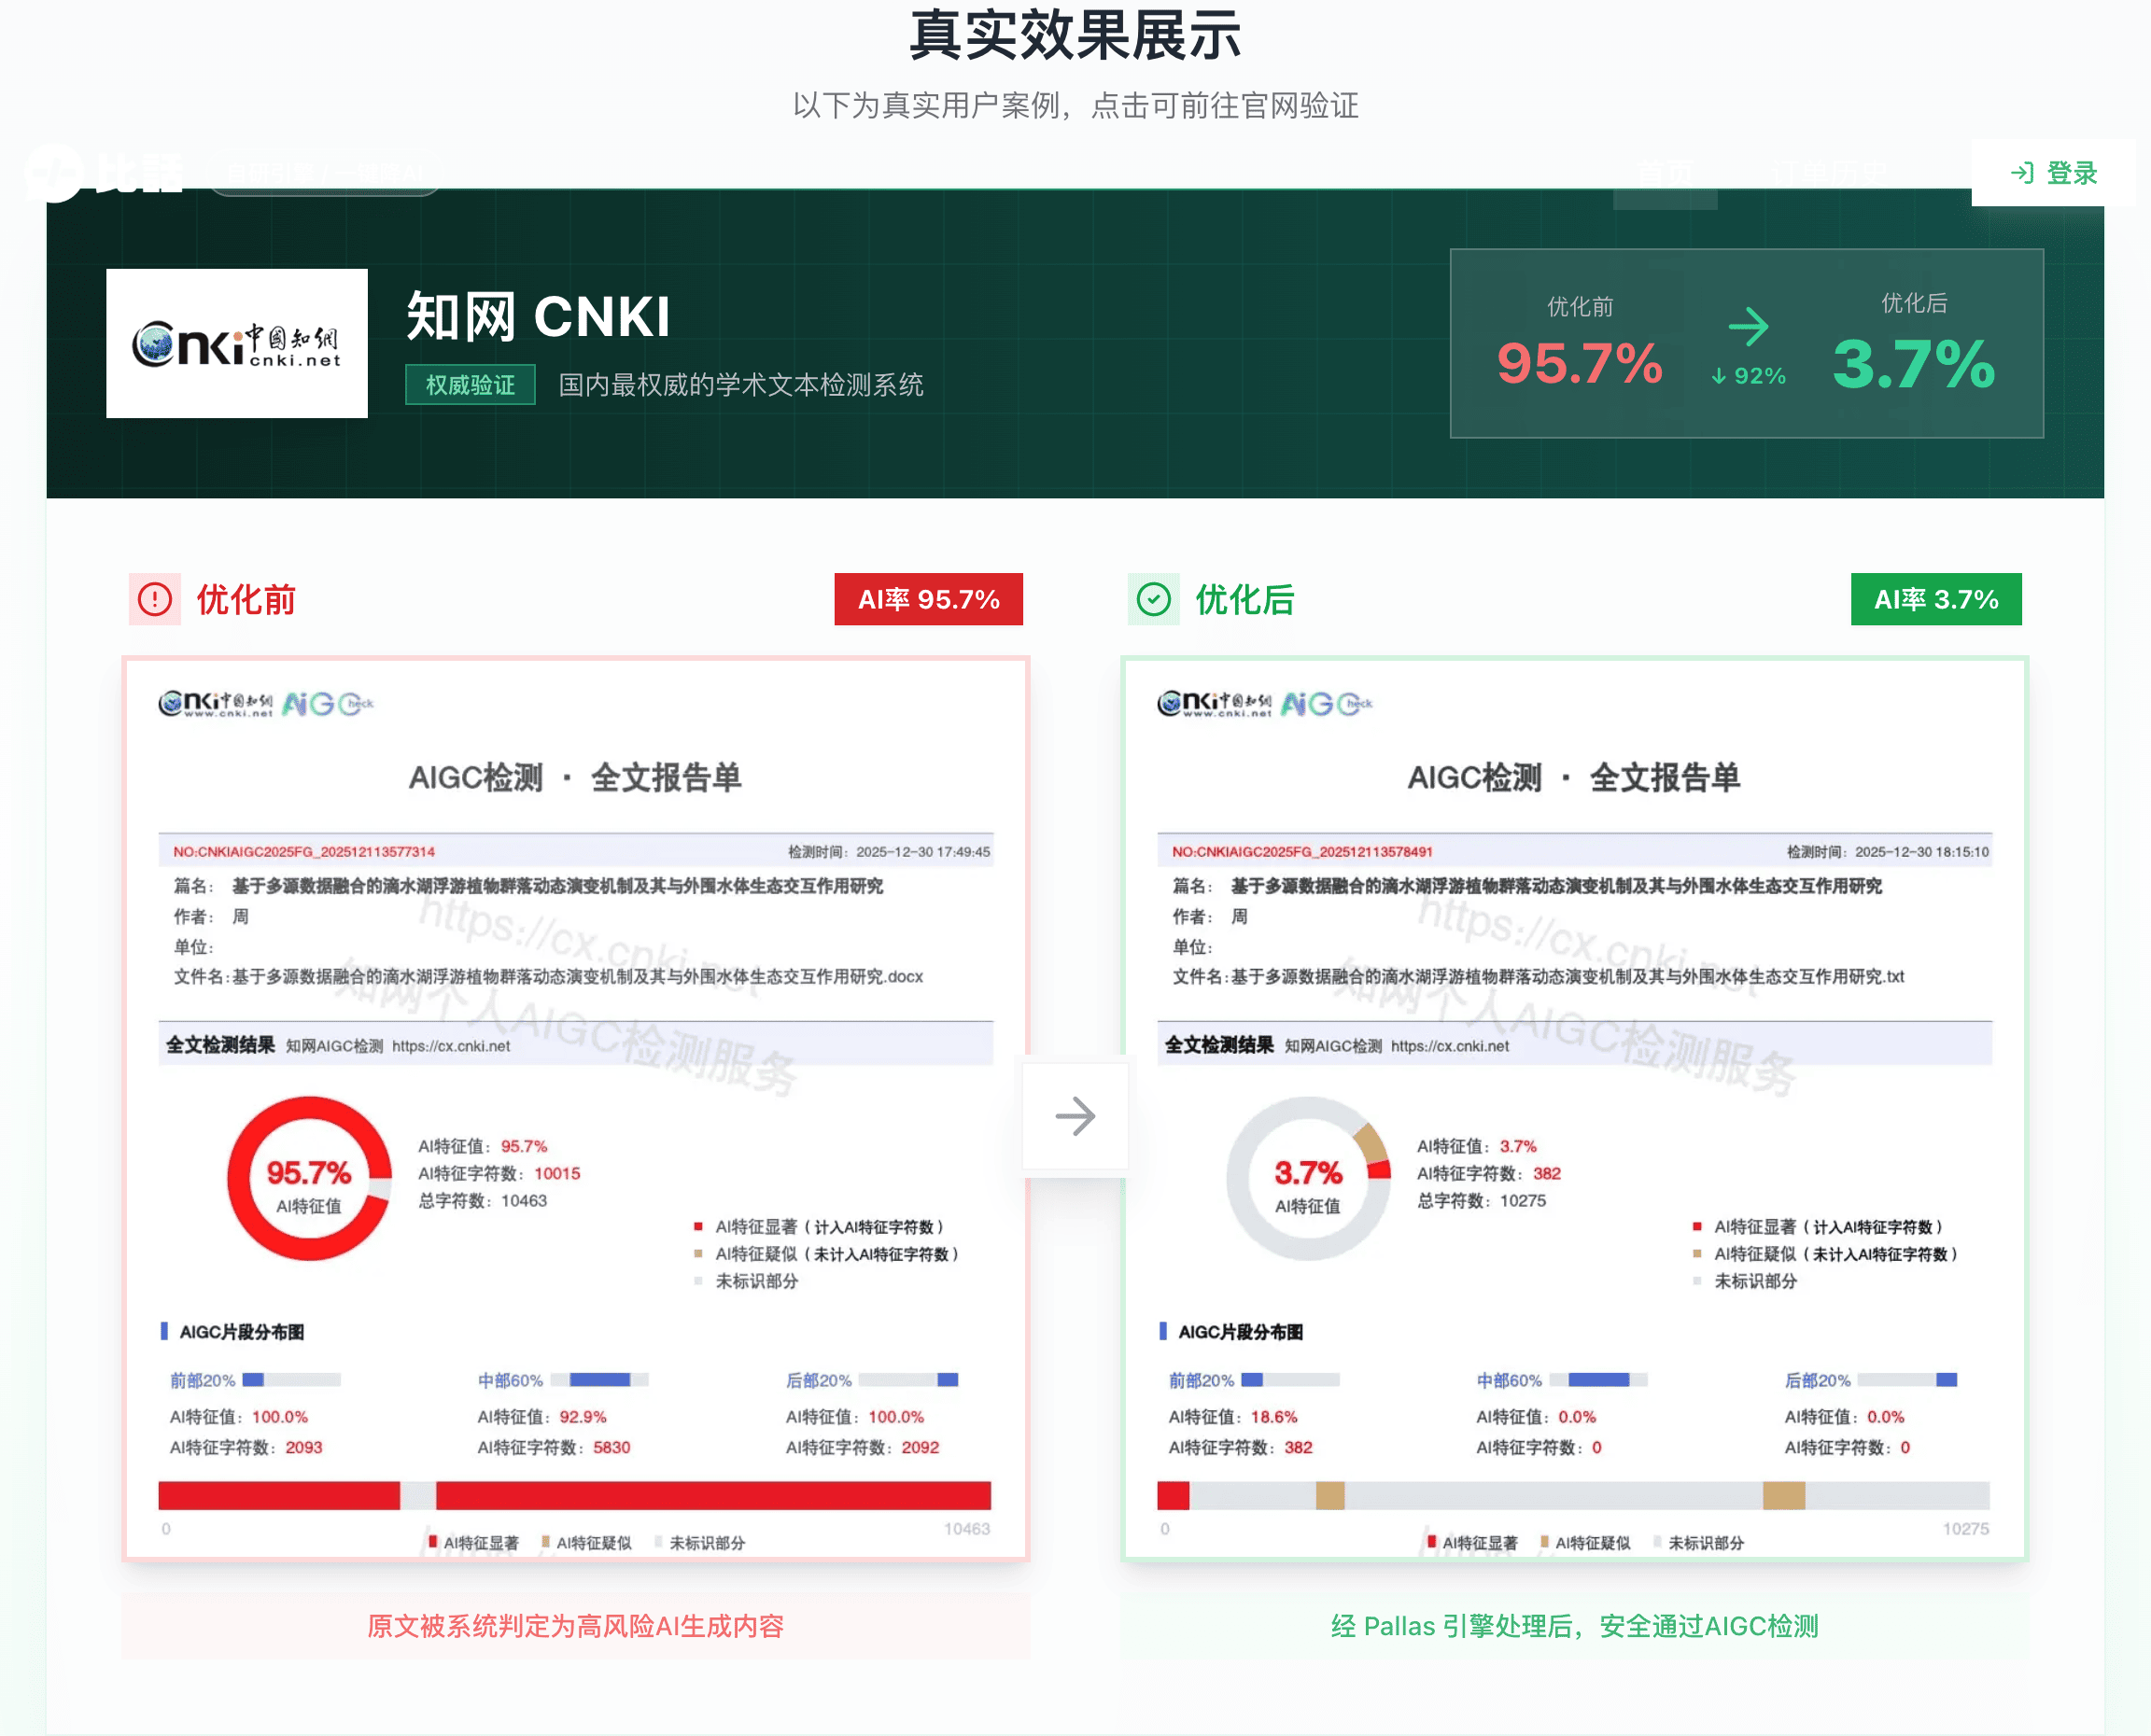
处理完别直接交,它的修订对照界面会把改动逐句并排展示,拿着本文的特征清单通读一遍改动,既核对术语没被改偏,也顺便验证每处修改确实打在信号上。懂原理的人用工具,用的是明白钱。
参数一句话带过:8元/千字,500字免费试用,建议拿标红最狠的段落先试,10万字上限,承诺降到15%以内、降不到全额退款并补检测费,7天无限次修改。入口:比话官网(500字免费试用)。
工具的事到此为止,回来把原理的最后一块补完。
为什么不同平台测出来的ai率不一样?
知网、维普、万方、大雅都做aigc检测,但四家的模型、训练语料、灵敏度阈值互相独立,等于四个口味不同的评委。同一篇论文在不同平台差出一二十个点很正常,这不说明哪家不准,只说明AI味本身就没有客观标尺,各家量法不同。
对你的实操含义就一条:学校用哪个系统,你就用那个系统自查和验证。拿别的平台的低分安慰自己,学校终检一测超标,重新检测重新改,耽误的是自己的答辩时间。其他平台的分数看看就好,别当救命稻草,也别自己吓自己。
看完这篇该怎么动手?三句话收尾
第一句,改之前先诊断:拿特征清单扫一遍全文,找出高危段落集中火力,别学师妹全文替换"的"字。第二句,每一笔修改都问自己打中了哪个信号,打不中的改动就是无用功,改了也白改。第三句,改完必须复检验证,用学校同款系统,凭手感交稿的勇气咱们不需要。
检测器不神秘,它就是个统计规律的裁判。搞懂它看什么,你的每一分钟修改时间才花在刀刃上,这就是标题说的事半功倍。自己改就按清单开工;工程量太大改不动的,先去比话免费测500字看看效果,再决定要不要把剩下的交给工具。
 浙公网安备 33010602011771号