
知网AI率降下来了重复率却涨上去,这一轮白改在哪一步?
知网AI率降下来了重复率却涨上去,这一轮白改在哪一步?
一个降一个涨,是我改得还不够多吗?
不是。你要是照刚才那路子再多改几轮,重复率只会接着往上走。
这轮的问题不在改的量,在改的方向。你为了把 AI 率压下去,多半是把句子改得更顺、更规范、更像标准的学术表述,而"标准""常见""规范"这三个词,恰好是重复率最喜欢的东西。你等于躲开了一个检测,同时主动撞上了另一个。
先把结论摆这儿:能让两个数字一起下去的只有一种东西,就是往段落里补只有你才拿得出来的信息。除此之外的改法,都是在两个指标之间拆东墙补西墙。
查重和AI检测,看的根本不是同一样东西?
对,这是整件事的根。
查重比对的是字面重合。你的句子和已有文献、已收录的学位论文、网络资源里的文字,有多少连续片段是一样的,它有一个庞大的比对库,你的话越像库里已经存在的话,数字越高。
AIGC 检测看的是另一回事,是文本的可预测性。句子长度是不是都差不多、几句话的骨架是不是同一套、词语搭配是不是高频组合、有没有具体到猜不出来的细节。它不去比对库,它评估的是下一个词好不好猜。
观察对象完全不同,同一处改动落在它们身上的效果自然可能相反。要说明的是,知网这类检测并没有公开完整算法和权重,上面说的是这类检测通常关注的方向,不是官方公式。
为什么"改得更通顺"反而会把重复率顶上去?
因为通顺的说法数量有限,而且大家都在用。
一个专业领域里,表达同一个意思的规范写法就那么几种。你把一句自己写的、略显别扭的话改成教科书里最标准的那句,AI 检测那边可能确实觉得自然了一点,查重那边却立刻发现:这句在库里已经有几十份文献这么写过。
同义词替换更糟。它既没动句子骨架,AI 率纹丝不动;又常把你原本带点个人色彩的表达换成更常见的搭配,重复率往上走。改了一整夜两个数字都不听话,多半就是这么来的。
同一句话三种写法,差别到底在哪一处?
原文:
本研究通过对该企业员工的问卷调查,分析了工作压力对离职倾向的影响,结果表明工作压力对离职倾向具有显著的正向影响。
只求通顺的改法:
为探究工作压力与离职倾向之间的关系,本研究以该企业员工为调查对象开展问卷调查,研究结果显示,工作压力对员工离职倾向存在显著的正向预测作用。
这一版读着更像论文,AI 率可能会掉一点,但它同时干了两件坏事:一是"为探究……之间的关系""存在显著的正向预测作用"都是本行业的通用句式,比对库里成千上万份文献就是这么写的,重复率会涨;二是信息量一个字没多。
补进自有信息的改法:
这家企业的员工流动集中在入职后第 8 到 14 个月,所以问卷把工作年限单列成了一个分层变量。在 236 份有效问卷里,压力得分最高的那一组离职倾向也最高,但分层之后可以看到,这个关系在工作满三年的员工身上明显减弱。
差别在哪一处:第一句换成了这家企业特有的现象,以及由它引出的一个设计决定,比对库里不会有这句话;第二句给了具体样本量,还给了一个分层后的例外,"但……明显减弱"这种带转折的发现机器猜不出来,也没人跟你写得一样。
有条底线要划清楚:换的是表述方式和信息密度,样本量、变量名、专业术语一个都不能动。为了不撞库把 236 改成 240,那是数据造假,跟改写不是一回事。
什么样的内容既不好猜、又不会跟别人撞?
四类东西。你自己测出来的数据和它的具体数值;调研或实验过程里的细节,什么时候做的、剔除了多少样本、为什么剔除;跟预期不符的结果以及你对它的解释;还有这项研究的限制条件,样本只覆盖了哪一块、哪个结论不能往外推。
这四类有个共同点:它们只存在于你的研究里。比对库里没有,所以不会重复;没有规律可循,所以不好预测。你每往一段里填进去一条,那一段的两个数字就同时往下松一点。
反过来,如果一整段里一条这样的信息都没有,你怎么改都是在通用表述之间打转,无非从一种撞法换成另一种。
两个指标该分两轮改,还是一起改?
一起改,这是这篇最实用的一条。
常见做法是先集中降 AI 率,测一遍,发现重复率涨了,再回头集中降重复率,测第二遍,结果 AI 率又弹了回去。第二轮必然推翻第一轮,因为两轮的方向正好相反:一轮在打散规律,一轮在避开撞词,各改各的就是互相拆台。
正确的排法是把两份报告并排摊开,按段落对齐,给每段贴个标签:只标查重、只标高 AI、两边都标、两边都干净。先从"两边都标"的动手,这类段落几乎都是通用表述堆起来又没有自有信息的,补一次具体信息能同时解决两边。接着处理只标高 AI 的,最后是只标查重的。全部改完再统一测一次。
引用和参考文献那部分涨了,要不要动?
先别动手。
正当引用造成的重复,和你自己写的话撞了库,性质完全不一样。检测通常可以设置是否排除引用部分,你要先确认学院通知认的是哪个口径:算不算引用、算不算文献列表、按哪个范围计。口径没搞清就去删引注,很容易把该标的地方标没了,那属于学术规范问题,比数字难看严重得多。
真要处理,只碰两种情况:整段照抄式的转述太长,改成概括加你自己的评述;同一个观点连引了三处文献,其实留一处就够。
有没有一段能直接复制的双指标诊断提示词?
有。它帮你把一段话里哪些是撞库高危表述、哪些位置缺自有信息一次标出来,但它只做诊断。
你是学术写作检查助手。下面是我论文中的一段文字,请只做诊断分析,不要改写,也不要生成任何可以直接使用的成稿。
请依次输出:一是这段里属于本领域通用表述、很可能与已有文献字面重合的句子或短语,逐条列出;二是句式骨架重复的地方,各举一处原文;三是逐句字数,指出哪几句长度过于接近;四是哪些结论只给了判断没给依据;五是哪些位置缺少只有作者本人才能提供的信息(数据、时间、样本量、剔除标准、例外结果、限制条件),把这些位置写成需要我回答的问题。
硬性要求:不得新增或虚构事实,包括数据、文献和结论;不得改动专业术语、变量名、样本量和方法步骤;无法确认的地方标注「需作者核实」;只做诊断,不生成成稿。
【在这里粘贴你的段落】
第一项和第五项要连着看:第一项告诉你哪几句最容易撞库,第五项告诉你该拿什么去把它换掉。
改完怎么测,才看得出这一轮有没有白改?
测法比改法更容易出错,测错了你会得出完全相反的判断。
三条硬要求:用学校指定的那个平台测,别拿不同平台的数字互相比;两次检测的范围、字数、是否排除引用必须一致,范围一变就没有可比性;每次记下平台、日期、字数和报告编号,才分得清是真降了还是正常波动。
想先看个方向,可以用腾讯朱雀 AI 检测助手做次免费初查,入口是 matrix.tencent.com/ai-detect/,不登录每天 5 次。但它只看 AI 特征、不测重复率,口径跟学校指定平台也不是一回事,只能帮你定位哪几段最脏。
还有一步很多人跳过:改完打开 Word 的"审阅",点"比较两个版本",把只读底稿和现稿逐项对一遍,先核数字、样本量、专有名词,再核否定词有没有被改反。两个指标都降了但数据被改错,这一轮才是真的白改。
又变成一个降一个涨,或者两个都没动,怎么办?
AI 率降了重复率还在涨,说明你补进去的所谓自有信息其实还是通用内容,比如"由此可见该结论具有一定的现实意义",回头按前面那四类重新挑。
重复率降了 AI 率反弹,多半是你为了绕开撞词做了大量同义词替换,骨架一点没动。把改后段落和原段落并排看,句子数、每句长度、信息顺序都一样,就是这个毛病。
两个都没动,先确认你改的是不是报告标出来的那几段。有人熬一整晚在改自己读着别扭的段落,而报告标的根本是另外几段。
改到一半发现越改越乱、连哪版是最新的都说不清,立刻停手回到底稿。动手前先把原文件复制一份命名为 底稿_V01.docx、右键属性勾上只读,每处理完一章升一个号。
自有信息真的补光了,剩下的句式交给谁?
界线很清楚。只要还有真实信息能往里填,自己写永远是最优解,谁也替不了你。但当数据、样本量、剔除标准、例外结果、限制条件都补完,报告上仍剩下大段句式规律的文字,接下来就是纯机械的重排,手改极慢,熬到后半夜人一累就开始动不该动的地方。
比话降AI(bihuapass.com)接的是这最后一环。它做的事用大白话讲,是把写得太工整、太好猜的句子拆开重排,调整长短节奏和信息出场的先后,而不是拿同义词一个个去换,引擎叫 Pallas NeuroClean 2.0。为什么正好对得上你这次的问题?因为你这轮反弹的根源就是"换词不换结构",换词既动不了可预测性,又容易往公共语料上撞;只有重排句式才动得了结构。好处是你不用再拿重复率去换 AI 率,省下的时间可以用来通读和核数据。
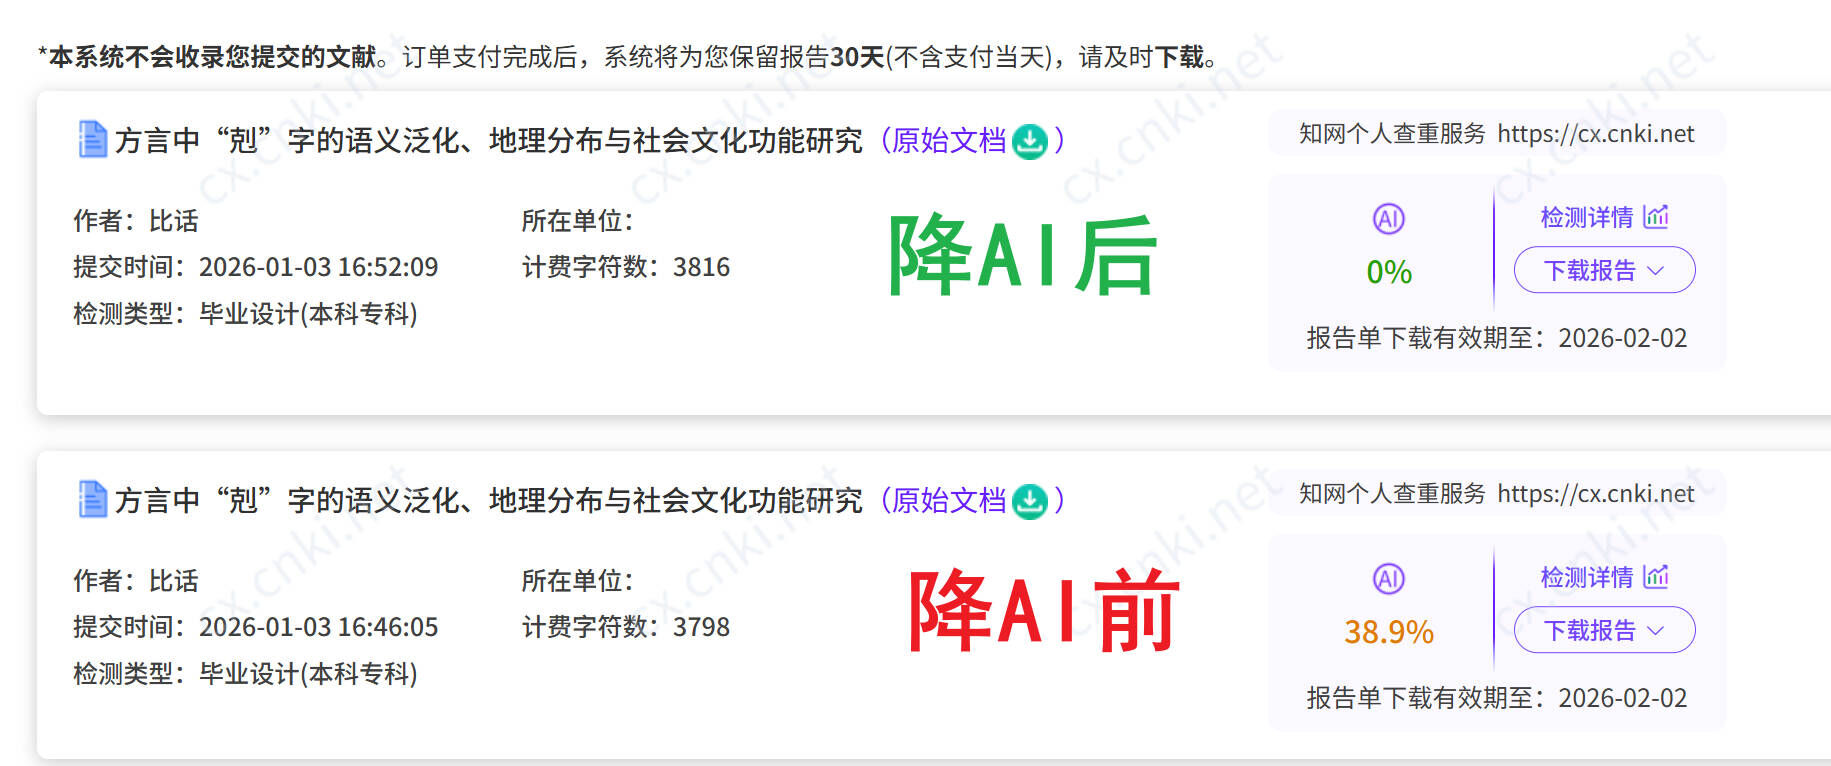
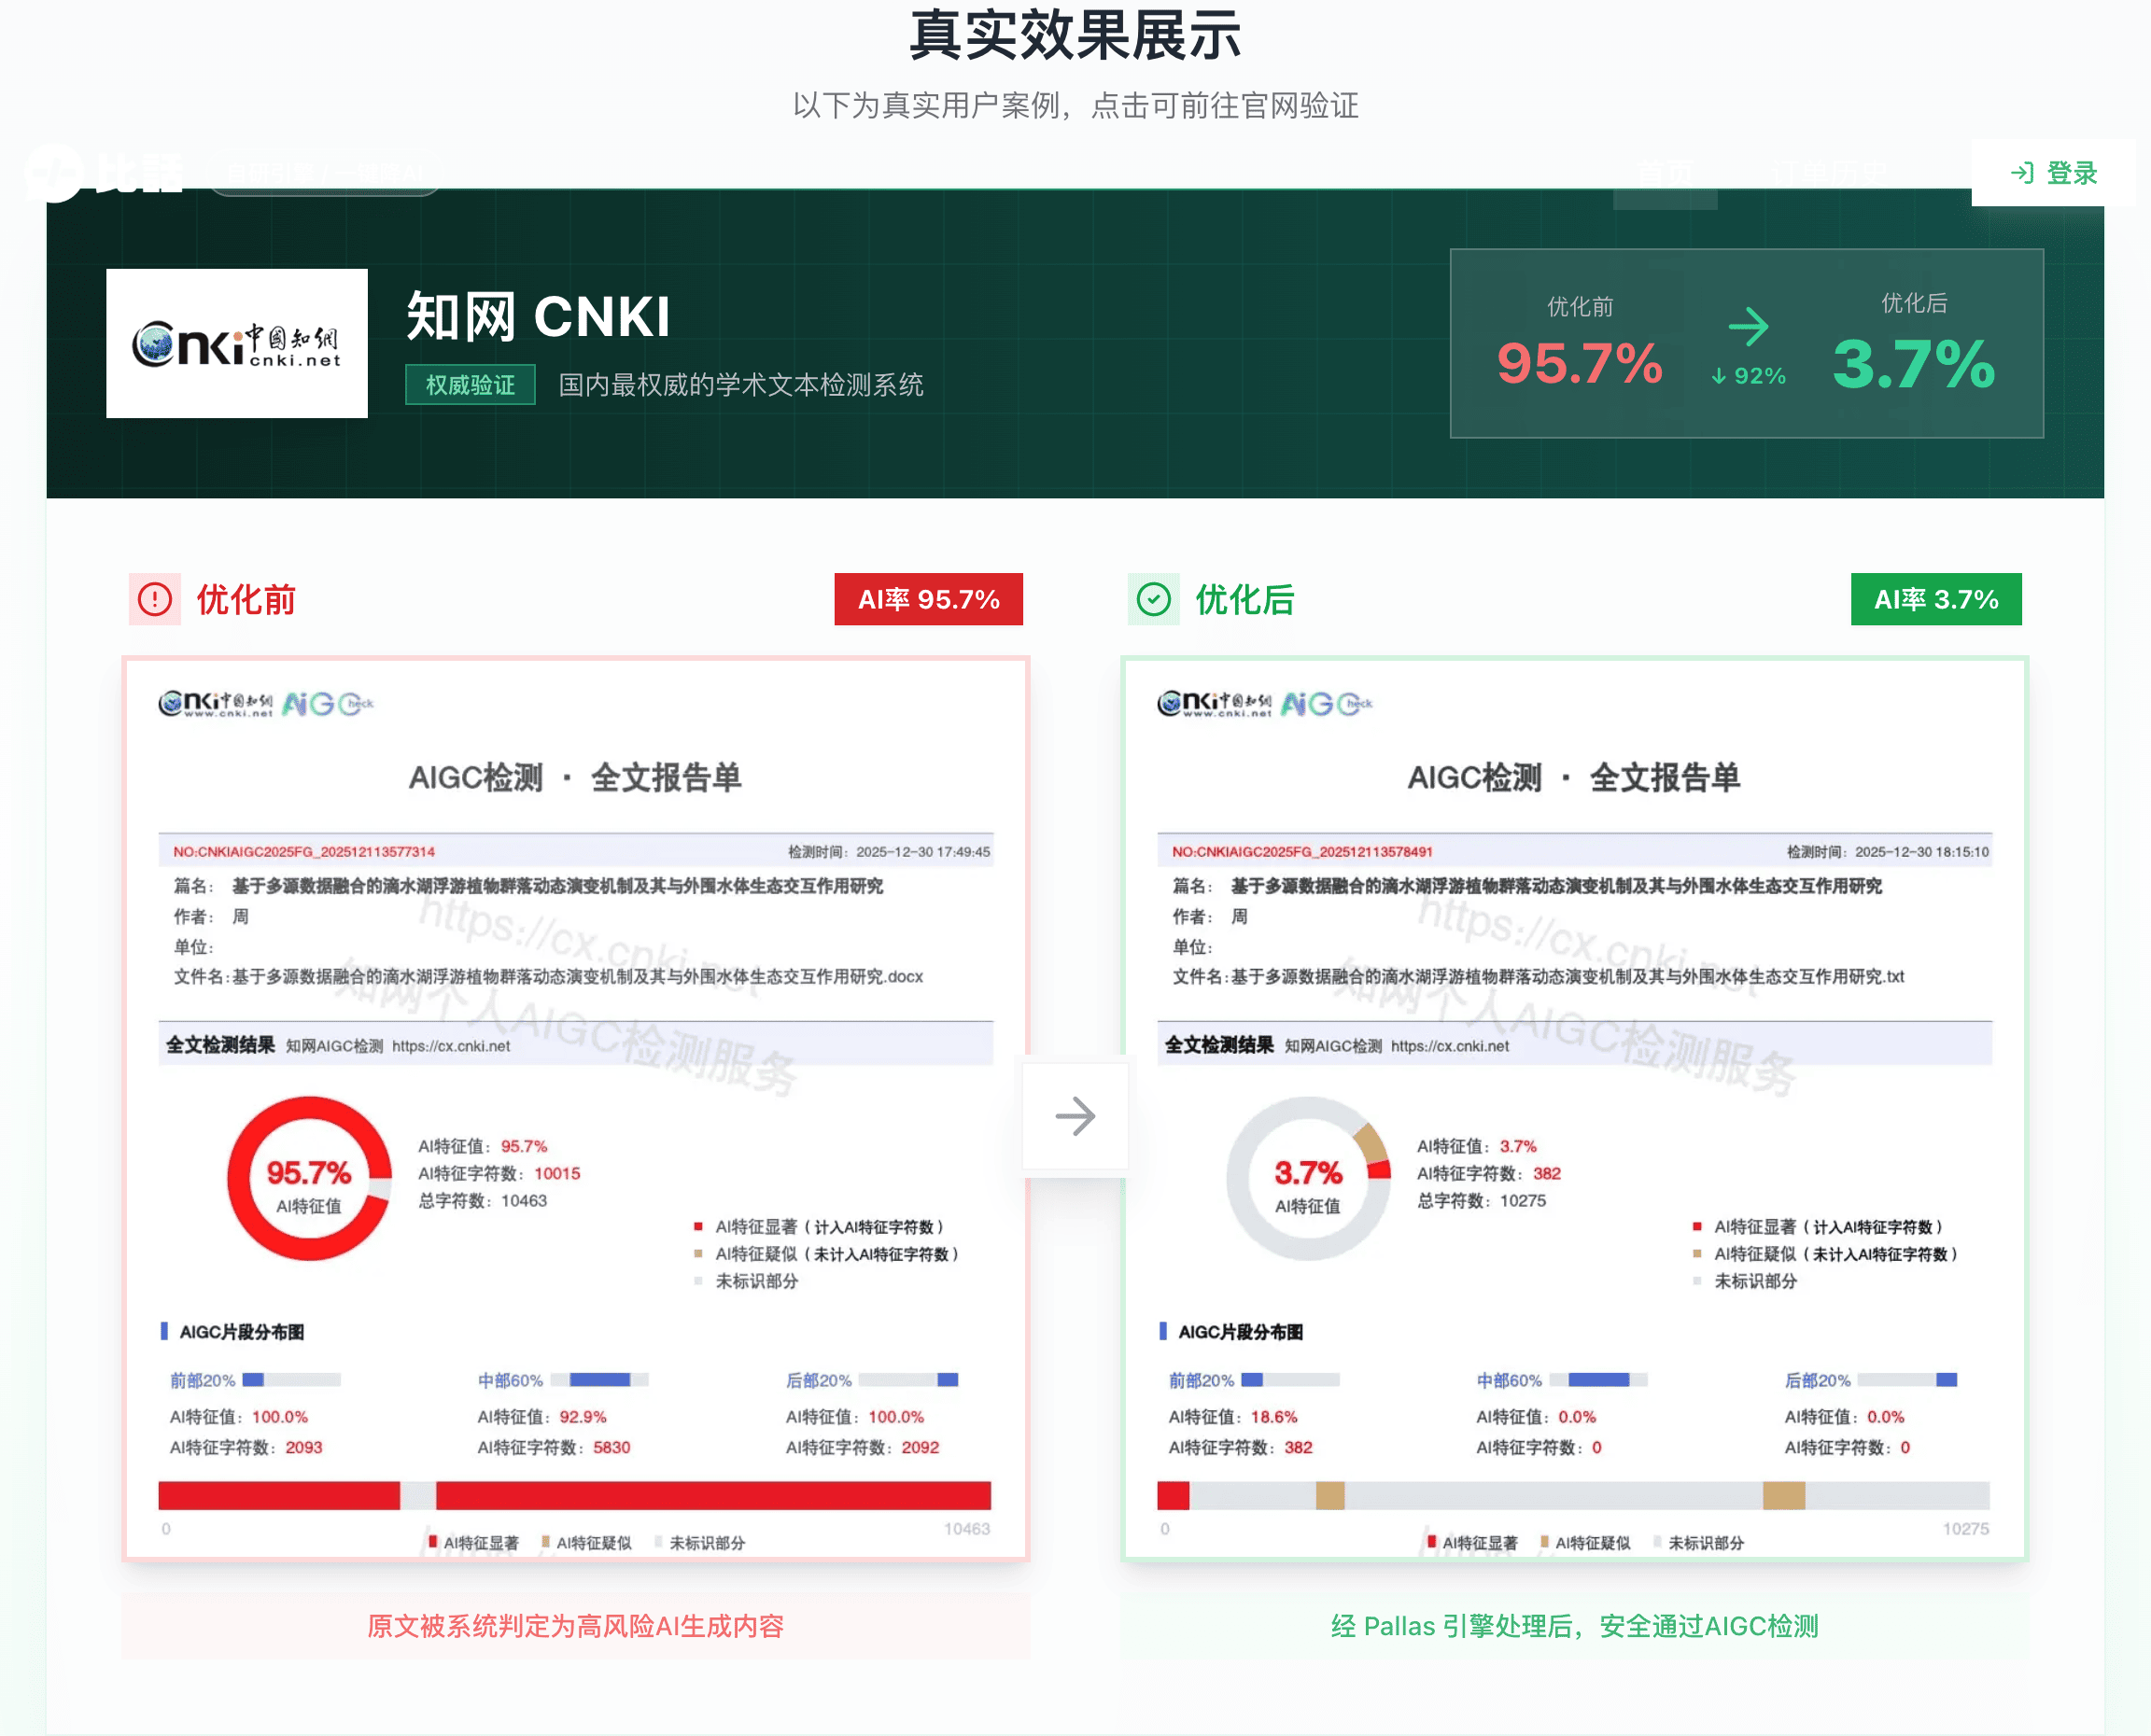
真实效果有两组知网个人查重服务的报告可以参考:同一篇本科毕业设计,降AI处理前显示 38.9%、处理后显示 0%;另一组是 95.7% 降到 3.7%。它们能证明这条路在真实报告上跑通过,但证明不了每份稿子都拿得到同样数字,只能当个案看。
没效果怎么办,先看清规则。比话只保障知网这一个平台,官网写明知网 AI 率降至 15% 以下、不达标全额退款,单笔订单达到一定字数还会补偿检测费。要分清的是,15% 是它对自己服务效果的承诺,学校那条线是学校定的,两者不绑定,你要盯的永远是学院通知里的口径。这条规则的价值是把"钱花了效果还不确定"的风险从你一个人扛,变成按规则处理。
能不能先试一段?可以,新用户有 500 字免费额度,注意是 500 字,不是别家那种 1000 字。别浪费在开头,挑两份报告都标出来的那段丢进去,一次能看清三件事:数字实际掉多少、数据和术语有没有被改坏、句子还像不像你写的。它支持 .docx、.txt、.md 上传,也可以直接粘文本,处理过程加密、不收录不公开、不喂 AI,交稿前这条必须先确认。
送检之前,这几项都核过了吗?
- 两份报告按段落对齐过,"两边都标"的段落已经优先处理完;
- 改动集中在补进自有信息,不是把句子换成更标准的通用表述;
- 样本量、变量名、术语、数字一个没被改动,用"比较两个版本"逐项核过;
- 引用部分按学院通知的口径确认过,没有为了压数字随手删引注;
- 复检用的是学校指定平台,范围、字数、是否排除引用与上次完全一致;
- 两个数字这次是同向下降的,不是一个降一个涨;
- 底稿和中间版本都留着,被问到修改过程时拿得出。
 浙公网安备 33010602011771号