
论文用豆包生成会有水印吗?知网AIGC检测查的根本不是水印!
论文用豆包生成会有水印吗?知网AIGC检测查的根本不是水印!
你担心的那个「水印」,到底是个什么东西?
你脑子里的画面大概是这样:豆包生成的时候悄悄往文字里塞了一段只有知网能读出来的暗号,你一交上去,系统一扫,全露馅。
先把这个画面拆开。被叫做"水印"的东西其实有三种,性质完全不同。
第一种是法定标识。《人工智能生成合成内容标识办法》要求服务提供者加两类标识,一类是给人看的显式标识,一类是写进文件元数据的隐式标识。这一层不能删、不能改、不能伪造,也不能隐匿。
第二种是不可见字符残留。大量用户发现某些模型输出里夹带过窄不换行空格、零宽空格这类字符。它确实存在,也能清掉,但跟知网AI率没关系。
第三种,才是你论文真正会栽的地方:写作痕迹。你的句子怎么排、信息怎么推进、有没有具体到别人猜不出来的细节。
我复制成纯文本了,是不是就安全了?
这个问题问得非常自然,但方向从一开始就偏了。
先回答字面上那半句:你从对话框里选中文字复制出来粘进 Word,元数据通常不会跟着走。元数据挂在文件上,不挂在字上。你复制的是纯文本,走的是剪贴板的文本通道,粘进 Word 另存之后生成的是一个全新的 docx,元数据字段是 Word 自己写的。
但接下来才是重点:就算一点残留都没有,你的AI率也不会因此降低半分。知网的AIGC检测压根不读文件里的那些字段,它读的是你写的字本身,看的是这些字排列出来的规律。
所以"复制成纯文本是不是就安全了",等于在问"把车牌摘了是不是就不会被拍超速"。测速看的是速度,不是车牌。
知网的AIGC检测究竟在看什么?
先说边界:知网没有公开完整算法和权重,任何号称"知道公式"的说法都不可信。能确定的是,这类检测普遍关注文本的可预测性,具体落在几个地方。
句子长度是不是接近。人写东西时长时短,写到得意处一口气二十多个字,下一句可能只有六个字,机器生成的长度往往挤在一个很窄的区间里。句式是不是同构,连着五句都是"主语加动词加宾语加一句补充",读起来很顺,但太顺了。搭配是不是高频,"具有重要的现实意义""随着……的不断发展"在语料里出现太多次,模型会优先选它们。推进是不是规律,先总后分、每段三点、每点两句,这种整齐本身就是可预测。
最后一条是分水岭:有没有别人猜不出来的细节。具体的样本量、反常的数据、一次失败的尝试,这些内容无法被预测,进入文本之后整段的变化性立刻上升。
摘要为什么几乎每次都被判高?
因为摘要天生就长得像机器写的,跟你用没用AI关系不大。
摘要的写法本身就是"目的、方法、结果、结论"的固定顺序,每部分各占一到两句,中间大量使用"本文旨在""结果表明""综上所述"。结构可预测、句式同构、搭配集中,三项一次命中。加上摘要篇幅短,几个规律句就能主导整段判定,几乎没有容错空间。
看一段典型的高AI率摘要:
本文旨在研究直播电商对县域农产品销售的影响。本文采用案例分析法,对某县进行了调查研究。结果表明,直播电商对农产品销售具有显著的促进作用。综上所述,应大力发展农村电商直播。
四句话对应四个模块,句长接近,套话齐全,全程没有一个具体数字。
改后:
直播电商对县域农产品的带动作用被讲得很多,但带动的是哪一类品项、代价是什么,讨论得不多。本研究跟踪了赣南某县 2024 年 3 月至 12 月的 47 场助农直播,逐场记录场观、成交额和退货率。脐橙这类标准化品项的场均成交额增长明显,而蜜薯因为分拣标准不统一,退货率一度到 18%,抵消了大部分增量。这说明真正的瓶颈可能不在流量端,而在分拣和履约。
一步步看做了什么。删掉四个套话开头,开场换成一个存在争议的空白点;把"某县"换成具体时间跨度和 47 场这个数字;把"显著促进"拆成两类品项的不同表现,其中一类是负面结果;把"应大力发展"换成有条件的推断。句子长度也从整齐变成长短交错。
这样改有效,是因为 47 场、18%、蜜薯分拣这些信息机器猜不出来,它们一进来,可预测性就掉了。
文献综述和研究方法为什么紧跟着中招?
文献综述最常见的写法是"作者加年份加观点"一句一条往下罗列。每句长度接近、句式相同,正好是低变化性文本的典型形态。改的方向不是换词,是把"一人一句"改成"共识在哪、分歧在哪、还缺什么、我的研究站在哪",句式自然就不整齐了,而且这本来就是综述该做的事。
研究方法中招的原因不一样。标准方法的描述天然模板化,"共发放问卷 300 份,回收有效问卷 280 份"谁写都差不多。这一段别硬改成花哨说法,方法必须准确,可行的做法是补充只有你才知道的执行细节:为什么选这个样本框、中途遇到什么问题、哪几份因为什么作废。补细节比换句式安全。
对比之下数据分析那一段往往最干净,因为里面全是具体数字、异常值和你自己的判断。
这条链走完,结论就很清楚了:你要降的不是"AI用量",是文本的可预测性。
有没有一段能直接复制的诊断提示词?
有。但只让它诊断,别让它替你写成稿,否则你只是把一版机器味换成另一版。
你是学术写作检查助手。下面是我论文里的一段。请只做分析,不要改写,也不要生成可以直接使用的成稿。
请依次输出:这一段中重复出现的句式结构,各举一处原文;高频套话和固定搭配清单;哪些句子只有结论没有依据;哪些位置缺少只有作者本人才能补充的信息(样本量、时间跨度、异常值、失败的尝试、数据来源),把它们改写成需要我回答的问题;全段句子长度分布,指出是否过于均匀。
硬性要求:不得新增或虚构文献、作者、年份、数据和研究结论;不得改动专业术语、实验参数、样本量和方法步骤;无法确认的地方标注"需要作者核实";只做诊断,不生成成稿。
【在这里粘贴你的段落】
拿到问题清单之后你自己回答,把答案写回论文,这是降AI率效率最高的一步。
顺便把不可见字符清一下,它不影响分数,但会让排版出现莫名其妙的间隙。Word 里按 Ctrl+H 打开查找和替换,点"更多"勾选"使用通配符",查找内容框里依次输入 ^u8203、^u8204、^u8205、^u8239、^u160,替换为留空或普通空格,点全部替换。做之前先把原稿另存成 0819_底稿_V01.docx 并勾上只读。清完把可疑段落贴进 VS Code,打开 Render Control Characters 看还有没有异常方框。
手改到什么程度就该换工具?
界线是这样的:还能往里补真实信息的地方,自己改最好也最安全;补无可补、纯粹剩一大片句式要重写的地方,手改非常慢。三万字论文标红面积过了三分之一,逐句重写通常要几十个小时,改到后半程人会疲劳,开始动数据和术语,那才是真正的风险。
比话降AI(bihuapass.com)接的就是这一环,做的事情是把AIGC痕迹一键去除。它背后那套引擎叫 Pallas NeuroClean 2.0,知道有这么个东西就够了,说人话是:它不做"提升"换"提高"这种同义词替换,而是去找那些写得太工整、长得太像的句子,重新安排句子的长短和信息出现的先后。这正好对上前面分析出来的原因,检测看的是可预测性,换词换不掉,只有把结构打散才动得了。
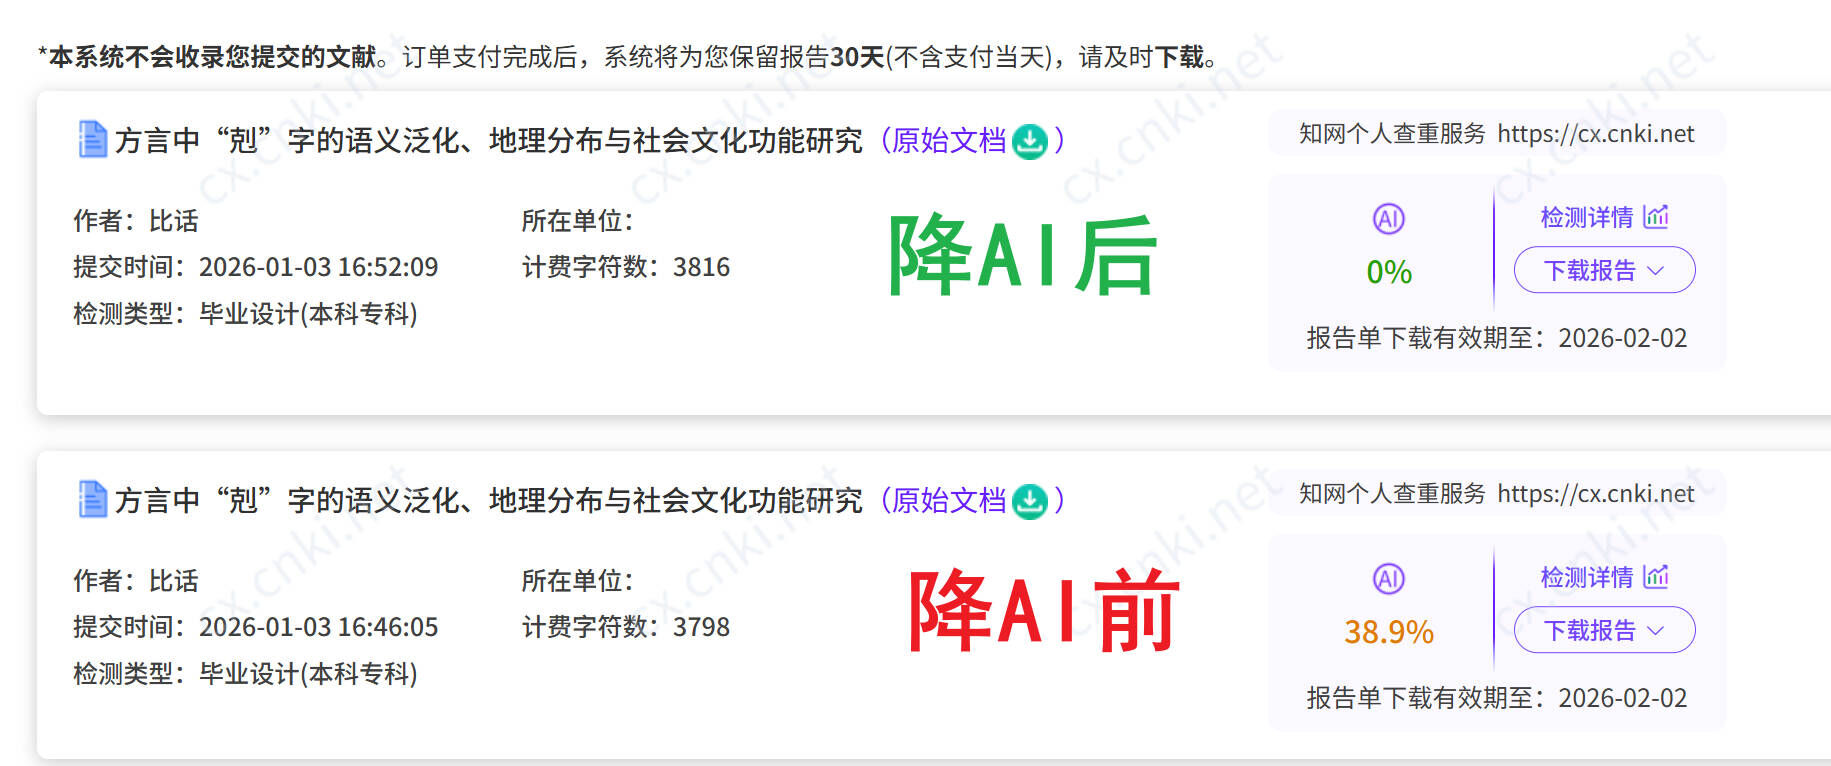
你最想知道的应该是它到底有没有真效果。有一个可以看的例子:知网个人查重服务出的报告显示,同一篇本科毕业设计降AI前是 38.9%,处理后是 0%。这个例子能证明改结构这条路在知网口径下确实动得了数字,不能证明任何论文都会降到 0。别拿单个案例当承诺,拿它当"这条路走得通"的证据就好。
没效果怎么办这件事,官网首页写的是知网AI率降至 15% 以下,不达标全额退款,单笔订单达到一定字数还会补偿检测费。这里要把两条线分清楚:这是产品对自己服务的承诺,不是你学校的红线。学校要求 10% 还是 20%,通知里怎么写就以那个为准。它只保障知网这一个口径,你们学校用别的系统,这份承诺套不过去。
能不能先试也很好办。免费额度是 500 字,别记成 1000。正因为只有 500 字,别拿开头随便一段去填,挑你改了两遍还是觉得别扭的那一段,最典型的就是摘要。支持 .docx、.txt、.md 上传,也可以直接粘文本,文档加密处理、不收录不公开、不拿去喂AI。这 500 字用完你能同时确认三件事:数字实际掉了多少、术语和样本量有没有被改错、语言风格你能不能接受。在付款之前搞清楚,就不会出现整篇处理完才发现不能用。
改完分数没降,问题出在哪一步?
分四种情况处理,别一上来就推倒重写。
第一种,数字几乎没动。大概率是只换了词没换结构。回头看改后的段落,如果句子数量、每句长短、推进顺序跟原来一样,那等于没改,必须去动结构:合并短句、拆开长句、把结论往后放。
第二种,这段降了全文没降。问题不止一处,回报告按标红面积从大到小逐段处理,别挑最容易的先改。
第三种,AI率降了重复率涨了。这是最常见的反弹,原因通常是改写时往通用表述上靠,撞到了公共语料。办法是换成你自己的数据和案例,而不是换成另一种通用说法。
第四种,术语被改错或逻辑被改反。立刻从底稿恢复这一段重来,然后进 Word 走"审阅、比较、比较两个版本",第一遍只看数字、专名、引用和否定词,第二遍看逻辑,第三遍才看语言。
送检之前还要核对哪些?
- 底稿和终稿比对一遍,数字、样本量、术语、引用标注、否定词全部没被动过;
- 摘要里的目的、方法、结果、结论四项还在,字数仍在学校要求范围内;
- 文献综述里没有新增文献、没有改动年份、没有把作者观点归纳错;
- 用学校指定的那个系统、同样的文件范围复检,不拿其他平台的报告去交差;
- 确认AI率降下来的同时重复率没有反向升高;
- 底稿和每个中间版本都留着,被问到修改过程时你拿得出来。
 浙公网安备 33010602011771号