
AI生成内容标识新规实施后,自媒体的稿子还能不能用AI写?
AI生成内容标识新规实施后,自媒体的稿子还能不能用AI写?
新规到底管什么,会不会直接禁掉AI写稿?
你现在最想确认的大概就一件事:以后自媒体的稿子还能不能让AI搭把手。能。这份办法管的不是"你有没有用",管的是"用了之后有没有让人知道"。
《人工智能生成合成内容标识办法》由国家网信办、工信部、公安部、广电总局四部门发布,2025年9月1日起施行,配套一份强制性国家标准 GB 45438-2025。它的落点全在"标识"两个字上。你用豆包搭提纲、让 DeepSeek 铺一版初稿、自己再重写一遍,这套流程本身没有被禁。被明确禁止的是另外几件事:恶意删除标识、篡改标识、伪造标识、隐匿标识,以及对外提供专门用来去掉标识的工具或者服务。
所以这篇不会给你任何"抹掉标识"的做法,那条路已经被堵死了。这篇要回答的是另一个更实际的问题:标了之后,你的稿子凭什么还能被人读完、还能被推出去。
显式标识和隐式标识,哪一个要你自己动手?
办法里的标识分两种,你真正需要操心的只有其中一种。
显式标识是给人看的。它出现在生成内容本身或者交互界面里,用文字、声音、图形呈现,要求是用户能明显感知。你刷到的那个挂在内容旁边的"AI生成"角标,就是这一类。
隐式标识是给机器看的。它用技术手段写进文件的元数据里,你平时不容易察觉,里面装的是生成合成内容属性、服务提供者名称或者编码、内容编号这些信息。这一层由服务提供者添加,不需要你手动去加,也不该由你去动。
要你动手的是前一种。发布页面上出现"内容由AI生成"这类声明选项时,如实勾上就行。这是义务,同时也是最省事的做法:与其等着被判定,不如自己先说清楚。
从对话框复制纯文本过来,元数据会不会跟着走?
这是被问得最多的一个担心:我从豆包对话框里选中、复制、粘进公众号后台,是不是就把那段信息一起搬过来了。
多数情况下不会。道理很朴素,元数据挂在文件上,不挂在字上。你复制的是纯文本,走的是系统剪贴板的文本通道,文件层面的字段并不在里面。你把它粘进 Word 再另存,生成的是一个全新的 docx,元数据是 Word 写的,跟原来那个对话框没关系。
但别把这件事理解成"那我就不用标了"。文件里有没有那段信息,和你在平台发布时该不该声明,是两条互不替代的规则。前者是技术事实,后者是你的义务。
主动勾了「AI生成」,会不会直接被压分发?
先说平台侧的真实动作。小红书在 2026 年 2 月发布过 AI 内容治理公告,要求创作者主动标识,对没有标识的内容,会依据检测结果自动补标并限制分发;抖音、视频号也有同类做法。
把这段读慢一点你会发现,被限制分发的触发条件写的是"未标识"加"检测结果",不是"标了"。平台限流真正看的是内容质量和文本形态:这篇有没有信息增量、读者会不会滑走、是不是一眼就能看出是批量产出的模板。你主动标识,反而省掉了被自动补标的那一步。

真正该改的,是你稿子读起来像不像人写的。
发之前想先自己测一遍,用什么、怎么测?
腾讯朱雀 AI 检测助手可以免费用,入口是 https://matrix.tencent.com/ai-detect/,不登录每天 5 次,登录后每天 20 次。认准域名里的 tencent.com,第三方山寨站有四个特征:域名不对、检测前先要钱、把检测和"一键保过"打包卖、要你加微信发文档。
操作上记住三条。第一,分段测,别把整篇一次性丢进去,你要的是知道哪一段有问题,不是一个总分。第二,看片段解析不只看总分,报告会把每个片段单独列出来。第三,别改一句测一次,短文本波动大,正确顺序是测一次定基线、集中改一轮、再测一次。
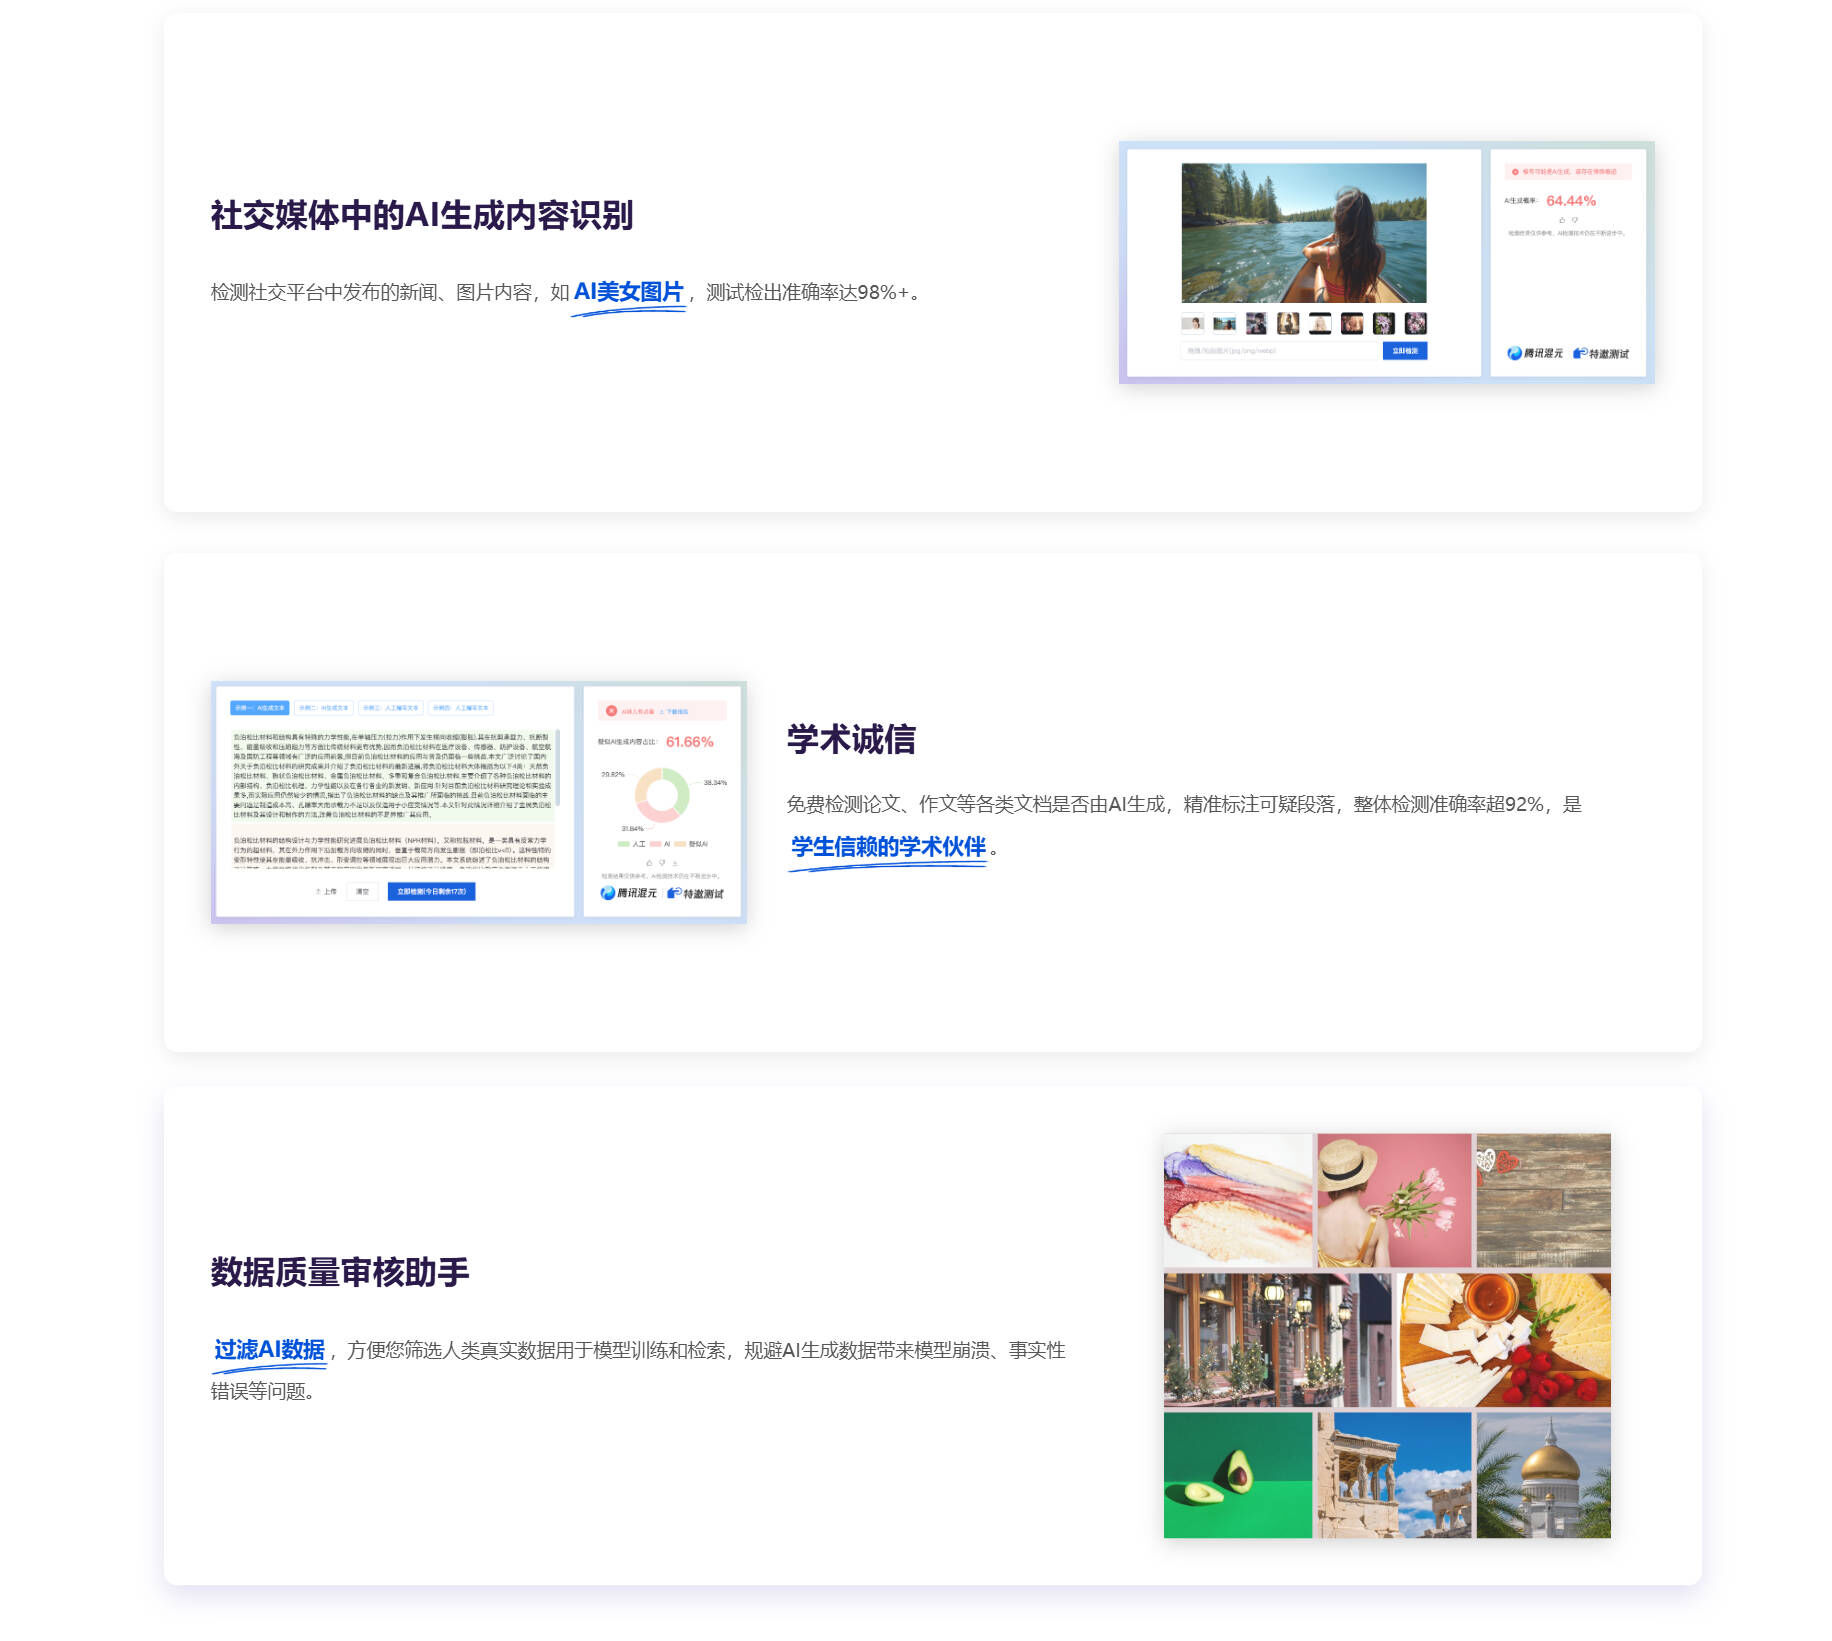
还有一个很多人读错的地方:报告里那个 AIGC 值是 0 到 1 的分值,不是百分比,口径是 0 到 0.5 属人工特征、0.5 到 0.99 属疑似 AI、0.99 以上落进 AI 特征区间。所以 0.9970 的意思是"落进了 AI 特征区间",不是"99.7% 的 AI 率"。圆环图里的百分比才是真的百分比。
一段稿子的AI味具体长什么样,怎么改掉?
看一个典型的 AI 开头:
在快节奏的现代生活中,越来越多的人开始关注居家收纳。合理的收纳不仅能提升空间利用率,还能改善生活品质。本文将从三个方面为大家详细介绍居家收纳的实用技巧。
问题不在用词,在于这三句话谁都能预测到下一句是什么。第一句是万能起手式,换成任何话题都成立;第二句是两个并列好处,没有一个具体到能被质疑;第三句预告"三个方面",等于告诉读者接下来是模板。
改后:
我家玄关一米二宽,去年冬天塞了七双鞋,进门得侧着身子走。上个月换成上下两层的窄鞋柜,按季节分开放,现在能正面走进去了。下面这几招是我自己试完留下来的,试过但没用的我也会说。
对着看做了什么。开头换成一个只有你才知道的场景,一米二和七双鞋这种数字别人替代不了;把"提升空间利用率"这类抽象收益换成"能正面走进去"这个可以想象的画面;把"本文将从三个方面"换成一句带风险的承诺,说明有失败案例也会讲。句子长短也从整齐变成了长短交错。
改的逻辑就一条:把别人猜得到的话,换成只有你能提供的信息。
有没有一段能直接复制的诊断提示词?
有,但只让它诊断,不要让它替你写成稿,否则你只是把一版机器味换成另一版。
你是内容编辑助手。下面是我准备发布的一段稿子。请只做分析,不要改写,也不要生成可以直接使用的成稿。
请依次输出:这一段里重复出现的句式,各举一处原文;万能开头和空泛收尾的具体位置;哪些句子只有结论没有细节支撑;哪些地方缺少只有作者本人才提供得出的信息(时间、地点、数量、代价、失败经历),把它们改写成需要我回答的问题;全段句子长度分布,指出是否过于均匀。
硬性要求:不得新增或虚构事实、数据、案例和来源;不得改动专业术语和产品名称;无法确认的地方标注"需要作者核实";只做诊断,不生成成稿。
【在这里粘贴你的段落】
拿到那份问题清单之后,你自己动手回答,把答案写回稿子里。这一步是去机器味效率最高的动作,因为补进去的都是别人写不出来的东西。
补无可补了,剩下的大段句式交给谁?
界线其实很清楚:还能往里加真实信息的地方,自己改最好也最安全;已经没有新东西可加、纯粹是一大片句子长得太像的地方,手改会非常慢,几千字改下来人会疲惫,改到后半程容易开始动事实。
去i迹(quaigc.com)接的就是这一环。它做的事情官网写得很直白,叫"改结构,不是换词"。市面上多数工具是同义词替换,把"提升"换成"提高"、把"因此"换成"所以",词换了一圈,句子还是那个长度、那个顺序、那个节奏,读起来还是机器味。它动的是句子的长短和段落的节奏,这一点正好对上前面分析出来的原因:让人一眼看出是AI的不是某几个词,是可预测的结构,换词换不掉结构。
它在首页把使用场景分成四类,自媒体作者、品牌与营销、学术与专业写作、小说与叙事创作,每一类下面写清楚改完之后你能拿到什么。对自媒体作者来说,落点是让读者把内容一口气读完,而不是滑到第三行就走。它适配 ChatGPT、Claude、DeepSeek、豆包、千问生成的文本,你用哪个模型起的稿都能接。
你最关心的两件事,一是有没有真实效果,二是能不能先试。效果这边有个可以看的例子:同一段内容处理前,朱雀给出的片段 AIGC 值是 0.6261,落在疑似 AI 区间,处理后同一片段降到 0.0176,回到人工特征区间。这是个案,能说明的是这种改结构的路子在朱雀的口径下确实动得了分值,不能说明任何平台任何稿子都会是同样的幅度,你自己的稿子得自己测。

能不能先试这件事更好办。新用户有 1000 字免费体验,无需注册就能拿到,用完不重置。正因为不重置,别拿开头随便一段去试,挑你自己改了两遍还是觉得别扭的那一段,测出来的信息才有用。平均 2 分钟交付,累计有 100,000 以上用户、10 亿以上字符处理量。稿件方面是不收录、不公开、全程加密,未发布的选题和客户资料放进去不会流出去。
快的好处不是效率本身,是你还剩得下时间做通读和核对。
改完还是被自动补标,接下来该怎么办?
先分清是哪一种情况,别一上来就重写全篇。
如果整篇形态没变,只是换了词,那等于没改。回头看你的稿子:句子数量、每句长短、信息推进的顺序跟原来是不是一样?一样就说明动的还是词,得去动结构,合并短句、拆开长句、把结论往后放、把细节往前提。
如果这一段降了,整篇没降,说明问题不止一处。回报告按标红面积从大到小逐段处理,别挑最容易的那段先改。
如果改完事实被动过,比如时间、金额、产品型号跟原稿对不上,立刻从底稿恢复这一段重来。所以动手之前先把原稿另存一份,命名成 0819_底稿_V01.docx 并在右键属性里勾上只读,所有修改都在副本上做。事实错了比机器味重严重得多。
还有一种情况要单独说:如果平台已经给你的内容补了标识,那就让它标着。想办法去掉它是违规的,正确的动作是把内容本身改到值得被推荐,然后自己主动声明。
发稿前还要核对哪些?
- 平台发布页里的AI生成声明选项,该勾的已经勾上;
- 稿子里没有任何删除、篡改、隐匿标识的操作痕迹;
- 开头三行里已经有一个具体的时间、地点或者数量;
- 通篇搜一遍"综上所述""总而言之""在当今社会",还剩几处;
- 用底稿和终稿比对,确认数字、专名、产品型号、否定词没有被改动;
- 分段复测一次,看之前分值最高的那几段现在落在哪个区间;
- 记下这次复测的日期、字数和结果,下次改稿才有基准;
- 确认删掉AI辅助的部分之后,这篇里仍然有你自己的判断和经历。
 浙公网安备 33010602011771号