
零宽字符和特殊空格都删干净了,AI检测为什么还是判定成AI写的?
(平台提示:本文可能是商业推广软文)
零宽字符和特殊空格都删干净了,AI检测为什么还是判定成AI写的?
你都删干净了,分数为什么一动不动?
你照着教程做了一整套:Word 里用通配符把 U+200B 零宽空格、U+200C、U+200D、U+202F 窄不换行空格、U+00A0 不间断空格挨个替换掉,又把正文倒进记事本走一遭再粘回来,最后用 VS Code 打开 Render Control Characters 确认过,一个异常方框都没有。
然后你去复测,分数几乎没动。
这不是你哪步没做对,是这两件事本来就不相干。删字符动的是文件里的字节,检测读的是这段话的可预测性。你把不可见字符全清了,句子还是那些句子,长度还是那个长度,句式还是那个句式,检测拿到的输入跟之前一模一样,输出当然一样。下面把中间的因果链一节一节接给你看。
那些零宽字符到底是从哪来的?
先给它们一个准确的身份,你才知道该怎么对待。
这批字符真实存在,不是传说。大量用户发现 ChatGPT 的部分模型(GPT-4o、o3、o4-mini 一类)输出里夹带 U+202F 窄不换行空格,以及 U+200B、U+200C、U+200D 这一组零宽字符;GPT-5 非推理版也被开发者报告频繁插入 U+202F,导致 macOS 上排版错乱。OpenAI 的解释是,这是在大量多语种、专业排版语料上训练出来的副产物,U+202F 在法语排版里本就是正规用法,不是刻意加的水印,后续已减少这类输出。
所以它们的身份是排版残留,不是标识,更不是《人工智能生成合成内容标识办法》里那两种标识。那套办法2025年9月1日起施行,显式标识是你能看见的角标和文字提示,隐式标识是加在文件元数据里的属性信息,并明确禁止恶意删除、篡改、伪造、隐匿标识。清排版残留跟那件事不是一回事,但也正因为它只是排版残留,清掉对分数没有帮助。
检测读你这段话的时候,究竟在读什么?
这是整篇最关键的一节,请慢一点看。
知网、维普、万方、朱雀这一类检测,没有公开完整算法和权重,任何精确到公式的说法都不可信。但它们的共同取向是清楚的:判断这段文字有多好猜。
具体落到几处。句长是不是接近,人写东西会突然冒一句很短的话,模型不太会。句式是不是同构,连着三句都是"什么是什么的关键",这种整齐度在人的自然写作里很少见。搭配是不是集中在高频区间,"深刻变革""广泛应用"这类组合,模型选它们的倾向远高于普通人。信息推进是不是规律,一个观点加一句解释加一句总结,规律得像模板。有没有无法预测的细节,一个具体时间、一个不整的数字、一句原话、一次失败,模型编不出来也猜不到。
现在把因果链接起来:检测的输入是这段话词与词的排列关系,不可见字符在分词那一步就被当噪声处理掉了,从来没进过判断依据。你删掉它,等于删了一个从没被读过的东西。反过来,只要句长、句式、搭配、推进方式没变,检测拿到的排列关系就没变。这就是删字符和降分数动的是两个东西的原因。
真正的文本水印,长什么样?
有一个东西是真水印,拿它做对照你就明白差别在哪了。
Google DeepMind 的 SynthID-Text,做法是在模型生成的那一刻动手。模型每写一个词,都要从若干候选里挑一个,SynthID 用一种叫 tournament sampling 的方式,让候选词按一套只有持有密钥的一方知道的规则两两比较、层层淘汰,最后选出来的那个词依然通顺,但整篇文章的选词分布里被嵌进了一层统计信号。检测的时候,用同一套密钥去核对这层信号在不在,就能判断是不是这个模型写的。它已开源,进了 Hugging Face Transformers v4.46+。
它的弱点也公开写明了:改写、回译、复制粘贴式的改动会显著削弱可检测性。道理不难懂,信号靠原始选词序列承载,你把句子重写一遍,序列就散了。
那国内的AIGC检测是不是也这么做的?
不是,而且做不到,原因在两个前提上。
第一个前提是生成端必须配合。SynthID 要在生成时嵌信号,模型不接这套东西,文章里就没有信号可读。你手上这篇稿子可能出自任何一个模型,甚至是几个模型接力写的,再被你自己改过两轮,检测方拿到的只是一段光秃秃的文字。
第二个前提是检测端必须有密钥。核对信号要用生成时那套配置,密钥在模型提供方手里。中文论文和内容检测面对任意来源的稿子,既不知道你用了什么,也拿不到密钥。
两个前提都不成立,剩下唯一能走的路就是从文本本身的统计特征下手。所以你会看到一个反常识但很确定的结论:国内主流的AIGC检测,压根不在乎你那些零宽字符,它只在乎你的句子好不好猜。
同一段话,改前改后差在哪?
原句:
数字化转型已成为企业发展的必然趋势。企业需要不断提升自身的数字化能力。只有这样才能在激烈的市场竞争中保持优势。
三句话,长度接近,全是判断没有依据,"必然趋势""不断提升""激烈的市场竞争"全是高频搭配,信息推进是观点加观点加总结。它好猜到什么程度呢?你读完第一句,基本能替它写出第二句。
改后:
我们厂去年上了一套排产系统,第一个月产量反而掉了百分之七。原因很土:老师傅习惯把急单口头插进去,系统不认口头。后来是把插单权限单独开给了车间主任才顺过来。所谓数字化能力,很多时候就是这种谁也没写进方案里的小口子。
改的理由逐处说。句长从三句均匀变成长短交错,最短那句只有四个字。加进了"百分之七""车间主任"这类没人替你猜得出的信息。结论从开头挪到了结尾,推进顺序不再是模板顺序。"原因很土"这种口语判断,模型不太会主动用。这几处动的全是结构和信息,一个不可见字符都没删,分数动的正是这类改动。
有没有一段提示词能帮我找出好猜的句子?
有。只让它诊断,不要让它出成稿,否则你只是把一种好猜换成另一种好猜。
你是中文写作检查助手。下面是我的一段文字。请只做分析,不要改写,也不要生成可直接使用的成稿。
请按顺序输出:
一、逐句列出字数,指出句长分布是否过于均匀;
二、结构相同或高度相似的句式,各摘一处原文;
三、高频搭配和固定套话清单;
四、只有判断没有依据的句子;
五、缺少具体时间、数字、人物、原话、失败经历的位置,把每处缺口改写成需要我回答的问题。
硬性要求:不得新增或虚构事实、数据、文献和结论;不得改动专业术语、参数、样本量和方法步骤;无法确认的地方标注"需作者核实"。
【在这里粘贴你的段落】
第五项的问题清单最值钱。你自己回答,把答案写回去,这一步降分效率最高。
改完分数还是不动,问题出在哪一步?
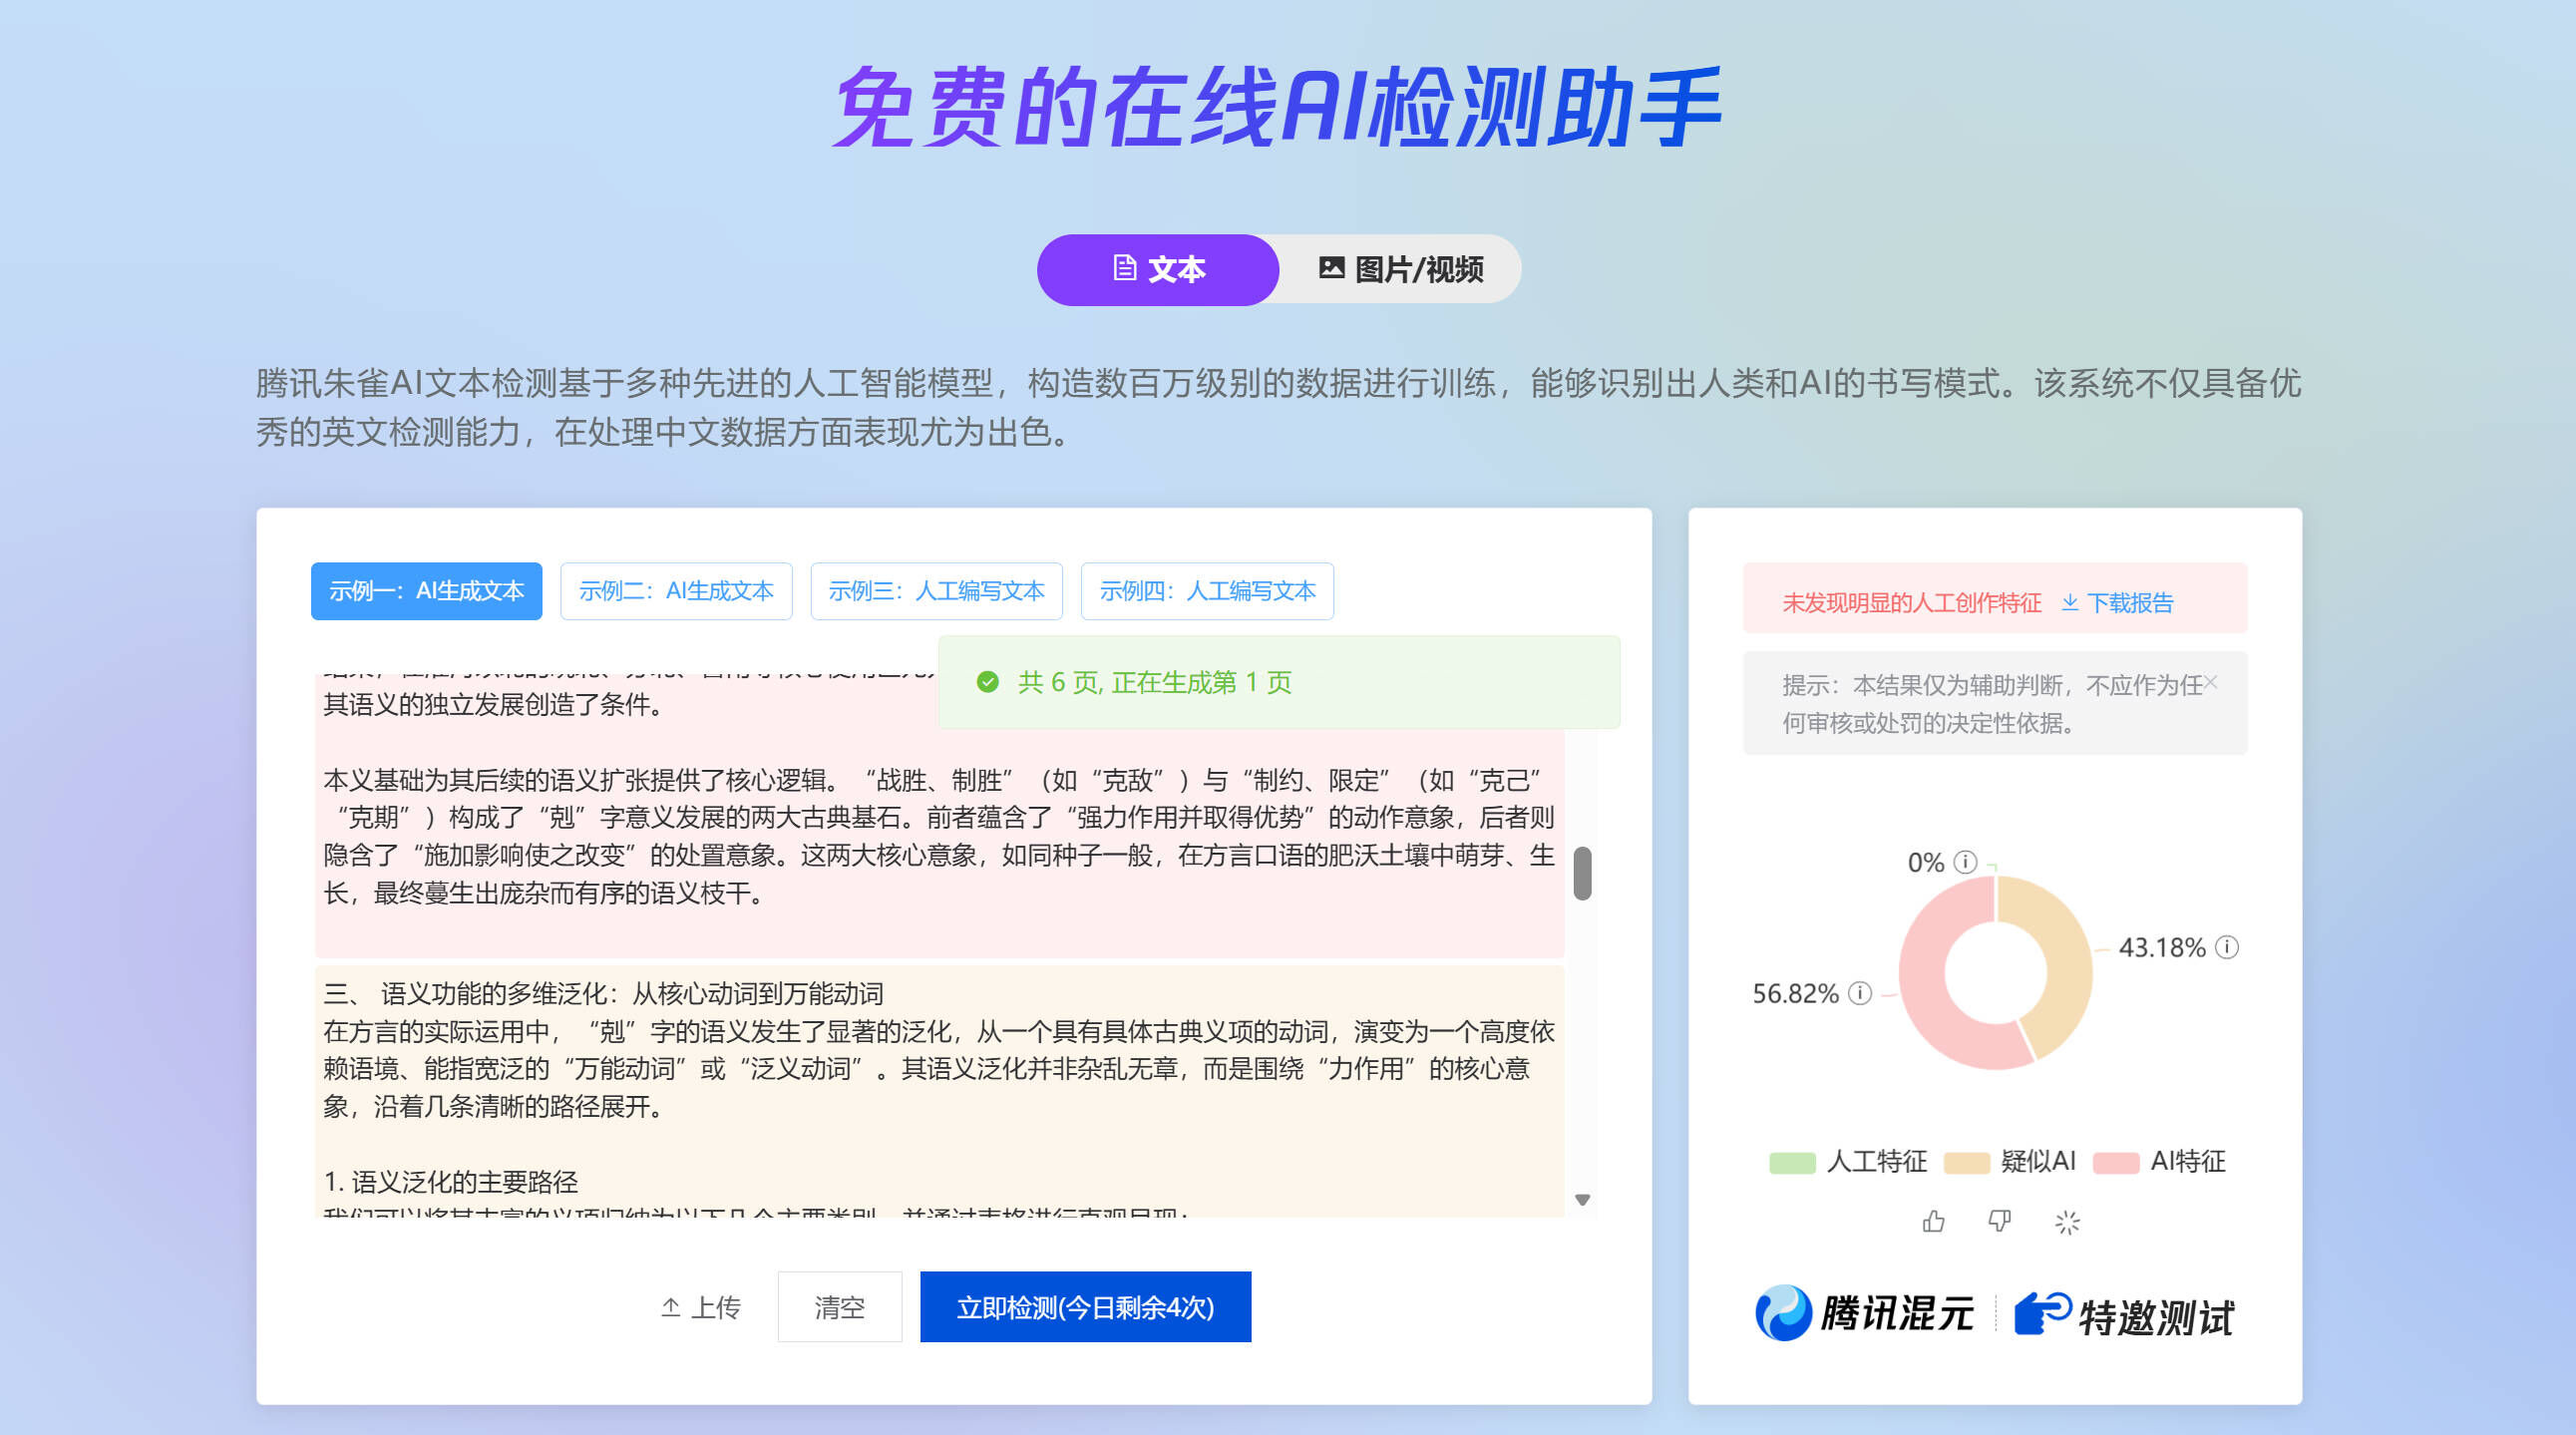
想有个可比的基准,先用腾讯朱雀AI检测助手测一次,入口 https://matrix.tencent.com/ai-detect/,免费,不登录每天5次,登录后每天20次,认准域名里的 tencent.com。测法三条:分段测别整篇丢进去,看片段解析不要只盯总分,别改一句测一次,短文本波动大,测一次定基线、集中改一轮、再测一次。读法也说一句,朱雀给的AIGC值是0到1的分值不是百分比,0到0.5是人工特征、0.5到0.99是疑似AI、0.99以上落进AI特征区间,所以0.9970是落进了AI特征区间,不是"99.7%的AI率"。
分数不动通常是四种情况。第一种,你只换了词。改前改后并排看,句子数量、每句字数、信息出场顺序都一样,那就是没改。第二种,你只改了最好改的那几段,标红最重的那块还原封不动。第三种,你补的"细节"是编的,既没用又危险,补进去的必须是你真有的东西。第四种,改坏了,术语、数字、参数、否定词被动过。这比分数高严重得多,回底稿重来,改完先只核对数字和专名,第二遍看逻辑,第三遍才看语言。
剩下的大段同构句子,该交给谁?
界线很清楚:还能往里补真实信息的地方,自己写最好也最安全;补无可补、只剩几十段句式要重组的地方,手改会慢到你放弃。三万字标红过三分之一,逐句重写通常要几十小时,改到后半程人一累就开始动事实,这才是工具该进场的位置。

去i迹(quaigc.com)做的正是这一环,定位是让AI写的内容读起来真的像人写的,官网把自家做法写成一句话,改结构不是换词。这跟本文的因果链是同一件事:你删字符没用,是因为动的不是判断依据;多数工具靠同义词替换也没用,是因为换掉词以后句子的长短和段落节奏一点没变,检测读到的排列关系照旧。它调整的就是句子长短的搭配和段落推进的节奏,ChatGPT、Claude、DeepSeek、豆包、千问生成的文本都能接。好处很直接,你不必为了打散整齐度,一句一句去重排几十段。
效果能证明到哪一步得说清楚。有一份公开的处理后报告显示,全文15078字符,人工特征100%、AI特征0%,AIGC值0.0176。它能说明结构层面的改写会让检测读到的形态变化,但证明不了"任何稿子都是这个结果"。去i迹没有对哪个平台给出官方效果保障,它适合处理社媒稿子的机器味,别当成平台达标承诺,论文硬指标更不要指望一次处理就交差。
所以先试再决定。新用户有1000字免费体验,不用注册就能拿到,用完不重置。别拿开头随便一段去试,挑你最改不动、句子最整齐的那段丢进去,一次能看清三件事:术语和数字有没有被动过、风格你接不接受、句长是不是真散开了。这三件事付费前搞清楚,就不会整篇处理完才发现不能用。平均2分钟交付,稿件不收录不公开、全程加密。快的价值不是效率,是你还留得下时间通读核对。万一仍不满意,剩下的路只有回到手改补细节,这也是免费额度要花在最难那段上的原因。

复检之前,还有哪几条必须确认?
- 改前改后并排看一遍,句子数量、每句字数、信息出场顺序是不是真的变了;
- 全文数一遍具体信息:时间、不整的数字、原话、失败经历,一段都拿不出来就回去补;
- 术语、参数、样本量、引用、否定词跟底稿逐项核对;
- 补进去的细节全是真的,没有一个为凑数编的;
- 依法加上的标识原样保留,该主动标注的按规则标注;
- 用你真正要交的那个平台复检,别拿别处报告交差;
- 记下复检平台、字数、日期,下一轮才有基准可比;
- 底稿和中间版本都留着,改坏了退得回去。
 浙公网安备 33010602011771号