
结对项目:小学四则运算题目生成器
| 这个作业属于哪个课程 | https://edu.cnblogs.com/campus/gdgy/Class78-Grade2024-CS/ |
|---|---|
| 这个作业要求在哪里 | https://edu.cnblogs.com/campus/gdgy/Class78-Grade2024-CS/homework/15703 |
| 作业目标 | 完成结对项目要求的程序作业 |
成员信息:翁佳华,3224004345;廖颖欣,3224004307。
GitHub 项目地址: https://github.com/Huahetai-cell/pair-arithmetic
一、需求分析
本项目实现一个小学四则运算题目生成与批改程序。生成模式通过 -n 控制题目数量,通过 -r 控制数值范围;每题包含1~3个运算符,支持自然数、真分数、带分数、四则运算和括号。程序保证任何减法子表达式不产生负数,任何除法子表达式的结果严格满足 0 < result < 1。
除题目和答案文件外,程序还支持读取指定题目文件与答案文件,统计正确和错误题号并输出 Grade.txt。重复题的定义不是简单字符串比较:加法和乘法允许交换左右子树,但不使用结合律任意展平表达式。程序还必须稳定支持一次生成10000道不重复题目。
为了便于教师直接运行,我们既保留了 Python 源码入口,也使用 PyInstaller 生成了 Windows 单文件程序 Myapp.exe。
二、PSP 表格
项目开始前的时间估计如下。实际时间一栏必须由两位成员根据真实开发记录补全,不能用估计值代替。
| PSP2.1 阶段 | 预计耗时(分钟) | 实际耗时(分钟) |
|---|---|---|
| 计划与需求分析 | 45 | 35 |
| 设计 | 60 | 45 |
| 编码 | 360 | 295 |
| 代码复审 | 60 | 70 |
| 测试与修复 | 180 | 95 |
| 性能分析与优化 | 120 | 70 |
| 文档与博客 | 75 | 45 |
| 合计 | 900 | 655 |
三、开发环境与项目组织
- 语言:Python 3.12,兼容 Python 3.10+
- 精确计算:标准库
fractions.Fraction - 测试:标准库
unittest - 性能分析:
cProfile、tracemalloc、time.perf_counter_ns - 图表输出:Pillow
- EXE 打包:PyInstaller
- 版本管理:Git、GitHub,默认分支为
main
项目主要目录如下:
pair-arithmetic/
├─ Myapp.py                    # 源码运行入口
├─ src/arithmetic/
│  ├─ cli.py                   # 参数处理和文件输出
│  ├─ expression.py            # 表达式树、运算符、分数格式化
│  ├─ generator.py             # 受约束随机生成和判重
│  ├─ parser.py                # 递归下降解析器
│  └─ grader.py                # 答案批改
├─ tests/                      # 19项自动测试
├─ tools/                      # 性能、验收和打包脚本
├─ samples/                    # 可复现判题样例
└─ docs/                       # 博客、性能和验收报告
四、设计实现过程
4.1 模块关系

4.2 表达式树和精确计算
数字节点 Number 保存一个 Fraction;二元节点 Binary 保存左子树、运算符和右子树。节点创建时立即计算并缓存结果、运算符数量和规范判重键。这样生成、输出、批改和性能分析都使用同一种数据结构,避免不同模块对表达式含义理解不一致。
使用 Fraction 而不是浮点数非常重要。例如 1/6 + 1/8 会精确得到 7/24,不会出现 0.291666... 一类误差。输出时根据数值自动选择自然数、普通分数或 2’3/8 格式。
4.3 生成流程

减法仅在左值大于等于右值时创建;除法要求左值大于0且小于右值,因此商必然是真分数。生成器还设置最大尝试次数,当很小的范围无法提供足够多的唯一题目时会明确报错,而不是无限循环。
4.4 重复题判定
每个数字节点生成形如 N[1/2] 的键。对于减法、除法,左右子树顺序原样保留;对于加法、乘法,两个直接子树的键按字典序排列。因此:
23 + 45与45 + 23的键相同;3 + (2 + 1)与(1 + 2) + 3可以通过有限次交换得到相同结构;(1 + 2) + 3与(3 + 2) + 1的内部子树不同,不会被错误地当作同一道题。
我们没有把连续加法或乘法展平成集合,因此严格遵循题目所描述的“有限次交换左右表达式”,没有额外使用结合律。
4.5 表达式解析与批改
ExpressionParser 使用递归下降方法,依次处理加减、乘除和括号/数字三个优先级层次,并按左结合构造表达式树。批改时不是比较答案字符串,而是重新解析题目、精确计算标准值,再把用户答案解析为 Fraction 比较,所以 1/2 与 2/4 会被视为相同答案。缺失答案或格式非法的答案计入 Wrong。
五、关键代码说明
5.1 减法与除法约束
if operator is Operator.SUBTRACT and left.value < right.value:
    stats.constraint_rejects += 1
    return None
if operator is Operator.DIVIDE and (left.value <= 0 or left.value >= right.value):
    stats.constraint_rejects += 1
    return None
在表达式树创建之前拒绝非法候选,使所有嵌套子表达式也满足要求,而不仅仅检查最终答案。
5.2 加法和乘法规范键
left_key, right_key = self.left.canonical_key, self.right.canonical_key
if self.operator.commutative and left_key > right_key:
    left_key, right_key = right_key, left_key
self.canonical_key = f"{self.operator.name}({left_key},{right_key})"
规范键由树结构递归产生,集合查询平均为 O(1),能够支撑万人题判重。
5.3 批改统计
expected = parser.parse(exercise_text).value
if supplied is not None and parse_fraction(supplied) == expected:
    correct.append(number)
else:
    wrong.append(number)
这种做法允许答案使用等值分数,同时把缺失、错误和非法格式统一归入 Wrong。
六、程序运行与输入输出
查看帮助:
.\dist\Myapp.exe --help

生成10道题:
.\dist\Myapp.exe -n 10 -r 10
Get-Content .\Exercises.txt -Encoding UTF8
Get-Content .\Answers.txt -Encoding UTF8


非法参数能够得到帮助信息和非零退出状态:
.\dist\Myapp.exe -n 10

批改固定样例:
.\dist\Myapp.exe -e .\samples\Exercises-demo.txt -a .\samples\Answers-demo.txt
Get-Content .\Grade.txt -Encoding UTF8
预期结果为:
Correct: 2 (1, 5)
Wrong: 3 (2, 3, 4)


七、测试与正确性说明
7.1 测试用例
| 编号 | 测试内容 | 预期结果 |
|---|---|---|
| 1 | 1/6 + 1/8 |
精确得到 7/24 |
| 2 | 解析 2’3/8 |
得到 19/8 并按带分数输出 |
| 3 | 输入 1/0 |
拒绝分母为0 |
| 4 | 表达式优先级 1 + 2 * 3 |
结果为7 |
| 5 | 生成500题并递归检查 | 每个减法非负、每个除法结果在0和1之间 |
| 6 | 交换 23 + 45 |
与 45 + 23 判为重复 |
| 7 | 比较两种不同结合结构 | 不使用结合律错误去重 |
| 8 | 缺失 -r、零或非整数参数 |
显示帮助并返回错误状态 |
| 9 | 正确、错误、缺失和非法答案 | 正确归入 Correct/Wrong |
| 10 | UTF-8 BOM文件 | 能正常读取并批改 |
| 11 | 连续生成20题再生成3题 | 文件被覆盖为3行,不追加旧内容 |
| 12 | 一次生成10000题 | 数量正确,规范判重键全部唯一 |
自动测试命令:
$env:PYTHONPATH = "$PWD\src"
python -m unittest discover -s tests -v
当前19项测试全部通过。

7.2 黑盒输入输出验收
本次本机验收入口为 dist/Myapp.exe,共执行13个场景,通过13个,失败0个,总耗时约10.11秒。
| 编号 | 检验场景 | 输入参数 | 预期结果 | 实际结果 |
|---|---|---|---|---|
| 1 | 帮助信息 | --help |
状态码0,显示完整用法 | PASS,正确显示两种模式和四个参数 |
| 2 | 缺少范围参数 | -n 10 |
状态码2并提示缺少 -r |
PASS,显示帮助及明确错误信息 |
| 3 | 题目数量为0 | -n 0 -r 10 |
拒绝非正整数 | PASS,提示“必须是正整数” |
| 4 | 题目数量不是整数 | -n abc -r 10 |
参数解析失败 | PASS,返回状态码2 |
| 5 | 范围为负数 | -n 10 -r -1 |
拒绝非正整数 | PASS,提示“必须是正整数” |
| 6 | 未知参数 | --unknown 1 |
拒绝未知参数 | PASS,显示无法识别参数 |
| 7 | 两种模式混用 | -n 1 -r 10 -e e.txt -a a.txt |
拒绝模式冲突 | PASS,提示只能选择一种模式 |
| 8 | 批改文件不存在 | -e missing-e.txt -a missing-a.txt |
状态码2并报告文件错误 | PASS,没有错误生成 Grade.txt |
| 9 | 最小范围 | -n 1 -r 1 |
生成1道合法题目 | PASS,题目与答案各1行 |
| 10 | 普通生成 | -n 100 -r 10 |
生成100道合法题目 | PASS,编号、答案和唯一性均正确 |
| 11 | 万人题生成 | -n 10000 -r 10 |
生成10000道不重复题目 | PASS,题目与答案各10000行,逐题验算正确 |
| 12 | 综合批改 | -e grade-e.txt -a grade-a.txt |
正确1、5;错误2、3、4 | PASS,输出 Correct: 2 (1, 5) 与 Wrong: 3 (2, 3, 4) |
| 13 | 覆盖写文件 | 先生成10000题,再执行 -n 3 -r 10 |
新文件只有3行 | PASS,没有追加旧题目 |
综合批改场景专门混合了不同输入情况:第1题为正确分数答案,第2题答案错误,第3题缺失答案,第4题答案格式非法,第5题为正确带分数运算。实际输出如下:
Correct: 2 (1, 5)
Wrong: 3 (2, 3, 4)
万人题场景不仅统计文件行数,还执行以下内部复核:
- 题目编号和答案编号必须从1连续到10000;
- 每行必须符合规定的空格、等号和分数格式;
- 将题目文本重新解析为表达式树,并精确计算答案;
- 重新计算的答案必须与 Answers.txt 对应答案相同;
- 规范判重键不能重复。
最终验收结果为:13/13 I/O cases passed。


这些测试不仅检查“程序能运行”,还验证了中间子表达式约束、输出语法、精确答案、编号、唯一性、编码和异常路径,因此能够较全面地说明程序正确性。
八、性能分析与优化
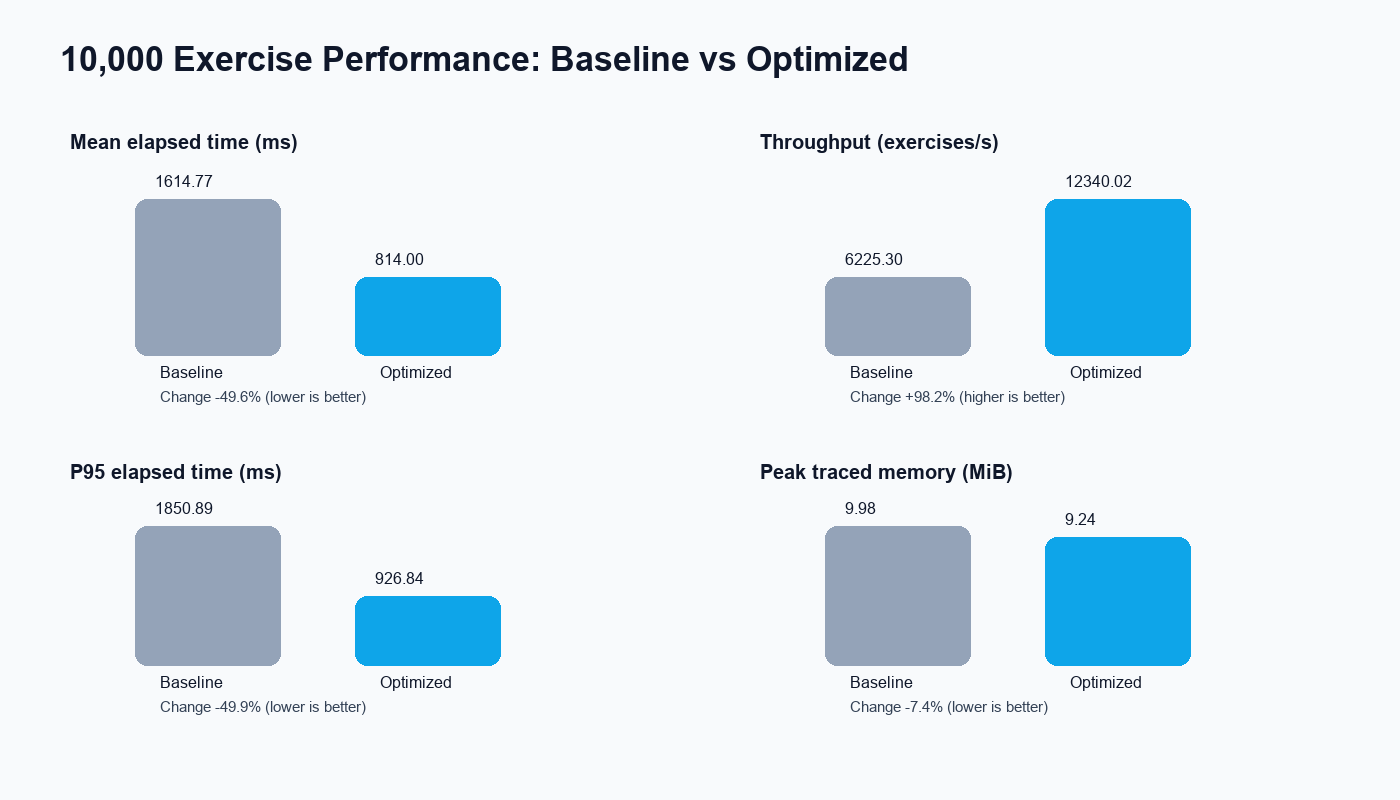
性能测试固定使用 -n 10000 -r 10,基线和优化版每轮使用相同随机种子,先预热3轮,再正式测量7轮。基线策略每次都把表达式格式化为文本、重新解析并构造判重键;优化版在表达式节点创建时缓存结果和规范键。
| 策略 | 平均耗时(ms) | 中位数(ms) | P95(ms) | 吞吐量(题/秒) | 峰值内存(MiB) |
|---|---|---|---|---|---|
| 基线 | 1614.77 | 1570.02 | 1850.89 | 6225.30 | 9.98 |
| 优化版 | 814.00 | 812.88 | 926.84 | 12340.02 | 9.24 |
优化后平均耗时下降49.6%,吞吐量提高98.2%。这说明缓存规范键避免了大量字符串构造和重复解析,优化方向与剖析结果一致。
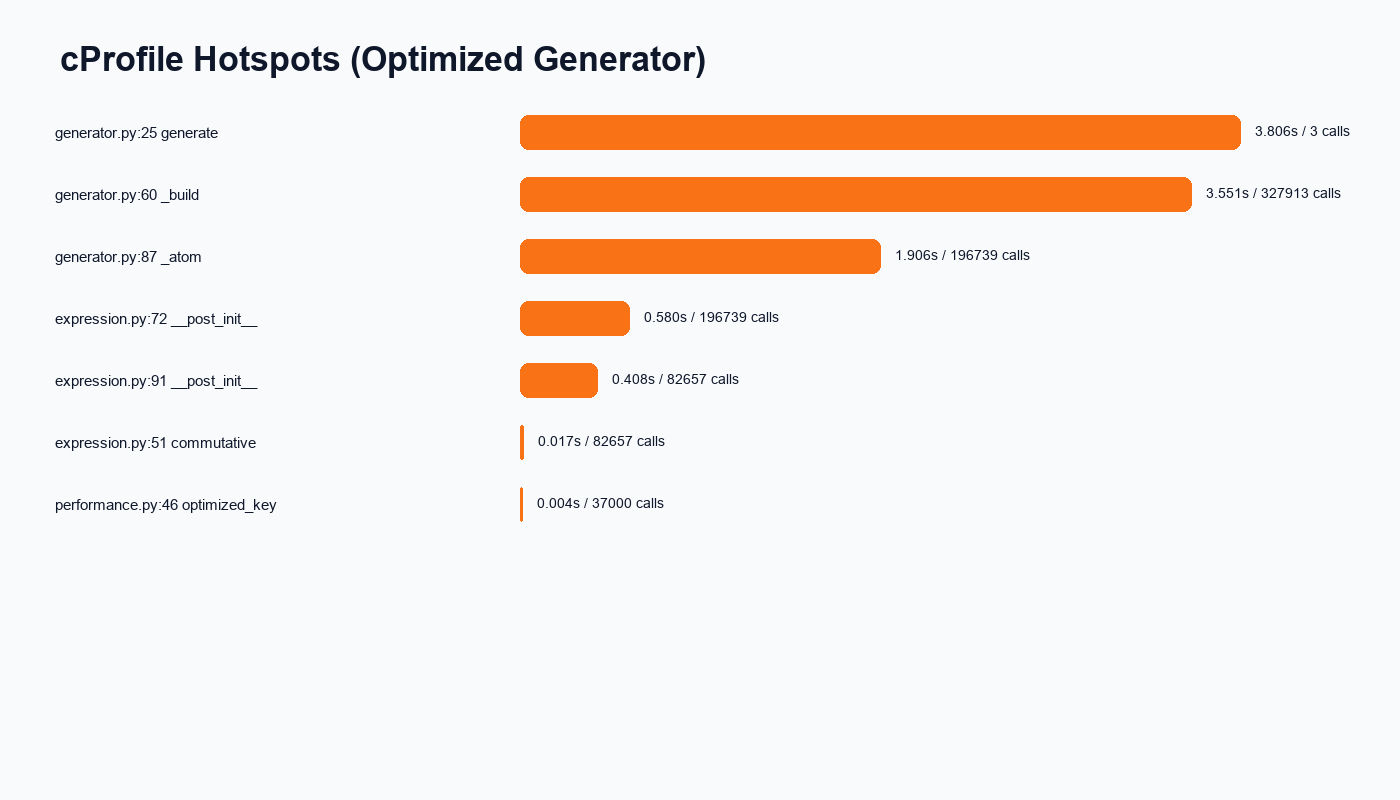
cProfile 显示优化后的主要累计耗时位于递归生成函数 _build 和随机操作数函数 _atom,而读取缓存键 optimized_key 的耗时很小。
九、项目小结
本项目最重要的设计决定是用表达式树和精确分数统一生成、计算、格式化、判重与批改。这样避免了浮点误差,也使“检查每一个减法或除法子表达式”成为自然的递归过程。规范结构键解决了字符串比较无法识别交换等价题的问题,有限重试则避免极小范围下无限循环。
在实现过程中,我们还认识到功能正确并不等于交付完整。除单元测试外,项目增加了真实EXE黑盒验收、自动性能报告、可复现输入文件、构建脚本和明确的提交历史。这些材料使运行结果能够被重复验证,也为博客中的结论提供了数据依据。
项目仍可继续改进:例如增加图形界面、允许通过可选参数固定随机种子、在持续集成环境中自动运行测试,以及为不同题目难度设计更细致的分布策略。
十、结对感受与相互评价
翁佳华的结对感受
在本次项目中,我主要负责程序编码与博客内容的编撰,包括将需求落实为表达式树、题目生成、答案批改、性能分析等模块,并整理实现思路、测试结果和性能数据。测试环境的搭建与验证由我们两人共同完成:一方面检查 Python 源码和打包后的 Myapp.exe 是否能在本机正常运行,另一方面共同核对万人题、异常参数和答案批改等场景。
与廖颖欣结对给我最大的帮助,是在编码前能够先围绕题目约束、模块边界和测试方法进行设计讨论。她负责的设计工作把较长的需求拆分成了清晰的模块,使我在实现时能够围绕统一的数据结构推进,而不是边写边改变整体方向。在博客整理完成后,她还从读者视角优化了文章排版、章节层次和图表位置,让实现过程和测试证据更容易阅读。
我认为廖颖欣的闪光点是整体意识较强,能够从需求和交付效果出发发现结构问题;她对排版细节也比较耐心,不只是关注程序能否运行,还会考虑材料是否清楚、完整。给她的建议是,今后可以把设计阶段的讨论进一步沉淀为更细的接口说明或任务清单,并更早地记录设计取舍,这样在实现和撰写总结时能够减少回溯成本。
廖颖欣的结对感受
在本次项目中,我主要负责整体设计和博客排版优化。设计阶段需要把题目中的分数表示、运算约束、表达式判重、文件输入输出和性能要求组织成能够实现的模块;在项目后期,我根据程序的实际结果调整了博客结构、表格和图片位置,使各项评分要求都能找到对应的说明和证据。测试环境由我们共同负责,我们一起确认了运行依赖、命令行参数、文件编码以及打包程序的实际表现。
合作过程中让我印象较深的是,题目的“重复”规则和普通数学等价并不完全相同,同时还要求检查每个嵌套子表达式。我们通过共同分析题目示例,确定使用表达式树和规范结构键,再由翁佳华完成具体编码,并通过自动测试和黑盒验收交叉验证。这种先形成共同理解、再实现并复核的方式减少了需求理解偏差。
我认为翁佳华的闪光点是执行力和问题定位能力较强,能够把设计快速转换为可运行代码,并主动补充单元测试、万人题验证、性能报告和 EXE 打包,使项目不仅实现了功能,也具备较完整的交付材料。他在博客撰写中也能把代码细节转换为较容易理解的文字。给他的建议是,在编码过程中可以更及时地同步阶段性变化,并把调试和实际耗时随手记录下来,这样能够进一步降低沟通成本,也能让PSP实际时间和项目复盘更加准确。
共同总结
两人一致认为,结对开发的价值不只是把任务简单拆成两份,而是让设计、编码、测试和文档形成相互反馈。廖颖欣的设计与排版工作帮助项目保持清晰结构,翁佳华的编码与博客撰写保证了方案能够落地并形成可验证的成果;共同完成测试环境和结果核对,则让双方都能了解项目的真实运行状态。后续合作中,我们会继续改进任务记录、阶段同步和时间统计,并在设计与实现之间保留更明确的检查点。

 浙公网安备 33010602011771号