
第一次个人编程作业
第一次个人编程作业
| 这份作业属于哪个课程 | 2024级计算机科学78班(Class78-Grade2024-CS) |
|---|---|
| 这个作业要求在哪里 | 作业要求 |
| 这个作业的目标 | 通过实现一个命令行论文查重程序,完成从需求分析、算法设计、文件输入输出、性能优化到单元测试和工程报告的完整开发流程,掌握 Python 项目组织、GitHub 版本管理和软件质量验证方法。 |
项目仓库: https://github.com/Huahetai-cell/3224004345
学号: 3224004345
开发语言: Python 3
本次软件工程实践完成了一款命令行论文查重程序。程序读取原文文件和抄袭版文件,在内存中计算字符 n-gram 相似度,并将保留两位小数的重复率写入答案文件。整个开发过程包含需求分析、代码实现、Counter 性能优化、20个自动化测试、覆盖率验证、异常处理和 GitHub 版本管理。
一、PSP 表格(开发前的预估)
本项目按需求分析、接口设计、首版实现、性能改进、测试和报告六个阶段推进。预估值在开始编码前记录,实际值在完成本地验收和资料整理后补充。时间单位为分钟。为避免中文阶段名称被挤成窄列,下面使用宽度为 100% 的表格。
| PSP2.1 阶段 | 工作内容 | 预估耗时(分钟) |
|---|---|---|
| Planning | 计划 | 30 |
| Estimate | 估计任务时间 | 20 |
| Development | 需求分析、设计、编码、复审和测试 | 500 |
| Reporting | 测试报告、工作量统计和事后总结 | 140 |
| 合计 | 690 | |
二、计算模块接口的设计与实现过程
2.1 需求与对外接口
程序按照作业规定从命令行接收三个文件路径:
python main.py <原文文件> <抄袭版论文文件> <答案文件>
程序读取前两个文件,计算重复率,再把固定两位小数写入第三个文件。例如:
python main.py C:\tests\orig.txt C:\tests\orig_add.txt C:\tests\ans.txt
答案文件输出范围为 0.00 到 1.00。成功退出码为 0,参数错误为 2,文件读取、解码或写入错误为 1。
2.2 代码组织:入口、计算、测试和证据四部分
| 文件或目录 | 作用 | 关键内容 |
|---|---|---|
main.py |
程序入口 | 调用 main() 并返回进程退出码 |
paper_checker.py |
计算与文件接口 | normalize_text()、calculate_similarity()、run()、main() |
tests/ |
自动化测试 | 20个 unittest 用例,覆盖正常、边界和异常分支 |
tools/ |
工程辅助 | 性能证据和老师测试数据批量运行脚本 |
docs/ |
过程材料 | 设计说明、PSP、测试报告和本文博客草稿 |
calculate_similarity() 不依赖文件系统,因此可以直接测试算法;run() 只负责读取、计算和写答案;main() 统一处理参数和异常。这种拆分让测试既能验证纯计算,也能验证真实命令行行为。
2.3 算法关键:字符一元组和二元组的多重集 Dice
原始论文和抄袭版可能出现增删改、标点变化、空格变化和局部重排。程序先对文本进行 Unicode NFKC 规范化、英文大小写归一,并移除空白、标点和符号。这样“全角A”和“半角A”、不同排版空格不会被误判成内容差异。
对规范化文本生成字符一元组和相邻字符二元组。两个多重集 A、B 的 Sørensen–Dice 系数为:
Dice(A, B) = 2 × |A ∩ B| / (|A| + |B|)
交集按每个片段出现次数的较小值累计,而不是简单判断“出现过/没出现过”。最终重复率为:
重复率 = 0.2 × 一元组 Dice + 0.8 × 二元组 Dice
一元组反映整体字符重合,二元组更重视相邻语序。文本短于两个字符时退化为一元组比较;两个空文本定义为 1.00,只有一边为空时定义为 0.00。
2.4 关键实现:用 Counter 计算多重集交集
初版用列表逐项查找并删除匹配项:
for item in left:
    if item in unmatched:
        unmatched.remove(item)
长文本中 item in list 和 list.remove() 会反复扫描列表,最坏复杂度接近 O(n²)。最终版本改为:
left_counts = Counter(left)
right_counts = Counter(right)
overlap = sum((left_counts & right_counts).values())
计数器交集保持多重集语义,时间复杂度降为 O(n),空间复杂度为 O(n)。这是本项目性能改进的核心。
2.5 整体流程
三、计算模块接口部分的性能改进
3.1 两代实现
| 版本 | 多重集匹配方式 | 时间复杂度 | 结果一致性 |
|---|---|---|---|
| 第一版 | 列表查找并删除 | 最坏 O(n²) | 基准版本 |
| 最终版 | Counter 交集 |
O(n) | 与第一版一致 |
3.2 实测耗时(Windows / Python 3.13)
在相同的 15,400 字符样本上使用 cProfile 和 tracemalloc:
| 实现 | 分析耗时 | 峰值内存 | 重复率 |
|---|---|---|---|
| 列表查找/删除 | 1.109023 秒 | 1.936 MiB | 0.810514 |
Counter 交集 |
0.146865 秒 | 1.842 MiB | 0.810514 |
结果完全一致,分析场景提速约 7.55 倍。对约 1 MiB 文本进行正常运行测试,耗时约 0.890186 秒,诊断峰值内存约 117.150 MiB,满足5秒和2048 MB限制。
3.3 性能分析图与热点函数
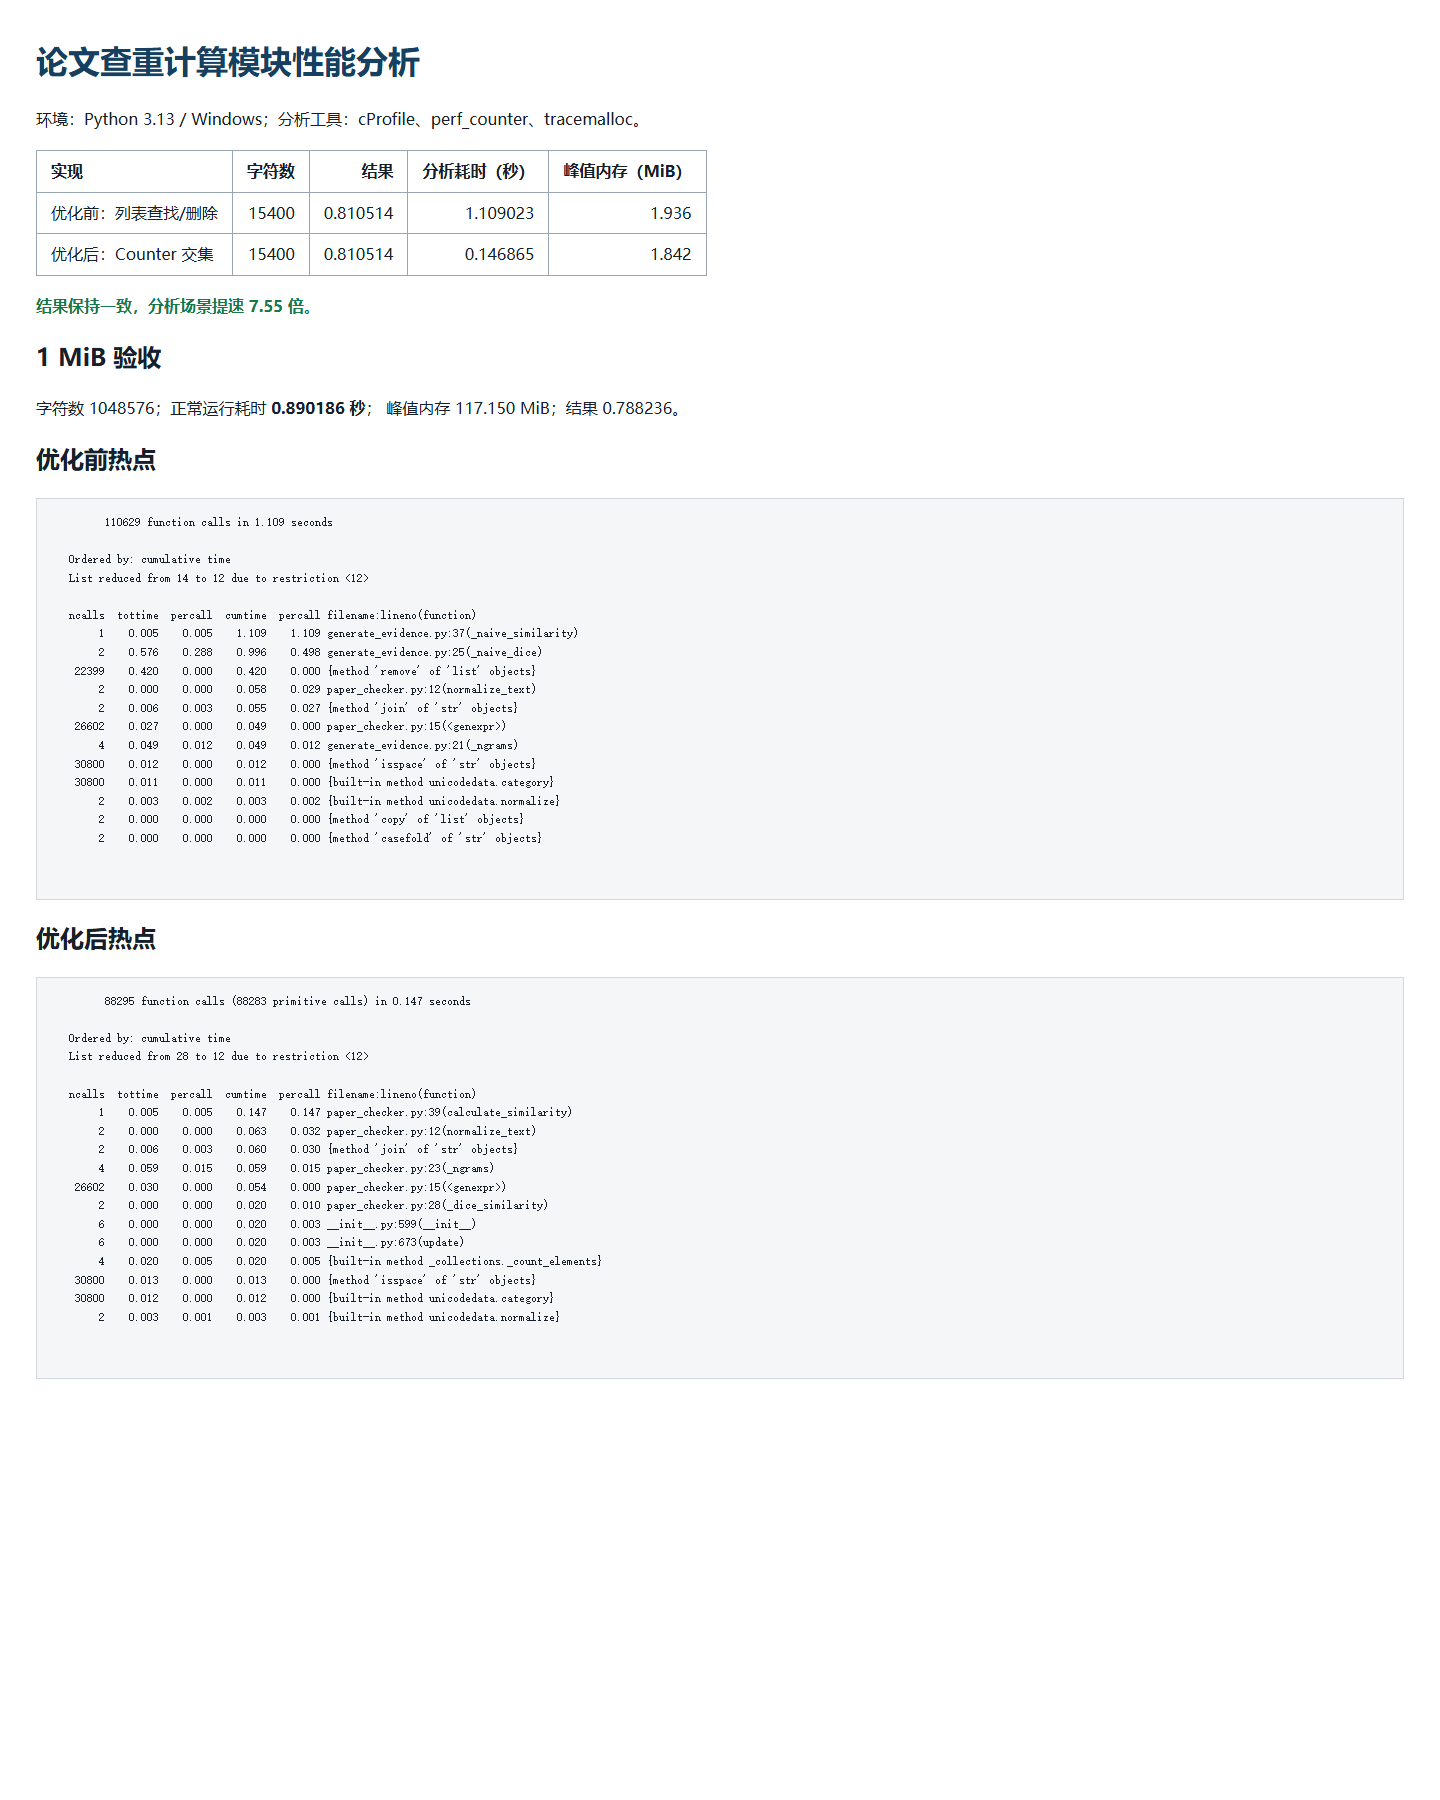
优化前的热点是 _dice_similarity() 中的列表查找和 list.remove();优化后热点转移到必要的文本规范化、n-gram 构造和 Counter 建立,说明二次匹配循环已经被消除。原始 cProfile 数据见 reports/evidence/cprofile-before.txt 和 cprofile-after.txt。
3.4 改进思路小结
先用基准版本确认功能,再用性能分析定位瓶颈,最后只替换多重集交集实现。每次优化都重新运行同一组测试,确认答案和边界行为不变,避免为了追求速度改变查重口径。
四、计算模块接口部分的单元测试
4.1 测试规模与运行方式
项目使用 Python 标准库 unittest,当前共有20个测试用例,超过需求规定的至少10个:
python -m unittest discover -v
本地实际结果:
Ran 20 tests
OK
测试覆盖规范化、相似度边界、多重集计数、UTF-8 BOM、GB18030、中文路径、命令行参数、文件异常、答案格式和独立进程调用。
4.2 覆盖率报告
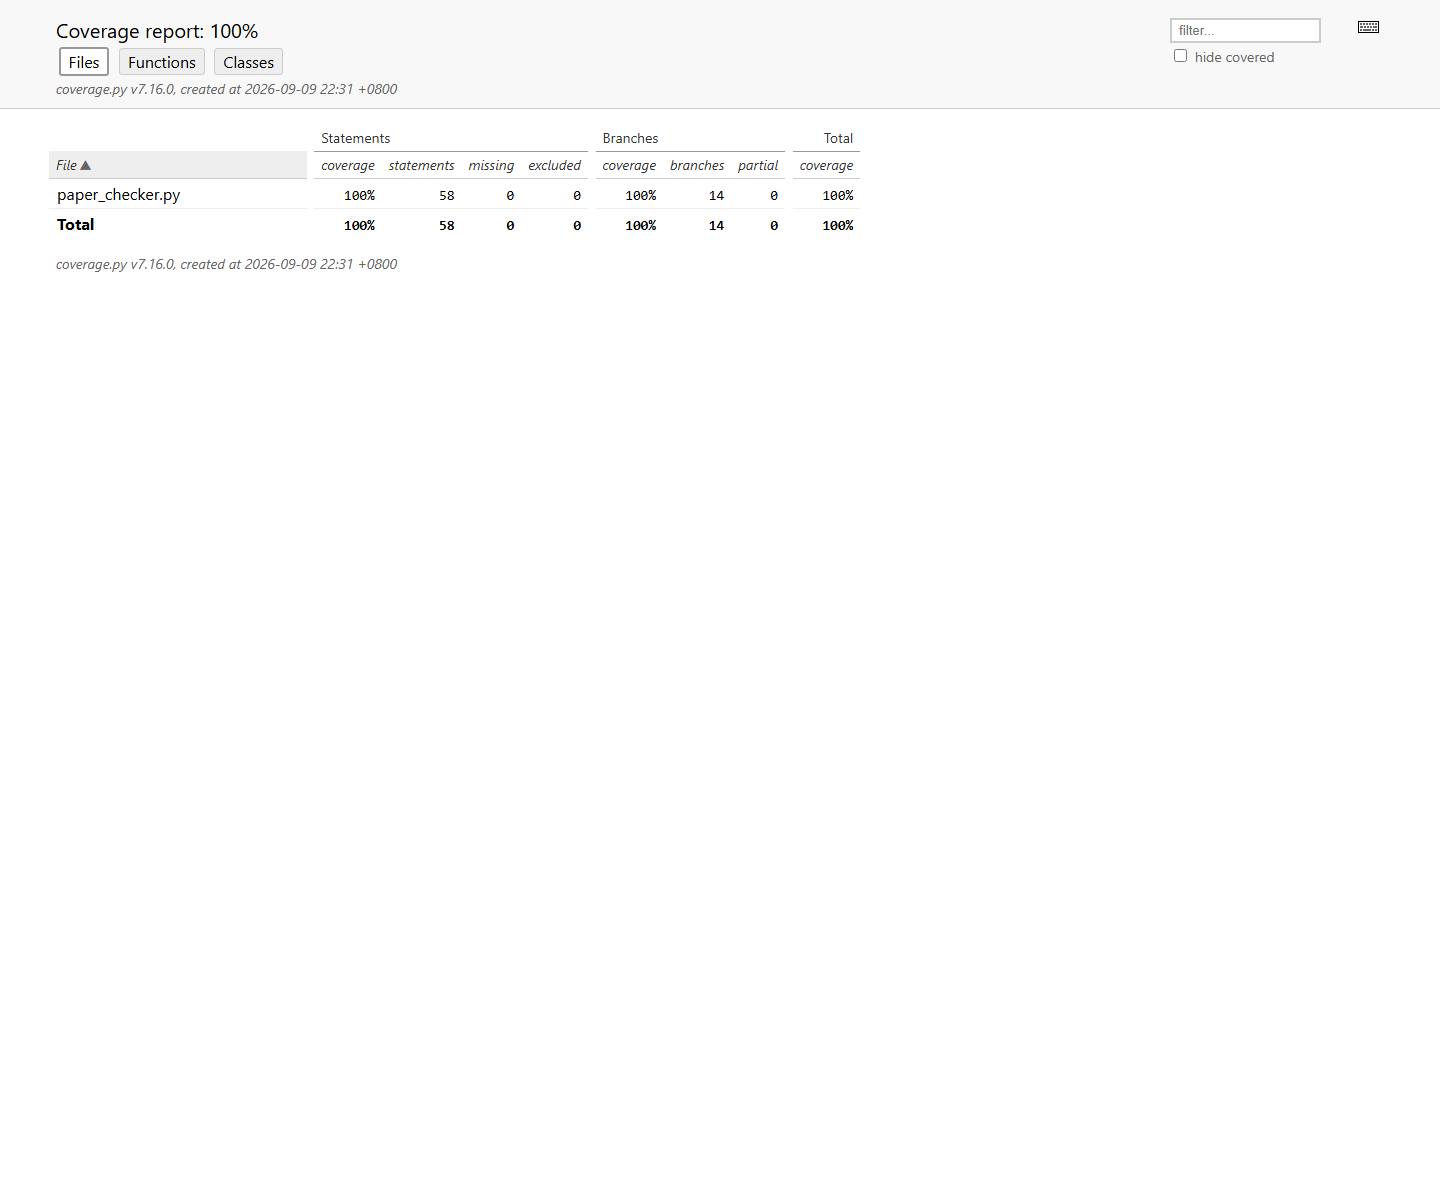
python -m coverage run --branch -m unittest discover
python -m coverage report -m
核心模块结果:
Name               Stmts   Miss Branch BrPart  Cover
----------------------------------------------------
paper_checker.py      58      0     14      0   100%
----------------------------------------------------
TOTAL                 58      0     14      0   100%
4.3 部分测试代码与构造思路
完全相同、完全不同和文档示例用于验证基本正确性;重复字符用于验证多重集而非普通集合;空文本和单字符用于覆盖退化分支;错误编码、缺失路径和输出目录不存在用于覆盖异常分支。
def test_repeated_fragments_use_multiset_counts(self) -> None:
    self.assertAlmostEqual(calculate_similarity("aaaa", "aa"), 0.5333333333)

def test_output_may_overwrite_an_input_after_both_are_read(self) -> None:
    original, suspect, _ = self._write_inputs()
    run(original, suspect, original)
    self.assertRegex(original.read_text(encoding="utf-8"), r"^\d\.\d{2}\n$")
这两例分别验证计数交集语义和“先读完输入再写输出”的文件安全行为。
4.4 老师数据的补充验收
项目新增了 tools/run_teacher_samples.ps1,可以批量解压并运行老师提供的样例。当前压缩包中的 orig_0.8_add.txt 可正常作为文本读取;另外几个文件开头是 GitHub HTML 页面,不是论文正文,因此验收记录明确标注了数据完整性问题,没有把文件名中的 0.8 擅自当成标准答案。
五、计算模块接口部分的异常处理说明
| 异常类别 | 处理目标 | 退出码 | 对应测试 |
|---|---|---|---|
| 参数数量不是3个 | 显示规范用法,不访问文件 | 2 | test_main_rejects_wrong_argument_count |
| 输入路径不存在或不是普通文件 | 提示具体路径 | 1 | test_main_reports_missing_input_without_traceback |
| UTF-8、GB18030均无法解码 | 提示支持的编码 | 1 | test_main_reports_invalid_encoding |
| 输出目录不存在或不可写 | 捕获系统写入错误 | 1 | test_main_reports_unwritable_output_location |
| 输出路径与输入相同 | 先完成两次读取再写答案 | 0 | test_output_may_overwrite_an_input_after_both_are_read |
预期异常统一转换成单行错误信息,不显示 traceback。程序不连接网络,不扫描指定路径之外的文件,也不使用数据库,符合题目对文件输入输出和评测红线的要求。
六、PSP 表格(实现之后的实际耗时)
| PSP2.1 阶段 | 工作内容 | 预估(分钟) | 实际(分钟) |
|---|---|---|---|
| Planning | 计划 | 30 | 45 |
| Estimate | 估计任务时间 | 20 | 30 |
| Development | 需求分析、设计、编码、复审和测试 | 500 | 620 |
| Reporting | 测试报告、工作量统计和事后总结 | 140 | 180 |
| 合计 | 690 | 875 | |
实际耗时包含需求阅读、编码、性能定位、20个测试用例、覆盖率报告、老师数据验收、README 和博客材料整理。与只运行一次程序相比,这个时间更接近一次完整作业交付的自主开发过程。
七、总结与改进计划
本项目完成了命令行文件输入输出、字符 n-gram 查重、异常处理、自动化测试和性能改进。当前最重要的限制是题目没有公开唯一算法和隐藏测试期望值;如果老师提供干净的原始样例及标准答案,下一步会用这些标注结果校准算法权重,并继续保持测试和性能基准不回退。

 浙公网安备 33010602011771号